


Я рассматриваю Jev как модель для быстрых решений, а не очередной чат-бот. Ей можно передать снимок состояния рынка и типизированные вопросы, а в ответ получить оценки с вероятностями. Такой механизм можно встроить в торговую систему, которая непрерывно анализирует стакан, проверяет сигналы и управляет ордерами.
В этой статье я разберу, как устроен такой контур высокочастотной торговли (HFT): где заканчивается работа модели и начинается обычный код, как задавать вопросы Jev, какие проверки поставить перед отправкой ордеров и как измерять качество системы.
Коротко о Jev
Модель выпустила TypeSafe AI. Её основатель – Диого Алмейда, один из исследователей ChatGPT и InstructGPT. Jev не генерирует свободный текст и не объясняет ход рассуждений. Вместо этого она отвечает на заранее сформулированные вопросы в заданном формате: выбирает вариант, возвращает число или выставляет оценку.
По данным TypeSafe, цена составляет $0,042 за миллион входных токенов, а выходные токены не тарифицируются.
В качестве примера я привожу работающего бота для маркет-мейкинга на Monad. Он читает стакан MON/USDC на Kuru, запрашивает решение у Jev на каждом блоке примерно раз в 300 мс и выставляет лимитный ордер на один тик ближе к рыночной цене. По данным репозитория, за три дня он набрал более тысячи звёзд, а некоторые решения приходили за 81 мс.
Сам по себе механизм принятия решений ещё не образует торговую систему. Нужны сбор данных, расчёт признаков, политика действий, управление риском, отправка ордеров и наблюдение за результатом. Jev должна отвечать только за часть оценок внутри этого контура.
Что я разберу в статье
-
Чем вызов модели отличается от полноценного цикла принятия решений.
-
Как разделить детерминированные расчёты и вероятностные оценки.
-
Как настроить TypeSafe SDK и отправить первый запрос.
-
Как собрать снимок состояния рынка и пакет параллельных вопросов.
-
Как организовать непрерывную работу, защиту от ошибок и проверку качества.
1. Что такое Jev и почему я рассматриваю её для HFT
TypeSafe называет Jev моделью «Системы 1» – быстрой, интуитивной части мышления в терминологии Даниэля Канемана. Идея в том, что многие решения внутри программы не требуют длинного рассуждения: нужно определить, к какой категории относится объект, оценить срочность или понять, похож ли поток ордеров на информированный.
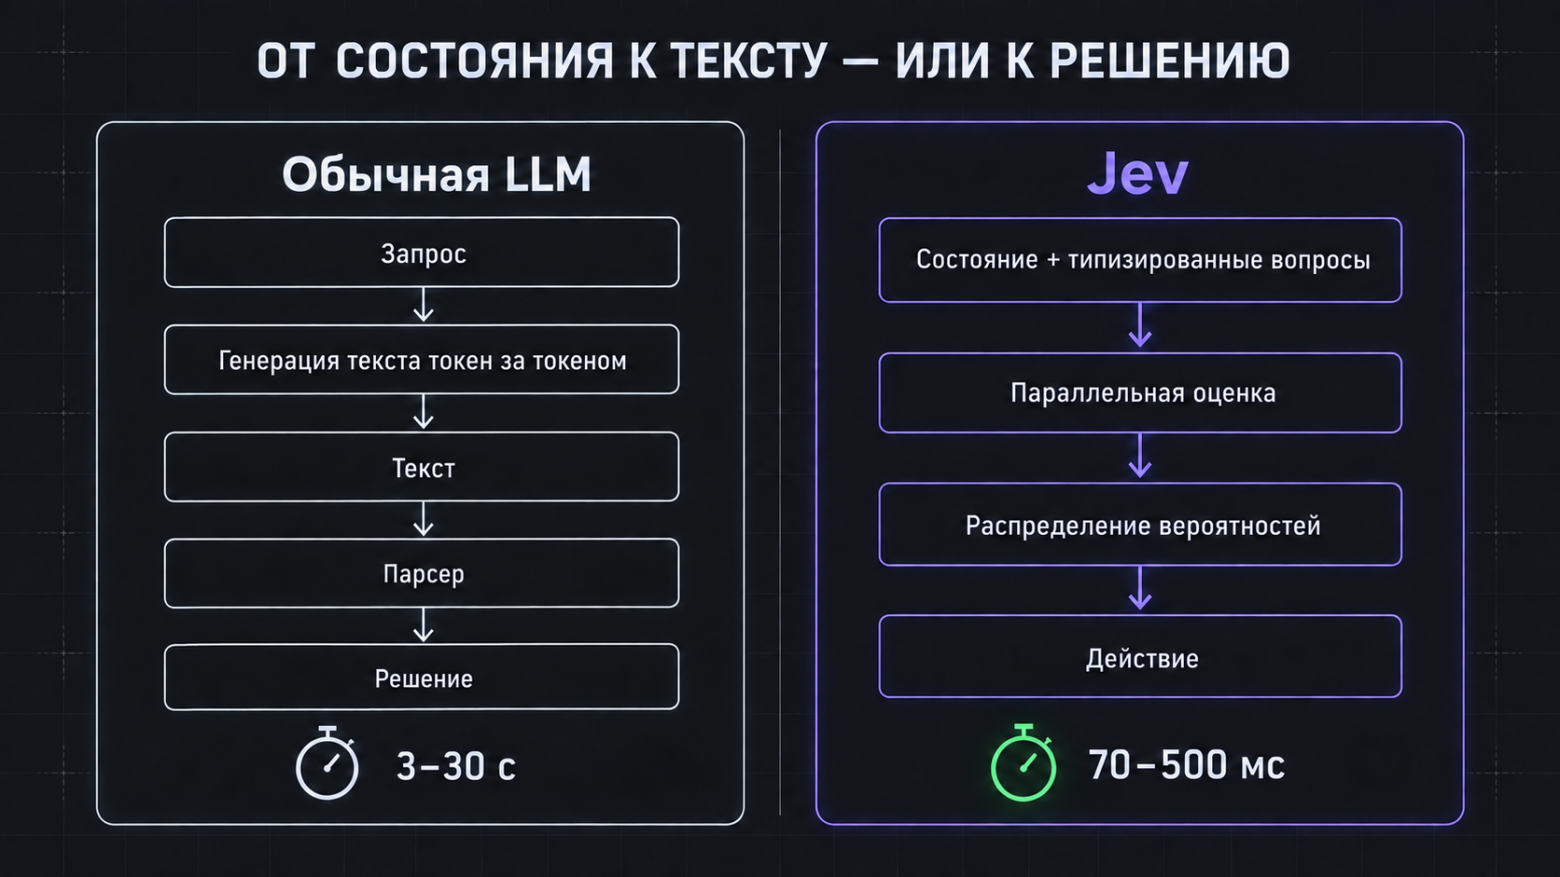
Легче понять как работает Jev можно по этой визуализации:
Языковая модель обычно превращает входные данные в последовательность токенов, затем выдаёт текст, который приходится разбирать программе. Jev получает состояние рынка и вопросы с заранее описанными форматами ответа. Она возвращает структурированные значения и уверенность в них – без свободного текста, парсинга и исправления JSON.
Я использую три формата ответа:
-
Noul возвращает число от 0 до 1. Например: «Насколько вероятно, что поток ордеров токсичен?» –
0.83. -
Choice выбирает вариант из списка, в котором может быть до 255 пунктов. Например: трендовый режим –
0.63, возврат к среднему –0.22, хаотичный –0.15. -
Score оценивает состояние по заданной шкале. Например: «Насколько рынок подходит для выставления котировок по шкале от 0 до 3?» –
2.3.
Все три формата можно объединить в один вызов. Вопросы оцениваются параллельно и независимо; я исхожу из того, что добавление новых вопросов почти не увеличивает задержку. Скорость я связываю с двумя особенностями:
-
Jev не авторегрессионная модель: она не генерирует токены один за другим, а вычисляет распределения вероятностей для вариантов ответа параллельно. Поэтому шесть вопросов могут занять примерно столько же времени, сколько один.
-
Модель обучена по методике RLCD (Reinforcement Learning for Calibrated Decisions – обучение с подкреплением для калибровки решений). По описанию TypeSafe, она подгоняет вероятности под реальные исходы, а не под человеческие предпочтения. В среднем более высокая уверенность должна соответствовать более высокой точности.
Контекстное окно – 32 000 токенов. Этого достаточно для компактного снимка рынка и последних сделок, но не для загрузки всей стратегии. Jev задаёт узкие оценки, а остальную логику выполняет код.
Где Jev помещается в бюджет задержки
В совместно размещённой инфраструктуре для торговли акциями задержки измеряются микросекундами. Я не рассматриваю Jev для такого сценария: там нужны программируемые логические интегральные схемы (FPGA) и C++.
У блокчейн-стаканов другой темп. Блоки Monad появляются примерно каждые 300 мс, слоты Solana – примерно каждые 400 мс. В такой цикл Jev может поместиться вместе с исполнением ордера. Для тактических оценок – например, режима рынка, токсичности потока или выбора стратегии – горизонт обычно составляет секунды.
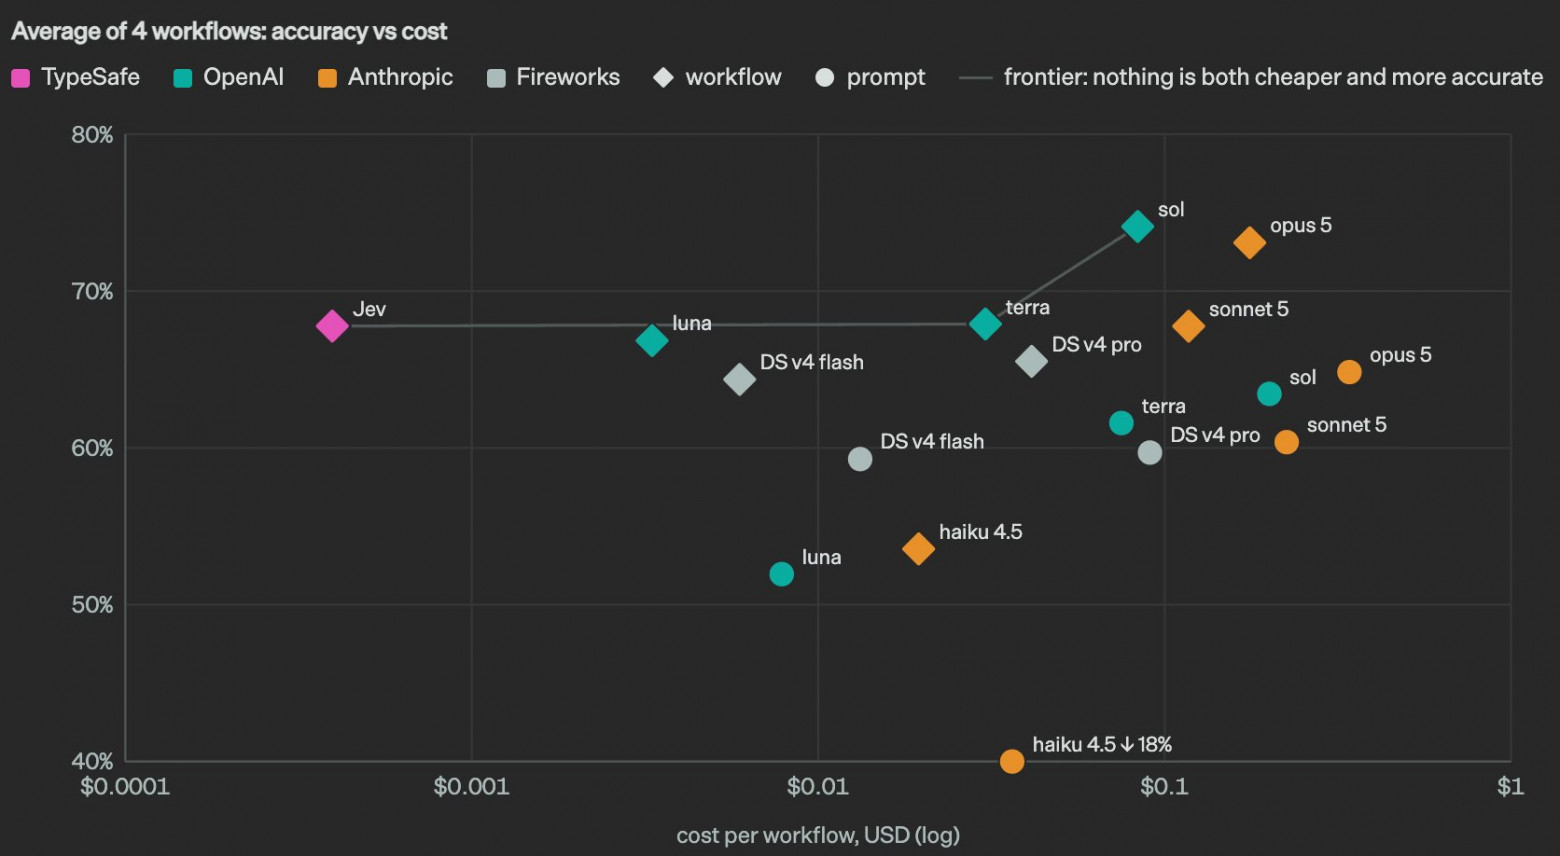
Я привожу следующие оценки стоимости:
|
Показатель |
Jev |
GPT-5.6 Terra |
|
Согласие с консенсусом передовых моделей в тесте TypeSafe |
67,8% |
67,9% |
|
Стоимость одного тестового кейса |
$0,0004 |
$0,0304 |
По этому бенчмарку Jev показывает практически такое же согласие с консенсусом и обходится примерно в 76 раз дешевле. Это собственный тест поставщика; я считаю приведённые цифры ориентировочными: на другой задаче результат может отличаться.
По моей оценке, один полный вызов на каждом блоке в режиме 24/7 обойдётся в $10–25 в месяц, тогда как аналогичный цикл на передовой LLM – в $50–150 в час. Эти суммы зависят от конфигурации и нагрузки, поэтому я рекомендую перепроверить их на собственных данных.
2. Архитектура: модель оценивает, код принимает решение
Главный принцип всей системы: Jev не должна управлять торговым ботом целиком. Ей поручают отдельные оценки, а остальную работу оставляют коду.
Не стоит отправлять модели запрос вроде «Посмотри на BTC и скажи, что делать». Для ответа ей пришлось бы одновременно восстановить состояние рынка, оценить вероятности, учесть комиссии и риск, выбрать размер позиции и ещё угадать правила исполнения.
Надёжнее разделить обязанности:
-
Код собирает данные и рассчитывает состояние.
-
Jev оценивает те признаки, которые сложно описать набором жёстких правил.
-
Политика в коде сопоставляет оценки с порогами и выбирает действие.
-
Исполнитель отправляет или отменяет ордер.
-
Жёсткие ограничения риска могут запретить действие на любом этапе.
В коде остаются все точные вычисления: средняя цена, спред, дисбаланс, реализованная волатильность, размер позиции, просадка, VWAP и место в очереди. Не нужно платить за модельный вызов, чтобы посчитать арифметику.
Jev можно спросить, например, о рыночном режиме, информированности агрессивного потока, качестве торговой возможности или ухудшении исполнения. Каждый вопрос должен быть атомарным. Если оценка зависит от нескольких факторов, запрос лучше разложить на отдельные вопросы, а результаты объединить в коде заданными весами. Когда меняются приоритеты, достаточно поправить коэффициент, а не переписывать промпт.
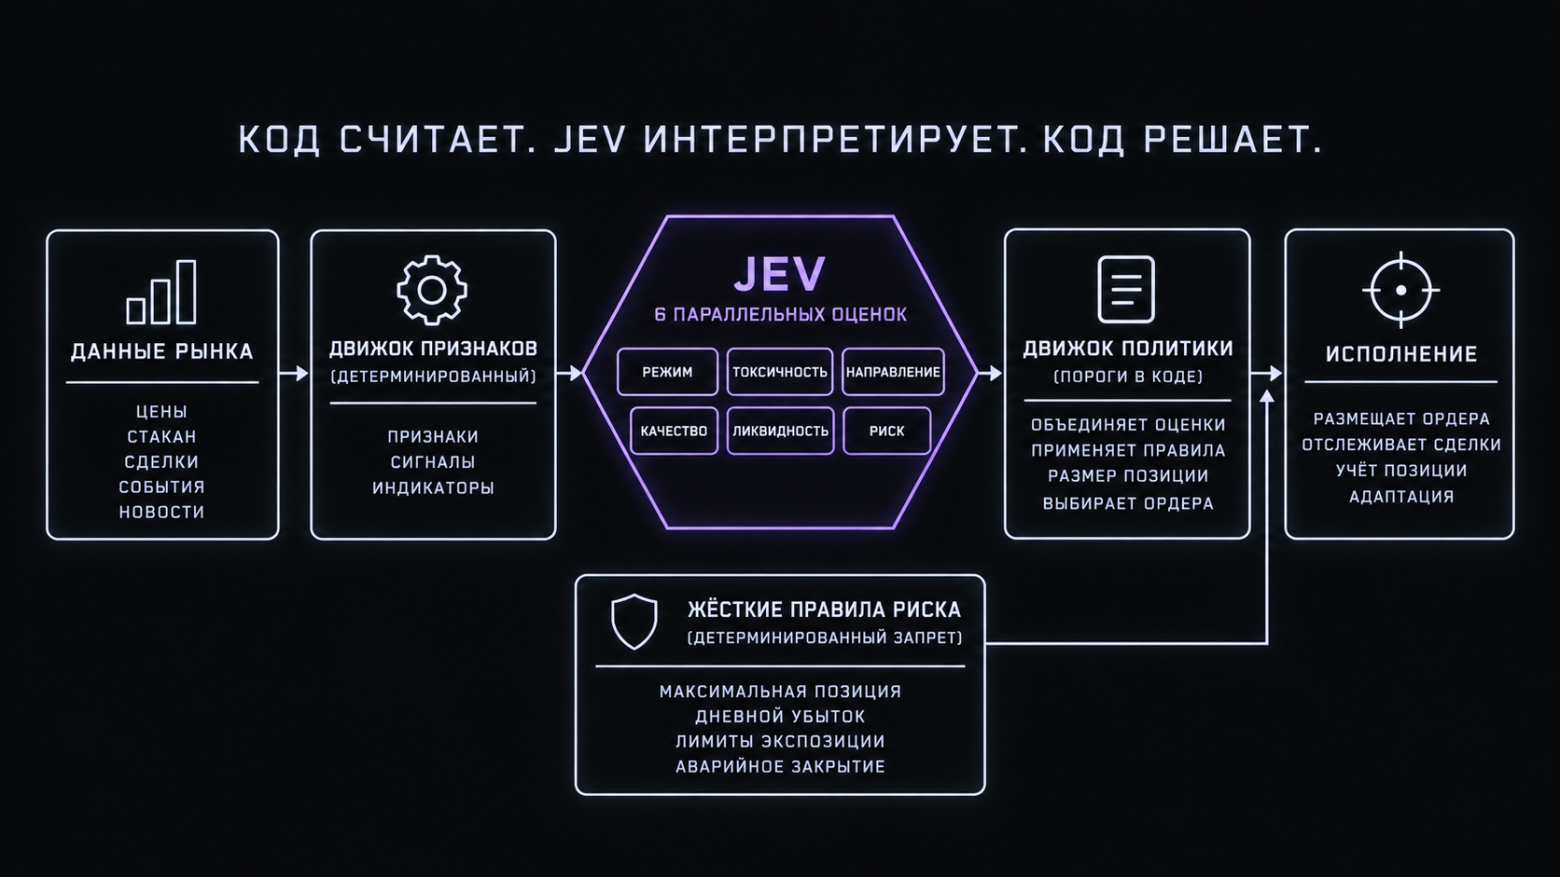
Слой жёстких ограничений всегда имеет последнее слово. Модель может подсказать действие, но не может отменить лимит позиции или аварийное отключение.
3. Настройка Jev с нуля
Ниже я следую официальному краткому руководству TypeSafe.
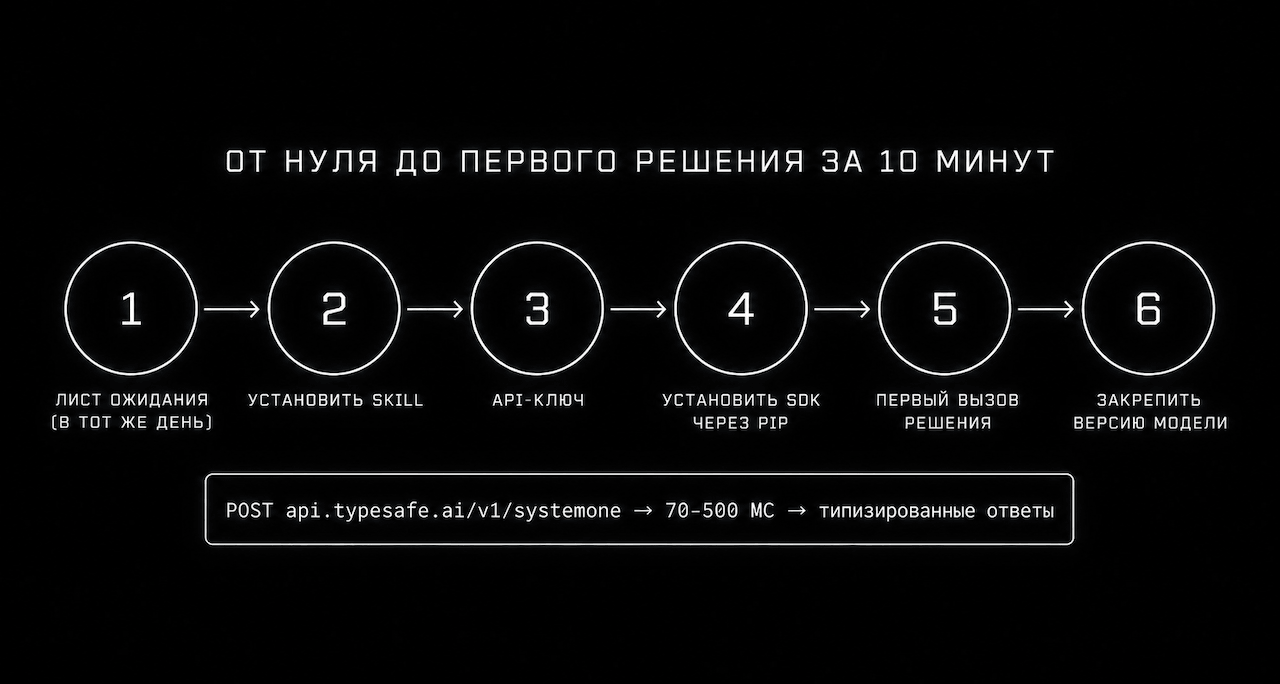
Шаг 1. Подать заявку
Запрос на доступ можно оставить на typesafe.ai. Отмечу, что некоторые пользователи получают доступ в тот же день.
Шаг 2. Установить официальный skill
Skill помогает агенту правильно вызывать Jev:
npx skills add typesafe-ai/skills --skill typesafe-aiВ Claude Code нужны две команды. Одного добавления marketplace недостаточно – требуется ещё установить плагин:
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
Шаг 3. Создать API-ключ
Ключ создаётся в панели TypeSafe. Затем его можно передать клиенту через переменную окружения:
export TYPESAFE_API_KEY="your-key"Шаг 4. Установить SDK
Для Python нужна версия 3.10 или новее:
# Python
pip install typesafe-sdk

# TypeScript
npm install @typesafe-ai/sdk

# Rust - для слоя исполнения
cargo add typesafe-ai-rs
В примере ниже строки с вопросами оставлены на английском, как в оригинале.
Шаг 5. Выполнить первый запрос
Клиент читает TYPESAFE_API_KEY и по умолчанию обращается к jev-latest:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()

state = {
    "mid": 3.4127,
    "spread_bps": 3.5,
    "imbalance": 0.71,
    "realized_vol_5m": 0.034,
    "inventory": -120,
    "aggressive_buy_ratio": 0.63,
}

response = client.system_one(
    state=state,
    questions={
        "regime": Choice(
            instructions="What market regime does this state describe?",
            criteria={
                "trending": None,
                "mean_reverting": None,
                "chaotic": None,
            },
        ),
        "toxic_flow": Noul(
            instructions="Is aggressive flow likely informed rather than noise?",
        ),
        "quote_environment": Score(
            instructions="How favorable is this state for providing liquidity?",
            legend={
                "0": "Do not quote",
                "1": "Marginal",
                "2": "Standard",
                "3": "Excellent",
            },
        ),
    },
)
Для HFT я рекомендую обращаться напрямую к API – через POST https://api.typesafe.ai/v1/systemone. Любой промежуточный шлюз добавляет сетевой переход, который может оказаться критичным при жёстком лимите задержки.
Также следует зафиксировать версию модели и записывать её вместе с каждым ответом. Пороговые значения уверенности подбираются под конкретную версию; незаметное обновление модели может нарушить их работу.
4. Снимок состояния и пакет параллельных оценок
Два ключевых компонента – движок состояния и пакет оценок. Движок состояния – это обычный детерминированный код. На каждом блоке он формирует компактный снимок объёмом менее 400 токенов.
В него можно включить:
-
Цена: mid, microprice и доходности за 1, 5 и 30 минут.
-
Стакан: спред в базисных пунктах, глубина на трёх уровнях, дисбаланс и позиция в очереди.
-
Поток ордеров: объём агрессивных покупок и продаж, частота сделок и отмен.
-
Волатильность: кратко- и среднесрочная реализованная волатильность, сравнение с 24-часовым режимом.
-
Другие площадки: расхождение с контрольной биржей, базис и фандинг.
-
Позиция: инвентарь, нереализованная прибыль или убыток (PnL), просадка и время удержания позиции.
-
Здоровье исполнения: доля исполненных ордеров, отказы, проскальзывание и последние десять значений задержки.
Я выделяю три правила:
-
Снимок должен быть плотным и числовым: за входные токены взимается плата.
-
Временные метки требуют особой дисциплины. Каждое поле должно учитывать только данные, доступные до момента принятия решения.
-
Нужно сохранять каждый снимок вместе с решением и последующим исходом. Эти записи станут данными для калибровки.
Один вопрос «покупать или продавать?» годится для демонстрации, но в рабочей системе я бы отправлял целый пакет оценок одним вызовом. По моей оценке, пакетирование даёт примерно 12-кратную экономию по сравнению с отдельными запросами:
response = client.system_one(
    state=snapshot,
    questions={
        "regime": Choice(
            instructions="Regime?",
            criteria={
                "trending": None,
                "mean_reverting": None,
                "high_vol": None,
                "crisis": None,
            },
        ),
        "direction": Choice(
            instructions="Bias next 10 blocks?",
            criteria={"up": None, "down": None, "neutral": None},
        ),
        "toxic_flow": Noul(
            instructions="Is aggressive flow informed?",
        ),
        "liquidity_stressed": Noul(
            instructions="Book thinner than 24h norm?",
        ),
        "quote_environment": Score(
            instructions="Favorable to provide liquidity?",
            legend={"0": "No", "1": "Marginal", "2": "Standard", "3": "Excellent"},
        ),
        "inventory_pressure": Score(
            instructions="Urgency to cut inventory?",
            legend={"0": "None", "1": "Mild", "2": "Skew hard", "3": "Reduce now"},
        ),
    },
)
Шесть оценок в одном запросе – одна задержка. Я оцениваю стоимость такого пакета примерно в $0,00001 на блок.
Затем код применяет пороги и выбирает действие. Условный пример:
def compose_action(ans, snap, limits):
    if snap["drawdown"] > limits.max_drawdown:
        return KILL

    if ans["toxic_flow"].noul > 0.6:
        return PULL_QUOTES

    if ans["liquidity_stressed"].noul > 0.7:
        return WIDEN

    quote = ans["quote_environment"]
    if quote.score >= 2.0 and quote.confidence > 0.80:
        skew = inventory_skew(ans["inventory_pressure"].score)
        return quote_both_sides(skew=skew)

    if quote.score >= 1.0:
        return quote_wide()

    return STAND_DOWN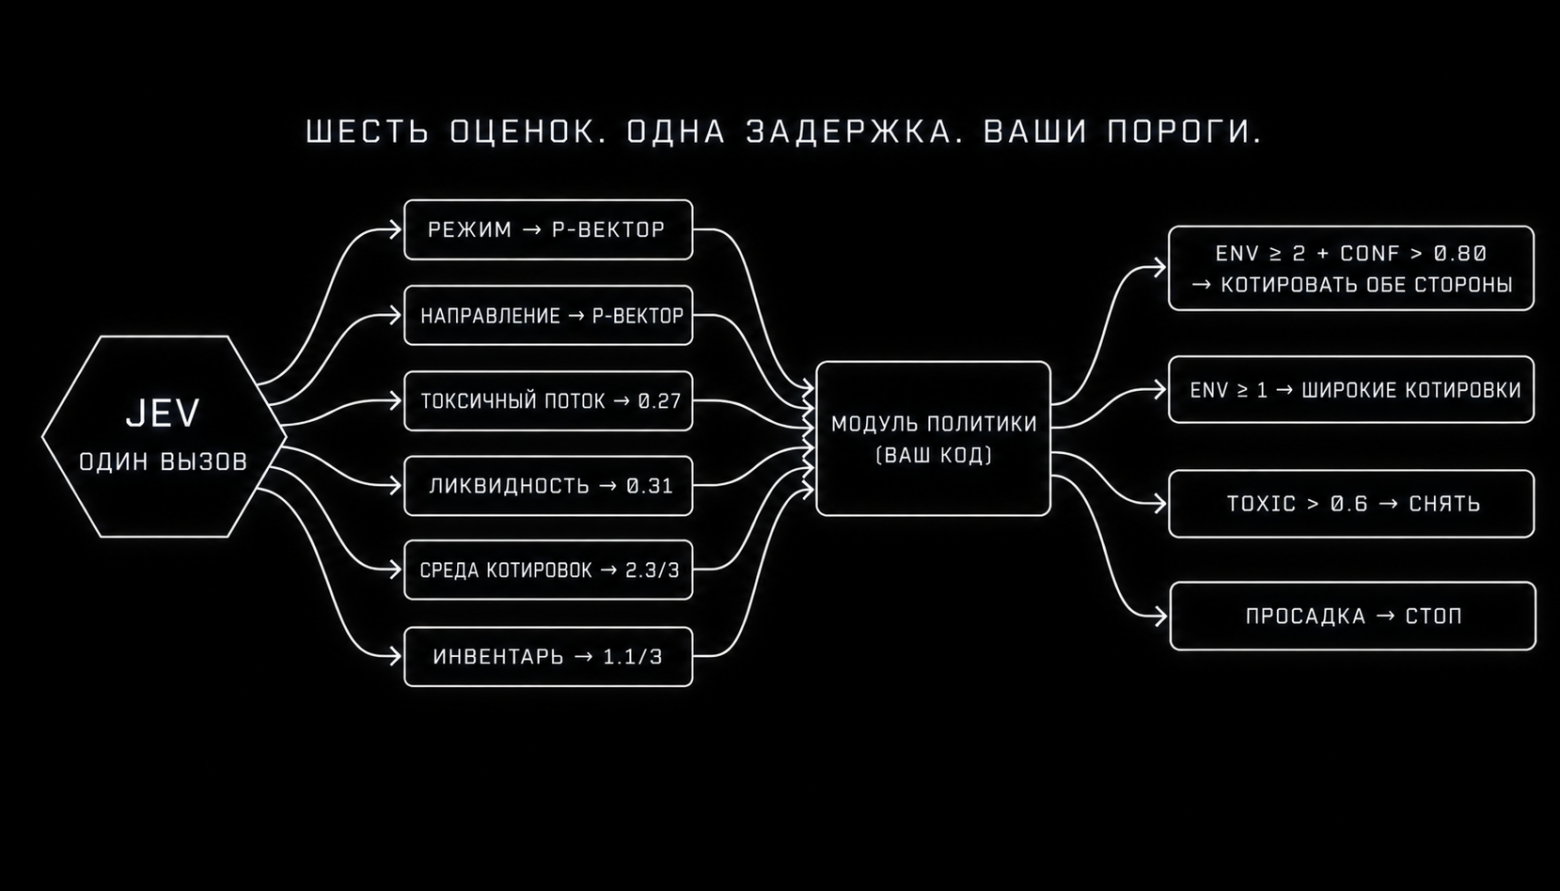
Здесь важны три принципа:
-
Пороги задаются в коде, а не поручаются модели.
-
Для разных действий можно установить разные пороги с учётом цены ошибки.
-
Дробный критерий Келли
(2p − 1), ограниченный четвертью, имеет смысл только при надёжно откалиброванной вероятностиp. На мой взгляд, применять его к логарифмам вероятностей от обычной LLM без калибровки бессмысленно.
5. Непрерывный цикл, риск-движок и аварийный режим
Теперь можно собрать цикл, который оправдывает круглосуточную работу.
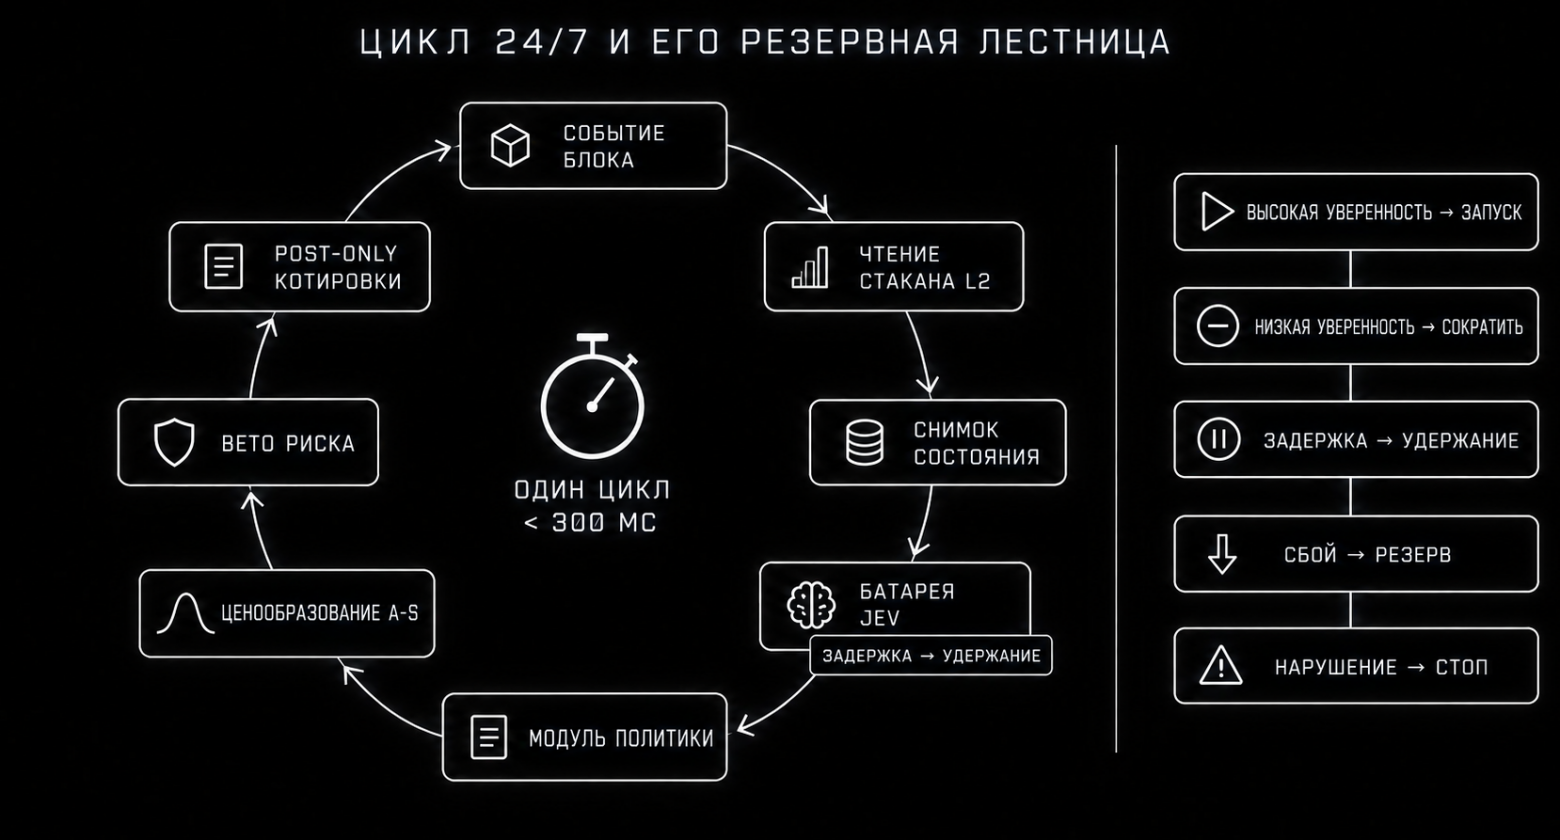
Основная математика маркет-мейкинга известна уже около полувека, поэтому её место – в детерминированном коде. На каждом блоке ценовой движок рассчитывает резервную цену и спред по модели Авелланеды-Стоикова:
резервная цена r = mid − inventory × γ × σ² × (T − t)
полуспред      = γ × σ² × (T − t) + (2 / γ) × ln(1 + γ / κ)
Jev отвечает только на вопрос, на который формула сама ответить не может: стоит ли вообще выставлять котировки в текущих условиях?
Полный цикл выглядит так:
-
Получить событие о новом блоке через WebSocket
newHeads; на случай сбоя оставить резервный опрос. -
Прочитать стакан второго уровня (L2): лучшие цены покупки и продажи, глубину.
-
Собрать детерминированный снимок состояния размером менее 400 токенов.
-
Одним вызовом получить пакет из шести оценок Jev.
-
Сформировать действие в движке политики.
-
Рассчитать резервную цену и спред по модели Авелланеды-Стоикова.
-
Проверить жёсткие ограничения риска. При нарушении любое действие отменяется.
-
Отменить старые котировки и выставить новые лимитные ордера, которые добавляют ликвидность.
-
Записать результат, учесть исполнения и PnL, обновить позицию и перейти к следующему блоку.
Каждый этап – отдельный модуль со своими условиями отказа. На стыках модулей ручная сборка часто превращается в долгую отладку, поэтому я заранее описываю и проверяю взаимодействие компонентов.
Два условия особенно важны:
-
Не торговать по устаревшему состоянию. Если Jev не вернулась до следующего блока, нужно пропустить цикл, а не отправлять котировку на основании старого снимка.
-
Заранее считать комиссии. В форке проекта
jevons critiqueприводится оценка, согласно которой наивная отмена и перевыставление ордеров на каждом блоке обходится примерно в 428 MON в час при спреде 3,5 базисного пункта. Системе придётся учитывать более широкий спред, более редкое перевыставление или реальное преимущество направленного сигнала. Я рекомендую повторить этот расчёт для своей сети и стратегии до размещения реальных ордеров.
Жёсткие лимиты риска
Риск-движок не должен делегировать ограничения Jev. Перед каждым ордером обычный код проверяет как минимум:
-
максимальный размер позиции и ордера;
-
дневной убыток и максимальную просадку;
-
максимальное время удержания инвентаря;
-
возраст рыночных данных;
-
плечо;
-
количество ошибок API;
-
максимальную задержку решения.
Каждый лимит должен проверяться независимо от заявления модели. Например, можно проверить, существует ли файл с результатом запуска или опустился ли показатель ниже заданного порога.
Резервный сценарий
Для непрерывной работы нужен заранее определённый план на случай задержки, низкой уверенности или недоступности модели:
|
Состояние |
Действие |
|
Система работает, уверенность высокая |
Штатная торговля |
|
Система работает, уверенность низкая |
Уменьшить размер позиции или воздержаться от входа |
|
Ответ не пришёл до следующего блока |
Пропустить цикл; не выставлять устаревшие котировки |
|
Jev недоступна |
Перейти на детерминированный резервный алгоритм |
|
Нарушен жёсткий лимит |
Остановить торговлю, закрыть позиции и отправить оповещение |
С таким планом систему можно считать автономной. Без него она работает лишь до первого сетевого сбоя.
Я бы рассматривал для частных разработчиков блокчейн-стаканы с частотой обновления на уровне блоков – Monad через Kuru, DEX-площадки Solana и Hyperliquid – а также рынки прогнозов с широкими спредами в 200–500 базисных пунктов. К микросекундной торговле крупнейших американских акций цикл в 300 мс отношения не имеет.
6. Калибровка и границы применимости
Проверять нужно не только то, угадала ли Jev направление цены, но и всю торговую политику целиком.
Я предлагаю сравнить четыре варианта на одинаковых данных, признаках, издержках и лимитах:
-
правила, написанные вручную;
-
система с передовой LLM;
-
система с Jev;
-
Jev с порогами уверенности, которые разрешают модели воздержаться от решения.
Для каждого варианта стоит измерить коэффициенты Шарпа и Сортино, максимальную просадку, долю успешных сделок, проскальзывание, потери от неблагоприятного отбора, стоимость миллиона решений и долю покрытых случаев.
Отдельный исследовательский вопрос – помогает ли фильтр уверенности: лучше ли результат у Jev, которая пропускает сомнительные ситуации, чем у Jev, обязанной отвечать на каждый запрос. Если модель откалибрована, такой фильтр должен улучшить качество портфеля.
Калибровку тоже нужно проверять. Если модель оценила вероятность роста в 80%, действительно ли события с такой оценкой происходят примерно в 80% случаев именно на вашей площадке? Для проверки сравнивают предсказанные вероятности с фактической частотой и считают Brier score, log loss и ожидаемую ошибку калибровки (Expected Calibration Error) по сохранённым тройкам «снимок – решение – исход».
RLCD калибрует ответы на данных TypeSafe, а не на ваших. Если кривая надёжности отклоняется от фактической частоты, я бы применил Platt scaling на уровне политики.
Что Jev умеет – и чего от неё ждать не стоит
Jev может:
-
возвращать типизированные решения с откалиброванными вероятностями за 70–500 мс;
-
оценивать десятки независимых вопросов параллельно с задержкой одного вопроса;
-
принимать до 255 вариантов ответа и контекст объёмом до 32 тысяч токенов;
-
работать в цикле блокчейна с интервалом 300 мс;
-
заменить часть нечётких правил, классификаторов, эвристических оценок и определителей режима рынка;
-
участвовать в расчёте доли Келли после проверки калибровки;
-
выполнять пакет оценок на каждом блоке за $10–25 в месяц – это моя оценка для указанной конфигурации, а не универсальная цена.
Jev не может:
-
генерировать текст или проектировать торговую стратегию;
-
за один вызов решать зависимые друг от друга вопросы: каждый оценивается отдельно, зависимость требует второго запроса;
-
конкурировать в микросекундной полосе;
-
заменить сбор рыночных данных, численные расчёты, подключение к бирже или жёсткие ограничения риска;
-
гарантировать результаты бенчмарка TypeSafe на вашей нагрузке;
-
превратить убыточную стратегию в прибыльную.
Jev может сделать отдельные решения быстрее и дешевле. Торговое преимущество всё равно нужно найти и подтвердить самостоятельно.
Заключение
Jev – не просто более умная языковая модель, а другой тип инструмента: движок решений, который возвращает структурированные оценки с вероятностями в пределах одного блокчейн-цикла.
Рабочая система не просит Jev «торговать». Она вычисляет всё вычислимое обычным кодом, отправляет компактный снимок рынка, получает набор атомарных оценок и пропускает каждое действие через пороги уверенности и жёсткие ограничения риска. Цену и спред рассчитывает детерминированный код; модель помогает оценить то, что трудно выразить формулой.
Я выбрал Jev не потому, что это самая новая модель на рынке. Я разделяю систему на детерминированные вычисления и вероятностные оценки, а затем проверяю, подходит ли калиброванная модель для второй части. Записи о решениях и их исходах нужны мне не только для аудита: по ним я проверяю калибровку и улучшаю систему.
Я предлагаю разработчику ответить на такой вопрос: ждать несколько секунд текстового ответа от чат-модели или задавать шесть типизированных вопросов и получать оценки до следующего блока?
Автор: quant_develop3r

