


Cortiq Mobile — приложение для Android и iOS (пока нет в Appstore, проходит проверку) с открытым кодом, которое запускает модели формата CMF прямо на телефоне. Сейчас производительность телефонов в некоторых случаях превышает производительность ПК поэтому небольшие LLM модели вполне можно использовать для работы. В самолёте без сети оно отвечает на вопрос, переводит письмо и разбирает текстовый файл. Дома, в доверенной сети, тот же телефон отдаёт ноутбуку локальный API или возвращает программе структурированное решение вместо чат-реплики. Актуально использовать в странах с ограничениями связи! ;-). Можно заранее подготовить список актуальных моделей для локального запуска.
Приложение умеет три вещи и каждую проверил на реальных устройствах:
-
отвечать в чате и читать ваши документы — офлайн;
-
переводить письма и сообщения — офлайн;
-
принимать решения для ваших программ — отдавать не текст, а готовое решения (аналог Jev)
А дома тот же телефон может стать локальным AI-сервером для ноутбука.
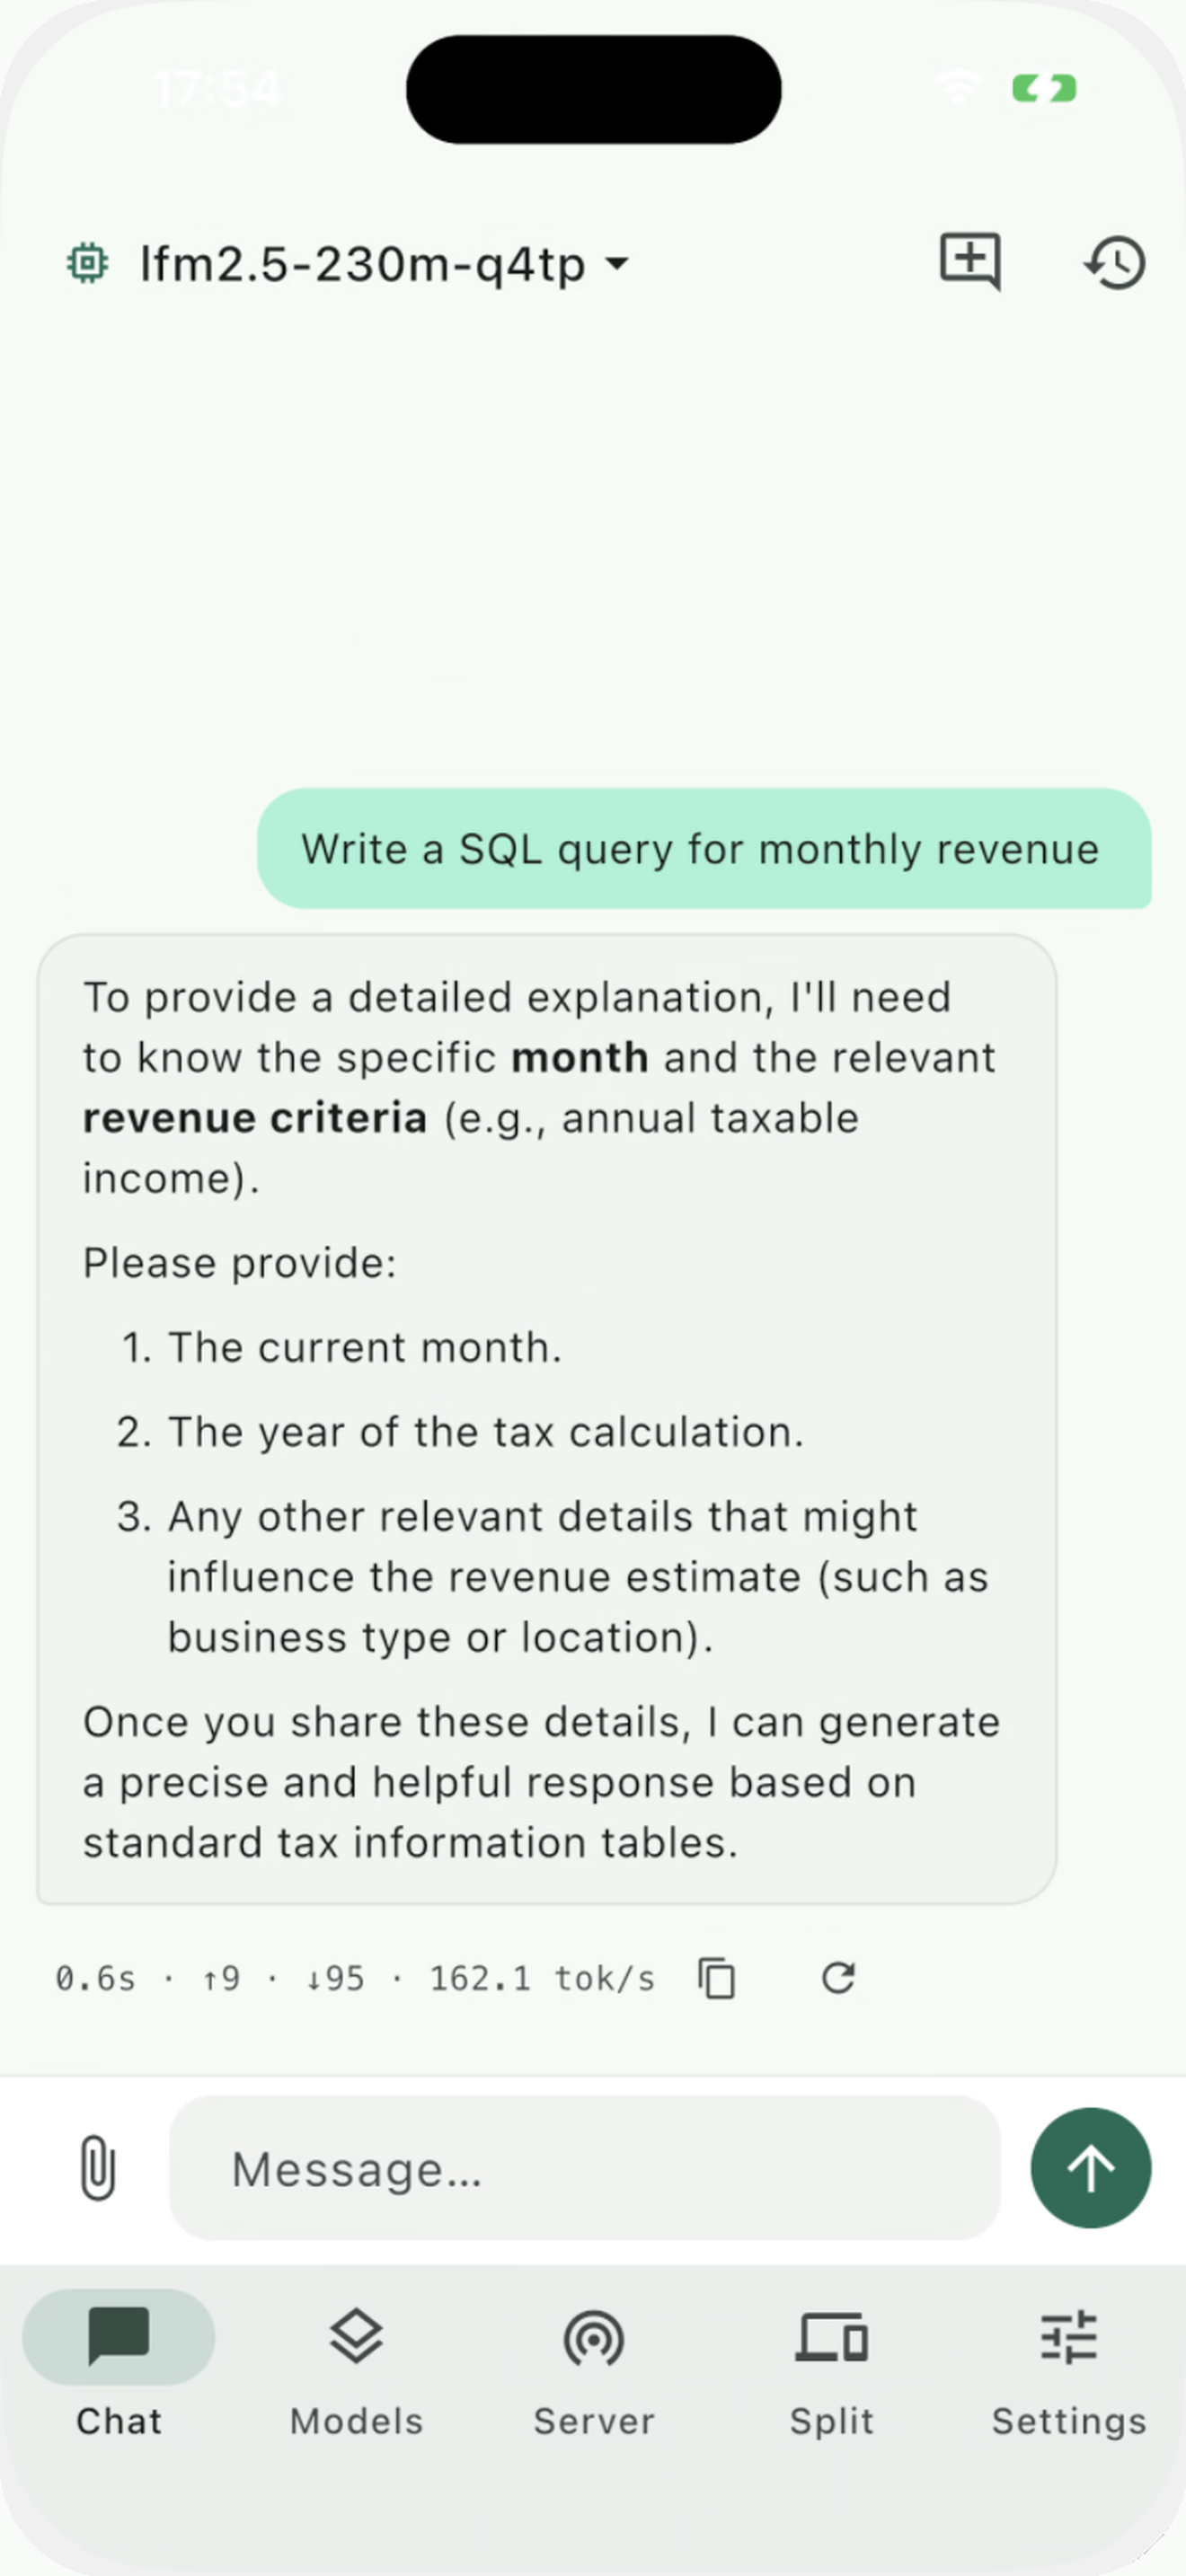
Тот самый экран: модель lfm2.5-230m-q4tp, 95 токенов ответа, 0,6 секунды, 162,1 tok/s.
Приложение: Google Play · исходный код 1.3.0: infosave2007/cmfmobile · страница со скриншотами: Hugging Face Space
Замеры на iPhone сделаны на сборке TestFlight 1.3.0 (47); все исходные данные открыты по ссылкам в конце.
145 токенов в секунду: как мы это измерили
Мы не любим цифры без контекста, поэтому вот он целиком.
Телефон — iPhone 16 (A18). Модель — lfm2.5-230m-q4tp: компактная LFM2.5 на 230 миллионов параметров, 14 слоёв, файл весит всего 126 MiB. Работает на CPU, пять потоков, GPU даже не понадобился. Параметры генерации: temperature: 0.10, top_p: 0.95, max_tokens: 128.
Почему это работает без облака
Секрет — в формате файла. Модели для Cortiq упакованы в CMF (Cortiq Model Format): один файл, внутри которого не только веса, но и архитектура, токенизатор, описание задач и шаблон чата. Файл сам рассказывает о себе. Поэтому приложение ещё до загрузки знает, сколько у модели слоёв, какой контекст и сколько памяти ей нужно, — и показывает это прямо в библиотеке.
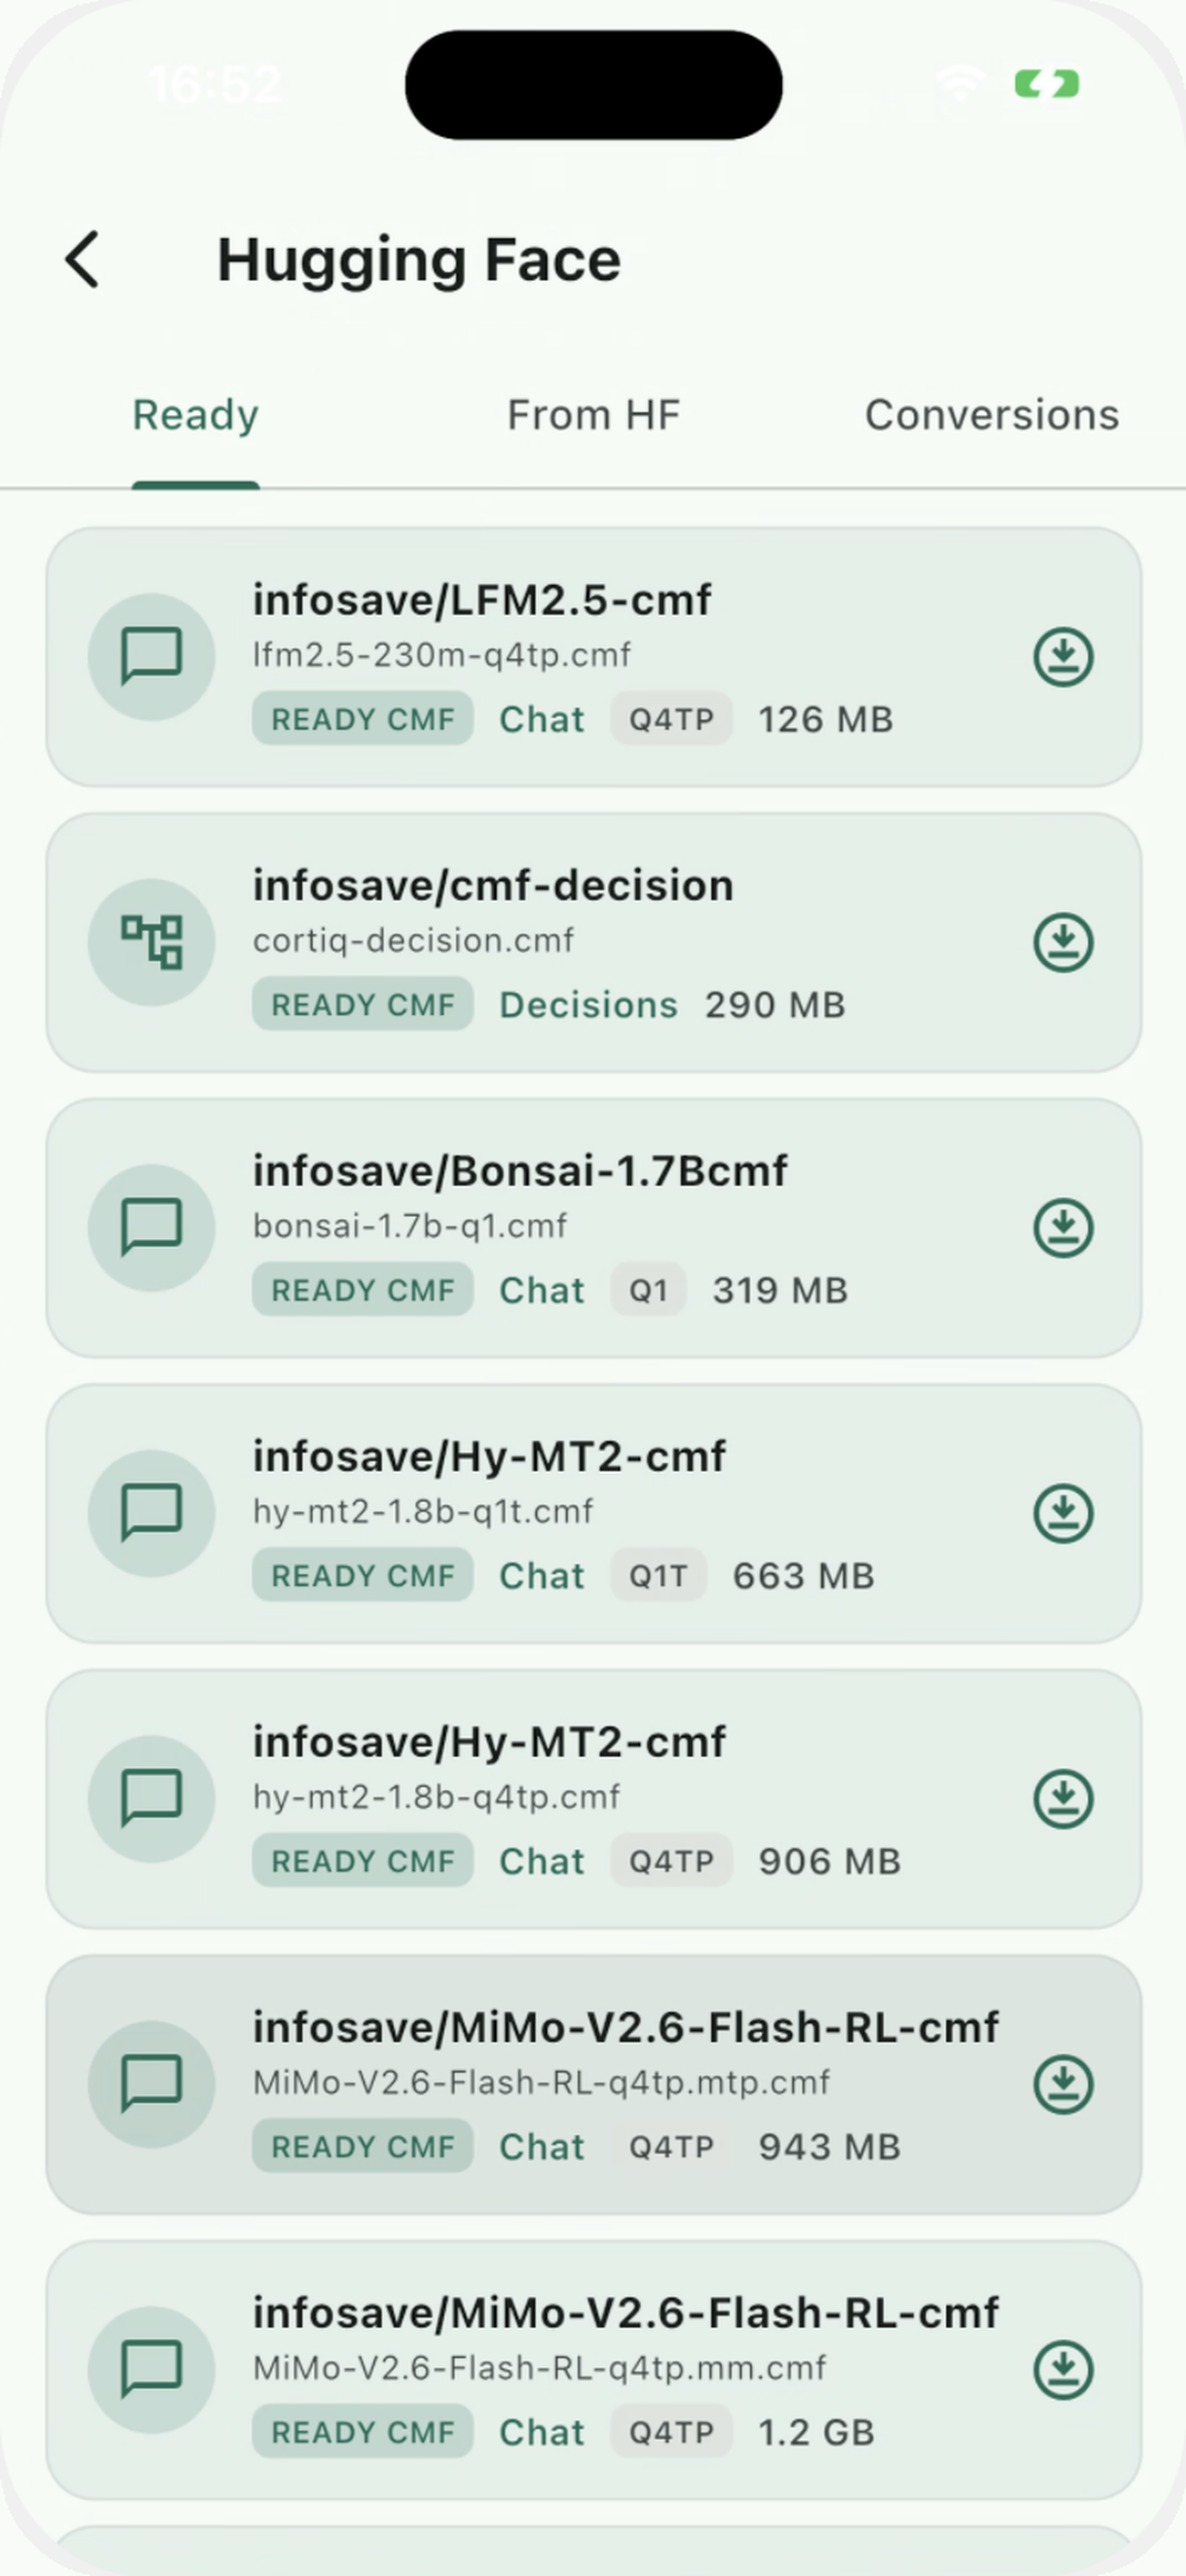
Каталог готовых моделей прямо в приложении. У каждого файла видно, что это: Chat или Decisions.
Взять модель можно тремя способами. Проще всего — выбрать готовый .cmf из каталога: он скачивается в один тап, а если сеть оборвётся, докачка продолжится с последнего байта. Можно взять любой подходящий репозиторий с Hugging Face в формате safetensors — приложение сконвертирует его в CMF прямо на телефоне. А модель в GGUF переводится в CMF настольной утилитой cortiq import-gguf и импортируется готовым файлом.
Тот же формат читает движок Cortiq на компьютерах. Одна модель — на всех устройствах.
Чат, который читает ваши файлы
Чат в Cortiq — это не окошко с одной строкой. Каждый диалог хранится как отдельная тема со своим контекстом, ответы приходят потоком, под каждым — время, число токенов и tok/s. Можно прикрепить документ: txt, md, код, JSON — до 512 KiB текста. Файл становится частью разговора, и модель отвечает по нему. Для этого подходит любая чат-модель с шаблоном чата и контекстом от 2048 токенов. Всё происходит на телефоне, файл никуда не уходит.
Перевести письмо без Google
Для перевода чат-модель не нужна. В каталоге есть Hy-MT2 — специализированная модель на 1,8 миллиарда параметров, которая умеет только переводить и делает это отлично. Дал ей на iPhone семь заданий: русский на английский и обратно, немецкий, турецкий и китайский на русский, идиому и кусок JSON с английского на немецкий.
RU → EN
«Посылка прибудет завтра после 15:00. Пожалуйста, позвоните перед доставкой.»
→ “The package will arrive tomorrow after 15:00. Please call before delivery.”
Все семь переводов вернулись целиком, модель сама завершила каждый ответ (finish_reason: stop). JSON пережил перевод без потерь: ключи, число count и плейсхолдеры {user_name} / {order_id} остались на месте. Короткая фраза занимала 1–2 секунды (0,996–2,015 с) с учётом дороги по Wi-Fi от ноутбука до телефона и обратно; сам движок выдавал 14,4–21,8 tok/s, в среднем 17,75.
Файлов два — выбирайте между размером и качеством:
|
Файл |
Размер |
Бит на вес |
Перплексия (меньше — лучше) |
Когда брать |
|---|---|---|---|---|
|
|
950,5 MB |
4,17 |
14,02 |
Основной вариант для перевода |
|
|
694,9 MB |
2,25 |
27,88 |
Когда важен каждый мегабайт |
Все семь исходников, ответы и времена — в отчёте и JSON.
Телефон как сервер для ноутбука
Дома телефон может работать на ноутбук. Открываете вкладку «Сервер», включаете защиту токеном, нажимаете «Запустить» — и на экране появляется QR-код с адресом. Теперь любая программа в вашей сети, умеющая говорить с OpenAI-совместимым API, может говорить с телефоном: POST /v1/chat/completions, POST /v1/completions, GET /v1/models. Запросы видны в журнале прямо в приложении.
Загрузили чат-модель — ноутбук получает чат. Загрузили переводчик — получает переводчик. А если загрузить модель решений, API меняется целиком. О нём — отдельно, потому что это самое интересное.
Решения вместо болтовни
Представьте бота поддержки банка. Приходит сообщение: «Where is my card?» Обычная языковая модель напишет вежливый абзац, из которого вашему коду потом придётся регулярками выковыривать, что же клиент хотел. Модель решений поступает иначе. Она не пишет ни слова. Она отвечает:
{"accepted": true, "choice": "card_arrival", "confidence": 0.998}
Это запрос о доставке карты, уверенность 99,8 %, можно действовать. А если модель не уверена, она честно скажет «не знаю»: accepted: false, choice: null. Для вашего кода это не ошибка, а чистый сигнал: отдай задачу человеку. Никакого угадывания по тексту.
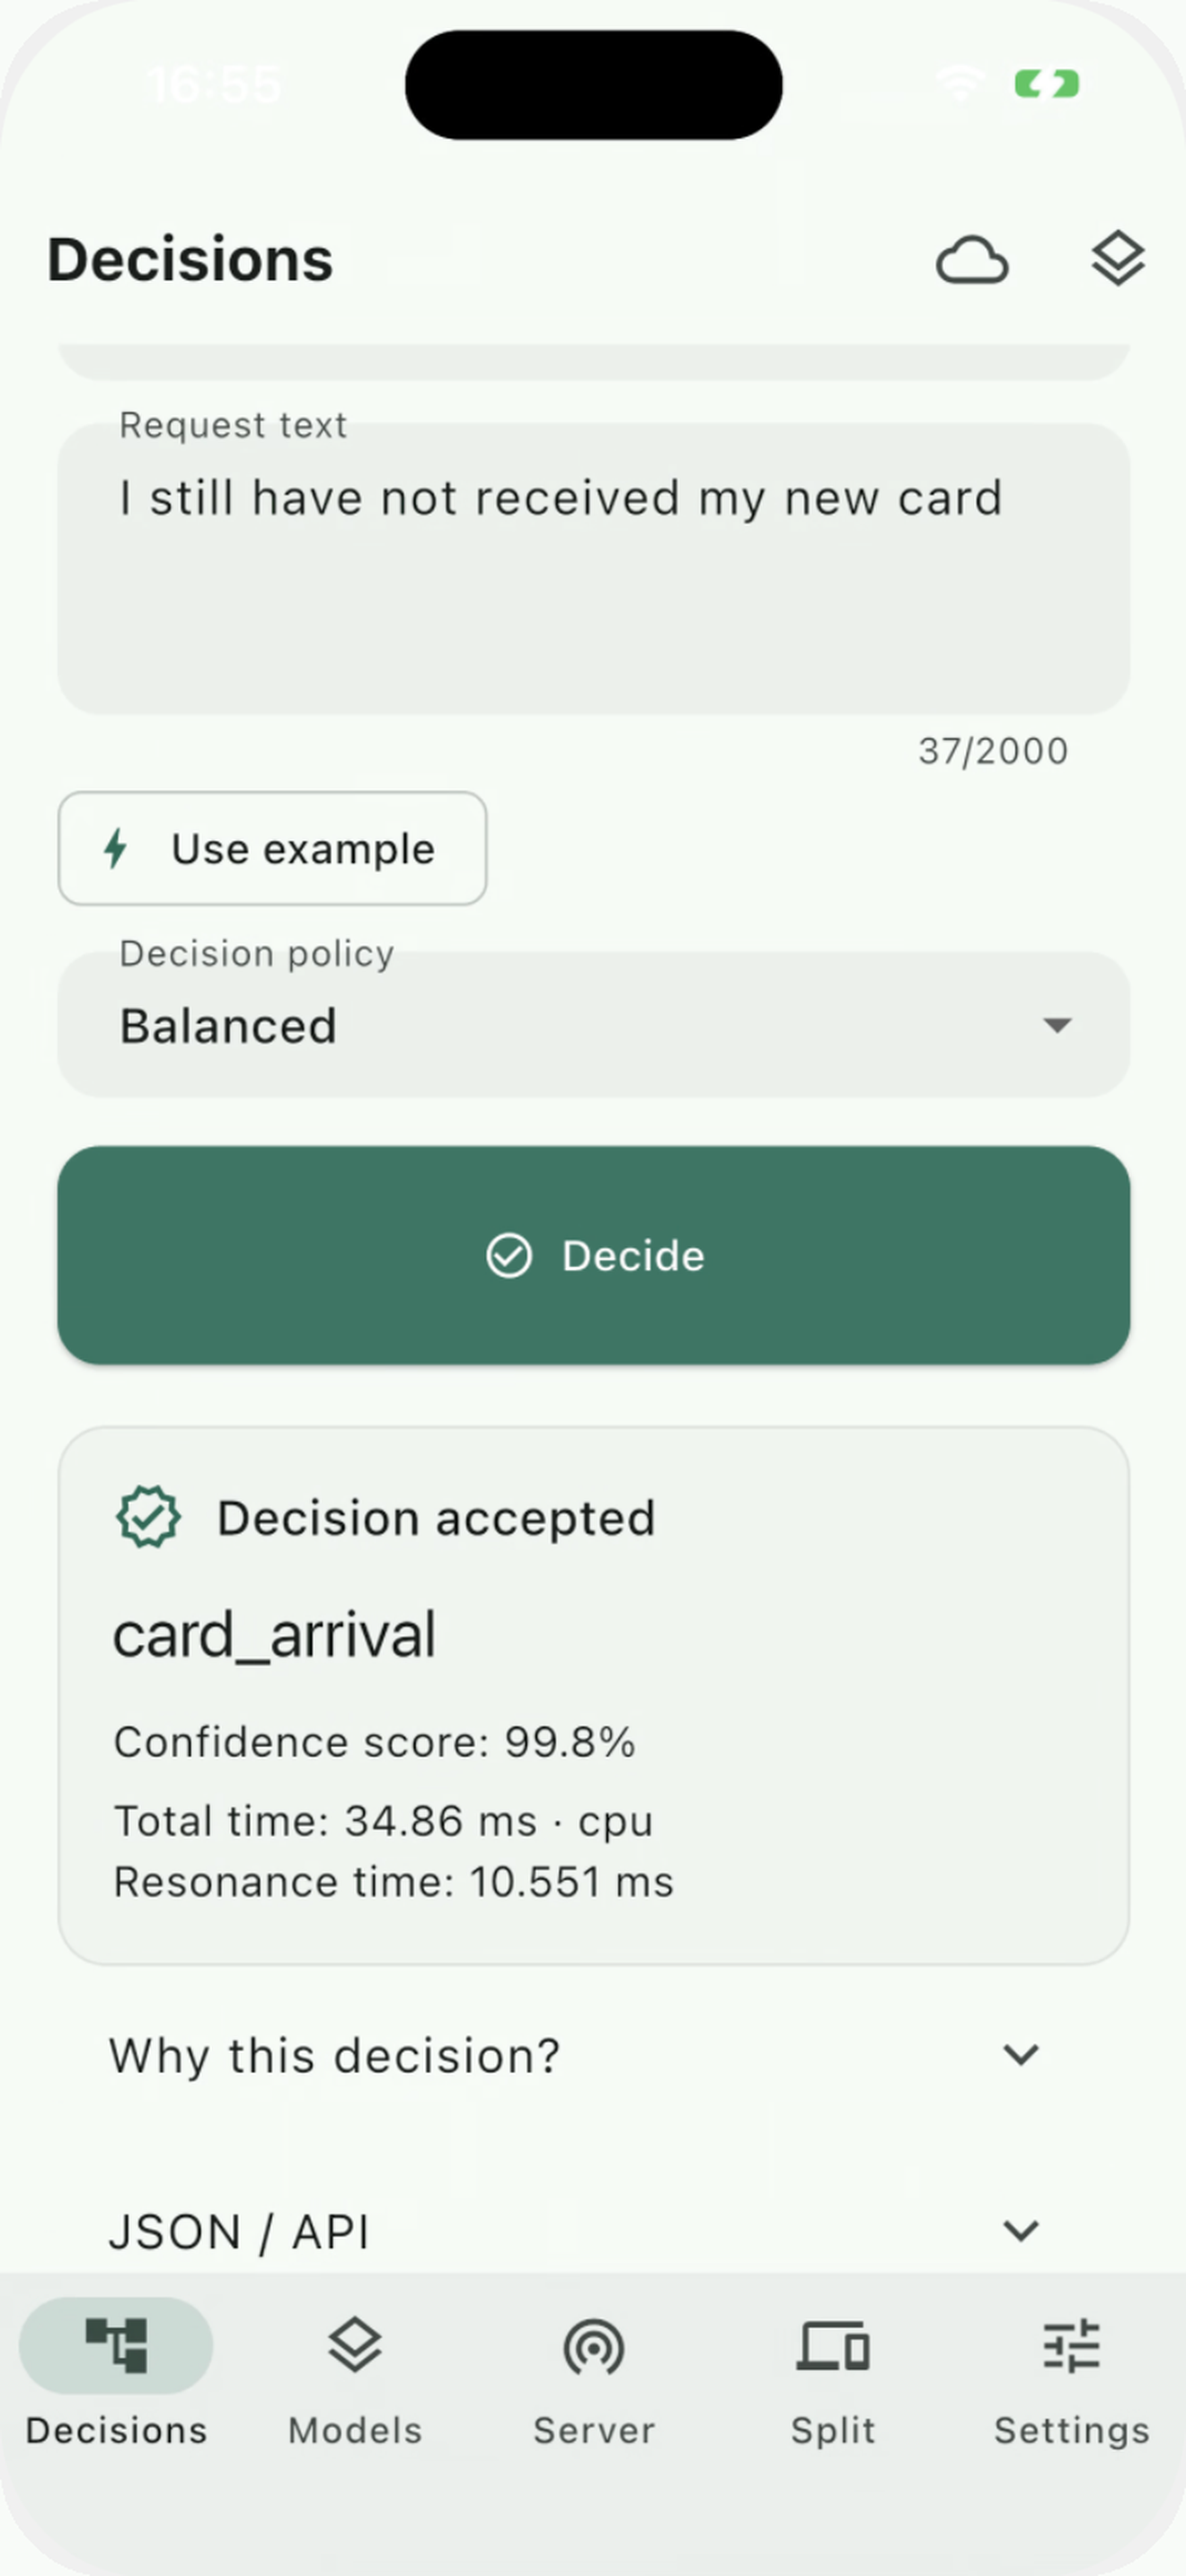
Решение принято на iPhone, без сети. Внизу — уверенность и время ответа.
Технически это модель формата CMF Decision. У неё есть навыки — наборы меток, например банковские запросы (BANKING77), бытовые команды (CLINC150, MASSIVE). Для каждого навыка модель оценивает, какая метка лучше всего описывает ваш текст, и выбирает её. Снаружи это один запрос:
# PHONE_TOKEN задайте локально; не храните его в исходниках.
curl "http://PHONE_IP:8080/v1/decide"
  -H "Authorization: Bearer $PHONE_TOKEN"
  -H 'Content-Type: application/json'
  -d '{"skill":"banking77","text":"Where is my card?","profile":"balanced"}'
Поле profile задаёт характер: balanced, quality-first или cost-saver. Список навыков и их описания отдаёт GET /v1/skills, для сценариев с несколькими вопросами есть типизированный POST /v1/decisions. Одно правило для кода: действовать при accepted: true и непустом choice.
Выдержит ли телефон несколько клиентов? Проверили на Xiaomi с Android 14 по настоящему Wi-Fi. Все 22 проверки контракта прошли, включая правильные коды ошибок — 400, 401, 404, 409. Под нагрузкой:
|
Клиентов одновременно |
Запросов |
Успешных решений в секунду |
Задержка p50 / p95 |
|---|---|---|---|
|
1 |
180 |
13,6 |
63 / 137 мс |
|
4 |
128 |
27,4 |
135 / 209 мс |
|
16 |
128 |
25,9* |
309 / 361 мс* |
* При 16 клиентах телефон обработал 22 запроса, а остальным 106 сразу ответил 429 «подождите» — очередь не разрастается, сервер остаётся отзывчивым. Для интеграций оптимально 1–4 клиента. Полный протокол — в репозитории.
Приватность по умолчанию
Cortiq спроектирован так, что ваши данные остаются у вас. Чат, перевод и решения считаются на телефоне. Интернет нужен только для скачивания модели. Два сетевых режима включаются вручную и только вами: Компаньон — телефон делит модель с вашим компьютером, чтобы запускать модели больше собственной памяти, и Оракул — возможность при отказе локальной модели спросить внешний HTTPS-провайдер с вашим собственным ключом. Оракул выключен по умолчанию, каждый запрос к нему требует подтверждения, а ключ лежит в защищённом хранилище телефона и недоступен через API.
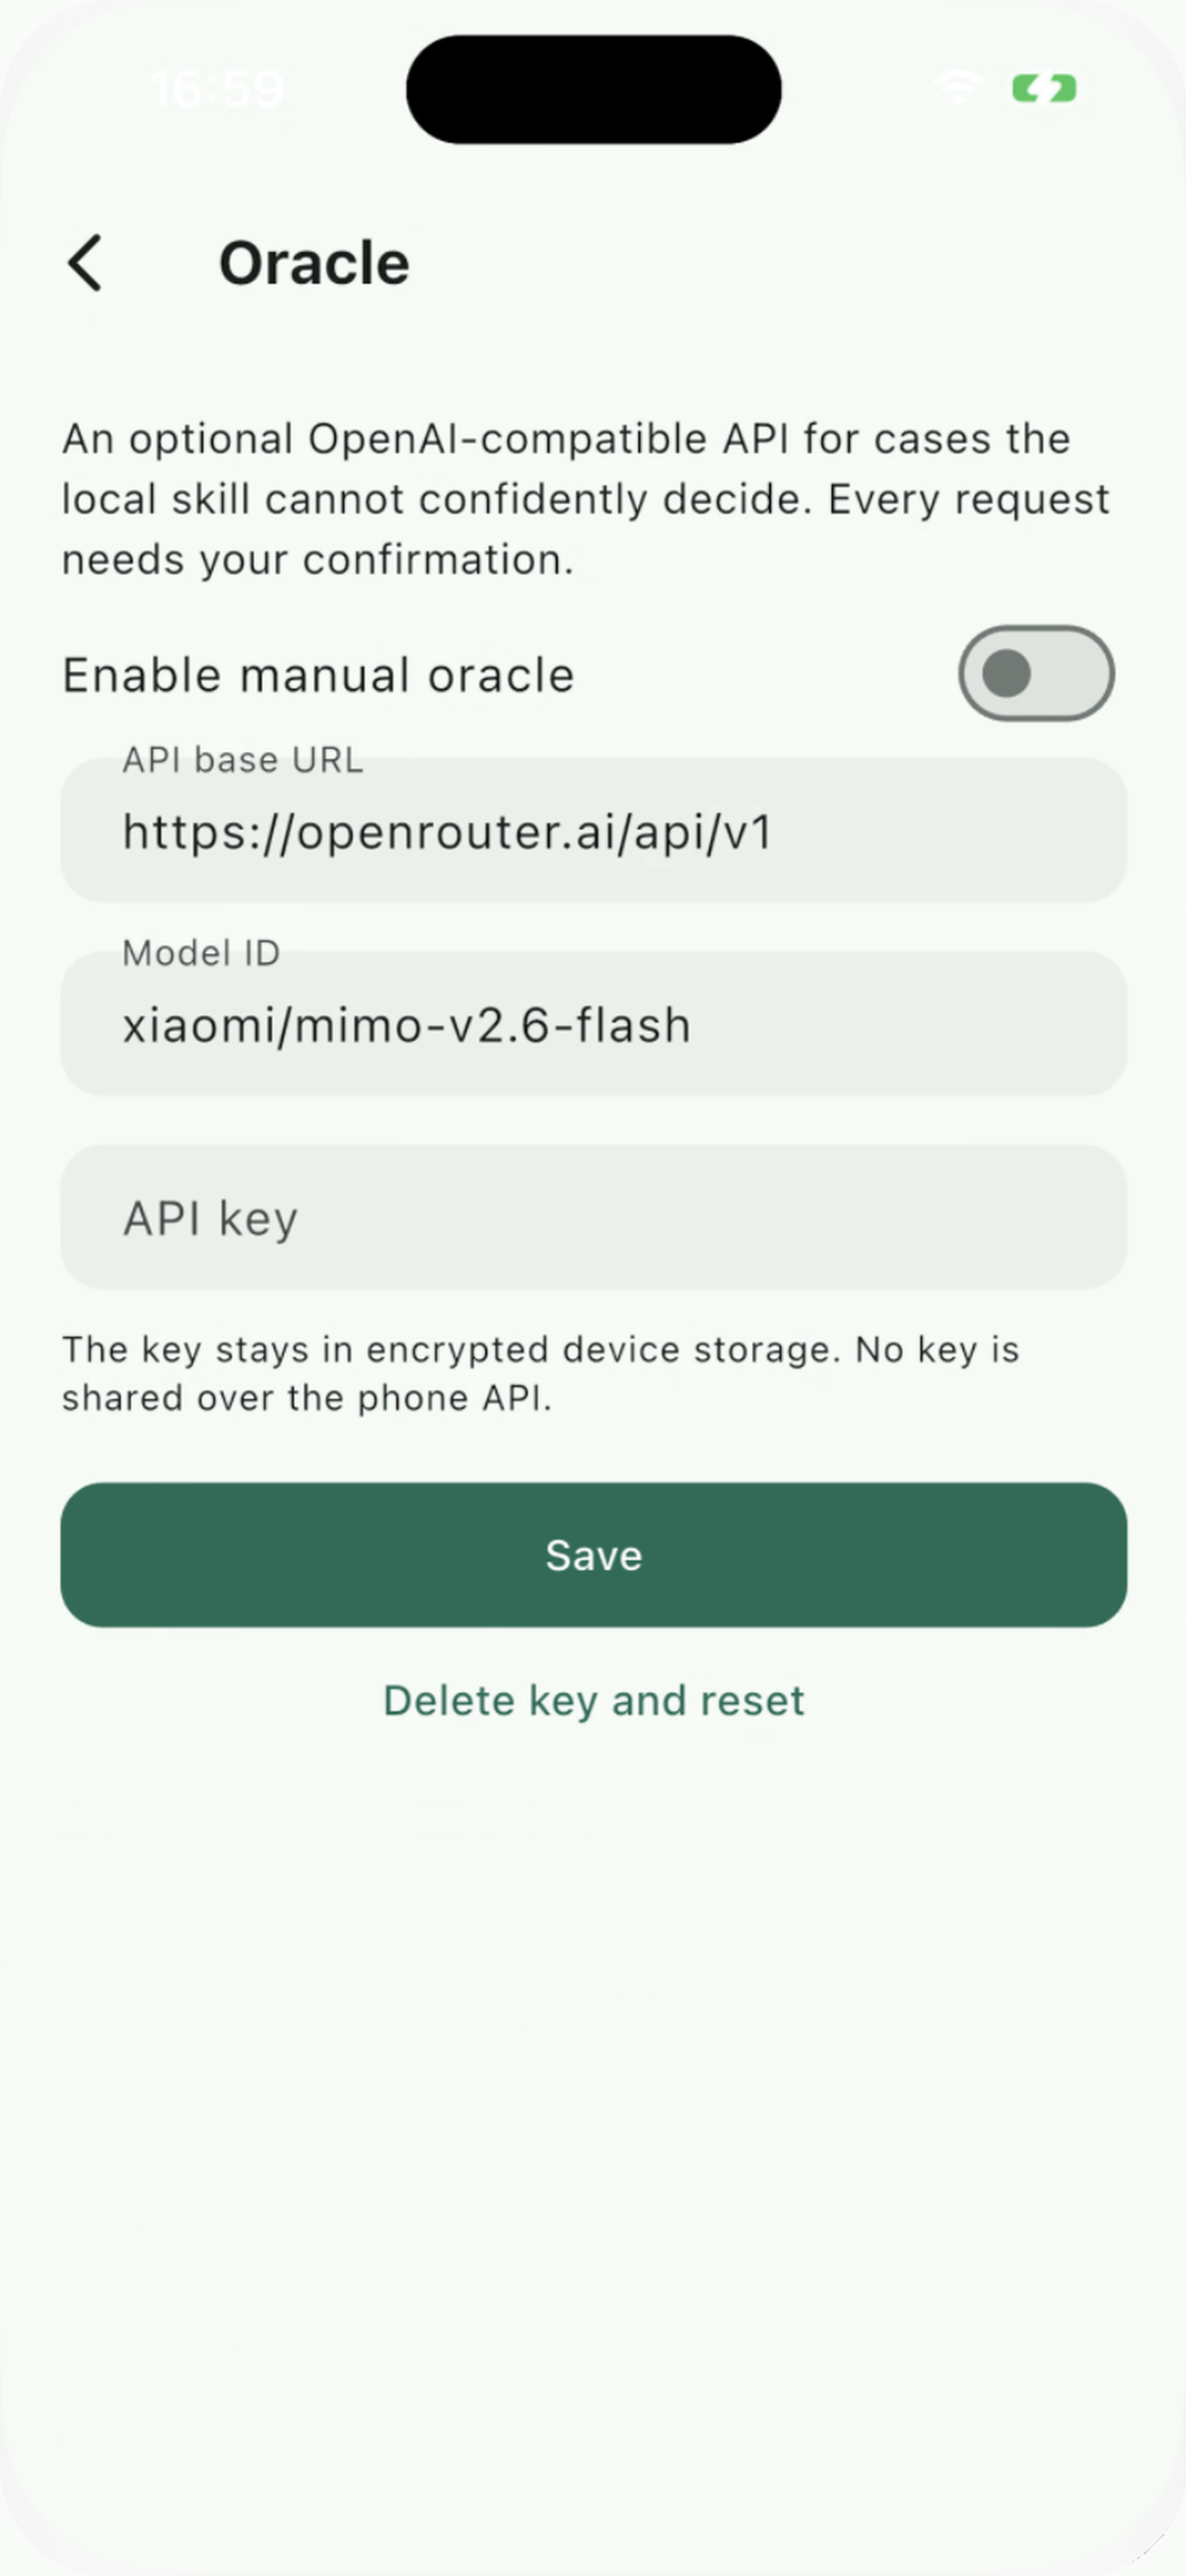
Оракул выключен по умолчанию и включается только вручную.
Локальный сервер рассчитан на домашнюю сеть: включайте bearer-токен перед запуском и не выставляйте адрес телефона в интернет.
Попробовать за пять минут
-
Поставьте приложение: Android — из Google Play, iPhone — через TestFlight (можно написать автору и я добавлю email для тестирования).
-
Модели → Hugging Face → Готовые. Для чата возьмите
lfm2.5-230m-q4tp, для перевода —hy-mt2-1.8b-q4tp.cmf, для решений —infosave/cmf-decision. Нажмите «Скачать», потом «Загрузить в движок». -
Откройте чат и спросите что угодно. Под ответом появятся время, число токенов и tok/s — сравните с нашими.
-
Хотите сервер — вкладка «Сервер», «Требовать bearer-токен», «Запустить сервер», отсканируйте QR-код с ноутбука.
Ссылки и методика
Автор: infosave


