


Если вы делаете поиск по документам, можно ли отвечать только словами из источника и отказываться, когда ответа нет? В ELM я проверил этот способ без дообучения. При заданном абзаце выбор цитаты дал близкий к генерации общий счёт на моей выборке. Если абзац надо найти, результат зависит от поиска и последующего выбора строки судьёй.
Отделить поиск от формулирования ответа
Я собрал систему, где документы хранятся на диске, код находит подходящие фрагменты, а нейросеть-судья выбирает и проверяет строку. Все найденные кандидаты я называю пулом; фрагменты, показанные судье, — окном. Судье доступны только три операции: выбрать вариант, ответить «да» или «нет» либо дать оценку. Ответ судья не пишет: в основном режиме пользователь получает дословную цитату с источником либо отказ.
Поиск определяет, какие доказательства увидит судья, а судья решает, подходят ли они. Локальная генеративная модель предлагает запросы или гипотезы; они проходят выбор и проверку и не становятся ответом. В финальном прогоне генератор понадобился на 4 вопросах из 150.
Гарантия касается фраз: ошибочный факт из источника система может процитировать.
Найти место потери нужной строки
Первая версия: Simple Wikipedia в базе SQLite, поиск по словам FTS5, окно строк, один выбор судьи и три проверки. На 150 отладочных вопросах Natural Questions вышло 20.0% строго верных и 60.0% отказов. Строгая метрика проверяет дословное наличие эталона в ответе.
Я измерил охват: эталон доходил до окна судьи только в 42.7% случаев. Большинство вопросов нельзя было решить выбором из этого окна.
После перехода на полный корпус psgs_w100 из 21 015 324 абзацев выдача стала хуже: редкие слова встречались в разных местах. Запрос со всеми редкими словами и старым запросом как страховкой дал 33.3%. После гипотез для поиска и исправления потерянных обращений база достигла 37.3%.
Дальше я взял готовый поиск по близости смысла: FAISS-индекс facebook/wiki_dpr. Он поднял охват окна до 82.0%. У словарного поиска по тому же корпусу охват окна был 56.0%. Строго верных стало 69/150 вместо 56/150, то есть 46.0% вместо 37.3%. Парный тест Макнемара: несовпадающие пары 22/9, p=0.029.
Прирост дал чужой индекс: кодировщик текста DPR обучался на train-части NQ, хотя я ничего не дообучал. Пик памяти на моей стороне вырос с 47.7 МБ до 4149 МБ. Плотный поиск уже не относится к профилю «малая память».
Судья не найдёт ответ среди строк, в которых его нет. Источник мема: Pinterest.
Проверить выбор и штатный отказ
После поиска по смыслу потери сместились к выбору: нужная строка доходила до судьи, но тот выбирал другую. Я отдельно проверял наличие ответа среди кандидатов, попадание в окно и правильность выбора. Мягкая метрика — проверка судьёй, допускающая равнозначный ответ, а не только дословное совпадение.
Семь способов изменить выбор не дали значимого прироста. Турнир по восемь строк дал 73 строго верных вместо 69, p=0.454; по мягкой метрике 85 против 85, p=1.000. Обращений стало 28.5 вместо 4.5 на вопрос. Проверки шли на отладочных данных, каждая против своей базы.
Порог уверенности тоже не помог: лучший срез убирал 6 неверных ответов, теряя 4 верных. Медианный отрыв выбранного варианта у неверных ответов был даже выше: 0.15 против 0.055 у верных.
Повторные проверки стали режимом строгости. На 150 отладочных вопросах ответов невпопад стало 30 вместо 40, пары 13/3, p=0.021. Верных стало 64 вместо 69, p=0.359, отказов 37.3% вместо 27.3%. Рост качества не подтверждён.
Сравнить системы на отложенных вопросах
Пороги я выбрал на отладочных половинах данных. На каждой отложенной половине финальную конфигурацию запустил один раз. Все системы проверял одним скриптом и одним оценщиком. В мягкой метрике ответ с эталоном сверяет тот же судья, который выбирает ответы ELM, поэтому рядом нужна строгая метрика.
BoolQ, SQuAD 2.0 и NQ: по 150 вопросов; LongBench v2: 30. Две строки SQuAD относятся к соответствующим подгруппам. На графике показаны 95% интервалы Уилсона; для сравнений использованы парные тесты. Малые выборки не дают точной оценки общего качества. Название «Claude Opus 5» сохранено из исходного отчёта; паспорт версии в использованных материалах не приведён. Это обозначение экспериментальной ячейки, а не подтверждение актуального продукта.
|
Что измерено |
ELM |
Claude Opus 5 |
DeepSeek |
|---|---|---|---|
|
BoolQ, абзац дан |
90.0% |
90.0% |
84.7%; без абзаца 68.0% |
|
SQuAD 2.0, абзац дан |
79.3% |
80.0% |
80.0% |
|
На отвечаемых вопросах |
78.8% |
96.2% |
86.2% |
|
Молчание на безответных |
80.0% |
61.4% |
72.9% |
|
NQ open, мягкая метрика |
56.7% |
74.0% |
60.0% |
|
NQ, ответов невпопад |
16.0% |
20.7% |
27.3% |
|
LongBench v2, отложенная выборка, окно 40 строк |
50.0% |
Не измерено |
— |
|
LongBench v2, отладочная выборка (dev), окно 40 строк |
43.3% |
76.7% |
— |
|
Цена 1000 вопросов BoolQ, USD |
0.0185 |
9.73 |
0.0396 |
|
Цена 1000 вопросов NQ, USD |
0.95 |
7.31 |
0.017 |
Остальные результаты в таблице — на отложенных выборках. Для LongBench отладочный и отложенный срезы показаны отдельно; результат одного среза нельзя сравнивать с результатом другого.
В BoolQ счёт ELM и Opus совпал, p=1.000. В SQuAD различие также незначимо, p=1.000. На отвечаемых вопросах Opus впереди; общий счёт выравнивается за счёт правильных отказов ELM.
В NQ строгие результаты: 49.3% у ELM, 62.0% у Opus, 47.3% у DeepSeek. У ELM 27.3% отказов. Парно качество с DeepSeek неразличимо, p=0.775, Opus значимо лучше, p=0.011. Зато ответов невпопад у ELM 24/150 против 41/150 у DeepSeek, p=0.0060.
В LongBench ELM ответил верно на 15/30 вопросов при одном обращении. Медиана окна 3926 токенов, документа 72 758, максимум 1 719 190. Отложенный результат нельзя сравнивать с 76.7% Opus на dev. На dev у ELM было 43.3%.
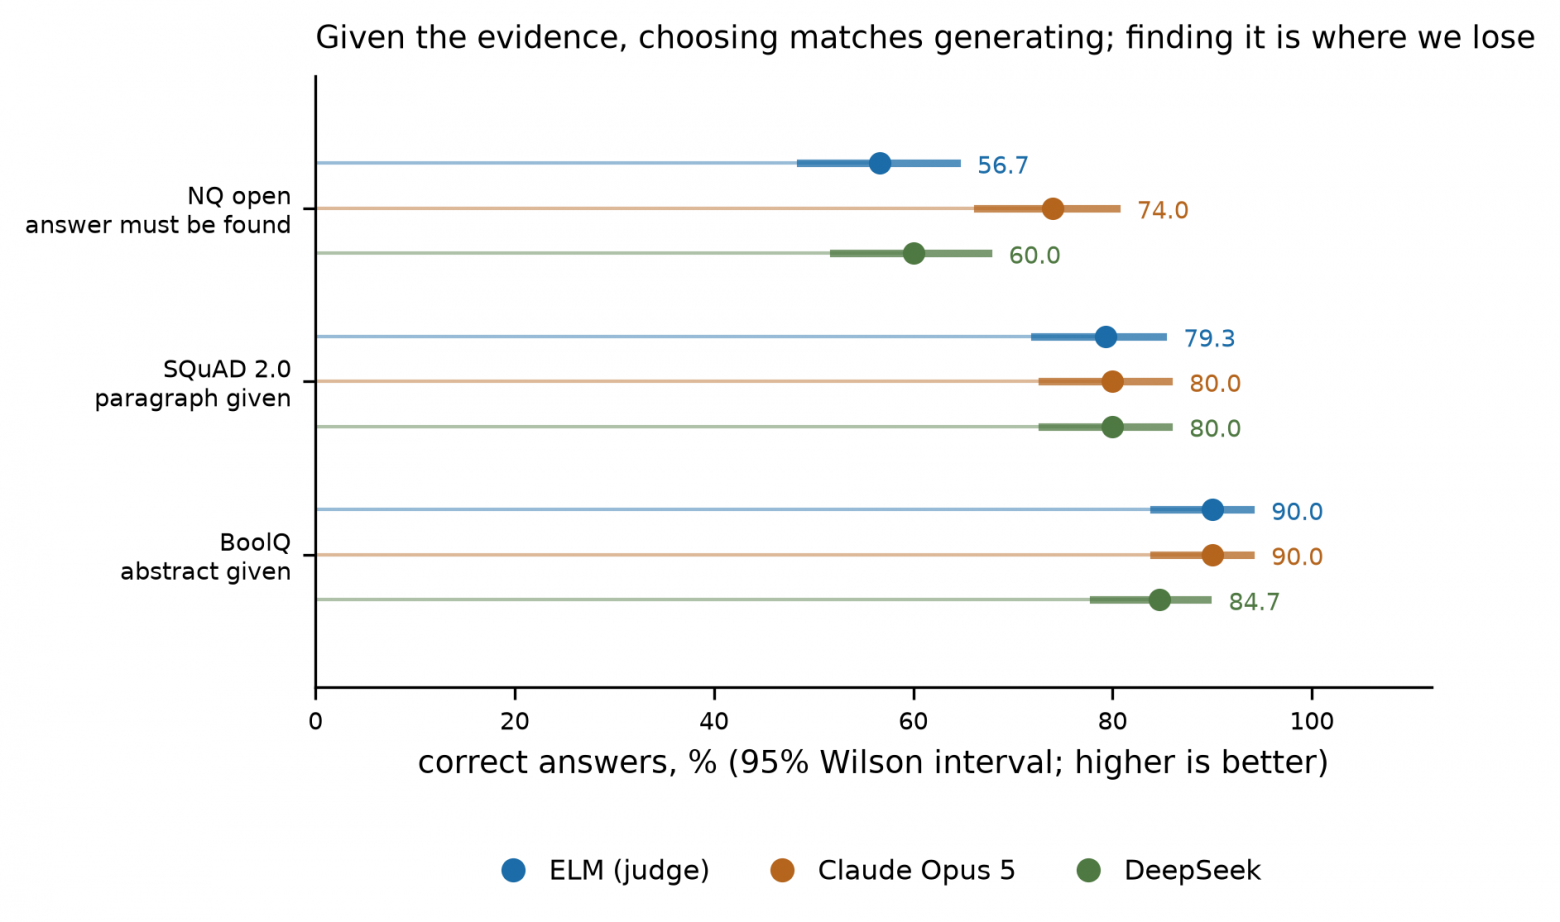
BoolQ, SQuAD 2.0 и NQ: по 150 отложенных вопросов, 95% интервалы Уилсона. В BoolQ и SQuAD абзац дан; NQ требует поиска, на графике мягкая метрика судьи.
Проверить предел дословного ответа
На BrowseComp-Plus с другим индексом документ пришлось искать по всей загадке, строку выбирать по финальному вопросу. На 30 отладочных вопросах вышло 13.3% строго верных при живом поиске и 10.0% с эталонными документами. Документ выбран в 7/30 случаях; ответ верен в 4/7 из них. Отложенного результата нет.
У 26.7% вопросов ответ составной или форматный, например «1986, Portugal» или «90g». Готовой строки с ним нет, поэтому потолок дословного цитирования на этой выборке 73.3%. В отдельном режиме сборки из проверенных цитат генератор вызван 3 раза на 30 вопросах, выдумок не обнаружено, непрошедшие проверки дали отказ. Результат 16.7% против 13.3% при живом поиске и 13.3% против 10.0% с эталонными документами; отказов стало 73.3% вместо 63.3%. Это не доказательство улучшения.
Исправить измерение до публикации
Я исправил четыре ошибки. Код читал настройки раньше, чем программа запуска их задавала. Одна проверка считала правильное «нет» провалом. Подключённый генератор сам по себе включал генеративный ответ. Поисковые догадки попадали в ответ и учитывались при оценке.
Пересчёт 16 файлов без новых прогонов изменил базу с 70 на 69 строго верных и с 86 на 85 по судье, вариант с гипотезами с 55 на 53. Отложенные результаты не затронуты: гипотезы там выключены. Исключены 10 недействительных прогонов с записанными причинами. Новую конфигурацию сначала проверяю на десяти вопросах.
Применять результат с его ограничениями
Цена в таблице получена из измеренных токенов и публичных ставок провайдеров. Для BoolQ выигрыш против Opus составляет 395–527 раз в зависимости от учёта служебного префикса; для NQ 7.7 раза. Здесь судья читает 23 120 токенов на вопрос. DeepSeek на NQ существенно дешевле ELM при неразличимом качестве.
Этот расчёт учитывает токены удалённого API. Полная стоимость поиска и подготовки ответа здесь не измерена. Память и время измерены на моей стороне; ресурсы удалённого судьи неизвестны. GPU и энергопотребление не измерены.
В тесте внедрённых инструкций было 0 успешных атак из 60, но подложный факт процитирован в 1/30 случаев. В двух проходах по 30 вопросам совпали режим 30/30, строка 29/30, реплика 26/30. Полностью детерминированной эту систему называть нельзя.
Сначала измерьте наличие ответа в пуле и окне, затем качество выбора; отдельно считайте ошибки и отказы. Дообучение кодировщика и калибровка уверенности пока не проверены. Из 43 гипотез замерены 27: 16 отвергнуты, 9 подтверждены, 2 приняты как размены; 16 не проверены.
Репозиторий с кодом и результатами пока приватный. Полностью воспроизвести эксперимент по материалам статьи извне пока нельзя: код, конфигурации и файлы результатов находятся в этом закрытом репозитории. Препринт на arXiv ещё не опубликован: для подачи мне нужен endorsement в cs.CL. Если можете помочь, напишите в личные сообщения на Хабре.
Автор: Lhody

