


Издревле (вот уже целый год) человечество пытается примириться со сжатием контекста.
Вот вы мило беседовали с чубриком, и дзинь…
Он замолкает на несколько десятков секунд, потом вроде отдупляется, бросается перечитывать доки и вроде бы с горем пополам продолжает беседу, но вы-то видите, что он не помнит шутку, которую вы только что пошутили.
К спонтанной амнезии мы уже привыкли, она воспринимается как неизбежное зло, сидящее чуть ли не в архитектуре трансформера. Контекст-то конечен, говорите вы себе, но…
Неужели с этим действительно ничего нельзя сделать?
Кое-что об устройстве трансформера
Вектор hᵢ — представление токена i в текущем слое. Из него три обученные матрицы получают “запрос”, “ключ” и “значение”:
qᵢ = W_Q hᵢ, kᵢ = W_K hᵢ, vᵢ = W_V hᵢ
Запрос q определяет, что искать; ключ k — насколько токен подходит запросу; значение v — да, это значение. Из векторов q, k, v собираются матрицы Q, K и V, участвующие в расчёте внимания.
В матрице внимания A элемент Aᵢⱼ задаёт вес, с которым при генерации токена i+1 берётся значение из токена j:
A = softmax(QKᵀ / √d + M)
Y = AV

или, что то же самое

Aᵢⱼ = exp(qᵢᵀkⱼ / √d + Mᵢⱼ) / Σₜ exp(qᵢᵀkₜ / √d + Mᵢₜ)
yᵢ = Σⱼ Aᵢⱼvⱼ
Здесь d — размерность ключа, M — маска причинности, softmax применяется по строкам. Вектор внимания yᵢ для токена i участвует в вычислении h следующего блока.
Трансформер составлен из нескольких последовательно соединённых блоков, поэтому:
hᵢ⁽ˡ⁺¹⁾ = Fₗ(h₁⁽ˡ⁾, …, hᵢ⁽ˡ⁾)
Благодаря этой матрёшке информация расползается по глубоким уровням k/v.
В латенте одного токена в сжатом виде сидит информация обо всём, что сопровождалось его написанием. Уж во всяком случае о текущей обсуждаемой теме. О чём думает модель, пока выводит “Златая цепь на дубе том”? Неужели о чём-то настолько разном, что каждое значение важно? Или она всеми токенами подсвечивает Лукоморье?
Вот что интересно. Если мы посмотрим на устройство одного блока трансформера, обнаружим, что значение v после попадания в KV-кеш самодостаточно. Value — вектор, ни на что не ссылается. Ключ тоже. Ячейки кеша к позициям не пришиты. Если удалить из взвешенной суммы аппарата внимания небольшую часть слагаемых, другие слагаемые не заметят. Результат останется осмысленным, а может статься, не сильно-то и изменится.
Из этого следует нелицеприятное предположение о чудовищной информационной избыточности KV-кеша. А ещё, что фрагмент кеша приемлемой длины, в принципе, достаточно информативен, чтобы ЛЛМ могла продолжить мысль, если обрезать начало.
И действительно. Эксперименты показывают, что модель может использовать факты из контекста, даже если сами факты прикрыты маской.
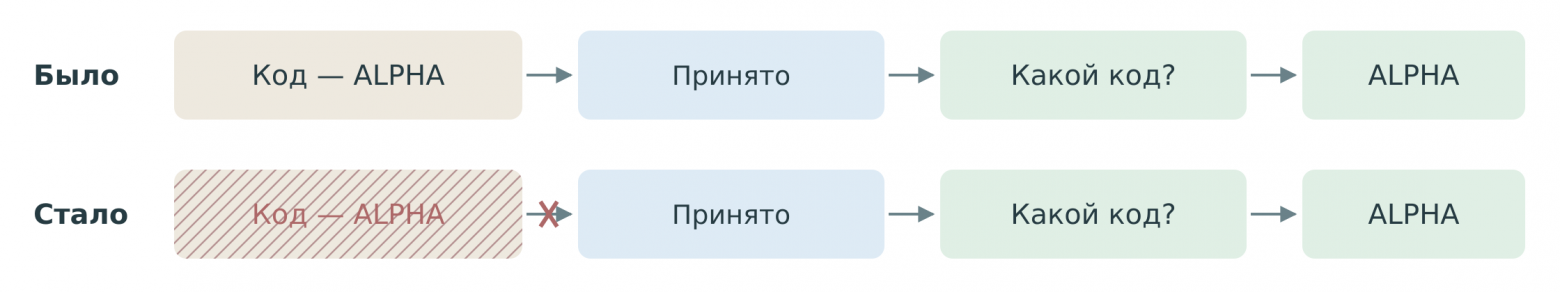
Более того, модель иногда продолжает воспроизводить факт, даже если установку в префиксе заменили на противоположную.
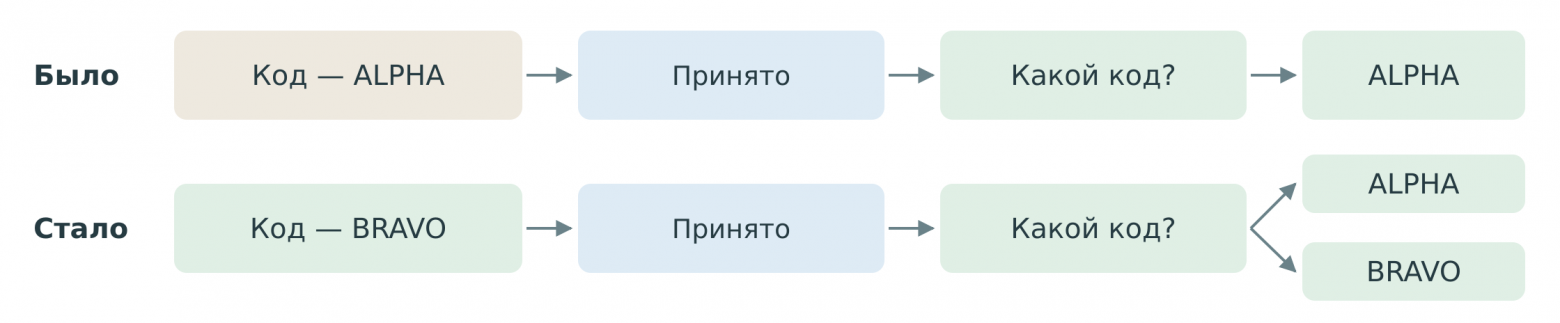
Оба ответа возможны. Обмануть агента задним числом, поменяв ему историю, — непросто. Скрытое состояние даже более значимо, чем явное изложение в контексте (вероятно, из-за механизма RoPe).
Но мы-то не собираемся обманывать агента, верно? Нас очень радует такая стойкость семантики латентов.
Вот что мы сделаем. Давайте возьмём финальную часть беседы и просто переставим её поближе к началу. А начальную часть, уж так и быть, заменим суммаризацией, чтобы информация из начала диалога не потерялась уж совсем. Суммаризация латенту не противоречит, сумаризация и латенты друг друга только обогащают.
Без сжатия и потери информации всё равно не обойдёмся, но переход будет гораздо более плавным, чем при создании новой сессии с куцей суммой. И уже не будет казаться, что вашего домового внезапно подменили.
Существующие исследования
Разумеется, я не один такой умный. Тема исследовалась:
В Memento модель обучают сворачивать рассуждения в короткие памятки. Старые блоки удаляются, но KV памяток сохраняется.
CoMem готовит суммаризацию асинхронно отдельной моделью, но при её установке пересчитывает кеш.
StreamingLLM продолжает генерацию, сохраняя начальные токены и недавний хвост кеша без пересчёта истории.
Есть и другие.
Ко всему прочему, когда я уже собрал финальное решение в том виде, что представляю в этой статье, я послал агента проверить, сваял ли уже кто-то что-то подобное, и тот выяснил, что практически то же самое за месяц до нас сварганил другой чувак: Spomin.
Вот и хорошо. Если одна и та же идея привела два раза к похожему решению — возможно, идея не совсем дурная.
Как всё работает
Я перебрал несколько вариантов и остановился на довольно простой схеме. Есть некоторый процент заполненности, служащий рубиконом. Как только рубикон перейдён, состояние до рубикона копируется в отдельную ветку для суммаризации. Важный момент в том, что суммаризация запускается, не прерывая хода диалога. Она выполняется асинхронно, в то время как вы продолжаете беседу. Технически суммаризация может отрабатывать даже на другом компьютере полностью параллельно, ну или, как в моей реализации, — асинхронно во время пауз в беседе. Если основной диалог простаивает, вычислитель выполняет суммаризацию. Но вы приоритетнее: с новой репликой суммаризация приостанавливается на границе шага, вычислитель переключается на основную сессию (сжатие осуществляется либо во втором слоте, либо временно неактивная ветка вытесняется из GPU в RAM, а потом закачивается обратно).
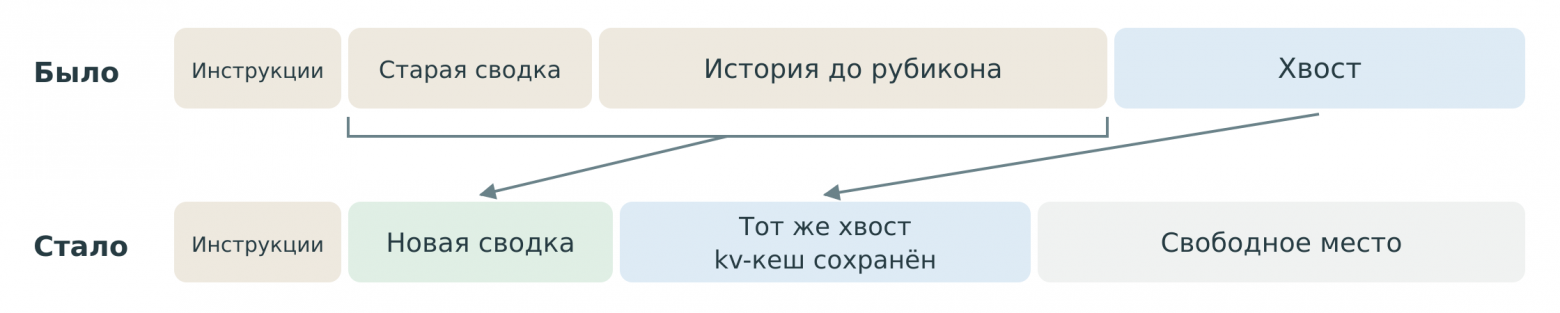
Но. Даже когда суммаризация завершается, контекст не подменяется сразу. Система позволяет беседе длиться до полного заполнения. И только в этот момент информация до рубикона удаляется. В начало беседы вставляется суммаризация с уже посчитанным асинхронно KV-кешем (сумму, кстати, тоже можно попробовать делать с переносом латентов). Информация после линии рубикона без всякого пересчёта сдвигается.
И вуаля. У нас снова куча места в контексте, а агент… будто бы ничего не заметил.
Детали. RoPE. Слои линейного внимания. QSA
Разумеется, тут опущены некоторые детали. Схема выше описана для классического трансформера, а таковых на планете уже не водится. Вот, например, обратный сдвиг требует согласования RoPE-поворотов.
RoPE
RoPE (Rotary Position Embedding) — способ сообщить вниманию о порядке токенов и расстояниях между ними. Пары координат query и key поворачиваются на угол, зависящий от позиции токена. При сравнении запроса и ключа эти повороты вносят зависимость от разности позиций:
q̃ᵢ = R(i)qᵢ,   k̃ⱼ = R(j)kⱼ
q̃ᵢᵀk̃ⱼ = qᵢᵀR(j − i)kⱼ
R(p)— матрица поворотов для позиции p. При сдвиге хвоста приходится вращать ключи соответственно.
Кроме того, отдельные архитектуры/модели могут исповедовать своё видение трансформера. Например, Qwen3.8-27B имеет, помимо аппарата полного внимания, слои линейного внимания. Но с ними как раз просто. С ними мы просто сохраняем накопленное состояние.
Линейное внимание
Рекуррентное линейное внимание сворачивает прочитанное как инерционное звено. Данные заталкиваются в один аккумулятор вместо того, чтобы сызнова собирать информацию по матрице внимания.
Для Gated DeltaNet (используется в 27b):
S̃ₜ = αₜ Sₜ₋₁
Sₜ = S̃ₜ + βₜ (vₜ − S̃ₜ kₜ) kₜᵀ
yₜ = Sₜ qₜ
α управляет забыванием, β — силой записи.
qwen3.8-flash-next тоже не лыком шит, требует, помимо прочего, переноса аппарата QSA.
QSA
Обычное внимание сравнивает запрос нового токена с ключами всех предыдущих токенов. QSA делает это в два приёма: сначала сравнивает запрос с одним общим ключом на небольшую группу соседних токенов и выбирает подходящие группы. Затем обычное внимание читает ключи и значения только выбранных групп. Так не приходится подробно обрабатывать всю историю на каждом шаге генерации.
При ротации мы переносим и согласуем этот индекс вместе с основным кешем.
Что было сделано и как оно себя ведёт
В ходе работы на основе технологий llama.cpp и strata были написаны два раннера с поддержкой моделей qwen3.8-flash-next и qwen3.8-27b.
https://github.com/mirmik/llama-ring
https://github.com/mirmik/strata-ring
Ведёт себя хорошо. Сложных задач я на этом чуде не гонял, но для включи свет, подай-принеси, сходи Хабр почитай — работает без нареканий. Уже довольно много циклов. Тот агент, что это дело писал, тоже всякие тестики гонял на нескольких десятках ротаций контекста. Существенных проблем не замечено.
Может ли оно сломаться и почему большие это не используют
Вообще-то так делать нельзя. Ллмки не обучаются в условиях, когда куски kv-кеша просто-напросто выдираются и переставляются в другое место. Никакой штатный прогон не воспроизведёт состояние, полученное после ротации. Исходная модель реализует фильтр с конечной характеристикой. С ротацией характеристика становится бесконечной. Ошмётки информации из начала разговора могут просачиваться сквозь десятки сжатий. Да будет благословен Омниссия, если они затухают. Нет никакой гарантии, что накопленная информация не отправит систему в разнос на стопятнадцатом круге.
Можно ли ожидать, что большие добавят такую технологию себе? Если и добавят, не в таком виде. Кеш — слишком тяжёлая штука, чтобы его хранить долго, а если не хранить, вся магия исчезнет. К вам на машину его тоже проблематично выгрузить. Кто ж будет для каждой сессии гонять несколько гигабайт по сети. Так что технология для локального применения.
Существующие локальные агенты/обвязки типа hermes, qwen-code для запуска не подойдут. В стандартном решении сигнал к суммаризации даёт харнес. А тут за суммаризацию отвечает раннер. Это несовместимо. Нужна кастомизация агента.
Ну а я… Если вам вдруг, уж так получилось, нужны эти раннеры или сама идея сдвига… Я просто дарю вам это… И простите, что отнял минутку вашего времени.
Автор: netricks

