


В предыдущей статье я проверял Jev на текстовых задачах: классификации, уверенности ответов, длинном контексте и грязном входе. 14 октября TypeSafe анонсировала Jev 1.14 и открыла экспериментальные возможности: изображения, новый тип вопроса box и расширенный контекст. Захотелось посмотреть, что с их помощью можно сделать на практике и где возникают ошибки.
За быструю серию экспериментов удалось проверить поиск объектов по описанию, классификацию пород кошек и собак, вопросы по картинке, поиск банковских реквизитов на документах и запросы с десятками фотографий. Все вычисления вместе обошлись примерно в $2.6.
Самый показательный результат получился в задаче «найти кошку среди собак». При 32 и 96 фотографиях модель ни разу не выбрала правильную фотографию из середины массива. После изменения структуры запроса — те же картинки, тот же порядок — ответила правильно во всех проверенных случаях. Ниже расскажу, что именно изменилось и почему первый результат легко было неправильно истолковать.
Что теперь можно спросить у Jev
Если вы пропустили предыдущую статью: Jev — модель TypeSafe для структурированных решений. Вы передаёте данные и вопросы, а в ответ получаете значения заданных типов. choice выбирает вариант из списка, score оценивает по шкале, noul возвращает вероятность ответа «да». У choice и score есть распределение вероятностей и показатель уверенности confidence. Краткое описание подхода есть в документации TypeSafe.
С изображениями к этому добавляется box: можно попросить найти голову кошки, человека в красных очках или IBAN получателя на документе. В ответе — четыре координаты рамки в долях ширины и высоты изображения, а также confidence. Один вопрос возвращает одну рамку. Описание box.
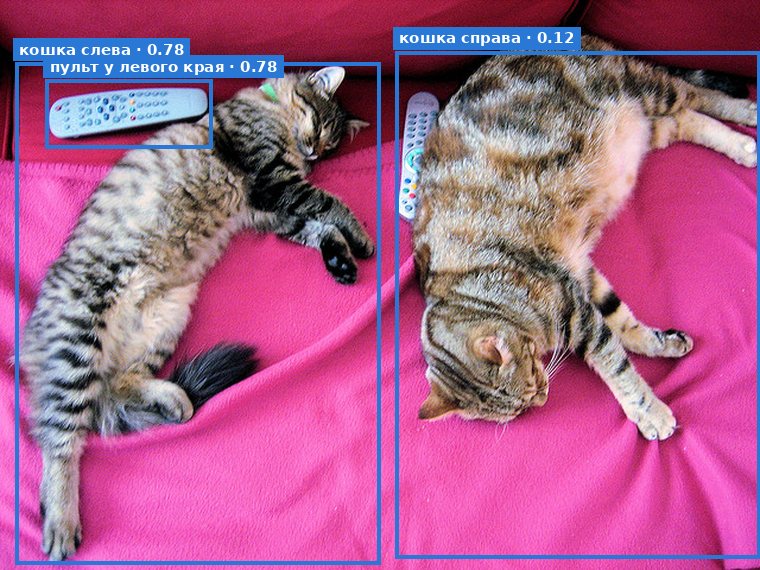
Три вопроса к одной фотографии. Синим показаны рамки Jev и их confidence. Все три рамки выглядят точными, хотя уверенность в правой кошке — всего 0.12. Низкая уверенность сама по себе ещё не означает ошибку.
Изображения можно передавать в данных запроса, инструкциях и даже в описаниях вариантов ответа — например, задать каждый класс фотографией-примером. Для изображений и box нужен заголовок TypeSafe-Danger-Zone-Images: true; разработчики пока обозначают эти возможности как экспериментальные. Формат работы с изображениями.
В анонсе есть любопытная деталь: Jev 1.13 уже была мультимодальной, а теперь эту возможность открыли пользователям. Расширенный контекст тоже поддерживается в 1.13; box доступен только с 1.14. Разработчики включили экспериментальные функции через отдельные заголовки API и прямо говорят, что пока не готовы рекомендовать их для production.
У самой 1.14 также заявлены небольшие улучшения по разным направлениям, особенно в поддержке языков. Здесь я сосредоточился на изображениях и длинном контексте. Все результаты ниже получены 15 октября 2026 года на jev-1.14.0; межъязыковые улучшения и разница качества между версиями в этой серии не проверялись.
Что можно использовать на практике
Это краткая сводка по проверенным задачам. Числа относятся к нашим выборкам; условия и ограничения разобраны дальше.
|
Задача |
Что получилось |
Как использовать |
|---|---|---|
|
Найти объект по описанию |
Головы питомцев: 92% попаданий; люди и предметы RefCOCO: 74%. Критерий — IoU ≥ 0.5 |
Описывать конкретную цель; один вопрос |
|
Проверить, есть ли объект |
|
Задавать |
|
Отобрать надёжные рамки |
При confidence ≥ 0.7 ошибок не было, но осталось лишь 24–31% рамок, по 12–47 на набор |
Подбирать порог под задачу; при нескольких похожих объектах уточнять описание |
|
Найти текст на документе |
Поиск IBAN по точному тексту: 44% → 89% на чистых страницах, 51% → 75% на имитации скана |
Нарезка и увеличение помогают. Цепочка «OCR → поиск по тексту» целиком ещё не проверена |
|
Извлечь все реквизиты по номерам |
Перебор «первый IBAN, второй…» даёт пропуски и лишние рамки; все реквизиты найдены лишь на 18 из 60 непустых страниц после нарезки |
Для полного извлечения нужен другой способ получить кандидатов |
|
Классифицировать фотографии |
На 37 породах: Jev 89.5%, Gemini Embedding 2 95.4–95.9%. У Jev порог 0.9 оставляет 64% ответов с точностью 98.7% |
Сравнивать с эмбеддингами; уверенность Jev полезна для отбора ответов |
|
Найти нужное фото среди десятков |
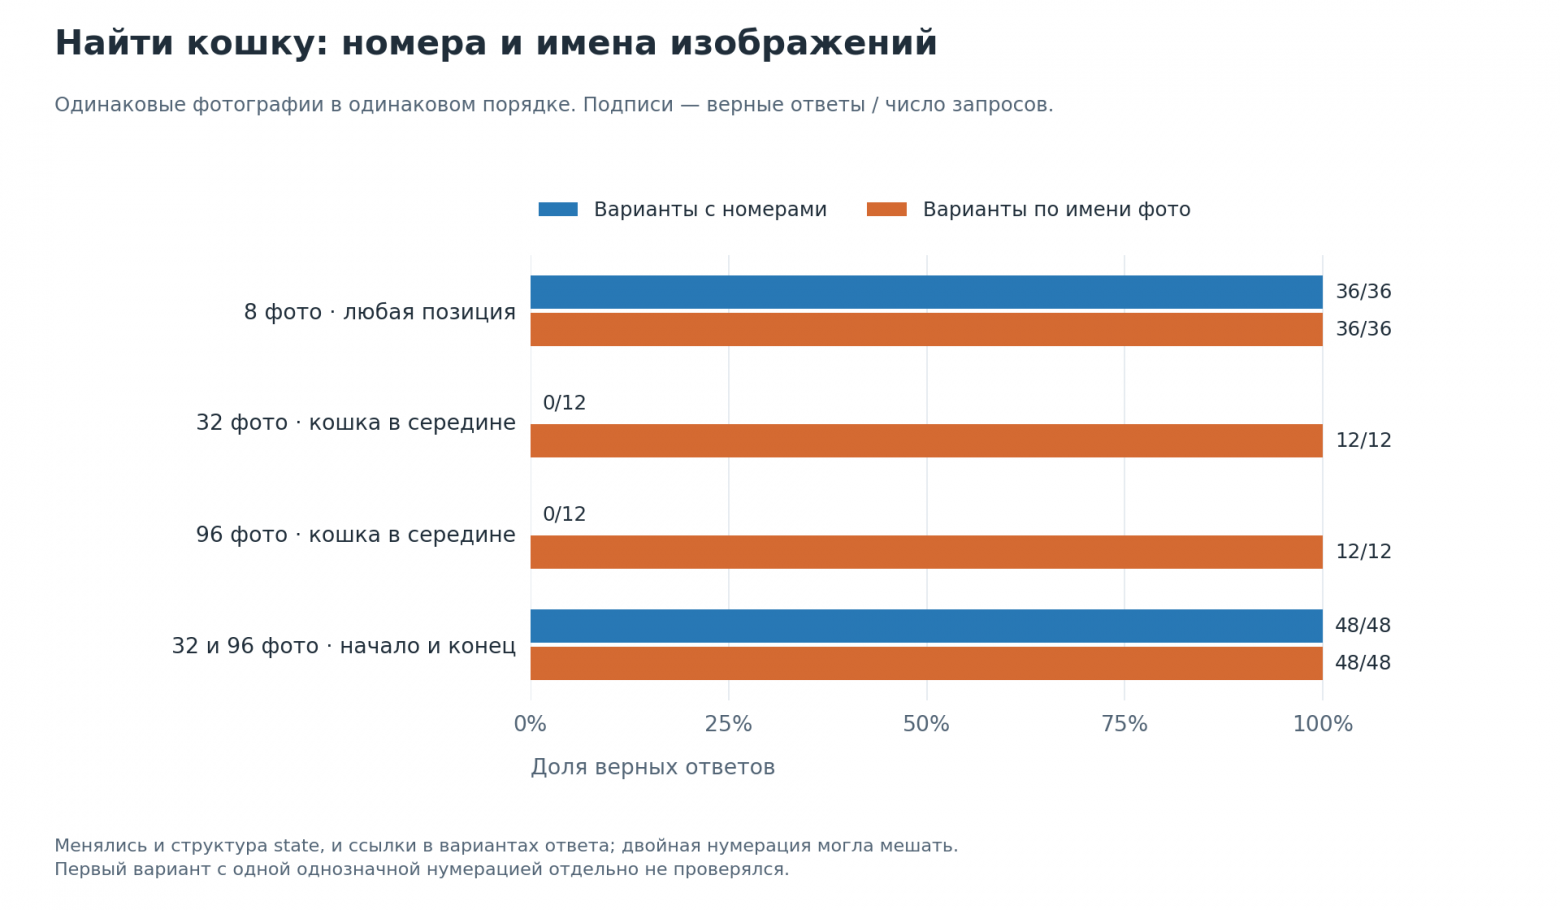
Именованные изображения: все ответы верны при 8, 32 и 96 фото, по 12 запросов на каждую позицию. Варианты с номерами давали сбои |
Ссылаться на фотографии по имени; одна однозначная нумерация отдельно не проверялась |
|
Обработать длинный текст |
Запросы до 193k токенов прошли; сводное снижение точности — 4.8 п.п., середина сложнее |
Сокращать лишний контекст; важное размещать в начале. Предел 262k не проверялся |
|
Оценить стоимость изображений |
Фото 640×480 — около 870 токенов, примерно $0.00004 без остальных частей запроса |
По замерам проходили стороны 280–1568 px; изображения меньшего размера стоит подготовить заранее |
Как проводилась проверка
Это обзор возможностей, выполненный за один день. Исследование я проводил с Claude. Использовались публичные фотографии и программно сгенерированные сцены и документы; реальные рабочие документы в Jev не отправлялись.
|
Что проверялось |
Данные |
|---|---|
|
Рамка вокруг головы |
150 фотографий Oxford-IIIT Pet |
|
Объект по описанию среди других |
100 фотографий RefCOCO: 50 с людьми и 50 с предметами |
|
Классификация |
370 фотографий, 37 пород кошек и собак |
|
Вопросы по изображению |
Простые сцены и 100 усложнённых сцен с фигурами и текстом |
|
Текст на документах |
70 синтетических страниц, каждая в чистом виде и с имитацией скана |
|
Длинный контекст |
30 текстовых обращений; отдельно — наборы из 8, 32 и 96 фотографий |
Отправлено около 4.5 тысячи запросов к Jev, включая отклонённые запросы, и получено 1110 эмбеддингов Gemini. Стоимость рассчитана по использованию токенов и тарифам, со счётом провайдеров не сверялась.
Сравнения методов проводились на одних и тех же примерах. Для долей использовались интервалы Уилсона, для парных сравнений — тест Макнемара с поправкой Холма внутри серии сравнений. В длинном контексте интервалы считались бутстрэпом по исходным обращениям: несколько вариантов одного обращения не считались независимыми примерами.
У части тестов с рамками было три повтора. Это проверка воспроизводимости ответа; число разных изображений от этого не увеличивается. В основных таблицах качества рамок ниже используется один прогон.
1. Найти объект по описанию
Для рамок использовалась стандартная метрика IoU: площадь пересечения предсказанной и эталонной рамки, делённая на площадь их объединения. Единица означает полное совпадение. Условным попаданием считался IoU ≥ 0.5.
|
Задача |
Изображений |
Средний IoU |
Доля попаданий, 95% интервал |
|---|---|---|---|
|
Голова кошки или собаки |
150 |
0.76 |
92% [86.5; 95.4] |
|
Человек по описанию, RefCOCO testA |
50 |
0.73 |
80% [67.0; 88.8] |
|
Предмет по описанию, RefCOCO testB |
50 |
0.66 |
68% [54.2; 79.2] |
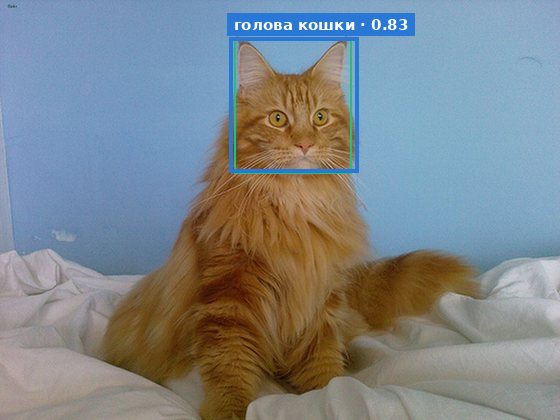
«The head of the cat»: IoU 0.90. Синяя рамка — Jev, зелёная — эталон датасета.
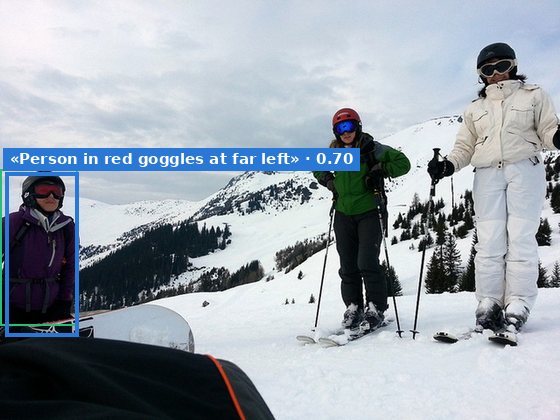
«Person in red goggles at far left»: IoU 0.86. Здесь нужно выбрать человека по описанию среди нескольких людей.
Что даёт уверенность
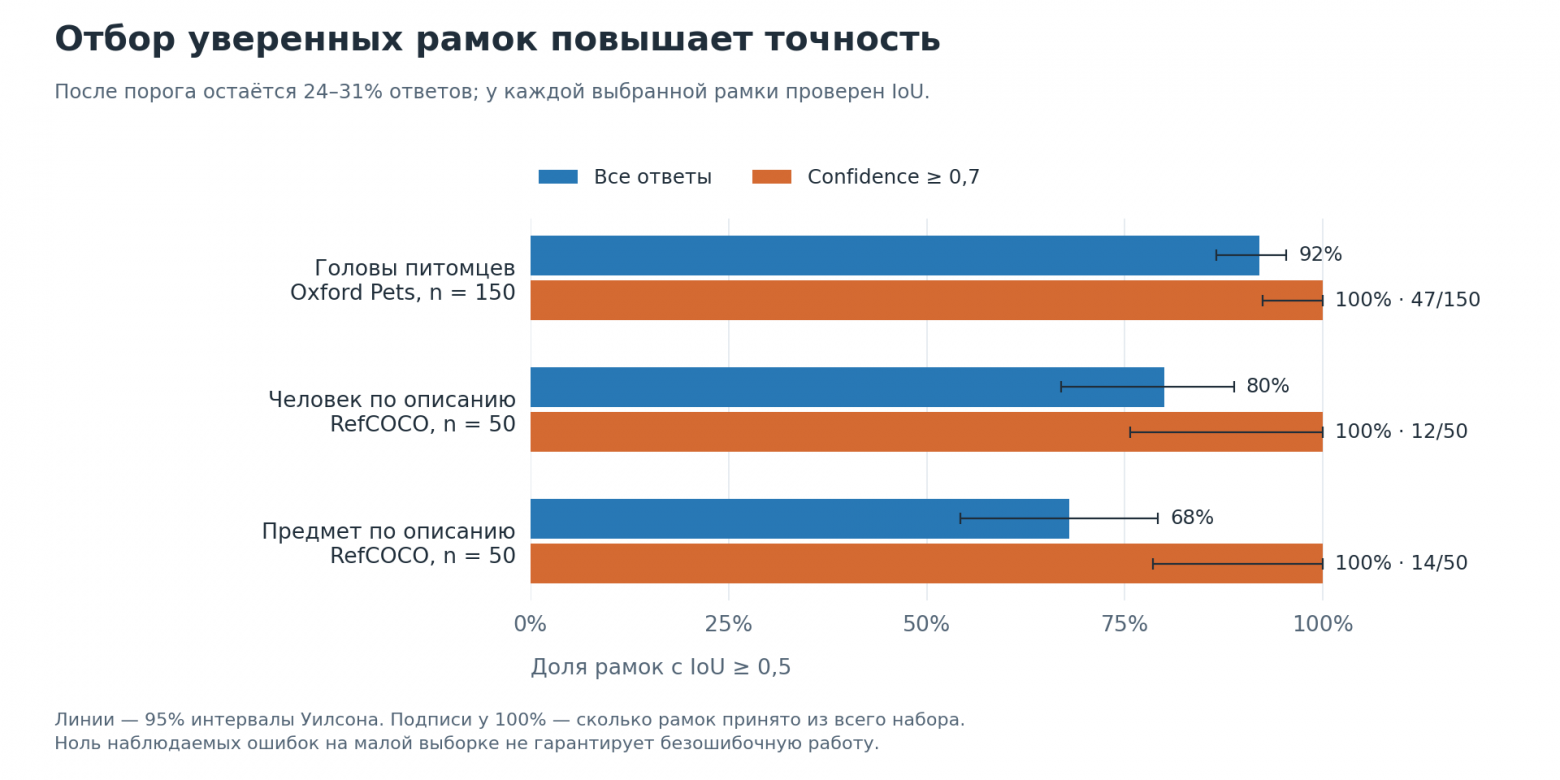
Точные числа: порог, доля принятых ответов и точность
|
Задача |
Все ответы: доля попаданий |
При confidence ≥ 0.5: осталось / попадания |
При confidence ≥ 0.7: осталось / попадания |
|---|---|---|---|
|
Головы питомцев |
92% |
76% / 98.2% |
31% / 100% |
|
Люди RefCOCO |
80% |
64% / 87.5% |
24% / 100% |
|
Предметы RefCOCO |
68% |
56% / 92.9% |
28% / 100% |
Порог 0.7 убрал все ошибки на этих выборках, но оставил лишь 12–47 рамок на набор. Например, 12 верных рамок из 12 дают 95% интервал примерно от 76% до 100%. Оснований обещать безошибочную работу нет.
Практическая польза показателя всё же видна: можно принимать часть рамок автоматически, а остальные отправлять на дополнительную обработку. При этом шкала box заметно отличается от классификации: уверенность ≥ 0.9 встретилась лишь у одной из 150 рамок вокруг головы. Порог нужно подбирать для конкретной задачи.
Если объекта нет
На фотографиях питомцев я спрашивал про самолёт, жирафа, велосипед и другие отсутствующие объекты. Рамка возвращалась и для них. Такое поведение прямо описано в документации: у box нет ответа «не найдено».
Поэтому рядом задавался noul — вопрос о присутствии объекта. На 150 положительных и 40 отрицательных примерах результаты полностью разделились: для присутствующих объектов вероятность была не ниже 0.91, для отсутствующих — не выше 0.21. Собственный confidence рамки разделял их хуже: у одной рамки для отсутствующего объекта он доходил до 0.80.
В запросе это выглядит так — фрагмент поля questions, если фотография уже передана в state.photo:
{
  "present": {
    "type": "noul",
    "instructions": "Is there a cat in `photo`?"
  },
  "location": {
    "type": "box",
    "instructions": "the cat in `photo`"
  }
}
В этой проверке отрицательные примеры были простыми. На перекрытых объектах, силуэтах или похожих предметах ошибок может быть больше. Но уже на них видно, почему использовать один confidence рамки для проверки присутствия — слабое решение.
Если одинаковых объектов несколько
На синтетических сценах с яблоками запрос «the apple» обычно выбирал одно яблоко. При трёх яблоках стало много промахов, а медианная уверенность упала с 0.69 для одного яблока до 0.19 для трёх.
Уточнение «самое левое яблоко» помогало: верные рамки получились в 100% ответов при двух яблоках и в 92% при трёх. На каждое количество было только 12 разных сцен с тремя повторами, поэтому это предварительное наблюдение. Оно показывает ценность однозначного описания цели.
2. Документы: найти строку проще, если увеличить её
Сначала задача выглядела обнадёживающе. На простых синтетических платёжных документах Jev находила строку IBAN, хотя рамка часто смещалась по вертикали. После расширения рамки вверх и вниз на высоту строки нужный реквизит оказывался внутри в 98–100% ответов. Плательщика с получателем модель не перепутала.
У этого результата две существенные оговорки: всего было по 15 документов с одним и с двумя IBAN; критерий пригодности кропа появился после просмотра ответов. При строгом IoU ≥ 0.5 результаты составляли лишь 27–47% в зависимости от вопроса. Расширение рамки выглядело полезным приёмом, который стоило проверить дальше.
Следующая серия была сложнее: страницы 1100×1556 пикселей с абзацами, таблицей, реквизитами и отвлекающими номерами. На странице — от нуля до 12 синтетических IBAN. Каждая страница проверялась в чистом виде и с поворотом, размытием, шумом и JPEG-сжатием, имитирующими скан.
Здесь критерий успеха зафиксирован до прогона: после расширения по вертикали на высоту строки рамка должна покрывать не менее 80% нужного IBAN и менее половины любого другого. Дополнительно ограничивалась площадь исходной рамки, чтобы ответ «вся страница» не считался успехом.
На целой странице модель часто возвращала рамки высотой в две-три строки со сдвигом примерно на строку. Тогда та же страница была разрезана на четыре горизонтальные полосы с перекрытием 60 пикселей, каждая увеличена в 1.4 раза. Ответы переводились обратно в координаты страницы.
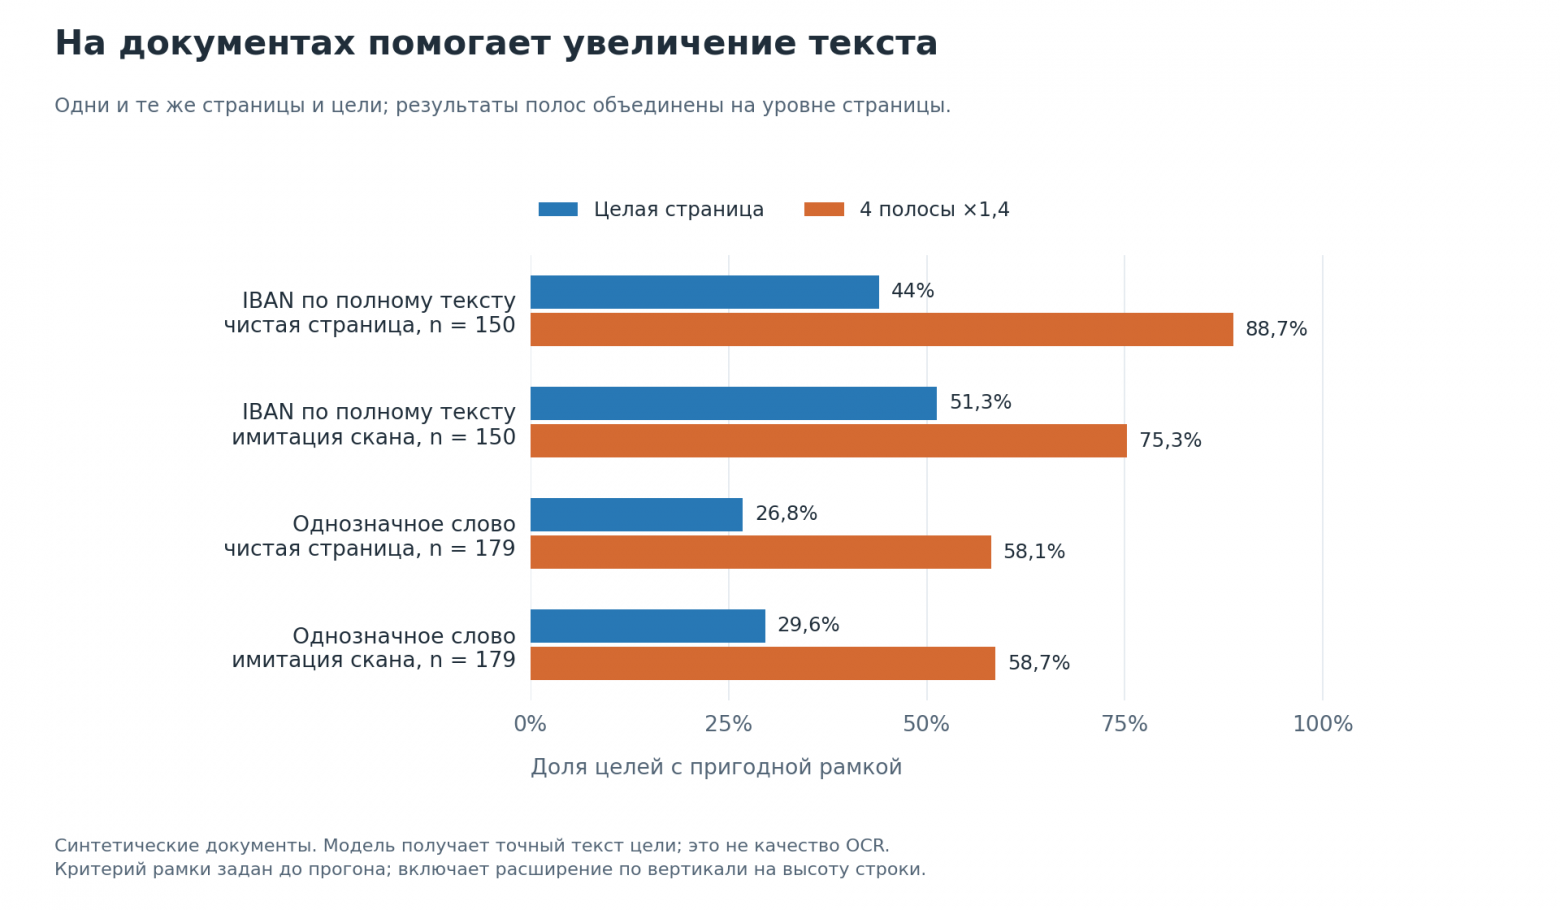
Числа для целых страниц и полос
|
Задача |
Целая страница |
Четыре полосы |
|---|---|---|
|
IBAN по полному тексту, чистая страница |
44% |
89% |
|
IBAN по полному тексту, имитация скана |
51% |
75% |
|
Однозначное слово абзаца, чистая страница |
27% |
58% |
|
Однозначное слово абзаца, имитация скана |
30% |
59% |
Для IBAN сравнивались те же 150 целей в каждом варианте документа; для слов — 179 однозначных целей. Улучшения статистически значимы в парном сравнении. На этих страницах увеличение текста помогло сильнее, чем мешала имитация сканирования.
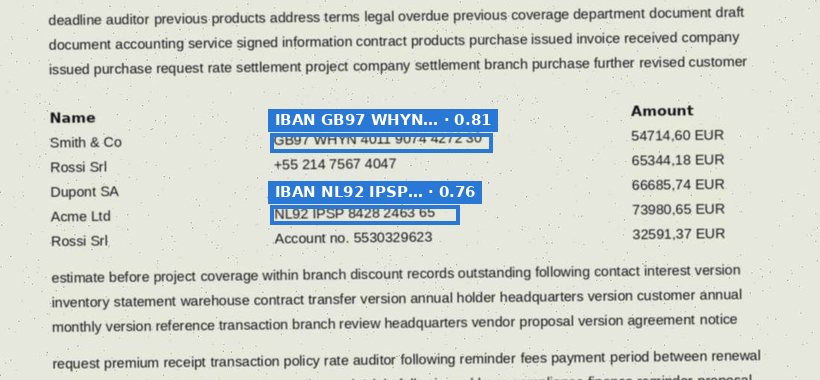
Синтетический документ: компании и реквизиты сгенерированы программой. Для каждого IBAN модель получила его полный текст. Это пример успешной локализации известных строк.
89% — результат поиска строки, текст которой уже известен. Вопрос содержал полный IBAN из эталона. Ошибки OCR и полнота предварительного распознавания в эту цифру не входят.
А что, если попросить «первый IBAN», «второй IBAN» и так далее? Этот путь оказался слабым. Правильный i-й реквизит находился примерно в 11% случаев на целой странице и в 31–37% внутри полосы. Даже с дополнительным noul «есть ли i-й IBAN» все реквизиты были найдены лишь на 18 из 60 непустых страниц после нарезки. Оставалось и много лишних рамок.
Поэтому следующий эксперимент я бы строил так: полосы → OCR находит кандидатов → Jev локализует кандидата по его тексту. В этой серии проверено последнее звено при идеальном тексте кандидата. Весь конвейер, включая чтение и проверку реквизитов, ещё предстоит измерить.
3. Классификация: эмбеддинги оказались сильным соперником
Для классификации использовался Oxford-IIIT Pet: 37 пород кошек и собак, по 10 тестовых фотографий каждой породы.
Jev получала список пород с короткими описаниями вида «название — порода кошек/собак». У Gemini Embedding 2 считалось сходство эмбеддинга фотографии с эмбеддингами текстовых описаний классов. Это сравнение без обучающих примеров, то есть zero-shot.
Отдельно проверялся one-shot: в описание каждого варианта Jev добавлялась одна фотография-пример из обучающей части датасета.
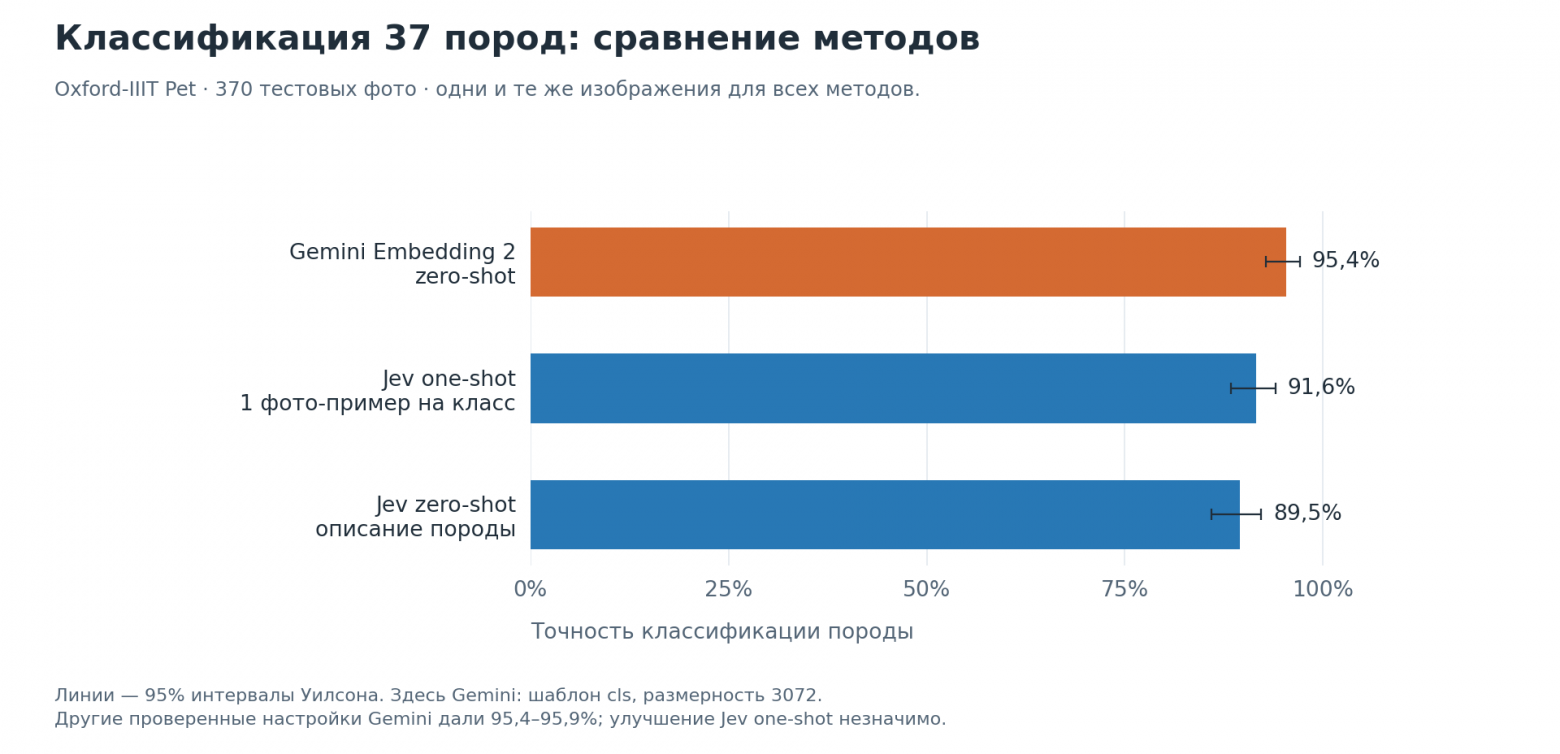
Числа сравнения классификаторов
|
Метод |
Примеров на класс |
Точность |
|---|---|---|
|
Jev zero-shot |
0 |
89.5% |
|
Jev с фотографией-примером в каждом варианте |
1 |
91.6% |
|
Gemini Embedding 2: сходство с текстом класса |
0 |
95.4–95.9% |
Диапазон Gemini получился при двух шаблонах описаний и двух размерностях эмбеддинга. Её преимущество перед Jev zero-shot подтвердилось в парных сравнениях с поправкой Холма. Улучшение Jev от одного примера на класс — на 2.1 процентного пункта — статистически подтвердить не удалось.
Примеры при этом увеличили медианный объём запроса примерно с 2.3 до 14.3 тысячи токенов, а время ответа — с 0.34 до 1.28 секунды. Замеры времени здесь побочные, в шести потоках; на точное сравнение производительности они не претендуют.
Ни одна из моделей ни разу не перепутала кошку с собакой. Ошибки происходили между похожими породами: например, стаффордширский бультерьер и питбуль, бирманская кошка и рэгдолл.
У Jev полезной оказалась уверенность ответа:
|
Минимальный confidence |
Доля принятых ответов |
Точность среди принятых |
|---|---|---|
|
Без отбора |
100% |
89.5% |
|
0.7 |
82% |
97.7% |
|
0.9 |
64% |
98.7% |
|
0.99 |
33% |
100% |
Это позволяет построить обработку с дополнительной проверкой сложных случаев. Пороговые показатели посчитаны на той же тестовой выборке; качество заранее выбранного порога на новых данных здесь не проверялось. Также это не отдельная проверка калибровки вероятностей: в этой серии измерено, насколько уверенность помогает отбирать более точные ответы.
Oxford Pets — широко используемый публичный датасет; пересечение с обучающими данными моделей я проверить не могу. Описания пород у Jev были минимальными, улучшать их я не пробовал. Вывод относится к этой задаче и этим настройкам.
4. Что модель видит на картинке — и где ошибается
Чтобы отделить трудности зрения от трудностей самой задачи, каждая синтетическая сцена передавалась двумя способами: как картинка и как текстовый список тех же объектов с координатами. Вопросы оставались одинаковыми.
На простых сценах с крупными контрастными фигурами точность по картинкам была 99.3%. Затем сцены усложнили: 8–20 фигур, три размера, десять цветов, мелкий текст.
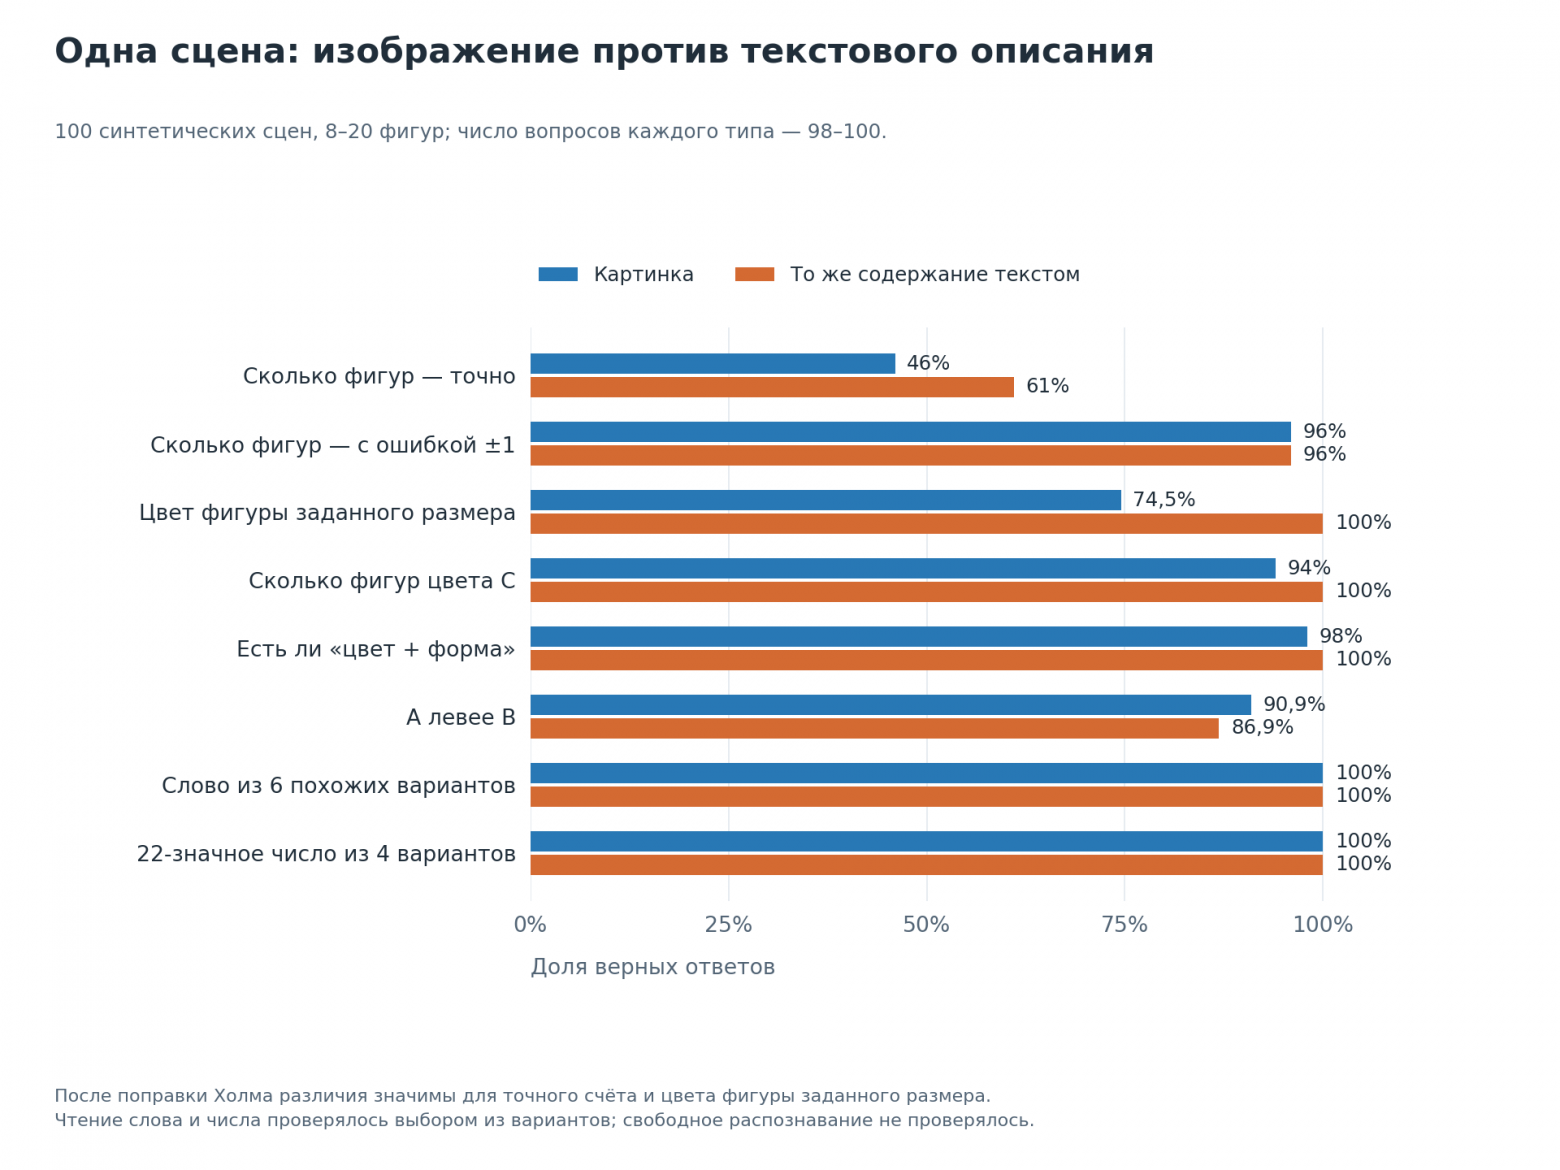
Числа по основным типам вопросов
|
Вопрос |
Картинка |
То же содержание текстом |
|---|---|---|
|
Сколько всего фигур |
46% |
61% |
|
Сколько фигур заданного цвета |
94% |
100% |
|
Есть ли фигура заданных цвета и формы |
98% |
100% |
|
Какого цвета фигура заданных размера и формы |
74.5% |
100% |
|
Какое слово написано, выбор из похожих вариантов |
100% |
100% |
|
Какое 22-значное число написано, выбор из четырёх |
100% |
100% |
После поправки на несколько сравнений значимыми остались различия в точном подсчёте всех фигур и в вопросах о цвете фигуры заданного размера.
Разбор ошибок оказался интереснее общей точности. Все 25 ошибок в вопросах о цвете относились к фигуре среднего размера. На маленьких и больших фигурах ошибок не было. В каждом ошибочном ответе модель выбирала цвет фигуры той же формы, но другого размера. То есть затруднение возникало при выборе объекта по относительному размеру.
Со счётом картина другая: точное количество угадывалось плохо и по картинке, и по тексту. Если разрешить ошибку на единицу, обе версии дают 96%. Модель часто была близка к ответу, но для точного подсчёта этого недостаточно.
А 100% на длинных числах требуют аккуратного прочтения: модель выбирала из четырёх готовых вариантов, отличавшихся одной цифрой. Шрифт был 16–22 пикселя, сцены — синтетические. Свободное распознавание текста без вариантов ответа этот тест не проверяет.
5. Кошка среди 96 фотографий: почему важны имена
В одном запросе передавались фотографии собак и одна кошка. Нужно было выбрать фотографию с кошкой. Проверялись наборы из 8, 32 и 96 изображений, кошка стояла в начале, середине или конце. На каждую комбинацию — 12 запросов.
В первой версии фотографии лежали массивом, а описания вариантов ответа содержали сразу две нумерации: photo k of n (item k−1 of the array).
|
Фотографий |
Кошка в начале |
В середине |
В конце |
|---|---|---|---|
|
8 |
100% |
100% |
100% |
|
32 |
100% |
0% |
100% |
|
96 |
100% |
0% |
100% |
Результат похож на потерю информации в середине длинного контекста. Но при 32 фотографиях все 12 ошибок указывали на соседнюю позицию. Это повод проверить, что именно модель не смогла сделать.
Во второй версии те же фотографии в том же порядке были переданы объектом со случайными именами. Варианты ответа ссылались на пути вроде photos.<имя> — без порядкового номера.
После этого все ответы стали верными: 8, 32 и 96 фотографий, любая из трёх позиций кошки. Уверенность во всех этих ответах — 1.0.
Набор из 96 фотографий занимал около 117 тысяч токенов, медианное время ответа было около семи секунд. Для 8 фотографий — около 10 тысяч токенов и 0.6 секунды.
Этот эксперимент позволяет сказать, что в проверенной задаче модель находила кошку и в середине набора. Причину провала первой схемы однозначно установить нельзя: одновременно изменились структура данных и способ ссылки на изображение. Двойная нумерация могла запутать модель; вариант с одной недвусмысленной нумерацией отдельно не проверялся. При 96 фотографиях вероятности были распределены шире, и объяснения только сдвигом на единицу недостаточно.
Для своих запросов я бы выбрал именованные изображения. А 12 успешных ответов на комбинацию пока воспринимал бы как хороший результат пилота, который стоит проверить на более сложном поиске.
6. Длинный текст: середина по-прежнему сложнее
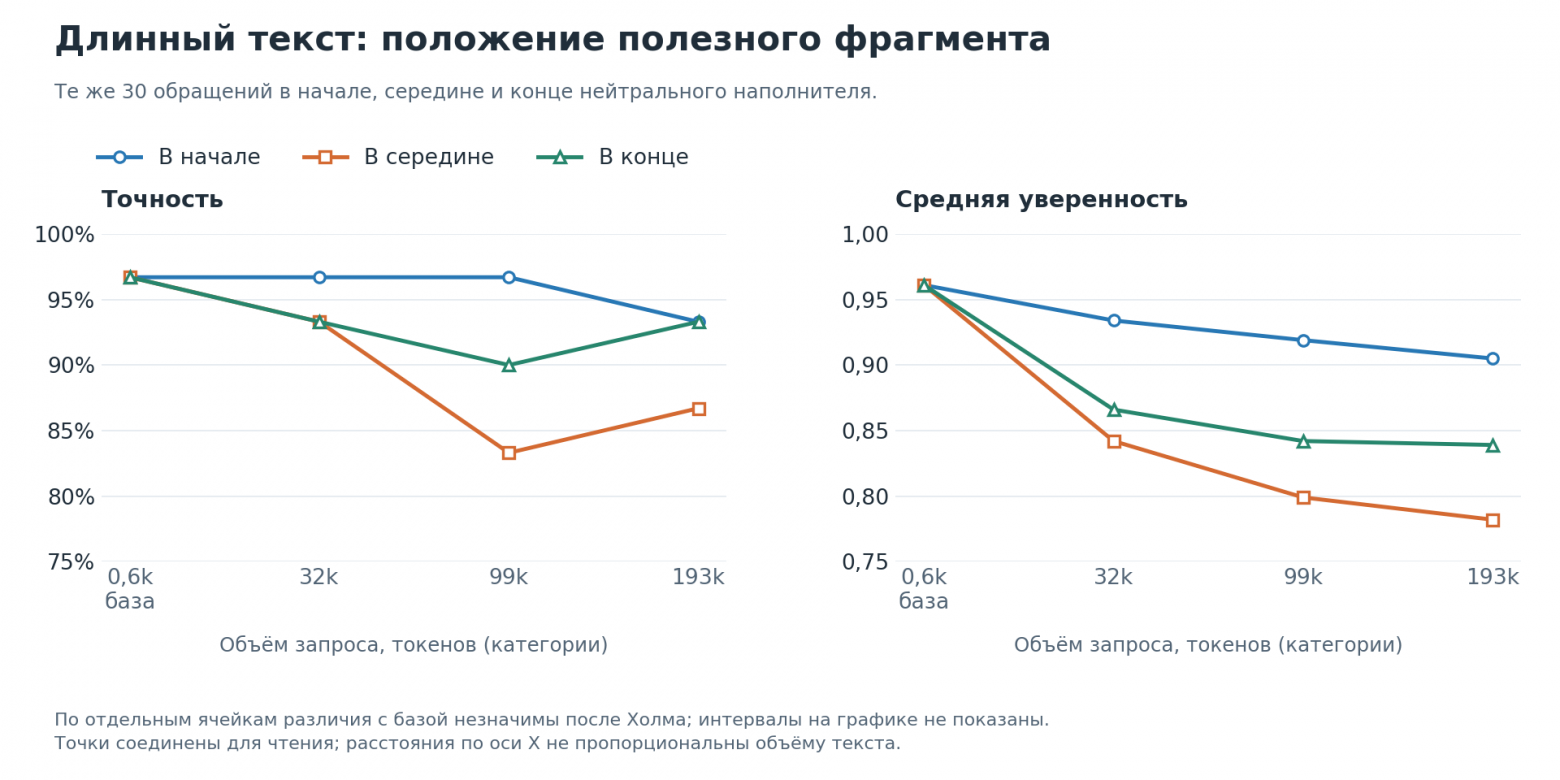
Отдельно проверялось обращение клиента банка среди большого объёма нейтрального текста. Нужно было выбрать один из десяти интентов. Использовались 30 обращений из предыдущей серии, каждое помещалось в начало, середину или конец наполнителя.
Расширенный контекст включался заголовком TypeSafe-Danger-Zone-Long-Context: true. По документации он поднимает лимиты запроса и отдельного вопроса до 262 тысяч токенов; здесь проверено только до 193 тысяч.
Точные числа и время ответа для длинного текста
|
Объём запроса |
Время ответа p50 |
Обращение в начале |
В середине |
В конце |
|---|---|---|---|---|
|
Без наполнителя, около 0.6k токенов |
0.3 с |
96.7% |
— |
— |
|
Около 32k токенов |
0.5 с |
96.7% |
93.3% |
93.3% |
|
Около 99k токенов |
1.2 с |
96.7% |
83.3% |
90.0% |
|
Около 193k токенов |
2.8 с |
93.3% |
86.7% |
93.3% |
Тридцати обращений мало для уверенных выводов по каждой ячейке: после поправки Холма ни одно отдельное сравнение с базой не стало значимым. Более высокая точность на 193k, чем на 99k, также не доказывает улучшение от длины.
При объединении всех длинных вариантов точность снизилась в среднем на 4.8 процентного пункта, 95% интервал — от −9.6 до −1.1. Уверенность снизилась на 0.10 [−0.16; −0.05]. Для средней позиции оценка падения точности — 8.9 п.п. [−17.8; −2.2].
Это согласуется с наблюдениями из предыдущей статьи: посторонний текст ухудшает результат, особенно если полезный фрагмент находится в середине. Здесь наполнитель был нейтральным, а на максимальной длине часть предложений повторялась. Длинные реальные документы могут вести себя иначе.
Несколько деталей для тех, кто захочет повторить
По тарифу TypeSafe, миллион входных токенов стоит $0.042, выход бесплатен. В этих замерах изображение 640×480 занимало примерно 870 токенов — около $0.00004. Поэтому даже широкая обзорная проверка стоила недорого. Полный запрос стоит больше: в нём есть инструкции, варианты ответа и, возможно, фотографии-примеры.
Размер изображений лучше проверять заранее. В документации указаны стороны от 256 до 1568 пикселей и отдельное ограничение по площади. Но в день замера API отвергал не только 256×256: 279×400 и 256×1000 тоже получили 400 Invalid image dimensions, хотя по площади проходили. 280×280 и 280×400 принимались. Для этих тестов использовалась минимальная сторона 280 пикселей. Это наблюдение о конкретном API на дату проверки.
В запросах я явно указывал jev-1.14.0: box на 1.13 в проверке вернул ошибку 400. Фиксация версии также помогает воспроизводить результаты и пороги уверенности.
Что хочется проверить дальше
Из этой серии я бы первым продолжил эксперимент с документами: взять реальные или более разнообразные размеченные страницы и измерить всю цепочку от OCR до рамки нужного реквизита. Сейчас видно, что масштаб изображения сильно влияет на результат, а перебор объектов по номеру даёт слишком много пропусков и лишних рамок.
На фотографиях уже получился полезный набор возможностей: найти объект по описанию, проверить его присутствие, отобрать более уверенные ответы. Для каждой операции есть измеримые ограничения — и возможность поменять запрос или обработку, когда качества недостаточно.
История с кошкой среди 96 фотографий особенно хорошо показывает, зачем разбирать неудачные ответы. Один результат выглядел как провал длинного визуального контекста, а повторная проверка показала, что модель видела нужную картинку. Способ указать на неё оказался существенной частью задачи.
Автор: rotor

