


Чтобы пункт выдачи заказов хорошо работал, надо учесть сразу несколько факторов: сколько людей живёт рядом, траффик, где уже работают другие ПВЗ и какую часть их заказов заберёт новая точка. Оценить всё это нужно до открытия — в нашем случае за 50 дней
Почти каждая статья про выбор локации начинается одинаково: берём слой населения по домам, накладываем сетку, считаем плотность спроса. Дальше — модель Хаффа, изохроны, красивая карта.
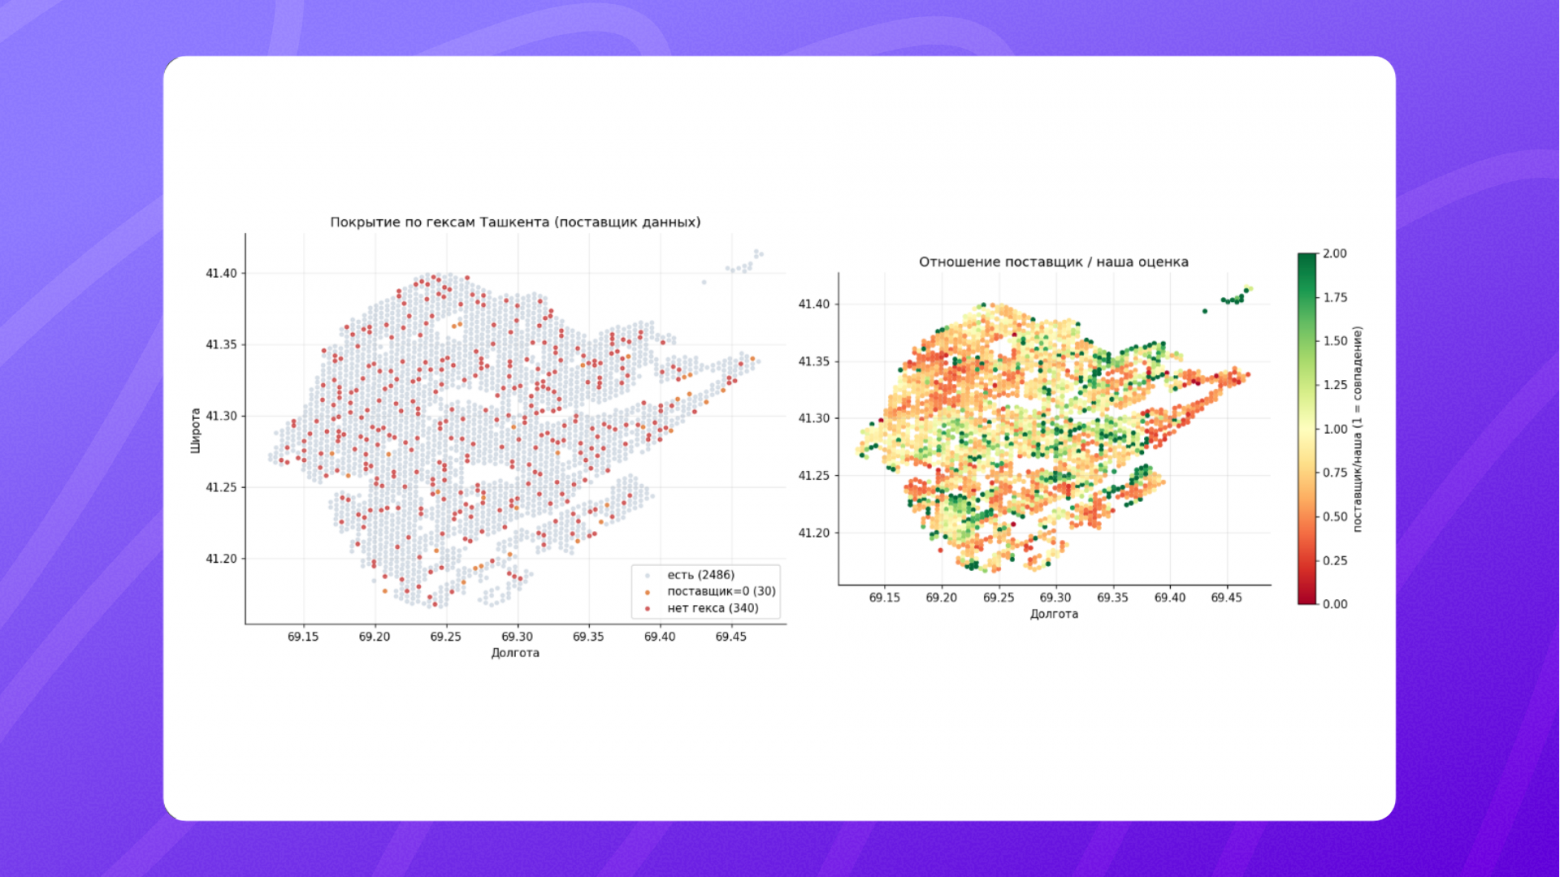
Но это отлично работает, когда у вас на входе заведомо достоверные и чистые данные. По стране мы используем данные коммерческого поставщика, а для Ташкента построили собственный слой населения по зданиям. Сравнение двух источников показало: в 13% гексагонов Ташкента с жилой застройкой население у поставщика отсутствовало или было равно нулю. По нашей оценке, в этих гексагонах живёт 12,3% горожан.
При поиске мест для новых ПВЗ мы оставляли только гексагоны с населением больше нуля. Из-за пропусков в данных целые жилые кварталы выпадали из списка кандидатов ещё до запуска модели. Для них прогноз заказов вообще не рассчитывался.
Меня зовут Артем Воронов, я Machine Learning Engineer в Uzum Market.
Мы развиваем сеть пунктов выдачи заказов. Пока точек мало, места ещё можно выбирать по опыту и интуиции. С ростом сети нужен воспроизводимый способ сравнивать локации и оценивать, сколько новых ПВЗ действительно требуется.
В статье разберем:
-
чем оценка конкретного помещения отличается от проектирования сети;
-
как мы измерили пропуски в покупном слое населения;
-
как прогнозируем заказы новой точки за 50 дней до открытия;
-
как оцениваем каннибализацию соседних ПВЗ по похожим открытиям;
-
как распределили население Ташкента почти по 370 000 зданиям, хотя этажность известна только у 3% объектов;
-
как устроен жадный алгоритм размещения точек с ленивой переоценкой.
Дальше встретятся несколько сокращений:
-
ПВЗ — пункт выдачи заказов;
-
GMV — суммарная стоимость заказов;
-
WAPE — сумма абсолютных ошибок, делённая на сумму фактических значений;
-
MAPE — среднее абсолютных относительных ошибок по объектам.
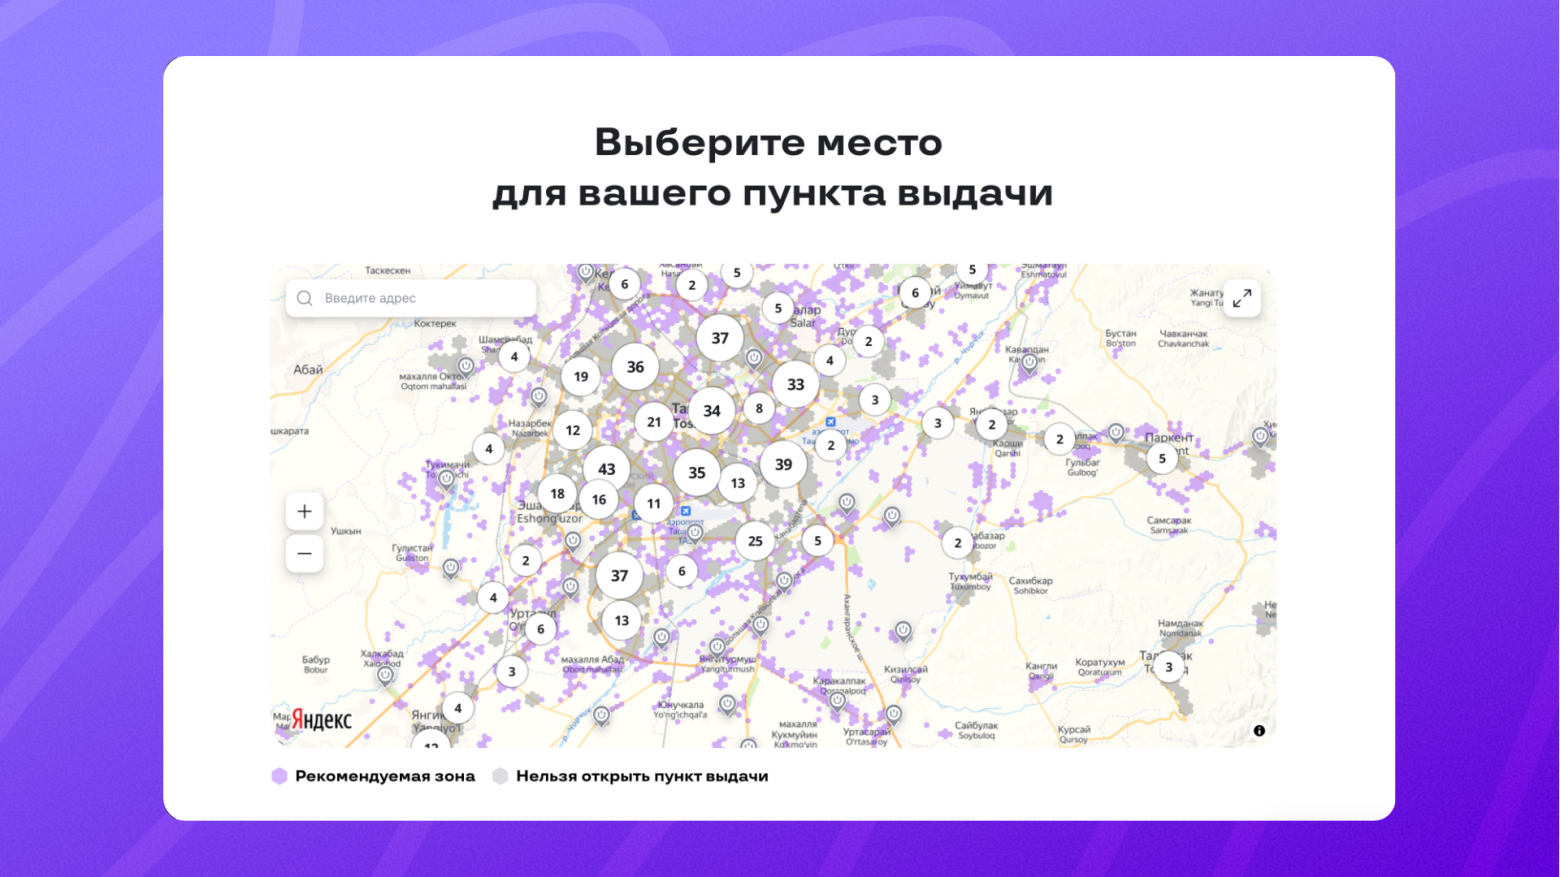
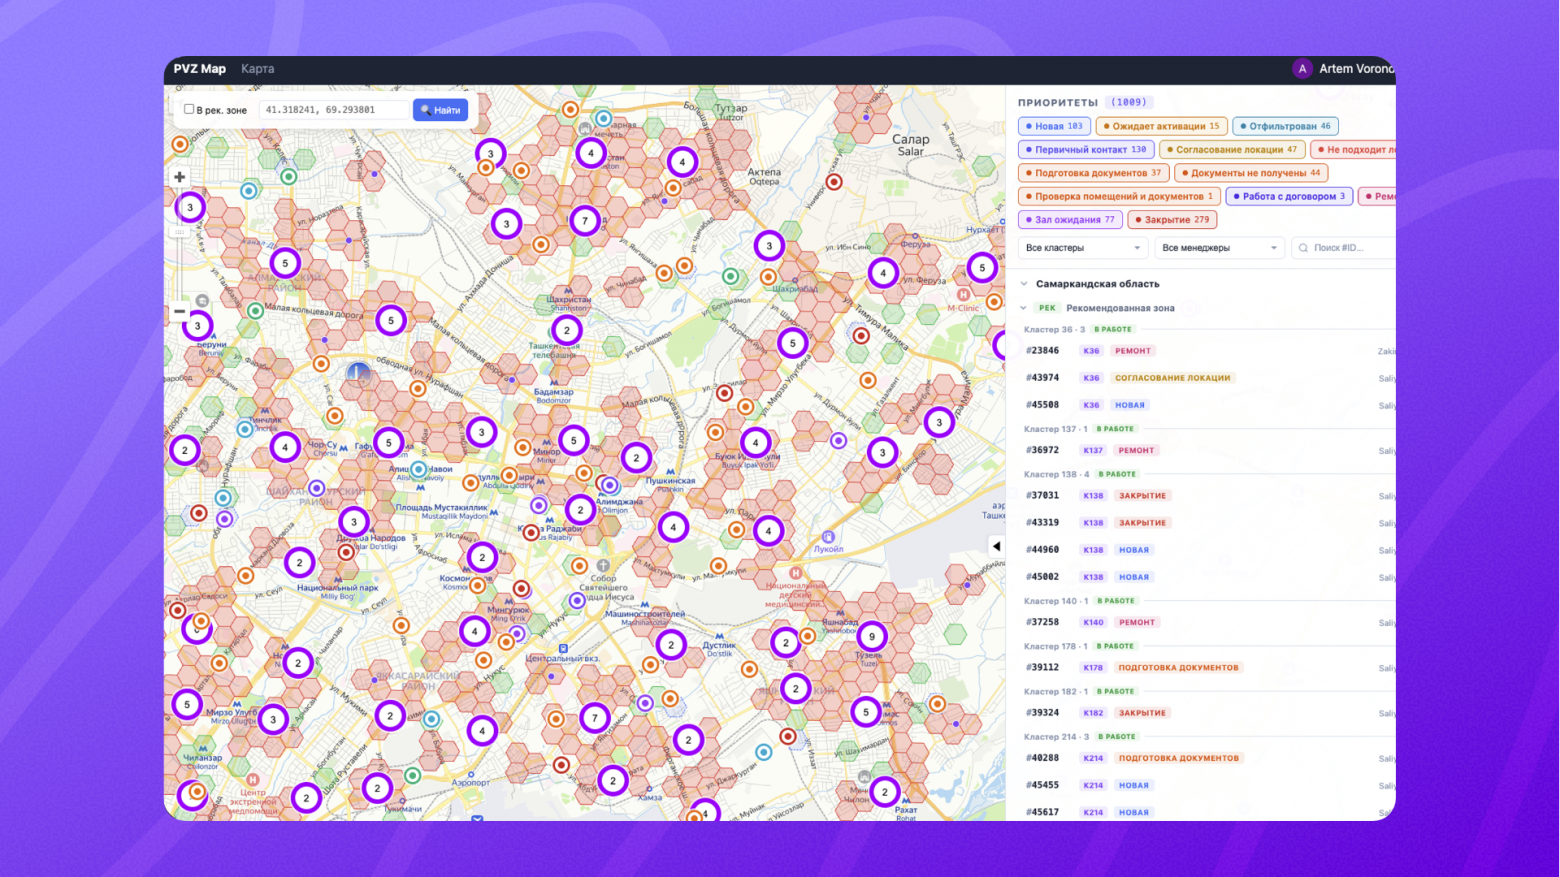
Три задачи, которые легко перепутать
Когда говорят «геоаналитика для розницы», обычно имеют в виду одну из трёх задач:
-
Оценить конкретное предложенное помещение. Пришёл арендодатель, вот адрес — сколько тут будет заказов?
-
Выбрать N лучших из пула предложений. Есть двадцать вариантов и бюджет на пять.
-
Сказать, где точка должна стоять в принципе — независимо от того, есть ли там свободное помещение.
Первая задача — регрессия: по признакам локации и истории открытий нужно предсказать число заказов. Вторая использует результат первой как ранжирование. Третья — комбинаторная оптимизация: при заданном распределении спроса и существующей сети нужно подобрать набор новых точек, который улучшит доступность.
Для этих задач нужны разные данные и метрики. Ошибаются они тоже по-разному.
Данные: что у нас есть
|
Слой |
В типовом российском кейсе |
У нас |
|---|---|---|
|
Население |
ЦПИ, Росреестр, БТИ |
Покупные данные по стране + собственная подомовая модель по Ташкенту |
|
Здания с атрибутами |
Адресный реестр, БТИ |
Есть по Ташкенту (муниципальный GIS-сервис) |
|
Перепись |
Регулярная |
1989 → 2026 |
|
Данные операторов связи |
Множество различных поставщиков |
Операторам связи запрещено делиться такими данными |
|
ОФД, обороты конкурентов |
Агрегаторы чеков |
Нет |
|
Адресный реестр |
ФИАС |
Нет |
|
POI |
2ГИС, Яндекс |
Коммерческие справочники организаций и OSM |
|
Контуры зданий по стране |
OSM + коммерческие |
Microsoft Building Footprints, AgeTashkent |
|
Собственные заказы |
Зависит от кейса |
Есть, включая территории без ПВЗ |
У нас нет единого адресного реестра, сопоставимого с ФИАС, и данных об оборотах конкурентов. Данные операторов связи пока не входят в контур проекта. Ниже разберу ограничения используемых слоёв.
Есть и свежий ориентир для проверки демографии. С 15 января по 28 февраля 2026 года в Узбекистане прошла первая со времён 1989 года перепись населения. По предварительным результатам Национального комитета по статистике, численность населения составила 39 047 321 человек — на 810 617, или примерно на 2,1%, больше текущей статистической оценки. Детализация итогов пока опубликована не полностью.
Покупные данные по населению и их проблемы.
Основной слой спроса по стране мы покупаем у коммерческого поставщика геоданных: оценки населения и индекс пешеходного трафика в разрезе гексагонов H3. Такие данные предлагают компании, занимающиеся геоаналитикой и геомаркетингом.
В нашем случае это таблица, где каждому гексагону сопоставлены оценка численности населения и индекс пешеходного трафика. Когда появилась собственная подомовая оценка по Ташкенту, мы впервые смогли сравнить два источника на одной территории.
Наша оценка строится на данных о жилых зданиях: их расположении, типе, площади и этажности. Каждому частному дому назначаем среднее число жителей — 3,35 человека. Для многоквартирных домов учитываем площадь контура и число этажей. Коэффициенты подбираем так, чтобы суммарное население каждого района совпадало с официальной численностью, а затем складываем оценки зданий внутри гексагонов H3.
Районные суммы в этой модели заданы заранее, но распределение жителей между домами остаётся приблизительным. Поэтому сравнение с покупным слоем показывает расхождения двух оценок. Само по себе оно не доказывает, какая из них точнее в конкретном гексагоне.
|
Что смотрим |
Результат |
|---|---|
|
Пропуски в данных (гексагоны отсутствуют) |
11,9% |
|
Гексы есть, но население = 0 |
1,1% |
|
Итого пропуски |
13,0% гексагонов, 12,3% населения города |
|
Сумма по общим гексагонам |
83% от нашей оценки — недоучёт около 17% |
|
Корреляция Пирсона / Спирмена |
0,845 / 0,903 |
|
Медиана отношения (их / наша) |
0,81 |
|
Медианная MAPE на гекс |
32%; у 26% гексов ошибка больше 50% |
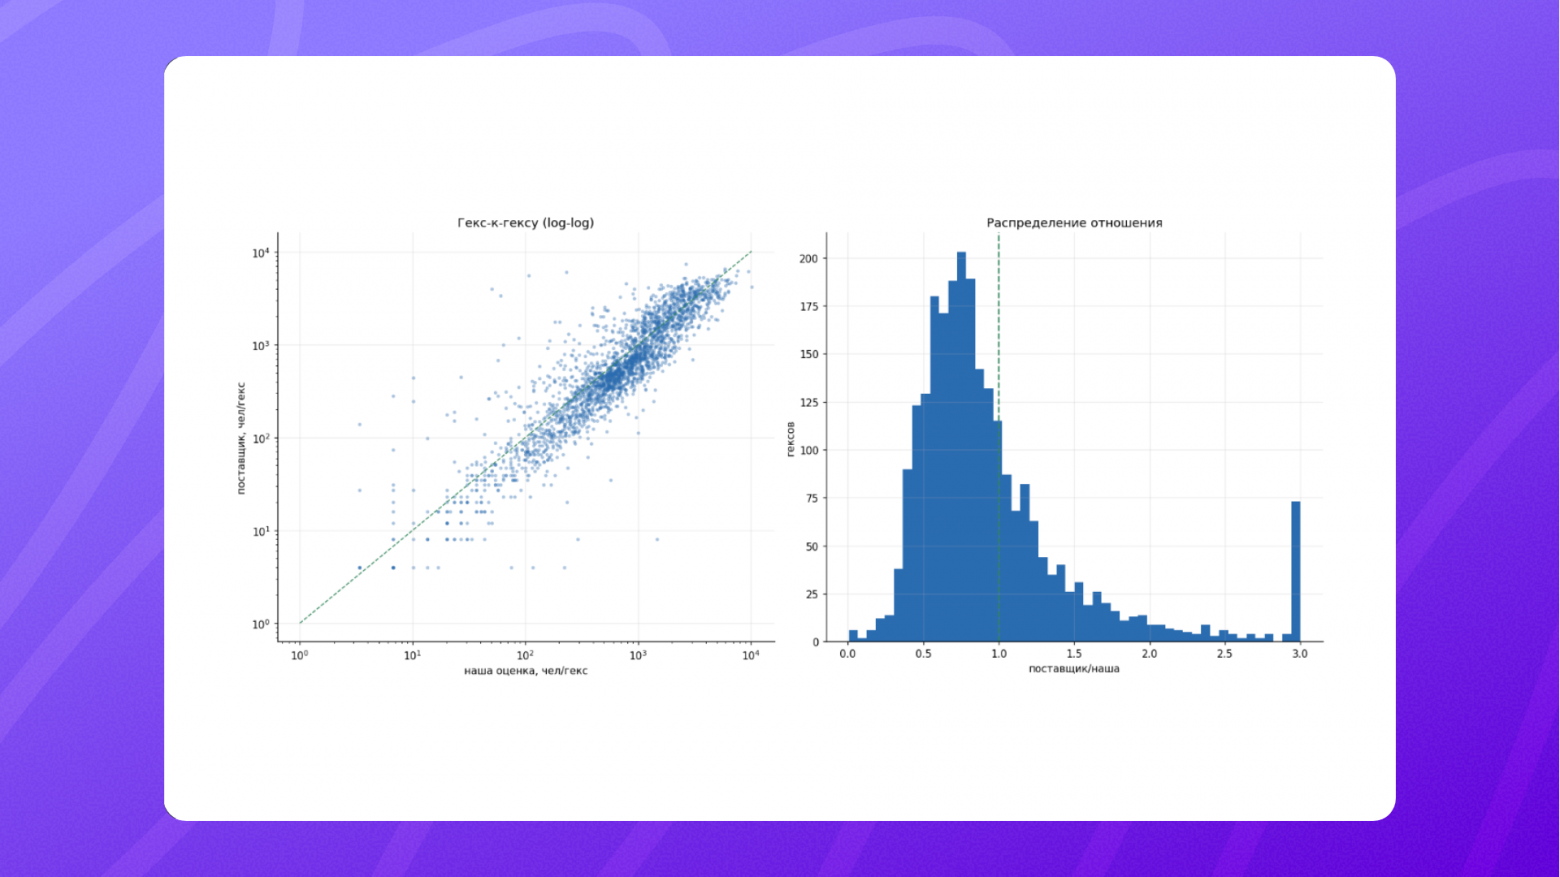
Корреляция 0,85 не описывает разброс между гексагонами. Десятый перцентиль отношения «поставщик / наша оценка» равен 0,46, девяностый — 1,63. Кроме того, 13% гексагонов с жильём отсутствуют или содержат нулевое население.
Для поиска новых точек мы отбирали только гексагоны, где население больше нуля. В результате эти 13% гексагонов не попадали на инференс. Низкого прогноза для них не было: модель их не видела.
Пока такой расчёт сделан только для Ташкента. При подготовке данных пришлось расшифровать типы зданий, проверить координаты, рассчитать площади и заполнить пропуски в этажности многоквартирных домов. После этого настроили распределение населения по зданиям с учётом районных итогов. Для остальных городов у нас пока нет сопоставимого набора характеристик зданий.
Прогноз заказов за 50 дней до открытия
Постановка задачи такая: за 50 дней до открытия нового ПВЗ предсказать число заказов отдельно для каждого из первых трёх 30-дневных периодов его работы.
Пятьдесят дней — максимальный срок от рассмотрения локации до открытия. Нам нужны три прогноза, а не одна сумма: точка, которая выходит на рабочий объём за месяц, и точка, которой требуется три месяца, предполагают разные решения по аренде и найму.
Единица наблюдения — гексагон H3 девятого разрешения, или в среднем около 0,1 км², умноженный на горизонт 30, 60 или 90 дней. Здесь горизонт обозначает день, к которому созрел соответствующий месячный таргет: дни 1–30, 31–60 или 61–90.
Кольцевые признаки
Основной приём — кольцевые агрегаты. Для каждого гексагона берём h3kRing радиуса 5, определяем расстояние в кольцах и считаем накопительные суммы населения, трафика и заказов в радиусе одного, двух, трёх и более колец. Добавляем агрегаты по родительским ячейкам уровней 8, 7, 6 и 5 — вплоть до масштаба района и города.
Расчёт кольцевых признаков
WITH nbrs AS (
    SELECT
        c.h3_index AS center_h3,
        arrayJoin(h3kRing(c.h3_index, 5)) AS nbr_h3,
        h3Distance(c.h3_index, nbr_h3) AS ring
    FROM candidates c
)
SELECT
    n.center_h3 AS h3_index,
    sumIf(g.population, n.ring = 0)  AS population,
    sumIf(g.population, n.ring <= 1) AS population_r1,
    sumIf(g.population, n.ring <= 3) AS population_r3,
    sumIf(g.traffic_index, n.ring <= 2) AS traffic_r2,
    sumIf(g.traffic_index, n.ring  = 2) AS traffic_ring_2
FROM nbrs n
LEFT JOIN geo_population g ON g.h3_index = n.nbr_h3
GROUP BY n.center_h3
traffic_ring_2 содержит трафик только во втором кольце. Вместе с накопительной суммой он описывает распределение активности вокруг кандидата: её концентрацию в центре или на периферии.
Всего используем более 50 признаков пяти семейств:
-
население и трафик по кольцам и родительским уровням H3;
-
активность пользователей приложения;
-
заказы и GMV вокруг кандидата;
-
расстояния до собственных объектов и их число в заданных радиусах;
-
количество организаций по категориям.
Валидация, когда таргет созревает три месяца
Прогноз строится в момент T, точка открывается не позднее T + 50, а последний таргет созревает ещё через 90 дней. Между расчётом признаков и полной проверкой проходит до 140 дней
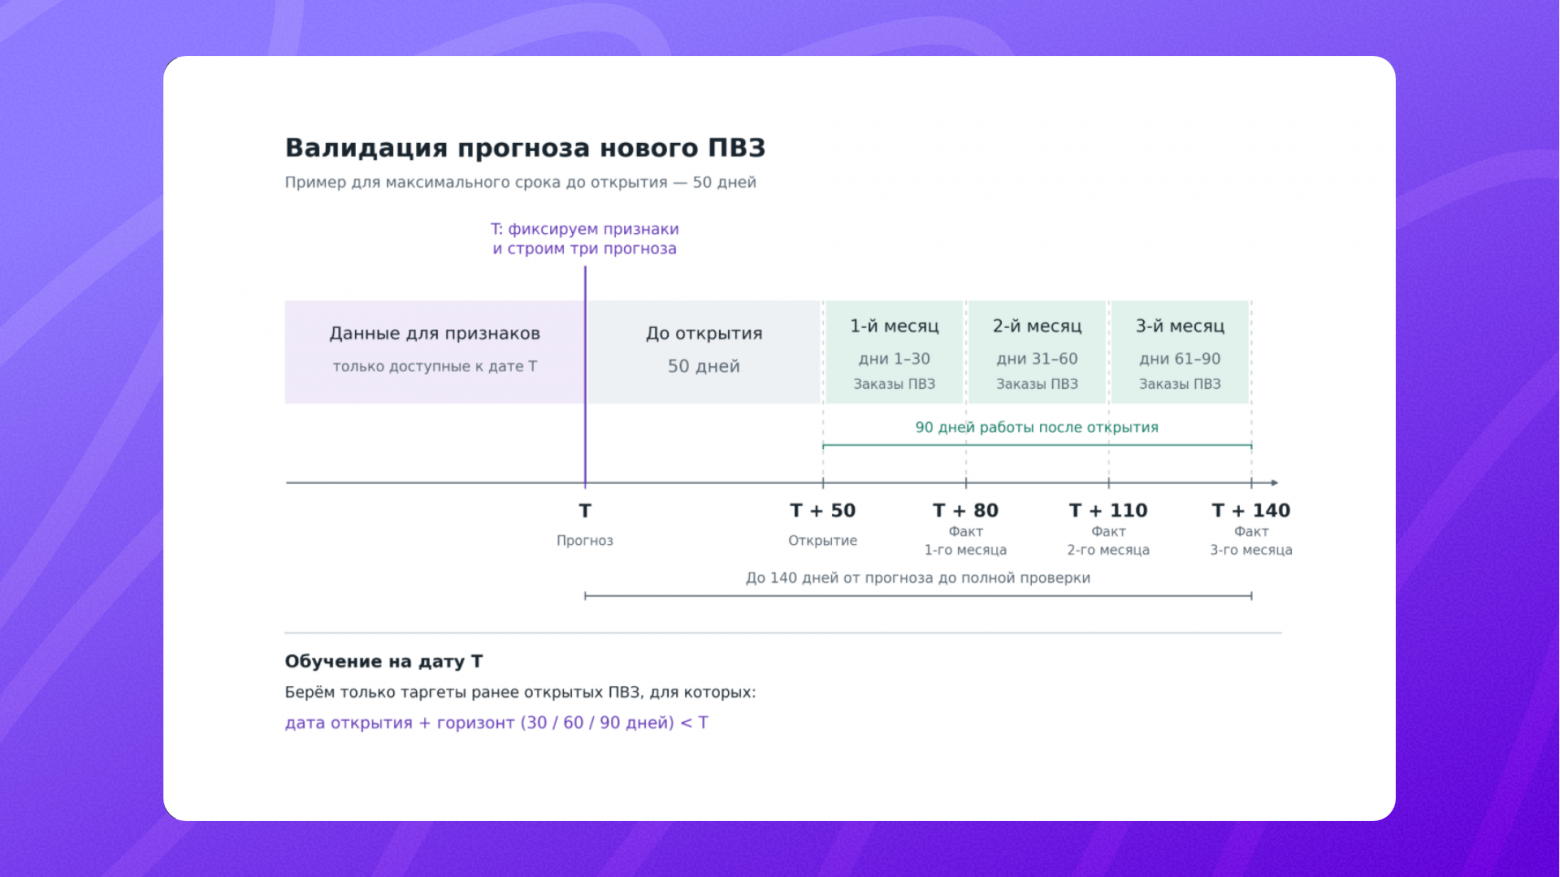
В обучение попадают только точки с уже созревшим таргетом. Для каждого горизонта проверяем, успела ли точка накопить соответствующие 30, 60 или 90 дней истории.
Отбор созревших таргетов для обучения
targets = (
    agg_df
    .unpivot(index=['delivery_point_id', 'open_date'],
             on=['30', '60', '90'],
             variable_name='target_horizon', value_name='orders_fact')
    .with_columns(pl.col('target_horizon').cast(pl.Int32))
    .filter(  # только созревшие таргеты
        pl.col('open_date') + pl.duration(days=pl.col('target_horizon'))
        < pl.lit(run_ds).str.to_date()
    )
)
Выборка растёт только по мере открытия новых ПВЗ. Поэтому мы ограничили глубину бустинга до 3, установили min_data_in_leaf=30 и отказались от моделей, которым требуется намного больше наблюдений.
V1 и три способа, которыми она ошибалась
Первая версия была псевдо-uplift-моделью на CatBoostRegressor: для контрольных наблюдений таргет принудительно обнулялся. Она прогнозировала один горизонт — 90 дней, использовала Tweedie(1.5) и переобучалась вручную. На свежих данных ошибка была заметно выше средней за весь период.
-
Ступенька на административной границе. На стыке Ташкентской и Сырдарьинской областей прогноз резко менялся по линии границы, хотя плотность населения меняется плавнее. Категориальный признак region получил слишком большое влияние: модель лучше различала регионы, чем гексагоны внутри них.
-
Прогноз в пустых гексагонах. Положительный спрос появлялся там, где население по входным данным было равно нулю. Население было одним из признаков наряду с трафиком, активностью пользователей и заказами вокруг. Нулевое значение этого признака само по себе не обнуляло прогноз: если остальные признаки указывали на высокий спрос, модель могла предсказать заказы и для такого гексагона. При этом часть нулей означала пропуски в данных — в этих местах действительно могли жить люди.
-
Рекомендации там, где ПВЗ уже работал. В таких гексагонах измеренный спрос выше, и модель его воспроизводила. Поверх прогноза пришлось добавлять правила: исключать кандидатов ближе заданного расстояния к существующей точке, исключать отдельные районы. Для одного города появился жёстко заданный список гексагонов. После этого мы пересмотрели постановку задачи.
V2: одна регрессия на три горизонта
|
Аспект |
V1 |
V2 |
|---|---|---|
|
Тип модели |
Псевдо-uplift (при treatment = 0 таргет обнуляется) |
Одна регрессия |
|
Горизонты |
Один, 90 дней |
Три одной моделью: 1-й / 2-й / 3-й месяц |
|
Переобучение |
Ручное |
Ежедневное, автоматическое |
|
Функция потерь |
Tweedie(1.5) |
RMSE (log(target)) |
В V2 мы отказались от uplift-конструкции и превратили горизонт в признак. Модель видит target_horizon ∈ {30, 60, 90} и обучается на трёх строках для каждого открытия. Это не создаёт три независимых открытия, но позволяет одной модели использовать наблюдения всех горизонтов.
Обучение модели и прогноз на три горизонта
train_pool = Pool(
    data=train_data.select(features_to_use).to_pandas(),
    label=np.log1p(train_data.select(['orders_fact']).to_pandas()),
    cat_features=['month', 'region'],
)
model = CatBoostRegressor(**params)
model.fit(train_pool)

# инференс: три прогона одной модели с разным флагом горизонта
f30 = np.expm1(model.predict(prepare(test_data, horizon=30)))
f60 = np.expm1(model.predict(prepare(test_data, horizon=60)))
f90 = np.expm1(model.predict(prepare(test_data, horizon=90)))
На последних шести месяцах получили такие изменения относительно V1:
|
Метрика |
Изменение V1 → V2 |
|---|---|
|
WAPE |
−10 п.п. |
|
WAPE на последнем месяце |
−15 п.п. |
|
Корреляция прогноза с фактом |
выросла практически вдвое |
Разрыв между средней ошибкой и ошибкой на самом свежем месяце у V1 достигал почти 15 п. п. После перехода на ежедневное переобучение он практически исчез.
В V2 мы обновили модель и перешли на ежедневное переобучение. После этих изменений WAPE снизилась на 10 п. п.
Рекомендации используются начиная с верхней части списка кандидатов. Поэтому вместе с WAPE мы измеряем качество ранжирования локаций.
Тюнинг V1 — новые признаки, варианты таргета и гиперпараметры — дал меньше, чем смена постановки. Другие варианты uplift-моделирования тоже не улучшили результат.
В V2 расстояние до ближайшего ПВЗ и количество точек вокруг стали обычными признаками. В итоге модель сама снижает прогноз заказов для новой точки в местах, где рядом уже работают наши ПВЗ. Дополнительный фильтр после расчёта прогноза для этого больше не нужен.
Каннибализация: KNN по похожим открытиям
Прогноз новой точки не показывает, какая доля её заказов перейдёт из уже работающих ПВЗ. Для более строгой причинной оценки можно использовать историю открытий, difference-in-differences или синтетический контроль, но наблюдений для устойчивой модели пока недостаточно.
Сейчас используем приближение на основе похожих случаев. Берём ПВЗ, открытые не менее 60 дней назад, для которых уже рассчитана фактическая каннибализация за первые два месяца. Для кандидата находим пять ближайших аналогов в стандартизированном пространстве признаков с L1-метрикой.
Итоговый прогноз — взвешенное среднее каннибализации пяти аналогов. Более свежие открытия получают больший вес.
Оценка каннибализации по пяти аналогам
knn = NearestNeighbors(n_neighbors=5, metric='l1')
knn.fit(scaler.fit_transform(X_train))
distances, indices = knn.kneighbors(scaler.transform(X_pred))

def weighted_prediction(similar_ids):
    similar = data.loc[data.index.isin(similar_ids)]
    days_since_open = np.clip(
        (analyze_dt - similar['open_date']).dt.days.astype(float), 0, None)

    denom = days_since_open.sum()
    weights = np.ones(len(similar)) if denom <= 0 else 1 - days_since_open / denom
    weights = weights / weights.sum()

    return float((similar['cannibalization_2m'].values * weights).sum())
От гексагона к зданию
Гексагоны удобны для агрегации, но могут быть слишком грубыми для выбора помещения.
Представим соседние гексагоны A и B. В A рассматриваем открытие, а в B уже работает ПВЗ. Он может находиться у общей границы или на противоположной стороне ячейки. Для H3 девятого уровня разница достигает нескольких сотен метров — для пешей доступности это уже «через дорогу» и «в другом квартале».
Поэтому часть признаков мы перенесли на уровень конкретной точки: считаем точное расстояние до ближайшего ПВЗ и других объектов, используем радиусы 50, 100 и 200 метров вместо одних только колец, различаем объекты внутри одного гексагона.
В нашей проверке значение WAPE снизилось ещё на 2 п. п. относительно гексагональной версии. Предыдущие 10 п. п. были результатом сразу нескольких изменений модели и процесса обучения; эти 2 п. п. появились после смены пространственной единицы и пересчёта признаков.
Оптимизатор размещения
У нас есть регулярная витрина с метрикой «расстояние до населения»: для каждого гексагона берётся население, считается расстояние по большому кругу от центра гексагона до ближайшего активного ПВЗ, и метрика — это среднее расстояние, взвешенное по населению:
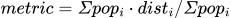
Получается среднее расстояние, взвешенное по населению: «по нашей модели житель Ташкента находится в среднем в N метрах по прямой от ближайшего ПВЗ».
После появления подомового слоя мы пересчитали метрику по координатам зданий с тем же набором ПВЗ. Результат отличался от гексагональной версии менее чем на 1,5%. Такое совпадение проверяет согласованность расчётов на уровне города. Точность распределения населения внутри районов по нему оценить нельзя.
Жадный алгоритм с ленивой переоценкой
Оптимизатор подбирает новые точки до тех пор, пока среднее расстояние не опустится до заданного уровня.
Это дискретная задача размещения объектов, или facility location. Спрос представлен жилыми зданиями, объединёнными в ячейки со стороной около 100 метров; вес ячейки равен оценке её населения. Кандидаты — центроиды населённых ячеек. Расстояния до существующих ПВЗ задают начальное состояние оптимизатора.
Точное решение на полном наборе кандидатов дорого, поэтому используем жадную эвристику: на каждом шаге выбираем точку с максимальным уменьшением метрики. По мере добавления ПВЗ предельный выигрыш любого оставшегося кандидата не растёт. Это свойство позволяет хранить старые оценки в куче и пересчитывать только её верхушку. Если обновлённая верхняя оценка всё ещё максимальна, можно выбирать кандидата, не проходя по всему списку.
Жадный выбор новых локаций
heap = [(-gain_of(c)[0], c, 0) for c in range(nC)]
heapq.heapify(heap)

while heap and remaining_thresholds:
    neg, c, stamp = heapq.heappop(heap)
    if used[c]:
        continue

    if stamp != cur_stamp:
        g, _, _ = gain_of(c)
        if g > 0:
            heapq.heappush(heap, (-g, c, cur_stamp))
        continue

    g, ii, eff = gain_of(c)
    dcur[ii] = np.minimum(dcur[ii], eff)
    used[c] = True
    cur_stamp += 1
В расчёте заданы два ограничения:
Нижняя граница расстояния. Если ПВЗ и дом попали в одну ячейку, расстояние между их центрами равно нулю. Это зануляет вклад жителей ячейки и делает оценку доступности слишком оптимистичной. Мы используем нижнюю границу 50 метров — примерно половину шага сетки.
Радиус влияния. В модели новая точка улучшает доступность только для жителей в пределах 1,5 км. Это заданное нами ограничение, а не геометрическое свойство задачи. Соседей внутри радиуса один раз находим через BallTree с haversine-метрикой, что заметно сокращает число попарных расчётов.
Что показывает кривая насыщения
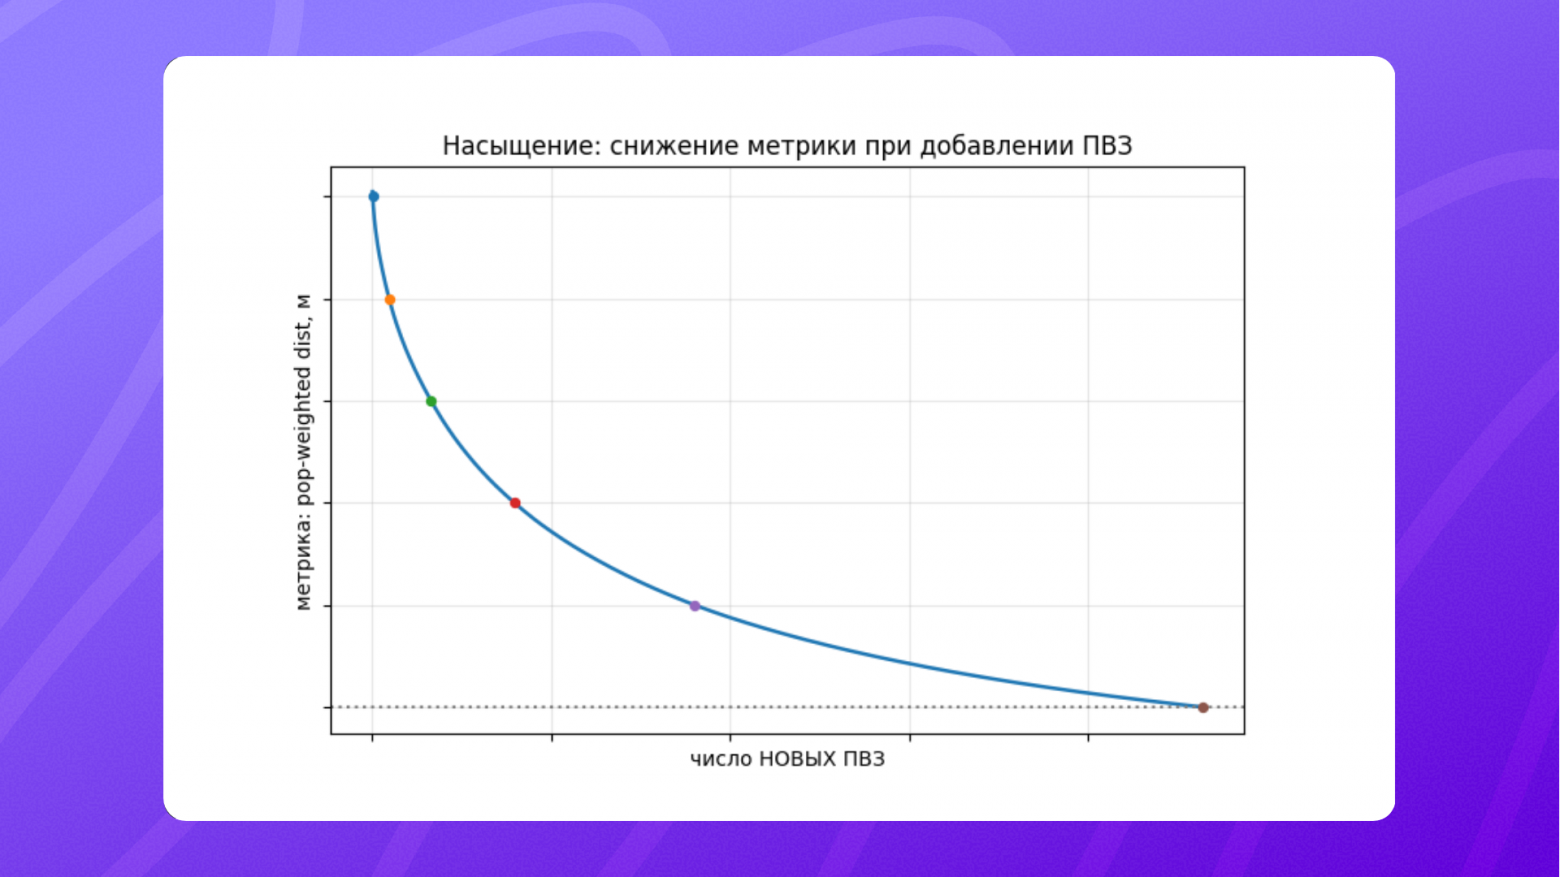
После каждого шага оптимизатора мы сохраняем новое значение метрики. По этим значениям строится кривая зависимости среднего расстояния от числа добавленных точек. На ней видно, как уменьшается вклад каждого следующего открытия.
Например, в Яккасарайском районе целевое значение достигается после добавления восьми точек. Среднее расстояние при этом снижается примерно на четверть. Команда развития сети получает восемь координат для дальнейшего поиска помещений.
Для всего города форма кривой похожа. Чтобы сократить метрику вдвое, сеть нужно увеличить в несколько раз; затем кривая выходит на пологий участок, где очередные открытия дают лишь небольшой выигрыш. По этой кривой оцениваем требуемый масштаб расширения сети при разных целевых значениях метрики.
Инструмент для what-if-сценариев
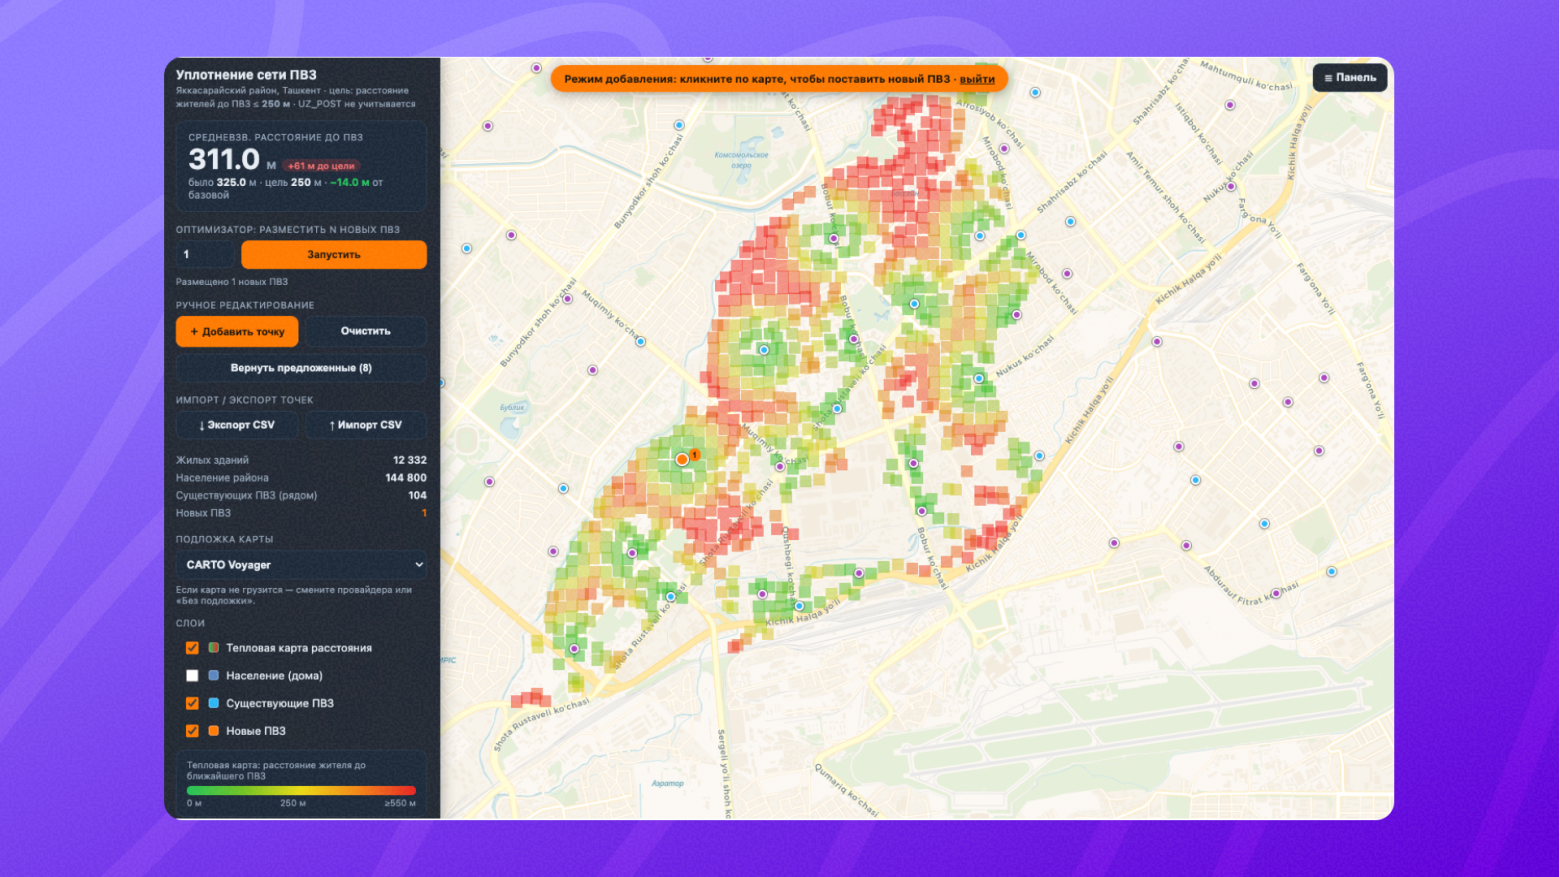
Расчёт по фиксированному списку кандидатов не учитывает расположение доступных помещений. Поэтому пользователю нужно вручную добавить точку или сдвинуть рекомендацию, например на 200 метров, и пересчитать метрику.
Мы собрали интерактивный инструмент с детализацией по каждому из 12 районов Ташкента. В нём есть:
-
подомовой слой населения, где размер маркера пропорционален числу жителей;
-
тепловая карта расстояния до ближайшего ПВЗ;
-
значения «было / сейчас / цель» с пересчётом в реальном времени;
-
запуск оптимизатора для заданного числа новых точек;
-
ручное добавление, удаление и перемещение точек;
-
импорт и экспорт координат в CSV.
Для JavaScript- и Python-реализаций мы проверяем равенство выходных координат и значения метрики на одинаковых входных данных.
Чтобы строить признаки на уровне зданий, нужно знать их координаты и хотя бы приблизительно распределить по ним население.
Почти 370 000 зданий Ташкента
Для Ташкента мы использовали данные по отдельным зданиям: контуры, адреса, год постройки, район и тип здания.
Что с этими данными не так:
-
Этажность заполнена у 3% объектов. У 96,9% в поле
floorsстоит ноль, и это означает отсутствие информации, а не «ноль этажей». Значения больше нуля есть у 11 093 зданий, максимум — 26. Но есть дополнительные признаки: заполнена этажность в основном именно у многоквартирных домов — там она известна у 95%. -
Год постройки содержит много ошибок. Медиана 1963, но есть значения меньше 1800 и одно отрицательное (−200).
-
Некорректным координатам верить нельзя. Часть построек лежат вне административных границ Ташкента. Надёжный источник — центроид из полигона, он есть у 100% объектов.
Основные типы в выгрузке распределены так: 267 000 индивидуальных домов, 54 000 «специальных» объектов, которые мы также относим к частному сектору, 29 000 нежилых и 11 500 многоквартирных зданий. Остальные типы составляют небольшую часть набора.
Как распределить 3,18 миллиона человек по зданиям
Нужно было распределить официальную оценку в 3,18 млн жителей Ташкента по жилым зданиям.
Первый вариант — пропорционально площади контура — плохо работает в частном секторе. Большой дом не обязательно означает большую семью, и площадь здания слабо предсказывает количество жильцов. Разбиение площади на интервалы тоже не помогло: доли таких интервалов сильно связаны с районами, и районная калибровка давала нестабильные коэффициенты.
В результате модель получилась двухкомпонентной:
-
частный дом — константа k, то есть среднее число жителей на одно здание; площадь не используется;
-
многоквартирный дом — rho[район] × footprint × floors, где rho задаёт районную плотность населения на единицу рассчитанной жилой площади.
Сначала по данным 12 районов оцениваем глобальные коэффициенты k и rho взвешенным методом наименьших квадратов. Вес района обратно пропорционален его населению, поэтому оптимизируется относительная, а не абсолютная ошибка.
Подбор коэффициентов подомовой модели
def calibrate(df, footprint, d_eff):
    """Подобрать глобальные (k, rho) по данным 12 районов."""
    is_house, is_apt, area_apt = _features(df, footprint)
    codes = list(OFFICIAL_DISTRICT_POP)
    off = np.array(
        [OFFICIAL_DISTRICT_POP[c] for c in codes],
        dtype=float,
    )
    w = 1.0 / off
    # Признаки района: число частных домов и площадь
    A = np.array([
        [
            int((is_house & (d_eff == c)).sum()),
            area_apt[is_apt & (d_eff == c)].sum(),
        ]
        for c in codes
    ], dtype=float)
    k, rho = lsq_linear(A * w[:, None], off * w, bounds=bounds).x
    return k, rho
Для итогового распределения фиксируем k, а районный коэффициент rho выбираем так, чтобы сумма оценок совпала с официальной численностью района. В частном доме получилось в среднем 3,35 жителя.
Итоговая оценка: 2,1 млн человек в многоквартирных домах и 1,08 млн в частном секторе — 66% против 34%. Медианный многоквартирный дом получает 152 жителя, максимальная оценка для одного здания — 1 351 человек.
У метода есть принципиальное ограничение. Районные суммы совпадают с официальными данными по построению, а значит, этими же суммами модель валидировать нельзя. Если в одном районе оцифрована лишь часть зданий, rho автоматически компенсирует пропуск и окажется завышенной.
Что дальше: перенести модель с Ташкента на всю страну
Подомовой слой пока работает только в Ташкенте. Следующая задача — использовать аналогичный подход в крупных городах таких как Наманган, Самарканд, Андижан и др. Контуры Microsoft дают геометрию зданий по стране, а снимки Sentinel-1 и Sentinel-2 — признаки для определения типа здания и этажности. Отдельная сегментационная модель нужна там, где готовые контуры отсутствуют или недостаточно точны. Качество переноса будем измерять отдельно: застройка Ташкента отличается от областных центров.
В планах также:
-
считать пешеходную доступность по графу OSM вместо расстояния по прямой: учитывать реальные маршруты, каналы, железные дороги и магистрали без переходов;
-
исследовать доступные способы использования агрегированных данных операторов связи для оценки дневного населения и трафика;
-
Также планируем сравнить подомовую оценку населения по районам с итогами переписи 2026 года. По официальному графику публикация окончательных результатов запланирована к ноябрю 2027 года.
Что мы сделали бы иначе
-
Измерить чужие данные до того, как на них строить. Мы пользовались покупным слоем населения довольно долго и только потом узнали, что 13% гексагонов с жильём в нём отсутствуют. Сравнить было не с чем — но и попытки такой не было.
-
Различать «нет людей» и «нет данных». Фильтр
population > 0выглядит безобидно ровно до момента, когда выясняется, что именно он вырезает. -
Не строить uplift там, где не хватает данных на обычную регрессию. Смена постановки дала больше, чем долгий тюнинг предыдущей версии.
-
Сделать горизонт признаком сразу. Одна модель на три горизонта утраивает обучающую выборку.
-
Не наращивали бы слой ручных исключений. Жёстко заданные фильтры маскировали проблемы постановки и признаков.
-
Смотрели бы на карту вместе с агрегированными метриками. Ступенька на границе областей неочевидна по одному значению WAPE, но сразу заметна визуально.
-
Измерить разброс внутри единицы агрегации до того, как её выбрать. Минусы гексагона мы выписали заранее, но не посчитали. Если бы сразу увидели ошибку в два диаметра, к зданиям пришли бы намного раньше.
-
Сразу добавили бы ручное редактирование сценария. Оно позволяет пересчитать метрику для доступных помещений, которых нет в списке кандидатов оптимизатора.
Следующий материал планируем посвятить переносу подомовой модели с Ташкента на другие города. Учтём прошлые ошибки и расскажем про качество модели на новых территориях.
Автор: voronoffart

