


Ранее мы рассказывали о библиотеке FAIRouter, которая направляет запрос к наиболее подходящему исполнителю. Пока исполнителями могут быть только языковые модели (LLM), но в дальнейшем мы планируем добавить инструменты и агентов. В той статье вопрос о том, как именно маршрутизатор решает, кому отдать задачу, был затронут лишь вскользь. Поэтому было принято решение посвятить математике отдельную статью и разобрать ее по шагам: от признаков задачи до обучения на отзывах.
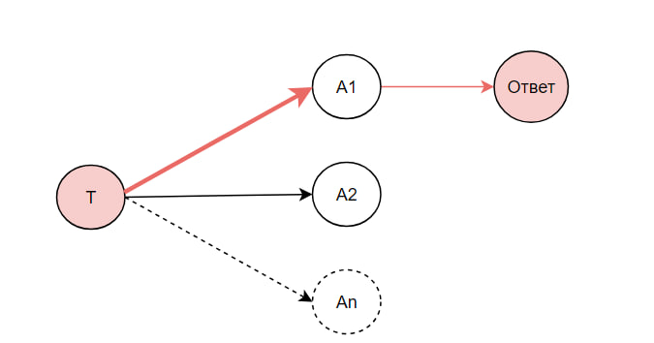
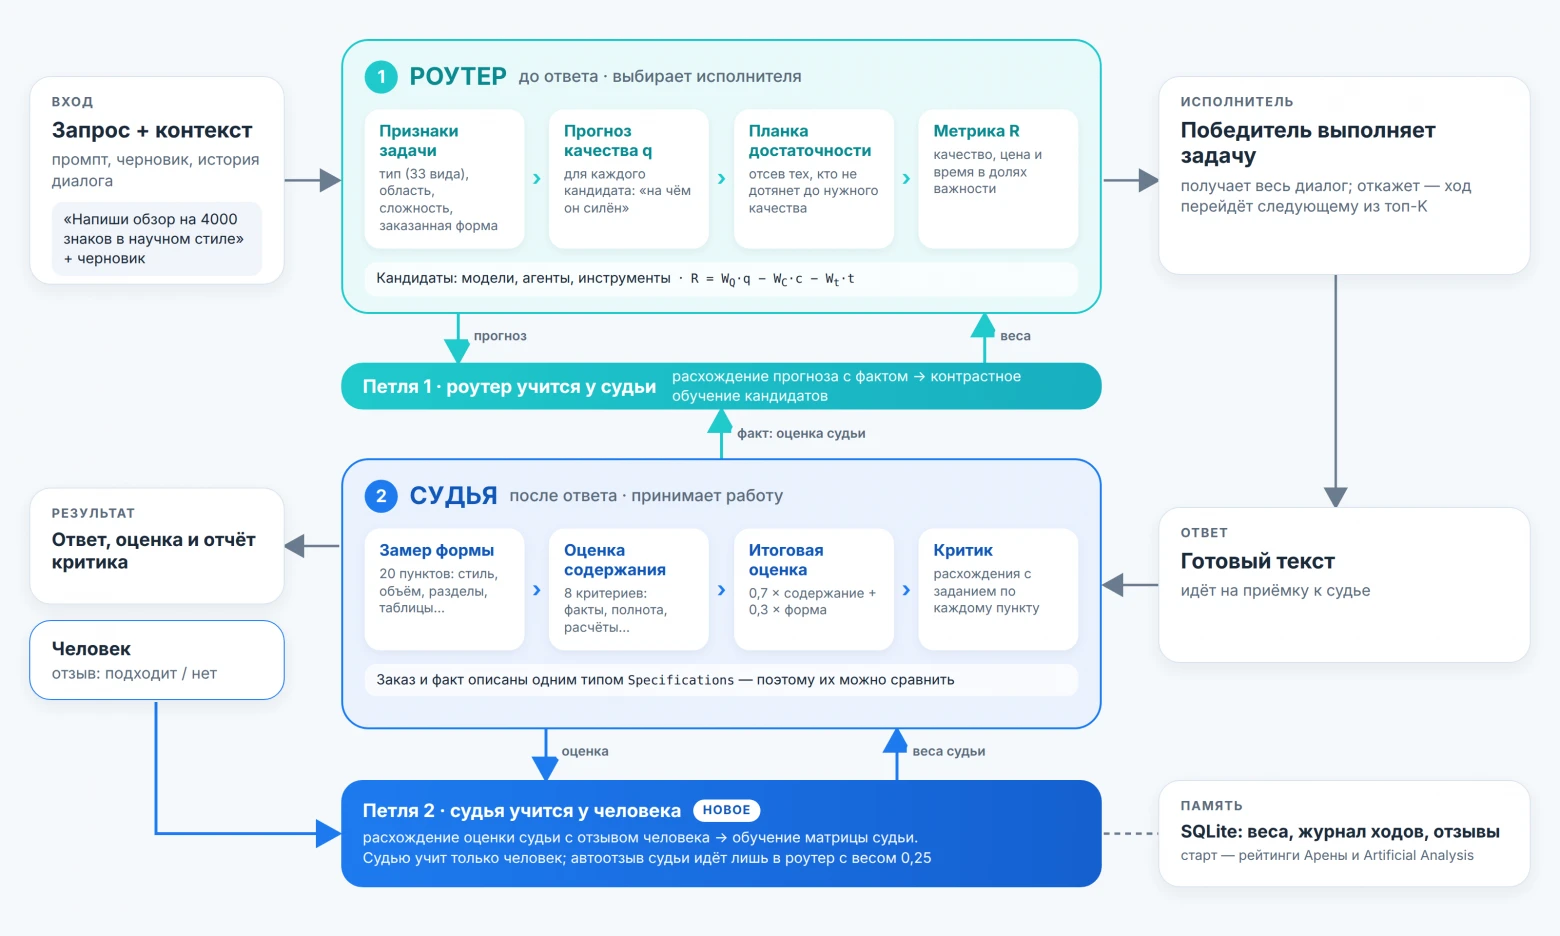
В основе проекта лежала простая формула, которая затем эволюционировала в ходе практического тестирования. Большинство описанных ниже решений появились как естественная реакция на ограничения первой версии. В этой статье мы покажем путь развития библиотеки. Схематично маршрутизацию одной задачи можно изобразить так.
Общая логика системы приведена на рисунке 2.
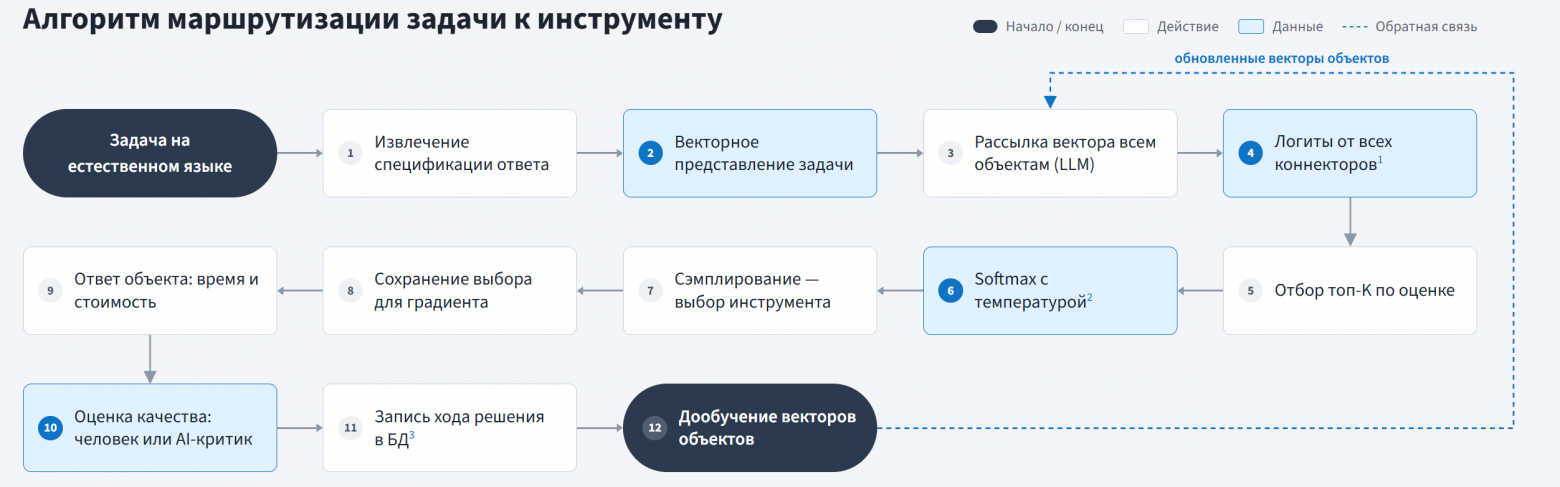
Задача приходит в виде текста на естественном языке. Сначала из нее извлекается спецификация, т.е. описание того, каким должен быть ответ: объем, структура, стиль, язык и так далее. После чего строится векторное представление задачи, и этот вектор передается всем объектам маршрутизации. Каждый объект возвращает логит, т.е. ненормированную оценку того, насколько хорошо он справится с задачей. Из них отбираются K лучших, по их оценкам с помощью функции softmax с температурой строится распределение вероятностей, и исполнитель выбирается случайно по этому распределению. Выбор сохраняется, для того чтобы после отзыва пользователя или автоматического критика можно было посчитать градиент по всей цепочке и обновить векторы исполнителей и матрицу проекции критика (об этом ниже).
Температура считается для каждого объекта отдельно и обратно пропорциональна корню из числа оценок, на которых он обучен. Чем больше у объекта статистики, тем ниже температура и тем ближе результат сэмплирования к аргмакс, т.е. выбора лучшей, по мнению системы, объекта. Таким образом, баланс между разведкой и использованием регулируется автоматически. Температура группы равна средней температуре по K лучшим объектам. В базу данных записывается ход решения: какие объекты участвовали, оценки цены и времени для каждого из них и оценка качества ответа от человека или автоматического критика, а также реальные данные биллинга и замеры по времени.
Статью мы разбили на восемь частей: в первых шести описана работа маршрутизатора и судьи, в седьмой эксперимент, в восьмой направление дальнейшего развития. Ниже рассмотрим каждую из них.
Часть 1. Вектор задачи
Первое, с чего начинается маршрутизация, это перевод задачи на естественном языке в вектор фиксированного размера. От того, насколько удачно это сделано, зависит все остальное: если по вектору нельзя отличить научную статью от сказки для детей, маршрутизатор не сможет отдать их разным исполнителям. Для того чтобы измерить качество представления, мы используем квадрат коэффициента корреляции Пирсона (доля объяснимой дисперсии) между фактической оценкой  и ее предсказанием
 :
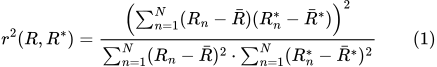
Сама оценка  для задачи
 задается выражением (2):
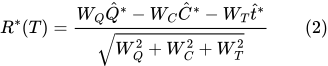
где  ,
 и
 означают приведенные к общему масштабу прогнозы качества, цены и времени, а
 ,
 и
 их веса. Как получается каждая из этих величин, будет показано в следующих частях.
Вектор задачи состоит из двух частей, на первых 7ми позициях стоят свойства самой задачи: длина запроса, ожидаемая длина ответа, длина диалога, число ограничений, требуемая экспертность, сложность и опора на факты (последние три в долях от 0 до 1). За ними идет вектор спецификации ответа.
Логарифмическая шкала
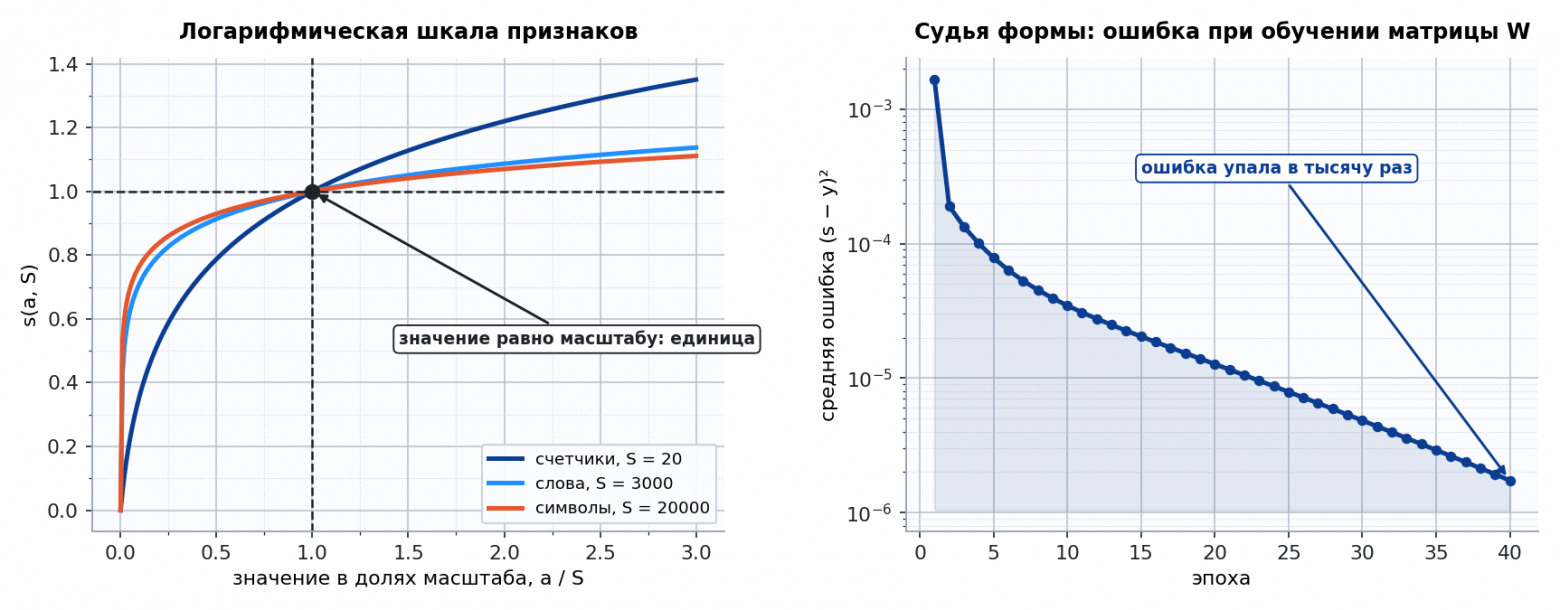
Изначально объемы и счетчики попадали в вектор в линейном масштабе, в символах, абзацах и токенах. Тестирование показало, что при такой записи объем в символах занимает 98% длины вектора, и остальные признаки почти не влияют на прогноз. К тому же для таких величин важна не разность, а отношение: ответ на 2000 символов отличается от ответа на 1000 гораздо сильнее, чем ответ на 21 000 от ответа на 20 000. Поэтому мы решили делить каждое поле  на типичный масштаб
 под логарифмом:
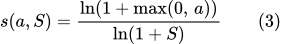
Значение, равное масштабу, переходит в единицу, иногда языковая модель при разборе задачи возвращает отрицательное число, такие значения обрезаются до нуля. Масштабы были подобраны под различные метрики, они представлены в таблице ниже.
|
Поле |
Масштаб S |
|
Объем в символах |
20 000 |
|
Объем в словах |
3 000 |
|
Абзацы, разделы, пункты списков, таблицы, блоки кода, формулы |
20 |
|
Глубина заголовков |
6 |
|
Средняя длина предложения |
40 |
|
Длина запроса в токенах |
2 000 |
|
Ожидаемая длина ответа в токенах |
7 000 |
|
Число реплик пользователя минус одна |
10 |
|
Число явных ограничений |
10 |
Читаемость делится на 100. Доля терминологии и формальность и так лежат в отрезке от 0 до 1, поэтому входят в вектор без изменений.
Размерность
Вектор спецификации состоит из кодов «один из многих» и чисел (вектор нулей с единицей на позиции нужного класса): стиль (10 разрядов), 13 числовых метрик, предметная область (15), язык программирования (11), область науки (10), тип задачи (34), язык текста (10) и признак ссылок на источники (1). Вместе с семью свойствами задачи получается:
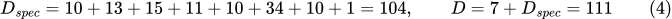
Спецификация одного и того же вида описывает и заказ, и готовый ответ, поэтому их можно сравнивать напрямую. На этом построен автоматический оценщик качества решения, подробнее о нем будет рассказано в части 6.
Вектор  нормируется к единичной длине:
 . Длину запроса в токенах мы оцениваем по числу символов
 , считая три символа на токен. Длина ответа берется из спецификации, а если объем в задаче не указан, то ответ считается вдвое длиннее запроса:
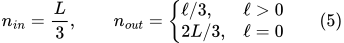
где  означает заказанный объем ответа в символах.
Центрирование
Векторы реальных задач оказались очень похожи друг на друга: все они лежат в узком конусе, и скалярное произведение с весами кандидата слабо зависит от того, какая задача пришла. Для того чтобы лучше различать задачи, перед прогнозом и обучением из вектора вычитается среднее по журналу ходов, а длина снова приводится к единице:
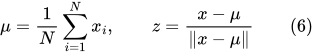
Шаг обучения меняет прогноз пропорционально квадрату длины вектора задачи, а после вычитания среднего вектор укорачивается в несколько раз. С нормировкой число удачных запусков на контрольном тесте выросло с 4 до 18 из 20. Среднее вычисляется один раз, при первом обучении, и после этого не меняется, так как веса кандидатов обучены именно в этом пространстве.
Часть 2. Прогноз качества, цены и времени
У каждого кандидата  есть обучаемый вектор
 той же размерности, что и вектор задачи, а прогноз качества равен их скалярному произведению:
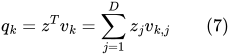
Веса в этом выражении имеют простой физический смысл: каждая координата вектора  показывает, насколько кандидат силен в задачах с соответствующим признаком. Если у модели большой вес на разряде «программирование», то задачи по программированию будут доставаться ей чаще.
Стоит отметить, что прогноз относительный, т.е. по нему можно сказать, что один кандидат лучше другого, но нельзя сказать, справится ли кандидат с задачей вообще. Для этого нужна калибровка, она описана в части 4.
Если начальных весов у кандидата нет, вектор заполняется случайно по схеме Ксавье. При таком разбросе прогноз на старте не зависит от числа признаков:
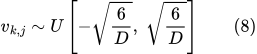
Стоимость хода считается по стоимости входных и выходных токенов кандидата:
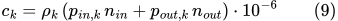
где  и
 означают цены миллиона входных и выходных токенов, а
 поправку на то, что реальный ход обычно дороже прайса: модель тратит токены на рассуждения, а ответ иногда приходится переделывать.
Время ответа оценивается по скорости кандидата  в токенах в секунду, добавка 0.1 в знаменателе защищает от деления на ноль:
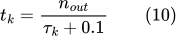
Часть 3. Как свести качество, цену и время в одну оценку
Эта часть претерпела наибольшие изменения по сравнению с первой версией. Качество, цена и время измеряются в разных единицах: качество порядка единицы, цена хода порядка тысячных долей доллара, время в секундах. Если складывать их напрямую, вклад цены получается в 1156 раз меньше вклада качества, и веса почти не влияют на выбор.
Поэтому каждая величина приводится к нулевому среднему и единичному разбросу внутри группы кандидатов, которые прошли отсев по возможностям:
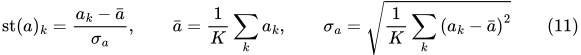
Цена и время у разных кандидатов различаются в разы и даже в десятки раз, поэтому их мы стандартизуем под логарифмом. Нижняя граница цены  нужна для бесплатных моделей, у которых логарифм иначе ушел бы в минус бесконечность:
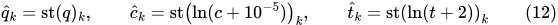
Эти три величины подставляются в выражение (2). Деление на длину вектора весов делает оценку безразмерной, поэтому при смене весов не приходится заново подбирать температуру. Если в группе один кандидат или у всех кандидатов величина одинакова, то соответствующее слагаемое равно нулю и на выбор не влияет.
После такого приведения веса означают именно то, что от них ожидаешь, т.е. относительную важность качества, цены и времени. В библиотеке есть три готовых профиля, они представлены в таблице ниже.
|
Профиль |
W_Q / W_C / W_T |
Назначение |
|
quality |
0.8 / 0.1 / 0.1 |
качество прежде всего |
|
balance (по умолчанию) |
0.5 / 0.25 / 0.25 |
качество наравне с ценой и временем |
|
price |
0.3 / 0.6 / 0.1 |
экономия |
Похожее разделение встречается и в других коммерческих решениях, например, у Sakana есть два продукта, Fugu Max и Fugu Ultra v2: первый ищет наилучший результат при наименьшей цене, второй наибольшее качество на сложных многошаговых задачах. По сути они соответствуют профилям price и quality, с той разницей, что в FAIRouter профиль переключается адаптивно во время. Кроме того, набор моделей и логика выбора у Fugu закрыты, а судьи и обучения на отзывах человека в них нет. В FAIRouter можно подключить любых поставщиков, а сам выбор открыт и обучается на отзывах. Обе модели Sakana доступны через OpenRouter, поэтому их можно просто добавить в FAIRouter как кандидатов.
Далее в выборе участвуют  кандидатов с наибольшей оценкой, по умолчанию пять.
Выбор с температурой
По оценкам  лучших строится распределение вероятностей, и исполнитель выбирается случайно. Если всегда брать кандидата с максимальным баллом, маршрутизатор никогда не узнает, что новый кандидат мог бы справиться лучше. Температура зависит от того, насколько хорошо изучена группа:
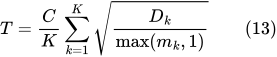
где  означает число ходов кандидата, которые оценил человек,
 несмещенную оценку дисперсии этих оценок,
 множитель температуры. Под корнем стоит квадрат среднеквадратического отклонения среднего, поэтому температура имеет вполне статистический смысл: чем больше оценок и чем меньше они расходятся, тем увереннее мы в кандидате и тем ниже температура. Дисперсия считается следующим образом:
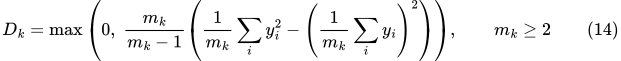
Если у кандидата меньше двух оценок, ему приписывается дисперсия 0.25, т.е. наибольшая возможная для величины от 0 до 1. Поэтому новичок поднимает температуру всей группы и чаще получает выбирается при сэмплировании. Автоматические оценки судьи в опыт кандидата не засчитываются. В противном случае температура падала бы только потому, что судья согласен сам с собой, без единого подтверждения от человека.
Вероятность выбрать кандидата, стоящего на месте  в списке лучших, задается выражением (15):
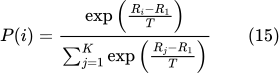
Из всех оценок вычитается лучшая  , для того чтобы при малой температуре экспонента не переполнялась. Если
 , т.е. группа изучена и оценки не расходятся, то ход отдается лучшему без жребия. Выбор кандидата не первого в списке, помечается в журнале как разведка.
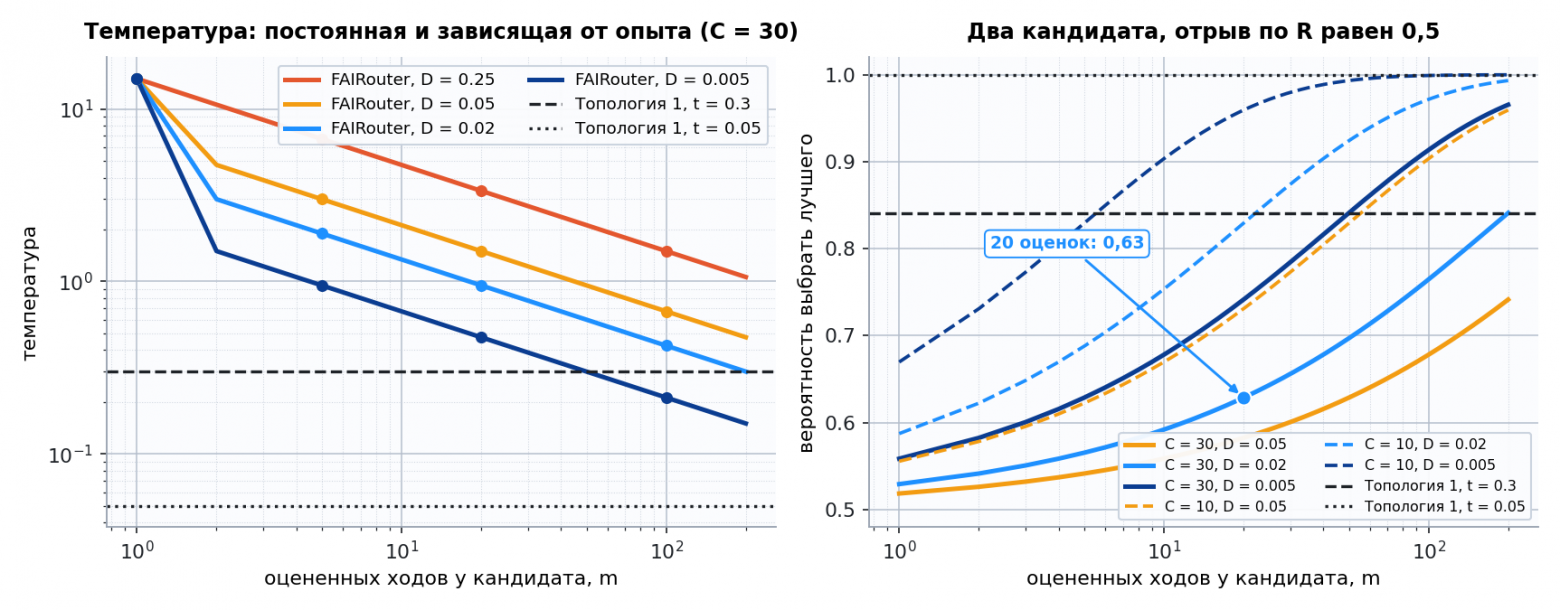
На рисунке 3 показано, как это работает. При  и дисперсии оценок 0.02 температура равна 4.24 после одной оценки, 1.90 после пяти, 0.95 после двадцати и 0.42 после ста. У группы из одних новичков температура равна 15, и первые ходы делятся между ними почти поровну. Таким образом, температура учитывает изученность группы: новый кандидат получает достаточно ходов, чтобы проявить себя, а изученная группа постепенно переходит к выбору лучшего.
Время выбора
Сам выбор занимает доли миллисекунды: признаки считаются за 0.02 мс, а выбор среди 54 кандидатов за 0.3 мс. Основное время уходит на одно обращение к языковой модели, которая извлекает из задания спецификацию, например, для gpt-4o-mini это 1–3 с. Оценка ответа судьей выполняется уже после ответа исполнителя, причем в версии на C# параллельно, а в версии на Python последовательно.
Существуют быстрые маршрутизаторы, которые выбирают модель за 70–500 мс, с медианой около 95 мс. Однако они не извлекают спецификацию задания, поэтому этот шаг ими не заменить. Для ускорения планируется собственный классификатор, обученный на парах «запрос, задание». Он будет давать ту же спецификацию за десятки миллисекунд, не дольше 0.1 с, а вариант на малых моделях, например на нашем дистиллированном sbert, за 3–10 мс.
Часть 4. Планка достаточности
Оценка  обменивает качество на цену без всяких ограничений. Однако на практике часто нужно другое правило: найти тех, кто справится с задачей, и среди них выбрать самого дешевого и быстрого. Переплачивать за сильную модель там, где хватит средней, нет смысла. Для этого задается планка
 , т.е. минимальная вероятность того, что ответ устроит человека.
Калибровка прогноза
Для того чтобы сравнивать прогноз с планкой, относительный прогноз  нужно перевести в вероятность положительной оценки. В качестве такого перевода была выбрана логистическая функция:
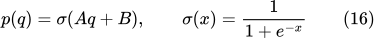
Коэффициенты подбираются по парам «прогноз  , оценка человека
 ». Минимизируется логистическая функция потерь с двумя штрафами: наклон стягивается к нулю, а сдвиг слабо привязан к средней оценке.
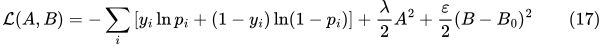
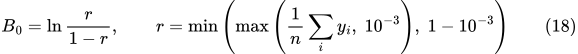
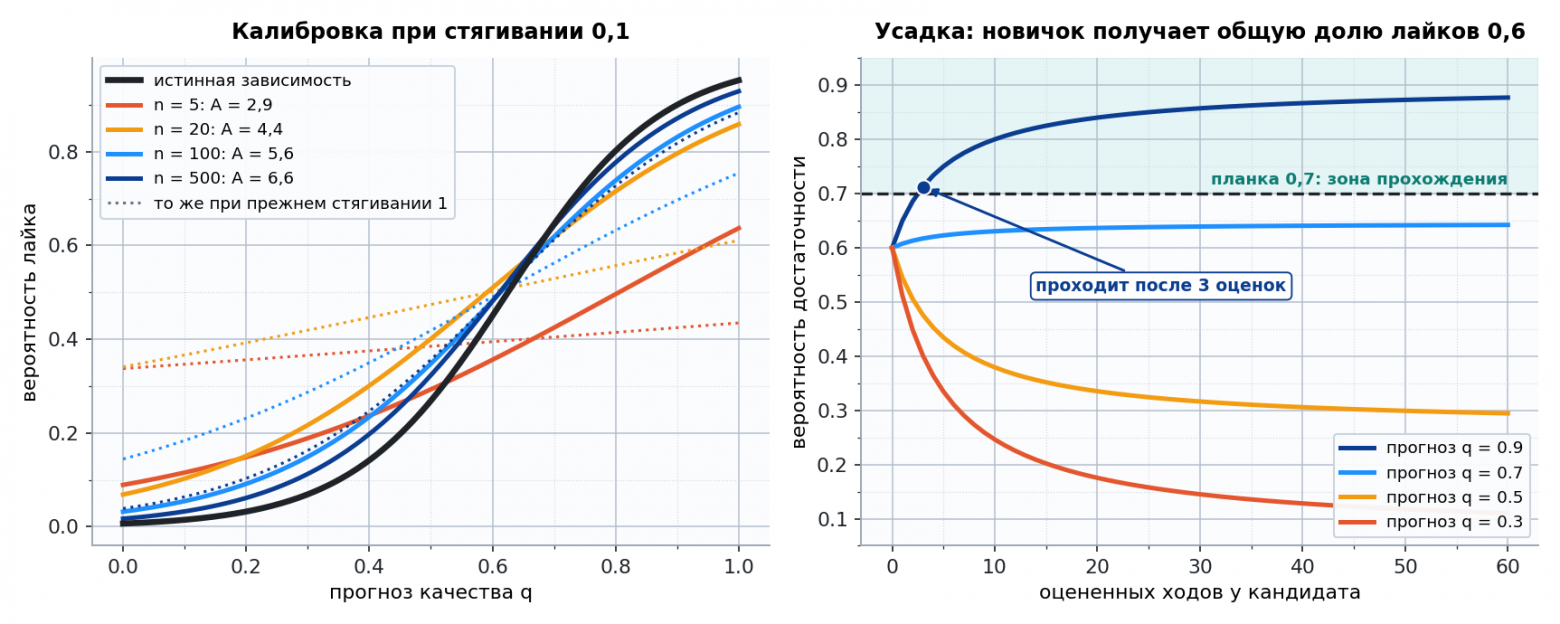
Штраф на наклон ( ) имеет следующий смысл: пока оценок мало, калибровка почти не реагирует на прогноз и возвращает общую долю положительных оценок. По трем оценкам зависимость надежно не восстановить, поэтому калибровка опирается на общую статистику, пока не накопит собственную. Привязка сдвига (
 ) нужна на случай, когда все оценки одинаковы, иначе у сдвига нет конечного оптимума.
Неизвестных всего два, поэтому задача решается методом Ньютона в явном виде. Начальная точка  ,
 . На каждом шаге при
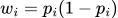 вычисляются градиент и матрица вторых производных:
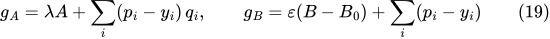
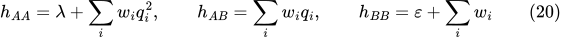
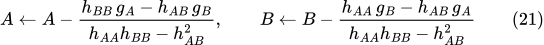
Делается не больше 50 шагов, остановка происходит, когда оба приращения становятся меньше  . Решатель в версиях на Python и C# одинаковый, и результаты калибровки у них совпадают до девятого знака.
Вероятность достаточности
Калибровка обучена на кандидатах, которые уже побеждали, поэтому для незнакомого кандидата ее наклону доверять рано. Его вероятность стягивается к общей доле положительных оценок  тем сильнее, чем меньше у него опыта:
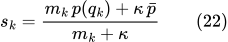
Параметр  означает, что общая доля весит столько же, сколько пять собственных оценок кандидата. У нового кандидата
 , и он получает ровно
 .
Правило выбора
Планку проходят кандидаты с  . Среди них выбор идет по той же оценке (2), но с уменьшенным весом качества:
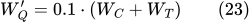
Качество у прошедших планку уже достаточное, поэтому решают цена и время. Небольшой вес качества остается, для того чтобы различать кандидатов с близкой ценой. Если планку не прошел никто, то ход без жребия отдается кандидату с наибольшей  , а в результате хода ставится соответствующая пометка. Пока оценок человека меньше трех, планка не работает и выбор идет по выражению (15).
Часть 5. Начальные веса и обучение
Старт с рейтингов
Со случайными векторами первые десятки ходов уходят на разведку. Их можно сэкономить, если качество кандидата  на каких-то задачах
 известно заранее. Замеров обычно меньше, чем координат, и решений бесконечно много. Из них мы выбрали решение с наименьшей нормой: оно лежит в линейной оболочке замеренных задач, а коэффициенты находятся из системы Грама с добавкой к диагонали:
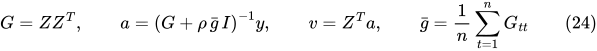
где строки матрицы  представляют собой центрированные векторы задач, а
 задает добавку как долю от среднего квадрата длины вектора задачи.
Изначально добавка была абсолютной и равной  . При таком значении прогноз почти точно проходит через полсотни близких точек, и на новых запросах он может выходить за шкалу от 0 до 1. Переход к относительной добавке сделал прогноз устойчивым. Значение 0.3 было выбрано скользящим контролем с исключением одной точки на рейтингах 263 моделей: среднее отклонение прогноза составило 0.241 при
 , 0.182 при 0.3 и 0.183 при 1.
Замеры качества берутся из открытых рейтингов, т.е. из попарных сравнений ответов людьми и прогонов тестовых наборов. Результат модели в каждой серии замеров нормируется между худшим и лучшим результатом этой серии:
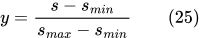
Каждой серии сопоставлен один или несколько типичных профилей задач. Пары «профиль, качество» по всем сериям, где есть модель, подаются в выражение (24). Из рейтингов берется и скорость модели. Поправка цены считается по средней доле рассуждений в стоимости задачи  и ограничена сверху числом 5. Доля иногда доходит до 0.99, но из-за одного такого замера не стоит считать модель в сто раз дороже.
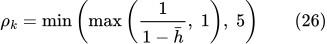
Обучение на отзывах
Маршрутизатор учится расставлять кандидатов в правильном порядке: на похожих задачах впереди должен оказываться тот, чей ответ понравился. Шаг обучения делается по одному ходу из журнала. Обозначим через  отзыв на ход, через
 победителя и через
 соперника из списка лучших.
Отзыв передается вызовом router.feedback(answer.round_id, y) и лежит в пределах от 0 до 1: значение 1.0 означает отличный ответ, 0.2 слабый. Отзыв человека заменяет автоматическую оценку судьи за этот ход, и на нем учатся и маршрутизатор, и сам судья.
Сила шага тем больше, чем дальше отзыв от нейтрального значения 0.5. Автоматический отзыв судьи весит вчетверо меньше отзыва человека:
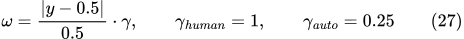
Если ответ понравился ( ), то победитель должен стоять выше соперника, если нет, то ниже. Отрыв и штраф за его нехватку при зазоре
 задаются выражением (28):
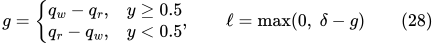
Зазор нужен, для того чтобы обучение не останавливалось в тот момент, когда порядок едва стал правильным. Для каждого соперника с ненулевым штрафом вектор того, кто должен быть выше, сдвигается в сторону задачи, а вектор того, кто должен быть ниже, в противоположную сторону:
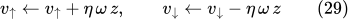
Выражение (29) по сути описывает шаг градиентного спуска по штрафу  с шагом обучения
 , сдвиги от разных соперников складываются. Отсюда же видно, зачем нужна повторная нормировка в выражении (6): за один шаг прогноз меняется на
 , т.е. скорость обучения прямо зависит от длины вектора задачи.
Часть 6. Автоматическая оценка качества решения
Человек оценивает далеко не каждый ответ, а без отзывов обучение не работает. Поэтому большую часть отзывов дает автоматический судья. Он проверяет две вещи: соответствует ли ответ заказанной форме и насколько хорошо его содержание.
Судья формы
Судья сравнивает вектор спецификации готового ответа  с вектором заказа
 , пропущенным через обучаемую матрицу
 размера 104 на 104:
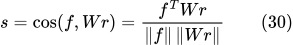
Вначале матрица единичная, т.е. судья считает, что ответ должен в точности совпасть с заказом. Люди так не оценивают, поэтому в ходе обучения матрица подстраивается так, чтобы оценка судьи совпадала с оценкой человека  . Функция потерь квадратичная,
 . Если обозначить
 , то производная косинуса и шаг спуска запишутся следующим образом:
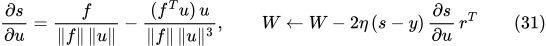
Судья учится только на отзывах людей, так как обучать его на автоматических отзывах означало бы подгонять одну автоматическую оценку под другую. Благодаря этому в корпоративном контуре судья подстраивается под задачи и критерии конкретной команды. Со временем матрица выучивает, например, что человек спокойно относится к небольшому превышению объема, но не прощает отсутствие заказанной таблицы. Для проверки было взято 60 пар «заказ, ответ», где человек систематически терпим к расхождению по объему. За 40 эпох расхождение судьи с человеком уменьшилось на три порядка, это показано на рисунке 5 справа.
Разбор расхождений по пунктам
Косинус дает одно число, а пользователю и LLM-агенту, например при встраивании в цикл ReAct, важно видеть, по каким именно пунктам ответ расходится с заказом. Поэтому одновременно с судьей работает критик. Он сверяет заказ и ответ по 20 пунктам формы: стиль, объем, абзацы, разделы, списки, таблицы, блоки кода, формулы, читаемость, язык и другие. Отклонение по числовому пункту задается выражением (32):
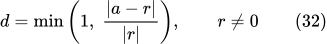
где  означает заказанное значение,
 фактическое. Если заказан ноль, то отклонение равно 0 при
 и 1 в остальных случаях. Для пунктов, где нужно точное совпадение (стиль, язык, тип задачи), отклонение тоже равно 0 или 1. Пункт считается проваленным, если
 . Оценка формы равна единице минус среднее отклонение:
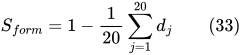
Структура ответа измеряется без обращения к модели. Например, читаемость считается по формуле Флеша в адаптации Оборневой для русского языка:
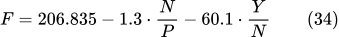
где  означает число слов,
 число предложений,
 число слогов.
Оценка содержания
Одной формы недостаточно, так как таблица с выдуманными цифрами легко пройдет проверку формы, ввиду чего отдельно от формы оценивается содержание, по восьми критериям, каждый от 0 до 1: фактическая точность, полнота, выполнение указаний, правильность рассуждений и расчетов, экспертная глубина, наполнение структуры, качество источников и практическая пригодность, признаки, которые к задаче не относятся, в среднее не входят.
Фактическая точность считается по списку проверяемых утверждений, которые судья выделяет из ответа (не больше 12). Для каждого утверждения оценивается вероятность  того, что оно истинно. Ее выставляет модель-судья или внешняя функция проверки, если она подключена:
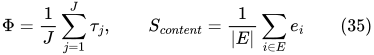
Функция проверки получает утверждение и возвращает вероятность его истинности либо отметку «проверить не удалось». Таким образом, к оценке фактологии можно подключить внешний источник, например правовую базу. Для ссылок на документы одной вероятности на утверждение недостаточно, так как здесь возникают три разных вопроса: существует ли документ и указанное место в нем, действует ли названная редакция и говорит ли документ то, что ему приписано в ответе. Первые два вопроса проверяются по базе без модели, третий требует сверки текста документа с тезисом. Сейчас функция получает утверждение строкой, и разбор ссылки на номер, редакцию и тезис выполняет тот, кто подключает проверку.
Поэтому для ссылок на нормы, стандарты, договоры, регламенты и научные статьи планируется отдельный вид утверждения с этими тремя проверками. Оценка по ссылкам будет выводиться в разборе отдельной строкой, а не усредняться вместе с остальной фактологией. Близкий подход к проверке утверждений мы применяли в библиотеке ExplainitAll, в версиях на Python и C#, и его также планируется внедрить в систему оценки.
Итоговая оценка складывается из оценок содержания и формы, доля содержания  :
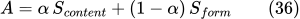
Совсем отбрасывать форму нельзя, ведь объем и структура тоже были частью заказа. Рассмотрим пример: заказан длинный ответ, а получен короткий, но отличный по содержанию. Оценка формы снизится, а итоговая оценка останется около 0.7, т.е. по умолчанию такой ход засчитывается. Библиотека показывает, какие пункты заказа не выполнены, а окончательное решение оставляет пользователю. Если для задачи короткий ответ на длинный заказ неприемлем, достаточно одного правила: жесткого порога по объему перед оценкой или большего веса формы.
Оценка  записывается в журнал как автоматический отзыв и участвует в обучении маршрутизатора с весом
 из выражения (27). Человек может заменить ее своей оценкой.
Два контура обучения
Таким образом, в системе работают две петли обучения, они показаны на рисунке 6. В первой маршрутизатор учится у судьи: расхождение прогноза с оценкой судьи приводит к контрастному шагу (29) для векторов кандидатов. Во второй судья, в свою очередь, учится у человека: расхождение оценки судьи с отзывом человека приводит к шагу (31) для матрицы  . Судью учит только человек, а автоматический отзыв судьи идет лишь в маршрутизатор. Веса, журнал ходов и отзывы хранятся в SQLite, а начальные веса берутся из рейтингов Арены и Artificial Analysis.
Часть 7. Эксперимент
Первая версия формулы
Для того чтобы был виден весь путь развития, вернемся к началу. Первая версия схемы с рисунка 1 записывалась так: оценка решателя была дробью, в числителе стояло качество минус цена, в знаменателе логарифм длительности, а температура была постоянной:
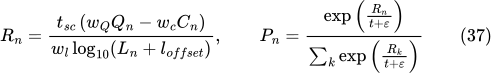
Эта формула хорошо подходила для первых опытов. Моделирование выявило три ее свойства, которые и определили направление дальнейшего развития.
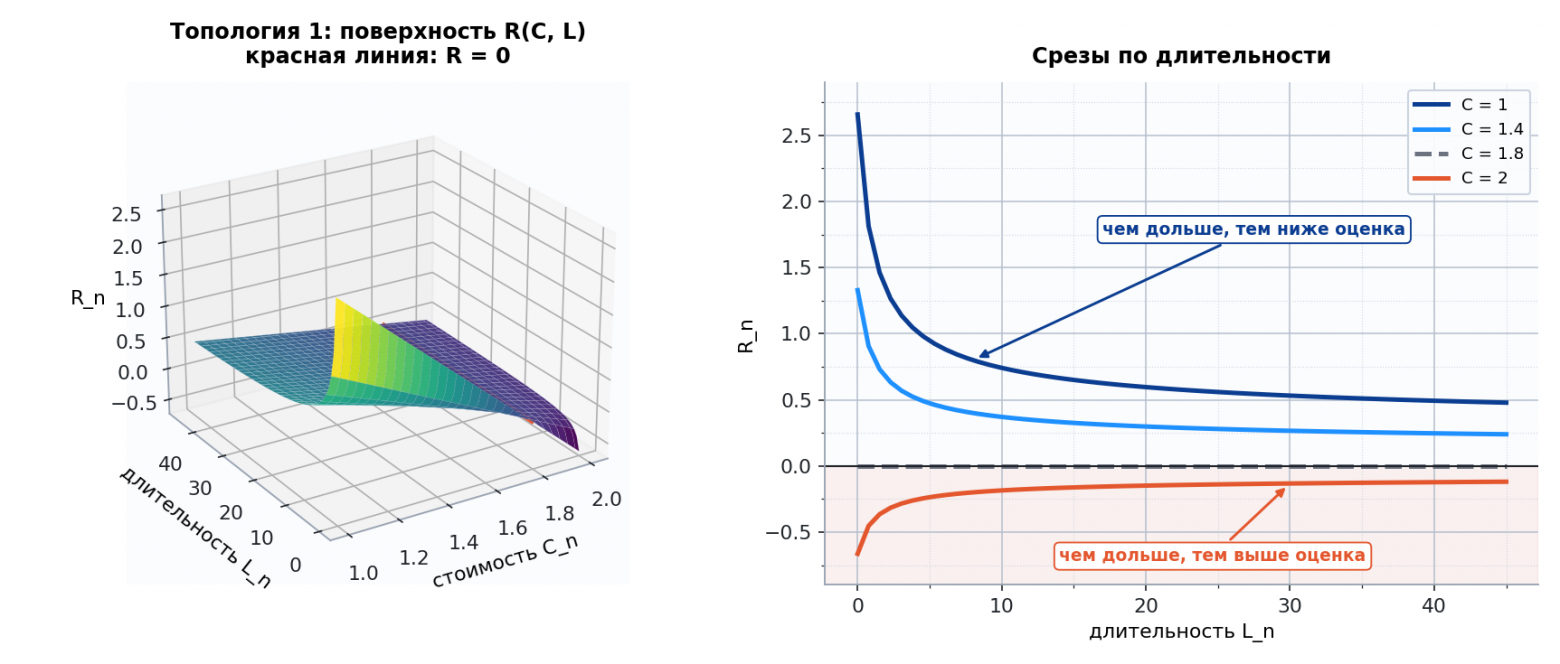
Первое свойство видно на правой части рисунка 7. Когда числитель отрицательный, оценка растет с длительностью, так как отрицательное число, деленное на растущий знаменатель, приближается к нулю. При  оценка с ростом длительности падает с 2.66 до 0.49, как и должно быть, а при
 растет с −0.66 до −0.12. Таким образом, длительность влияет на оценку по-разному в зависимости от знака числителя, и в FAIRouter время было вынесено в отдельное слагаемое.
Второе свойство состоит в том, что коэффициент  и вес
 не меняют порядок решателей. Они одинаково растягивают или сжимают все оценки, т.е. на деле работают как температура.
Третье свойство связано с масштабом величин, о котором шла речь в части 3: без приведения к общему масштабу веса слабо влияют на выбор. Для проверки были взяты четыре модели с реальными ценами и скоростями и задача на 100 входных и 500 выходных токенов. В первоначальной записи при всех пяти проверенных наборах весов, в том числе при весе цены, увеличенном в 100 раз, побеждает самая быстрая модель, gemini-2.5-flash. В FAIRouter, в свою очередь, у каждого из трех профилей свой победитель, это видно на рисунке 8 и в таблице ниже.
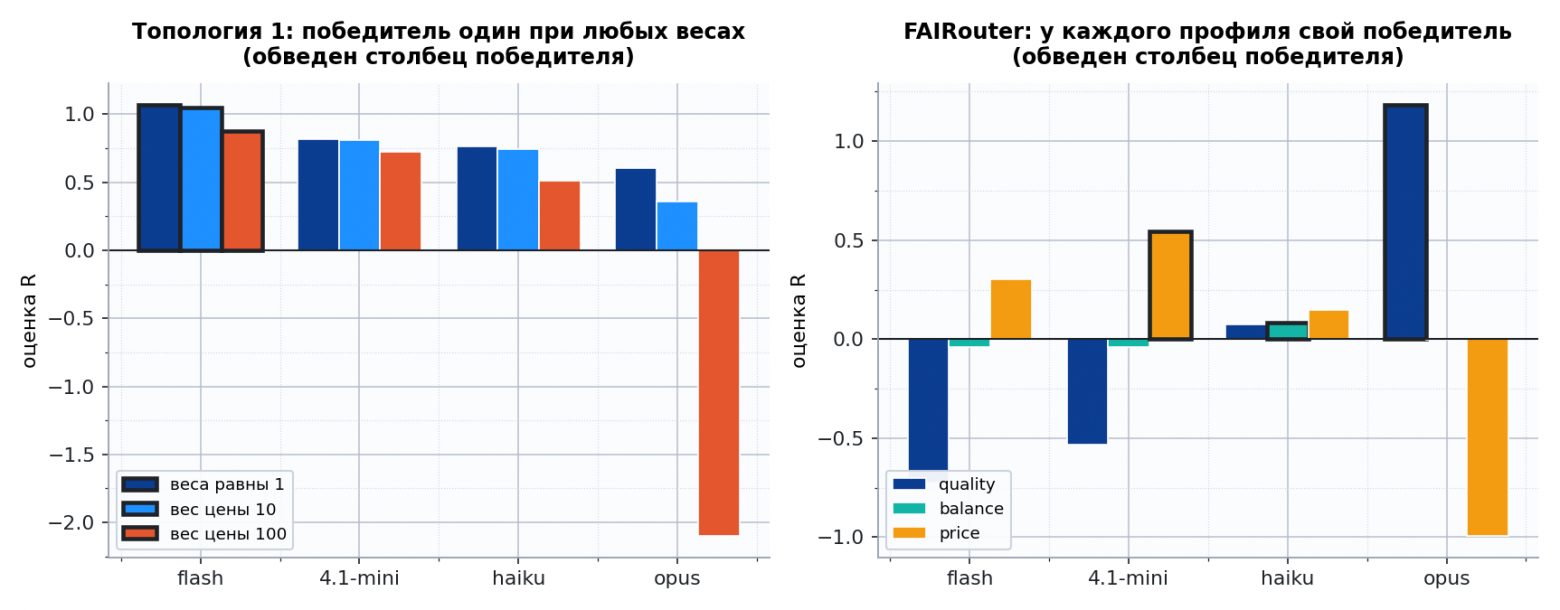
|
Модель |
Качество |
Цена хода, $ |
Время, с |
Побеждает в FAIRouter |
|
gemini-2.5-flash |
0.70 |
0.00128 |
2.5 |
нет |
|
gpt-4.1-mini |
0.72 |
0.00084 |
5.5 |
в профиле price |
|
claude-haiku-4.5 |
0.78 |
0.00260 |
8.3 |
в профиле balance |
|
opus |
0.90 |
0.03900 |
24.9 |
в профиле quality |
Сквозное моделирование
Отдельные формулы мало говорят о том, как система поведет себя в целом, поэтому был смоделирован полный цикл. В модели три типа задач (научный, детский и деловой текст) и три исполнителя, причем у каждого типа свой лучший исполнитель, как это обычно и бывает:
|
Исполнитель |
Научный |
Детский |
Деловой |
|
дешевый |
0.55 |
0.88 |
0.62 |
|
средний |
0.70 |
0.70 |
0.88 |
|
сильный |
0.92 |
0.74 |
0.80 |
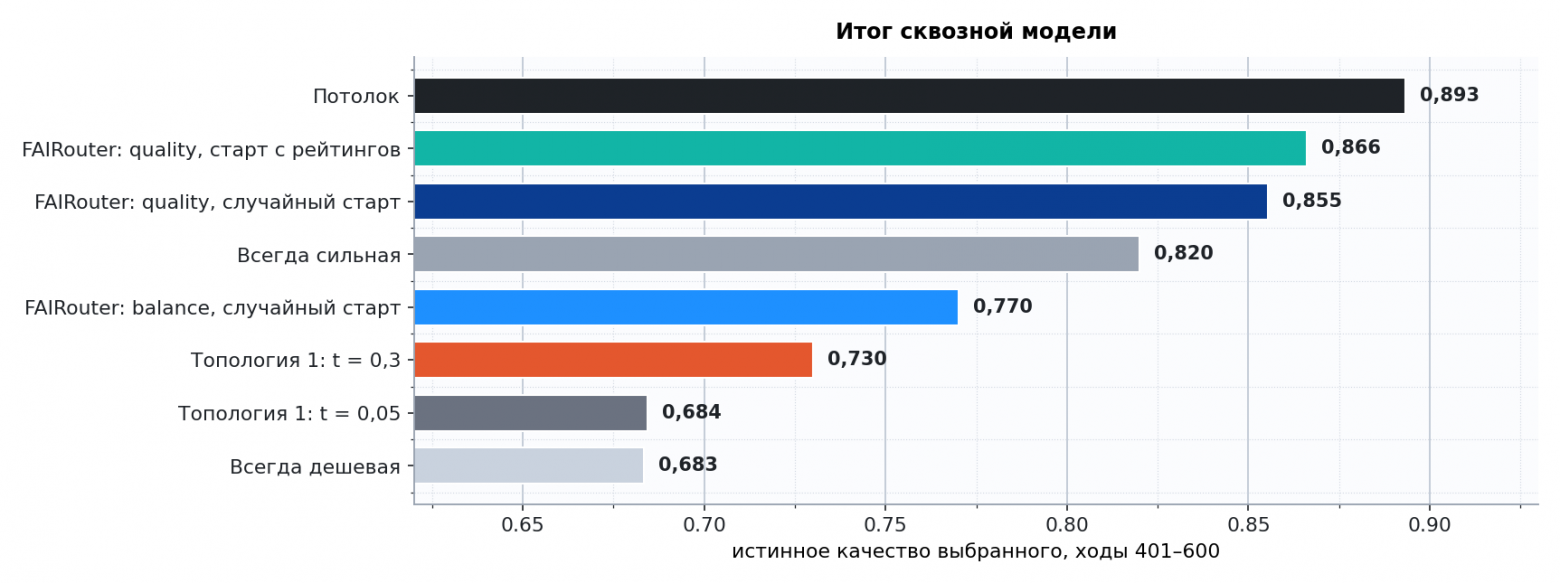
Отзыв на ход равен истинному качеству исполнителя плюс нормальный шум со стандартным отклонением 0.1. За FAIRouter работает настоящий код библиотеки. Первоначальная запись реализована по выражению (37), где  равно средней оценке решателя по всем задачам. Каждый прогон длится 600 ходов, тип задачи выбирается случайно, всего было проведено 200 прогонов. Результаты представлены на рисунке 9 и в таблице ниже.
|
Стратегия |
Ходы 1–100 |
Ходы 401–600 |
Попадание в лучшего |
Цена хода, $ |
|
FAIRouter, quality, старт с рейтингов |
0.852 |
0.866 |
0.86 |
0.0280 |
|
FAIRouter, quality, случайный старт |
0.801 |
0.855 |
0.82 |
0.0229 |
|
FAIRouter, balance, случайный старт |
0.767 |
0.770 |
0.49 |
0.0031 |
|
Первоначальная запись, t = 0.3 |
0.727 |
0.730 |
0.38 |
0.0092 |
|
Первоначальная запись, t = 0.05 |
0.683 |
0.684 |
0.34 |
0.0016 |
|
Потолок: лучший на каждой задаче |
|
0.893 |
1.00 |
|
|
Всегда сильный |
|
0.820 |
0.33 |
|
Как мы видим, FAIRouter с профилем quality обходит стратегию «всегда сильный»: 0.866 и 0.855 против 0.820. Он научился отдавать детские и деловые задачи тем исполнителям, которые справляются с ними лучше, чего нельзя сказать о первоначальной записи: качество решателя у нее одно число на все задачи. При температуре 0.05 ее выбор близок к стратегии «всегда дешевый», а при 0.3 он ближе к случайному. Профиль balance сознательно жертвует качеством ради цены: ход в нем стоит в 7 раз меньше, чем в профиле quality.
Из этого можно сделать вывод, что основной выигрыш дает прогноз качества по вектору задачи.
Подбор постоянных
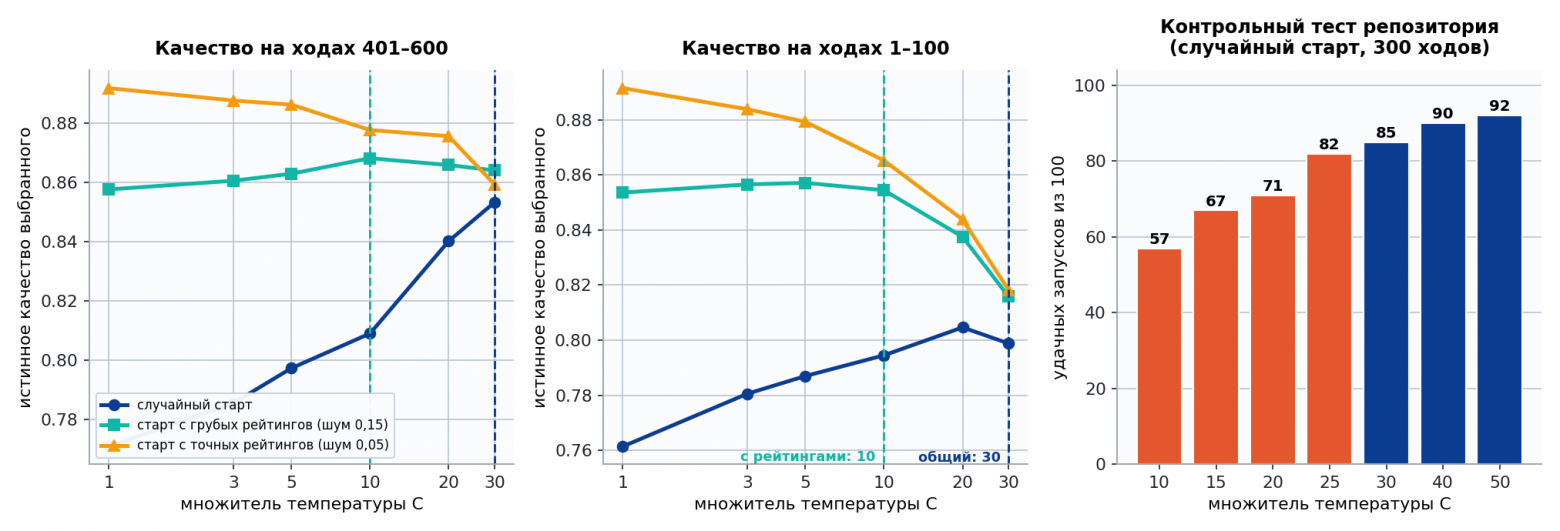
На той же модели были проверены и собственные постоянные библиотеки. Первым проверялся множитель температуры, результаты представлены на рисунке 10 и в таблице ниже.
|
Старт, ходы 401–600 |
C = 30 |
C = 20 |
C = 10 |
C = 5 |
C = 1 |
|
случайный |
0.853 |
0.840 |
0.809 |
0.797 |
0.771 |
|
с грубых рейтингов |
0.864 |
0.866 |
0.868 |
0.863 |
0.858 |
|
с точных рейтингов |
0.859 |
0.876 |
0.878 |
0.886 |
0.892 |
Как мы видим, при случайном старте лучший результат дает большой множитель. Это связано с правилом обучения: любой ответ с оценкой от 0.5 считается одобренным и поднимает победителя над соперниками, поэтому активная разведка помогает маршрутизатору найти действительно лучшего кандидата. При старте с рейтингов картина обратная: порядок кандидатов изначально близок к верному, и меньший множитель позволяет быстрее перейти к использованию накопленного знания. С грубыми рейтингами на первой сотне ходов  дает 0.854, а
 только 0.816.
В итоге общий множитель был оставлен равным 30, а для маршрутизатора, у которого все кандидаты стартуют с весов по рейтингам, был введен отдельный множитель 10.
Также проверялся штраф на наклон калибровки  . При прежнем значении 1 наклон медленно приближался к истинному: на 500 оценках получалось 5.3 при истинном 8. Среднее отклонение на отложенных точках составило 0.336 при
 , 0.244 при 0.1 и 0.216 при 0.01. Значения меньше 0.1 в среднем немного точнее, но при трех-десяти оценках и пологой зависимости менее устойчивы, поэтому мы остановились на
 .
Часть 8. Не только языковые модели
Исполнитель как вектор
Стоит обратить внимание, что ни в одной формуле из частей 1–6 не используется то, что исполнитель является языковой моделью. Маршрутизатору нужны четыре вещи: вектор задачи  , вектор кандидата
 , прогнозы цены
 и времени
 и отзыв на результат. Отзыв выставляет человек или судья из части 6, а судья оценивает готовый ответ и не заглядывает внутрь исполнителя. Таким образом, алгоритм по сути является универсальным, и кандидатом может быть любой исполнитель с ценой вызова и временем работы: поисковый сервис, интерпретатор кода, вызов внешней системы, MCP или целый агент с собственной цепочкой шагов.
Для инструментов меняется только способ оценить цену и время, выражение (9) считает цену по токенам, а у инструмента она обычно фиксирована за вызов или зависит от объема данных. У агента цена и время складываются из шагов, поэтому их удобнее прогнозировать по журналу как среднее на похожих задачах. Отсев по возможностям работает так же: если инструмент не умеет строить таблицы, то в группу кандидатов для задачи с таблицей он не попадет.
Инструмент выбирается так же, как модель, если он зарегистрирован кандидатом, через делегат execute. Предположим, что в агентном сценарии один из шагов требует поиска в интернете. Тогда «глубокий поиск по 3–5 страницам» и «быстрый поиск по одной странице» регистрируются как отдельные кандидаты со своей ценой и скоростью. На шаге подготовки диплома маршрутизатор отдаст запрос глубокому поиску, на шаге покупки товара быстрому, и по отзывам будет уточнять, где какой вариант оправдан. Разбиение запроса на шаги и переформулировку поисковых запросов выполняет агентная надстройка, у нас это MAS. FAIRouter же выбирает исполнителя для каждого шага, будь то модель или инструмент, но параметры инструмента, на данный момент, не настраивает.
С ростом числа разнородных исполнителей появляется возможность развить схему дальше. Температура (13) одна на всю группу и описывает изученность кандидата в целом, а не в отдельных областях задач. Для нескольких моделей с похожими сильными сторонами этого достаточно, в свою очередь инструменты и агенты устроены иначе: DSL (домено-специфичный язык), например, силен в узком классе задач, и для него полезно знать изученность в каждой области отдельно. Поэтому дальнейшее исследование мы связываем с более сложной постановкой задачи выбора.
Маршрутизация как контекстный бандит
Задача маршрутизатора совпадает с задачей многорукого бандита, на каждом ходу виден вектор задачи, выбирается один кандидат, а отзыв приходит только по выбранному. Цель состоит в том, чтобы уменьшить сожаление, т.е. разницу между суммой отзывов лучшего возможного выбора и фактического:
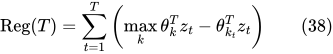
где  означает неизвестный вектор кандидата, а
 кандидата, выбранного на ходу
 . Ожидаемый отзыв считается линейным по вектору задачи,
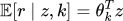 , так что
 играет роль вектора
 из выражения (7). Хороший алгоритм дает сожаление порядка
 , т.е. доля неоптимальных выборов со временем падает.
Алгоритм LinUCB
Наиболее известным алгоритмом для такой постановки является LinUCB. Для каждого кандидата он ведет гребневую регрессию отзывов по векторам задач и выбирает того, у кого верхняя доверительная граница качества больше. Запишем этот алгоритм в матричной форме:
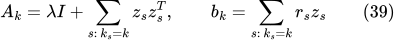
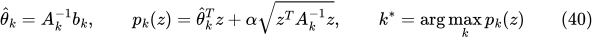
Выражение (39) описывает накопленную статистику кандидата, где суммы идут по ходам, отданным кандидату  ,
 означает отзыв на ход,
 коэффициент регуляризации Тихонова. Выражение (40), в свою очередь, описывает выбор, где
 задает ширину доверительного интервала. После отзыва обновляется только выбранный кандидат, соперников алгоритм не обновляет.
Первое слагаемое в выражении (40) дает гребневая регрессия. Если собрать задачи кандидата в матрицу  , а отзывы в вектор
 , то
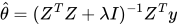 . Это та же система, что и в выражении (24), только записанная в пространстве признаков, а не через матрицу Грама. Обе записи дают один результат благодаря тождеству
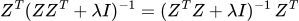
Следовательно, старт с рейтингов из части 5 переносится в LinUCB без изменений: замеры рейтингов добавляются в  и
 как наблюдения с весом меньше единицы.
Второе слагаемое представляет собой среднеквадратическое отклонение прогноза, умноженную на  . Это тот же корень из дисперсии на число наблюдений, что и в температуре (13), но посчитанный вдоль направления конкретной задачи. Предположим, что кандидат решил 200 научных задач и ни одной детской. Тогда вдоль научного направления матрица
 велика и бонус мал, а вдоль детского она почти равна
 и бонус остается стартовым. Таким образом, разведка становится прицельной: маршрутизатор пробует калькулятор там, где его еще не пробовали, а не на всех задачах подряд.
Обращать матрицу на каждом ходу не нужно. Обратная матрица пересчитывается по формуле Шермана и Моррисона за  операций:
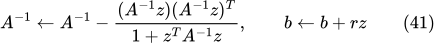
К вектору задачи придется добавить постоянную единицу. Вектор  центрирован, и без свободного члена прогноз всех кандидатов для средней задачи был бы близок к нулю. При
 состояние одного кандидата занимает около 100 КБ, а выбор из сотни кандидатов требует около 1.3 млн операций, т.е. долей миллисекунды.
Сэмплирование Томпсона
Выбор в LinUCB детерминированный, человек оценивает ответ не сразу, и до прихода оценки алгоритм раз за разом выбирает одного и того же кандидата, поэтому при задержке отзывов удобнее случайный выбор. Линейное сэмплирование Томпсона использует те же  и
 , но вместо бонуса берет случайное значение из апостериорного распределения:
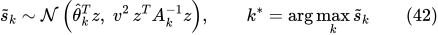
где  играет ту же роль, что и
 в выражении (40). Выбор остается случайным, как в нынешнем выражении (15). Это позволяет записывать в журнал вероятность каждого хода и потом оценивать новые стратегии по старому журналу без запуска.
Что меняется в FAIRouter
Вектор задачи, цена, время, судьи и профили весов остаются прежними. Меняются четыре узла, они представлены в таблице ниже.
|
Узел |
Сейчас |
С LinUCB |
|
Прогноз (7) |
q = zᵀv |
μ = θᵀz и σ = √(zᵀA⁻¹z) |
|
Выбор (13), (15) |
случайный выбор с температурой группы |
максимум оптимистичной оценки или выборка Томпсона |
|
Обучение (27)–(29) |
контрастный шаг, двигаются соперники |
гребневая регрессия, обновляется только выбранный |
|
Планка (22) |
стягивание к среднему, κ = 5 |
нижняя граница μ − ασ |
Отзывы человека и судьи идут в одну регрессионную модель с весами  из выражения (27):
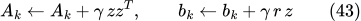
Сейчас неуверенность падает только от оценок человека, в новой схеме она падает и от отзывов судьи, просто вчетверо медленнее. Порог одобрения 0.5 при этом становится не нужен, так как регрессия учится на самом значении отзыва и учитывает степень одобрения.
Планка достаточности тоже получает естественную форму. Кандидат проходит ее, если калиброванная вероятность для пессимистичной оценки не ниже планки:
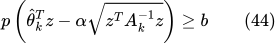
Новичок не считается достаточным, пока не наберет опыта. Из этого следует, что стягивание (22) и постоянная  становятся не нужны.
Для разнородных исполнителей особенно полезен гибридный вариант LinUCB. В нем ожидаемый отзыв делится на общую часть и часть кандидата:
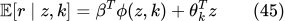
где  означает признаки пары «задача, кандидат», а вектор
 общий для всех кандидатов. В
 удобно заложить свойства исполнителя: тип (модель, инструмент или агент), класс цены, наличие рассуждений и их произведения с признаками задачи. Тогда новый инструмент с первого хода получает разумный прогноз через
 , а
 доучивает его особенности.
Состояние исследования
В план дальнейших работ входит сравнение LinUCB и сэмплирования Томпсона с нынешней схемой FAIRouter, с ε-жадной стратегией, с выбором по температуре поверх гребневой регрессии. Модель из части 7 мы усложняем: 10–20 кандидатов с реальными ценами, оценка человека только на части ходов и с задержкой, появление новой сильной и дешевой модели посреди прогона. После чего планируется проверка на наборе RouterBench, где для каждого запроса известны ответы всех моделей.
Сами по себе маршрутизаторы языковых моделей на основе LinUCB уже опубликованы, например PILOT (Panda и соавторы, 2025) и работа Poon и соавторов (2025). Поэтому новизну мы видим не в самом применении LinUCB, а в его связке со спецификацией заказа, судьей по признакам формы и содержания, планкой достаточности, а также в переносе этой схемы на инструменты и агентов.
Автор: Zachar_5

