


👋
Меня зовут Настя, я Data Scientist и TeamLead. Сегодня хочу рассказать про вредную занозу, которая засела у меня в голове и далее я не могла это игнорировать.
Сейчас я читаю книгу Себастьяна Рашки «Строим LLM с нуля». Читаю по-взрослому: глава за главой, с открытым Jupyter рядом и кружкой кофе (не первой). И на разделе 2.8 про позиционные эмбеддинги я встала. Прямо как вкопанная.
Причём там не сложно! В книге это буквально три строчки кода: есть таблица эмбеддингов слов, есть таблица эмбеддингов позиций, складываем — и вперёд, к attention. В других учебниках и статьях то же самое: «просто прибавим вектор позиции той же размерности». Ну понятно же? Понятно. Только в голове вместо ясности почему-то остался список вопросов:
-
Если сложить 3 и 5, получится 8. И обратно уже не разберёшь, где была тройка, а где пятёрка. Почему с векторами должно быть иначе?
-
Как модель потом отличит, где в этой сумме слово, а где позиция?
-
Не размоется ли смысл слова, если к нему каждый раз что-то подмешивать?
-
И почему вообще складывают, а не склеивают?
Ответов на это в книге нет, и это нормально — у неё другая задача. Но я так устроена: если в фундаменте есть пробел, дальше двигаться уже сложно, ощущение – что тема не раскрыта для меня полностью и как будто я вообще ничего не поняла. А следующая глава про attention целиком стоит на этих самых векторах. Так что… пришлось мне ставить перед собой вопросы и самостоятельно искать ответы. А заодно проверим – возникают ли такие вопросы еще у кого-то?
Разбираться я люблю руками. Фраза «в многомерном пространстве векторы почти ортогональны» звучит умно, но пока я не увижу это в цифрах — не считается. Поэтому я написала маленький эксперимент на numpy и устроила своим сомнениям очную ставку. Дальше всё по порядку: картинки, код и то, к чему я пришла. Код в конце, можно запустить и проверить самой (или самому). Поехали!
Зачем модели вообще позиция, или Кто кого укусил
Начала я с самого простого: а что будет, если позицию вообще не добавлять? Оказалось, ничего хорошего. Self-attention порядок слов просто не видит.
Attention сравнивает каждый токен с каждым через скалярное произведение, а потом складывает результаты с весами. А от перестановки слагаемых сумма, как мы помним со школы, не меняется. Так что для attention фраза — не цепочка, а мешок векторов. Классика жанра: «dog bites man» и «man bites dog». Слова те же, смысл противоположный (особенно для собаки), а attention без позиций выдаст для них одно и то же.
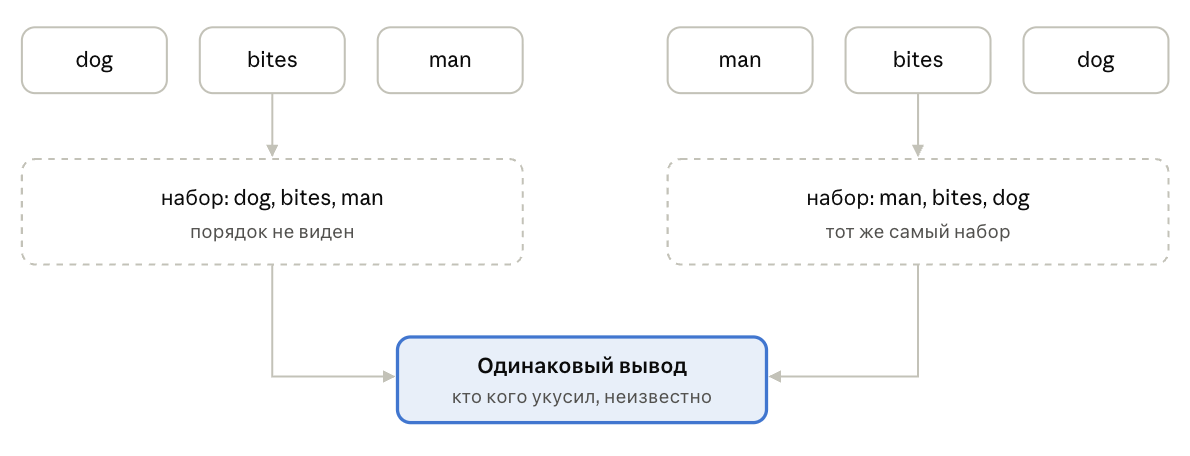
Значит, к каждому токену надо приклеить бирочку «я стою на месте номер k». Осталось понять, как это сделать и ничего не сломать.
Что происходит в коде главы 2.8
В книге бирочку делают максимально в лоб. Заводят вторую таблицу эмбеддингов, только ищут в ней не по id токена, а по номеру позиции. А потом две таблицы просто складывают:
token_embedding_layer = torch.nn.Embedding(50257, 256)  # таблица «слово -> вектор»
pos_embedding_layer   = torch.nn.Embedding(4, 256)      # таблица «место -> вектор», 4 = context_length

token_embeddings = token_embedding_layer(inputs)          # [8, 4, 256]
pos_embeddings   = pos_embedding_layer(torch.arange(4))   # [4, 256]
input_embeddings = token_embeddings + pos_embeddings      # [8, 4, 256]
Вот как это выглядит для одной строки батча:
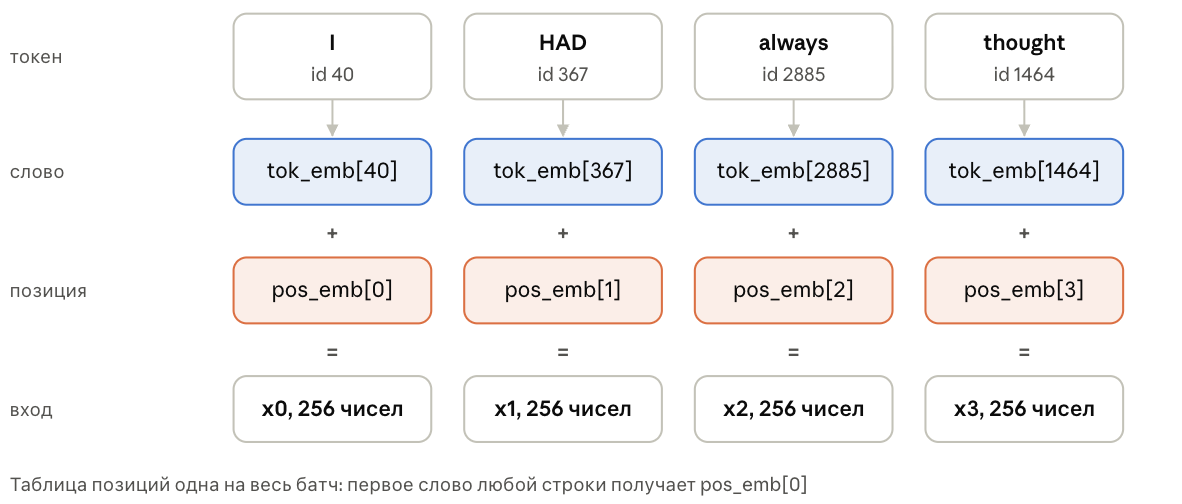
Деталь, которую я сначала проскочила: обе таблицы — это обычные обучаемые веса. В главе 2 там лежат случайные числа, и пока они ничего не значат. Смысл у них появится только в главе 5, когда модель начнут обучать. Такой подход – абсолютно обучаемые позиции, и именно так устроен GPT-2. В оригинальном Transformer 2017 года вместо таблицы были фиксированные синусоиды, но это уже другая история.
И вот тут у меня случился главный затык. Мы взяли два вектора и слепили их в один. Как модель потом из этой «каши» поймёт, что было словом, а что местом? И как мы из этого потом вообще получим слово, если говорим о трансформе с блоками энкодер и декодер?
Эксперимент, или Очная ставка с моей интуицией
С числами интуиция меня не обманывает: 3 + 5 = 8, и обратно не разобрать. Но число — это вектор из одной координаты, а в книге их 256. Вот и захотелось проверить: с какой размерности сумма перестаёт быть кашей и возможно ли это?
Взяла размеры как у GPT-2: словарь на 50 257 токенов и 1 024 позиции. Заполнила обе таблицы случайными числами, как в главе 2, без всякого обучения. Дальше беру случайное слово и случайную позицию, складываю их векторы и спрашиваю: какое из 50 257 слов ближе всего к сумме по скалярному произведению? А какая из 1 024 позиций? Если находится ровно то, что я складывала, значит, информация в сумме не потерялась. И так для разных размерностей, от 4 до 256.
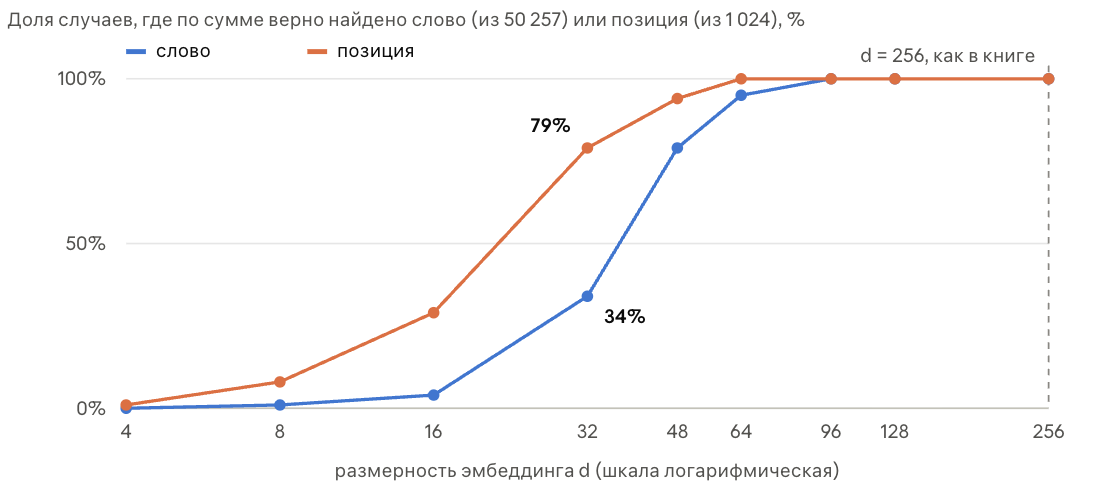
При 4–16 измерениях сумма и правда каша, тут моя «школьная» интуиция права. При 32 слово угадывается уже в трети случаев. А примерно со 100 измерений и слово, и позиция находятся практически всегда. При d = 256 я отдельно прогнала 2 000 пар — ни одной ошибки. Ни одной! И это на случайных векторах, без обучения.
Позиция, кстати, находится легче слова. Тоже логично: угадать один вариант из 1 024 проще, чем из 50 257.
Почему так? В двумерном пространстве два случайных вектора часто смотрят примерно в одну сторону. А в 256 измерениях места столько, что случайные векторы почти всегда почти перпендикулярны. Я посчитала косинусную близость: сумма похожа на «своё» слово в среднем на 0,71, а на случайное чужое — всего на 0,05. Смысл слова в сумме приглушён, но вполне различим.
Мне тут помогла аналогия с аккордом. Когда две ноты звучат одновременно, ухо слышит обе, потому что у них разные частоты. С векторами то же самое: у слова и у позиции разные направления в пространстве, и они друг друга не заглушают. На этом месте меня впервые отпустило.
Модели не нужно «разбирать» сумму обратно
Второй момент, после которого стало совсем легко. Я почему-то представляла, что модель где-то внутри делает обратную операцию: так, вот это слово, а вот это позиция. А ей это просто не нужно!
Первое, что attention делает с входным вектором, — умножает его на матрицы W_q, W_k и W_v. А умножение на матрицу раскрывает скобки, и слово с позицией расходятся сами:
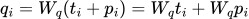
А вес внимания между токенами i и j — это скалярное произведение запроса и ключа. Раскрываем и его, получаем четыре слагаемых:
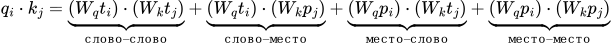
И у каждого слагаемого своя работа. Первое — про то, насколько слова связаны по смыслу. Второе и третье смешанные: важно ли этому слову, что стоит на таком-то месте, и какие слова ищут с этого места. Четвёртое чисто про порядок, что-то вроде «посмотри на соседа слева».
Матрицы обучаемые, поэтому модель сама решает, какое слагаемое какой голове важнее. Одна голова может почти не замечать позицию, другая — почти не замечать смысл. Вот оно, то самое «разделение», которое я так искала. Только делается оно не явно, а подбором весов.
И последний кусочек пазла. При обучении таблицы слов и позиций учатся одновременно, обычным back propagation. Если позиция начнёт мешать смыслу, градиент это поправит, и модель сама разведёт их по разным направлениям. В обученном GPT-2, насколько мне удалось найти, позиционные эмбеддинги занимают сравнительно небольшую часть пространства, а остальное фактически отдано словам.
Вопросы помельче, которые всё равно не давали спать
Когда главное встало на место, из-под него полезли вопросы помельче. Собрала их тут — вдруг у вас они тоже есть.
Почему складывать, а не склеивать?
Мне сначала казалось, что concat честнее: слово отдельно, позиция отдельно, никто никому не мешает. Но склейка удваивает размерность, а вместе с ней дорожает каждый следующий слой. И главное — выигрыша почти нет. После склейки всё равно идёт линейный слой, а он делает вот что:
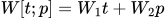
То есть та же сумма, только двух преобразованных векторов. А раз эмбеддинги и так обучаемые, модель выучит эти преобразования сама. Сложение дешевле и почти ничего не теряет.
Почему не подать просто номер позиции: 0, 1, 2?
Одно число на фоне 256 координат легко потеряется. А позиция 1000 по масштабу вообще задавит всё остальное. Да и «близость мест» через одно число плохо ложится на скалярные произведения, на которых держится attention.
Может ли модель перепутать «слово A на месте 3» и «слово B на месте 5»?
Для этого t_A + p_3 должно почти совпасть с t_B + p_5. В 256 измерениях случайно такое практически не случается. В моём эксперименте при d = 256 не нашлось ни одной такой путаницы.
Не забьёт ли позиция смысл, если её векторы окажутся длиннее?
В самом начале обучения может. В книге обе таблицы создаются через nn.Embedding и стартуют из одного распределения N(0, 1), то есть в одном масштабе. Дальше баланс подстраивает обучение, а LayerNorm внутри блоков не даёт кому-то одному раздуться.
А как это делают сейчас?
Честно? Так, как в книге, сегодня почти никто не делает. Llama, Qwen, Mistral и большинство моделей последних лет используют RoPE (rotary position embedding). Там к входу вообще ничего не прибавляют: внутри attention векторы q и k поворачивают на угол, который зависит от номера позиции. В итоге скалярное произведение q и k зависит только от расстояния между токенами, а не от их абсолютных мест. Такую позицию называют относительной, и на длинные тексты она переносится лучше.
Но разбирать абсолютные позиции всё равно стоило. Идея ведь та же: подмешать позицию в векторы, а attention сам разберётся. Меняется только способ подмешивания. Так что после версии со сложением RoPE, надеюсь, уже не будет казаться магией.
Что в итоге улеглось в голове
Если ужать всё до трёх мыслей:
-
Позиция нужна, потому что attention сам по себе порядок слов не видит.
-
Сумма векторов в 256 измерениях — не каша. Случайные векторы там почти перпендикулярны, и по сумме однозначно находятся и слово, и позиция.
-
Модели не нужно явно разбирать сумму. Линейные слои attention раскрывают скобки сами, а обучение решает, какая часть сигнала кому важна.
Пробел в фундаменте закрыт, можно со спокойной душой идти к attention.
Код эксперимента
Всё, что нужно, это numpy. Размеры взяты как у GPT-2: 50 257 токенов в словаре и 1 024 позиции. Код ноутбука на git
А теперь вопросы к вам
Цепляли ли вас «очевидные» места в учебниках и как разбираетесь с непонятным?
Пишите в комментариях — обещаю, все прочитаю! А если вам интересно смотреть на ML через мою призму, заглядывайте в мой телеграм-канал: там я делюсь тем, что обычно остаётся за кадром.
Автор: Zotovaa

