


Всем привет, на связи ML-команда компании “Платформа Третье Мнение”. Мы занимаемся искусственным интеллектом в медицине. Большая часть продуктов компании построена вокруг задач компьютерного зрения в области лучевой диагностики.
Данные, с которыми мы работаем, — рентгенографии, флюорографии, КТ различных частей тела, а также маммографии. Медицинские организации отправляют исследования, а в ответ получают результаты обработки с различными находками: локализованными областями патологии, измерениями, оценкой вероятности патологии и другими данными.
Подробнее о специфике этой работы расскажем в другой раз. А сегодня поговорим о Ray и о том, зачем он вообще понадобился в нашей архитектуре.
Причем здесь Ray?
Как правило, мы работаем с медицинскими исследованиями в формате DICOM. Каждый DICOM хранит визуальные данные — например, срезы КТ или рентгенограммы — и подробные метаданные о проведенном исследовании (данные пациента, аппарата, дозы, даты и многое другое). В результате одно исследование представляет собой довольно увесистый файл или набор файлов, над которым сервису нужно выполнить несколько действий, прежде чем получится итоговый результат.
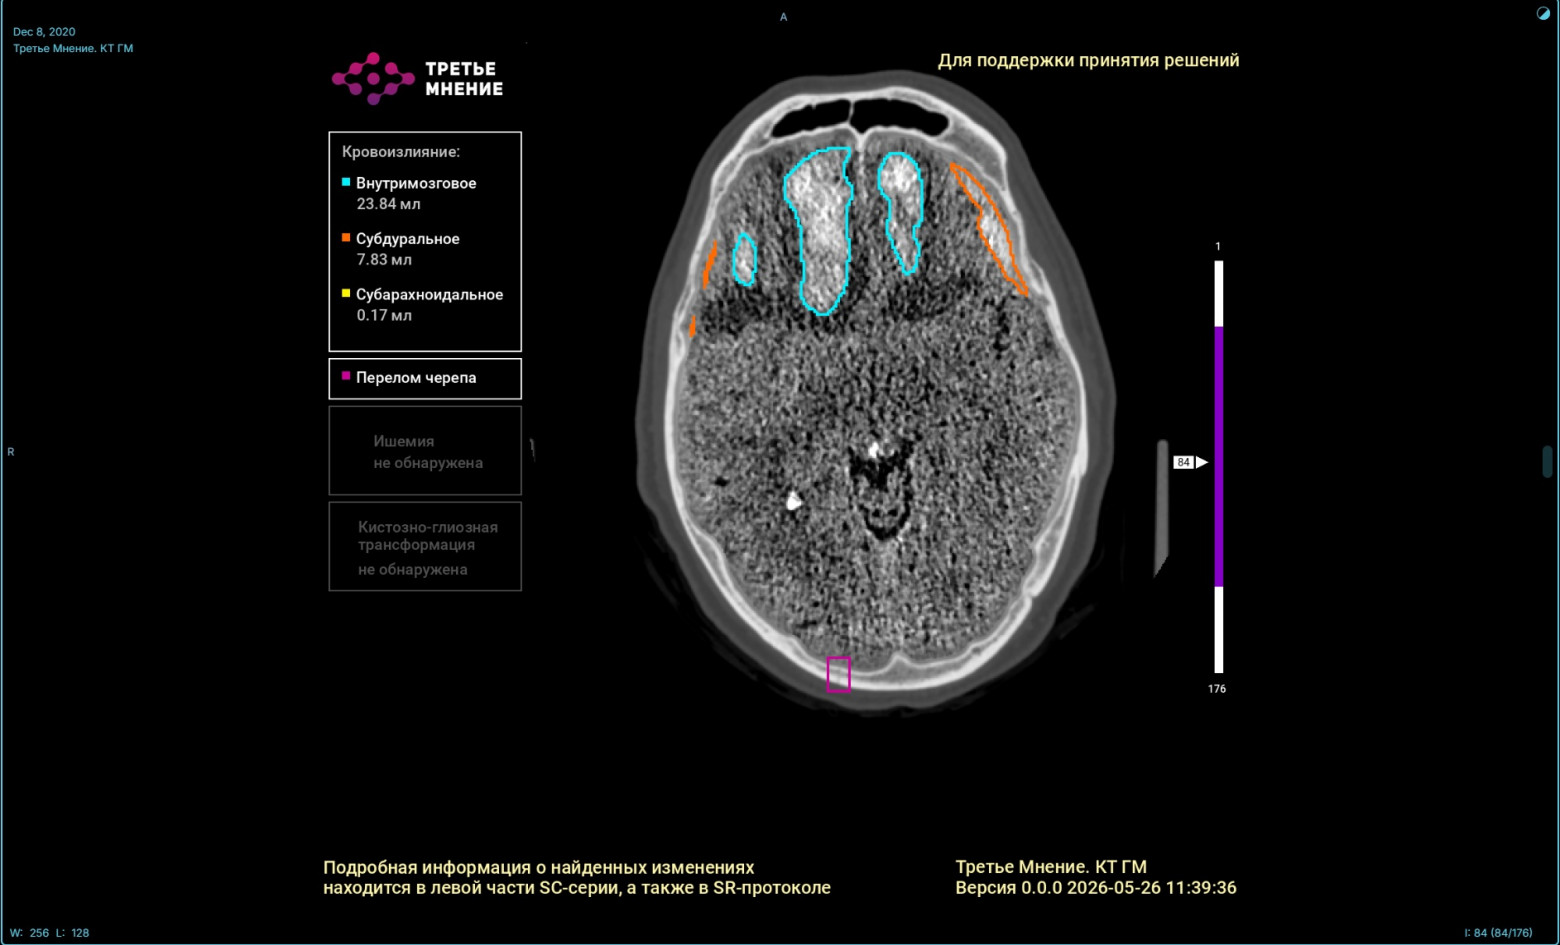
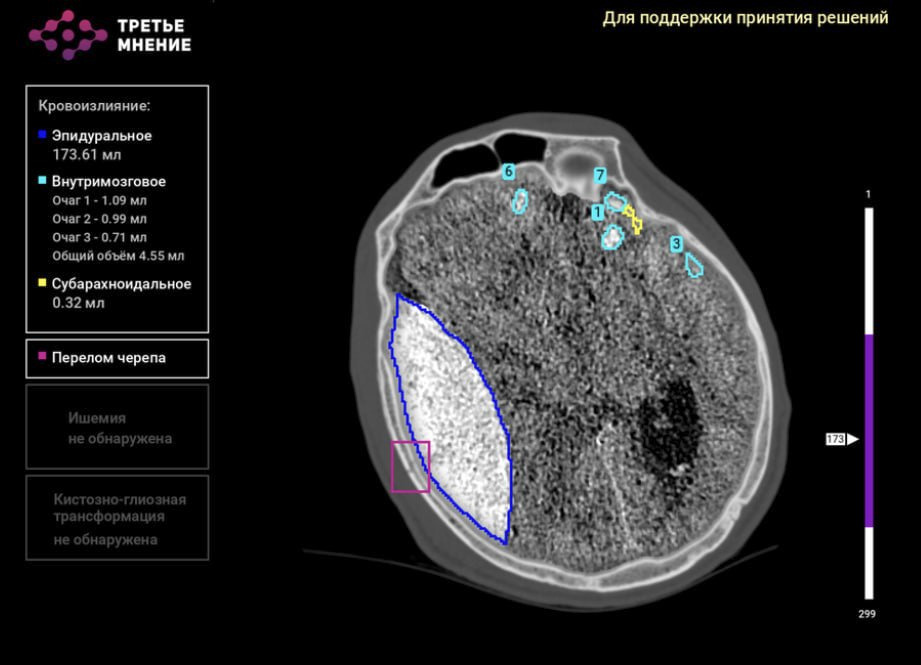
Часть операций создает высокую нагрузку на CPU и требует значительного объема оперативной памяти. А если железо ограничено, настройка, поддержка и масштабирование целого зоопарка таких сервисов быстро перестают быть простой задачей.
Причин несколько.
Во-первых, на одном сервере могут жить разные сервисы, которые конкурируют за ресурсы. При этом поток исследований распределяется во времени неравномерно: утром может увеличиться нагрузка на сервис КТ головного мозга, а в обед — на сервис маммографии. Поэтому хотелось гибко выделять ресурсы каждому сервису, не держать большой оверхед в резерве и при этом быстро реагировать на изменения нагрузки.
Во-вторых, внутри одного сервиса могут находиться разные бутылочные горлышки. Реплицировать сервис целиком в таком случае слишком расточительно. Но выносить каждую небольшую нагруженную функцию или класс в отдельный сервис тоже не слишком удобно: поддерживать и дебажить такие объекты по отдельности сложнее, чем в составе одного приложения.
Наконец, большой проект со смесью асинхронности и многопоточности, конкуренцией за ресурсы, очередями задач и разными узкими местами довольно быстро становится сложным в поддержке. Хотелось получить инструмент, который оборачивает это в понятные абстракции и позволяет управлять поведением системы через параметры конфигурации.
И такой инструмент есть. Встречайте — Ray.
Что такое Ray
Ray — унифицированный фреймворк с открытым исходным кодом для масштабирования приложений на основе искусственного интеллекта и Python.
Его главная идея — взять обычные Python-функции и классы и запускать их параллельно на одном компьютере или распределенно на кластере, не перестраивая приложение вокруг низкоуровневых RPC, очередей задач и управления процессами.
Основа системы — Ray Core.
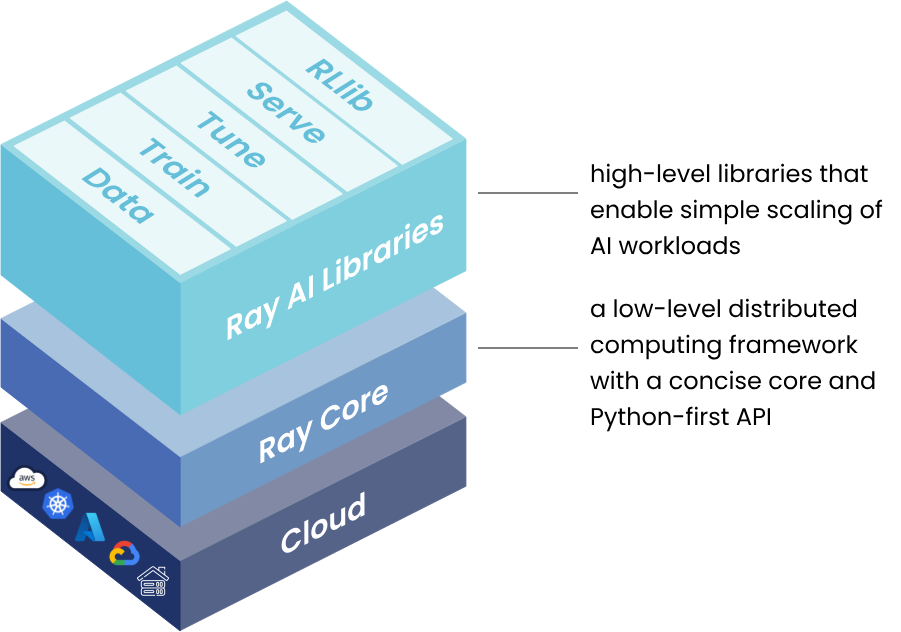
Из его основных объектов для дальнейшего разговора нам понадобятся четыре:
1. распределенные функции — tasks;
2. распределенные объекты с состоянием — actors;
3. распределенное хранилище данных — Object Store;
4. планировщик ресурсов — scheduler.
Разберем их коротко.
Tasks
Task можно определить как обычную функцию, добавив декоратор @ray.remote.
Например:
@ray.remote
def preprocess(path: str) -> dict:
     data = load_file(path)
     return transform(data)
Каждый вызов логически независим. Вот пример использованя выше описанной таски:
refs = [
     preprocess.remote(path)
     for path in paths
]

results = ray.get(refs)
В отличие от обычных функций, Ray может выполнять такие вызовы в разных процессах, на разных ядрах и (при наличии настроенного кластера) на разных машинах. Порядок выполнения может быть произвольным, если задачи независимы. При наличии зависимостей порядок определяется графом задач внутри самого Ray.
Actors
Если проводить аналогию с Python, то Task — это обертка (wrapper) над обычной функцией. Это stateless-объект, где каждый вызов Task запускается в новом или случайном воркере Ray-я. Тогда как Actor это обертка над над экземпляром Python-класса, которая поднимает его до уровня stateful-сервиса.
Одно из базовых применений actor — загрузка модели:
@ray.remote(num_gpus=1)
class ModelWorker:

     def init(self, model_path):
         self.model = load_model(model_path)
         self.model.cuda()

     def predict(self, batch):
         return self.model(batch)
После инициализации актора рэй заводит для него отдельного воркера (выделяет отдельный процесс) и планирует исполнение методов класса внутри этого процесса.
В отличие от task, actor может своими методами изменять внутренние атрибуты.
Object Store
Object Store — распределенная система хранения объектов, в том числе результатов remote-задач. Особенно она полезна для больших общих объектов. В кластере Ray каждый узел имеет собственный Object Store. Если объект создается, например, через ray.put(), по умолчанию он сохраняется в хранилище того узла, где был создан, и не транслируется автоматически на остальные узлы. Данные передаются на другой узел, когда это становится необходимо.
Scheduler
Scheduler распределяет задачи и actors по узлам кластера с учетом запрошенных ресурсов: CPU, GPU, памяти и пользовательских ресурсов. На основании этих требований Ray определяет, где и когда может быть запущена конкретная задача или actor.
Библиотеки на основе Ray Core
Ray Core — базовый уровень экосистемы Ray. На нем построены высокоуровневые библиотеки для разных сценариев работы:
● Ray Tune — масштабируемая настройка гиперпараметров;
● Ray RLlib — обучение с подкреплением;
● Ray Serve — сервинг моделей в продакшене;
● Ray Datasets — распределенная обработка данных с интеграцией с Apache Arrow;
● Ray Train — распределенное обучение.
Все они используют единый Core и могут комбинироваться друг с другом.
Для своих задач мы в первую очередь используем два уровня: Ray Core — для создания мультипроцессорных алгоритмов для CPU- и RAM-нагруженных операций, и Ray Serve — чтобы собирать из таких компонентов управляемые API-приложения.
Ray Core: проводим параллели
Есть три типичных сценария, которые нам здесь интересны.
1. Пайплайн-параллелизм
Можно поставить тяжелую операцию считаться в фоне, если ее результат понадобится только позднее.
Представим типичный сценарий. На вход приходит КТ-исследование. Для итогового отчета нужно построить двумерную проекцию, но понадобится она только в конце пайплайна.
@ray.remote(num_cpus=2)
def render_projection(volume: "np.ndarray") -> "np.ndarray":
     return build_2d_projection(volume)

volume_ref = ray.put(volume)

projection_ref = render_projection.remote(volume_ref)

findings_ref = detect_findings.remote(volume_ref)

measurements_ref = calculate_measurements.remote(volume_ref)

projection, findings, measurements = ray.get(
     [
         projection_ref,
         findings_ref,
         measurements_ref,
     ]
)
Вызов .remote() сразу возвращает ObjectRef — ссылку на результат, похожую на Future.
Задача передается среде выполнения Ray, а планировщик выбирает узел и worker-процесс с подходящими ресурсами.
ray.get() блокирует выполнение до тех пор, пока результат не будет готов. В асинхронном Python-коде ObjectRef можно ожидать через await ref; использовать блокирующий ray.get() внутри event loop обычно не стоит.
2. Батчи и чанки
Другой сценарий — распараллеливание обработки набора массивов или одного большого массива. Например, при создании стоматологического отчета по КЛКТ сначала нужно найти все зубы на компьютерной томограмме и визуализировать их.
Предположим, после инференса модели сегментации получено около 30 масок отдельных экземпляров. Для репрезентации каждого зуба необходимо проанализировать его ориентацию в пространстве, выполнить операции поворота объема и интерполяции. Это тяжелые CPU-нагруженные операции, поэтому обработку отдельных зубов естественно запускать параллельно.
Крупный общий объект при этом можно один раз положить в Object Store:
ct_volume_ref = ray.put(ct_volume)

tooth_report_refs = []

for tooth_id, tooth_mask in tooth_masks:
     tooth_mask_ref = ray.put(tooth_mask)

     tooth_report_refs.append(
         process_one_tooth_pipeline.remote(
             tooth_id,
             ct_volume_ref,
             tooth_mask_ref
         )
     )

tooth_reports = ray.get(tooth_report_refs)
Но бесконтрольно запускать все задачи тоже хочется не всегда. Если нужно ограничить количество одновременно обрабатываемых задач, ray.wait() позволяет реализовать backpressure:
ct_volume_ref = ray.put(ct_volume)
pending = []
results = []

for tooth_id, tooth_mask in tooth_masks:

     if len(pending) >= max_inflight:
         done, pending = ray.wait(
             pending,
             num_returns=1
         )
         results.extend(ray.get(done))

     tooth_mask_ref = ray.put(tooth_mask)

     pending.append(
         process_one_tooth_pipeline.remote(
             tooth_id,
             ct_volume_ref,
             tooth_mask_ref
         )
     )

if pending:
     results.extend(ray.get(pending))
3. Граф вычислений
Часто код состоит из последовательности remote-функций. В таком случае Ray позволяет передавать объекты через ObjectRef.
За счет этого промежуточный результат не обязательно материализовать между каждым этапом: его можно оставить в Object Store и построить цепочку вычислений.
projection_ref = render_projection.remote(volume)
encoded_ref = encode_png.remote(projection_ref)

# Материализуем в драйвере только конечный результат.
png_bytes = ray.get(encoded_ref)
Планировщик Ray не запустит encode_png, пока не завершится render_projection.
При этом если ray.get(projection_ref) возвращает np.ndarray, то encode_png содержит логику работы именно с np.ndarray. Разработчику не приходится отдельно продумывать, придет функции сам объект или ObjectRef.
Удобно.
Управление ресурсами
При написании remote-функций можно указывать количество необходимых ресурсов. Для этого есть параметры num_cpus, num_gpus и custom resources.
По сути, разработчик сообщает планировщику: эту задачу или actor можно запустить только тогда, когда доступно определенное количество CPU, GPU или кастомных ресурсов. Если ресурсы есть, планировщик запускает задачу и помечает их как занятые. Здесь есть два противоположных сценария. Если занизить оценку потребляемых ресурсов, процессы начнут бороться друг с другом за ресурсы. В результате можно получить нестабильную latency и OOM. Если оценку завысить, задачи будут стоять в очереди, хотя часть реальных ресурсов еще доступна.
Поэтому параметры удобны для управления, но их тонкая настройка возможна только после профилирования.
По умолчанию:
num_cpus = 1
num_gpus = 0
Ray Serve: собираем управляемое API
Ray Serve работает поверх Ray Core и позволяет превратить выполнение функций в онлайн-сервис.
Основная единица Serve — deployment.
Технически его реплики выполняются как Ray actors, но deployment задает более высокий уровень абстракции. Serve управляет количеством реплик, распределяет между ними запросы, проверяет состояние, перезапускает упавшие экземпляры и применяет обновления конфигурации.
Несколько deployments можно связать через DeploymentHandle и собрать из них Serve application.
Рассмотрим упрощенный пайплайн обработки медицинского исследования:
● ingress принимает запрос;
● Preprocessor выполняет CPU-нагруженную подготовку данных;
● Model хранит модель в GPU-памяти;
● Postprocessor формирует итоговый отчет.
Каждый этап можно масштабировать и обновлять независимо.
При этом API получает идентификатор исследования, это нельзя назвать произвольным путем в файловой системе. Сами данные должны находиться в хранилище, доступном нужным узлам кластера. Это может быть общее файловое хранилище, объектное хранилище или отдельный слой загрузки данных.
Еще один важный момент — передача результатов между этапами.
Вызов DeploymentHandle.remote() возвращает DeploymentResponse — объект, похожий на ObjectRef. Если результат одного этапа сразу нужен следующему, DeploymentResponse можно передать дальше без промежуточного await:
image = self.preprocessor.remote(study_id)
prediction = self.model.remote(image)
report = self.postprocessor.remote(prediction)

return await report
Ingress-реплика в таком случае не извлекает изображение и prediction в собственную память только затем, чтобы немедленно отправить их дальше. Она формирует цепочку вызовов и ожидает уже конечный ответ. Получается очень похоже на граф вычислений с ObjectRef, который мы разбирали в Ray Core. На уровне кода переход между этапами выглядит почти как обычный вызов Python-метода, хотя каждый этап остается отдельным управляемым компонентом.
Как приложение появляется в кластере
Локально приложение можно запустить через:
serve.run(application)Для управляемого развертывания приложение определяется как импортируемый объект, а параметры эксплуатации выносятся в Serve config.
Например:
applications:
   - name: medical-api
     route_prefix: /
     import_path: app:application
На самостоятельно управляемом кластере или наборе виртуальных машин head node можно запустить отдельно:
ray start --headПосле этого подключаются worker nodes:
ray start --address="<head-address>"А конфигурация Serve применяется командами:
serve deploy serve_config.yaml
serve status
После serve deploy контроллер Serve создает ingress, deployments и их реплики на доступных узлах в соответствии с объявленными ресурсами.
Serve config описывает желаемое состояние приложения. Повторный serve deploy приводит работающую систему к новой конфигурации.
Изменение некоторых параметров, включая num_replicas, autoscaling_config, user_config и max_ongoing_requests, считается легким обновлением и не требует пересоздания всех реплик соответствующего deployment.
Что в итоге
Ray Core и Ray Serve в связке дают архитектурную модель для production ML-сервисов. Ray Serve берет на себя внешний контур: деплой, маршрутизацию, масштабирование, отказоустойчивость и управление жизненным циклом сервисов. Ray Core закрывает внутренний: вычислительные графы, параллелизм, планирование ресурсов и передачу данных через Object Store. В результате получается система, в которой можно контролировать скорость разработки, операционную надежность и производительность под нагрузкой.
Классно, да и только.
А дальше началось самое интересное.
Во второй части разберем, с чем мы столкнулись уже при работе с Ray Serve: потреблением памяти, ray::IDLE, Object Store и передачей крупных объектов между deployment’ами.
Отдельное спасибо Роберту Фитагдинову, Артуру Турбову и Георгию Линовскому за подготовку статьи.
Автор: LechimAI

