


1. Введение: Анатомия бутылочного горлышка
Когда современные нейросетевые модели с INT8-квантованием начинают выполняться за единицы миллисекунд, «узкое место» системы смещается с чистой вычислительной мощности на инфраструктуру вычислительного конвейера и операции ввода-вывода. При использовании дискретных графических процессоров многократная передача видеокадров высокого разрешения и промежуточных данных, таких как, например, bounding boxes (для случая object detection), по шине PCIe способна существенно снизить общую пропускную способность.
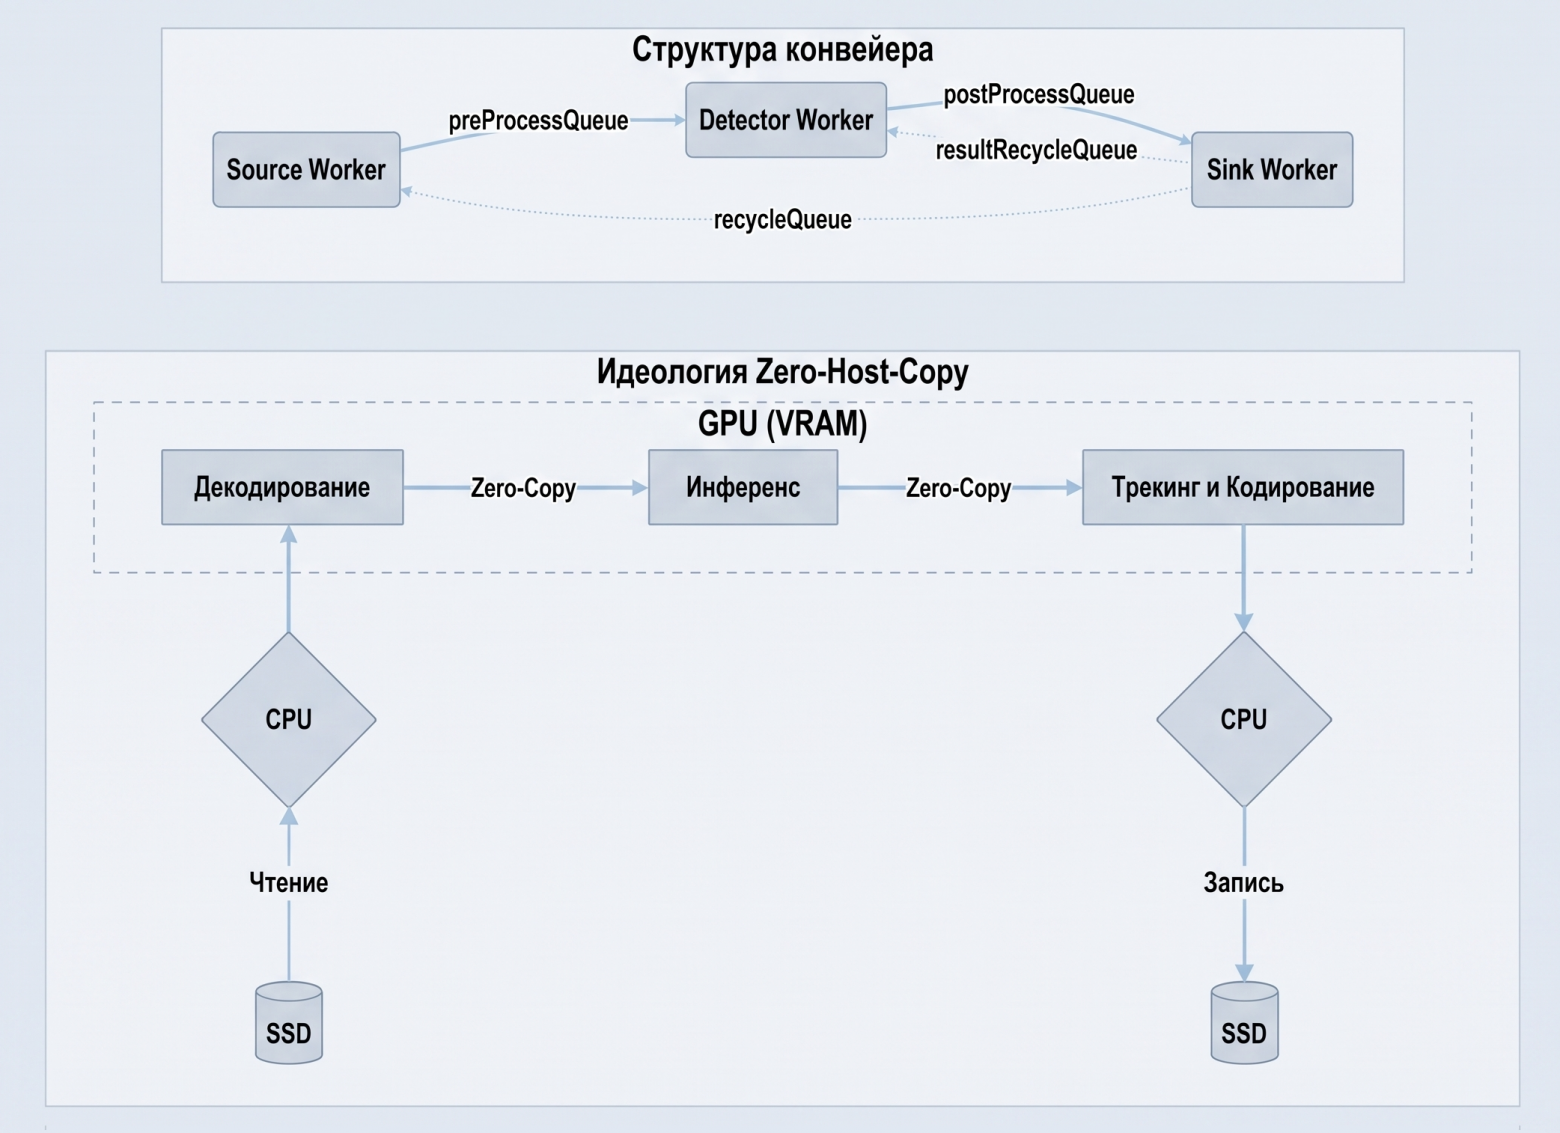
Архитектура Zero-Host-Copy заключается в том, чтобы начиная с чтения с диска перед декодированием и заканчивая записью на диск после финального кодирования, файлы кадров оставались в памяти GPU и обрабатывались только с помощью GPU, а копирования данных GPU -> CPU и обратно минимизировались. Если же говорить про Zero-Copy архитектуру, то под ней подразумевается передача блоков данных для обработки от одного этапа конвейера к другому исключительно по указателю без излишнего копирования данных.
Впрочем, лишние копирования CPU-GPU — не единственный скрытый фактор, снижающий эффективность конвейера. Динамическое выделение памяти в процессе работы системы столь же пагубно сказывается на быстродействии в реальном времени. Это происходит в связи с тем, что вызов cudaMalloc влечет за собой неявную синхронизацию (implicit synchronization), заставляя CPU ждать GPU, что нарушает асинхронность конвейера. Для достижения максимальной частоты кадров (FPS) высокопроизводительная система должна строиться с учетом реализации трех фаз жизненного цикла: «фаза инициализации» (initialization phase), «фаза подготовки» (warm-up phase) и «фаза активной работы» (hot phase). На этапе инициализации приложение заранее выделяет необходимые пулы памяти, буферы и очереди с начальными параметрами вложенности (глубины). В процессе фазы подготовки система запускает полную очередь обработки, где возможно срабатывание механизмов выделения дополнительных буферов в соответствии с реальной работой. Как только конвейер переходит в фазу активной работы после прогона нескольких начальных кадров, динамическое выделение памяти должно быть полностью исключено. Такая архитектура не допускает вызовов cudaMalloc или new во время выполнения, полагаясь исключительно на повторное использование уже выделенных блоков памяти для поддержания стабильной частоты (FPS).
Почему я не сделал свой выбор в пользу NVIDIA DeepStream? DeepStream — отличный инструмент, но создание собственных плагинов GStreamer на C++ — процесс, известный своей громоздкостью и недостаточной гибкостью. Я хотел реализовать конвейер обработки, работающий непосредственно на железе (bare-metal), дающий полный контроль над многопоточностью и лишенный зависимостей от GStreamer. Все это ради максимальной производительности и совместимости.
Полный код проекта (GitHub): ZeroHostCopyInference
2. Архитектура: cтруктура конвейера, локальность данных в памяти, использование аппаратных кодеков
2.1. Структура конвейера и обратное давление (Backpressure)
В высокопроизводительной системе обработки видео недостаточно просто иметь быстрые отдельные компоненты. Если аппаратный декодер работает со скоростью 300 кадров/с, а модуль инференса (вывода модели) — 165 кадров/с, то наивная реализация конвейера исчерпает всю доступную оперативную память и приведет к сбою системы.
Для управления потоком данных без утечек памяти и возникновения «узких мест» я разработал класс InferencePipeline, разделяющий рабочую нагрузку на три асинхронных этапа (обработчика), выполняемых в отдельных потоках: Source, Detector, Sink. Сама передача данных в конвейере может быть описана паттерном “Chained Producer-Consumer”:
-
Source: выполняется в основном потоке; считывает необработанные файлы данных и передает их на аппаратный декодер.
-
Detector: выполняет инференс нейросети и постобработку сырых данных (NMS). Архитектура опирается на абстрактный интерфейс IDetector, позволяющий приложению переключаться между высокооптимизированным TrtDetector (TensorRT), OnnxDetector (для обеспечения универсальной совместимости) или StubDetector – заглушкой, используемой исключительно для профилирования задержек ввода-вывода.
-
Sink: получает итоговые координаты bounding boxes, запускает алгоритм трекинга объектов, отрисовывает финальные значения рамок и аннотаций на кадре, кодирует выходные кадры и записывает их на SSD.
Для безопасного соединения этих трех этапов я реализовал специализированную очередь SafeQueue на базе std::mutex и std::condition_variable. Стандартные потокобезопасные очереди обычно могут расти бесконечно. Однако для поддержания стабильности системы моя очередь реализует строгий механизм обратного давления (Backpressure), ограничивающий максимальный объем хранимых данных.
Если, скажем, обработчик Detector не успевает за обработчиком Source, очередь после наполнения принудительно приостанавливает Source до тех пор, пока в ней не освободится место. Приостановка Source-потока происходит на уровне операционной системы, что предотвращает холостые циклы процессора (busy-waiting) и предотвращает бесконтрольное разрастание очереди и исчерпание свободной памяти.
template <typename T>
class SafeQueue {
  // ...
  void Push(T value) {
    std::unique_lock<std::mutex> lock(mutex_);
    // Приостановка Producer-потока, если очередь заполнена (backpressure)
    if (capacity_ > 0) {
      cond_full_.wait(lock, [this] { return queue_.size() < capacity_; });
    }
    queue_.push(std::move(value));
    cond_empty_.notify_one();
  }
  // ...
};
Ключевое условие для поддержания частоты 165 FPS — это отказ от использования cudaMalloc, cudaFree, new или delete на этапе активного выполнения (hot execution phase). Динамическое выделение памяти в процессе работы приводит к фрагментации памяти и простоям конвейера GPU. Секрет работы без динамического выделения памяти — задействование очередей повторного использования.
Для решения этой задачи в InferencePipeline реализован замкнутый цикл управления памятью. Данные проходят через очереди выполнения (preProcessQueue_, postProcessQueue_), но после того как обработчик вывода (Output Worker) завершает сохранение кадра, память не уничтожается. Вместо этого пустые буферы BatchData и BatchDetections возвращаются в очереди повторного использования recycleQueue_ и resultRecycleQueue_. Когда Producer-потоку требуется считать новый кадр, он просто извлекает из пула предварительно выделенный и уже использованный ранее буфер:
CudaError InferencePipeline::Run() {
  // ... инициализация потока ...
  while (process && running_) {
    BatchData batch;
    // Попытка повторного использования старого буфера пакета для экономии ресурсов
    recycleQueue_.TryPop(batch, std::chrono::milliseconds(0));
    // Если очередь пуста, объект 'batch' безопасно инициализируется один раз
    CUDA_TRY(source_->GetNextBatch(batch, batchSize_, process));
    // ...
    if (process) {
      // ...
      preProcessQueue_.Push(std::move(batch));
    }
  }
  // ...
}
Вывод: Сочетание строгой системы контроля нагрузки (backpressure) и циклических пулов памяти гарантирует, что все вызовы cudaMalloc происходят на этапе предварительного прогрева. На этапе активного выполнения конвейер работает исключительно с предварительно выделенными и повторно используемыми блоками памяти, что позволяет дискретным GPU и модулям Jetson Orin работать с максимально возможной пропускной способностью.
2.2. Управление памятью: локальность данных
Фундаментальные архитектурные различия аппаратуры, учтенные в данном проекте, заключаются в принципиальной разнице между дискретным GPU, взаимодействующим с CPU через шину PCIe, и архитектурой унифицированной памяти (UMA) в устройстве Jetson Orin.
В случае с дискретным GPU центральный процессор (CPU) и графический процессор (GPU) имеют физически раздельные банки памяти. Передача данных по шине PCIe — ресурсоемкая операция, требующая специальной координации. В архитектуре UMA на платформе Jetson ARM-процессор и GPU используют одни и те же чипы оперативной памяти.
Чтобы решить задачу обобщения столь разных архитектур, я централизовал управление поведением памяти в специализированном аллокаторе Block.h, подменяя тип памяти, отличающийся по способу его выделения, на alias, показывающий основное назначение данных в памяти, то есть локальность данных: для GPU или CPU. Таким образом получились три основных универсальных типа данных в памяти:
-
Чистые вычисления на GPU: Данные, которые полностью генерируются и потребляются GPU, используют стандартный тип MemoryType::Device (видеопамять/VRAM, выделяемая с помощью cudaMalloc()). Данный тип памяти представляет собой бОльшую часть выделений как для RTX/x64, так и для Jetson UMA.
-
Тяготение в сторону GPU (граничные вычисления): Для операций, при которых CPU считывает небольшие объемы данных о состоянии (например, параметры bounding boxes), используется тип BoundaryMemType. На дискретных GPU он соответствует Device, а на Jetson задействует механизм ZeroCopy (cudaHostAlloc() с флагом cudaHostAllocMapped).
-
Тяготение в сторону CPU (интенсивный ввод-вывод): Для передачи больших объемов данных, например, при записи файлов на SSD, используется память типа HostStagingMemType. На дискретном GPU этот тип отображается в MemoryType::Pinned (системная оперативная память с закрепленными страницами, выделяемая с помощью cudaMallocHost()), что предотвращает выгрузку данных ОС в файл подкачки и позволяет максимально загрузить DMA-контроллер шины PCIe. На платформе Jetson, поскольку оперативная память является общей, этот тип отображается в MemoryType::ZeroCopy, что позволяет избежать лишних копирований данных и экономить пропускную способность общей шины памяти, которая является узким местом в Edge-системах.
enum class MemoryType {
    Device, // Стандартная видеопамять (VRAM) — наиболее быстрая для вычислений на GPU
    Pinned, // Закрепленная память хоста (промежуточный буфер для передачи данных на/из RTX)
    ZeroCopy // Отображаемая память (общий указатель для CPU и GPU — оптимально для операций ввода-вывода на Jetson)
};

#ifdef PLATFORM_JETSON
// --- Реализация для Jetson (архитектура унифицированной памяти / UMA) ---
constexpr MemoryType BoundaryMemType = MemoryType::ZeroCopy;
constexpr MemoryType HostStagingMemType = MemoryType::ZeroCopy;
#else
// --- Реализация для x64 (дискретный GPU и шина PCIe) ---
constexpr MemoryType BoundaryMemType = MemoryType::Device;
constexpr MemoryType HostStagingMemType = MemoryType::Pinned;
#endif
2.3. Использование аппаратных кодеков (FFmpeg и MMAPI)
Для выполнения инференса на платформе x64 по идеологии zero-host-copy видеокадры не должны попадать в обычную оперативную память хоста. В файле FFmpegSource.cpp я инициализирую аппаратный контекст типа AV_HWDEVICE_TYPE_CUDA и привязываю к нему непосредственно cuda-контекст декодирования.
// Получаем текущий cuda контекст
CUDA_TRY(cudaFree(0));
CUcontext primary_ctx = nullptr;
CUresult cuRes = cuCtxGetCurrent(&primary_ctx);
// ...
// Создаем контекст FFmpeg
hwDeviceCtx_ = av_hwdevice_ctx_alloc(AV_HWDEVICE_TYPE_CUDA);
// Переопределяем вручную cuda контекст в аппаратном контексте FFmpeg
AVCUDADeviceContext* internal_ctx = (AVCUDADeviceContext*)((AVHWDeviceContext*)hwDeviceCtx_->data)->hwctx;
internal_ctx->cuda_ctx = primary_ctx;
//...
// Указываем декодеру использовать аппаратное ускорение с подключенным cuda-контекстом,
// гарантируя сохранение выходных кадров непосредственно в память GPU
decCtx_->hw_device_ctx = av_buffer_ref(hwDeviceCtx_);
В основном цикле обработки вызов avcodec_receive_frame возвращает кадр gpuFrame_ типа AVFrame с форматом AV_PIX_FMT_CUDA. Указатели data[0] и data[1] класса AVFrame уже являются валидными указателями на память GPU, содержащими плоскости формата NV12. Они сразу же передаются в буферы накопления в видеопамяти (VRAM), а затем после набора полного пакета (batch), в специализированное ядро CUDA (BatchedNV12ToRGBPlanar) для преобразования цветового пространства без выхода за пределы VRAM.
int ret = avcodec_receive_frame(decCtx_, gpuFrame_);
//...
CUDA_TRY(cudaMemcpyAsync(
    device_nv12_y_[buf_idx].data() + (framesCollected * y_plane_size),
    gpuFrame_->data[0],
    y_plane_size,
    cudaMemcpyDeviceToDevice, 0));

CUDA_TRY(cudaMemcpyAsync(
    device_nv12_uv_[buf_idx].data() + (framesCollected * uv_plane_size),
    gpuFrame_->data[1],
    uv_plane_size,
    cudaMemcpyDeviceToDevice, 0));
//...
CUDA_TRY(BatchedNV12ToRGBPlanar(
    device_nv12_y_[buf_idx].data(),
    device_nv12_uv_[buf_idx].data(),
    framePitch,
    outBatch.deviceData.data(),
    framesCollected,
    actualW, actualH,
    outW, outH,
    *cuda_stream_
    ));
При тестировании стандартного видеопотока H.264 конвейер упирается в предел ~165 FPS. Однако, при конвертации исходного видео в формат H.265 (HEVC), общая пропускная способность возрастает до 190+ FPS, а просадки производительности на больших размерах батча (batch size 16) существенно уменьшаются.
Почему это происходит? Математически H.265 сложнее, но выделенный аппаратный блок NVDEC (на архитектуре Ampere) спроектирован для работы с блоками CTU (Coding Tree Units) размером до 64×64 пикселей, в то время как H.264 оперирует макроблоками 16×16. Для кадра с одним и тем же разрешением чипу NVDEC при декодировании H.265 требуется обработать значительно меньше блоков. Это радикально снижает накладные расходы на внутреннее планирование в чипе (hardware scheduling), позволяя аппаратному декодеру работать синхронно с инференсом TensorRT даже при больших значениях batch size.
Поскольку аппаратное декодирование FFmpeg не поддерживается нативно на UMA платформе Jetson, конвейер обработки использует альтернативный сценарий – чтение директорий с JPEG-файлами (-i ./frames/).
При работе на дискретном GPU этот сценарий, изначально планируемый как резервный, реализуется через классы NVJpegSource и NVJpegSink. При этом используется библиотека nvJPEG. Например, разбор битового потока, считанного из jpeg-файла, в NVJpegSource выполняется на CPU (nvjpegDecodeJpegHost), а данные асинхронно (std::async/std::future) передаются на GPU для финального декодирования (nvjpegDecodeJpegTransferToDevice / nvjpegDecodeJpegDevice).
Однако устройства Jetson оснащены специализированными аппаратными блоками для декодирования и кодирования изображений, возможности которых библиотека nvJPEG не задействует в полной мере. Для достижения максимальной пропускной способности на платформе Orin я внедрил в пайплайн использование Jetson Multimedia API (MMAPI), реализовав классы MMAPIJpegSource и MMAPIJpegSink. Работа с MMAPI требует строгого разделения этапов жизненного цикла памяти. Разберем эти этапы более подробно на примере класса MMAPIJpegSource.
Для полной загрузки аппаратных ресурсов данный класс определяет логический пул аппаратных декодеров и кодеров, определяющих число запускаемых параллельных потоков декодирования и кодирования (std::async).
struct DecodeResource {
    static constexpr int HW_DECODERS_PER_BUFFER = 2;
    // ...
};
Для распараллеливания аппаратного декодирования и последующей обработки кадров (inference) используется двойное буферизирование, работающее по принципу “пинг-понг”, поэтому все буферные структуры представляют собой массивы, состоящие из двух элементов.
class MMAPIJpegSource : public ISource {
  //...
  std::unique_ptr<CudaEvent> dma_complete_event_[2];
  //...
  std::vector<DecodeResource> resource_pool_[2];
  std::vector<std::unique_ptr<NvJPEGDecoder>> hw_decoders_[2];
  std::vector<std::future<std::vector<MMAPIDecodeStatus>>> futures_[2];
  int frames_in_buffer_[2] = {0, 0};
  //...
Жизненный цикл памяти при работе с MMAPI выглядит так:
-
Этап инициализации (предварительное выделение):
На этапе инициализации (MMAPIJpegSink::Init()) приложение заранее выделяет основные буферы, требуемые для загрузки файлов, необходимые структуры данных и проводит инициализацию EGL-дисплея.
-
Фаза прогрева:
В течение данной фазы происходит реальная обработка кадров и выделяются промежуточные буферы требуемых размеров и необходимые аппаратные поверхности (DMA-буфер с дескриптором block_linear_fd, буфер поверхности pitch_linear_surf типа NvBufSurface). Конвейер использует движок VIC (NvBufSurfTransform) для выполнения сверхбыстрого аппаратного копирования данных из области памяти с блочно-линейной организацией (доступной через файловый дескриптор block_linear_fd) в новую структуру NvBufSurface. Затем поверхность регистрируется как EGL ресурс для получения доступа к пикселям поверхности из cuda контекста (cudaGraphicsEGLRegisterImage).
-
Активный цикл инференса:
В ходе активного цикла инференса выделение буферов и создание поверхностей не выполняется. В нормальной ситуации (если не происходит каких-либо изменений геометрии кадров) происходит переиспользование уже аллоцированных блоков памяти. Например, для передачи EGL поверхности в cuda ядро, выполняющее конвертацию кадра в RGB тензор для инференса, вызываются функции, использующие отображения (mapping), что позволяет передавать лишь указатели, реализуя истинный Zero-Copy.
CudaError MMAPIJpegSource::MapAndConvert(DecodeResource& res, ...) {
  //..
  cudaEglFrame eglFrame;
  // Чрезвычайно быстрая передача: просто извлекает device-указатели из уже зарегистрированного ресурса
  CUDA_TRY(cudaGraphicsResourceGetMappedEglFrame(&eglFrame, res.egl_cuda_resource, 0, 0));
  // Извлечение стандартных Pitch-Linear указателей
  const uint8_t* srcY = static_cast<const uint8_t*>(eglFrame.frame.pPitch[0].ptr);
  const uint8_t* srcUV = static_cast<const uint8_t*>(eglFrame.frame.pPitch[1].ptr);
  int srcPitch = eglFrame.frame.pPitch[0].pitch;
  // Чтение данных из поверхности
  CUDA_TRY(NV12ToRGBPlanar(srcY, srcUV, srcPitch, ...));
  //...
}
Позже применение архитектуры двойной буферизации (double-buffering) с пулом логических декодеров (DECODERS_PER_BUFFER) в классах NVJpegSource и NVJpegSink позволило этому сценарию стать абсолютным лидером по сравнению с декодированием видеопотока и дать прирост по скорости до 215 FPS. Это объясняется тем, что JPEG файлы — это полностью независимые кадры со строго intra-frame кодированием, поэтому их можно читать на CPU в пуле из нескольких потоков и передавать на GPU параллельно, скрывая задержки передачи по шине PCIe. В отличие от чтения видеопотока (FFmpeg), где кадры видео зависят друг от друга и декодируются строго последовательно, чтение папки с кадрами идеально параллелится.
3. Специализированные CUDA-ядра и трекинг объектов
Большинство современных конвейеров инференса попадают в распространенную ловушку: они успешно выполняют нейросетевые вычисления на GPU, но затем сразу же копируют вспомогательные данные (например, для случая object detection — это координаты ограничивающих рамок, типы распознанных объектов и их вероятности) в память CPU для запуска алгоритмов отслеживания объектов, таких как SORT или ByteTrack. Последующие вычисления на CPU приводят к значительным накладным расходам на синхронизацию и простоям конвейера.
Для обеспечения частоты 165 FPS я спроектировал логику отслеживания так, чтобы алгоритмы оперировали данными исключительно в видеопамяти (VRAM), не осуществляя лишних копирований в память процессора. Класс ObjectTracker использует структуру TypedBlock<TrackState>, размещенную непосредственно в памяти GPU. Это гарантирует, что история состояний (местоположение, скорости, вероятности классов) никогда не передается через шину PCIe.
Входные результаты детектирования, для которых алгоритмически требуется копирование в память CPU, передаются через массивы типа BoundaryMemType: они по умолчанию используют память GPU на архитектурах x64 и задействуют механизм ZeroCopy на архитектурах Jetson UMA. Таким образом обеспечивается оптимальное размещение данных для обоих типов аппаратного обеспечения.
Изначально использование функций стандартных библиотек, таких как thrust::sort, приводило к проблеме в критически важном цикле выполнения (hot-path loop): к неявным вызовам cudaMalloc. Чтобы полностью исключить динамическое выделение памяти во время работы, я заменил этот вызов на cub::DeviceMergeSort::SortKeys, передав ему предварительно выделенный буфер sortWorkspace, управление которым осуществляется через пул памяти FrameResources.
Данная сортировка применяется на этапе Non-Maximum Suppression (NMS) для фильтрации “сырых” предсказаний детектора, еще до начала трекинга объектов.
Сам конвейер трекинга объектов разделен на отдельные CUDA-ядра, выполняемые асинхронно и последовательно для каждого кадра из партии (batch).
3.1. Прогнозирование (PredictTracksKernel)
Перед сопоставлением трекер должен спрогнозировать, где должны находиться существующие объекты. Это ядро просто перебирает активные треки и применяет их текущие векторы скорости (vx, vy) к координатам bounding boxes. Оно также инкрементирует счетчики timeSinceUpdate и missedFrames — позже они будут сброшены в ноль, если удастся найти соответствие.
3.2. Cопоставление объектов (MatchDetectionsKernel)
Вместо сложного последовательного венгерского алгоритма это ядро использует возможности массового параллелизма GPU для активного сопоставления результатов детектирования с прогнозируемыми состояниями треков. Вычисление IoU для bounding boxes происходит непосредственно внутри ядра. Чтобы избежать ошибочных сопоставлений при кратковременном перекрытии объектов, ядро применяет динамический порог: если трек пропустил предыдущие кадры, требуемое значение IoU для подтверждения соответствия повышается с 0.30 до 0.45.
В сценариях плотного скопления объектов может возникать проблема гонки данных (data race N-to-1), то есть несколько независимых детектированных объектов могут одновременно претендовать на один и тот же трек. Чтобы разрешить такие коллизии строго в видеопамяти (без синхронизации с CPU), я внедрил механизм атомарных заявок (atomic claims). Ядро упаковывает значение IoU (старшие 32 бита) и индекс обнаружения (младшие 32 бита) в единое 64-битное целое число. Затем для фиксации заявки в выделенном буфере trackClaims используется атомарная операция atomicMax.
// Упаковка заявки: старшие 32 бита - IoU, младшие 32 бита - индекс
unsigned long long iouBits = (unsigned long long)__float_as_uint(bestIOU);
unsigned long long claim = (iouBits << 32) | (unsigned int)idx;
atomicMax(&trackClaims[bestTrackIdx], claim);
3.3. Обновление и фильтрация скорости (UpdateTracksKernel)
На этом этапе сначала происходит валидация прав владения треком. Потоки считывают финальное значение из буфера trackClaims и сверяют свой индекс с индексом потока-победителя. Если поток проиграл конкуренцию (значение IoU у другого перекрывающегося объекта оказалось выше), он сбрасывает свой индекс совпадения (trackIdx = -1) и переходит к логике создания нового независимого трека. Такой подход полностью защищает систему от “потери” детектированных объектов при значительном перекрытии.
Далее к победившим трекам применяются физические ограничения реального мира. Расчет скорости на основе bounding boxes известен своей нестабильностью, особенно когда объекты входят в кадр или покидают его. Когда рамка касается края экрана, объект частично обрезается, что смещает центр масс и приводит к возникновению резких скачков скорости.
Для решения этой проблемы ядро анализирует отступы (margins). Если объект касается левого края (det.x – det.w * 0.5f <= margin), ядро игнорирует левый край и для расчета мгновенной скорости (raw_vx) полностью полагается на правый край. После того как мгновенная скорость вычислена, она проходит через экспоненциальный сглаживающий фильтр (EMA) с коэффициентом TRACK_VELOCITY_FILTER_RATIO для стабилизации траектории:
// Логика адаптивной скорости (пример для оси Y)
bool touchingTop = (det.y - det.h * 0.5f) <= margin;
bool touchingBottom = (det.y + det.h * 0.5f) >= (heightF - margin);

if (touchingTop && !touchingBottom) {
    // Верхний край обрезан. Доверяем НИЖНЕМУ краю.
    float det_y_b = det.y + det.h * 0.5f;
    float t_y_b   = t.y + t.h * 0.5f;
    raw_vy = det_y_b - t_y_b + t.vy;
}
// ... логика повторяется для другого края/центра ...

// Применение фильтра
t.vy += (t.vy == 0 ? raw_vy : TRACK_VELOCITY_FILTER_RATIO * (raw_vy - t.vy));
Ядро также применяет байесовское обновление к массиву classProbs (с параметром TRACKER_ALPHA = 0.1), чтобы предотвратить мерцание классов между кадрами.
3.4. «Призраки» и удаление треков (GhostAndCleanupKernel)
Если объект временно перекрыт, или его детектирование отсутствует по другой причине, мы не хотим, чтобы его ID исчезал и появлялся заново. Система поддерживает так называемые «призрачные» треки (Ghost tracks). Если существующий трек отсутствует в течение нескольких кадров, ядро динамически возвращает в конвейер обнаружение типа «призрак». Это гарантирует, что модуль рендеринга продолжит отрисовывать прогнозируемую рамку, пока объект движется по инерции, например, за препятствием, скрывающим его из виду.
Однако для корректного удаления неактуальных треков система должна отсеивать выбросы, вычисляя глобальную среднюю скорость всех установившихся треков в текущем кадре. Использование стандартных вызовов atomicAdd для работы с разделяемой памятью (shared memory) в данном случае может приводить к сильной конкуренции между потоками. Вместо этого ядро использует двухуровневую архитектуру редукции в сочетании с циклом с шагом по размеру сетки ядра (grid-stride loop): сначала потоки суммируют значения скоростей на уровне регистров, используя warp-примитив __shfl_down_sync.
__inline__ __device__ float warp_reduce_sum(float val) {
#pragma unroll
    for (int s = 16; s >= 1; s >>= 1) {
        val += __shfl_down_sync(0xFFFFFFFF, val, s);
    }
    return val;
}
Использование паттерна grid-stride loop позволяет cuda-ядру масштабироваться и безопасно обрабатывать массивы bounding boxes, размер которых превышает жесткое аппаратное ограничение в 1024 потока на один CUDA-блок.
    int idx = threadIdx.x + blockDim.x * blockIdx.x;
    // ...
    // The grid stride loop
    int sidx = idx;
    while (sidx < totalTracks /* ... */) {
        // ...
        sidx += gridDim.x * blockDim.x;
    }
В каждом варпе поток с индексом 0 («Lane 0») записывает полученную частичную сумму в блок динамически выделяемой разделяемой памяти (extern shared float s_reduce[]). Затем нулевой варп («Warp 0») выполняет финальную редукцию на уровне блока.
Траектории, слишком сильно отклоняющиеся от полученного таким образом корректного глобального среднего значения, немедленно помечаются как подлежащие удалению (t.age = -999).
3.5. Компактизация с нулевым копированием (CompactTracksKernel)
Наконец, из массива необходимо удалить неактивные («мертвые») треки. Стандартные функции, такие как thrust::remove_if, требуют использования тяжеловесных барьеров синхронизации. Чтобы полностью избежать этого, я реализовал специализированное ядро CompactTracksKernel.
Если предыдущие этапы конвейера трекинга требуют запуска для каждого кадра, то CompactTracksKernel запускается один раз после отработки полной пачки кадров (batch). Ядро анализирует активные треки и безопасно переносит сохранившиеся элементы в предварительно выделенный вспомогательный буфер (tempTracks_), используя атомарный счетчик. Этап уплотнения завершается на стороне хоста операцией обмена указателями с временной сложностью O(1) (tracksBuffer.raw().swap(tempTracksBuffer.raw())). Это мгновенно подготавливает состояние для следующего шага, не требуя ни одной операции копирования памяти (device-to-device memcpy) внутри устройства.
4. Результаты, тесты производительности и сравнение бэкендов
4.1. Архитектура профилирования
При разработке высокопроизводительных систем на C++ и CUDA невозможно оптимизировать то, что не поддается измерению. Чтобы выявить «узкие места» и при этом избежать накладных расходов на синхронизацию, я создал модульную систему профилирования, описанную в файле PerformanceTimer.h:
-
PerformanceTimer: класс таймера, реализующий идиому RAII и использующий std::chrono::high_resolution_clock для измерения общего времени выполнения (wall-clock time) и задержек инициализации.
-
Stopwatch: легковесный класс таймера с ручным управлением, который создается внутри критических циклов для профилирования отдельных этапов конвейера.
-
PipelineStats: потокобезопасный накопитель метрик, использующий std::atomic<double> и std::atomic<long long> для параллельного суммирования времени выполнения в разных потоках (std::atomic используется вместо std::mutex в PipelineStats, чтобы избежать взаимных блокировок в трех высоконагруженных потоках конвейера).
Поскольку конвейер работает асинхронно в трех выделенных потоках, простое суммирование времени работы отдельных компонентов дает результат, превышающий общее время выполнения процесса. Для объективного представления нагрузки метод PipelineStats::PrintReport() вычисляет относительную долю активной работы, деля время выполнения каждого этапа на суммарное время работы всех активных компонентов. Ниже приведен пример отчета при реальном запуске.
=======================================================
          ОТЧЕТ О РАБОТЕ КОНВЕЙЕРА ИНФЕРЕНСА
=======================================================
Всего обработано кадров: 122
Всего обработано пакетов (батчей): 8

1. Инициализация: 745 ms
2. Общее время работы конвейера: 570 ms (214.04 FPS)

3. Декодирование (Source):
   - Всего:           280.83 ms
   - В среднем/пакет: 35.10 ms
   - В среднем/кадр:  2.30 ms
   - Доля:            30.23% (активной работы)

4. Инференс (Detector):
   - Всего:           465.24 ms
   - В среднем/пакет: 58.15 ms
   - В среднем/кадр:  3.81 ms
   - Доля:            50.07% (активной работы)

5. Сохранение данных (Sink):
   - Всего:           183.05 ms
   - В среднем/пакет: 22.88 ms
   - В среднем/кадр:  1.50 ms
   - Доля:            19.70% (активной работы)

=======================================================
Для более детального и глубокого профилирования, выявления конкретных ядер или операций, являющихся “узким местом”, я активно использую NVIDIA Nsight Systems.
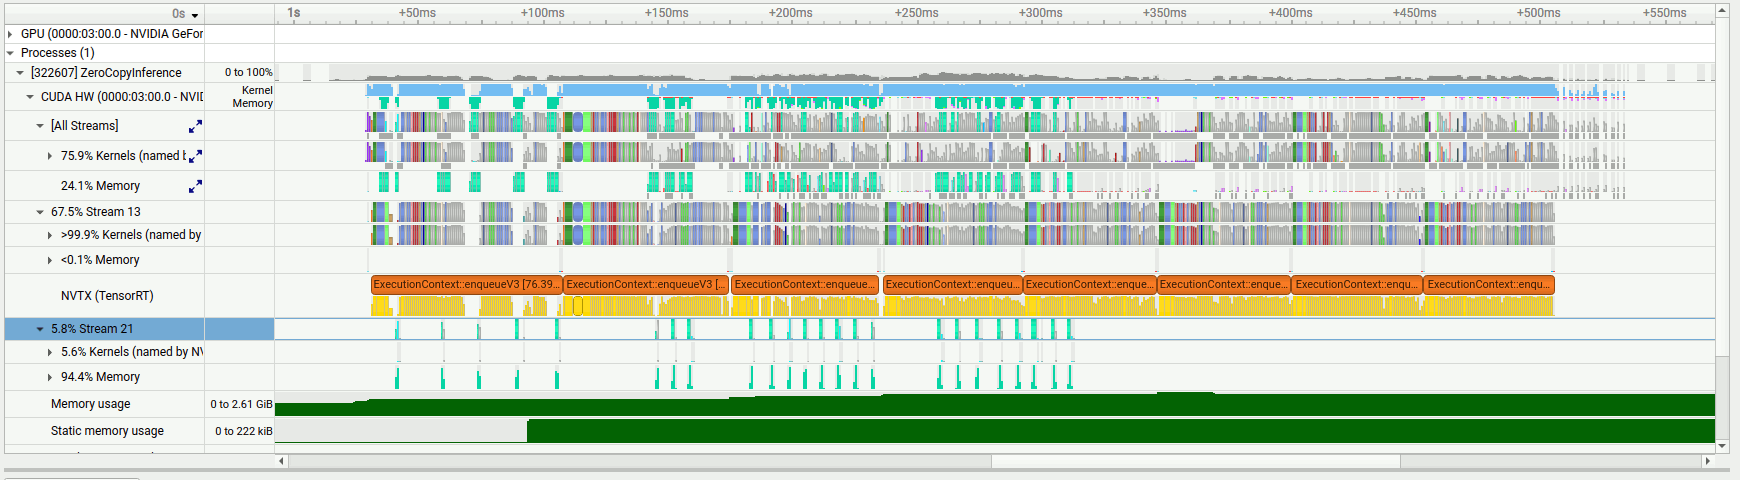
На диаграмме видно, что при работе NVJpegSource в качестве источника входных кадров достигается основная цели асинхронной архитектуры – плотная, практически непрерывная упаковка контекстов выполнения TensorRT (оранжевые блоки).
Благодаря двойной буферизации и пулу логических декодеров в классе NVJpegSource, графический процессор не простаивает в ожидании данных от процессора, что возлагает основную нагрузку непосредственно на этап инференса нейросети.
4.2. Реальные показатели
Тестирование конвейера проводилось на NVIDIA RTX 3060 Ti и NVIDIA Jetson Orin Nano Super.
Входные данные: Видеопоток 1440p или директория с кадрами в формате JPEG.
Модель: YOLOv8 Medium (YOLOv8m) с разрешением 1024×1024.
4.2.1. Предел инфраструктуры (режим-заглушка / Stub Mode) — RTX 3060 Ti
Для измерения накладных расходов архитектуры конвейера (задержки ввода-вывода) используется детектор-заглушка, пропускающий данные насквозь без обработки.
|
Тип входных данных |
Пропускная способность |
Задержка декодирования |
Примечание |
|
Видеопоток (FFMpeg) |
~300 – 470 FPS |
~2,1 – 3,3 мс |
Предел аппаратного декодирования cильно зависит от используемого кодека (H.264 / H.265). |
|
Директория с изображениями (NVJpeg) |
~430+ FPS |
~1,38 мс |
Используется многопоточное асинхронное декодирование и двойная буферизация. |
4.2.2. Инференс нейросети (режим TensorRT INT8) — RTX 3060 Ti
Запуск YOLOv8m (с явной квантизацией INT8) с полным отслеживанием объектов и сохранением с помощью NVJpegSink.
Сценарий A: Видеопоток (источник FFmpeg)
|
Показатель |
Результат |
Примечание |
|
Пропускная способность (H.264) |
~165 FPS |
Базовый формат (AVC). >2,5x от скорости реального времени. |
|
Пропускная способность (H.265) |
~190 FPS |
Высокоэффективный формат (HEVC). Аппаратная обработка укрупненных CTU-блоков. >3,0x от скорости реального времени. |
|
Узкое место |
Декодирование |
Инференс выполняется настолько быстро (~3,36 мс), что для обоих кодеков декодирование – самый нагруженный этап (доля активной работы для H.265 составляет ~46% против ~41% у инференса). |
Сценарий B: Директория с изображениями (источник NVJpeg)
|
Показатель |
Результат |
Примечание |
|
Общая пропускная способность |
~215 FPS |
Общее время выполнения (End-to-End). | >3,5x от скорости реального времени |
|
Смена «узкого места» |
Инференс |
Асинхронная двойная буферизация сокращает время декодирования до ~2,51 мс, перенося «узкое место» на инференс нейросети. |
Распределение нагрузки (обработка изображений из папки):
-
Декодирование (источник): ~2,51 мс/кадр (нагрузка 32,01%)
-
Инференс (детектор): ~3,78 мс/кадр (нагрузка 48,26%)
-
Запись/хранение (приемник): ~1,55 мс/кадр (нагрузка 19,73%)
В случае с каталогами изображений (**NVJpegSource**), где используется исключительно внутрикадровое сжатие, распараллеливание работает превосходно, так как нагрузка распределяется одновременно между несколькими потоками CPU и аппаратными декодерами JPEG.
Для видеопотоков (**FFmpegSource**) характер обработки по своей сути последователен, а «узким местом» становится единственный аппаратный блок NVDEC.
4.2.3 Сравнение бэкендов и точности — RTX 3060 Ti
Конвейер поддерживает как бэкенд TensorRT (высокая оптимизация), так и ONNX Runtime (универсальная совместимость).
|
Бэкенд / Точность |
FPS |
Задержка (инференс) |
Коэффициент ускорения |
Примечание |
|
TensorRT (INT8) |
~165 |
~3,36 мс |
1,4x |
Максимальная производительность. |
|
TensorRT (FP16) |
~118 |
~5,58 мс |
1,0x (база) |
Базовое ускорение. |
|
ONNX Runtime |
~38 |
~24,2 мс |
0,33x |
Универсальность выполнения моделей. |
Примечание: Квантование до INT8 обеспечило значительный прирост пропускной способности при потере всего 0,007 mAP@50 (снижение с 0,862 до 0,855).
4.2.4. Производительность на периферийном устройстве — Jetson Orin Nano Super 8GB
Сценарий: Входное разрешение 1440×1440 (папка с JPEG-кадрами).
Модель: YOLOv8 Medium (YOLOv8m) 1024×1024.
ONNX Runtime не поддерживается.
|
Показатель |
Результат, FPS |
Примечаниe |
|
Предел производительности инфраструктуры (заглушка) |
~160 |
Максимальная скорость конвейера при использовании MMAPI (без инференса нейросети). |
|
TensorRT (FP16) + NVJpeg |
~22.2 |
Базовое аппаратное ускорение (CUDA NVJPEG). |
|
TensorRT (INT8) + NVJpeg |
~31.4 |
Быстрый инференс; задачи декодирования/кодирования выполняются на ядрах CUDA SM. |
|
TensorRT (INT8) + MMAPI |
~38.0 |
Пиковый показатель. Операции ввода-вывода перенесены на выделенные аппаратные средства. |
Примечание: тестирование проводилось на устройстве NVIDIA Jetson Orin Nano Super 8GB с использованием стандартного профиля энергопотребления 25 Вт (nvpmodel -m 1).
5. Заключение и выводы
Почему быстрые модели — это только половина дела:
В индустрии Computer Vision основное внимание традиционно уделяется нейросетям: подбору архитектуры, квантованию до INT8, экспорту в TensorRT. Однако на практике, когда время инференса модели сокращается до единиц миллисекунд, реальным узким местом становится окружающая инфраструктура.
Чтобы добиться стабильных 165+ FPS на пользовательской RTX 3060 Ti и выжать 38 FPS из Jetson Orin Nano, критически важно оптимизировать весь конвейер данных:
-
Идеология Zero-Host-Copy: пиксели кадров остаются исключительно в VRAM на всех этапах — от декодирования до финального сохранения.
-
Zero-Allocation в Hot Phase: исключение cudaMalloc и new и любых синхронных аллокаций в горячем цикле при помощи циклических очередей повторного использования.
-
Аппаратная специфика (UMA vs PCIe): реализация классов управления памятью, поддерживающих абстракции, обозначающие локальность данных, позволяет максимально эффективно использовать механизмы обеих архитектур, например, Pinned для DMA по PCIe или ZeroCopy/Mapped для разделяемой шины Jetson.
-
Асинхронность и двойная буферизация: маскирование задержек дискового ввода-вывода через независимые потоки и пинг-понг буферы.
-
Трекинг объектов на GPU: выполнение IoU, сглаживания скоростей и варп-редукций (__shfl_down_sync) в специализированных CUDA-ядрах без выгрузки результатов детектирования на CPU.
Автор: igkho

