


Задача звучит в одну строку: «развернуть новый веб-сервис в AWS и сделать джобы для деплоя». Внутри неё — сеть, контейнеры, база, секреты, CDN, два workflow и десятки мелких действий, которые инженер обычно держит в голове. Пока всё идёт по плану, это работает. Но стоит отвлечься на созвон, и уже непонятно, проверили ли вы security group, а на вопрос «сколько займёт» остаётся честный ответ «день-два». В статье разберу, как опытный инженер раскладывает такую задачу на этапы, действия, проверки и откат, где этот процесс ломается и как заставить агента , от git clone до открытого в браузере сайта.
Я занимаюсь построением IT-инфраструктур около 15 лет, сейчас руковожу DevOps-командой в игровой студии. Задачи вида «подними новый сервис» / “внеси изменения в систему Х” прилетают каждую неделю, и за эти годы у меня сложился довольно устойчивый способ их планировать. Этот способ я и попробовал формализовать, а потом отдать агенту.
Часть 1. Как инженер планирует задачу
Возьмём конкретную задачу:
Развернуть новый веб-сервис в AWS. У него React-фронтенд и Python-бэкенд, для работы нужен PostgreSQL. Есть github репозиторий с приложением . В результате в GitHub должны появиться джобы для развёртывания инфраструктуры и деплоя приложения.
Ничего необычного. Такие задачи прилетают регулярно, и каждый, кто работает с инфраструктурой, примерно представляет, что за ними стоит. Давайте разберём, что происходит в голове инженера, когда она приходит, — по шагам, медленнее, чем это происходит на самом деле.
Шаг 1. Собрать контекст
Прежде чем что-то планировать, инженер отвечает себе на три вопроса:
-
Что за проект? Кто им пользуется, насколько он критичен, есть ли у него окружения кроме прода.
-
Как устроена текущая инфраструктура? Какие аккаунты AWS, где хранится state Terraform, как устроены сети, какой CI/CD уже есть.
-
Что известно о продуктах из задачи? Здесь это AWS, PostgreSQL и GitHub Actions: какие сервисы AWS подходят, какую версию Postgres взять, как Actions будут ходить в облако.
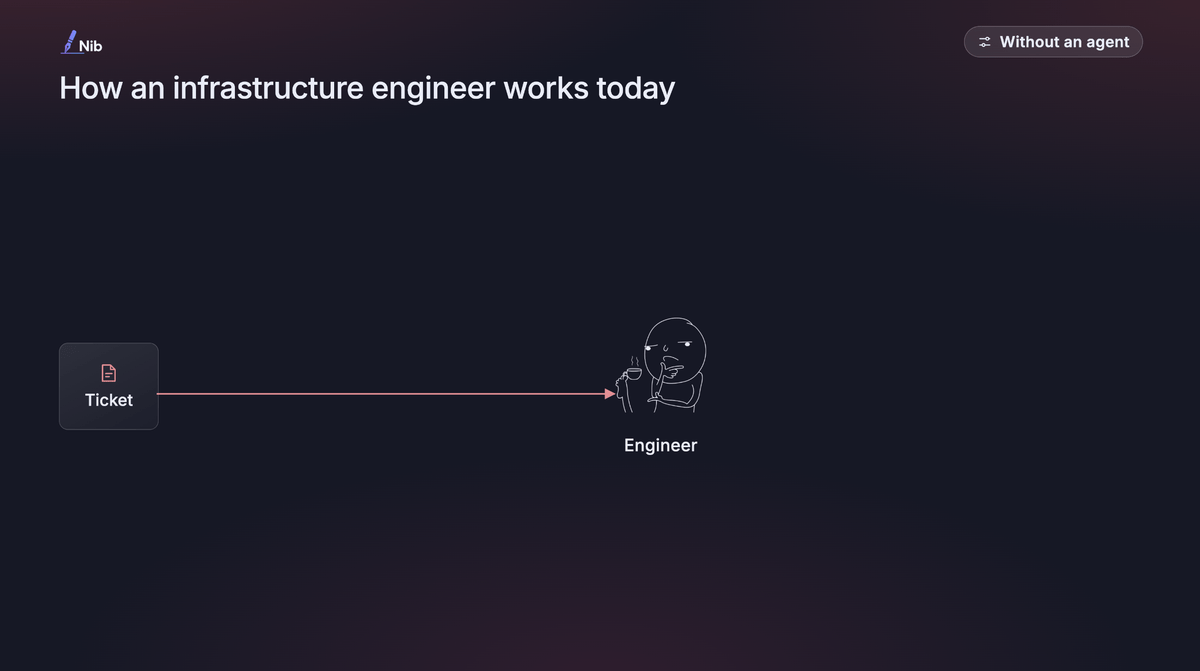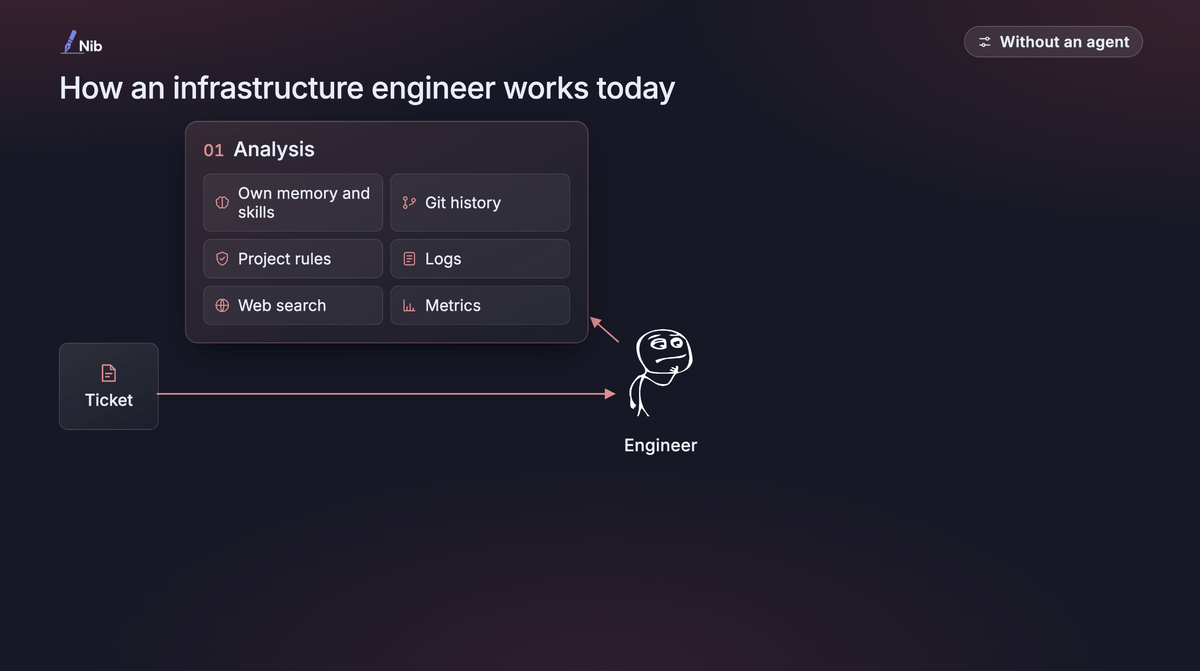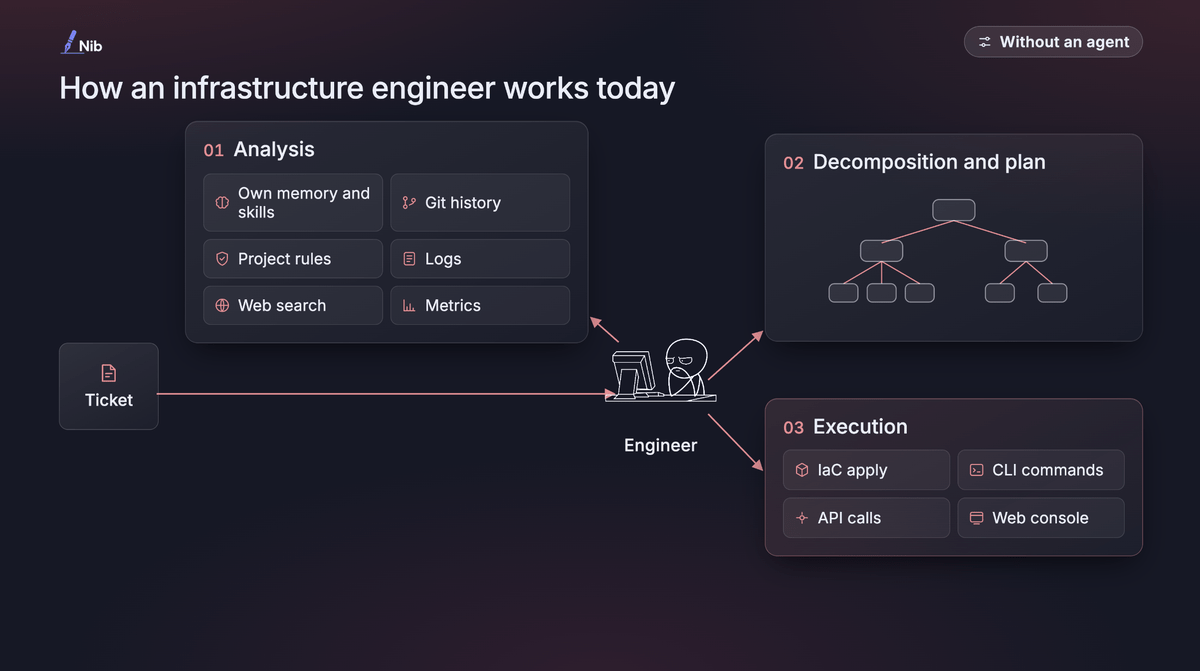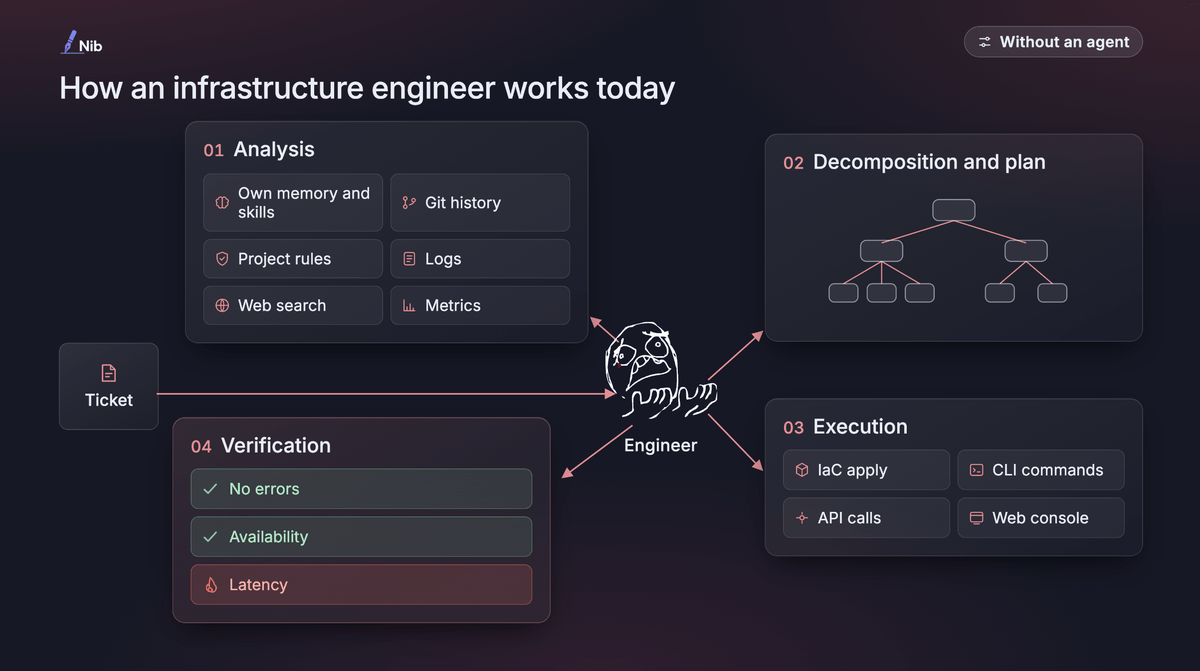
Часть ответов хранится прямо в голове. Недостающее инженер добирает из git и wiki: обычно это детали устройства инфраструктуры и внутренние правила компании по работе с облаком, базами данных и CI/CD.
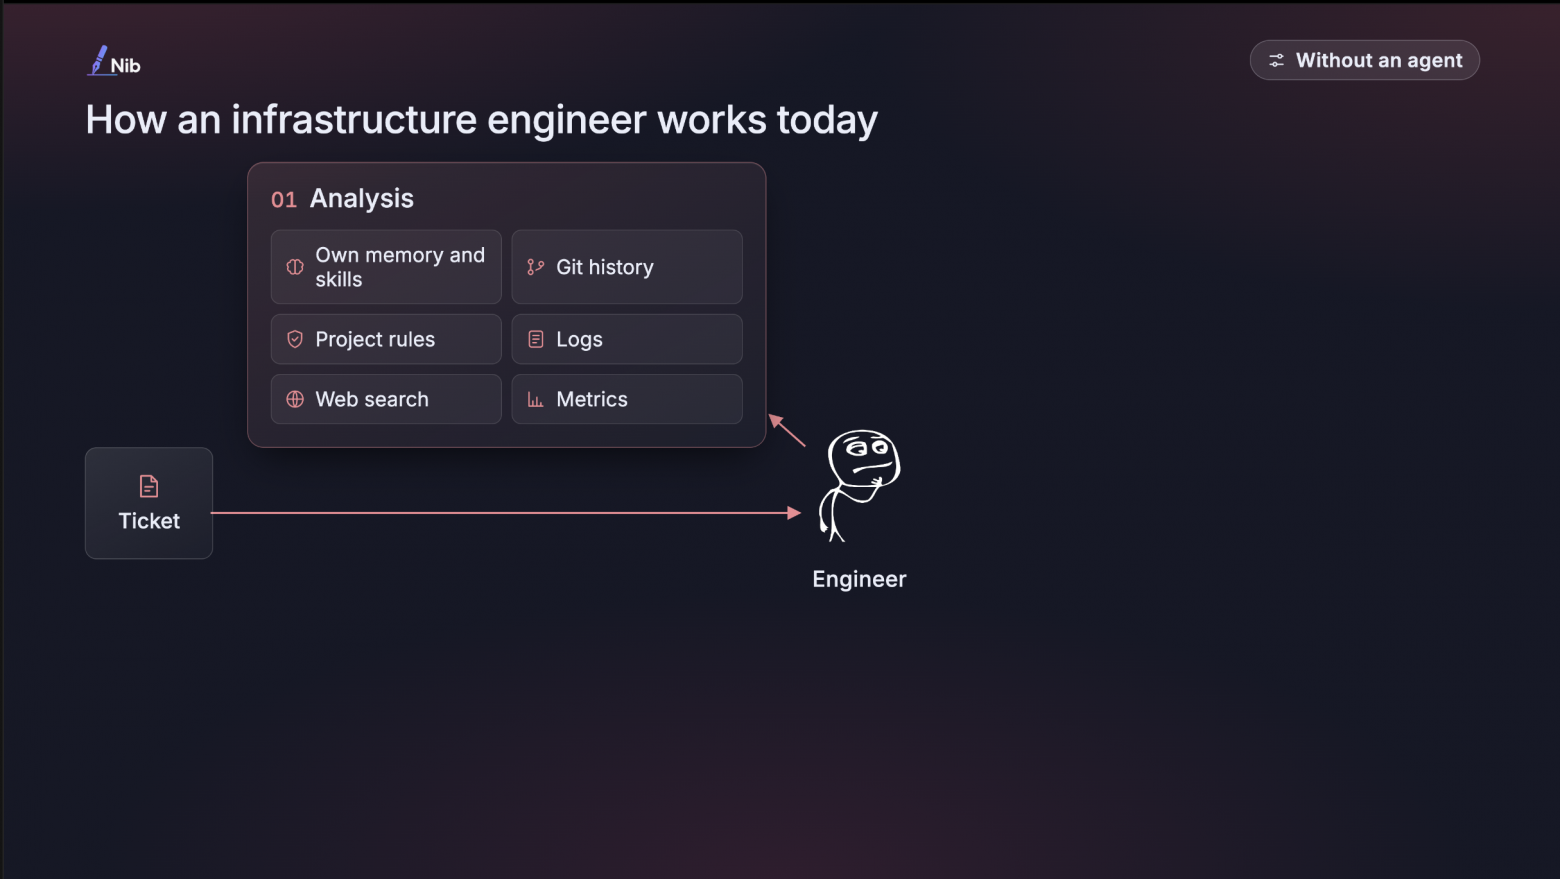
Уже на этом шаге видна первая проблема, к которой мы ещё вернёмся: часть контекста не записана нигде, кроме головы конкретного человека.
Шаг 2. Наметить этапы
Когда контекст собран, задача распадается на крупные этапы:
-
Подготовить инфраструктурный код для ресурсов в AWS.
-
Написать build- и deploy-workflow.
-
Создать ресурсы в AWS.
-
Развернуть приложение.
-
Проверить, что всё работает.
Этапы связаны зависимостями: нельзя задеплоить приложение, пока нет кластера, и нельзя создать кластер, пока нет кода. Зависимости важнее самого списка, потому что именно они определяют, что можно делать параллельно, а что нет.
Шаг 3. Разложить этапы на элементарные действия
Каждый этап — это набор простых действий, которые можно выполнить за один подход:
-
поправить файл;
-
выполнить команду в CLI;
-
сделать API-вызов;
-
что-то настроить в UI.
Например, «создать ресурсы в AWS» распадается на цепочку: создать бакет под state, настроить доступ GitHub Actions к аккаунту, выполнить terraform plan, прочитать diff, выполнить terraform apply, посмотреть outputs.
Шаг 4. Опереться на правила и опыт
Чтобы выстроить действия в правильном порядке, инженер опирается на две вещи:
-
Принятые в команде правила. Как называем ресурсы, где храним state, какие теги обязательны, чего никогда не делаем в проде.
-
Собственный опыт. Он уже делал что-то похожее и помнит, где было больно в прошлый раз.
Правила обычно хоть как-то записаны. Опыт почти никогда: это знание вида «NAT-шлюз в каждой зоне стоит денег, согласуй заранее» или «после первого деплоя ECS-сервис будет пытаться поднять несуществующий образ».
Шаг 5. Собрать план: действие, проверка, откат
Из этих кирпичиков складывается детальный план. Как правило, в голове, реже на бумаге. Хороший план содержит три вещи:
-
действия — что именно делаем;
-
проверки перед завершением каждого этапа — как понять, что этап действительно закончен, а не «вроде прошло»;
-
план отката на случай, если что-то пойдёт не так.
Вот как это может выглядеть для одного этапа нашей задачи:
|
Действие |
Проверка |
Откат |
|
|
в diff только создание ресурсов, ни одного |
не требуется, ничего не изменено |
|
|
outputs на месте, RDS в статусе |
|
|
запуск deploy-workflow |
джоба зелёная, smoke-тест проходит, сайт открывается |
откат ECS-сервиса на предыдущую ревизию task definition |
Колонка «Откат» — та, которую чаще всего оставляют пустой. Честно ответьте себе: когда вы последний раз писали план отката до того, как он понадобился?
Шаг 6. Исполнить
Дальше инженер проходит весь список: действие, проверка, действие, проверка. Если проверка не прошла — откат или исправление, и снова проверка.
Довольно муторно, правда?
Описанный процесс хорош на бумаге. На практике он регулярно ломается в трёх местах.
-
Список действий живёт в голове, и из него выпадают пункты. Вас отвлекли на созвон, пришёл алерт, коллега попросил глянуть его PR. Через час вы возвращаетесь к задаче и уже не уверены, закрыли ли вы порт базы наружу. План в голове не переживает переключения контекста, и его невозможно передать коллеге, если вы заболели посреди задачи. У меня так было при переезде бакетов с ассетами из одного облака в другое. Данные перенёс, доступы настроил, а CORS добавить забыл. Шаг занимает пару строк конфигурации и в голове кажется настолько очевидным, что ни в какой список не попадает.
-
Проверки выполняются не полностью. Хочется сэкономить время: «сайт открылся — значит, работает». А то, что база доступна из интернета или бэкап не настроен, всплывает через месяц. Проверки — первое, чем жертвуют под дедлайн, потому что их пропуск ничего не ломает сразу.
-
Нет понимания, насколько задача сложная. На вопрос «сколько займёт?» звучит «день-два». Это не оценка. Пока задача не разложена на действия, её объём просто не виден — ни вам, ни тимлиду, ни тому, кто её поставил.
У всех трёх одна причина: план существует только в голове исполнителя, поэтому его нельзя ни передать коллеге, ни посчитать.
Что, если план будет строить агент
Отсюда естественный вопрос: а что, если декомпозицию, планирование, исполнение и проверки будет делать агент? Инженер при этом по-прежнему контролирует этапы, решает, какие шаги запускать, и принимает конечный результат.
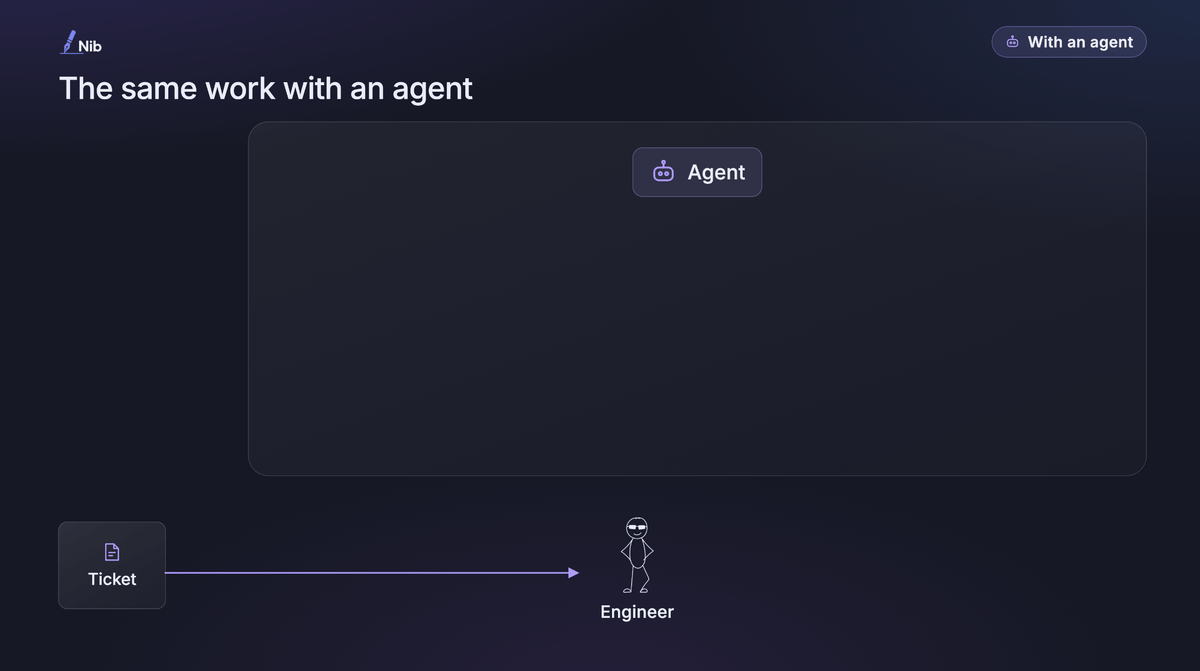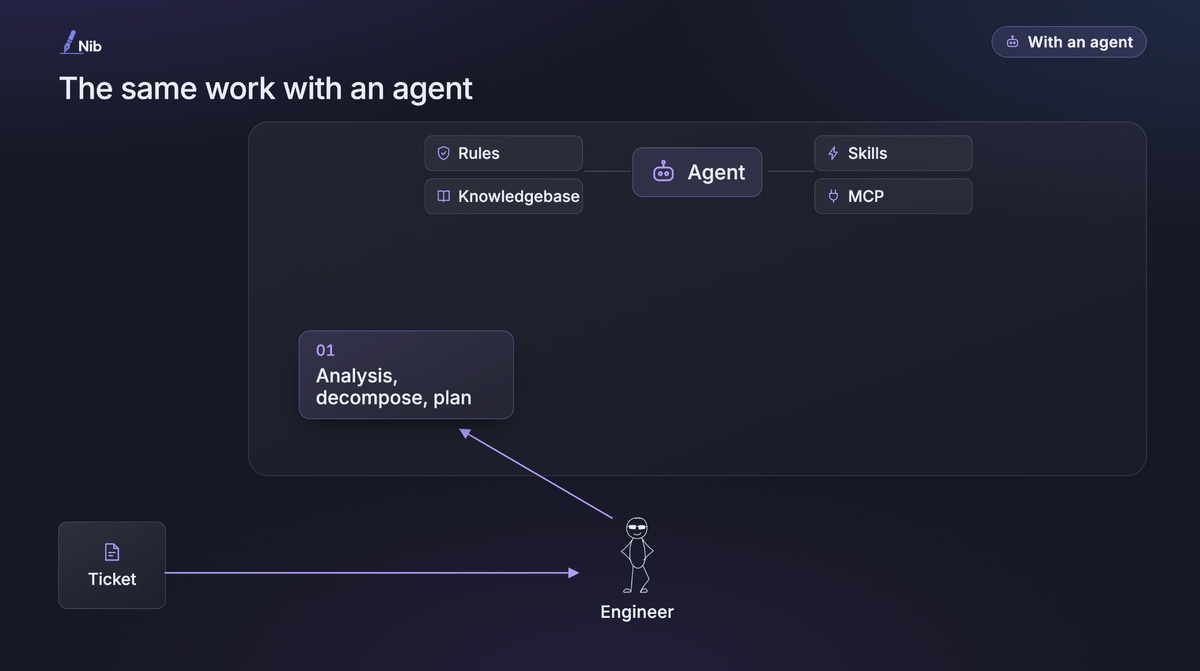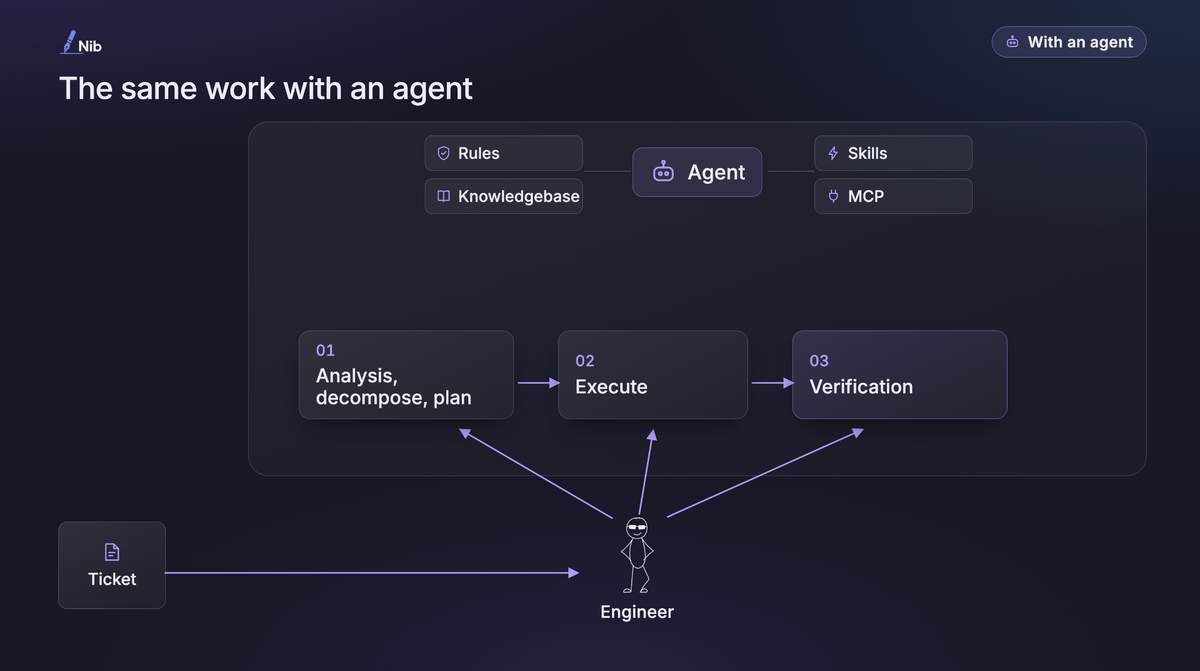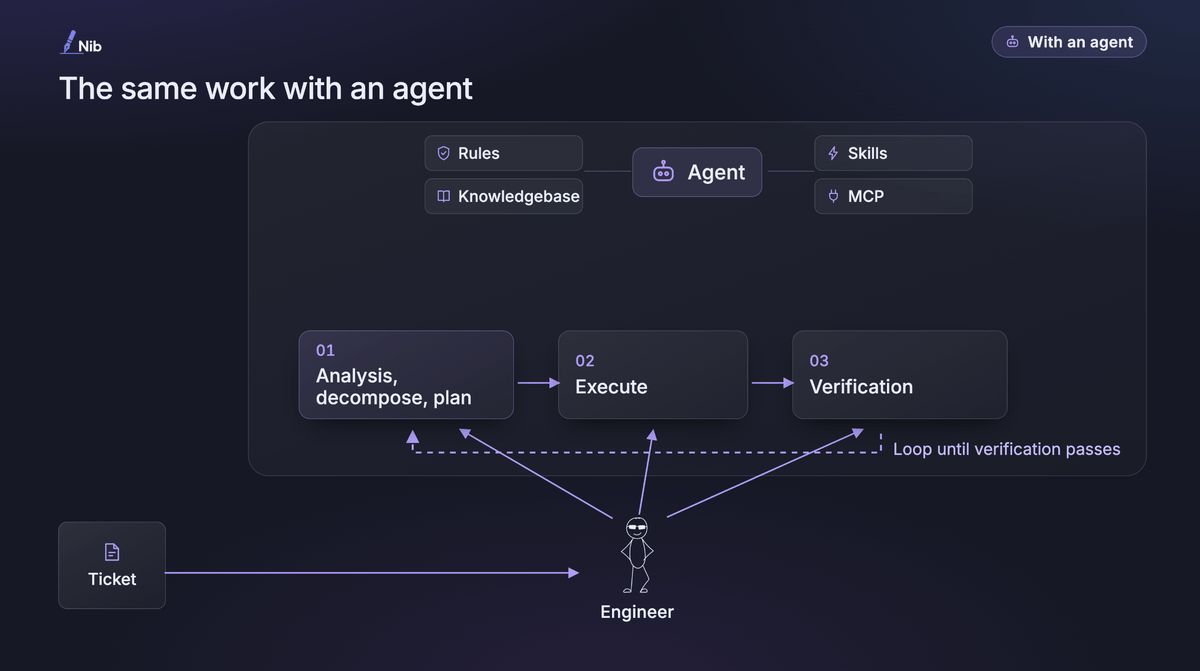
Для этого я и сделал nib (Neuro Infrastructure Builder). Это opensource инструмент для инфраструктурной работы: он раскладывает задачу на этапы, для каждого этапа расписывает конкретные действия с проверками, строит план отката, а затем либо выполняет шаги сам, либо даёт оператору максимально подробную инструкцию.
Внутри nib повторяет ту же логику, что и инженер из первой части. Работа разбита на режимы (или сабагенты), у каждого своя роль:
|
Режим |
Что делает |
Аналог в голове инженера |
|
Decompose |
задаёт уточняющие вопросы, выделяет этапы и зависимости между ними |
шаги 1–2 |
|
Plan |
по агенту на каждый этап, параллельно расписывают действия и проверки; отдельный агент строит откат |
шаги 3–5 |
|
Execute |
выполняет конкретное действие через подключённые инструменты |
шаг 6 |
Контекст, правила и опыт, на которые опирается инженер, в nib тоже есть: это база знаний, правила (rules) и навыки (skills). В этой статье мы используем только базу знаний, остальное — тема следующей части.
Часть 2. От git clone до работающего сайта
Теперь проведём ту же задачу через nib. Весь путь показан на видео:
Что понадобится
-
Docker.
-
API-ключ LLM-провайдера. nib работает с любым OpenAI-совместимым API; при установке есть готовые пресеты для OpenAI, OpenRouter, Google Gemini, Qwen, DeepSeek, Grok и Kimi.
-
Аккаунт AWS. Настоятельно рекомендую отдельный, песочничный: агенту понадобятся ключи с правом создавать ресурсы. Можно использовать другое облако с сопоставимым функионалом
-
GitHub-аккаунт и форк demo-app, если хотите повторить именно эту задачу.
Установка
nib можно поставить локально через Docker Compose или в Kubernetes через Helm-чарт. Для знакомства хватит локального варианта:
git clone https://github.com/javdet/nib.git
cd nib
make setup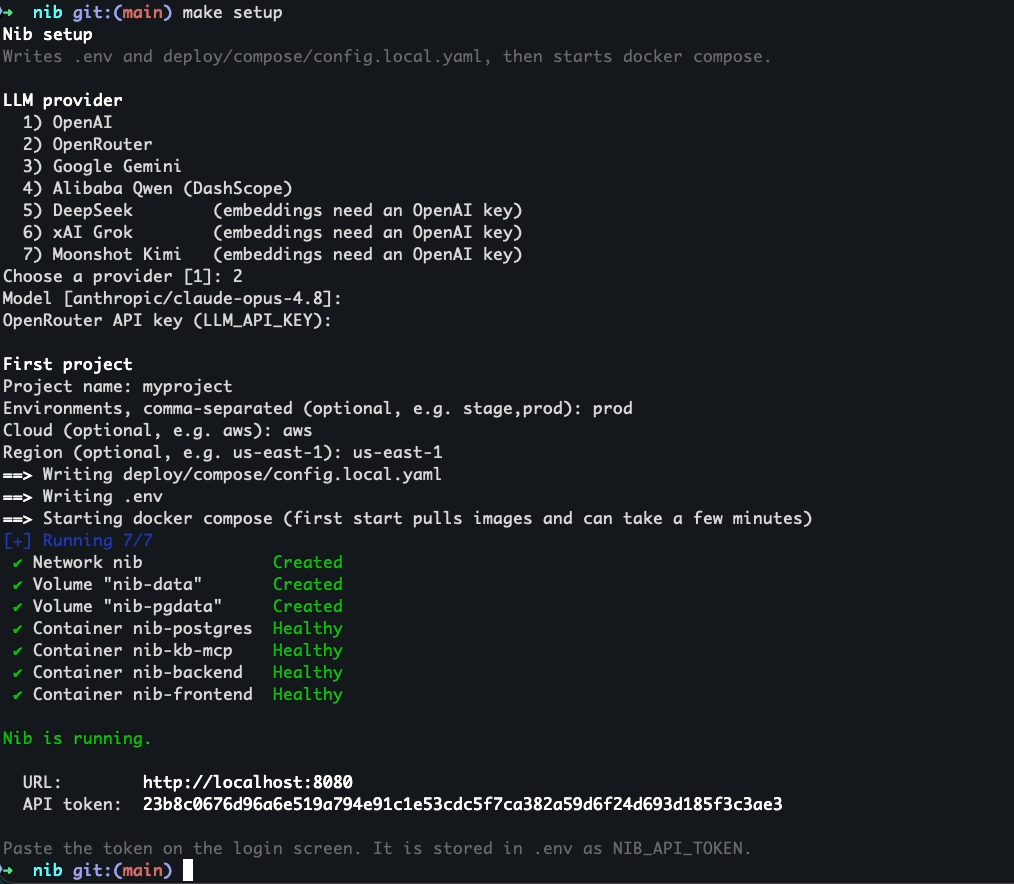
В конце скрипт печатает адрес интерфейса (по умолчанию http://localhost:8080, если порт занят — выберет свободный) и API-токен. Этот токен вставляется на экране входа, он же сохраняется в .env как NIB_API_TOKEN, так что потерять его сложно.
База знаний: что заполнить для нового проекта
Первое, что стоит открыть после входа, — раздел Knowledgebase. Это тот самый «контекст» из первого шага: всё, что инженер знает о компании и проекте, а агент — нет.
В карточке Company Information заполняются базовые поля: название и описание компании, система контроля версий и базовый URL git, git-пользователь, CI/CD-система, трекер задач, wiki и мессенджер команды. Для нашей задачи ключевые — GitHub как VCS и GitHub Actions как CI/CD: от этого зависит, какие workflow агент будет писать.
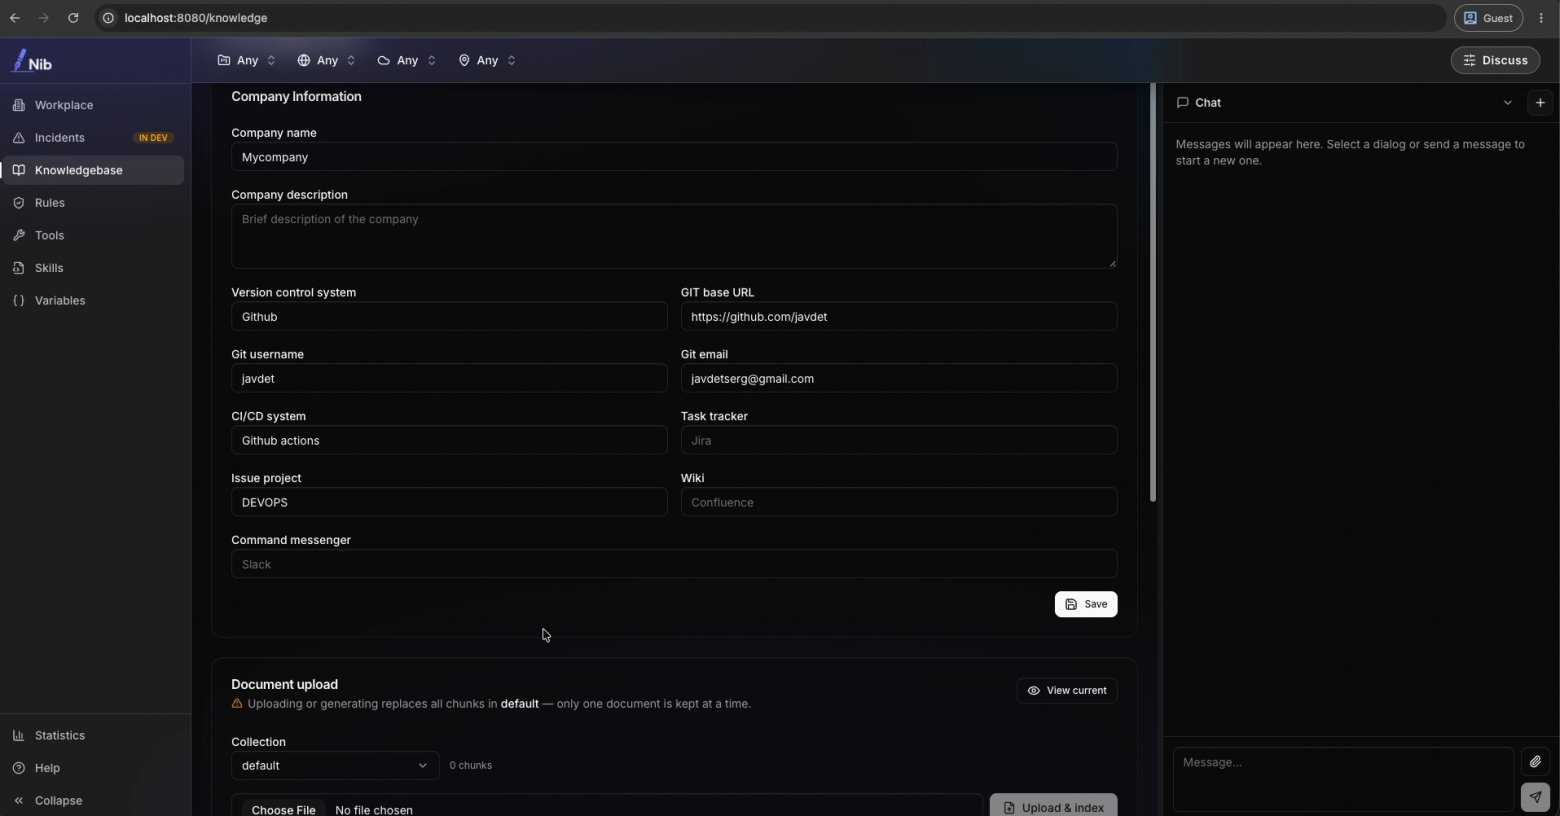
Загружать документы для нового проекта пока не нужно: описывать ещё нечего. На живом проекте сюда стоит положить то, что обычно лежит в wiki и в головах: схему сетей, соглашения об именовании, где хранится state, особенности окружений. Документ можно загрузить в формате Markdown или попросить агента сгенерировать его по списку репозиториев.
Когда план завершается, nib пишет отчёт и обновляет по нему базу знаний, так что следующая задача стартует уже с тем, что агент узнал в предыдущей.
Подключаем GitHub, AWS и поиск через MCP
Сам по себе агент умеет только думать. Чтобы он мог создать репозиторий, посмотреть ресурсы в AWS или найти документацию, ему нужны инструменты. В nib они подключаются через MCP (Model Context Protocol) — открытый протокол, по которому LLM-приложение получает от внешнего сервера список инструментов и вызывает их. Один MCP-сервер — одна система: GitHub, AWS, поиск.
Если не знаете, с чего начать, спросите самого nib, например: «Как подключить тебя к AWS через MCP?» Его ответ есть на видео.
Для нашей задачи нужны три сервера:
-
GitHub — работа с репозиторием, PR и workflow;
-
AWS — чтение и создание ресурсов в аккаунте;
-
SearXNG — поиск в интернете, чтобы агент мог свериться с актуальной документацией, а не полагаться только на то, что знает модель.
nib поддерживает только HTTP-транспорт MCP (streamable HTTP), поэтому все три сервера поднимаем контейнерами в той же сети, что и nib. Добавляем их в docker-compose.yml.
Кусок docker-compose.yml
  github-mcp:
    image: ghcr.io/github/github-mcp-server:latest
    restart: unless-stopped
    command:
      - http
      - --port=9082
    networks:
     - nib

  aws-mcp:
    image: public.ecr.aws/awslabs-mcp/awslabs/aws-api-mcp-server:latest
    restart: unless-stopped
    environment:
      AWS_API_MCP_TRANSPORT: "streamable-http"
      AWS_API_MCP_HOST: "0.0.0.0"
      AWS_API_MCP_PORT: "9081"
      AUTH_TYPE: "no-auth"
      AWS_REGION: "${AWS_REGION:-us-east-2}"
      AWS_API_MCP_ALLOWED_HOSTS: "aws-mcp,localhost,127.0.0.1"
      AWS_API_MCP_ALLOWED_ORIGINS: "aws-mcp,localhost,127.0.0.1"
      READ_OPERATIONS_ONLY: "false"
      REQUIRE_MUTATION_CONSENT: "false"
      AWS_ACCESS_KEY_ID: "${AWS_ACCESS_KEY_ID}"
      AWS_SECRET_ACCESS_KEY: "${AWS_SECRET_ACCESS_KEY}"
      AWS_SESSION_TOKEN: "${AWS_SESSION_TOKEN:-}"
    networks:
      - nib

  searxng:
    image: docker.io/searxng/searxng:latest
    restart: unless-stopped
    environment:
      SEARXNG_PORT: "9083"
      SEARXNG_BASE_URL: "http://searxng:9083/"
      SEARXNG_SECRET: "${SEARXNG_SECRET}"
    volumes:
      - ./searxng:/etc/searxng:rw
    networks:
      - nib

  searxng-mcp:
    image: docker.io/isokoliuk/mcp-searxng:latest
    restart: unless-stopped
    environment:
      SEARXNG_URL: "http://searxng:9083"
      SEARXNG_DEFAULT_RESPONSE_FORMAT: "json"
      SEARXNG_MAX_RESULT_CHARS: "500"
      SEARXNG_TIMEOUT_MS: "15000"
      MCP_HTTP_PORT: "9084"
      MCP_HTTP_HOST: "0.0.0.0"
      MCP_HTTP_STATELESS: "true"
    networks:
      - nib
Здесь стоит остановиться на трёх строках, потому что они определяют, что агент сможет сделать с вашим аккаунтом:
-
READ_OPERATIONS_ONLY: "false"разрешает изменяющие операции. Без этого агент сможет только смотреть. -
REQUIRE_MUTATION_CONSENT: "false"отключает подтверждение каждой изменяющей операции на стороне MCP-сервера. Подтверждение остаётся в nib: действие выполняется, только когда вы сами нажимаете Execute. -
AUTH_TYPE: "no-auth"допустим только потому, что у сервиса нет секцииportsи он доступен лишь внутри docker-сети. Публиковать такой порт наружу нельзя.
Прописываем серверы в nib
Теперь nib нужно рассказать, где искать эти серверы. Конфиг MCP редактируется в разделе Tools → Config (или через Tools → MCP Servers → Add):
mcp.json
{
  "mcpServers": {
    "knowledge-base": {
      "url": "http://kb-mcp:8081/mcp"
    },
    "aws": {
      "type": "http",
      "url": "http://aws-mcp:9081/mcp"
    },
    "searxng": {
      "type": "http",
      "url": "http://searxng-mcp:9084/mcp"
    },
    "github": {
      "type": "http",
      "url": "http://github-mcp:9082/",
      "headers": {
        "Authorization": "Bearer ${GITHUB_TOKEN}",
        "X-MCP-Toolsets": "all",
        "X-MCP-Readonly": "false"
      }
    }
  }
}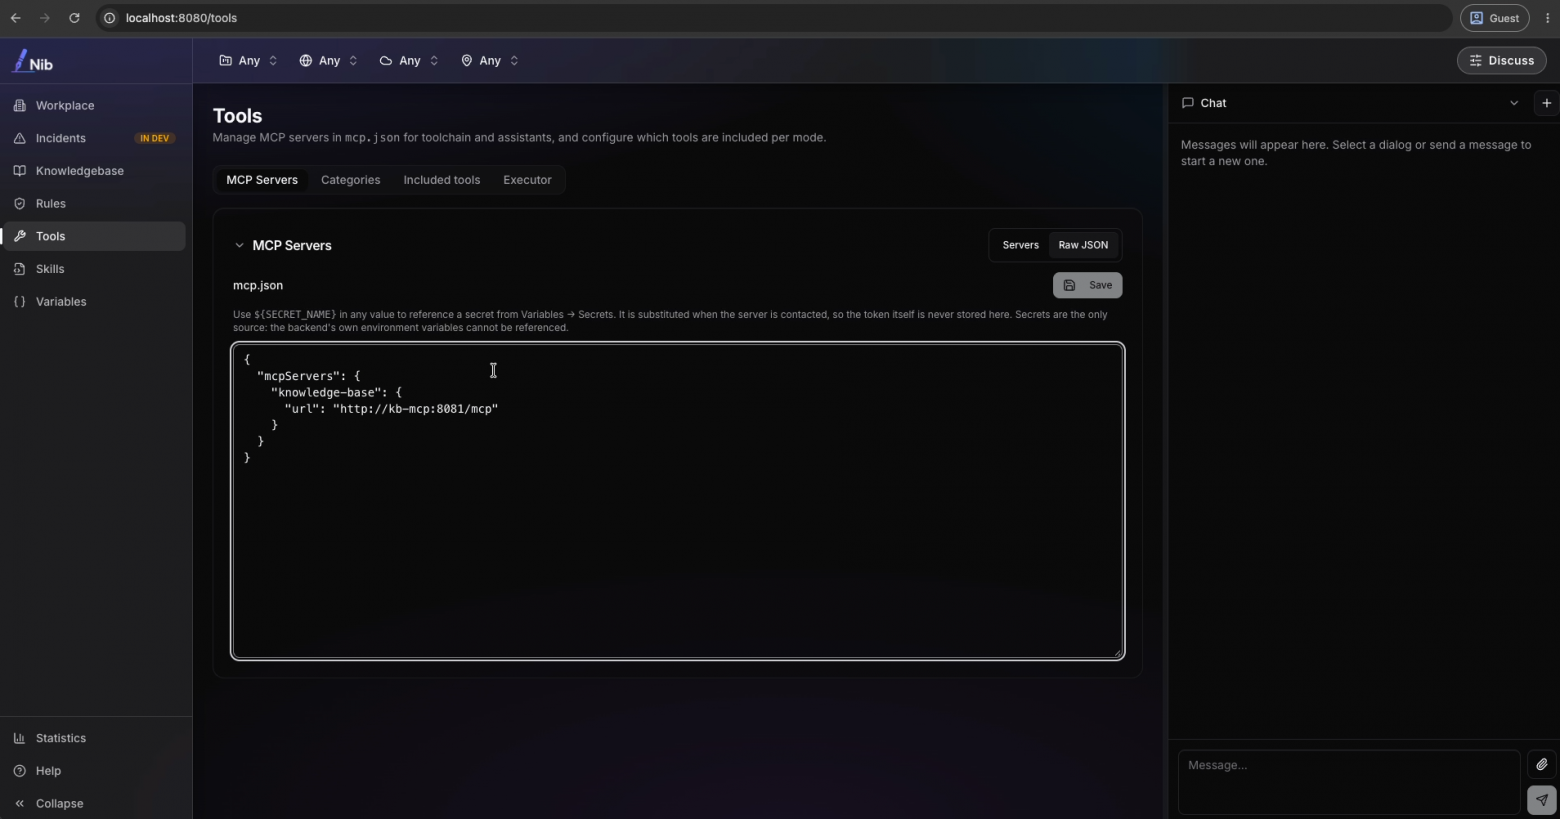
knowledge-base — встроенный сервер базы знаний, он уже есть в конфиге после установки. Остальные три добавляем.
Обратите внимание на ${GITHUB_TOKEN} в заголовке. Токены в конфиг не пишутся открытым текстом: nib подставляет их из раздела Variables → Secrets в момент запроса. У каждого секрета есть список разрешённых хостов, поэтому токен GitHub уйдёт только на github-mcp и никуда больше.
Токен создаётся в настройках пользователя GitHub, в разделе Developer settings github.com/settings/tokens. Я использовал classic-токен со scope repo и workflow. Второй легко упустить: без него GitHub не принимает push файлов в .github/workflows/, и агент просто не сможет закоммитить свои workflow.
Получается, что секреты живут в двух местах, и это легко перепутать:
-
ключи AWS нужны самому контейнеру
aws-mcp, поэтому они в.envи попадают в контейнер через переменные окружения; -
токен GitHub передаётся в HTTP-заголовке запроса от nib к MCP-серверу, поэтому он в секретах nib.
Проверяем подключение
После перезапуска контейнеров открываем Tools → MCP Servers. У каждого сервера можно посмотреть список инструментов, которые он отдаёт. Если список пустой или сервер в ошибке, проблема в сети, адресе или токене, и дальше идти смысла нет: агент без инструментов будет планировать вслепую.
В моём случае GitHub отдал пару десятков инструментов, SearXNG — пять, а AWS всего два. Так и должно быть: AWS API MCP Server даёт агенту универсальный вызов AWS CLI и помощник, который подбирает нужную команду, поэтому весь AWS умещается в два инструмента. GitHub, наоборот, приходит россыпью, по инструменту на операцию, и с этим помогает разобраться следующий раздел.
Категории инструментов и базовый набор режимов
Три MCP-сервера дают агенту много инструментов. Если отдавать их все в каждый вызов, модель начинает путаться, контекст раздувается, а токены тратятся на описания инструментов, которые в этой задаче не понадобятся. Для планирования ресурсов в облаке не нужны инструменты для логов и метрик. В nib для этого есть два механизма.
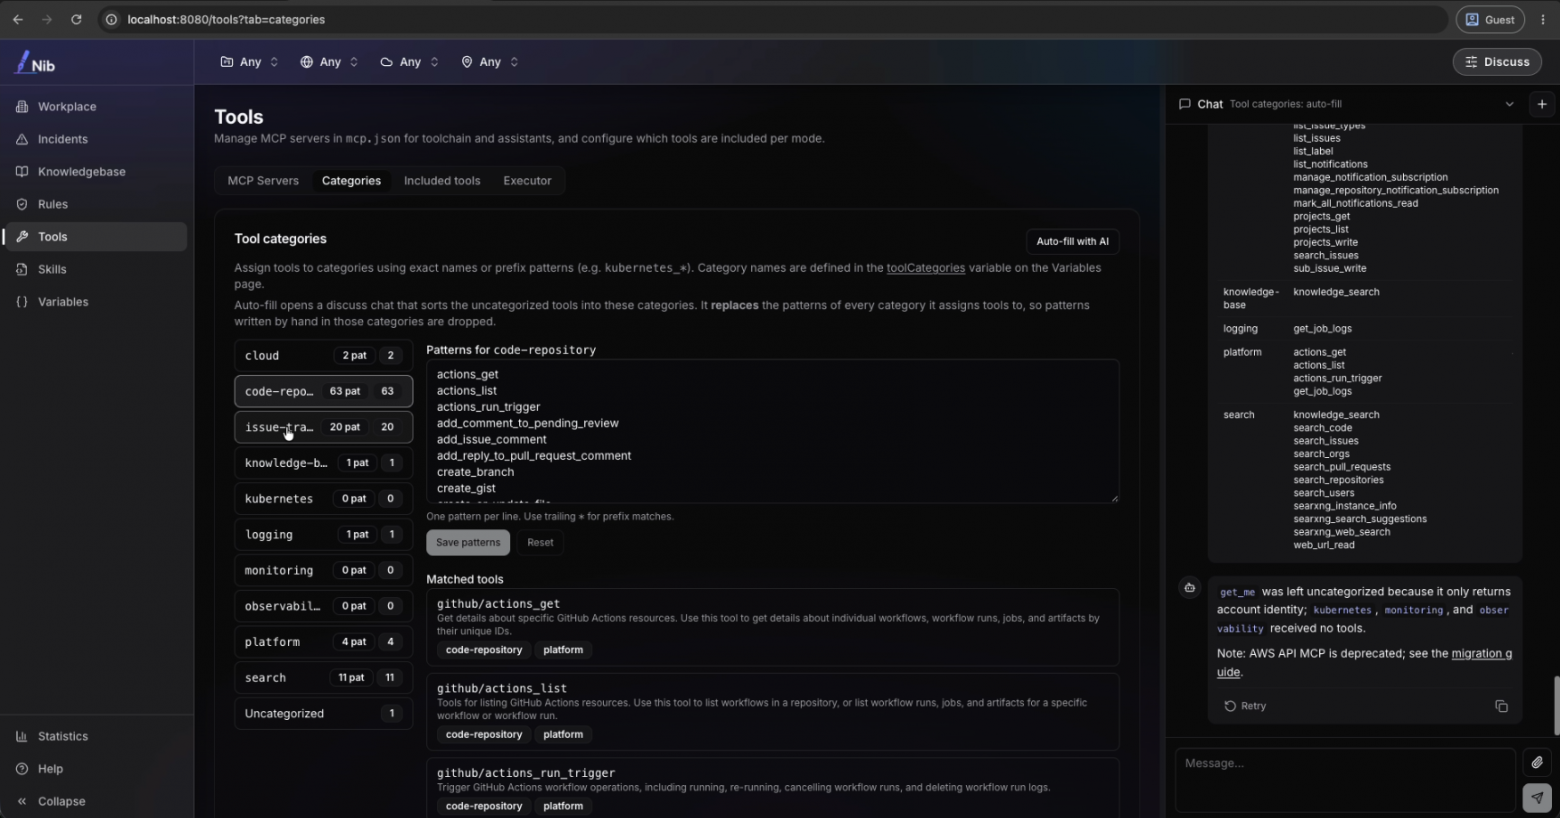
Категории инструментов. Инструменты группируются по категориям (например, всё про AWS, всё про git). На этапе декомпозиции агент решает, какие категории затрагивает задача, и получает доступ только к ним. Каждое отдельное действие в плане получает ещё более узкий набор: только категории, отмеченные на нём самом. Раскладывать инструменты по категориям руками не обязательно, кнопка Auto-fill with AI в карточке Tool categories сделает первичное заполнение, которое потом можно поправить.
Базовый набор для каждого режима. Режимы nib можно считать сабагентами: одни декомпозируют задачу, другие прорабатывают этапы, третьи выполняют действия. По умолчанию каждому режиму доступны все инструменты. В Tools → Included tools это можно сузить: режимам, которые должны только читать и планировать, незачем инструменты, которые что-то меняют. Кнопка Distribute with AI умеет только убирать инструменты, поэтому читающие режимы теряют изменяющие, и ничего лишнего не добавляется.
Первый план
Всё готово, можно планировать. Напомню, что мы разворачиваем: demo-app — интернет-магазин товаров для рисования с бэкендом на Python, фронтендом на React и базой PostgreSQL. Нажимаем New plan и вставляем задачу из первой части:
Развернуть новый веб-сервис в AWS. У него React-фронтенд и Python-бэкенд, для работы нужен PostgreSQL. Есть github репозиторий с приложением . В результате в GitHub должны появиться джобы для развёртывания инфраструктуры и деплоя приложения.
Дальше повторяется то, что в первой части делал инженер.
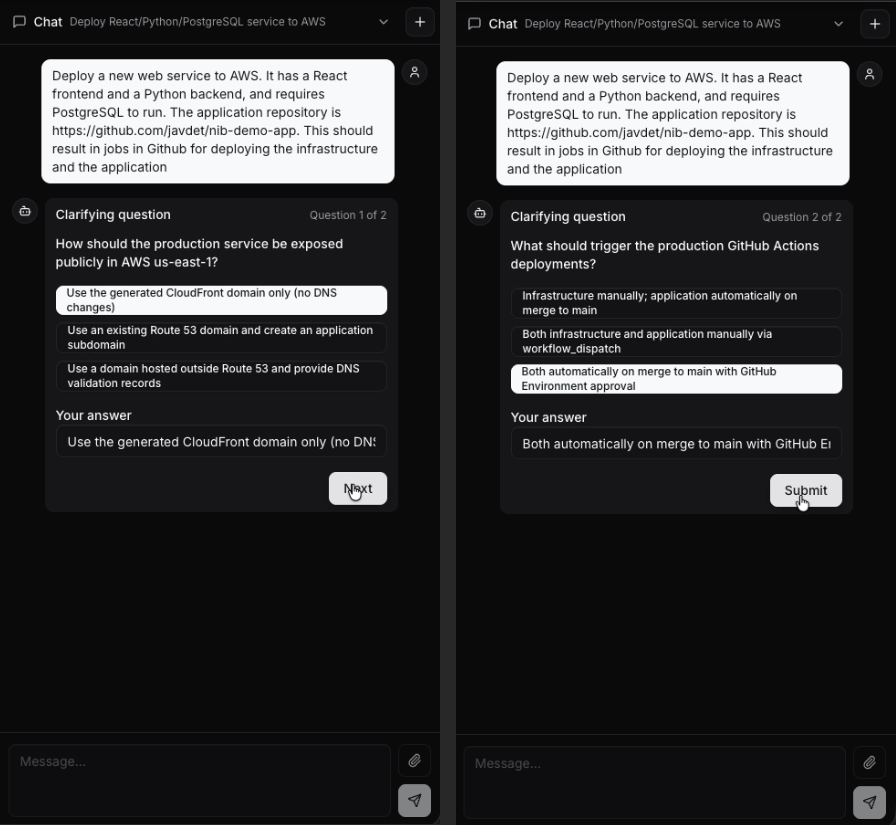
Сбор контекста. Сначала decompose-агент задаёт уточняющие вопросы и к большинству сам предлагает варианты ответа, их можно выбрать кликом. Мне он задал два вопроса, которые инженер задал бы постановщику задачи в первые пять минут:
-
Как публиковать сервис? Есть ли собственный домен, или хватит адреса, который сгенерирует CloudFront. От ответа зависит, появятся ли в плане DNS-записи и TLS-сертификат.
-
Как запускать джобы? Автоматически при мерже в основную ветку или вручную. По сути, это вопрос о том, может ли инфраструктура измениться без человека.
Домена у меня нет, поэтому сайт живёт на адресе CloudFront, а джобы запускаются автоматически при мерже в main.
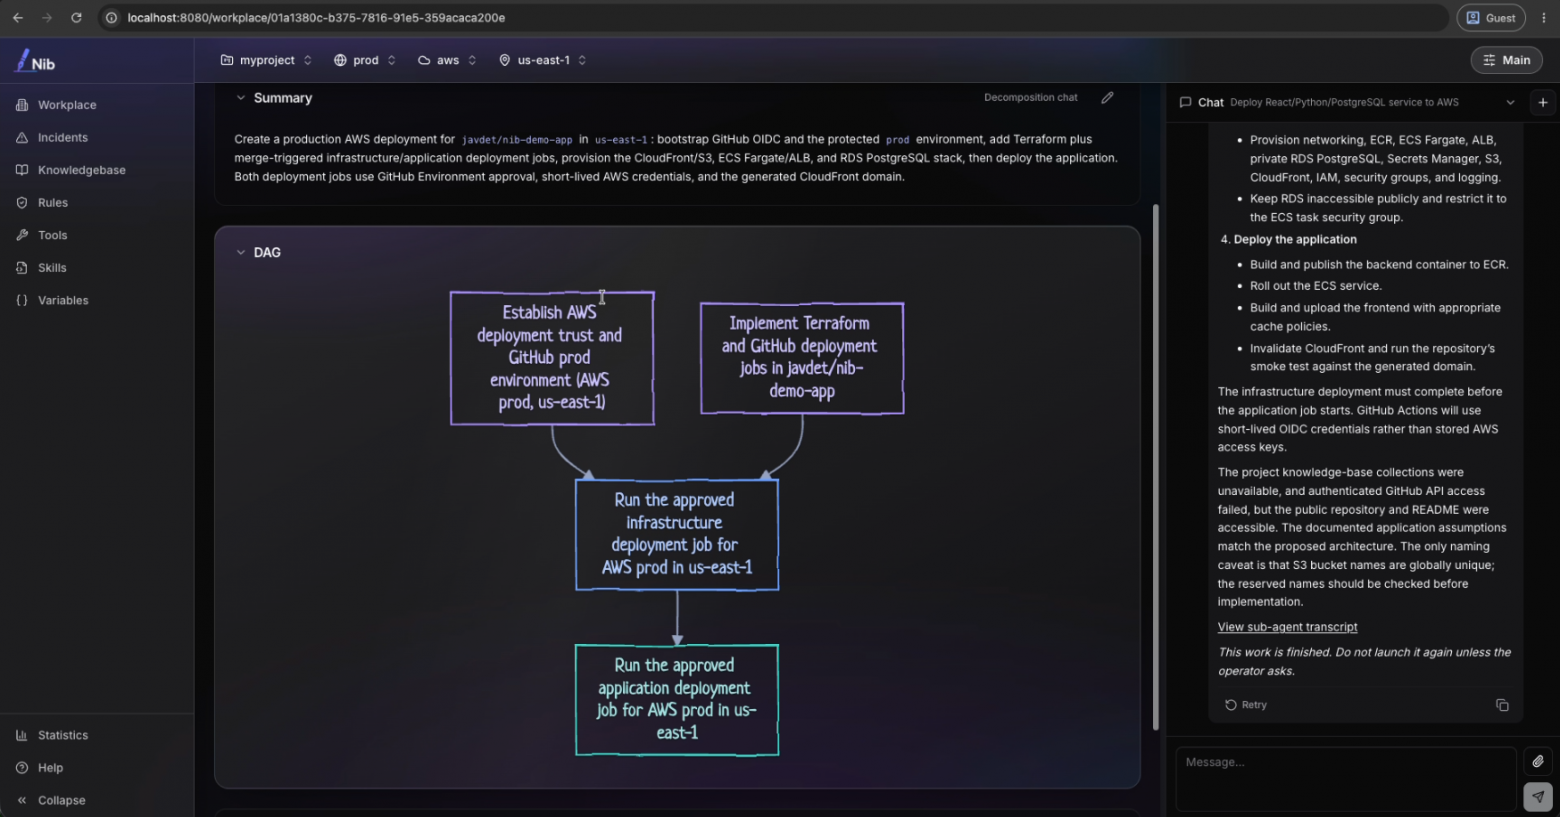
Этапы и зависимости. После ответов агент показывает Summary (как он понял задачу) и DAG: этапы и зависимости между ними. DAG (directed acyclic graph, направленный ациклический граф) — это схема «что после чего», в которой нет циклов. Здесь впервые видно то, что в голове инженера было неявным: какие этапы можно делать параллельно и какие блокируют остальные. Если вопросов к этапам нет, переходим к детальному планированию.
Действия, проверки, откат. Кнопка Process plan here запускает планирование. Каждый этап прорабатывает отдельный агент, параллельно с остальными, а в конце строится план отката. На всё ушло около двух минут. Получилось четыре этапа и план отката:
|
Этап |
Шагов |
Проверок |
|
1. Establish AWS deployment trust and GitHub prod environment |
5 |
4 |
|
2. Implement Terraform and GitHub deployment jobs |
2 |
4 |
|
3. Run the approved infrastructure deployment job for AWS |
2 |
4 |
|
4. Run the approved application deployment job for AWS |
1 |
3 |
|
Всего |
10 |
15 |
Посмотрите на последнюю строку: проверок в полтора раза больше, чем действий. Именно эта часть плана в голове первой усыхает под дедлайн.
Шаги бывают четырёх типов: выполнить CLI-команду, сделать API-запрос, поработать с кодом или внести изменения в веб-интерфейсе. У каждого шага подробное описание того, что нужно сделать, а если действие может вызвать даунтайм уже работающей системы, план отдельно об этом предупреждает.
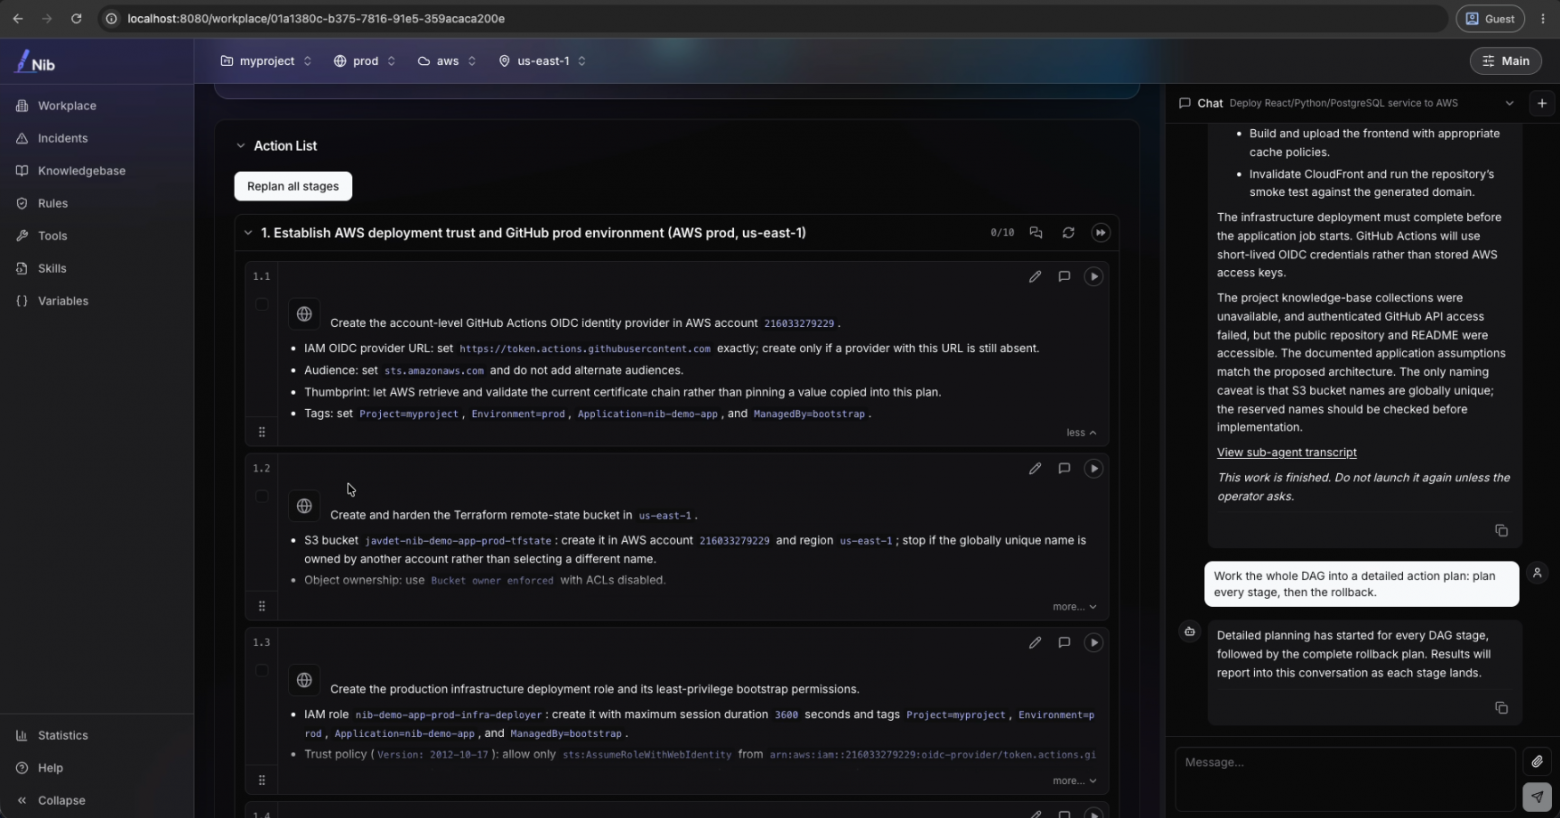
Вот и ответ на третью проблему из первой части. Оценки в часах nib не даёт, но объём работы виден до старта: четыре этапа, десять шагов, пятнадцать проверок, и понятно, где нужен код, а где хватит вызова API. С этим уже можно идти к тому, кто спрашивал «сколько займёт», и разговор будет предметнее, чем «день-два».
Выполняем первые шаги
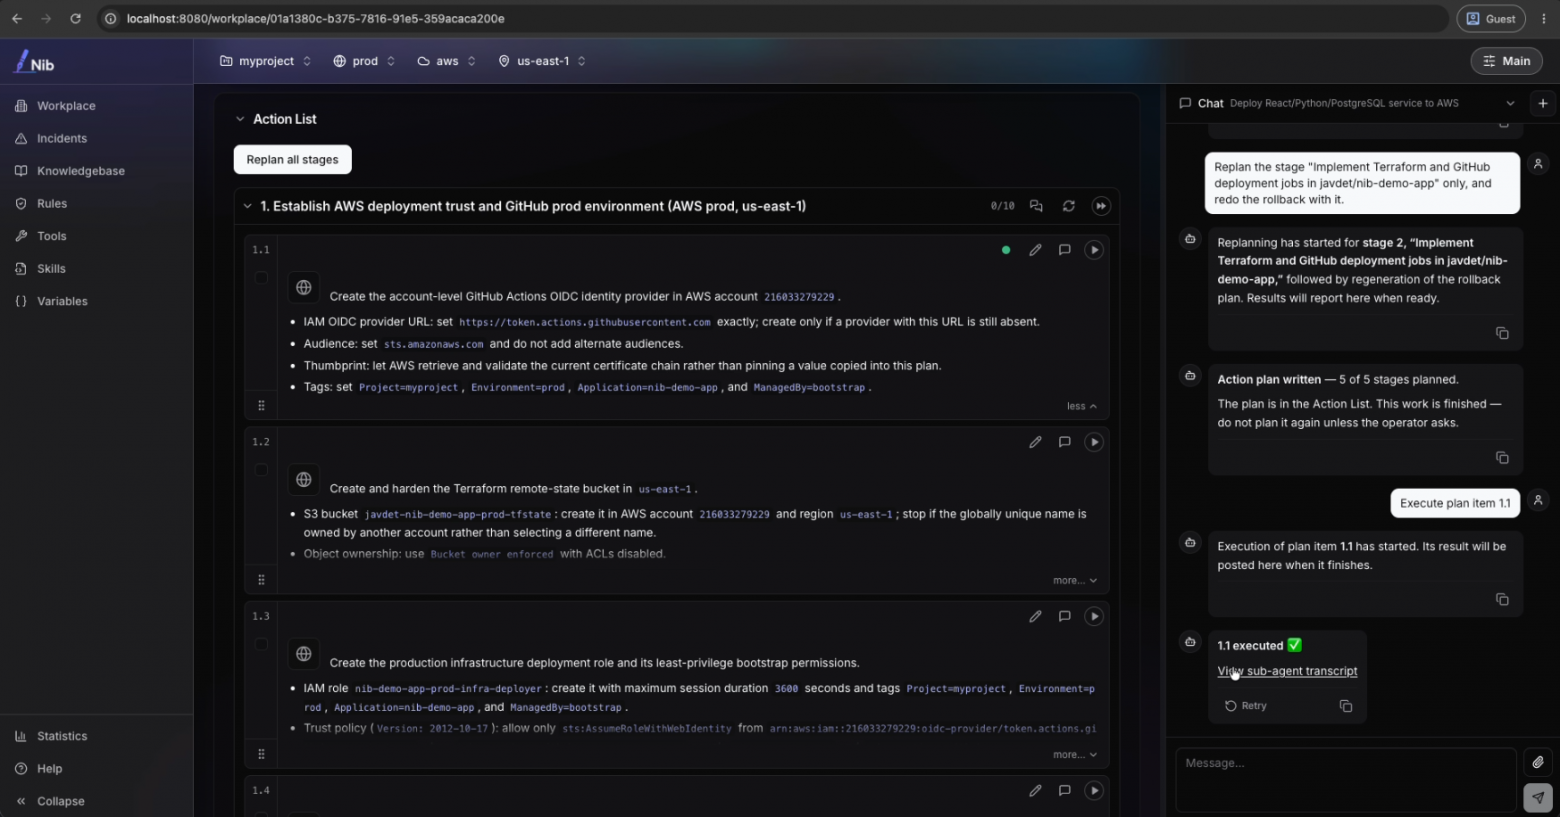
У каждого шага есть кнопка выполнения, у этапа есть Execute all, а ещё шаг можно запустить из чата, просто попросив агента. Галочка напротив шага отмечает его выполненным, к любому шагу можно оставить комментарий. Одновременно выполняется только одно действие: это сознательное ограничение, чтобы два агента не меняли одну инфраструктуру параллельно.
Первый этап целиком состоит из вызовов API и CLI, поэтому его агент выполнил сам, через MCP:
-
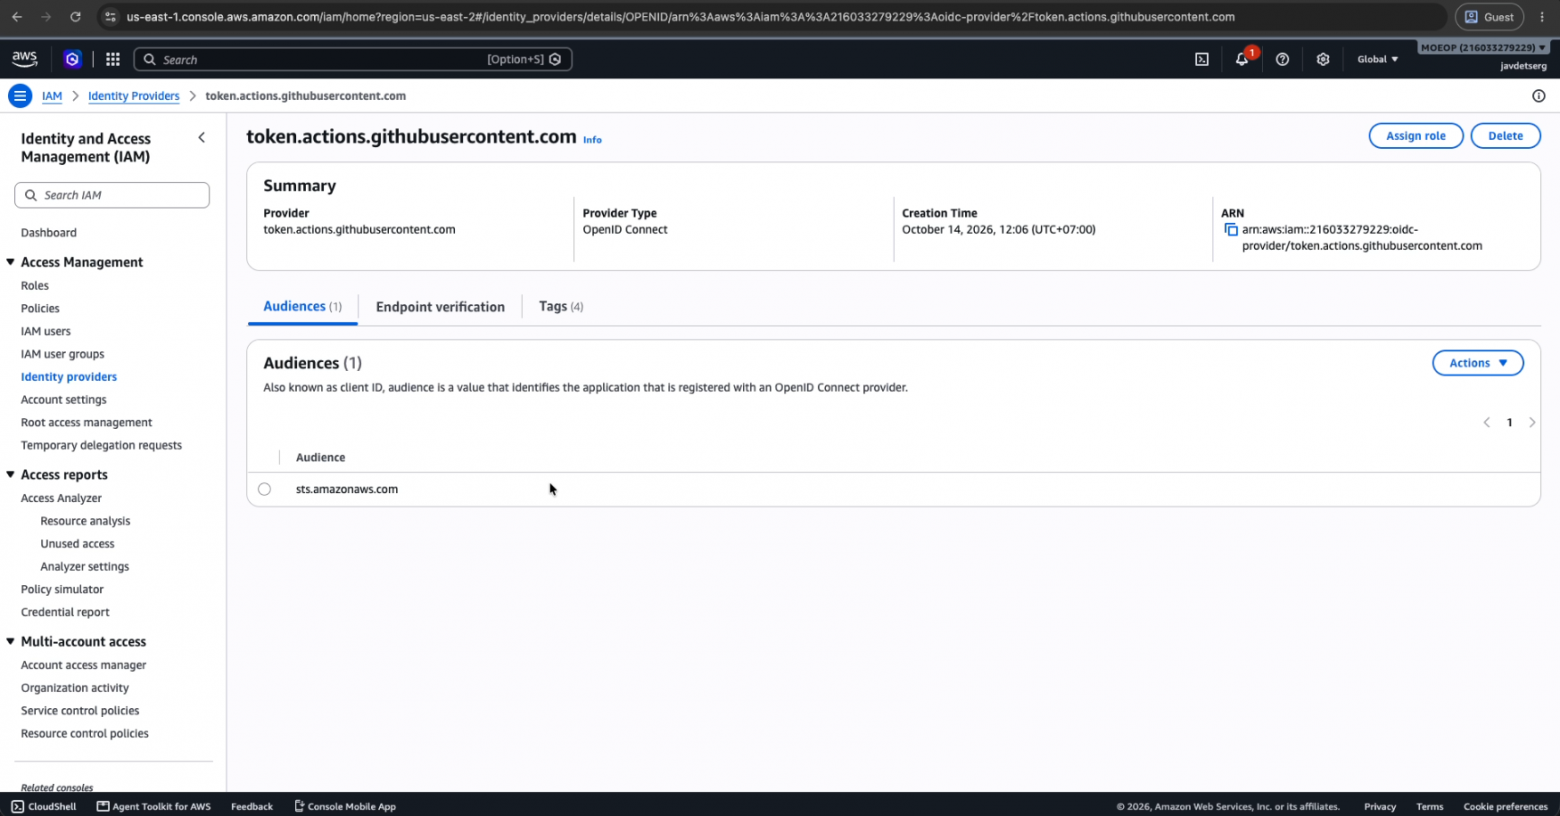
Настройка OIDC-провайдера, через который GitHub Actions будут получать доступ к AWS;
-
Создание S3-бакет под state Terraform;
-
Добавление роли, от имени которой Terraform создаёт ресурсы;
-
Добавление отдельная роль для выкладки приложения;
-
Создание защищённого окружения
productionв репозитории;
Слово reconcile знакомо по Kubernetes: привести систему к желаемому состоянию. Если ресурса нет, его нужно создать, если он есть, но настроен иначе, поправить, а если всё уже как надо, ничего не делать. Такой шаг можно безопасно запустить повторно, и это пригодится, если план прервётся на середине. Две отдельные роли тоже выбраны с умыслом: роли, которая выкладывает приложение, незачем права создавать сети и базы данных.
После каждого шага агент сообщает в чате, что сделано. Проверки этапа я для наглядности выполнял сам: зашёл в консоль AWS и убедился, что OIDC-провайдер создан, бакет на месте, а в репозитории появился environment. Агент умеет проверять и сам, его достаточно попросить. Запомните проверку про OIDC-провайдер, она нам ещё понадобится.
Выполнение действий
Код: Terraform и workflow
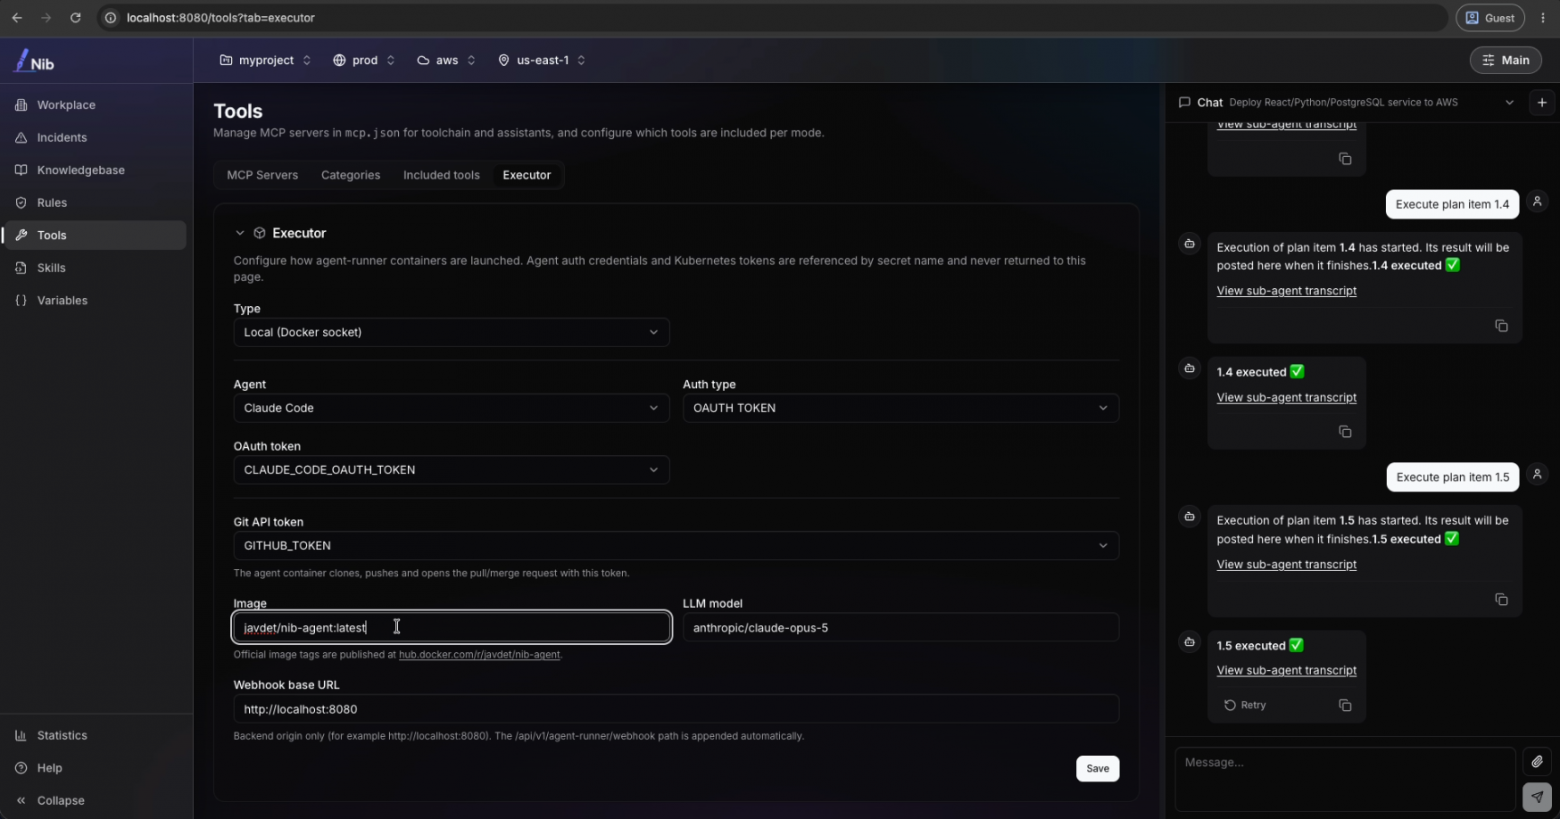
На втором этапе вызовов API уже недостаточно, нужно писать Terraform и workflow. Для таких шагов в nib есть executor: исполнитель, который запускает coding-агента в отдельном контейнере. Он клонирует репозиторий, вносит изменения, коммитит, пушит и открывает pull request.
При первом запуске шага с кодом nib сам перекидывает на страницу настройки executor (Tools → Executor). Executor бывает трёх видов: выключен (по умолчанию), Local, то есть контейнеры на вашей машине через Docker, и Remote в виде Kubernetes Jobs. Для первого знакомства хватит Local: агент запускается прямо на вашем компьютере, а логи контейнера видны из интерфейса.
Выбираем тип агента и способ аутентификации. Нужного токена в списке секретов ещё нет, поэтому создаём его:
-
CLAUDE_CODE_OAUTH_TOKEN— токен подписки Claude Code, его выдаёт командаclaude setup-token. Вместо него можно использовать API-ключ Anthropic; -
токен GitHub, чтобы агент мог пушить изменения, — тот же, что для MCP.
Образ агента и модель можно оставить по умолчанию. Возвращаемся к плану и запускаем шаг.
Что подготовил агент
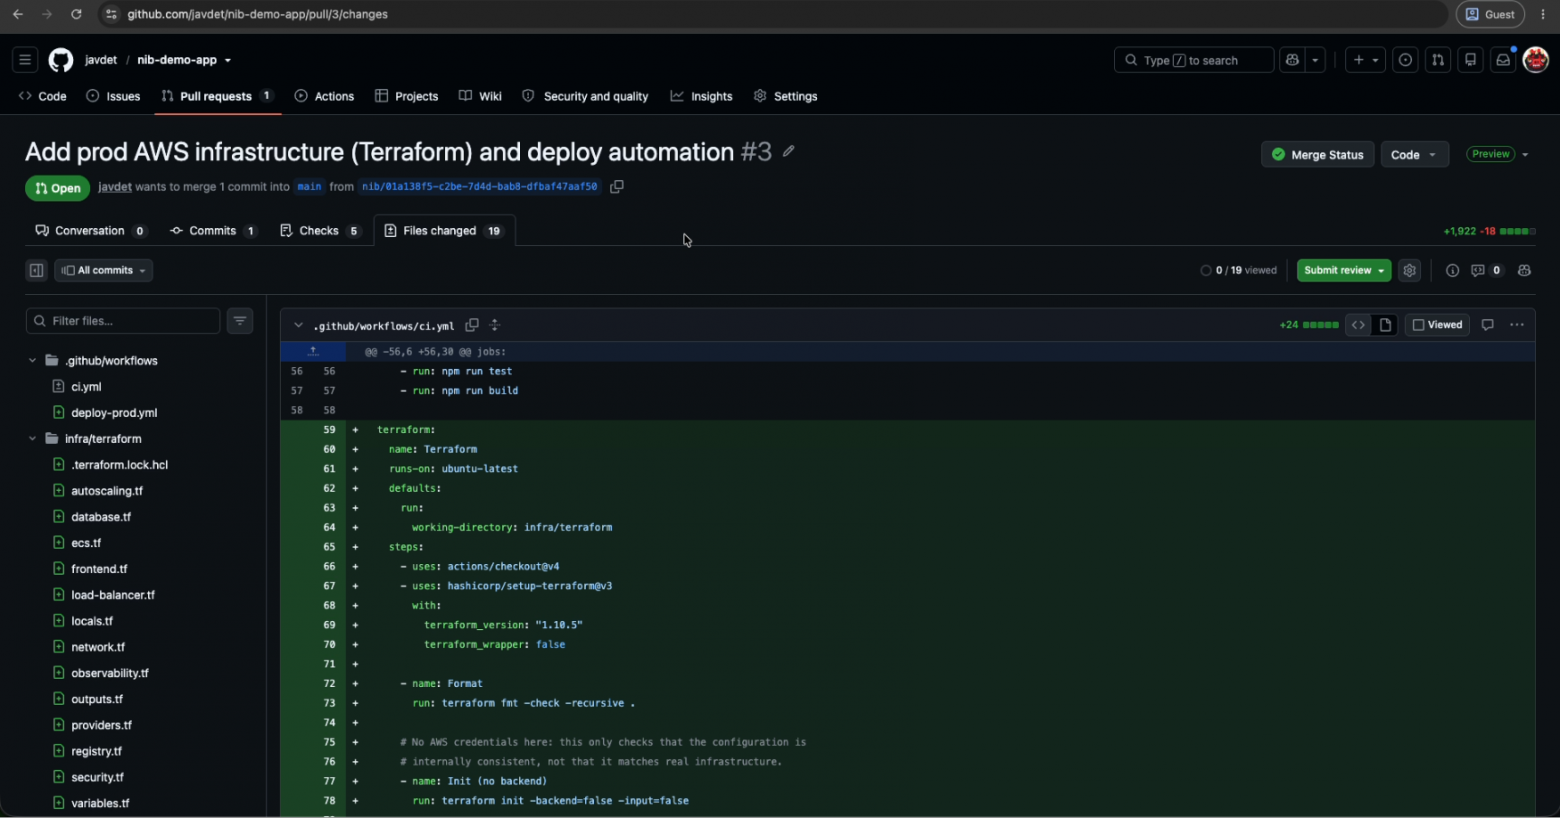
В PR 20 файлов: два workflow, Terraform-код в infra/terraform и обновлённый README. Если коротко, получилась такая схема:
-
CloudFront перед всем: статика фронтенда отдаётся из приватного S3-бакета, запросы
/api/*уходят на ALB; -
ALB принимает трафик только из managed prefix list CloudFront, то есть напрямую из интернета до него не достучаться;
-
бэкенд работает в *ECS Fargate** в приватных подсетях и принимает трафик только от ALB;
-
RDS PostgreSQL 16 в изолированных подсетях без маршрута в интернет, Multi-AZ, с шифрованием, бэкапами и deletion protection; пароль генерируется Terraform и сразу уходит в Secrets Manager;
-
GitHub Actions ходят в AWS через *OIDC**: джоба получает временные учётные данные, принимая IAM-роль, и в GitHub не хранится ни одного долгоживущего ключа AWS. Тут пригодились провайдер и роли с первого этапа.
И два workflow:
-
Deploy Infrastructure —
terraform planиterraform apply. Apply запускается только вручную, с явным флагом, и в GitHub environmentproduction, где можно включить обязательное одобрение. Так агент учёл ответ на вопрос о запуске джоб; -
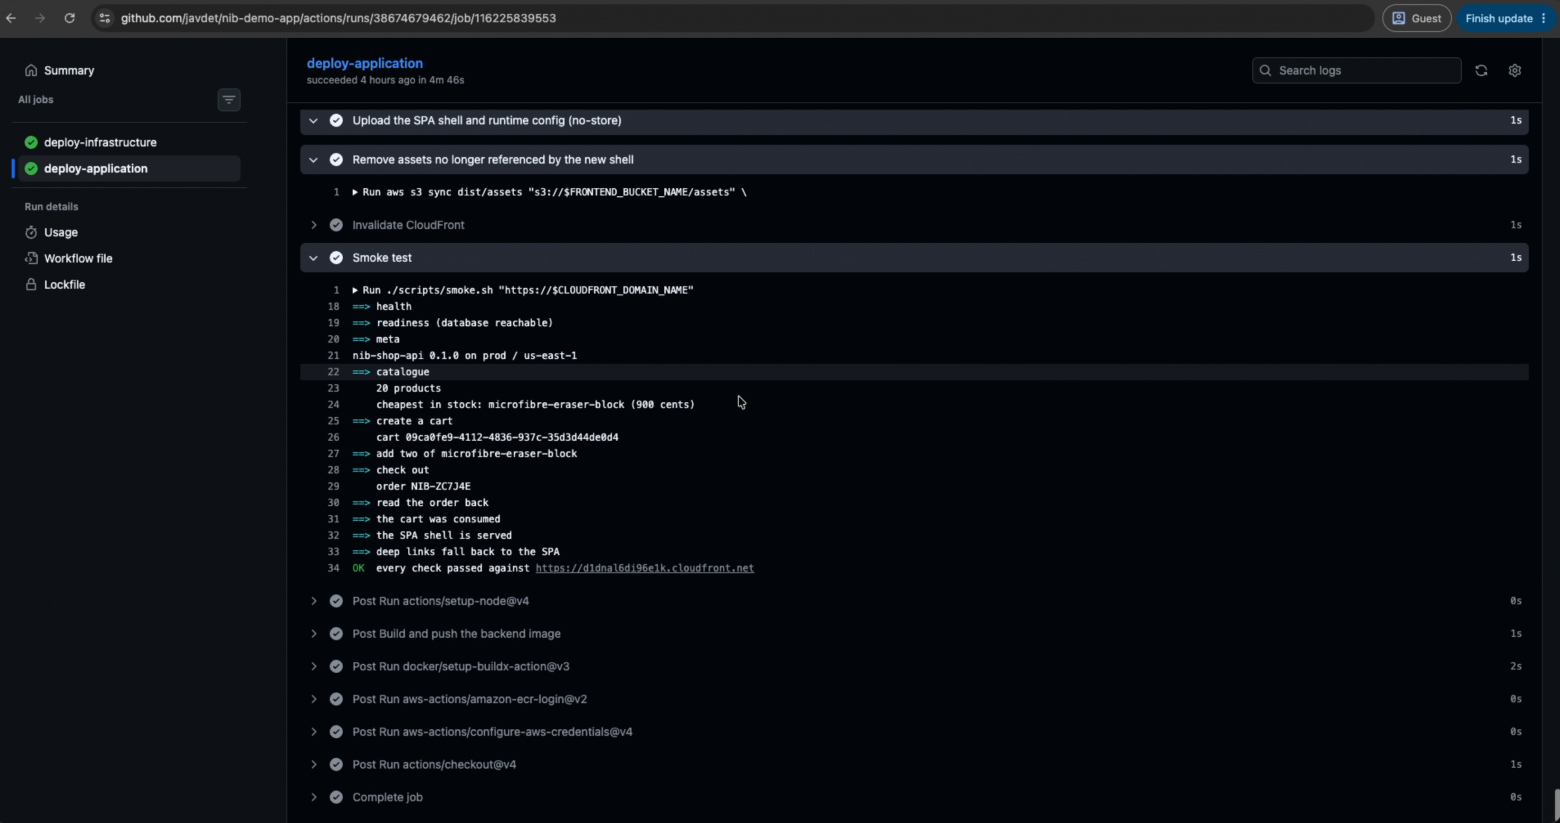
Deploy Application — собирает образ бэкенда, пушит его в ECR с тегом коммита, обновляет ECS-сервис, собирает фронтенд, выкладывает его в S3, сбрасывает кеш CloudFront и в конце прогоняет smoke-тест по адресу CloudFront.
Два решения в этом коде хорошо иллюстрируют тот «опыт» из первой части, который обычно нигде не записан.
ECS-сервис создаётся с
desired_count = 0. На моментterraform applyв ECR ещё нет ни одного образа приложения. Если сразу попросить два таска, ECS будет бесконечно пытаться поднять несуществующий образ. Поэтому Terraform создаёт сервис пустым и игнорирует дальнейшие изменения образа и числа тасков, а деплой-workflow публикует первый настоящий образ и масштабирует сервис до двух. Без этой детали Terraform при каждом запуске откатывал бы то, что сделал деплой.Стоимость названа явно. Multi-AZ база и NAT-шлюз в каждой зоне доступности — продовая конфигурация, и она стоит денег даже без трафика. Агент вынес это в README рядом с порядком запуска workflow. Для демо это избыточно, для прода правильно, и такое решение стоит принимать осознанно, а не узнавать о нём из счёта.
Изменения выглядят разумно, мержим PR в основную ветку.
Первый запуск, первый сбой
Запускаем Deploy Infrastructure, и первая попытка падает.
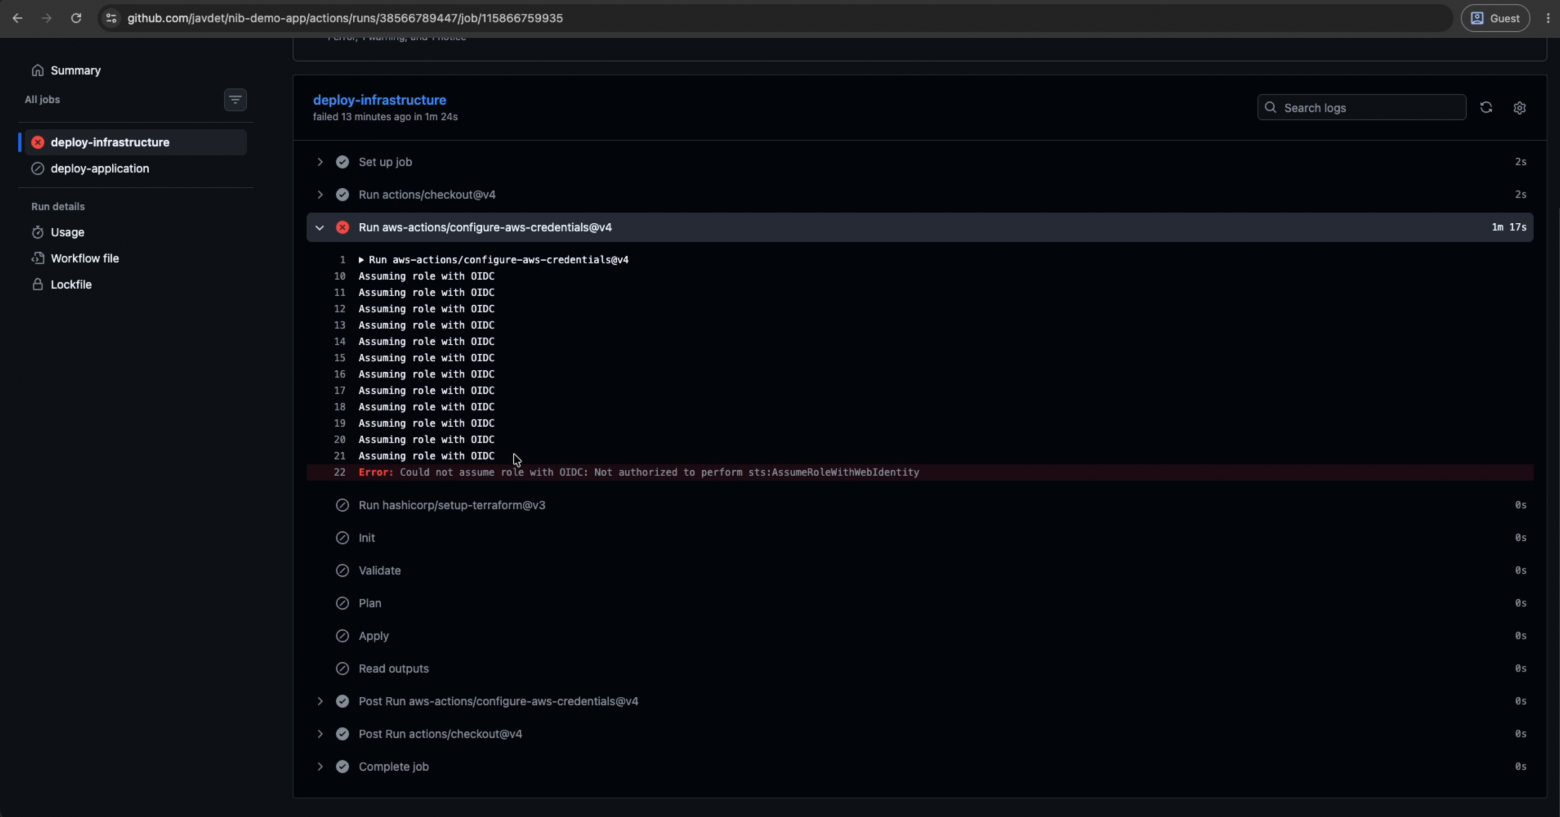
Такое случается и с опытными инженерами, так что ничего страшного. Вместо того чтобы самому разбирать лог, показываем ошибку nib и просим разобраться. Он находит причину: в OIDC-провайдере, созданном на первом этапе, указаны не все thumbprints.
Thumbprint — это отпечаток TLS-сертификата провайдера идентичности. По списку таких отпечатков AWS проверяет, что токен действительно выдал GitHub. Если нужного отпечатка в списке нет, AWS не доверяет токену, и джоба не может принять роль и получить доступ к аккаунту.
Ответ агента
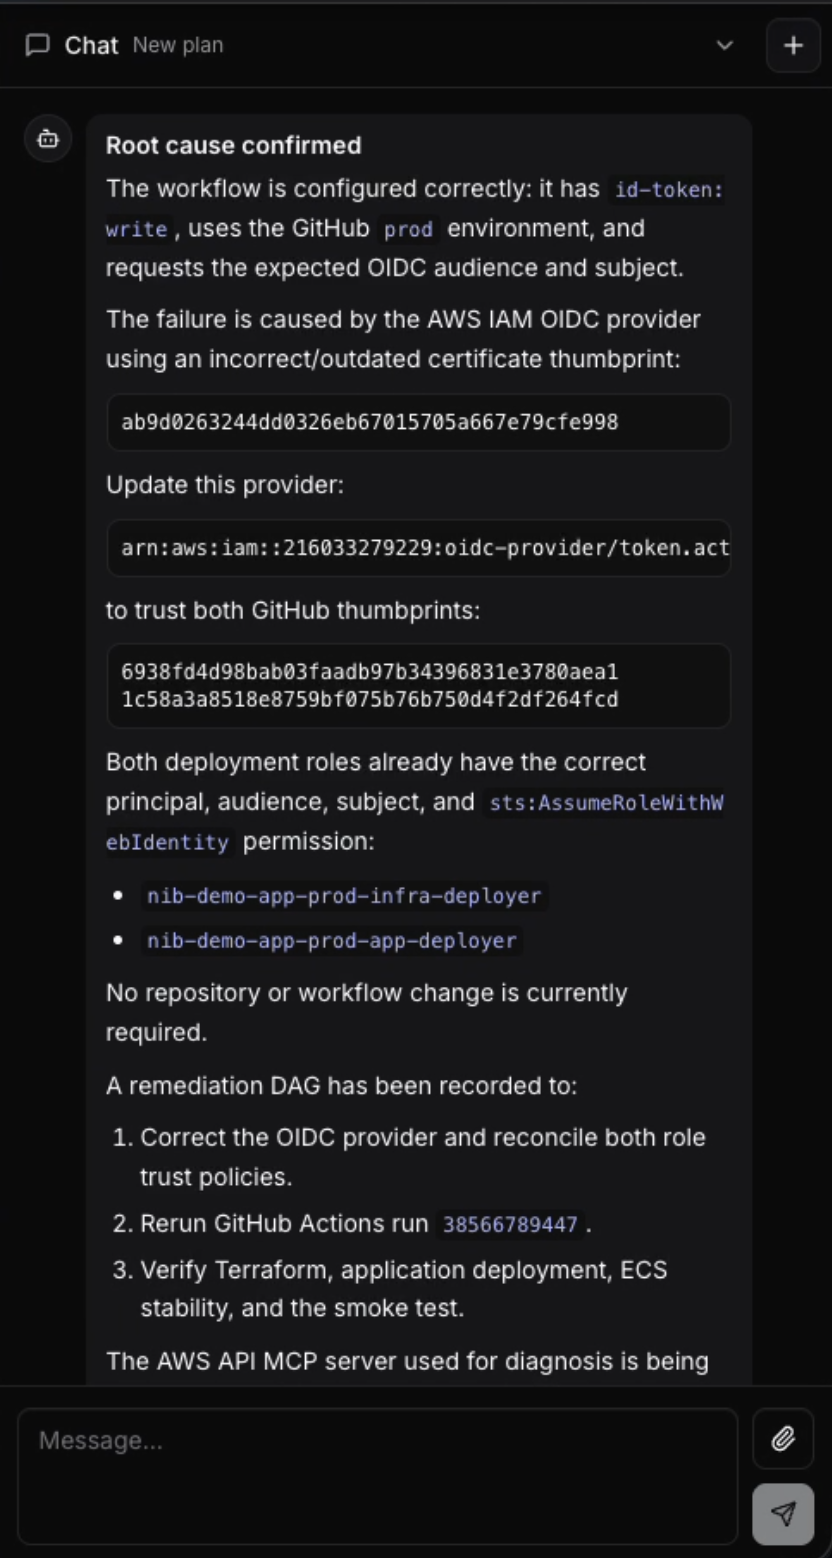
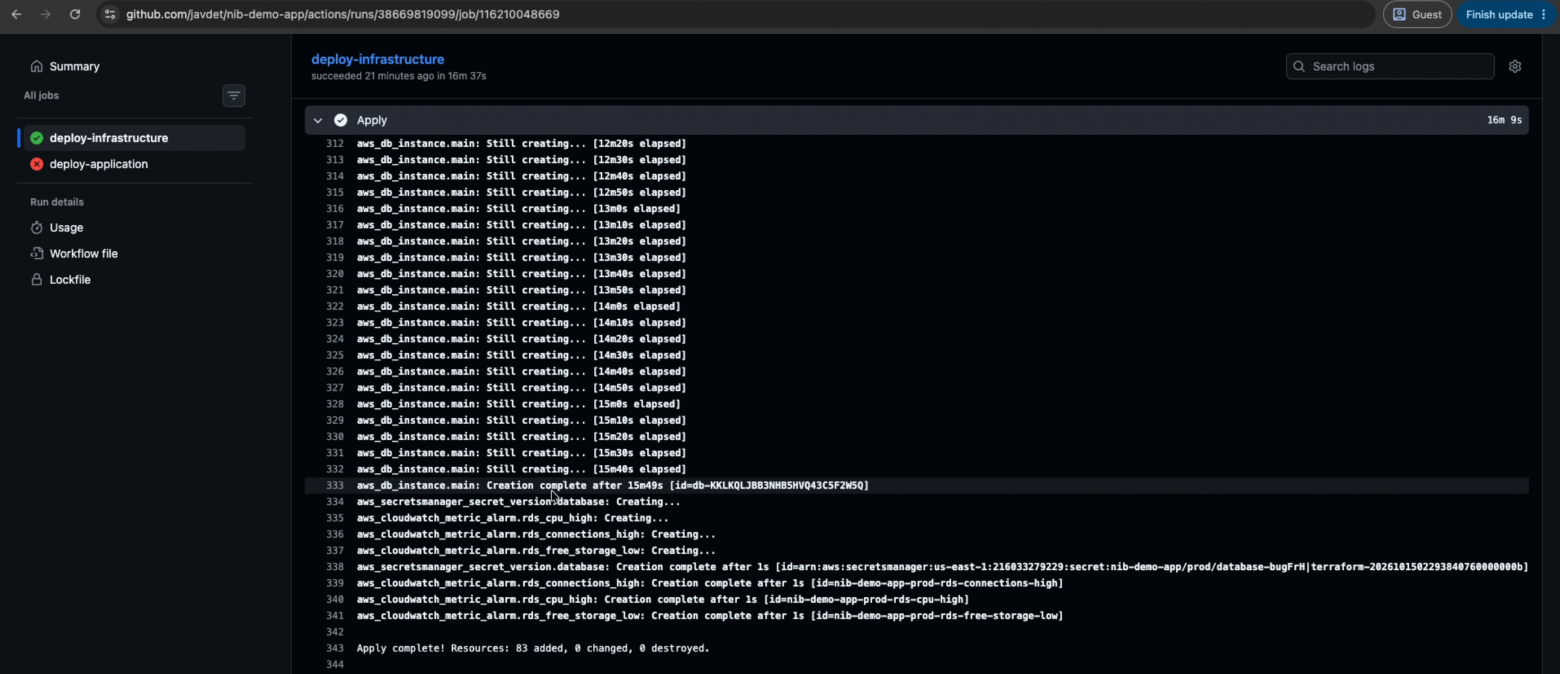
Добавляем недостающие thumbprints и перезапускаем workflow. Со второй попытки инфраструктура создаётся: в логе видно terraform plan и сколько ресурсов создано. Проверяем, что база данных готова и балансировщик на месте, и отмечаем выполненные шаги.
Деплой приложения: второй сбой и сайт
Запускаем Deploy Application, и он тоже падает с первого раза: не проходит healthcheck. Деплой отработал слишком быстро, и приложение не успело инициализироваться к моменту проверки. Такое поведение ожидаемо, и следующий шаг плана как раз предписывает перезапустить деплой. Его и выполняем.
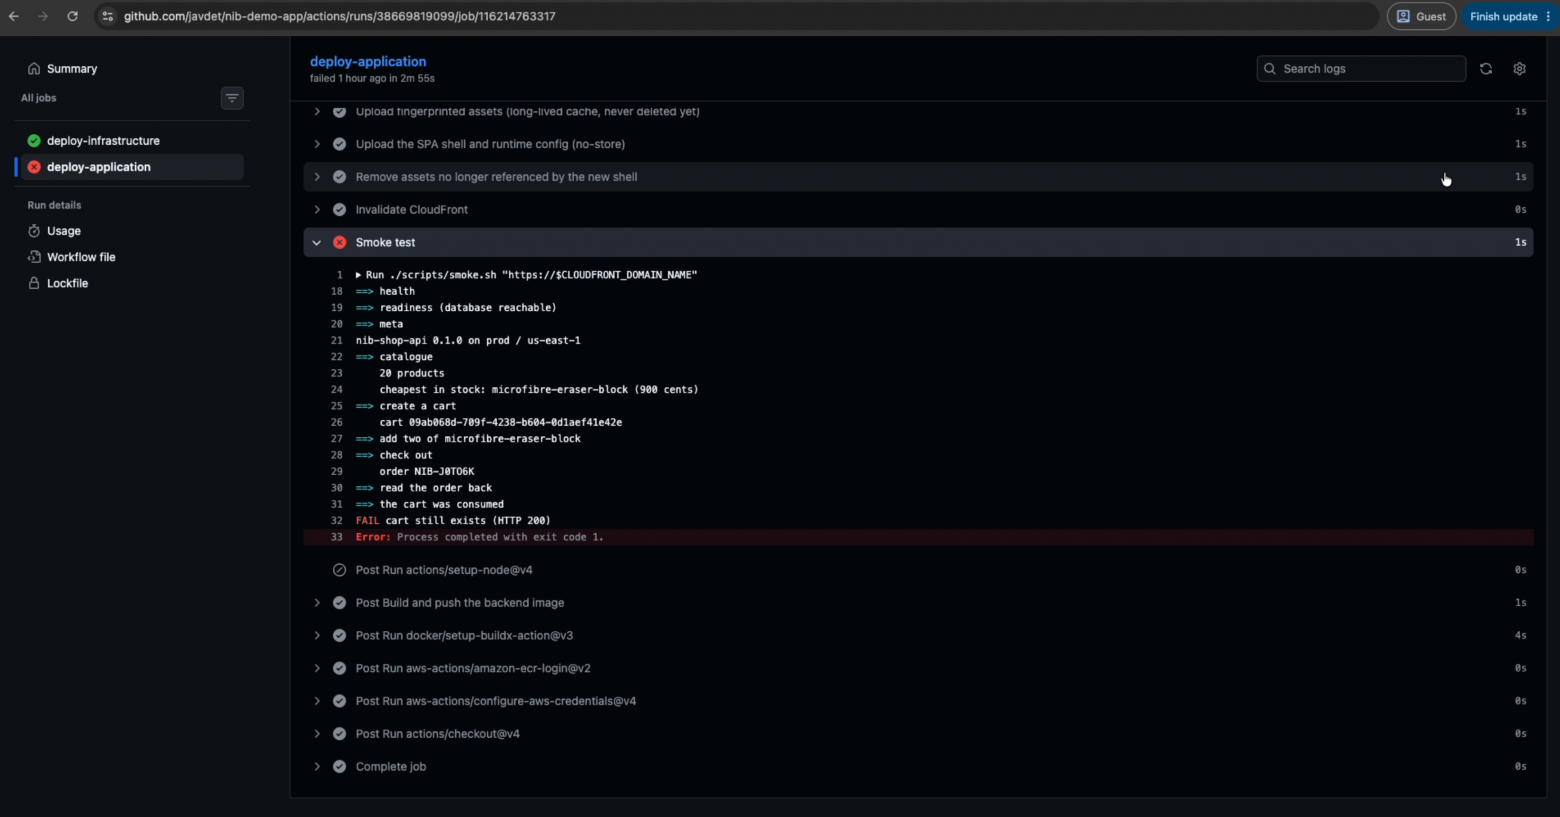
Со второго раза деплой проходит, smoke-тест зелёный. Открываем адрес CloudFront и видим витрину магазина товаров для рисования, тот самый сервис, который мы хотели развернуть.
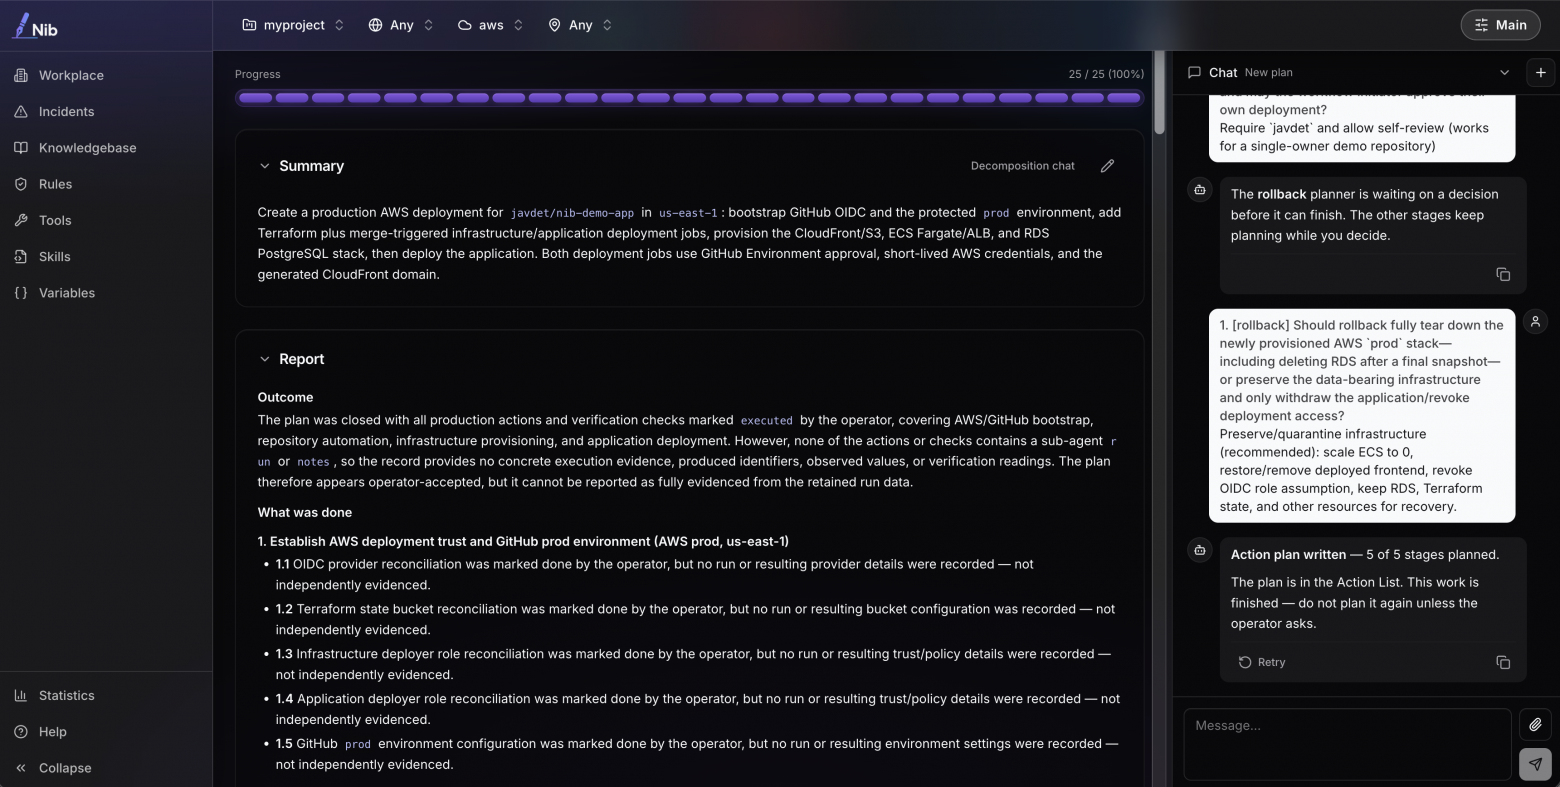
Отмечаем оставшиеся шаги и нажимаем Finish. nib закрывает план, пишет отчёт о выполненной работе и обновляет базу знаний. В следующий раз, когда придёт задача про этот проект, агент уже будет знать, что в нём есть VPC, ECS-кластер и база, и начнёт не с нуля.
Итоги
Мы взяли обычную задачу: развернуть веб-сервис в AWS и настроить в GitHub джобы для его деплоя. За две минуты nib разбил её на четыре этапа с десятью шагами, пятнадцатью проверками и планом отката. Доступы в AWS и GitHub агент подготовил сам через MCP, Terraform и workflow написал executor, а два сбоя по дороге, с OIDC-провайдером и с healthcheck, мы разобрали вместе с nib. В конце открыли сайт и убедились, что магазин работает.
Вернёмся к трём проблемам из первой части:
-
Пункты не теряются. Список действий записан в плане, его видно, его можно передать коллеге и продолжить с того же места.
-
Проверки не пропускаются. Они записаны в каждый этап заранее, и у агента нет соблазна сэкономить на них время. Правда, история с OIDC показала, что проверка полезна ровно настолько, насколько точно она сформулирована.
-
Объём виден до старта. Сколько этапов и шагов впереди, понятно ещё до первой команды.
Решения при этом остаются за вами: вы решаете, какие шаги запускать, читаете PR и принимаете результат.
Даже если вы не собираетесь пользоваться агентами, попробуйте на следующей задаче записать план в три колонки: действие, проверка, откат. Это уже закрывает первую проблему и заметно упрощает вторую.
В первой части я говорил, что инженер опирается на правила команды и собственный опыт. nib можно дать то же самое. В следующей статье покажу, как подключить свои правила, навыки и базу знаний, чтобы планы получались точнее и ближе к тому, как принято у вас.
Репозиторий: https://github.com/javdet/nib. Попробуйте на своей задаче, а в комментариях расскажите: какую инфраструктурную задачу вы бы первой доверили агенту, а какую — никогда?
Автор: javdet12

