


Я делаю свою линейку маленьких языковых моделей dpp-gpt. Не файнтюн чужой модели, а всё с нуля: токенизатор, претрейн, SFT, RL, бенчмарки. Всё это на одной домашней видеокарте RTX 4060 с 8 ГБ памяти. Недавно вышла версия 2.2 Pro на 260 миллионов параметров. В статье расскажу, как она устроена, что получилось, что нет, и какие неожиданные вещи всплыли по дороге.
Сразу честно: это не конкурент моделям, обученным большими командами на триллионах токенов. На общепринятых английских бенчмарках она отстаёт даже от самых маленьких из них (бенчмарки ниже). Интересна она другим: тем, сколько можно выжать из одной видеокарты, и тем, что видно изнутри.
Что это за модель
|
Параметры |
259M (242M уникальных: эмбеддинги входа и выхода общие) |
|
Архитектура |
как у Llama: RMSNorm, RoPE, SwiGLU, GQA |
|
Слои / ширина / головы / KV-головы |
20 / 1024 / 16 / 4 |
|
Контекст |
8192 токена |
|
Словарь |
16 384, свой BPE, цифры отдельными токенами |
|
Языки |
русский, английский, французский |
Претрейн: 31 миллиард токенов
2.2 продолжает претрейн базовой версии 2.1: к её 11.8 млрд токенов я долил ещё около 19 млрд, всего примерно 31 млрд. Смесь:
-
Википедия на трёх языках: 23%;
-
CulturaX (веб) на трёх языках: 13%;
-
код на Python: 16%, веб-код: 5%;
-
Cosmopedia и Zyda-2: по 5%;
-
стихи 4%, факты 5%, переводы 5%;
-
синтетика по работе с текстом (написание по буквам, анализ слов, капс): 4%;
-
синтетический код, написанный deepseek 4 flash: 1%;
-
математика: 14%.
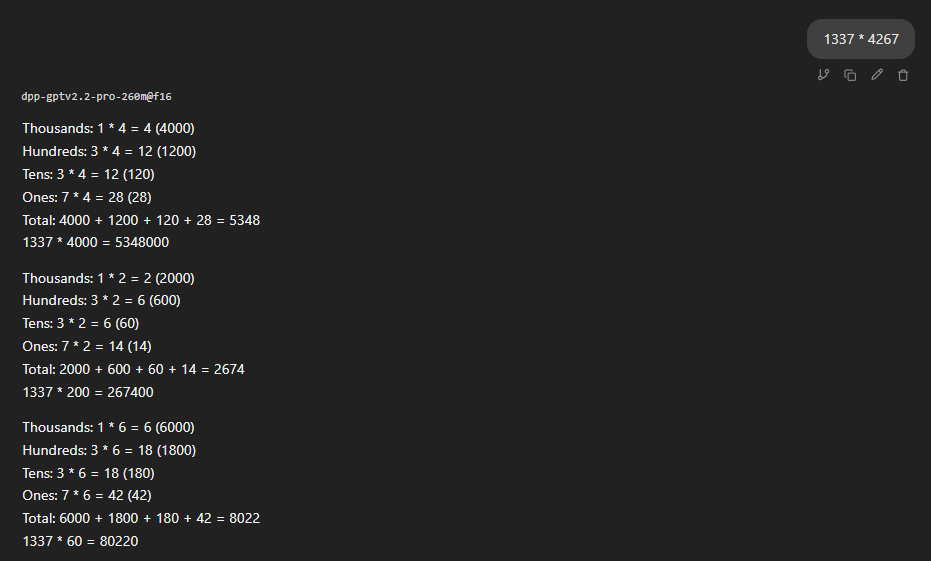
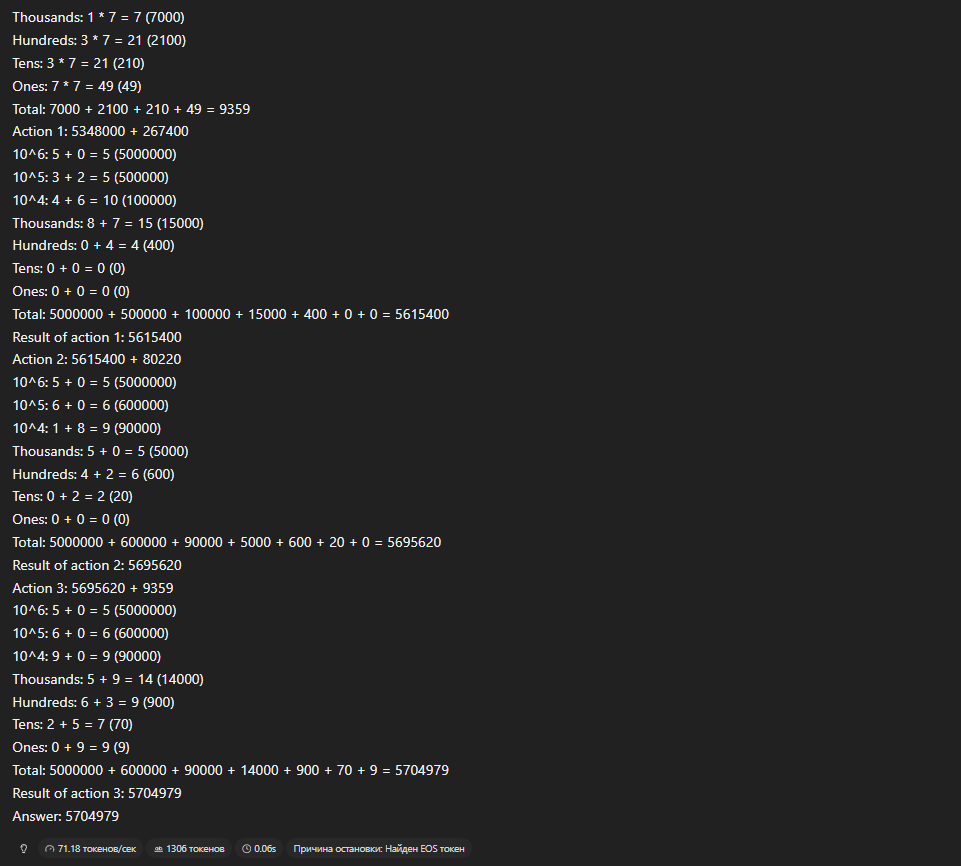
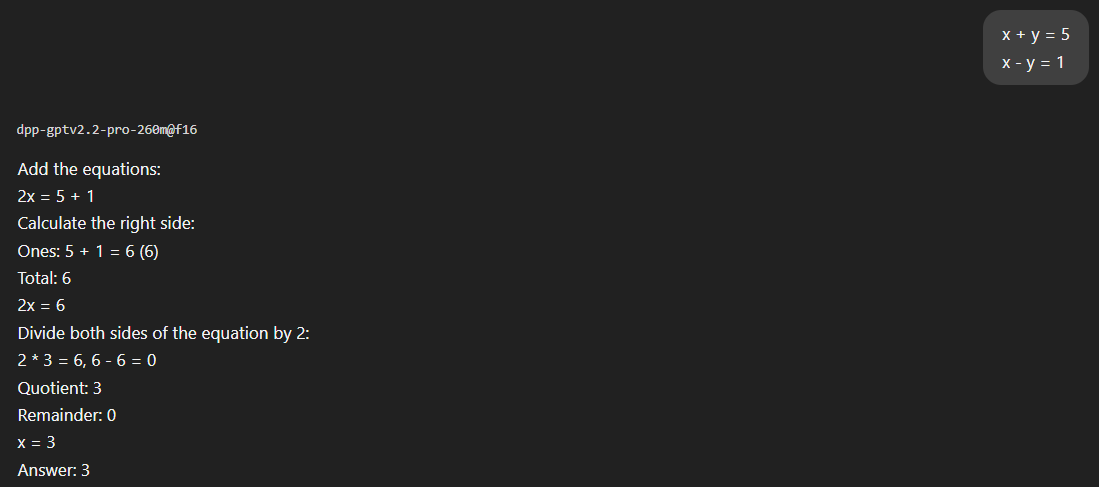
Математика сгенерирована скриптом, с поразрядным счетом. Благодаря этому модель может считать большие числа. Пример формата:
Действие 1: 290 * 3
Сотни: 2 * 3 = 6 (600)
Десятки: 9 * 3 = 27 (270)
Единицы: 0 * 3 = 0 (0)
Итого: 600 + 270 + 0 = 870
Ответ: 870
В предыдущей версии модели тоже был пошаговый поразрядный счет, однако в новой версии стало больше более сложных и разнообразных примеров. Генераторы покрывают сложение и вычитание чисел до 40 знаков, умножение, деление с остатком, скобки, уравнения, дроби, системы. Каждый ответ считается Python, так что ошибок в данных нет.
SFT: 60 миллионов токенов
SFT-датасет вырос с 16.5 млн токенов у 2.1 до 60 млн, это около 122 тысяч диалогов. При обучении 68% примеров брались из них, остальные 32% были повтором претрейна, чтобы модель не забывала базу.
-
общий чат на трёх языках (86 тем, 431 подтема, многоходовые разговоры): 27.7 тыс. диалогов, 15.4 млн токенов;
-
следование инструкциям (системные промпты, роли, форматы, списки): 35.7 тыс., 9.8 млн;
-
математика с решениями: 13.8 тыс., 7.7 млн;
-
код на Python: 11.5 тыс., 5.4 млн;
-
сочинения: 2.0 тыс., 4.5 млн; стихи: 2.2 тыс., 1.7 млн;
-
работа с текстом: 4.4 тыс., 3.7 млн;
-
иголка в стоге сена (найти факт в тексте до 6000 токенов): 1.4 тыс., 3.0 млн;
-
вызов инструментов: 3.1 тыс., 1.5 млн;
-
JSON по описанию: 2.4 тыс., 1.1 млн;
-
переводы: 6.1 тыс., 1.0 млн;
-
факты: 9.0 тыс., 0.7 млн;
Почти всё сгенерировано DeepSeek через OpenRouter. Каждый ответ с числами пересчитан и проверен кодом. На данные для 2.2 ушло около 3000 рублей.
Результат SFT я выложил как 2.2 Pro preview. Неприятный момент: SFT просадил математику. У базовой модели было 47.6% на моём математическом бенчмарке, у первого SFT 26%, после подбора смеси 36.8%. Вернуть её стало одной из целей следующего этапа.
RL (GRPO) на 8 ГБ видеопамяти
Финальная 2.2 Pro получена обучением с подкреплением (GRPO) поверх preview. Суть GRPO: на каждый запрос модель пишет несколько ответов (у меня 8), каждый получает награду, и модель учится на разнице между ответами внутри группы. Награда за ответы выдается либо кодом, либо моделью-судьей, в зависимости от типа задачи.
Код проверял:
-
арифметику и уравнения;
-
школьные текстовые задачи;
-
Python: код запускается на тестах;
-
JSON по описанию;
-
поиск числа в тексте;
-
инструкции к форме ответа;
-
вызов инструментов в разных форматах и ответ по результату инструмента;
-
перевод (по сходству с эталоном).
Сочинения, стихи и ответы о фактах оценивал локальный судья Gemma 4 E4B.
Ещё одна полезная вещь: подбор сложности. Если модель какой-то тип задач решает всегда или не решает никогда, все 8 ответов получают одинаковую награду, и учиться нечему. Такие типы задач выбираются реже, а те, где модель решает примерно половину, чаще.
Всего было 9 прогонов GRPO. Я улучшал оценку, чтобы она проверяла больше разных проблем, и следил, чтобы не было перекоса под бенчмарк или какую-то узкую тему. Например, в первых прогонах награду за текст считал код по косвенным признакам, и модель научилась обманывать её короткими ответами: сочинения и общие вопросы сломались. Пришлось добавить судью и перебалансировать обучение. Но потом очевидные проблемы вроде бы закончились, и дальнейшего роста не было: каждый следующий чекпоинт где-то выигрывал, а где-то терял, и среднее упёрлось примерно в одно значение. Помогло неожиданно простое: усреднение весов нескольких чекпоинтов. Финальная модель — это 0.4 · GRPO8 + 0.3 · GRPO9 + 0.3 · GRPO5. Такой суп оказался лучше каждого отдельного чекпоинта.
Бенчмарки
Свой набор
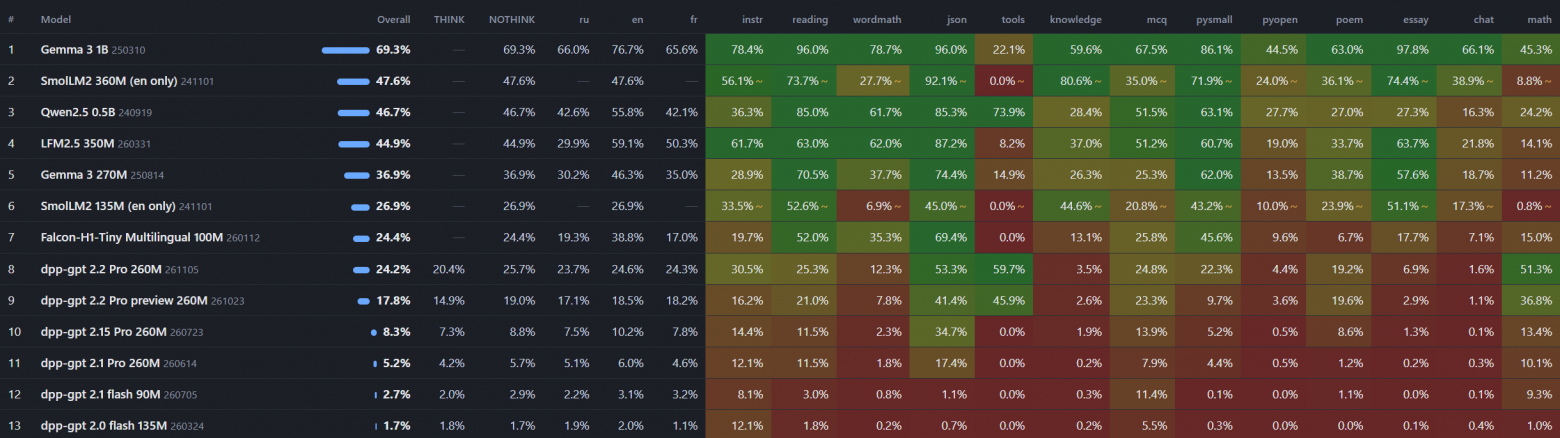
Я сделал свой набор под эту линейку: 12 областей, 2450 вопросов на трёх языках, каждый задаётся дважды (с мыслями и без). Всё, что можно, проверяет код; стихи, сочинения, чат и знания оценивает Gemma 4 26B. Плюс отдельный математический бенчмарк на 2200 задач.
Важная оговорка: набор сделан под мои форматы, поэтому подыгрывает dpp-gpt. А часть задач RL сделана теми же генераторами, что и часть бенчмарков (с другими числами и формулировками).
|
Модель |
Среднее |
instr |
json |
tools |
pysmall |
math |
|---|---|---|---|---|---|---|
|
2.2 Pro |
24.2 |
30.5 |
53.3 |
59.7 |
22.3 |
51.3 |
|
2.2 Pro preview |
17.8 |
16.2 |
41.4 |
45.9 |
9.7 |
36.8 |
|
2.15 Pro |
8.3 |
14.4 |
34.7 |
0.0 |
5.2 |
13.4 |
|
2.1 Pro |
5.2 |
12.1 |
17.4 |
0.0 |
4.4 |
10.1 |
|
2.0 Pro |
1.1 |
8.2 |
1.6 |
0.0 |
0.0 |
0.3 |
|
Gemma 3 270M |
36.9 |
28.9 |
74.4 |
14.9 |
62.0 |
11.2 |
|
SmolLM2 135M |
26.9 |
33.5 |
45.0 |
0.0 |
43.2 |
0.8 |
|
Falcon-H1-Tiny 100M |
24.4 |
19.7 |
69.4 |
0.0 |
45.6 |
15.0 |
За одно поколение среднее выросло с 8.3 до 24.2. 2.2 Pro впереди всех в арифметике и вызове инструментов, но в среднем примерно на уровне Falcon-H1-Tiny и позади Gemma 3 270M. Полная таблица по всем 13 колонкам — в карточке модели.
Общепринятые бенчмарки
Чтобы цифры можно было честно сравнить с чем угодно, я прогнал lm-evaluation-harness с одинаковыми настройками для всех моделей. Это только английский.
|
Модель |
HellaSwag |
ARC-Easy |
PIQA |
GSM8K |
IFEval (строго) |
|---|---|---|---|---|---|
|
dpp-gpt 2.2 Pro |
28.9 |
39.2 |
57.7 |
1.8 |
14.1 |
|
Gemma 3 270M |
39.3 |
55.3 |
65.6 |
8.6 |
25.5 |
|
SmolLM2 135M |
42.9 |
54.0 |
66.7 |
1.7 |
22.7 |
|
SmolLM2 360M |
56.7 |
56.6 |
71.6 |
8.9 |
32.4 |
|
случайный выбор |
25 |
25 |
50 |
0 |
|
Здесь картина без прикрас: 2.2 Pro выше случайного угадывания, но заметно позади всех. Базовая модель без SFT набирает на HellaSwag столько же (28.8), так что дело не в файнтюне, а в претрейне: 31 млрд токенов против триллионов, причём на трёх языках и с большой долей синтетики. RL эти бенчмарки не сдвинул: preview и финал здесь в пределах погрешности. Его выигрыш в другом: в арифметике, инструментах, JSON и инструкциях.
Что умеет и что нет
Умеет:
-
считать длинные числа по разрядам и решать простые уравнения по шагам;
-
вызывать инструменты (и не вызывать, когда не нужно), отвечать по результату;
-
писать JSON по описанию, выполнять простые инструкции к форме ответа;
-
брать имя и роль из системного промпта;
-
разговаривать, писать стихи и простой код на трёх языках.
Не умеет или умеет плохо:
-
умножение 5–6-значных чисел (верно примерно в 30% случаев);
-
держать счёт через несколько сообщений («было 5 яблок, съел 3, потом купил ещё 3»);
-
следовать инструкциям вроде «ответь одним словом» или «ответь по-английски»;
-
сочинения, факты, сложный код;
-
мысли в среднем пока не помогают: без них ответы немного лучше.
Вызов инструментов работает только в том формате, на котором модель училась (пример в карточке модели).
Что дальше
-
2.2 flash (около 140M) сейчас дообучается на немного улучшенных данных: Python код (из-за ошибки в Python-датасете 260M-версии Python составлял лишь 14%, а всё остальное было другими языками; теперь это исправлено), более очищенная Википедия, FineWeb-Edu и FineWeb2.
-
2.3: увеличу словарь до 32k и слои до 28, часть слоев сделаю с локальным вниманием: это ускорит обучение и инференс примерно на 20-30% (не проверял точно), а перплексия без дообучения вырастает всего на 2%. Плюс новые данные, включая много рассуждений.
Если интересно следить или есть вопросы, пишите в комментариях. Модель: huggingface.co/dikiyplayerpig/dpp-gpt-V2.2-Pro-260m
Автор: dikiyplayerpig

