


ESP32-S3 — микроконтроллер за несколько сотен рублей: два ядра Xtensa LX7 на 240 МГц и 512 КБ внутренней SRAM. Языковые модели на нём уже запускали: крошечная stories260K, 260 тысяч параметров, но это настоящая Llama-2 с вниманием, RoPE и SwiGLU. Известные запуски дают около двух десятков токенов в секунду.
Я взял ту же модель и тот же чип и выжал из них 406 токенов в секунду. Это в 18 раз быстрее наивной версии на одном ядре. Никакого разгона и внешних ускорителей: только квантование, векторные инструкции, второе ядро и много возни с памятью.
В этой статье мы разберём, как устроен этот разгон по шагам: где модель держать, как заставить работать редкие SIMD-инструкции ESP32-S3, почему после ускорения матриц узким местом стало внимание и как убедиться, что после всех оптимизаций модель выдаёт тот же текст, что и эталон.
❯ Модель и железо
Модель — stories260K из коллекции tinyllamas Андрея Карпатого. Её обучили на датасете TinyStories, простых историях для детей, поэтому она пишет связные сказки про Лили и красный мяч, но больше ничего не умеет. Зато умеет стабильно: красный мяч Лили находит чаще, чем я свои носки.
|
Параметр |
Значение |
|
Размерность |
64 |
|
Слоёв |
5 |
|
Голов внимания |
8 (KV-голов 4, GQA) |
|
Скрытый слой FFN |
172 |
|
Словарь |
512 токенов |
|
Параметров |
259 328 |
|
Размер в float32 |
1013 КБ |
Плата — ESP32-S3 с 2 МБ PSRAM, подключённая к MacBook по USB. Главная проблема видна сразу: модель во float32 весит больше мегабайта, а внутренней SRAM всего 512 КБ, и часть её занимают ESP-IDF и кэши. Поэтому в известном проекте esp32-llm от DaveBben веса лежат во внешней PSRAM, которая подключена по SPI и заметно медленнее внутренней памяти. Автор использовал оба ядра, float-ускорение из библиотеки ESP-DSP и получил 19.13 tok/s. Этот результат будем держать в голове как ориентир.
В качестве движка за основу взят llama2.c: один файл на C, понятный и без зависимостей. Код для ESP32 написан заново, но формулы и порядок операций те же.
❯ Как проверить, что ничего не сломали
Оптимизировать нейросеть на микроконтроллере опасно: ошибка в ассемблере не роняет программу, а просто портит текст. Модель продолжает писать что-то похожее на сказку, и на глаз поломку не заметить: сказки про Лили и в исправном виде не шедевр. Поэтому сначала я собрал цепочку проверок, а потом уже начал ускорять.
-
Эталон на numpy. Прямой проход Llama-2, который выдаёт тот же текст, что и
run.cКарпатого, слово в слово. -
Симулятор прошивки. Тот же проход, но с квантованием, int8 KV-кэшем и приближённой экспонентой. Каждая операция с float32 идёт в том же порядке, что и в C-коде, а суммы считаются последовательно через
np.cumsum, а не попарно, как это делаетnp.sum. -
C-движок на компьютере. Тот же
llm.c, собранный обычным gcc с флагом-ffp-contract=off, чтобы компилятор не склеивал умножение и сложение в FMA и не менял округление. На 200 шагах генерации он совпадает с симулятором бит в бит. -
Эмулятор. У Espressif есть свой форк QEMU с машиной esp32s3. Он эмулирует даже векторные инструкции PIE, так что прошивку можно прогнать до появления платы.
-
Плата. Хост посылает ей промпт, она отвечает номерами токенов и значением максимального логита на каждом шаге, а скрипт сравнивает их с симулятором.
На плате все режимы, от float32 в PSRAM до двух ядер с SIMD, выдают те же токены, что и симулятор. Расхождение логитов не превышает 5·10⁻⁸, то есть одного-двух последних битов float32. Это различия в реализации деления и квадратного корня на Xtensa и x86, на выбор токена они не влияют.
Благодаря этому каждое ускорение ниже проверено, а не просто «вроде работает».
❯ Шаг 1. int8 и место для весов
Первое, что сделал, — перевёл веса в int8 с одним масштабом float32 на строку матрицы. Модель сжалась с 1013 до 274 КБ, и стало можно выбирать, где её хранить. Сначала проверил, сколько качества это стоит. Метрика — перплексия на тексте, который сгенерировала исходная float32-модель:
|
Вариант |
Изменение перплексии |
|
int8, масштаб на строку |
+0.0% |
|
int6, масштаб на строку |
+1.2% |
|
int4, масштаб на строку |
+24.4% |
|
int4, масштаб на 16 весов |
+14.5% |
|
Весь конвейер прошивки: int8 веса, int8 активации, int8 KV-кэш, быстрая экспонента |
+0.7% |
Для такой маленькой модели 4 бита уже разрушительны, а 8 бит почти бесплатны. Активации тоже квантуются в int8, на лету, перед каждым умножением на матрицу. Тогда скалярное произведение становится целочисленным, а float появляется только в самом конце:
for (int r = r0; r < r1; r++) {
    const int8_t *w = W->q + (size_t)r * n;
    int32_t a = 0;
    for (int j = 0; j < n; j += 4)
        a += w[j] * x[j] + w[j+1] * x[j+1] + w[j+2] * x[j+2] + w[j+3] * x[j+3];
    out[r] = ((float)a * W->s[r]) * sx;  // масштаб строки × масштаб активации
}
Дальше интереснее: одну и ту же int8-модель я положил в три разных места и замерил скорость на одном ядре без SIMD.
|
Режим |
Где веса |
tok/s |
|
esp32-llm: float32, 2 ядра, ESP-DSP |
PSRAM |
19.1 |
|
float32, 1 ядро |
PSRAM |
22.5 |
|
int8, 1 ядро |
PSRAM |
55.3 |
|
int8, 1 ядро |
флеш (XIP) |
53.3 |
|
int8, 1 ядро |
внутренняя SRAM |
71.7 |
Наша float32-версия на одном ядре оказалась чуть быстрее esp32-llm на двух: 22.5 против 19.1 tok/s, так что базовая линия честная. Переход на int8 в той же PSRAM дал ×2.5. Вычислений при этом не стало меньше: мы упирались не в арифметику, а в чтение памяти, и int8 читается вчетверо быстрее.
Второй сюрприз: флеш почти не уступает PSRAM. ESP32-S3 умеет отображать флеш в адресное пространство (XIP) и читать его через тот же кэш, что и PSRAM. Для модели, которая помещается во флеш, отдельная PSRAM вообще не нужна.
Внутренняя SRAM добавляет ещё 30%. Немного, потому что пока узкое место — сам скалярный цикл, а не память. Это и исправляет следующий шаг.
❯ Шаг 2. Векторные инструкции PIE
У ESP32-S3 есть малоизвестное расширение PIE (Processor Instruction Extensions): восемь 128-битных регистров q0–q7 и набор векторных инструкций. Главная для нас — ee.vmulas.s8.accx. Она перемножает 16 пар int8 и прибавляет сумму к 40-битному аккумулятору ACCX, то есть делает 16 умножений-сложений за одну инструкцию. Компилятор такие инструкции сам не генерирует, поэтому ядро пришлось писать на ассемблере. Да, в 2026 году.
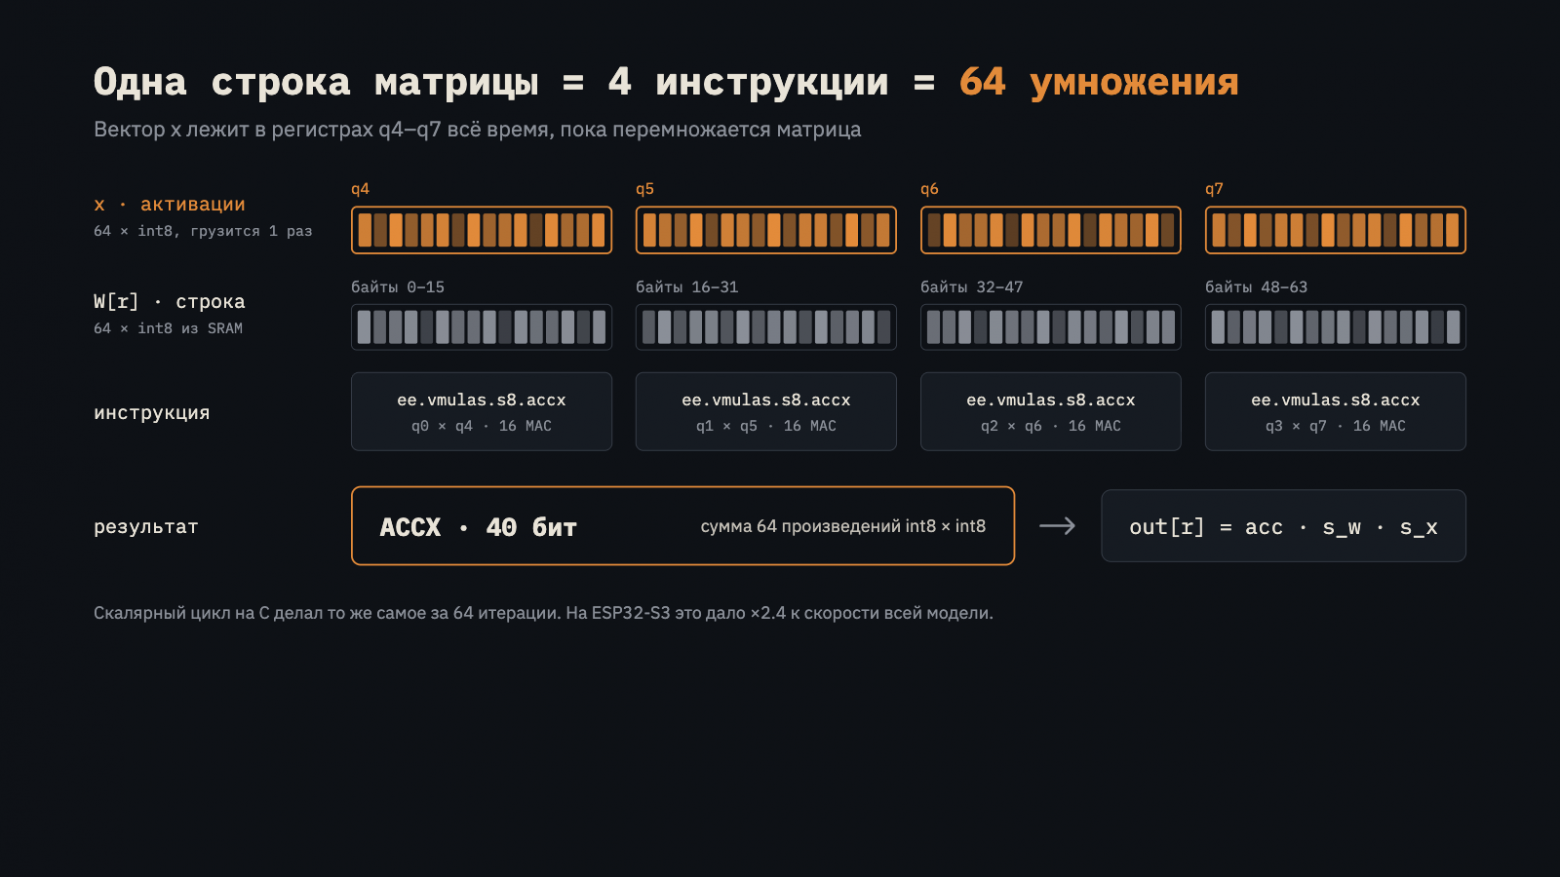
У модели размерность 64, а это ровно четыре 128-битных регистра. Значит, входной вектор можно загрузить в q4–q7 один раз и держать там, пока перемножается вся матрица. На каждую строку остаётся четыре загрузки весов и четыре векторных MAC:
    ee.vld.128.ip q4, a3, 16      // вектор x целиком в q4..q7
    ee.vld.128.ip q5, a3, 16
    ee.vld.128.ip q6, a3, 16
    ee.vld.128.ip q7, a3, 16
1:  ee.zero.accx
    ee.vld.128.ip q0, a2, 16      // первые 32 байта строки
    ee.vld.128.ip q1, a2, 16
    ee.vmulas.s8.accx.ld.ip q2, a2, 16, q0, q4   // MAC + загрузка следующего блока
    ee.vmulas.s8.accx.ld.ip q3, a2, 16, q1, q5
    ee.vmulas.s8.accx q2, q6
    ee.vmulas.s8.accx q3, q7
    nop
    nop                            // ACCX нельзя читать сразу после MAC
    rur.accx_0 a8
    s32i a8, a4, 0
    addi a4, a4, 4
    addi a5, a5, -1
    bnez a5, 1b
Инструкция с суффиксом .ld.ip одновременно умножает текущий блок и загружает следующий, так что задержка памяти частично прячется за вычислениями. Для FFN, где строка длиной 176 байт, есть общий вариант с циклом loopnez. Скрытый слой 172 при экспорте дополняется нулями до 176, чтобы строки были кратны 16 байтам.
Ещё один приём на этом шаге — слияние матриц. Q, K и V умножаются на один и тот же вектор, поэтому их строки склеены в одну матрицу 128×64. То же сделано с W1 и W3 из SwiGLU. На слой выходит четыре матричных умножения вместо семи, и активацию нужно квантовать реже.
Результат: 71.7 → 175.2 tok/s, ×2.4. Но профиль после этого шага выглядит странно. Матричные умножения, которые раньше занимали 65% времени, теперь занимают 13%. Остальное съедает внимание — 72%.
❯ Шаг 3. Второе ядро
У ESP32-S3 два ядра, и второе до этого простаивало. Разделить работу просто: каждое ядро считает половину строк матрицы и половину голов внимания. Сложность в другом — матрицы очень маленькие. Умножение 64×64 на PIE занимает микросекунды, и семафор FreeRTOS на каждую такую задачу съел бы весь выигрыш.
Поэтому второе ядро не ждёт семафор, а крутится в цикле на volatile-счётчике:
static void worker_task(void *arg) {
    uint32_t seen = job_req;
    for (;;) {
        ulTaskNotifyTake(pdTRUE, portMAX_DELAY);   // спим, пока ядро не нужно
        while (worker_spin) {
            if (job_req != seen) {
                seen = job_req;
                job_fn(job_a, job_b);              // своя половина работы
                __sync_synchronize();
                job_done = seen;
            }
        }
    }
}

static void run_parallel(llm_job_fn fn, int n) {
    job_fn = fn; job_a = n / 2; job_b = n;
    __sync_synchronize();
    job_req = job_req + 1;                         // отдали вторую половину
    fn(0, n / 2);                                  // первую считаем сами
    while (job_done != job_req) { }
    __sync_synchronize();
}
Вне генерации второе ядро спит на уведомлении задачи. Иначе оно бы постоянно читало SRAM и мешало честным замерам в однопоточных режимах. Сторожевой таймер задач пришлось отключить: оба ядра подолгу заняты, и он принял бы это за зависание. Справедливо: со стороны это так и выглядит.
Результат: 175.2 → 285.5 tok/s, ×1.63. До двукратного ускорения не дотянули, потому что часть работы осталась последовательной: RMSNorm, квантование активаций, RoPE, SwiGLU, выбор следующего токена. Её доля в профиле выросла с 15% до 23%.
❯ Шаг 4. Закон Амдала и внимание
После PIE и второго ядра матричные умножения стали настолько дешёвыми, что узким местом оказалось внимание. Это закон Амдала в чистом виде: ускорили одну часть, и всё время теперь уходит на другую.
У внимания есть неприятное свойство: его цена растёт с длиной текста. На позиции p каждая из 8 голов в каждом из 5 слоёв сравнивает текущий запрос со всеми p предыдущими ключами, считает экспоненту для софтмакса и складывает p векторов значений. Поэтому в первой версии скорость падала с 705 tok/s на первом токене до 193 на 120-м.
Вторая версия внимания использует две идеи. Первая — GQA: в модели две головы запросов делят одну голову ключей и значений. Раньше каждая голова читала KV-кэш сама и переводила каждый int8 во float, теперь обе головы обслуживаются за один проход, и каждый байт кэша преобразуется один раз. Вторая — регистры. У FPU в Xtensa всего 16 регистров, а в первом варианте нового кода в цикле жило больше 20 переменных. В дизассемблере нашлось 81 обращение к стеку для сохранения и загрузки регистров. После разбиения счёта на две половины по 4 измерения всё поместилось в регистры, а порядок операций остался прежним, так что результат совпадает со старой версией бит в бит.
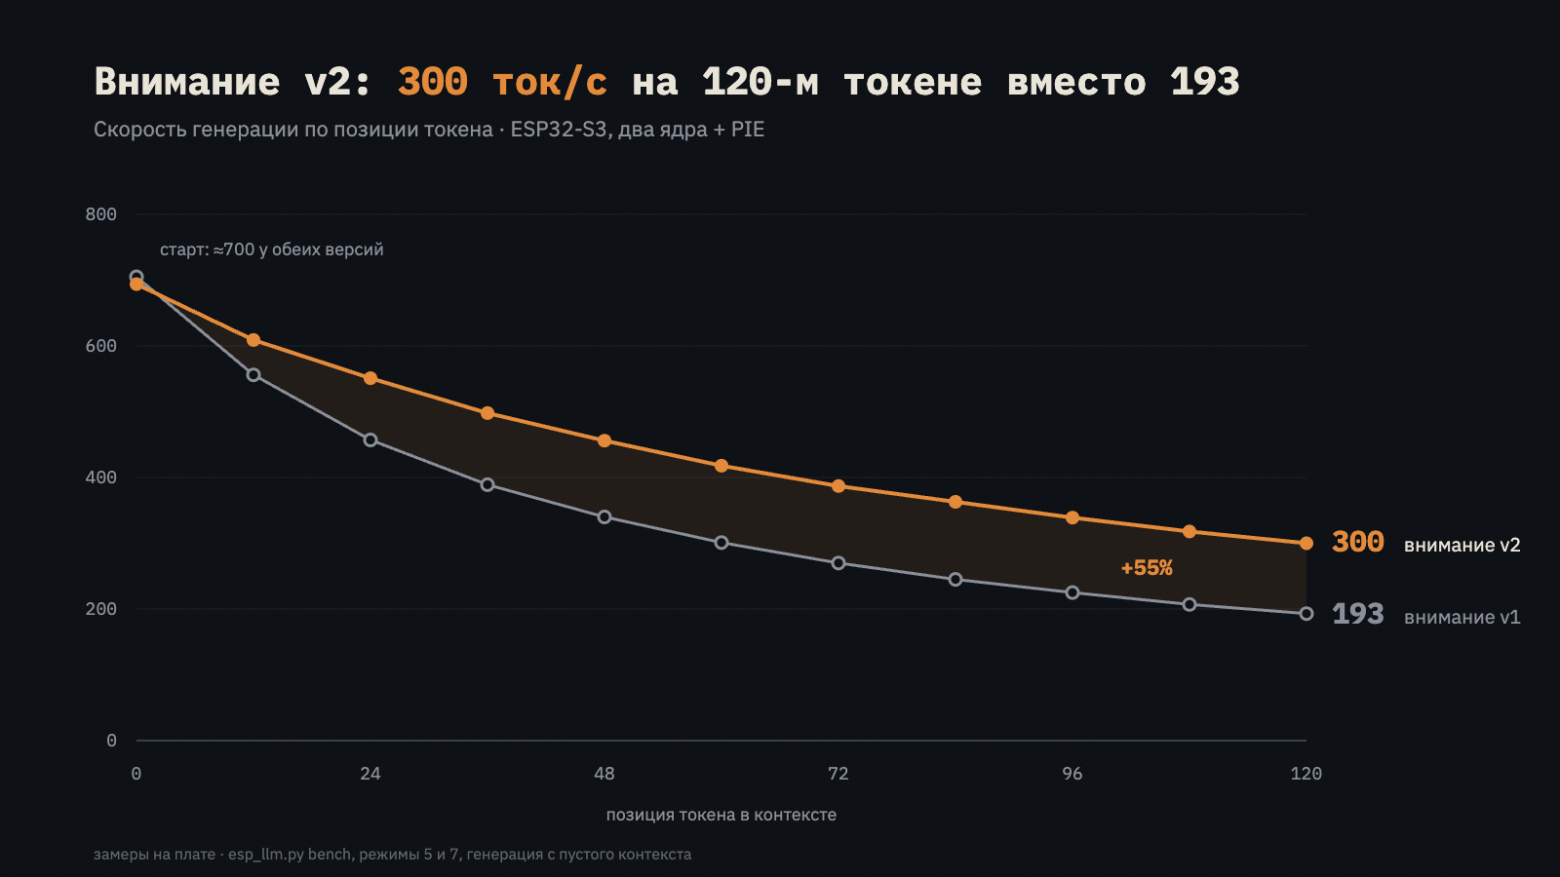
На длинном контексте новая версия быстрее в полтора раза, а средняя скорость на 128 токенах выросла с 285.5 до 406.1 tok/s. Доля внимания в профиле упала с 60% до 43%.
Казалось бы, следующий очевидный шаг — перевести в целые числа и скалярное произведение запроса и ключа. Я попробовал: 403.6 tok/s против 406.1, разница в пределах шума. Значит, время уходит не на Q·K, а на софтмакс и сложение значений. А самым толстым куском профиля теперь стал «прочий» код — 33%: деления в SwiGLU, квантование, RMSNorm. На каждом шаге узкое место переезжает куда-то ещё. Оптимизация вообще похожа на игру «бей крота», где крот никогда не заканчивается.
❯ Битва за килобайты SRAM
Самая неожиданная часть работы — не ассемблер, а бухгалтерия памяти. Килобайты тут считаются, как деньги за три дня до зарплаты. В SRAM должны одновременно поместиться веса (274 КБ), активации и KV-кэш. Кэш растёт с длиной контекста: на каждый токен 5 слоёв × 32 байта ключей и столько же значений плюс масштабы, около 360 байт.
После загрузки ESP-IDF в куче оставалось 335 КБ, и контекст влезал только на 96 токенов. Что помогло:
-
Код ESP-IDF из IRAM во флеш. У ESP32-S3 инструкции и данные делят одну SRAM, и по умолчанию FreeRTOS, куча и драйвер флеша живут в IRAM ради скорости. Опции
CONFIG_FREERTOS_PLACE_FUNCTIONS_INTO_FLASH,CONFIG_HEAP_PLACE_FUNCTION_INTO_FLASH,CONFIG_SPI_FLASH_ROM_IMPLи несколько похожих освободили около 20 КБ. -
Минимальный кэш инструкций, 16 КБ: кэш тоже вырезается из SRAM.
-
Маленькие буферы UART и USB, промпт до 400 токенов вместо 1000.
-
Таблица RoPE во флеше. На каждый токен из неё нужна одна строка в 32 байта, и кэш флеша с этим справляется.
-
Задача второго ядра создаётся первой. Иначе к моменту её создания нормальная память заканчивалась, стек попадал в RTC-память, и второе ядро падало с исключением. Заодно RTC-память убрана из кучи совсем.
В итоге свободно 363 КБ, а контекст вырос до 160 токенов. Прошивка сама считает бюджет при загрузке и урезает KV-кэш до того, что помещается рядом с весами. Получается любопытный вывод: 260 тысяч параметров в int8 — это почти потолок для SRAM ESP32-S3. Модель заметно больше придётся читать из флеша или PSRAM.
❯ Итоги
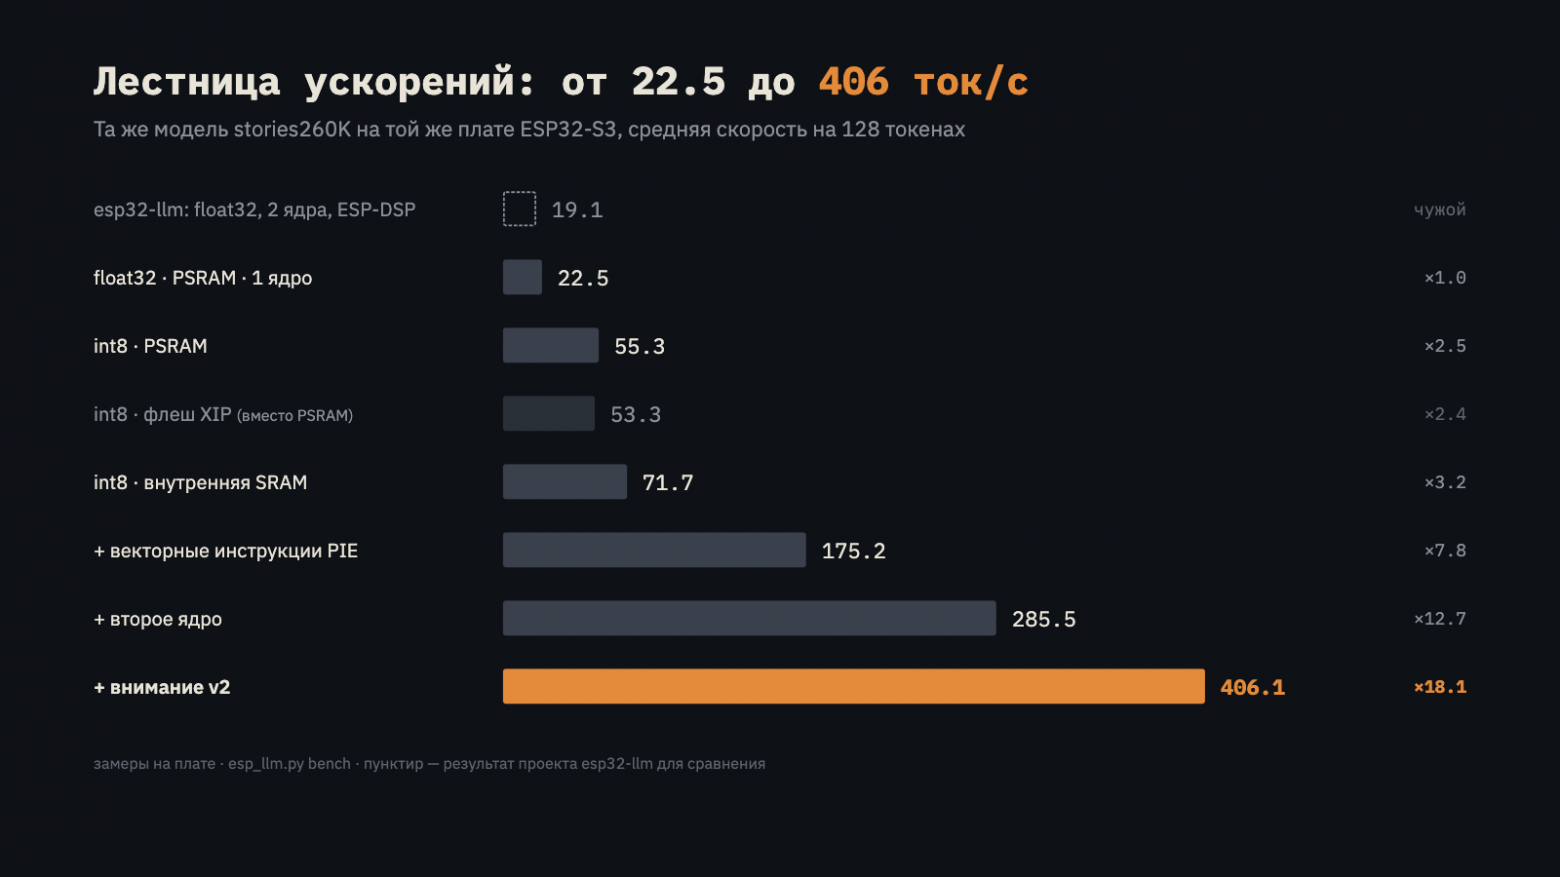
Та же модель на том же чипе: 22.5 tok/s у наивной версии на одном ядре, 406 tok/s после всех шагов. Это в 21 раз быстрее esp32-llm с его 19.1 tok/s. Главный вклад дали не хитрые трюки, а скучные вещи — int8 и правильное место для весов. Векторные инструкции и второе ядро добавили ещё ×4, а переписанное внимание — ×1.4.
Вот что плата пишет на этих 406 tok/s, начиная с «Once upon a time»:
Once upon a time, there was a little girl named Lily. She loved to play outside in the park. One day, she saw a big, red ball. She wanted to play with it, but it was too high.
Lily’s mom said, “Lily, let’s go to the park.” Lily was sad and didn’t know what to do.
На эти пару десятков токенов ушло около десятой доли секунды. Сюжет в модели на 260 тысяч параметров, правда, оставляет желать лучшего: мама зовёт в парк, где Лили уже стоит, а мяч висит слишком высоко без всяких объяснений.
Ещё два вывода оказались для меня неожиданными. Флеш с XIP почти не уступает PSRAM, так что маленькой модели внешняя память не нужна. А узкое место на каждом шаге переезжает: сначала память, потом скалярный цикл, потом внимание, теперь деления и нормализации, которые раньше никто не замечал.
Весь код — движок, ассемблерные ядра, симулятор на numpy и скрипт для прошивки и замеров — лежит на гитхабе. Прошивка уже собрана, и для повторения хватит платы с ESP32-S3 и Python.
Код: https://github.com/nikuson/esp32-llm
Следующая цель — stories15M прямо из флеша. Она в 60 раз больше и, подозреваю, тоже про Лили и мяч, но зато подробнее. А пока у меня на столе лежит плата за пару сотен рублей, которая сочиняет сказки быстрее, чем я успеваю их читать. Практического применения я ей так и не придумал, но выглядит она очень довольной. Если придумаете вы — пишите в комментариях, передам ей.
А если суровая борьба за каждый килобайт памяти — не самый любимый вид досуга, попробуйте AI-агентов Timeweb Cloud. Выбирайте LLM, настраивайте и тестируйте свои идеи.
Новости, обзоры продуктов и конкурсы от команды Timeweb.Cloud — в нашем Telegram‑канале →
Автор: Nikuson

