


ИИ-агенты сейчас стремительно развиваются. Совсем недавно ИИ-агент был обычным чатом с LLM, где он творил что хотел. Но в последнее время вы могли даже сами слышать такие вещи, как скиллы, MCP, оркестрационный цикл, инструменты, управление контекстом, — все это составляющие части агентской системы под названием Harness. Сам агент — это LLM + Harness. При умелом использовании даже не самая лучшая модель, но с качественным Harness-окружением может обогнать использование топовой LLM, но без обвязки.
И в последнее время идет много разговоров насчет самого харнесса. Скиллы, MCP, инструменты, оркестрация и субагенты — все это нововведения совсем недавние. Но в текущем состоянии есть недочеты: в одной конфигурации агент читает структуру директорий, находит ключевые файлы и точечно запрашивает нужные фрагменты. В другой — жадно вычитывает все подряд, забивая контекст. Или агент может что-то забыть, или использует инструменты и вызовы MCP/субагентов не совсем по назначению.
Инженеры в таком случае крутят настройки харнесса. Но ручная настройка все-таки трудна и ресурсозатратна. И вот Google выложила открытый фреймворк Harness² для самоулучшения ИИ-агентов. Он позволяет агентам в OpenCode и Codex самостоятельно корректировать инструкции, скиллы и другие компоненты по мере работы.
В этой статье мы как раз и рассмотрим Harness² — plug-and-play фреймворк от Google Research для рекурсивного харнесса в открытом мире.
Слово «harness» в контексте ИИ пришло из инженерии и прижилось не сразу. Буквально это «упряжь». В контекст разработки пришло из сферы тестирования и обозначает инфраструктуру и условия для прогона кода. В нашем случае это эволюционировало в действия, которые нужно сделать после LLM, чтобы та решала задачи качественно и меньше слопила. На данный момент сюда входит управление контекстом, инструменты, память, скиллы, MCP, инструменты и мультиагентная логика.
В эталонном восприятии ИИ-агента LLM — это всего лишь эндпоинт, который принимает JSON (или другой формат) и отдает JSON.
Без качественного harness даже топ-модель остаётся чат-ботом; с хорошим harness средняя модель решает задачи иногда даже надёжнее. Собственно, именно поэтому есть такие вещи, как оркестрация и мультиагентность — дорогая модель для верификации и сложного проектирования и раздумывания, средняя для генерации и оркестрации, быстрая и дешёвая для массовых субагентских вызовов.
Такое распределение требует единого слоя доступа к разным моделям, и здесь практическим решением становится OpenAI-совместимый шлюз BotHub (https://openai.bothub.chat/v1). Официальные SDK работают без изменений, а при регистрации по реферальной ссылке начисляется 300 000 CAPS.
В README фреймворка Harness² на GitHub компонентов Harness ровно восемь, и они разложены по полочкам: system prompt, guardrails, memory, tool guidance, subagents, skills, scripts и plugins. Первые четыре отвечают за то, как модель строит контекст, что она читает первым, что ей нельзя делать, что именно запоминать между шагами и как ей объяснили работу с инструментом. Tool guidance и scripts задают интерфейс с инструментами — когда вызывать search_docs, а когда просто ответить своими словами. Subagents включаются в делегирование, когда один агент разбирает задачу на части, а другой эти части выполняет. Plugins — это middleware, который подкручивает поведение внутри цикла вызова инструментов.
Теперь про квадрат в названии. Двойка означает два уровня рекурсии. Первый уровень — task-level recursion — работает внутри одной задачи. Агент запускает её в базовой обвязке, получает некий результат, затем редактор harness предлагает правки, эти правки проверяются на той же задаче, и из удачных собирается улучшенная версия обвязки. А вот второй уровень — harnessing-level recursion — работает между задачами. После того как задача закончена, система записывает принятые изменения и «уроки, подтверждённые поведением» в постоянную библиотеку — называемую improvement harness, — которая потом подсказывает редактору, какие правки имеет смысл предлагать в следующий раз.
Проще говоря, первый уровень чинит обвязку под конкретную задачу. Второй уровень чинит сам процесс починки, чтобы следующая задача чинилась быстрее и точнее. Отсюда и квадрат: harness, который улучшает harness. Кстати, в препринте на arXiv авторы прямо пишут, что каждый новый таск всё равно стартует с одной и той же базовой обвязки — переносится именно библиотека опыта.
Давайте теперь изучим этот Harness в квадрате.
Как это работает?
Первый уровень рекурсии — это то, что происходит внутри одной задачи, пока она в процессе выполнения. И сердце этого уровня — цикл Propose-Probe-Compose, предложить-проверить-собрать. Этот цикл заключается в том, чтобы предложить правки, проверить их эффект на той же задаче и собрать улучшенный харнесс из поведенческих различий между запусками.
Начинается все с reference execution — первого прогона задачи в базовой обвязке. Этот прогон нужен для фиксирования способа решения задачи и цепочки его операций — где остановился, что прочитал, какой инструмент вызвал зря, что забыл проверить. Траектория и артефакты этого запуска становятся отправной точкой для сравнения.
Дальше в дело вступает редактор. В дефолтной конфигурации это Claude Opus 4.8 (немного старая модель, но можно взять и более новую). Да, фреймворк от Google Research использует модель от конкурентов. Редактор получает на вход задачу, текущий harness, траекторию эталонного запуска и, если есть, то библиотеку прошлых харнессов. И на основе этих данных он предлагает двух кандидатов.
Первый — это инвариантивная правка (invariant edit). Она решает типовые слабости агентов, такие как планирование, использование инструментов, управление контекстом, делегирование. Скажем, если агент жадно вычитывает весь репозиторий подряд, инвариантная правка может добавить в Tool Guidance новое явное правило, чтобы агент сначала посмотрел структуру директорий и только потом точечно запрашивал файлы.
Второй вариант — доменная правка (domain-specific edit), созданная для того чтобы решать проблемы в конкретной предметной области — будь то юридические процедуры, офисные стандарты, особенности работы с бюджетами или таблицами.
После наступает шаг Probe — самый прямолинейный и самый важный. Каждый кандидат запускается на той же самой задаче, в тех же условиях и с тем же исполнителем. А потом начинается различие поведенческих различий — проверяется, изменилась ли траектория, появились ли новые шаги, исчезли ли старые, стал ли артефакт на выходе другим. Данный шаг заключается в том, что система проверяет, что изменилось, и смотрит, ведет ли изменение к устранению замеченной слабости. То бишь, тут нет эталонного правильного варианта.
В одном из заданий JobBench (бенчмарка, который мы рассмотрим позднее) агент должен был собрать комплект документов с согласованными цифрами. Первый прогон дал балл 43.1: числа в разных файлах не сходились, а выходные документы никто не переоткрыл и не проверил. Правки добавили две вещи — сверку источников и обязательное переоткрытие финальных артефактов, — и повторный прогон дал уже 77.8. Конечно, это единичный пример, и он не доказывает, что та же правка сработает на другой задаче.
И наконец завершающий шаг — Compose. Композер смотрит на три набора данных — эталонный прогон, прогон с инвариантным и доменным кандидатами — и решает, какие правки принять, какие отклонить, а какие объединить. Принятые изменения вливаются в итоговый harness, который тут же запускается ещё раз, уже как финальная версия для этой задачи. Всё это укладывается в бюджет k: при k=1 цикл проходит один раз, при больших значениях — либо параллельно (несколько кандидатов сразу), либо последовательно (цепочка из нескольких PPC-шагов). Параллельная рекурсия расширяет пул кандидатов, последовательная — углубляет проработку. На бенчмарках рост бюджета с 1 до 5 добавлял ещё баллов сверху, но и стоил заметно дороже.
Но есть и ограничения — поведенческое различие не гарантирует правильность. Если две версии харнесса ведут себя по-разному, это не значит, что какая-то из них лучше. Система может закрепить изменение, которое просто выглядит лучше, а на следующей задаче оно вряд ли может сработать. И вот поэтому механизм стараются делать на сравнении и на рефлексии.
Второй уровень, harnessing-level recursion, вступает в дело после того, как задача закрыта. Специальный компонент, который в коде называется reflector, просматривает весь записанный процесс, который состоит из эталонного запуска, предложенных кандидатов, решения композера и финального выбора. И вытаскивает из этого уроки — при каких условиях какая правка дала какой поведенческий эффект. Урок сохраняется только в том случае, если он подтверждён сравнением исполнений, а не просто сформулирован редактором на словах. Дальше принятый harness и эти уроки уходят в постоянную библиотеку под названием improvement harness. Далее рядом с деревом файлов появляется EXPERIENCE.md с описанием применимых сценариев, на которые опираются уроки.
Следующая задача не наследует настроенный harness предыдущей, кстати. Наследуется только библиотека опыта для того, чтобы направлять редактор.
Если собрать всё вместе, получается довольно аккуратная конструкция. Внутри задачи работает быстрый контур «предложил — проверил — собрал», который чинит обвязку под текущий контекст. Между задачами работает медленный контур, который накапливает подтверждённый опыт и делает следующие правки более прицельными. Ни один из этих контуров не трогает веса модели.
О бенчмарках
Время поговорить о бенчмаркинге. Авторы прогнали Harness² на трёх бенчмарках, и каждый проверяет свою сторону агентской работы.
WorkBuddy-Bench покрывает офисные, веб- и кодинг-задачи — от сборки документов до написания скриптов. JobBench — это сквозные профессиональные задачи с длинным горизонтом выполнения, ближе к тому, чем занимается человек в течение рабочего дня. И LAB от Harvey — юридический бенчмарк, где метрикой служит частичный pass rate по отдельным критериям.
Картина по максимальным приростам за один шаг выглядит так:
|
Бенчмарк |
Что измеряет |
Максимальный прирост за один шаг |
|---|---|---|
|
WorkBuddy-Bench |
офисные, веб- и кодинг-задачи |
+11.5 балла (GLM-5 + OpenCode: с 64.2 до 75.7) |
|
JobBench |
профессиональные задачи |
+4.5 балла (Gemini 3.5 Flash + OpenCode: с 31.5 до 36.0) |
|
LAB (Harvey) |
юридические задачи, pass rate |
+11.8 п.п. (GLM-5: с 59.6 до 71.4) |
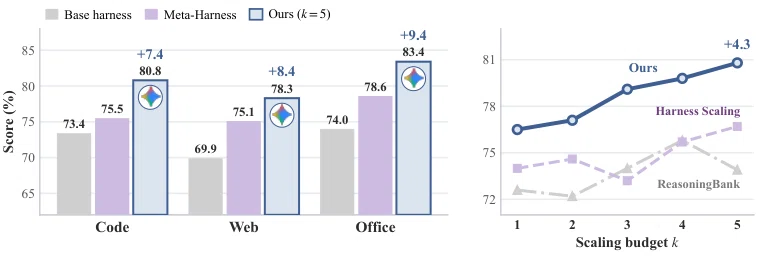
На первом изображении — сводная столбчатая диаграмма, которая хорошо передаёт общий тон результатов. Видно, что синие столбцы («Ours», то есть Harness² с k=5) уверенно выше и серых («Base harness»), и сиреневых («Meta-Harness»). Цифры над столбцами вроде +7.4, +8.4, +9.4 — это разница с базовой обвязкой, и они дают примерное представление о порядке величин.
Но самое интересное начинается, когда смотришь не на средние, а на разбивку по моделям и исполнителям.
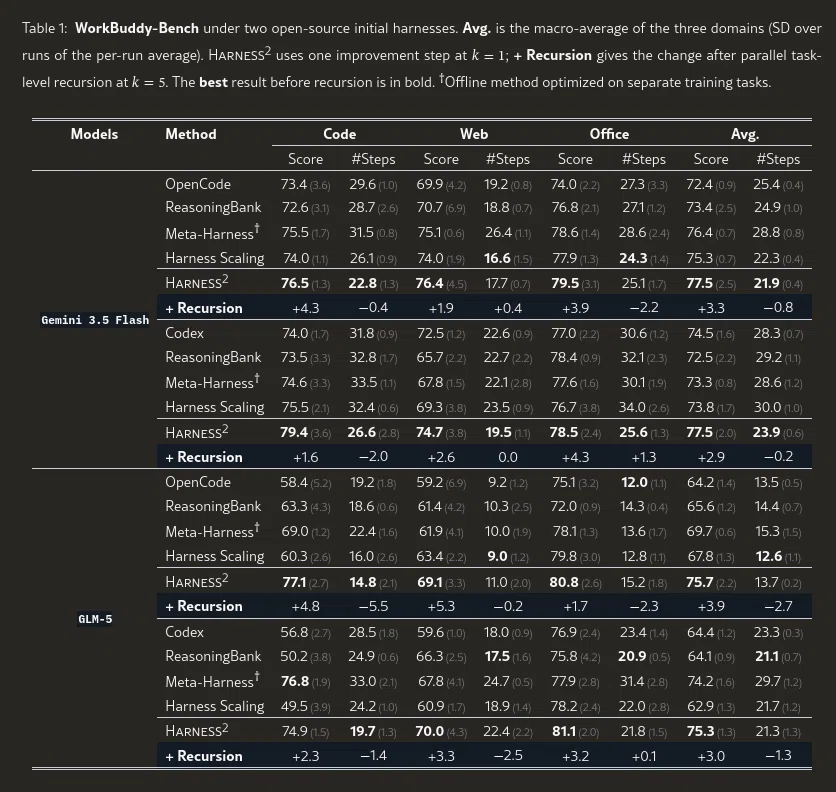
В таблице 1 из препринта — WorkBuddy-Bench с двумя открытыми исполнителями, Gemini 3.5 Flash и GLM-5. Обратите внимание на строку Harness² для GLM-5 под OpenCode: было 58.4, стало 77.1, то есть +14.7 балла на подмножестве Code. Это даже больше, чем средний прирост в 11.5, и наглядно показывает, что значит «поведенческое различие» на практике. Но ещё любопытнее строка + Recursion: при k=5 GLM-5 добирает ещё +4.8 на Code, и это уже не единичный скачок, а накопленный эффект от нескольких последовательных или параллельных шагов.
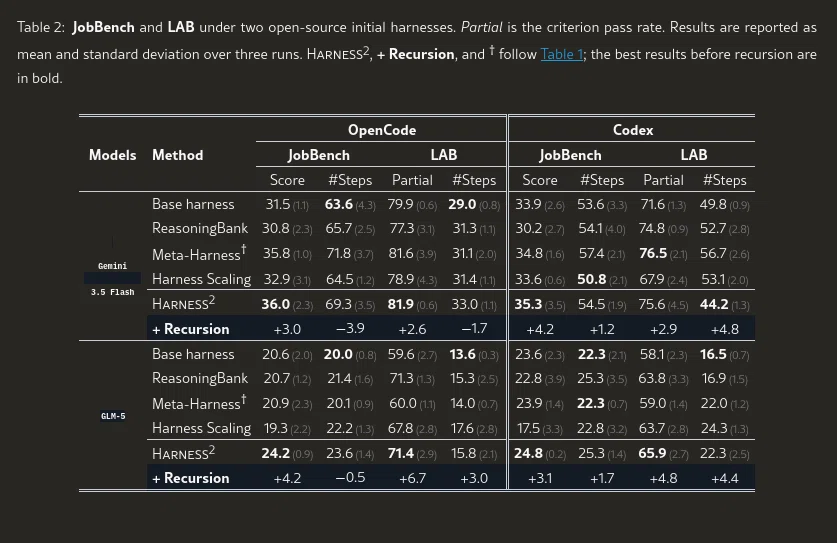
Таблица 2 переносит нас на JobBench и LAB. Здесь цифры скромнее по абсолютным значениям, но не менее показательны. Для Gemini 3.5 Flash под OpenCode на JobBench прирост с 31.5 до 36.0 — это те самые +4.5, которые фигурируют в сводке. А на LAB для GLM-5 виден скачок Partial pass rate с 59.6 до 71.4 — +11.8 процентных пунктов. Кстати, если присмотреться к строке + Recursion для LAB, там есть и +6.7 — это добавка от масштабирования бюджета, и она почти такая же крупная, как сам первоначальный шаг.
Теперь про паттерн, который авторы называют «weaker executors benefit more». Звучит как утешительный приз для слабых моделей, но на деле это довольно серьёзный сдвиг в том, как думать о качестве агентской системы. GLM-5 после одного шага оптимизации обвязки добирается до 75.7 на WorkBuddy-Bench (OpenCode) и 75.3 (Codex), тогда как базовый Gemini 3.5 Flash без оптимизации показывает 72.4 и 74.5 соответственно. То есть более слабая модель с улучшенной обвязкой обгоняет более сильную модель с обвязкой по умолчанию.
ReasoningBank и Harness Scaling — это альтернативные методы, с которыми сравнивали Harness². ReasoningBank на кодинг-задачах падает до 6.6 балла ниже базовой обвязки, а Harness Scaling уступает базовой в семи из двенадцати пар «бенчмарк — конфигурация». Harness², напротив, превышает базовую обвязку на WorkBuddy-Bench Avg. и JobBench Score во всех четырёх конфигурациях. Рекурсивное улучшение обвязки — не автоматическая кнопка «сделать хорошо». Метод имеет значение, и наивные подходы могут навредить.
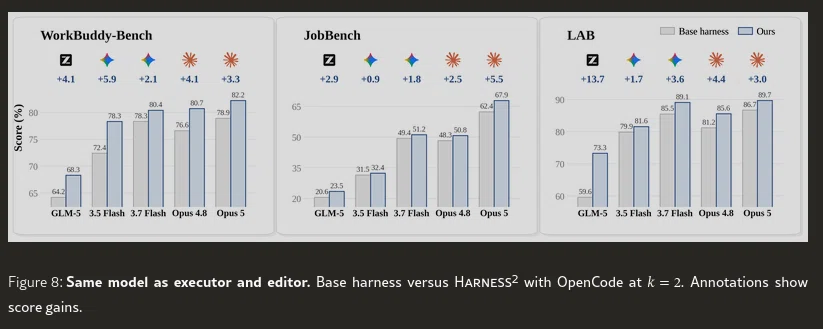
И последнее изображение — это, пожалуй, самый прямой ответ на вопрос «а что если редактор и исполнитель — одна и та же модель?». На столбчатых диаграммах для WorkBuddy-Bench, JobBench и LAB показаны результаты для пяти разных моделей в роли и исполнителя, и редактора одновременно, при k=2. Видно, что прирост есть у всех, но у Opus 5 он скромнее (+3.0 на WorkBuddy, +5.5 на JobBench), а у GLM-5 — заметнее (+4.1 и +2.9). Осторожно можно сказать, что Harness² не требует, чтобы редактор был умнее исполнителя. Механизм сравнения поведенческих различий работает и тогда, когда обе роли занимает одна и та же модель, хотя абсолютные цифры, конечно, зависят от её возможностей.
Стоит проговорить и цену. Каждый шаг рекурсии — это дополнительные прогоны задачи, а значит, токены и время. В препринте есть отдельный анализ компромисса между бюджетом k и приростом, и он показывает, что отдача от масштабирования убывает, то бишь переход с k=1 на k=5 даёт на WorkBuddy-Bench добавку в 2.9–3.9 балла, на JobBench — 3.0–4.2, на LAB — 2.6–6.7 процентных пункта. Это не бесплатно, и в продакшене придётся решать, готовы ли вы платить за эти дополнительные баллы пятикратным увеличением прогонов. Но сам факт, что прирост есть и он предсказуем, уже отделяет Harness² от методов, которые на тех же бенчмарках уходят в минус.
Как попробовать?
С теорией и цифрами всё более-менее понятно. Если вы заинтересовались и вам захочется потрогать Harness² руками, то начать стоит с репозитория на GitHub.
Самый простой способ посмотреть, как это работает, — локальное демо. Достаточно Linux-машины (на macOS официально не поддерживается), Python 3.12 и пакетного менеджера uv. Демо прогоняет оба уровня рекурсии с детерминированными «редакторами» и реальным исполнением Python-скриптов, так что поведение системы видно буквально за десять минут, без единого вызова модели. Выглядит это примерно так:
git clone https://github.com/google-research/harness2.git
cd harness2
uv venv --python 3.12 .venv
source .venv/bin/activate
uv pip install -e '.[render]'
harness2-demo --output runs/demo --k 2
Флаг --k 2 задаёт бюджет рекурсии, то бишь сколько раз цикл «предложить — проверить — собрать» успеет пройти внутри одной задачи.
Для реальных прогонов на бенчмарках понадобится уже больше инфраструктуры. Нужен Google Cloud проект с доступом к Vertex AI, установленный gcloud CLI, Node.js 20+ и, в зависимости от бенчмарка, Docker для WorkBuddy-Bench или Pandoc с Poppler для LAB. Модели вызываются через Vertex AI, и это платно, за прогоны на реальных моделях придётся платить. Исполнители поддерживаются два: OpenCode (по умолчанию) и Codex, причём второй подключается через Responses API, а для Gemini на Vertex AI есть специальный мост на локальном LiteLLM-сервере.
Запуск одного задания на юридическом бенчмарке LAB выглядит так:
cp .env.example .env
# редактируем .env: Vertex AI project и model IDs
gcloud auth application-default login

harness2-setup lab
harness2 --bench lab --k 1 --mode parallel
  --only-domains antitrust-competition --max-tasks 1
harness2-judge --bench lab --k 1 --mode parallel
harness2-report --bench lab --k 1 --mode parallel
Здесь --mode parallel включает параллельную рекурсию — несколько кандидатов проверяются одновременно. Последовательный вариант (--mode sequential) углубляет проработку, но требует больше времени. Начинать стоит с --max-tasks 1 и маленького k, чтобы просто увидеть, как система себя ведёт и сколько это стоит по токенам.
Harness2 — это исследовательский фреймворк, а не официально поддерживаемый продукт Google. API может меняться, вещи могут работать нестабильно, а сообщество только формируется.
Заключение
Главный сдвиг, который приносит Harness², лежит в том, что инженерия агента отделяется от инженерии модели. Раньше качество агентской системы почти целиком определялось тем, насколько сильна базовая LLM, а обвязка воспринималась как что-то вспомогательное — «ну, промпт подкрутить, инструменты добавить». Теперь появляется механика, которая системно и автоматически улучшает именно обвязку, и делает это на основе наблюдаемого поведения.
Если качество харнесса может дать +11 баллов без единого шага fine-tuning, то конкуренция может смещаться. Вместо того чтобы мериться моделями, будут мериться проработанностью харнесса. Разрыв между флагманской и дешёвой моделью можно закрыть за счет качественного харнесса, хоть и не всегда.
Источники
Автор: DrArgentum

