


Исследователи из Meta и KAIST решили проверить очевидный на первый взгляд вопрос: если дать большой языковой модели реальную историю измерений с фитнес-трекера — пульс, сон, шаги за полгода — сможет ли она разобраться в этих данных так же уверенно, как рассуждает о здоровье вообще? Результат оказался неожиданным. Модели гораздо хуже справлялись с простыми вычислениями по самим цифрам, чем с клинической интерпретацией того же ряда. GPT-4o правильно считал тренды и аномалии лишь в четверти случаев, а вот рассуждал о рисках для здоровья на основе тех же данных вдвое увереннее.
Логика подсказывает обратное: клиническая интерпретация — это высокий уровень, требующий знаний и осторожности, а посчитать среднее значение или найти всплеск в ряду чисел — задача попроще, почти техническая. Оказывается, для языковых моделей все устроено иначе, и разрыв между этими двумя навыками — системная проблема, которую авторы бенчмарка WearableQA зафиксировали на 14 моделях сразу. Разбираемся, что именно это значит для тех, кто планирует доверить ИИ анализ собственных данных о здоровье.
Почему нельзя скормить модели графики с часов
Идея дать LLM данные с носимых устройств не нова — ассистенты для сна и фитнеса на основе больших языковых моделей появляются один за другим. Проблема в том, как их проверяли до сих пор. Существующие бенчмарки для рассуждений над временными рядами в основном опираются на синтетические или смоделированные сигналы, а не на данные реальных людей. Разница принципиальная. Синтетический ряд чист и предсказуем, как учебная задача с округленными числами. А показания трекера с живого человека — это шум датчика, пропущенные дни, особенности конкретного тела и десятки мелочей, которые в лаборатории просто неоткуда взять.
Авторы WearableQA пошли другим путем. Они взяли данные 200 живых людей с ежедневными измерениями, у некоторых почти за полтора года. К каждому профилю добавили анализ крови (инсулин, гликированный гемоглобин и еще полтора десятка показателей) и базовые сведения о человеке: возраст, пол, вес, происхождение. Получилось 4084 вопроса. Причем таких, с какими реально столкнется ИИ-ассистент в приложении для здоровья, если однажды доберется до ваших собственных данных. Вопросы устроены как тест с выбором из 10 вариантов.
Как проверить ответ, если речь о живой физиологии
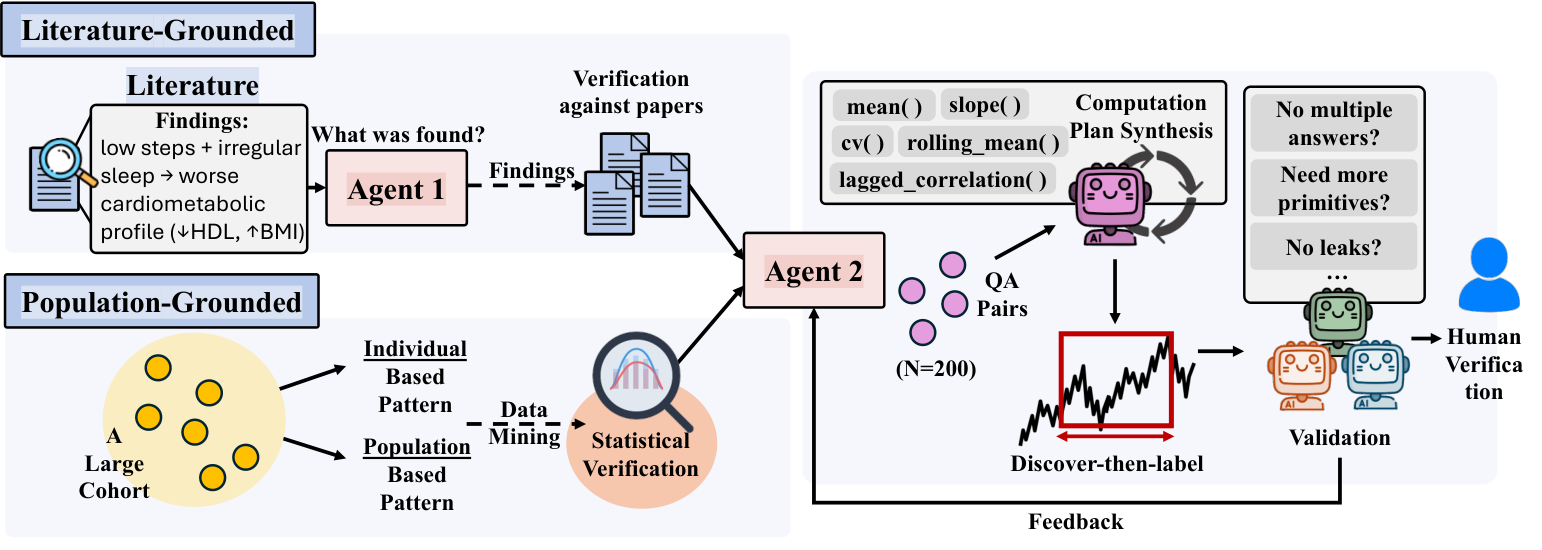
Для вопроса вроде «правда ли у этого человека растет пульс в покое» нужен эталонный ответ. А его нельзя взять из головы: он должен опираться либо на медицинскую литературу, либо на статистически подтвержденную закономерность.
Исследователи выбрали оба источника сразу. Часть вопросов построена на данных из рецензируемых статей — авторы отобрали 11 опорных публикаций (в том числе из Nature Medicine и PNAS), проверили идентификаторы по DOI, PMID и PMCID, прочитали каждую целиком и требовали, чтобы найденная закономерность подтверждалась минимум двумя независимыми исследованиями с одинаковым направлением эффекта.
Другая часть вопросов родилась непосредственно из данных: команда искала закономерности в 200 профилях пользователей — тренды, всплески, связи между разными сигналами. Но найти корреляцию мало, ее еще нужно было проверить на прочность. Поэтому каждый такой паттерн пропускали через три фильтра.
Во-первых, сила связи: коэффициент корреляции не ниже 0,5, причем знак должен совпадать в обеих половинах временного окна. Во-вторых, устойчивость. Закономерность обязана была выдерживать пересэмплирование данных (не меньше 80% из 30 повторов) и не разваливаться, если убрать из выборки любой отдельный день. И наконец, подлинность: связи проверяли на случайно перемешанных парах пользователей — так отсеивали то, что на самом деле было статистическим шумом, а не реальной физиологией.
Вопросами становились только закономерности, прошедшие все три проверки. Отдельно доставалось и неправильным вариантам ответа: если модель могла угадать правильный, просто ориентируясь на формулировки, а не заглядывая в данные, вопрос переделывали заново.
Два типа мышления, которые бенчмарк разводит по разным сторонам
Все вопросы делятся на две независимые группы. Первая группа проверяет тип рассуждения. Одни вопросы требуют посчитать что-то напрямую по сырым измерениям: найти тренд, всплеск, время восстановления после нагрузки, самую сильную связь между двумя сигналами. Другие уже требуют интерпретации: оценить риск, дать прогноз, предложить рекомендацию, опираясь на клинические знания, а не только на голые цифры.
Вторая группа смотрит на сложность по числу сигналов. Одни вопросы касаются одной метрики, скажем, только пульса. Другие заставляют сводить сразу несколько сигналов вместе — например, искать связку между физической активностью и пульсом в покое.
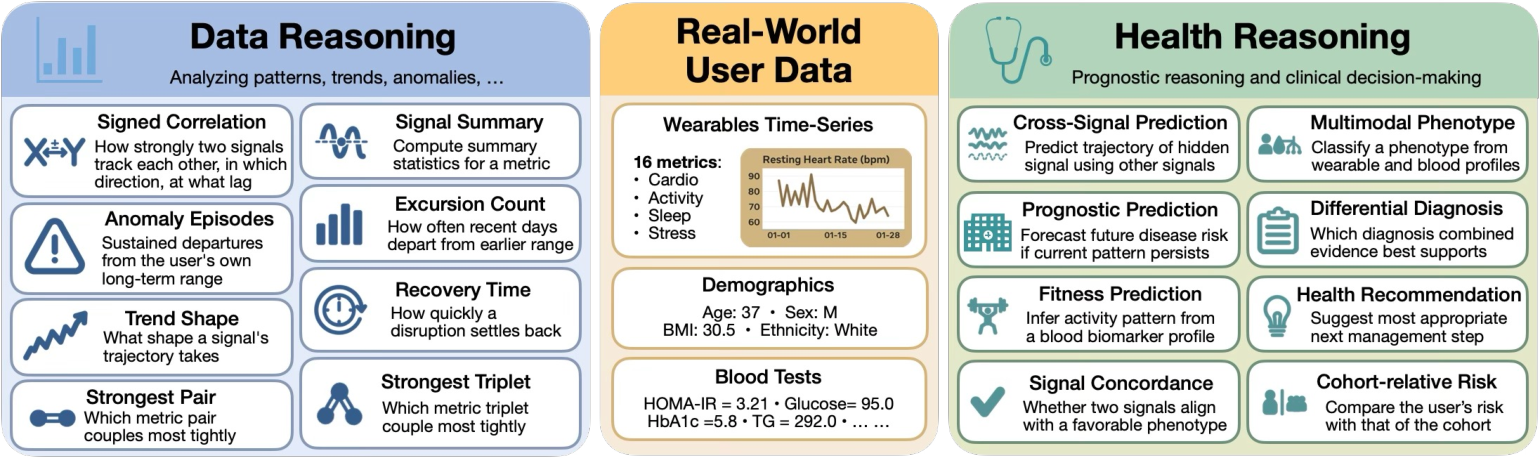
Вместе эти оси дают 16 типов вопросов и, что важнее, позволяют локализовать, где именно модель ошибается: не справляется с самим вычислением, с медицинской интерпретацией или с объединением нескольких источников данных в одну картину.
Подходим к главному
Исследователи прогнали через бенчмарк 14 моделей: от GPT-4o и Gemini 2.5 Pro до компактных Llama и Gemma. Точность разбежалась от 19,6% до 72,9% при случайном угадывании в те же 10%. Само по себе это не удивляет: модели покрупнее и посвежее обычно точнее. Неожиданность в другом.
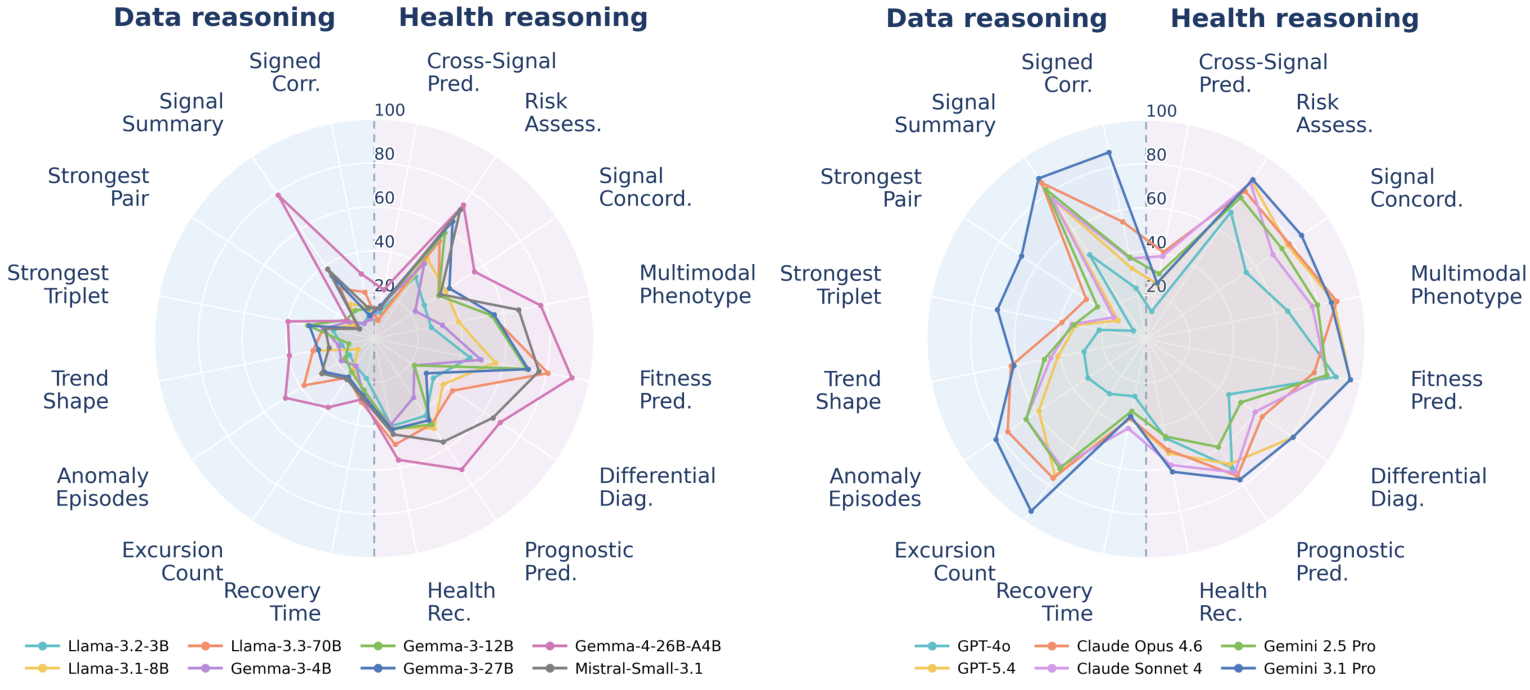
Почти у всех моделей точность на клинической интерпретации оказалась выше, чем на вычислениях по сырым данным. Хотя интуиция подсказывает обратное. У GPT-4o разница составила 25,3% против 53,5%, у компактной Gemma-4-26B — 33,8% против 59,8%, у Mistral-Small — 20% против 47,9%. И только у одной модели, Gemini 3.1 Pro, вышло наоборот: с вычислениями она справилась даже увереннее, чем с интерпретацией — 75,4% против 67,8%.
Похоже, дело не в том, что клиническая интерпретация — задача попроще. Дело в том, откуда вообще берется ответ. Оценивая риск для здоровья, модель может просто опереться на общие знания о физиологии, вынесенные из обучающей выборки. Примерно как студент, вызубривший учебник, отвечает на вопрос теста, даже не открывая условие задачи. А вот чтобы найти тренд или всплеск в конкретном ряду чисел конкретного человека, общих знаний уже не хватит. Тут придется реально смотреть в данные и что-то считать.
Авторы бенчмарка проверили эту гипотезу отдельным экспериментом. Они сравнили пары сигналов двух видов. Одни связаны очевидно, чуть ли не по определению: скажем, число шагов и потраченные калории — тут и так все понятно. Другие пары раскрывают себя только через наблюдение за конкретным человеком, например пульс в покое и уровень стресса. Силу связи выровняли специально, чтобы сравнение было честным. И разница в точности вышла разительная: у Gemini 2.5 Pro «очевидные» пары дали фору почти в 52 процентных пункта, у GPT-5.4 — почти в 48. Модели действительно чаще узнают знакомую закономерность, чем вычисляют новую по данным конкретного человека.
Слепая зона: когда нужно свести несколько сигналов воедино
Вторая часть эксперимента, про межсигнальные рассуждения, оказалась не менее показательной. У большинства закрытых моделей точность на вопросах с одним сигналом заметно выше, чем там, где нужно свести несколько сигналов вместе. У GPT-5.4 разрыв составил 59,1% против 45,7%, у Gemini 2.5 Pro — 58,1% против 45,3%.
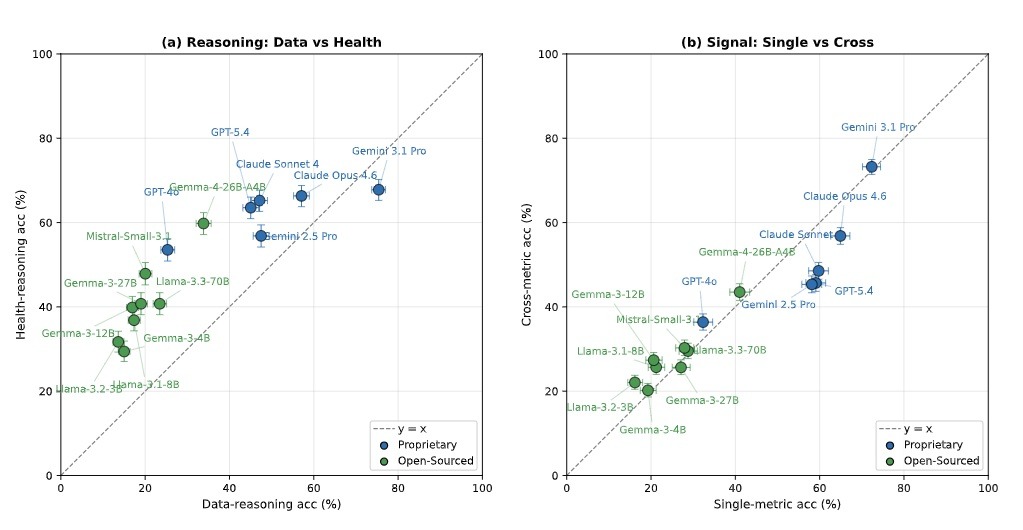
Отдельно выделяется один тип вопросов — прогноз одного сигнала через связь с другим (cross-signal prediction). Здесь результаты почти катастрофические даже для сильных моделей: от 8,3% у компактной Llama-3.1-8B до 40,5% у Claude Opus 4.6 — притом что случайное угадывание дает 10%. То есть лучшая модель на этом конкретном типе задач едва превосходит уровень случайности в четыре раза, тогда как на других задачах разрыв с угадыванием доходит до семи-восьми раз.
Графики не помогают, а код — помогает
Отдельно проверили, как формат подачи данных влияет на результат. Авторы сравнили текстовые представления — построчную запись, таблицу по столбцам, Markdown, CSV — и визуальные: отдельные графики по каждому сигналу и сгруппированные графики.
Разница между текстовыми форматами оказалась минимальной, в пределах одного-двух процентных пунктов. А вот с графиками вышло интересно. Точность не выросла, а упала: с 51,2% на обычном тексте до 36,6%, если каждому сигналу дать отдельный график, и до 34,1%, если графики сгруппировать. Совмещение текста и картинки тоже не спасло ситуацию.
Зато когда модели дали доступ к интерпретатору Python и разрешили самой писать код для вычислений, случился резкий скачок: точность подскочила с 51,2% до 71,3%, это почти 20 процентных пунктов разом. Похоже, дело не в том, что модели плохо «понимают» временные ряды сами по себе. Просто устный счет в уме по огромному массиву чисел им дается плохо, а вот если разрешить считать напрямую, разрыв между «знать физиологию» и «уметь анализировать данные» во многом исчезает.
Есть в исследовании и почти анекдотичный момент. Когда моделям запрещали рассуждать пошагово и просили сразу называть букву ответа, маленькие модели начинали заметно тяготеть к одним и тем же вариантам. Ярче всего это видно на Llama-3.2-3B: в режиме прямого ответа она выбирала один и тот же вариант в 51,5% случаев, независимо от вопроса. Стоило разрешить модели порассуждать вслух — и перекос почти пропал: доля одного варианта упала до 13,5%. У крупных проприетарных моделей перекос был мягче, но тоже заметен — например, Claude Opus 4.6 предпочитал более ранние буквы алфавита.
Вместо вывода
Результаты WearableQA складываются в не самую приятную картину для тех, кто уже пользуется или только собирается пользоваться ИИ-ассистентами по здоровью на основе данных с трекера. Модель может уверенно и связно рассуждать о рисках для здоровья, но это вовсе не значит, что она реально анализирует ваш личный ряд измерений. Она вполне может просто опираться на общие знания о физиологии, которые звучат убедительно сами по себе, независимо от того, что на самом деле происходит в ваших конкретных цифрах. И заметить эту подмену со стороны почти невозможно: оба типа ответа выглядят одинаково уверенно.
Практический вывод для тех, кто разрабатывает подобные продукты, тоже довольно конкретный — судя по эксперименту с доступом к Python, лучший способ заставить модель действительно считать, а не гадать по общим знаниям, — дать ей инструмент для вычислений, а не просто более подробное текстовое описание данных.
Если бы вы точно знали, что ИИ-ассистент в вашем трекере скорее опирается на общие знания о физиологии, чем реально разбирает именно ваши цифры, — стали бы вы доверять его советам так же, как раньше?
Автор: aberglaube

