


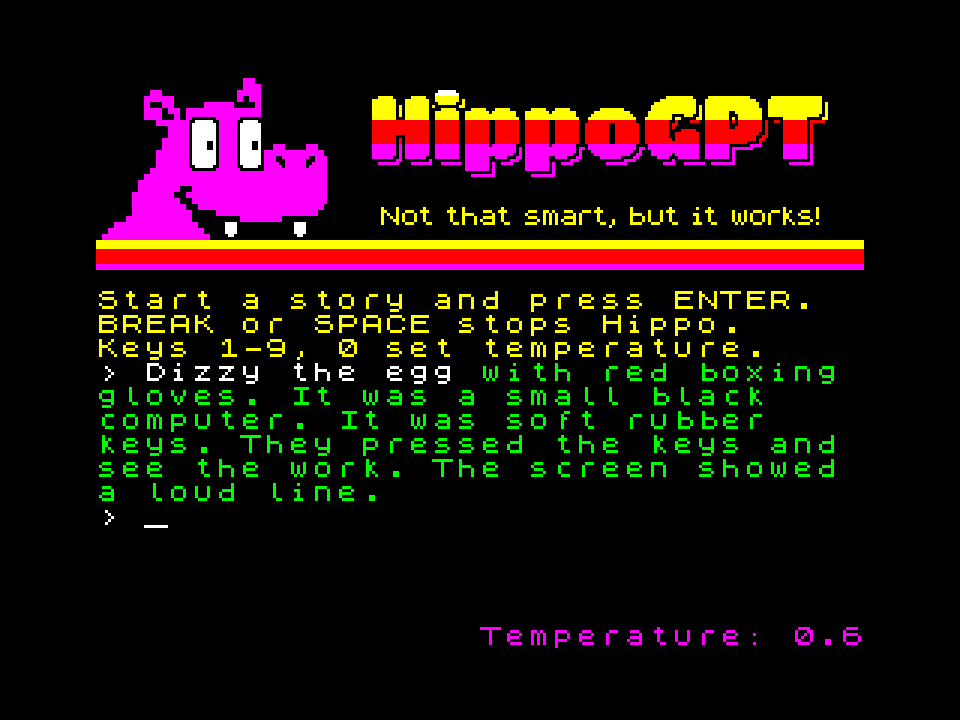
Начитавшись статей о сверхкомпактных языковых моделях — вроде тернарной нейронки на C# — я задумался: а заведется ли такая модель на любимом компьютере моего детства? При этом хотелось, чтобы это был не просто proof-of-concept, а приложение, ответа которого человек будет в силах дождаться.
Так появился HippoGPT — крошечная языковая модель, которая сочиняет детские сказки на обычном Spectrum 128K. Обучена она на TinyStories — корпусе простых англоязычных сказок для малышей. Про Спектрум там нет ни слова, поэтому пришлось добавить полторы тысячи сгенерированных историй про Speccy — с кассетами, текстами ошибок и Dizzy. Запустить можно прямо в браузере, на странице ZX Art. Не ждите слишком многого, но оно… работает!
Дисклеймер: код приложения написан с помощью Claude Opus. Проект задумывался как ответ на вопрос «возможно ли это?», а не как повод освежить навыки программирования на ассемблере Z80.
Для тех, кто не застал Спектрум
ZX Spectrum — британский домашний компьютер 1982 года, а у нас в 90-е его массово собирали в виде клонов промышленного производства типа «Пентагона» или безымянной кустарщины по чертежам из журналов. Его процессор Z80 вышел в 1976 году и производился 48 лет.
Z80 оказался настолько универсальным, что его ставили почти везде, где нужен был дешевый и простой процессор. Как пишут на Old-Games.ru, это автоматические определители номера, процессоры RFID-карт, стиральные машины, скороварки и даже ракеты. У меня самого в конце 90-х стоял телефон «Русь» с АОНом — тоже на Z80.
Для нейросети это суровая машина: 3,5 миллиона тактов в секунду и 128 КБ памяти. Ни плавающей точки, ни даже умножения — только сложение и сдвиги.
Как измерить ум GPT-бегемота
Для того чтобы выбрать подходящие параметры сети, нужно было как-то измерить «осмысленность» текста. Представьте игру «угадай следующую букву»: модель читает настоящую сказку и перед каждой буквой задает вопросы «да или нет», пока ее не угадает. Среднее число таких вопросов на букву и называется «биты на символ». Наугад среди 64 символов выбранного шрифта нужно шесть вопросов, а модель, которая что-то поняла в языке, обходится одним-полутора. Чем меньше, тем умнее.
На глаз разница в десятые доли бита плохо ощущается, поэтому во втором столбце та же цифра в словах. Она показывает, из скольких одинаково вероятных слов модель как будто выбирает каждое следующее слово. Меньше вариантов — связнее текст. Для масштаба в таблице есть и Qwen3-8B, которую я прогнал на тех же сказках, что и Хиппо.
|
Модель |
Бит на символ |
Выбирает слово из |
|---|---|---|
|
По буквам |
1,38 |
116 |
|
По токенам |
1,11 |
45 |
|
HippoGPT: веса по 4 бита и сказки про Спекки |
1,26 |
77 |
|
Для сравнения: Qwen3-8B, 8 млрд параметров |
0,67 |
10 |
Главный скачок при тестировании дал переход с букв на токены — частые куски слов вроде « the» или «ing». Словарь из 512 таких токенов сократил выбор со 116 слов до 45. Сжатие весов до 4 бит стоило немного, а без него веса просто не влезли бы в память. В итоге у модели два слоя, около 120 тысяч параметров и память на 64 токена назад.
Умножение без умножения
Нейросеть — это в основном умножения: чтобы написать один токен, HippoGPT перемножает около 119 тысяч пар чисел. Если решать в лоб, Z80 умножает программно, циклом из сдвигов и сложений, и тратит на каждое около 300 тактов. Одни умножения заняли бы 11 секунд на токен или 20 секунд на слово.
Выручила хитрость в духе школьной таблицы умножения. Весов в модели больше ста тысяч, но у каждого всего 15 возможных значений — от −7 до 7. Поэтому каждое входное число достаточно один раз умножить на эти 15 значений и записать ответы в табличку. Дальше умножать не нужно: для каждого веса ответ просто берется из таблички и прибавляется к сумме. На это уходит около 52 тактов.
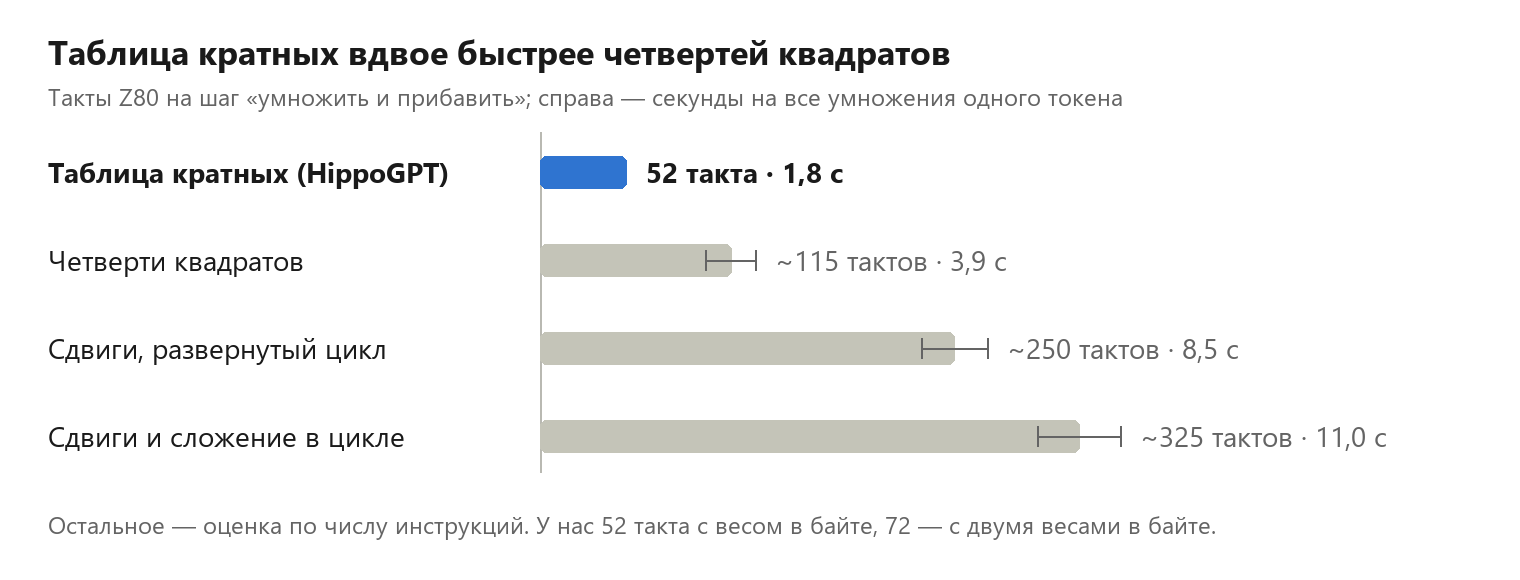
Ближайший конкурент, умножение через таблицу квадратов, вдвое медленнее: ему на каждом шаге нужны два чтения из таблицы и вычитание. Зато квадраты пригодились во внимании, где меняются оба множителя: a·b = (a² + b² − (a − b)²) / 2. Суммы a² и b² по вектору считаются один раз, так что на каждую пару чисел остается одно чтение (a − b)² из таблицы. Экспоненту, корень и выбор следующего слова тоже заменили таблицами: в этой модели Спектрум почти не считает, а в основном подглядывает.
Веса заняли шесть банков памяти по 16 КБ из восьми. Казалось бы, 120 тысяч весов по 4 бита — это всего 60 КБ, но самые нагруженные матрицы пришлось хранить по байту на вес: так их быстрее читать. И первая раскладка все равно не сошлась: в расчетах просто забыл таблицу эмбеддингов на 32 КБ. Спасли полубайты — по два 4-битных веса в каждом байте самых больших таблиц.
Как проверить, что Спектрум не ошибается
Рядом с моделью живет ее точная копия на Python, которая считает в тех же целых числах, с теми же сдвигами и округлениями. Код для Z80 сверяется с ней в симуляторе до бита, и сказка из 200 токенов совпадает до последней буквы.
Две ошибки, найденные случайно
Сначала не срабатывал BREAK: клавиатура опрашивалась между тяжелыми расчетами, и короткое нажатие проваливалось в паузы до четверти секунды. Опрос пришлось встроить прямо в умножение матриц, и теперь самая длинная пауза — 47 миллисекунд. А опечатка «r type loading» вскрыла баг посерьезнее: Спектрум резал введенную фразу на токены не так, как модель видела при обучении, и понимал ее заметно хуже. После исправления фраза «R Tape loading error» больше не продолжается нелепым «errording».
Итоги в цифрах
|
Что |
Значение |
|---|---|
|
Параметры |
~120 тысяч, по 4 бита |
|
Скорость |
~4 секунды на токен |
|
Память |
112 КБ |
|
Машины |
Spectrum 128K, Pentagon |
|
Качество |
выбирает слово из ~77 (1,26 бита на символ) |
Признаюсь, я ожидал чуть-чуть большего. Связную и осмысленную сказку получить вполне можно — но, по моим ощущениям, лишь примерно в одном случае из десяти. В остальных девяти Хиппо бодро начинает, а через пару фраз путает героев, ходит по кругу и теряет нить. Что ж, не очень умный — зато работает.
Цель была полторы-две секунды на токен, вышло вдвое медленнее: текст печатается со скоростью бабушки, набирающей сообщение на телефоне без очков — слово примерно за восемь секунд. Все проверено в эмуляторах. Попробовать HippoGPT можно на ZX Art прямо в браузере — или скачать ленту и диск для своего Спектрума.
Автор: discourage

