


Есть момент, знакомый всем, кто работает с ИИ-агентами дольше недели. Вы открываете проект, ставите задачу, и агент задает вопрос, на который вы уже отвечали. Вчера. Подробно, с примерами.
Вы отвечаете еще раз. Через полчаса он предлагает починить то, что позавчера вы решили не трогать. Предлагает убедительно — он ведь не знает, почему вы так решили. А еще через час контекст переполняется, разговор сжимается в пересказ, и половина обсужденного превращается в пару строк.
Я работаю в команде Lamantin AI, которая делает kaeru — память для ИИ-агентов. Когда мы разбирали логи своих агентов, заметили, что агент иногда переспрашивает то, что сам уже записал. В этой статье покажу, как я работаю с памятью в течение дня: что агент видит на старте, что записывает по ходу и как подхватывает задачу в новой сессии.
Если коротко. kaeru — локальный MCP-сервер, который дает ИИ-агентам (Claude Code, Codex, Cursor, OpenCode и другим) долговременную память между сессиями. Память хранится как граф: наблюдения, решения, задачи, гипотезы с результатом проверки и связи между ними, у каждой записи есть история изменений. Агент может писать в память по ходу работы. При входе в проект он или его клиент запрашивает сводку. Данные остаются на вашей машине, для команды есть общий сервер, который вы поднимаете у себя. Исходники — на GitHub.
Почему не файл с правилами
Первое, что делают все, — заводят файл. CLAUDE.md, AGENTS.md, .cursorrules, заметка в Obsidian — названия разные, суть одна: текст, который агент читает перед работой. Я тоже так начинал, и какое-то время это работает. Проблемы приходят примерно через месяц:
-
Файл пополняется, когда о нем вспомнили. Вы сами или агент по вашей просьбе — обычно через три дня после того, как что-то выяснилось, когда половина подробностей уже вылетела из головы.
-
Файл только растет. Дописывать легко, вычеркивать страшно. Агент одинаково верит правилу, которое вы ввели вчера, и правилу, которое отменили месяц назад и забыли удалить.
-
В файле записано «что», но не «почему». «Парсер не трогать» — а почему? Если причина давно ушла, узнать об этом неоткуда.
-
У каждого свой файл. Если вы работаете не один, каждый агент знает о проекте что-то свое.
Есть и более строгие варианты. ADR (записи об архитектурных решениях) решают проблему «почему», но пишут их о крупных решениях. Трекеры задач для агентов вроде beads хорошо держат план работ, но не то, что выяснилось по дороге.
Все это нужные вещи, и мы их не заменяем. Файл правил и ADR хороши для устойчивых договоренностей, которые проходят ревью и живут в git. Но есть рабочий слой между коммитами: гипотезы, проверки, особенности стендов, то, что агент узнал во время работы и что не дошло ни до задачи, ни до документа. Тащить его в репозиторий — захламлять историю, не записывать — терять. Для этого слоя и сделана память.
Что такое kaeru: память для агентов за одну минуту
kaeru — это сервер, который работает у вас на машине и хранит память агента в виде графа. Агент подключается к нему по MCP — стандартному протоколу, через который Claude Code, Codex, Cursor и другие клиенты вызывают внешние инструменты.
В памяти лежат записи разных видов: наблюдения («файлы заказчика приходят в cp1251»), решения, задачи со сроками, гипотезы вместе с результатом проверки, сохраненные документы. Правило — это запись, помеченная как устойчивое ограничение проекта, напоминание — запись, которая всплывет с определенной даты. Записи связаны, и у каждой связи есть смысл: это решение выросло из того наблюдения, эта запись заменяет ту, эта проверка опровергла ту гипотезу. Цепочку от наблюдения до решения агент сохраняет целиком — это называется сохраненным рассуждением. Записи разложены по проектам: у меня в одном хранилище больше тридцати проектов, и агент работает в рамках того, который открыл.
По ходу работы агент сам выбирает, что записать. Сервер отдает короткую инструкцию при подключении по MCP, а в правилах проекта я напоминаю, когда читать память и что в нее складывать. Например, при записи решения агент может тем же вызовом связать его с наблюдением.
За хранение и сводку отвечает kaeru. Когда запросить сводку и что сделать при сжатии диалога, решает клиент. Для этого используются хуки — скрипты, которые запускает Claude Code или Codex.
Один читатель черновика сформулировал это лучше нас: в репозитории остается то, как должно быть, а в kaeru — то, что «между строк»: как к этому пришли, что пробовали и почему от чего-то отказались.
Дальше — как это выглядит в течение дня. Для примера возьму выдуманный, но узнаваемый проект: сервис, который принимает файлы от заказчика и выгружает их в учетную систему. Скриншоты ниже сняты с демо-хранилища, которое мы наполнили этим проектом, чтобы не показывать рабочие данные.
Утро: агент уже знает, на чем вы остановились
При открытии проекта нужен один вызов context. У меня его делает хук при старте сессии. Он определяет проект по рабочей папке, запрашивает сводку и подкладывает ее агенту еще до первой задачи. Это мой хук, в kaeru он пока не входит, подробнее — в разделе «Как начать».
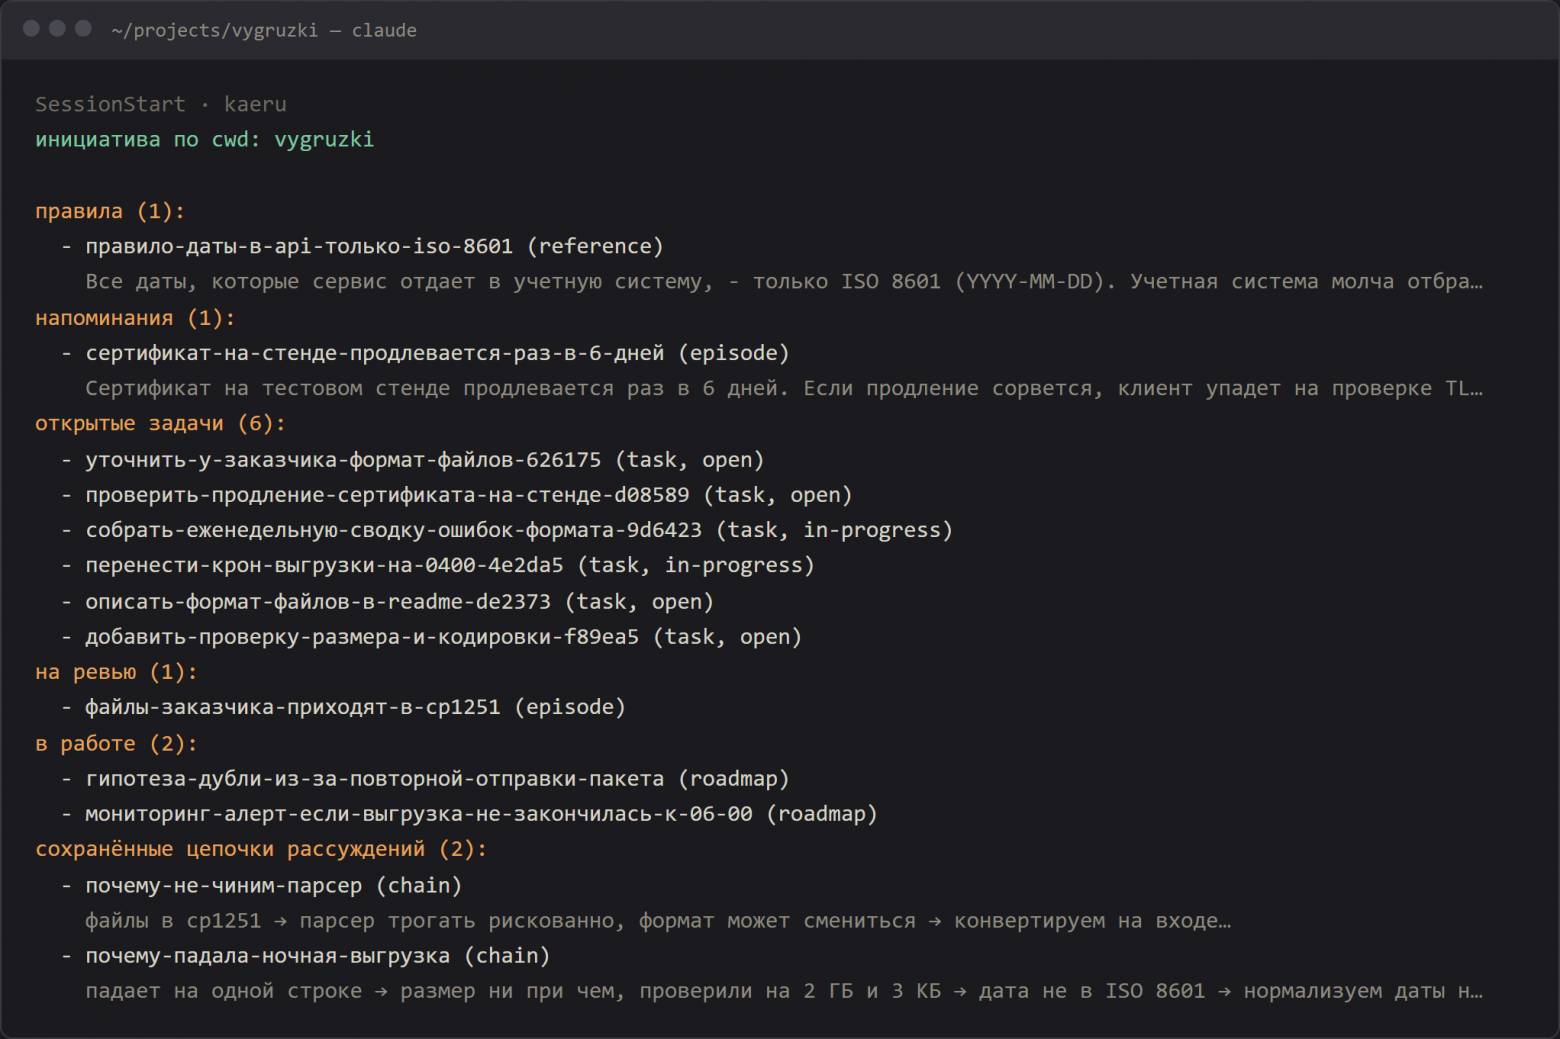
В ней то, с чего и начинается рабочий день: какое правило действует, о чем пора вспомнить, что просрочено, что требует проверки и почему решили так, а не иначе. Объяснять заново не нужно.
Отдельно скажу про верхний блок. Туда попадают устоявшиеся правила проекта. Там можно хранить правила, которые выяснились в работе, и ссылаться на записи, из которых они выросли. У меня, например, с лета живет правило, что интерфейс встроенного в kaeru визуализатора (о нем в конце) пишется только на английском. Я сказал это агенту один раз.
Мы пробовали просто предложить агенту прочитать сохраненные рассуждения. В семи сессиях он видел эту подсказку и ни разу их не открыл. Поэтому я подкладываю короткую сводку сразу, когда открываю проект.
Днем: записи, которые не надо диктовать
В течение дня агент пишет в память сам и сам выбирает, что именно записывает. Наблюдение по текущей работе — записью с внятным именем. Спецификация или договоренность, которую надо сохранить дословно, — документом. Дело на потом — задачей со сроком.
Чаще всего я радуюсь, когда в памяти осталась отвергнутая гипотеза. Допустим, агент подозревает, что ночная выгрузка падает из-за размера файла. Проверяет — нет. Он записывает гипотезу сразу с вердиктом: «опровергнуто, проверено на файле в 2 ГБ». Если через неделю выгрузка снова упадет, следующий агент сможет найти проверку и начать с другой версии. Без памяти отрицательный результат теряется первым: удачные решения попадают в код, неудачные — никуда.
Первый вопрос, который нам задают: не пишет ли агент туда поток сознания? Вот как выглядит обычная запись после такой проверки. Жесткой схемы полей нет, блоки «проверено, причина, решение, уроки» агент оформляет сам:
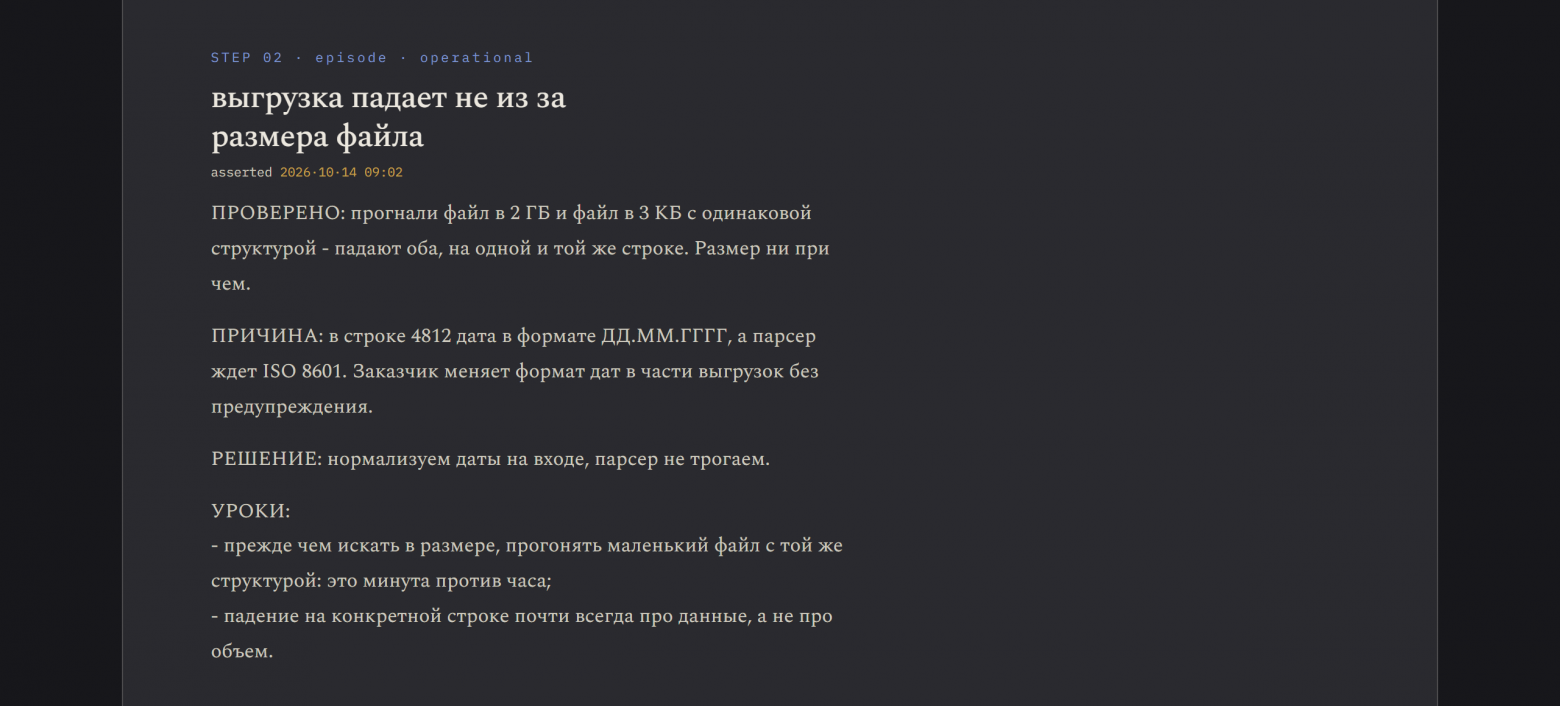
Если формулировка не нравится, агента можно попросить переписать: он поправит саму запись, а прежняя версия останется в истории.
Связи — это и есть «почему»
Записывая что-то новое, агент сразу указывает, из какой записи оно выросло или с чем связано, — это одно поле в том же вызове. Связь у нас не безликое «относится к», у нее есть тип: выросло из, заменяет, опровергает, подтверждает, блокирует, является частью, противоречит.
Когда агент дошел от наблюдения до решения, он отдельным вызовом сохраняет эту цепочку целиком, как рассуждение, с коротким описанием:
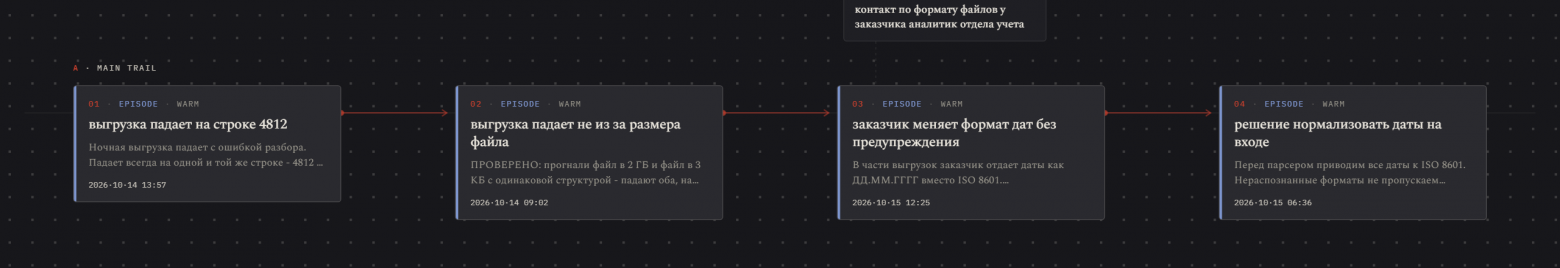
Через месяц на вопрос «почему мы нормализуем даты на входе?» находится не только решение, но и весь путь к нему. А если причина за это время ушла — скажем, заказчик зафиксировал формат в договоре, — видно, что решение пора пересмотреть.
Устаревшее можно явно заменить
Самое неприятное в файле правил — старое и новое лежат рядом на равных правах. В kaeru новая запись может явно заменить старую. Старая не удаляется, но рядом с ней появляется пометка, чем ее заменили.
У меня после вызовов записи срабатывает хук. Он ищет похожие записи и показывает их агенту. Если новая запись уточняет действующую, ее можно отредактировать через revise. Если знание изменилось, replace помечает старую запись как замененную и показывает, какие выводы на нее опирались. Хук предлагает кандидатов, решение принимает агент.
Но заменить старое должен агент. Если он записал новое и не вызвал replace, прежняя запись так и останется действующей рядом с новой. У меня так почти две недели жили два правила с разными ID одних и тех же людей в GitLab: команда переехала на новый сервер, новое правило агент записал, а старое не заменил.
Когда агент собирается вас спросить
В логах бывало, что агент спрашивал о том, что уже записал. Для этого в репозитории kaeru есть отдельный хук для Claude Code и Codex, kaeru-first. Перед тем как передать ход человеку, клиент дает хуку посмотреть на вопрос. Хук учитывает, читал ли агент что-то по теме, и может поискать по словам из вопроса. Если есть совпадения, предлагает один раз прочитать найденные записи перед тем, как спросить.
Совпадение по словам еще не означает, что в записи есть ответ. Если зацепок нет или сервер памяти недоступен, вопрос уйдет человеку.
Долгая сессия: сжатие контекста не съедает работу
Когда контекст переполняется, Claude Code сжимает разговор в пересказ. Все, что в пересказ не попало, пропадает. Если агент что-то выяснил и не успел записать, найденное пропадает вместе с контекстом.
Записи в kaeru остаются после сжатия. Чтобы сохранить и то, что еще не успели записать, в моем окружении срабатывают хуки. В Claude Code перед сжатием хук просит вынести в сводку список уже сохраненных записей и отдельный список того, что еще надо записать. После сжатия второй хук сохраняет сводку в слое Cold, где ее можно найти поиском.
В Codex хук перед сжатием сохраняет локальный снимок конца разговора. Если после сжатия доступна сводка, в память идет она. Если сводки нет, можно сохранить сам снимок. Так остается точка, с которой можно продолжить разбор.
Вечер: задачи и напоминания
Задачи в kaeru — обычные записи со сроком и статусом, и у каждого проекта есть доска:
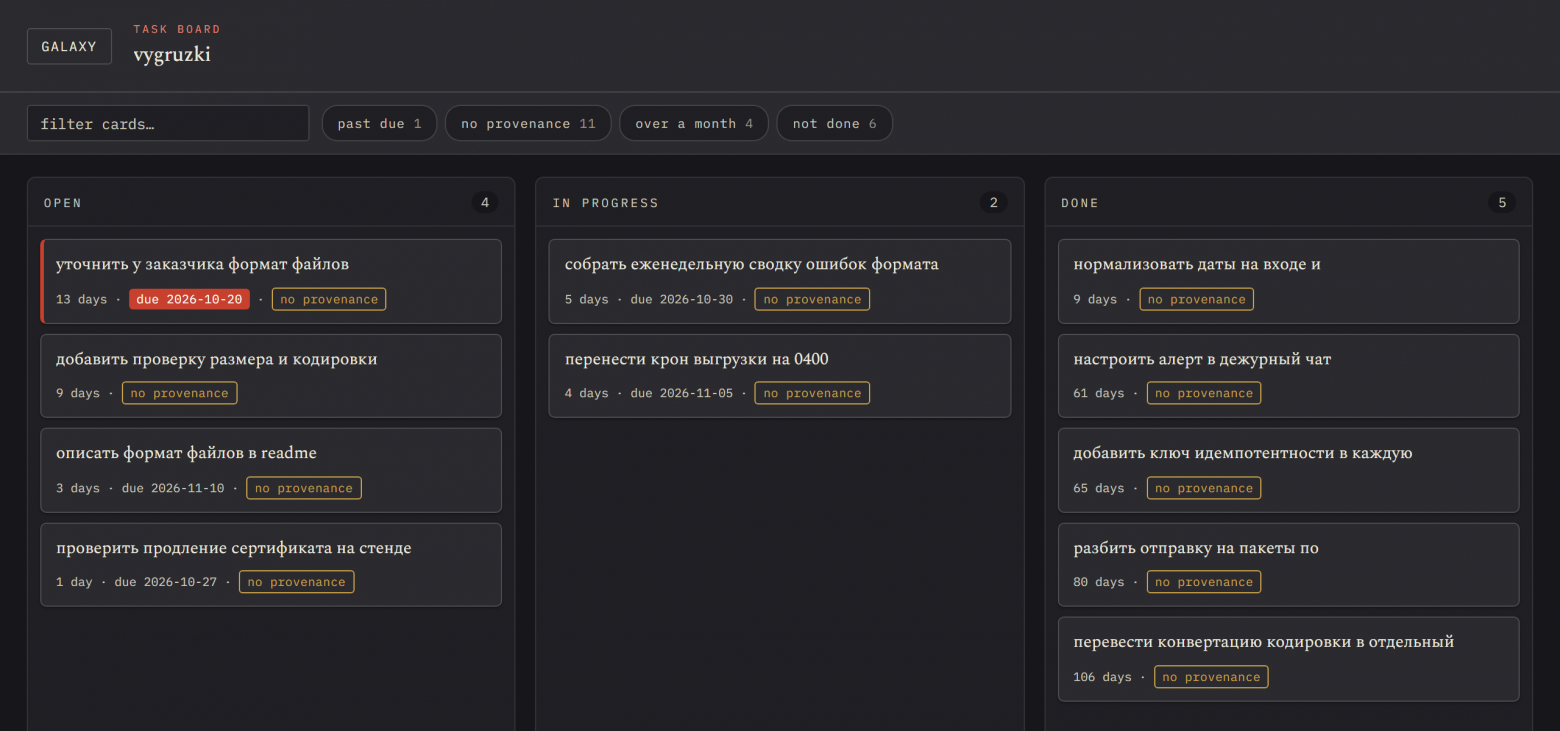
Ничего особенного, кроме одного: просроченная задача всплывает в сводке первой, и агент обращается с ней как с долгом (подробнее про долги агента рассказал тут).
Отдельная история — напоминания. Агент часто узнает то, что станет важно позже. Сертификат на стенде продлевается раз в шесть дней, и если продление сорвется, клиент упадет на проверке TLS — с ошибкой, которая похожа на что угодно, кроме истекшего сертификата. На пятый день это знание бесценно, на первый оно только мешает.
Поэтому в kaeru есть напоминания: агент при записи указывает, с какого числа это важно и сколько дней напоминать. До этой даты запись в сводке не видна. После — появляется в разделе напоминаний, как на скриншоте сводки выше, и висит, пока не кончится срок. Срок отсчитывается от первого показа, а не от даты: если вы на две недели уехали в отпуск, напоминание дождется первой сессии и только тогда начнет отсчет.
Через неделю и через месяц: машина времени и уборка
Можно открыть содержимое записи таким, каким оно было сохранено в kaeru на выбранный момент. У меня это нужно, когда спустя неделю возникает вопрос, откуда взялось странное решение. Смотрю, на какую версию записи тогда могли опираться. Это история того, что было записано, а дата самого события может быть указана отдельно.
Когда записей становится много, сервер сам меняет слои, по которым собирается сводка. Например, старые записи без ссылок может убрать в Cold, а те, к которым часто ведут связи, поднять выше. Содержимое остается на месте, и запись по-прежнему можно найти поиском.
Несколько агентов и команда
На машине работает один сервер kaeru. К нему могут подключаться несколько сессий, в том числе разных агентов. У нас это выглядит так: идеи обсуждаются с Claude и оформляются задачами в памяти, а делает их Codex. Ему достаточно сказать «проверь последние задачи и сделай» — он берет контекст из памяти, сам проверяет результат и закрывает задачу.
Командная история началась с отпуска. Коллега уходил отдыхать, и его работу нужно было продолжить. Мы выгрузили из kaeru архив по проекту, и работа продолжилась почти без швов: агент уже знал весь контекст, погружать пришлось не его, а себя. Коллега вернулся, архив выгрузили обратно. Стало понятно, что это костыль, и мы подняли общий командный сервер с правилами, что и кому можно отдавать.
Еще одна история. Коллега пишет с Claude уроки для онлайн-курса, эксперты их правят, и правила написания постепенно копятся в памяти. Первые уроки приходилось переписывать почти целиком, к восьмому замечаний почти не осталось. Агент не стал умнее — просто правки перестали теряться между сессиями.
Для работы в команде есть kaeru-cloud — отдельный сервер из того же репозитория, который команда поднимает в своей инфраструктуре. В документации его называют облаком, но это не наш сервис, а ваш сервер. По умолчанию все закрыто: каждый проект изначально приватный, и с машины ничего не уходит, пока вы явно не разрешите этому проекту делиться. Даже после этого на общий сервер попадают только записи, которые вы отметили, а перед отправкой kaeru проверяет, нет ли в записи фрагментов, похожих на ключи API, токены и приватные ключи. Облако рассчитано на доверенную команду. Сейчас у него одно общее пространство с разделением по проектам, а изоляция пользователей и организаций еще в планах. Агент обращается к общей памяти отдельно. Обычный локальный поиск ее не обходит.
Можно ли верить тому, что записал агент
Это самый частый и самый справедливый вопрос. Короткий ответ: kaeru не гарантирует, что записанное истинно. Агент может записать ерунду так же, как в файл правил. kaeru — это журнал работы, а источник достоверности — эксперимент. Журнал нужен, чтобы следующий эксперимент начинался не с чистого листа и не с догадок на пустом месте.
Зато ошибочное здесь проще заметить:
-
у каждого вывода видно, из каких наблюдений он вырос;
-
при чтении видно, актуальна ли запись, чем ее заменили и какие противоречия уже записаны в памяти;
-
гипотеза хранится вместе с вердиктом и тем, чем ее проверяли;
-
можно посмотреть, каким было сохраненное содержимое записи;
-
когда агент заменяет ошибочную запись, kaeru показывает выводы, которые на нее опирались и могут требовать пересмотра.
Самый неприятный сценарий — неверная исходная рамка, которую замечают поздно. Агент усердно копает не там, выводы копятся, и когда выясняется, что ошибка была в самом начале, переделывать приходится всю цепочку. Внутри одного длинного контекста модели справляются с такой чисткой плохо. Память устроена иначе: чистка идет не во внимании модели, а в хранилище явными операциями — заменить, опровергнуть, пометить противоречие. Следующая сессия начинается уже с исправленного состояния. Но если ни агент, ни человек ошибку не заметили, память ее не найдет сама — она только делает ее видимой.
Если у вас SDD и все уже в репозитории
Если вы работаете по SDD (spec-driven development, разработка от спецификаций), мигрировать никуда не нужно. Спецификации в репозитории — это то, как должно быть: их пишут осознанно, ревьюят, они версионируются вместе с кодом. kaeru — это то, что происходит между спецификациями, пока агент работает: расследования, опровергнутые гипотезы, причины, по которым спеку поменяли, знание, которое не принадлежит одному репозиторию (стенды, окружения, особенности заказчика), напоминания на будущее.
Спеки остаются в репозитории как есть. В файл правил добавляются две строки о том, что рабочая память живет в kaeru. Если что-то из памяти дозрело до спецификации, это выгружается в markdown и коммитится.
Честно о выгоде: если у вас дисциплинированный SDD и все решения уже проходят ревью, выигрыш будет меньше. Он в основном в том, что между спеками.
Что еще
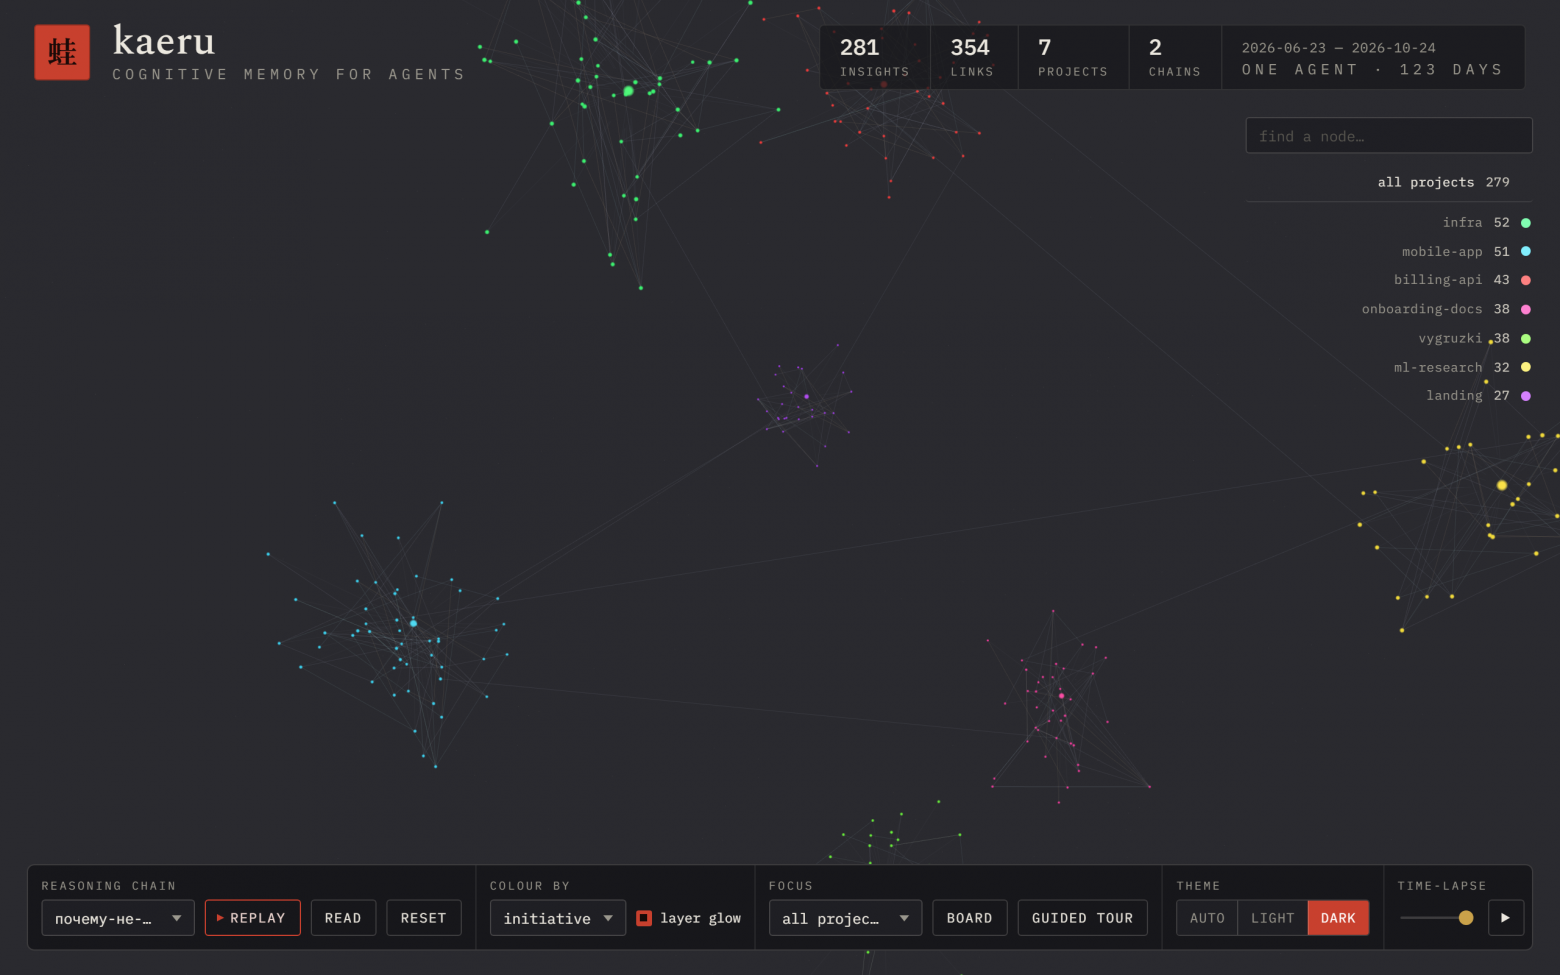
Визуализатор встроен в сам сервер: откройте в браузере http://127.0.0.1:9876/ui/, и хранилище предстанет звездной картой. Каждый проект — созвездие, видны мостики между проектами, сохраненные рассуждения можно проиграть по шагам, а рост знаний — посмотреть в ускоренной перемотке. Там же доска задач и история каждой записи. Вход по паролю включается по желанию.
Данные не заперты внутри kaeru. Любой проект, несколько проектов или все хранилище выгружаются в ZIP с markdown-страницами, которые открывает Obsidian, или в AMG (Agentic Memory Graph) — наш двоичный формат переноса знаний на CBOR (компактный аналог JSON), который сохраняет типы связей, — чтобы перенести их в другое хранилище kaeru.
Для OpenCode — открытого консольного агента — есть скрипт подключения kaeru. Модель и способ ее запуска выбираются в OpenCode. А если вы пишете своего агента на Rust, есть адаптер для LLM-фреймворка rig.
Ограничения
У kaeru 35 тулов. Схемы их аргументов занимают место в контексте. Сколько именно, зависит от клиента и модели. Когда клиент загружает описания по запросу, они не занимают контекст все сразу. Вводная инструкция сервера короче набора схем.
Поиск — вспомогательный и без векторов. Основной путь агента по памяти — граф: сводка, связи записи, сохраненные рассуждения. Полнотекстовый поиск нужен, когда точное имя забыто. Он лексический, без векторов и морфологии; для русских окончаний есть поиск по началу слова — «утечк» найдет и «утечку», и «утечке».
Агент может пропустить память. Поэтому в файле правил проекта я оставляю короткую инструкцию о том, когда получить сводку, когда искать прошлые решения и что записывать по ходу работы.
Итоговый эффект мы пока не измерили. Наши цифры — про поведение агентов: что они читают, что пишут, на какие подсказки реагируют. Сколько времени, денег или токенов память экономит на задачу, мы честно не знаем. Для оценки ответов по накопленной истории можно взять LongMemEval или MemoryAgentBench. Для нашего рабочего сценария первым делом смотрим по логам вызовов, обращается ли агент к памяти, что находит и как это влияет на следующий шаг.
Память нужно иногда проверять. Уборка по слоям идет сама, но содержание записей она не оценивает. Раз в какое-то время стоит открыть визуализатор и посмотреть, что агент считает устоявшимся.
Как начать
curl -fsSL https://raw.githubusercontent.com/LamantinAI/kaeru/main/contrib/install/install.sh | bashУстановщик скачивает релиз и запускает сервер фоновой службой. Готовые сборки есть для Linux x86_64 (glibc 2.34 и новее), macOS на Apple Silicon и Windows x86_64. На Windows скачайте ZIP со страницы релизов, распакуйте его и запустите kaeru-mcp.exe. Сборка macOS не подписана. Для остальных платформ есть инструкция по сборке. По умолчанию сервер слушает loopback-адрес.
Подключение к локальному серверу для Claude Code:
claude mcp add --transport http kaeru http://127.0.0.1:9876/mcpДля Codex:
codex mcp add kaeru --url http://127.0.0.1:9876/mcpЕсли клиент поддерживает только stdio, укажите команду kaeru-mcp --stdio. Для OpenCode в поставляемом примере используется endpoint /sse. Настройки для разных клиентов, включая вариант с авторизацией, есть в инструкции.
И третий шаг, до которого мы сами дошли слишком поздно: добавьте в файл правил проекта (CLAUDE.md, AGENTS.md) пару строк о памяти, например:
Долговременная память проекта — kaeru (MCP). В начале работы получай
сводку через context для текущего проекта. По ходу работы записывай
решения, проверки и задачи в kaeru.
Для начала хватит строки в правилах и одной задачи, к которой вы вернетесь в следующей сессии. Попросите агента записать решение и причину, затем проверьте, нашел ли он их при повторном входе. Хук kaeru-first можно подключить отдельно.
Что вы получите из коробки: сервер, его инструменты и хук kaeru-first. Хуки, о которых я рассказывал выше, — сводка при старте сессии, поиск похожих записей после записи и сохранение перед сжатием контекста — мои, в kaeru они не входят. Без них агент получит сводку, когда сам вызовет context по строке в правилах.
Исходники открыты: github.com/LamantinAI/kaeru. Лицензия BSL 1.1: kaeru можно использовать в работе и встраивать в свои продукты, в том числе платные. Ограничение касается предоставления самого kaeru третьим лицам как хостинга или управляемого сервиса. Подробности и сроки перехода на Apache 2.0 — в описании лицензии.
Вместо заключения
Главное, что я вынес из полугода работы с памятью для агентов: агенту мало дать место, куда записывать. Нужно, чтобы записанное приходило к нему само, в тот момент, когда понадобится, и звучало как дело, которое надо сделать. Графы, слои и машина времени работают только поверх этого.
Следующее, что мы хотим попробовать, — проверка самой памяти. Сейчас ошибку в записи замечает агент или человек. Идея в отдельном проходе между сессиями: он сверяет записи с тем, что реально происходило в работе, и предлагает исправления, которые человек принимает или отклоняет. Anthropic недавно описала похожий механизм и назвала его dreaming.
Спасибо, что дочитали. Если захотелось попробовать, установка выше занимает пару минут. А если kaeru вам пригодится, поставьте звездочку на GitHub: для небольшого проекта это лучший способ сказать, что мы делаем полезное, и помочь другим его найти. А как вы убираете устаревшие правила из своего CLAUDE.md или AGENTS.md? Расскажите в комментариях. Вопросы и баги приносите в чат сообщества.
Автор: ceounittt

