


Компактная рассуждающая модель Qwen3.5-0.8B (752 млн параметров в текстовой части, 18 рекуррентных слоёв GatedDeltaNet и 6 слоёв внимания) умеет решать математические и логические задачи, но в проверенных опытах часто не доводит ответ до конца. Даже получив верный промежуточный результат, она может повторять самопроверки вплоть до предела генерации в 32 768 новых токенов.
В недавней работе MIT CSAIL Sparks of Weight-Space Programming (Takehi et al., 2026) была предложена правка весов без дообучения MIT-p50c, повысившая точность на MATH-500 с 7.9% до 48.1% (в среднем по четырём прогонам vLLM; базовая модель в этом эталоне достигает предела длины в 93.0% генераций). Этот результат получен с температурой T = 0.6 и штрафом присутствия pp = 1.5, который снижает вероятность уже использованных токенов.
Моей целью было снизить зацикливание и добиться завершения рассуждений за счёт изменения весов, без штрафа за повторы. Так была получена открытая весовая поправка SGNE-CC (Spherical Gated Norm-preserving Edit, Column-Constrained, 3.13 МиБ) — направленные повороты выходных столбцов матриц с сохранением их исходной евклидовой нормы.
Я сравнил базовую Qwen3.5-0.8B, MIT-p50c и SGNE-CC на едином движке PyTorch с исходными весами BF16, при лимите генерации 32 768 новых токенов в двух режимах:
-
Жадный режим (T = 0, pp = 0) — выбор наиболее вероятного токена без случайности и без штрафа присутствия.
-
Режим карточки модели (T = 0.6, pp = 1.5) — вероятностный выбор токена с включённым штрафом присутствия. С этими настройками получена приведённая выше оценка MIT на MATH-500.
Проверка проведена в полном объёме по пяти тестовым наборам (MATH-500, MGSM-240, BBH-160, HumanEval-164 и MultiSpeech-64 — 30 прогонов с размышлением, по 1 128 заданий на модель в каждом режиме). При создании SGNE-CC для настройки использовались только 200 задач из MATH-500; остальные 300 задач MATH-500 и все четыре других тестовых набора при подборе весов не затрагивались.
1. Как устроена правка весов: SGNE-CC против MIT-p50c
Правки затрагивают разные слои и по-разному меняют геометрию весовых матриц (нумерация слоёв везде начинается с нуля):
-
MIT-p50c изменяет только две выходные матрицы полносвязных блоков в слоях с индексами 15 и 19 (всего 128 столбцов). Все 18 рекуррентных слоёв GatedDeltaNet, составляющие 75% глубины сети и отвечающие за удержание контекста по шагам, остались нетронутыми. В каждой из двух изменённых матриц MIT-p50c на первую сингулярную моду приходится свыше 99.999% энергии приращения, а нормы отдельных выходных столбцов увеличены на величину до +114.3%.
-
SGNE-CC распределяет поправку по глубине сети: поворачиваются направления 802 выходных столбцов в 15 полносвязных слоях и 1 182 столбцов в 9 рекуррентных слоях GatedDeltaNet, а в слое с индексом 16 дополнительно изменена одна строка ворот затухания (механизма, регулирующего сброс накопленного рекуррентного состояния; всего изменено 2 031 616 скаляров в столбцах и 1 024 в строке ворот — 2 032 640 параметров). Слои внимания не изменяются. Максимальное отклонение нормы любого изменённого столбца после округления в BF16 не превышает 0.1625% (около 0.16%, медианный угол поворота — 8.8°, максимальный — 93.7°), а доля первой сингулярной моды в матрицах слоёв 15 и 19 составляет 67.6% и 73.4%.
В проверенных опытах с SGNE-CC модель заметно реже обрывает рассуждение на лимите, в том числе без штрафа за повторы. Архитектура, токенизатор и код исполнения остаются штатными.
2. Жадный режим (T = 0, pp = 0) и режим карточки на MATH-500
В жадном режиме без штрафа присутствия MIT-p50c достигает предела генерации в 85.1% случаев: 960 обрывов на 1 128 заданиях пяти наборов. У SGNE-CC доля обрывов составляет 18.8% (212 из 1 128), у базы — 98.0%. Средняя длина ответа SGNE-CC в 3.5 раза меньше, чем у MIT-p50c: 8.0 тыс. против 28.5 тыс. токенов; у базы — 32.1 тыс. Результаты отдельных наборов приведены ниже.
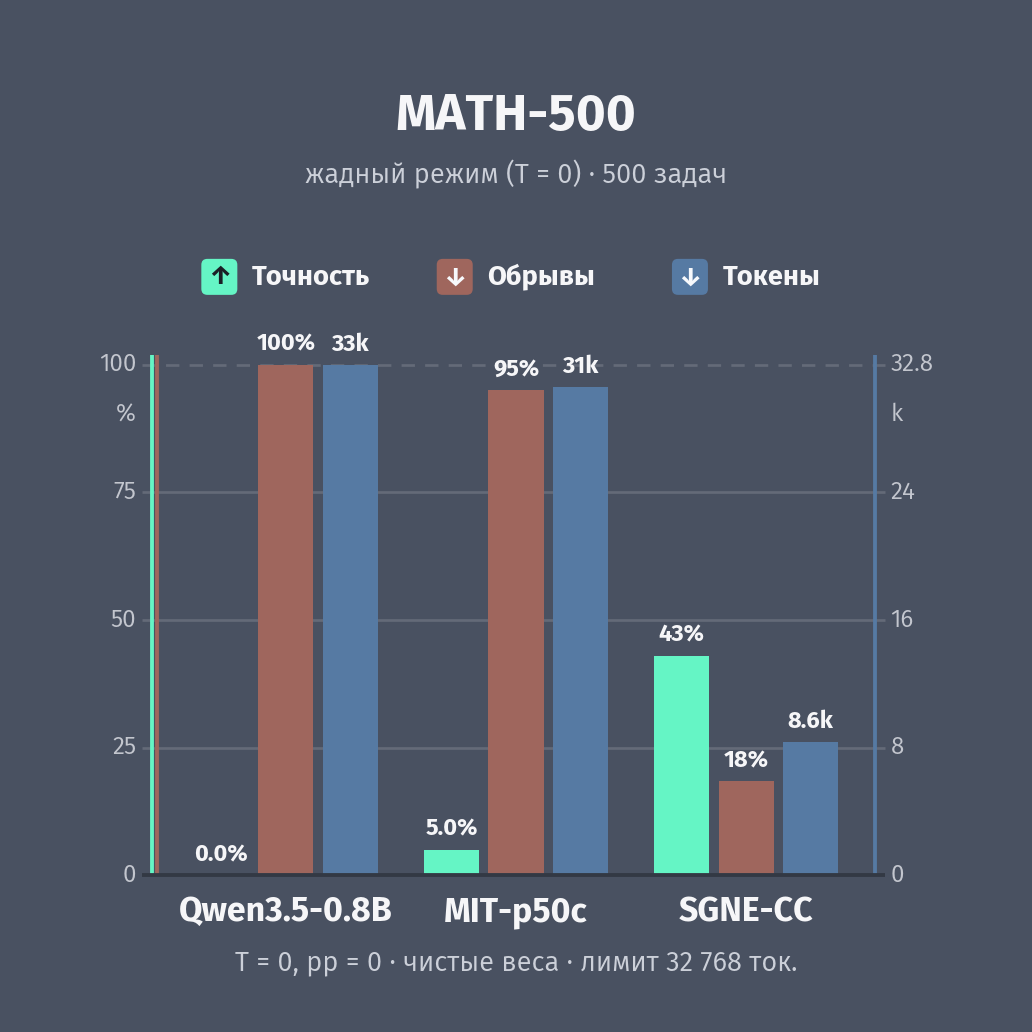
Рис. 1. В жадном режиме (T = 0, pp = 0) SGNE-CC решает 43% задач полного набора MATH-500 против 5% у MIT-p50c (в 8.6 раза больше), расходуя в 3.7 раза меньше токенов. Все 500 задач без штрафа присутствия; единый движок PyTorch, лимит генерации 32 768 токенов. Строгий зачёт требует корректного завершения генерации и верного ответа в итоговой рамке.
На полном наборе MATH-500 (500 задач) в жадном режиме базовая модель при строгом зачёте не завершает ни одной задачи (0%, 100% обрывов на 32k), MIT-p50c решает 25 из 500 (5.0%) при 95.0% обрывов и средней длине 31.4 тыс. токенов, а SGNE-CC решает 215 из 500 (43.0%) при 18.4% обрывов и средней длине 8.6 тыс. токенов (парный критерий МакНемара: +195 побед против 5 потерь, p < 0.0001).
На 300 нетронутых задачах MATH-500, которые не участвовали в подборе весов, отрыв в жадном режиме ещё заметнее: SGNE-CC решает 154 из 300 (51.3%) против 20 из 300 (6.7%) у MIT-p50c и 0 из 300 у базы (p < 0.0001), а на выделенной подвыборке из 49 нетронутых задач — 24 из 49 (49.0%) против 2 из 49 у MIT-p50c и 0 из 49 у базы (p < 0.0001).
В записях генераций встречается такой сценарий: модель получает верный промежуточный результат, но не переходит к итоговому ответу. Например, в задаче о переводе декартовых координат в полярные MIT-p50c в начале рассуждения получает правильную пару координат, после чего сотни раз повторяет один и тот же абзац проверки вплоть до обрыва на 32 768 токенах. SGNE-CC записывает итоговый ответ в рамку и штатно останавливается на 2 394 токенах.
Даже если отказаться от строгого требования завершения генерации и оценивать ответы по правилам из репозитория MIT, перевес сохраняется:
-
по основному правилу MIT (засчитывающему ответ в рамке без проверки закрытия размышления) счёт составляет 215 у SGNE-CC против 32 у MIT-p50c и 14 у базы;
-
по резервному правилу MIT, допускающему извлечение последнего числа из ответа, SGNE-CC всё равно выигрывает более чем вдвое: 221 против 93 у MIT-p50c и 71 у базы.
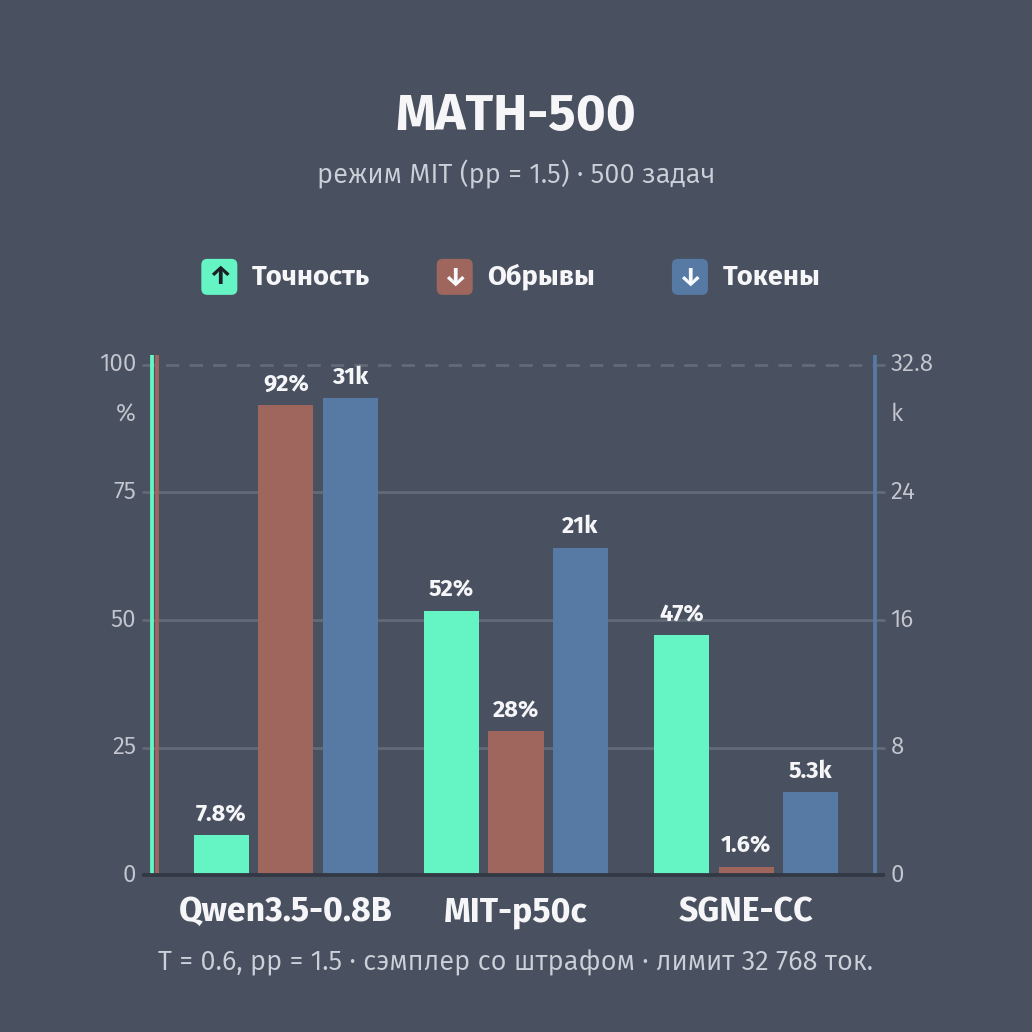
Рис. 2. В режиме карточки модели (T = 0.6, pp = 1.5) MIT-p50c получает более высокую точность в прямом прогоне PyTorch (51.8% против 47.0%), но ответы SGNE-CC вчетверо короче и упираются в лимит в 17.6 раза реже (1.6% против 28.2%). Все 500 задач MATH-500 на едином движке PyTorch.
В режиме карточки модели (T = 0.6, pp = 1.5) соотношение результатов меняется. В прямом прогоне на PyTorch по всем 500 задачам база решает 39 (7.8%), MIT-p50c — 259 (51.8%), а SGNE-CC — 235 (47.0%) (номинальное p = 0.048 в пользу MIT). Относительно первого внешнего запуска самих авторов MIT в vLLM (48.2%, или 241 из 500; среднее четырёх прогонов vLLM — 48.1% при 33.1% обрывов и 22.0 тыс. токенов) статистически значимого различия по точности с SGNE-CC не выявлено (p = 0.67), что не доказывает равенства моделей. При этом ответы SGNE-CC в 4.0 раза короче в прямом прогоне PyTorch (5.3 тыс. против 21.1 тыс. токенов; в 4.1 раза короче среднего vLLM), а обрывы на пределе 32k происходят в 17.6 раза реже (1.6% против 28.2% в PyTorch; в 20.7 раза реже относительно 33.1% в vLLM).
По уровням сложности MATH-500 виден характерный компромисс:
-
На простых задачах (уровни 1–2, 133 задачи) в режиме карточки со штрафом MIT-p50c решает 103 задачи (77.4%) против 92 (69.2%) у SGNE-CC, но в жадном режиме (T = 0, pp = 0) результат SGNE-CC составляет 95 из 133 (71.4%), тогда как MIT-p50c решает 13 из 133 (9.8%).
-
На сложных задачах (уровни 3–5, 367 задач) в режиме карточки точность близка — 143 из 367 (39.0%) у SGNE-CC против 156 из 367 (42.5%) у MIT-p50c (p = 0.24; у базы 17 из 367, или 4.6%), однако MIT-p50c достигает лимита 32 768 токенов в 124 ответах из 367 (33.8%), а SGNE-CC — лишь в 7 ответах (1.9%), то есть в 17.7 раза реже при длине в 3.7 раза меньше (6.3 тыс. против 23.5 тыс. токенов). В жадном режиме (T = 0) на уровнях 3–5 SGNE-CC решает 120 из 367 (32.7%) против 12 из 367 (3.3%) у MIT-p50c.
3. Перенос на многоязычную математику, логику, код и тексты (таблица 5 × 2)
Обе правки настраивались только на англоязычных математических задачах. Ниже — результаты на четырёх других наборах, которые не участвовали в подборе весов.
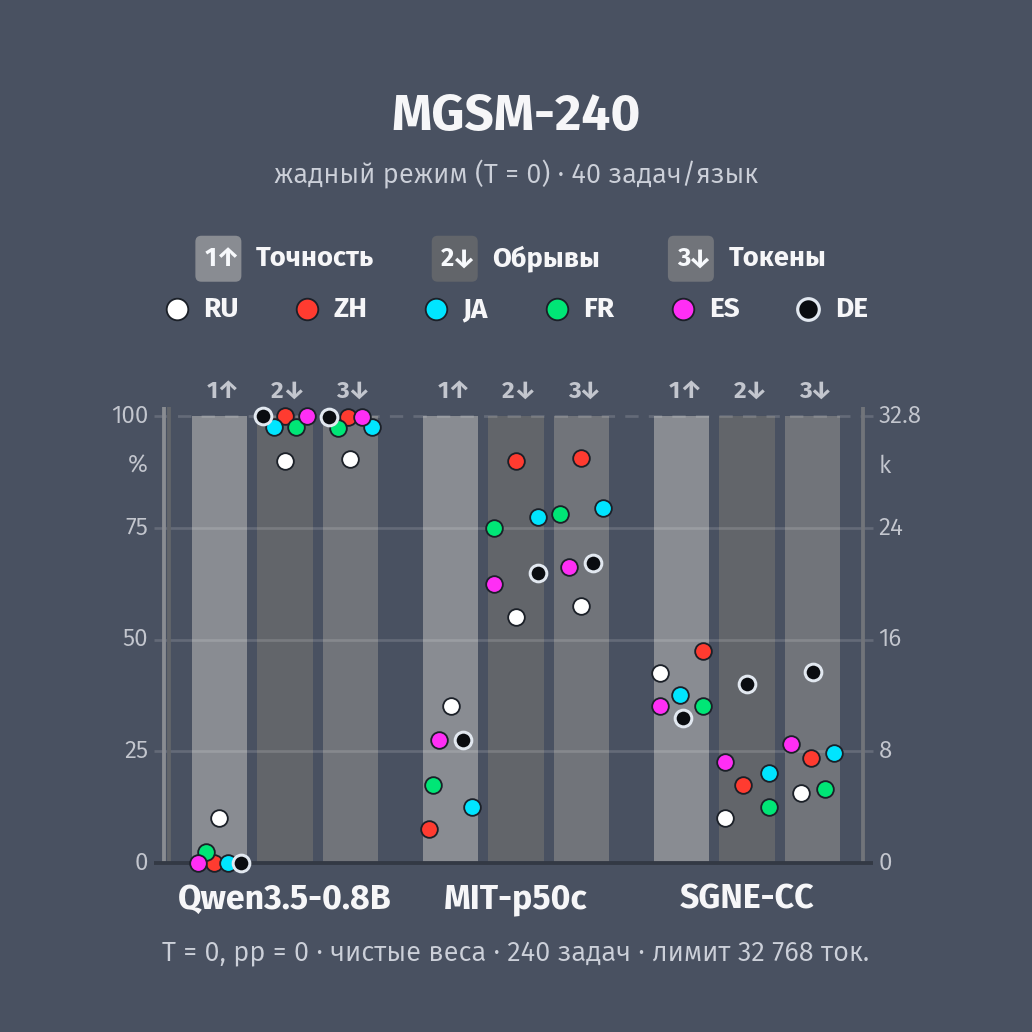
Рис. 3. В жадном режиме (T = 0, pp = 0) на многоязычных текстовых задачах MGSM-240 SGNE-CC опережает MIT-p50c на всех шести языках (38.3% против 21.3% в сумме). По 40 задач на русском, китайском, японском, французском, испанском и немецком языках.
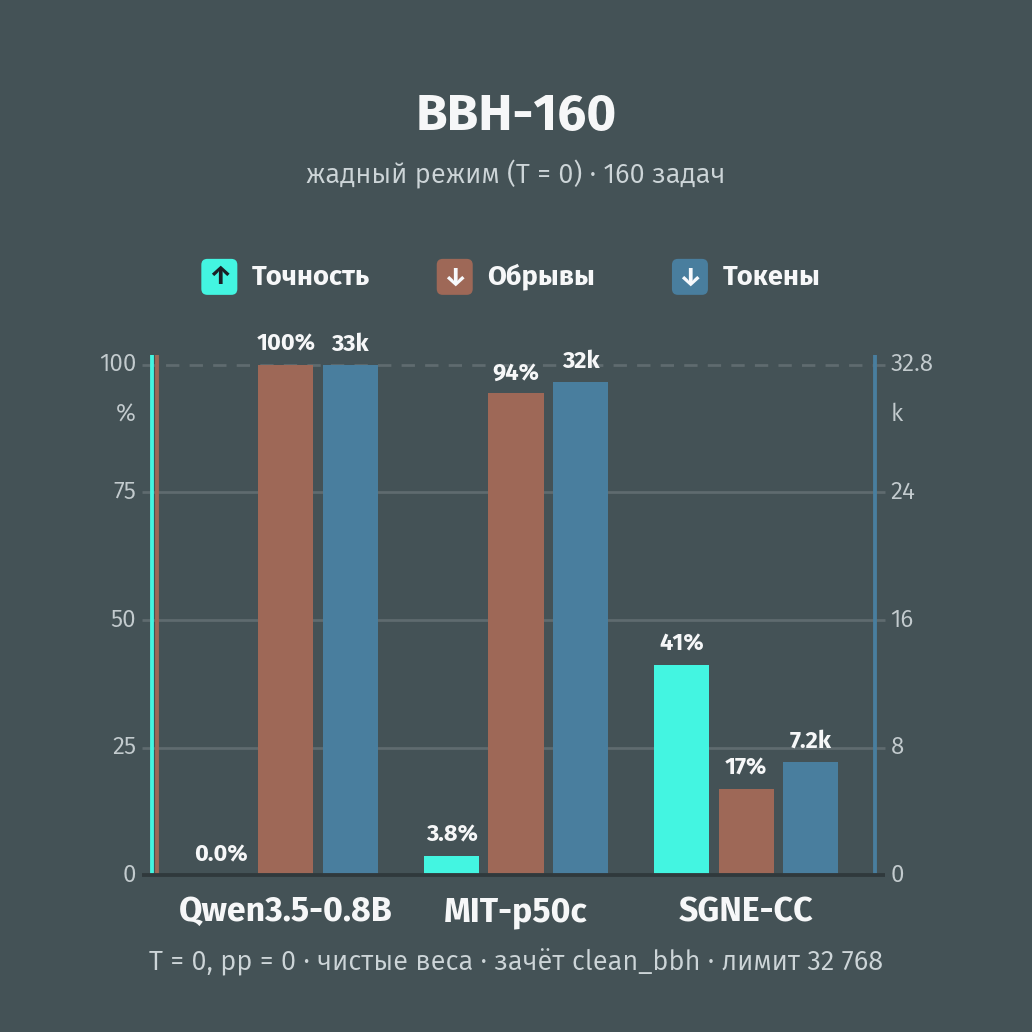
Рис. 4. На символической логике BBH-160 SGNE-CC получает 41.3% в обоих прогонах. У MIT-p50c результат составляет 3.8% в жадном режиме и 50.6% в режиме карточки. Восемь логических подтестов BIG-Bench Hard по 20 задач.
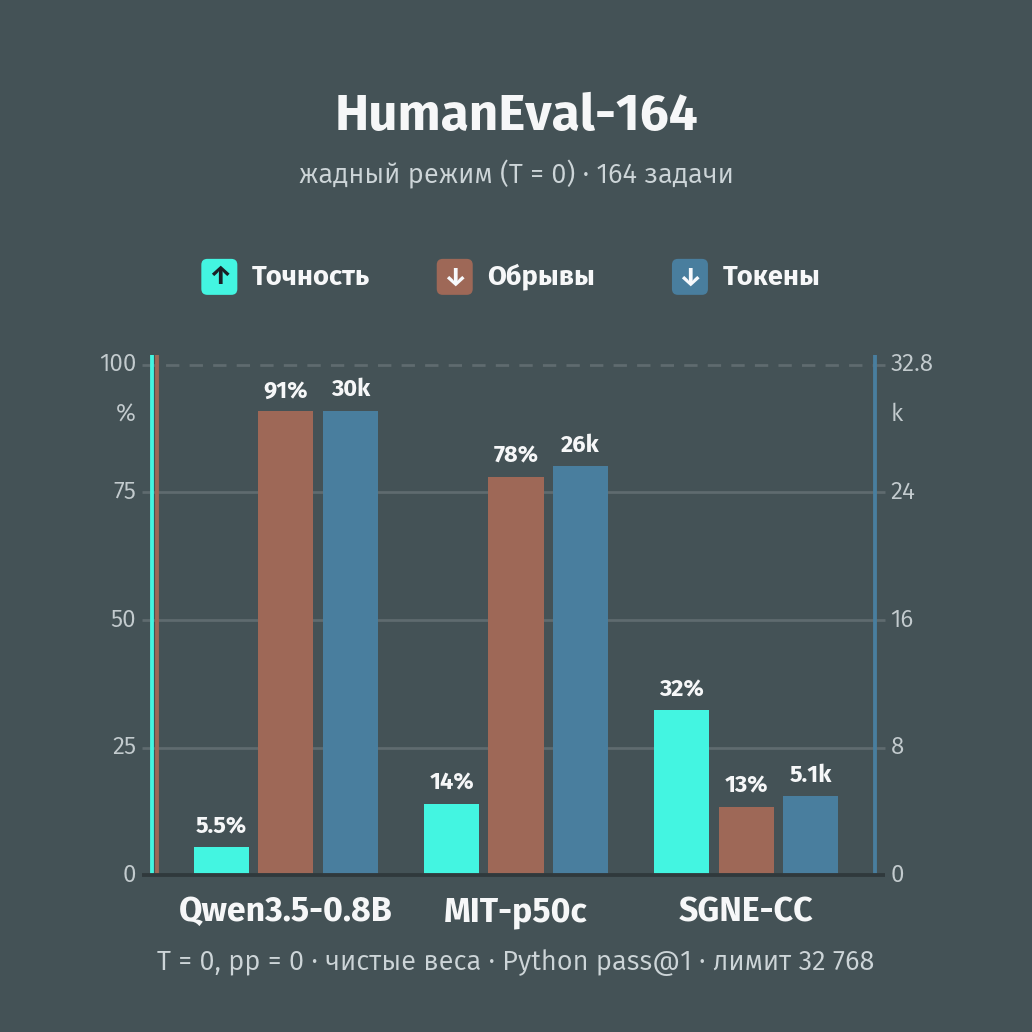
Рис. 5. На генерации кода Python (HumanEval-164) в жадном режиме (T = 0) SGNE-CC показывает лучший результат всей серии — 32.3% (53 из 164), сокращая общую длину ответа в 5.2 раза (5.1 тыс. против 26.3 тыс. токенов), а само размышление — в 12.5 раза. Зачёт по модульным тестам при T = 0, pp = 0.
Ниже сведены результаты трёх моделей в 10 сочетаниях тестового набора и режима генерации (5 наборов × 2 режима), с лимитом 32 768 токенов:
|
Тестовый набор (лимит 32 768 токенов) |
Режим декодирования |
Qwen3.5-0.8B |
MIT-p50c |
SGNE-CC |
Длина, обрывы 32k и значимость (SGNE к MIT) |
|---|---|---|---|---|---|
|
MATH-500 (500 задач) |
Жадный (T = 0, pp = 0) |
0/500 (0.0%) |
25/500 (5.0%) |
215/500 (43.0%) |
В 3.7 раза короче (8.6 против 31.4 тыс.), обрывы 18.4% против 95.0%, p < 0.0001 |
|
MATH-500 (500 задач) |
Карточка (T = 0.6, pp = 1.5) |
39/500 (7.8%) |
259/500 (51.8%) |
235/500 (47.0%) |
В 4.0 раза короче (5.3 против 21.1 тыс.), обрывы 1.6% против 28.2%, p = 0.048 (в пользу MIT; к vLLM 48.2% p = 0.67) |
|
MGSM-240 (6 языков) |
Жадный (T = 0, pp = 0) |
5/240 (2.1%) |
51/240 (21.3%) |
92/240 (38.3%) |
В 2.9 раза короче (8.2 против 24.0 тыс.), обрывы 20.4% против 70.8%, p < 0.0001 (40 блоков) |
|
MGSM-240 (6 языков) |
Карточка (T = 0.6, pp = 1.5) |
62/240 (25.8%) |
137/240 (57.1%) |
100/240 (41.7%) |
В 2.8 раза короче (3.1 против 8.6 тыс.), обрывы 2.1% против 3.8%, p < 0.0001 (40 блоков, в пользу MIT) |
|
BBH-160 (логика) |
Жадный (T = 0, pp = 0) |
0/160 (0.0%) |
6/160 (3.8%) |
66/160 (41.3%) |
В 4.4 раза короче (7.2 против 31.7 тыс.), обрывы 16.9% против 94.4%, p < 0.0001 |
|
BBH-160 (логика) |
Карточка (T = 0.6, pp = 1.5) |
3/160 (1.9%) |
81/160 (50.6%) |
66/160 (41.3%) |
В 6.9 раза короче (2.4 против 16.9 тыс.), обрывы 0.6% (1) против 14.4% (23), p = 0.058 |
|
HumanEval-164 (код Python) |
Жадный (T = 0, pp = 0) |
9/164 (5.5%) |
23/164 (14.0%) |
53/164 (32.3%) |
Ответ в 5.2 раза короче (5.1 против 26.3 тыс.; размышление в 12.5 раза короче: 1.8 против 22.1 тыс.), обрывы 13.4% против 78.0%, p < 0.0001 |
|
HumanEval-164 (код Python) |
Карточка (T = 0.6, pp = 1.5) |
26/164 (15.9%) |
51/164 (31.1%) |
46/164 (28.0%) |
Ответ в 8.3 раза короче (1.1 против 8.8 тыс.; размышление в 14.1 раза короче: 449 против 6 334 ток.), обрывы 0.0% против 13.4%, p = 0.47 |
|
MultiSpeech-64 (8 яз., автофильтр) |
Жадный (T = 0, pp = 0) |
2/64 (3.1%) |
17/64 (26.6%) |
23/64 (35.9%) |
Незакрытое размышление: 5 против 22, медиана длины 2 235 против 32 768 ток. (средняя 13.0 против 20.2 тыс.), p = 0.21 |
|
MultiSpeech-64 (8 яз., автофильтр) |
Карточка (T = 0.6, pp = 1.5) |
43/64 (67.2%) |
58/64 (90.6%) |
57/64 (89.1%) |
Медиана длины 1 861 против 2 311 ток. (средняя 2.9 против 2.5 тыс.), обрывы 3.1% против 0.0%, p = 1.00 |
Сопоставление всей матрицы 5 на 2 показывает чёткое разделение режимов:
-
На многоязычной арифметике MGSM-240 в режиме карточки более короткая генерация SGNE-CC (3.1 тыс. против 8.6 тыс. токенов) сопровождается уступкой по точности относительно MIT-p50c: 100 против 137 решённых задач; различие значимо с учётом объединения переводов в 40 шестиязычных блоков. В жадном режиме результат MIT-p50c составляет 21.3% вместо 57.1%. SGNE-CC получает 38.3% в сумме и опережает MIT-p50c на каждом из шести языков. На китайском MIT-p50c решает 7.5% задач против 57.5% в режиме карточки, при 90.0% обрывов.
-
В символической логике BBH-160 SGNE-CC решает 66 из 160 задач (41.3%) в каждом из двух прогонов. У MIT-p50c результат составляет 50.6% в режиме карточки и 3.8% в жадном режиме. На подтесте булевой дедукции Web of Lies (20 задач) SGNE-CC решает 7 из 20 (35.0%) против 0 из 20 у MIT-p50c и базы при T = 0, а в режиме карточки — 9 из 20 (45.0%) против 7 из 20 (35.0%) у MIT-p50c и 0 из 20 у базы при 0.0% обрывов.
-
В генерации кода Python (HumanEval-164) SGNE-CC получает 32.3% (53 из 164) в жадном режиме и 28.0% в режиме карточки. Первый результат — лучший среди трёх моделей в обоих режимах; размышление при этом в 12.5 раза короче, чем у MIT-p50c при T = 0 (1.8 тыс. против 22.1 тыс. токенов).
-
В текстовой генерации на 8 языках (MultiSpeech-64) автоматический фильтр проверяет только структурное завершение ответа и пороги повторов (не оценивая фактическую достоверность содержания). При T = 0 SGNE-CC вчетверо реже оставляет незакрытым блок размышления (5 случаев против 22 у MIT-p50c), хотя в режиме карточки у обеих правок встречаются единичные иероглифические вставки, а на немецком языке у SGNE-CC сохраняются повторы в 4 из 8 заданий.
4. Ограничения и как проверить у себя
Сохранение норм столбцов проверено непосредственно на весах. Но какая часть улучшения связана именно с ним, а какая — с выбором слоёв и другими изменениями, ещё предстоит установить. На каждую задачу в каждом режиме опубликован один прогон. Разбиение MATH-500 на 200 калибровочных и 300 нетронутых задач открыто; их разделение до анализа результатов опирается на протокол автора. Значения p приведены без поправки на множественные сравнения.
Процедура поиска углов поворота не публикуется. Файл весовой поправки (sgne_cc_dna_delta.npz, 3.13 МиБ), готовые веса BF16, разбиение задач, все 38 файлов с записями генераций и программы проверки открыты:
python3 apply_dna_patch.py --verify-only
python3 scripts/verify_paper_metrics.py
Примечание: работа выполнена И. М. Жуком в сотрудничестве с ИИ — как в самом исследовании, так и в подготовке кода, графиков и текста. Полную ответственность за выводы несёт автор. Данные и расчёты доступны в открытом репозитории.
Статья, записи генераций и проверки (GitHub) · Архив DOI (Zenodo) · Веса BF16 и поправка SGNE-CC (Hugging Face)
Код, весовая поправка и текст автора открыты под лицензией Apache-2.0; сторонние данные, код и журналы сохраняют исходные лицензии.
Автор: igorzhuk

Советуем прочесть:
 Headroom на 80 запусках агента: что получилось с расходом токенов 21.09.2026 Недавно увидел ещё один репозиторий с обещанием резко сократить расход…
 Вдвое меньше токенов без смены модели: что NVIDIA сделала с harness кодинг-агента 01.10.2026 Исследователи из NVIDIA, MIT и NTU поручили одному ИИ-агенту улучшать…
 Как настроить мониторинг для 500+ узлов: опыт Percona 18.11.2026 Представьте: вы следите за сотней серверных узлов. А если их…
 Я обучил собственную визуально‑языковую модель меньше чем на 1 млрд параметров 15.09.2026 Каково это сегодня — с нуля собрать и обучить собственную визуально‑языковую модель? Именно…
- Сериал «Чёрное зеркало» всё меньше похож на фантастику: странные случаи с ChatGPT и что за ними стоит 31.08.2026 Пользователи слышат из ChatGPT собственный голос, внезапные крики и плач.…
 dots, GPT-6.1 Sol и тариф $500: всё, что OpenAI показала на DevDay 2026 30.09.2026 TL;DR. 29 сентября на DevDay в Сан-Франциско OpenAI за час…
 Успеть за 15 минут ̶и̶ ̶н̶е̶ ̶п̶о̶д̶р̶а̶т̶ь̶с̶я̶ ̶в̶ ̶р̶е̶г̶и̶с̶т̶р̶а̶т̶у̶р̶е̶. Как устроен цифровой… 17.09.2026 По нормам Минздрава, на прием терапевта отведено 15 минут. За…
 NER для юристов, у которых нет A100: как мы догнали Ministral 14B моделью почти в 10 раз меньше 03.11.2026 Юристы не могут отправлять материалы дел во внешние API, а…
 Учебный проект MIT превратился в одобренное устройство для уменьшения тремора 15.10.2026 В 2017 году мужчина по имени Майкл вышел на сцену перед заполненным залом…
 Аудит MIT-p50c для Qwen3.5-0.8B и редактирование весов с сохранением норм (SGNE-CC) при лимите 32 768 токенов 15.11.2026 Qwen3.5-0.8B — модель с 752 млн параметров, 18 рекуррентными слоями…
