


Представьте: вы следите за сотней серверных узлов. А если их 500? С ними придется скроллить дашборд до старости, не иначе.
Меня зовут Антон Быстров, я ведущий DevOps-инженер Cloud.ru. В 2022 году мы с моей коллегой Сашей написали о том, как команда Percona пересобрала главную панель мониторинга PMM для сотен узлов. Зелье молодости или маховик времени еще не изобрели, так что от бесконечной прокрутки пришлось спасаться иначе.
Спустя четыре года я искал информацию по мониторингу и случайно наткнулся на нашу же статью. Перечитал и решил перевести ее на русский, а заодно добавить комментарии. Вопрос по-прежнему актуален: как сделать дашборд, который помогает быстро понять, что происходит, и которым будут пользоваться после первого релиза? В статье — перевод, а также немного свежих мыслей по теме.
Авторы оригинала: Антон Быстров и Александра Абрамова (@insel11). Оригинальная статья — Percona Community, 2022 год.
Почему нельзя просто так взять и сделать новый дашборд
Он бы вряд ли сработал. А если и сработал, то не решил бы ключевой запрос пользователя.
Дашборды Percona Monitoring and Management (PMM) построены на платформе Grafana. Сама по себе она неплохая, с ней легко отследить загрузку ЦП, память, место на дисках, состояние сети. В общем, есть стартовый набор по выявлению проблем.
Но с годами узлов в сети становилось все больше, а вот производительности у дашборда — меньше. На масштабе в сотни машин главная страница начала тормозить, а пользователю требовалось слишком много времени, чтобы разобраться в происходящем.
Сменить один дашборд на другой не вариант: рано или поздно возникли бы старые проблемы с производительностью. Но даже не будь их, вряд ли пользователям пригодился бы такой объем данных при беглой оценке инфраструктуры.
Так что перед стартом работ команда Percona решила найти ответы на три вопроса:
Что именно происходит?
Где возникает проблема с производительностью?
Как ее исправить?
А еще задумалась о первом действии пользователя в системе — об этом расскажем чуть позже.
Для проверки прошлой версии дашборда собрали тестовую инсталляцию PMM с 200 узлами и измерили время ответа.
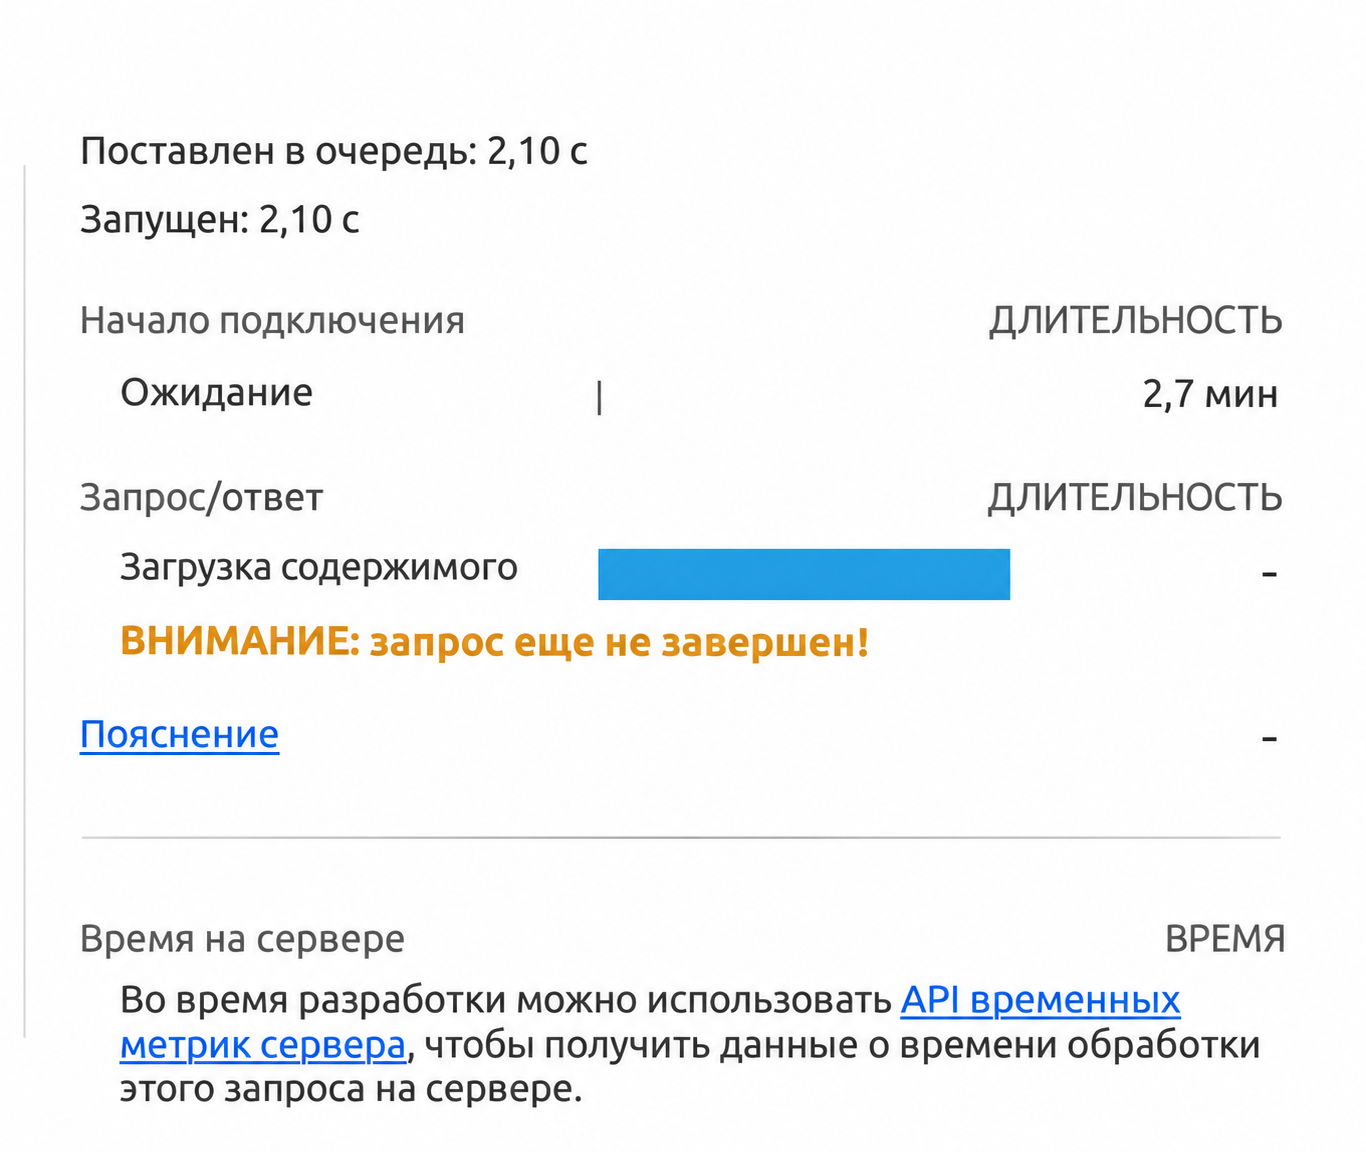
Загрузка заняла почти три минуты — страшно предположить, сколько времени уходило на сам мониторинг.
Далее команда посмотрела, какие запросы занимают больше всего времени. Барабанная дробь…
Оказалось, это запросы к хранилищу VictoriaMetrics. При прокрутке добавлялась ленивая загрузка панелей, а браузер работал все медленнее. Главная страница запрашивала слишком много метрик, получала слишком много ответов и пыталась все это показать.
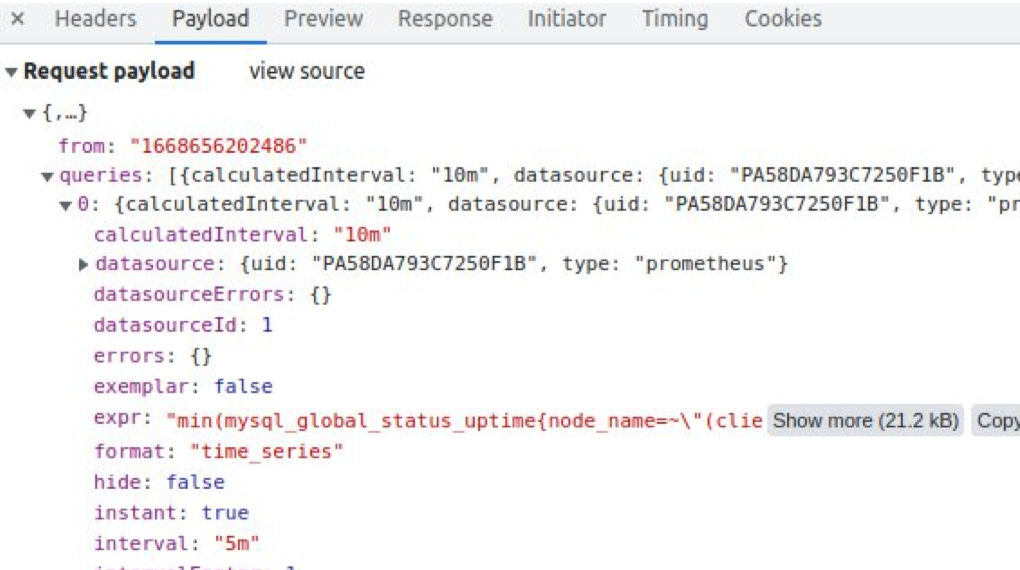
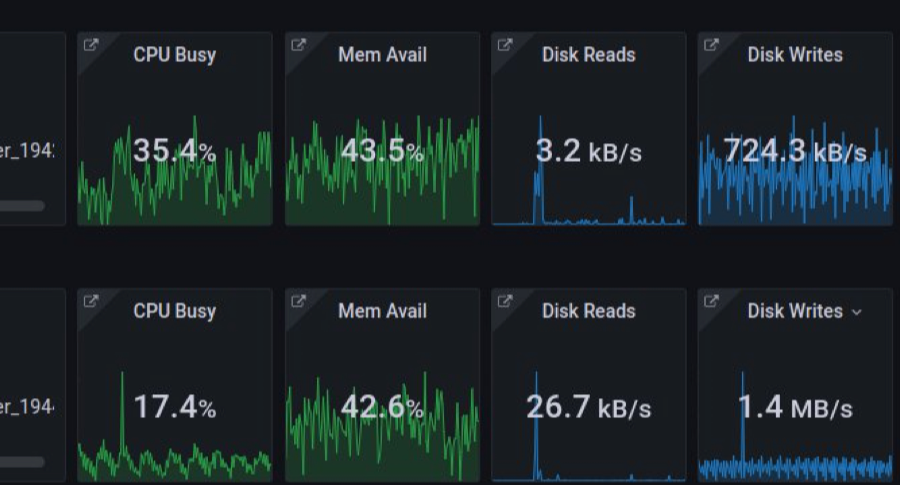
Ну хотя бы понятно, как быть. Очевидно, старая платформа не тянет такой объем данных, запросов и реквестов. Пора создавать новый главный дашборд.
Сначала кофе — потом все остальное
А вот и то самое первое действие пользователя. По мнению команды, человек открывает метрики с простым вопросом: «Успею допить кофе или надо срочно что-то чинить?» Ему нужен простой, но исчерпывающий ответ. Тут следует опираться на четыре золотых показателя из книг Тима О’Райли по SRE.
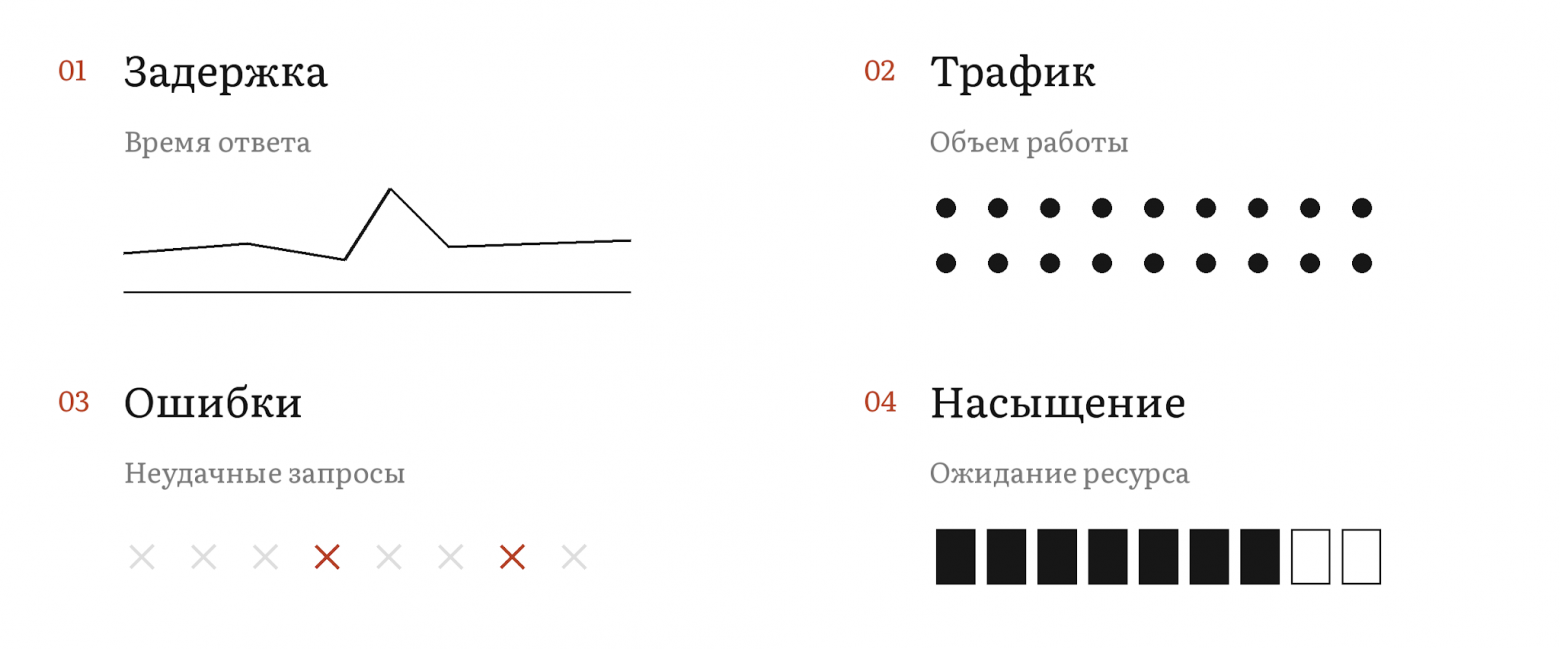
Задержка — сколько времени занимает запрос
При оценке этого показателя важно четко разграничивать успешные запросы и запросы, которые завершились ошибкой.
Например, если соединение с базой данных потеряно, сервер может быстро вернуть HTTP 500: запрос завершился, но пользователь не получил ответ. Если таких быстрых ошибок станет много, среднее время ответа может снизиться. Из-за этого будет казаться, что система стала работать быстрее, хотя на деле она чаще возвращает ошибки.
При этом задержку ответов с ошибками тоже важно отслеживать: если запрос долго выполняется и в итоге завершается ошибкой, пользователь еще и теряет время на ожидание.
Трафик — какая нагрузка поступает в систему
Способ измерения зависит от того, что делает эта самая система.
Для веб-сервиса можно считать HTTP-запросы в секунду: например, запросы на открытие страницы или получение списка заказов. Для сервиса потокового аудио — объем данных, который он принимает и передает по сети за секунду.
Для хранилища «ключ — значение» (key-value) нагрузку можно оценивать по числу транзакций и операций чтения в секунду: как часто приложения обращаются к нему, чтобы записать или получить данные.
Ошибки — как часто запросы завершаются неуспешно
Ошибки бывают явными и неявными. Например, ответ HTTP 500 — явная ошибка: сервер сообщает, что не смог выполнить запрос. Такие ответы можно отслеживать на балансировщике нагрузки, который распределяет запросы между серверами.
А ответ HTTP 200 с неверным содержимым — неявная ошибка. Сервер сообщает об успехе, но пользователь получает неправильный результат: например, вместо своих заказов видит чужие.
Способы обнаружения этих ошибок отличаются. Для явной ошибки достаточно проверить код ответа. Для неявной нужно проверить еще и содержимое: соответствует ли результат тому, что запросил пользователь. Для этого используют сквозные тесты, которые воспроизводят действия пользователя и проверяют результат.
Насыщение — насколько система близка к перегрузке
В первую очередь нужно отслеживать ресурс, который ограничивает работу. Если системе не хватает памяти — показатели памяти, если возможности ограничены вводом-выводом — показатели ввода-вывода.
Многие системы начинают работать медленнее еще до того, как загрузка достигает 100%. Поэтому важно заранее определить допустимый уровень их использования.
Вместе четыре золотых сигнала дают базовую картину: сколько работы получает система, как долго выполняет запросы, как часто ошибается и хватает ли ей ресурсов. Если показатели указывают на проблему или приближение к пределу ресурсов, инженер должен увидеть предупреждение на дашборде.
При выборе метрик мы также рассмотрели подходы RED и USE. RED сосредоточен на запросах: сколько их поступает, сколько завершается ошибкой и сколько времени занимает обработка. USE предлагает проверять каждый ресурс: насколько он занят, скапливается ли очередь на его использование и возникают ли ошибки.
Как прошла работа над первым прототипом
Техлид Дани Гусман Бургос подготовил Proof of Concept, или PoC, для проверки гипотез команды. Основная задача осталась прежней: пользователь должен быстро понять, все ли в порядке. Поэтому на дашборде появились простые цветовые индикаторы — зеленые и красные.
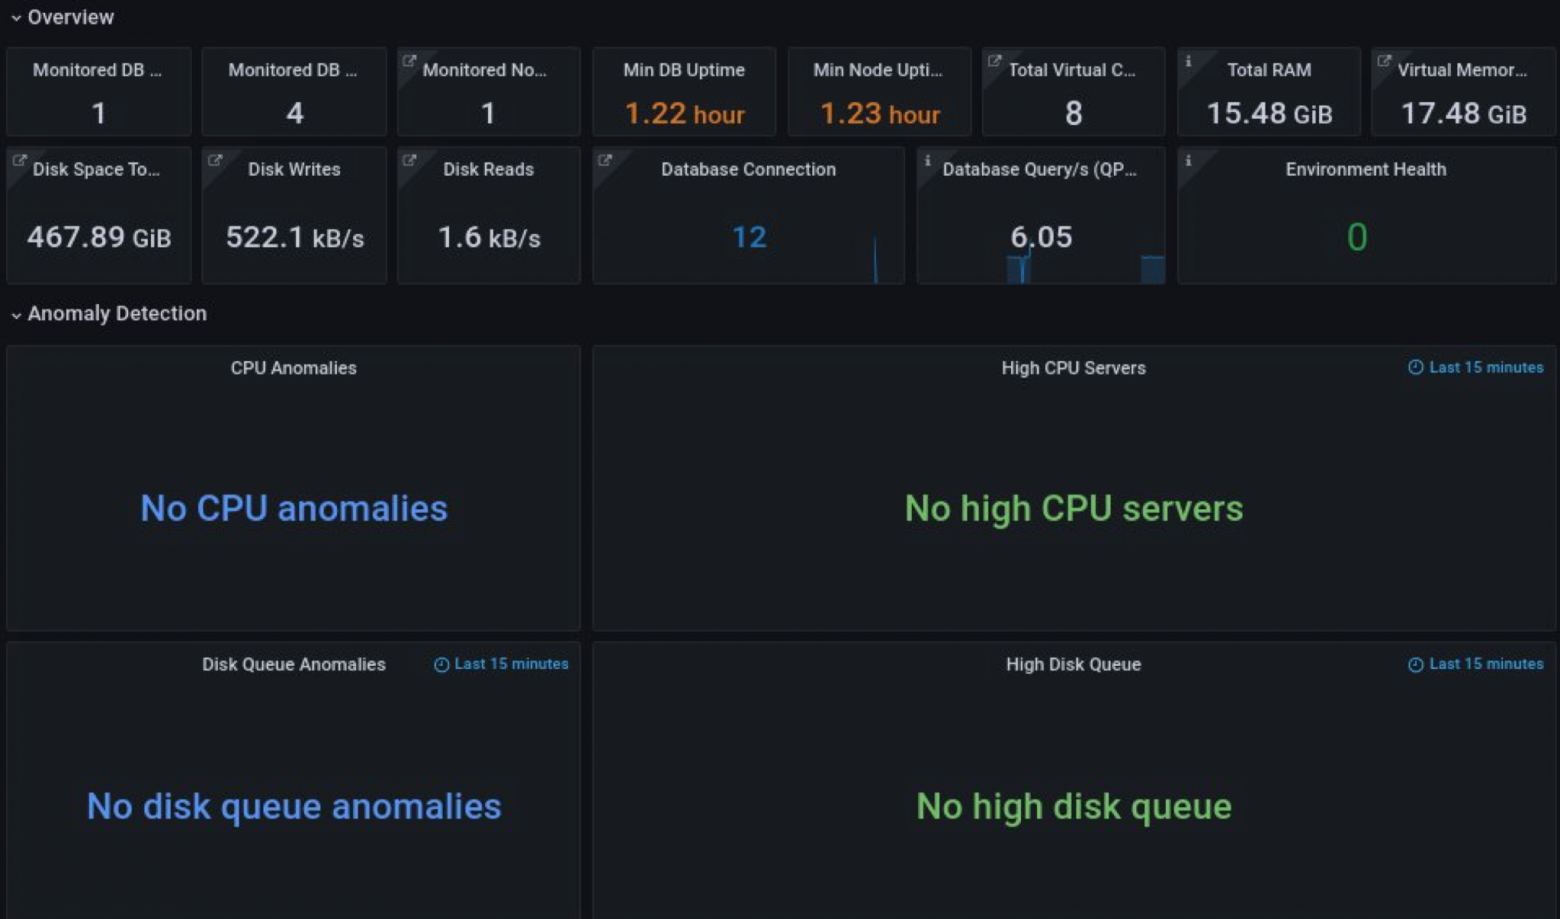
В общей сводке видны число узлов, дисковые операции, время непрерывной работы баз данных и узлов, а также результаты диагностики баз данных и инфраструктуры. Отдельного внимания заслуживает панель «Состояние окружения» — уж она точно помогала понять, когда можно пойти за кофе.
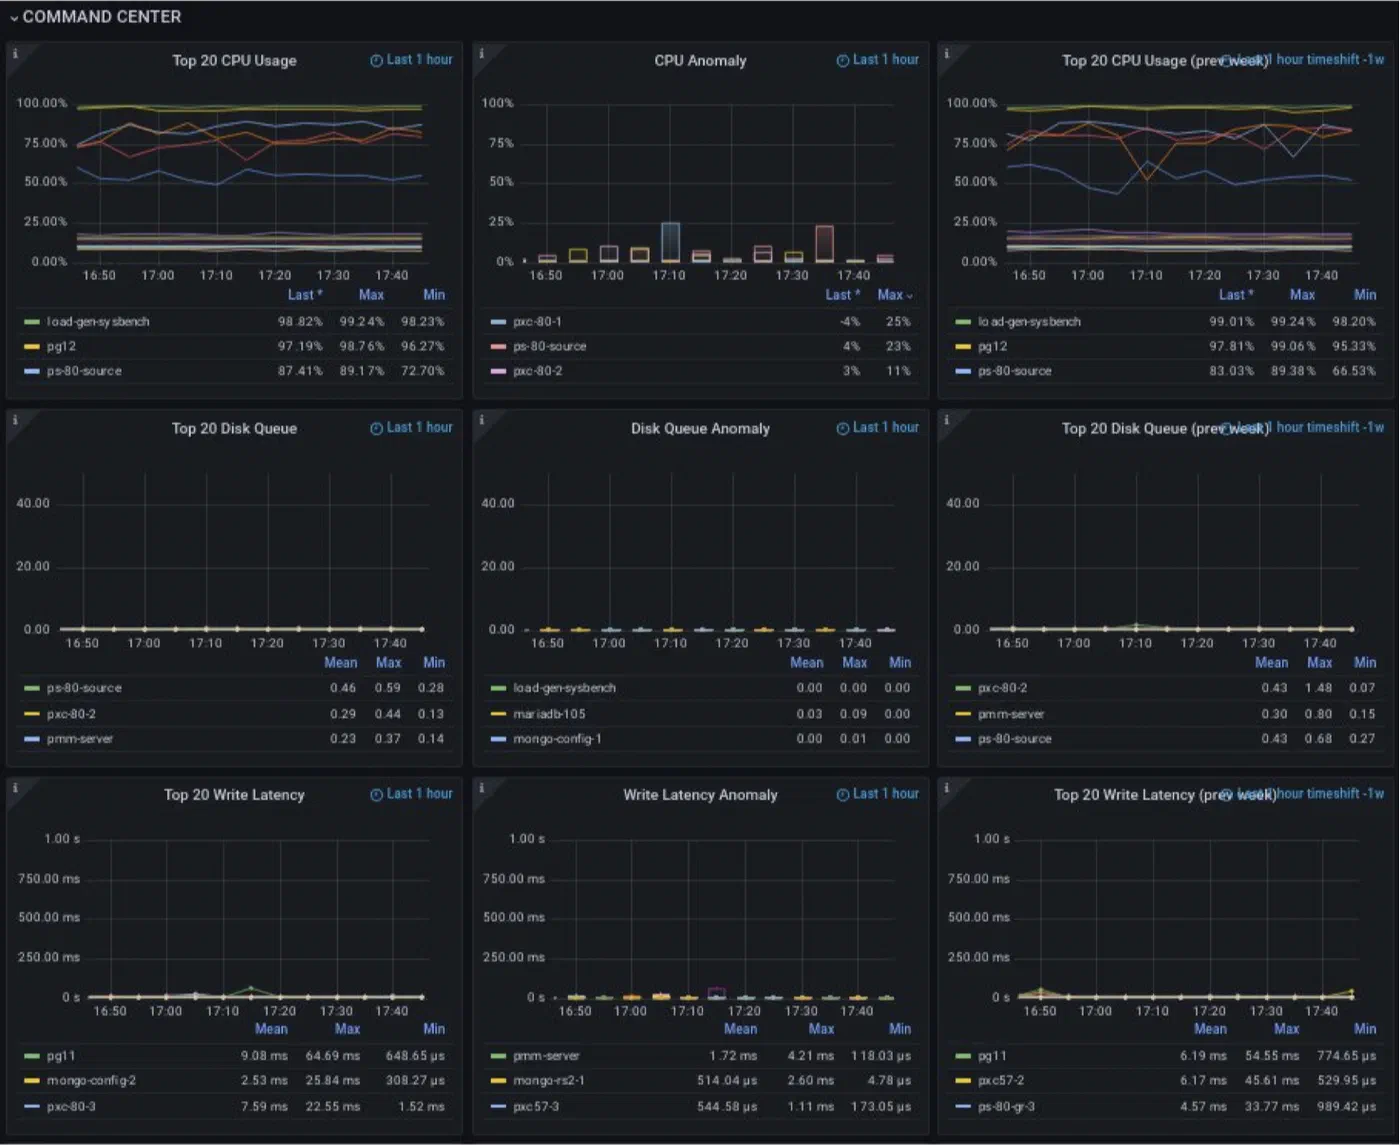
Для обнаружения аномалий команда опиралась на метрики CPU и дисков. Они помогли оценить использование ресурсов и задержки. Инженеры вывели показатели за неделю и за последние 15 минут, чтобы отслеживать тенденции.
Для более подробной статистики в прототипе был «Командный центр», в котором собраны ключевые метрики: загрузка ЦП, очередь диска, задержки записи и чтения, объем занятой памяти. По ним можно быстро оценить, что происходит в системе. Они распределены по трем панелям, которые показывают текущее использование ресурсов, аномалии и показатели недельной давности.
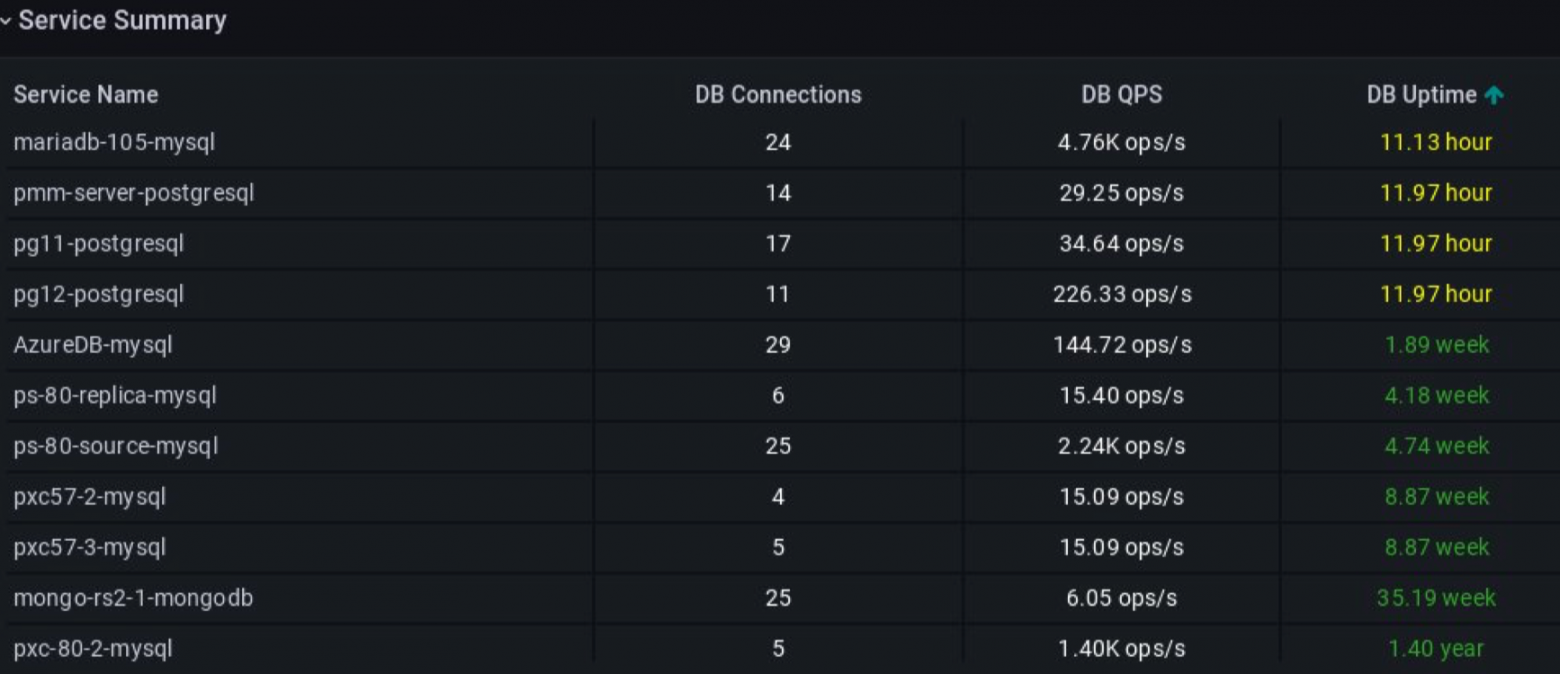
Для данных по каждому сервису были отдельные сводки. Здесь можно было оценить количество соединений с базой данных, число запросов в секунду — QPS — и время непрерывной работы.
Каким стал продукт в итоге
Когда инженеры Percona показали прототип другим командам, их спросили: «Что именно означает “Нет аномалий”?» Тогда разработчики добавили пояснение: предупреждений нет, потому что загрузка CPU ниже заданного порога. Так стало понятнее, на чем основан статус.
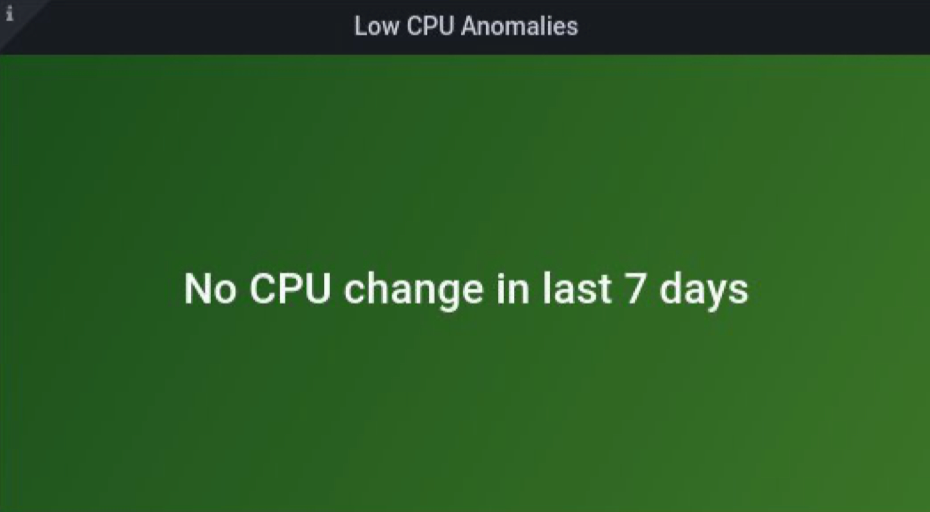
Затем расширили набор показателей, так вышел полноценный детектор аномалий. Помимо проблем с использованием ЦП и дисков добавили высокое потребление памяти. Еще появилась панель серверов с загрузкой процессора ниже 30%. Она помогла находить мощности, за которые платят, но почти не используют.
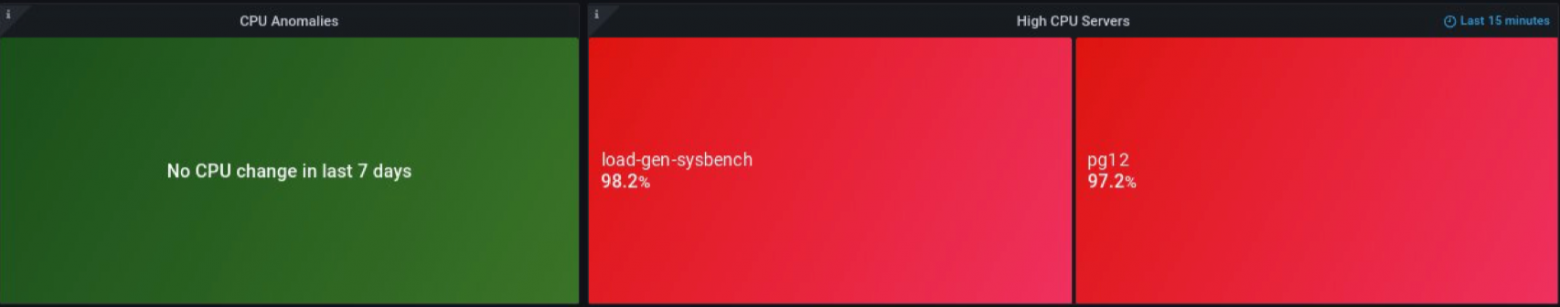
В статусы по аномалиям можно было провалиться и изучить подробнее состояние ЦП, дисков и памяти конкретного узла. Так главная страница дашборда оставалась входной точкой расследования, а подробности открывались по необходимости.
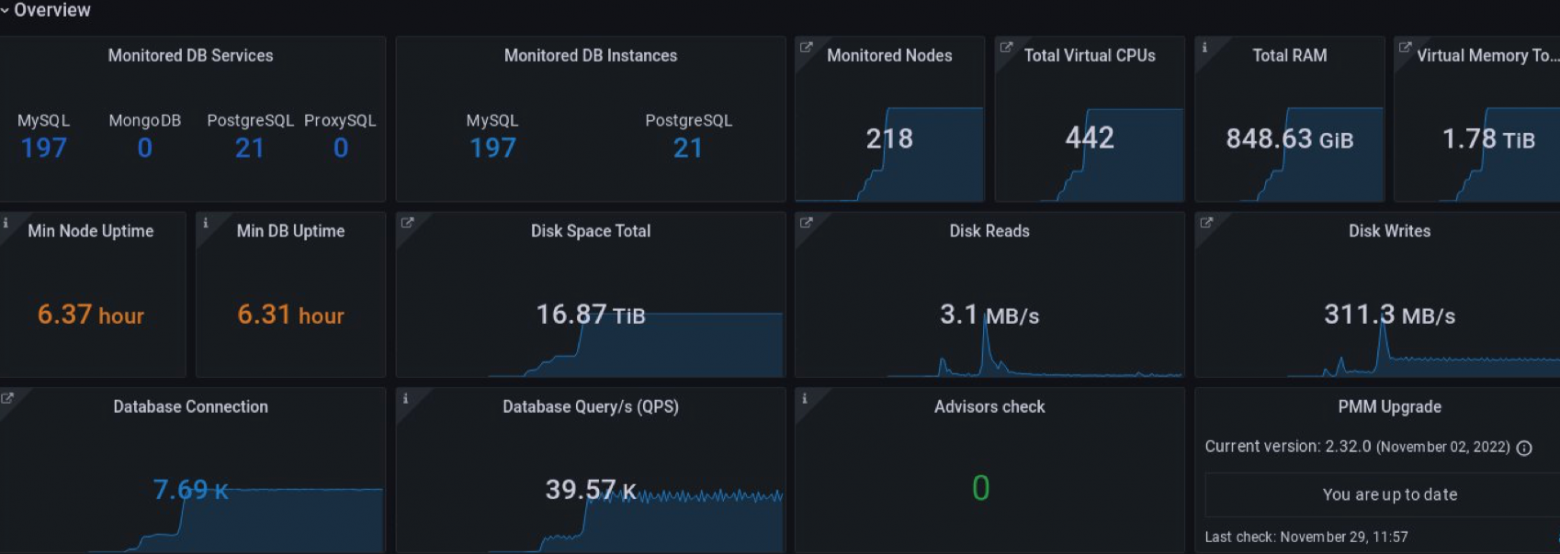
Инженеры изменили и раздел «Обзор». Добавили подробности по базам данных, а часть панелей убрали после негативного фидбэка. На этом же этапе появилась фильтрация по окружению. С ней пользователь мог оценить только относящиеся к нему узлы.

Так команда пришла к исходной цели. Можно открыть главную страницу, понять, требуется ли вмешательство, и при нормальной ситуации спокойно вернуться к кофе. Полный набор метрик остается доступен, но больше не требует начинать каждый просмотр с бесконечной прокрутки.
А что с дашбордом сейчас — в 2026-м?
Что по факту: его обновили до версии 3.10.0. Дашборд по-прежнему служит обзорной точкой входа. В нем также остались общие сводки, детектор аномалий, командный центр. С главной страницы можно перейти к оценке состояния отдельных узлов. Разработчики подтвердили гипотезу о первом решении пользователя и не стали радикально менять продукт.
А изменилось ли что-то у меня? Да, мои требования к мониторингу за четыре года точно поменялись. Идея «открыл дашборд — понял, можно ли спокойно пить кофе» мне по-прежнему близка, но теперь я смотрю и на то, насколько можно доверять этому ответу.
Например, одной быстрой загрузки дашборда мне уже мало. Если страница открылась за секунду, а потом еще десять минут ищешь проблему среди графиков, работу явно есть куда улучшать. Важно, сколько времени проходит от открытия страницы до понимания, где искать причину.
К зеленому статусу у меня тоже появились вопросы. Проверка прошла и отклонений нет? Или метрики просто перестали приходить? Допустим, из ста узлов данные присылают только девяносто. У них все спокойно, но что с остальными десятью — неизвестно. Показывать, что вся инфраструктура в порядке, в такой ситуации слишком оптимистично.
Поэтому статусы «проблем не нашли» и «не смогли проверить» должны выглядеть по-разному. Мне нужно видеть, насколько свежие данные, какие узлы проверены и от каких давно ничего не приходило. Иначе зеленому цвету трудно доверять.
Ну и про кофе-то понятно, конечно, но о критической проблеме хочется узнавать из уведомления, а не случайно открыв дашборд. Дальше уже разбираемся: что затронуто, насколько все плохо и куда смотреть.
Кстати, если сейчас делаете или переделываете такой экран, вот что советую сделать:
-
Попробуйте найти на нем конкретный сбой. Дайте коллеге сценарий и посмотрите, сколько времени займет поиск проблемного узла и где возникнут вопросы.
-
Разделите норму, отклонение и неизвестное состояние. Пропавшие данные не должны превращаться в зеленый статус.
-
Покажите, когда обновились метрики и сколько узлов проверено. Особенно если часть инфраструктуры перестала отвечать.
-
Проверьте переход к деталям. Выбранное окружение и время инцидента должны сохраняться, чтобы не приходилось выставлять их заново на каждом экране.
-
Проверьте уведомления. Доходят ли они до нужного человека и понятно ли из сообщения, что случилось и с чего начать?
-
За четыре года главный критерий для меня остался простым: помогает ли этот экран быстрее разобраться в происходящем? С этого и стоит начинать очередную переделку.
Пусть сбоев будет поменьше, а кофе почаще остается горячим. Всем благ!
Автор: Crazy_Eagle

Советуем прочесть:
 Мой опыт с Hermes Agent: ненависть, любовь, ненависть, любовь 21.08.2026 Началось все с установки. Я пошёл почти по самому простому пути — установил…
 10 лет растил команды — и не прохожу фильтр на управленческий опыт 16.10.2026 «Мы отдали предпочтение кандидату с актуальным управленческим опытом».Так закончился очередной разговор…
 Как организовать UI так, чтобы не переписывать код: личный опыт 30.09.2026 Интерфейс в 2D проектах и десктоп приложенияхОдна из участниц команды,…
 Опыт QA‑автоматизатора: как я подключил нейросеть к wiki, базам данных и тест‑менеджменту 22.10.2026 «Давайте скормим модели документацию, а она сама нагенерит тест‑кейсы». Вот что обычно…
 Страхование будущего: как бороться с AI‑мошенниками, как нейронки меняют бизнес, разработку и клиентский… 17.11.2026 20 ноября AGIMA и Т‑Страхование обсудят это на закрытом подкасте.В программе:Как бороться с мошенниками, вооружёнными…
 Как мы мигрировали с MongoDB на Cassandra за квартал: опыт использования АI-агентов 22.09.2026 Что делать, если критически важное хранилище с миллиардами записей требует…
 Ищем замену MinIO в условиях импортозамещения: опыт тестирования трех S3-совместимых хранилищ 30.09.2026 Привет, я Иван Засухин, DataOps Лаборатории искусственного интеллекта департамента больших…
 Как я перевёл свой self-hosted мониторинг с JSONL на SQLite и заставил модули просить разрешения 22.10.2026 Привет, Хабр.Мне нужно было открыть страницу и увидеть, что происходит…
 Собрал мониторинг упоминаний бренда в ChatGPT: три способа сбора данных показали три разные картины 10.09.2026 Для одного из клиентов собрал упоминания бренда в ответах ChatGPT.…
 ROC‑AUC 1,000 против 0,500: Как я совместил мультиплексирование и HTTP-2-профиль трафика 05.11.2026 В нашем тестовом стенде p95 latency снизилась с 579 до 108 мс, а Random Forest…
