


Меня зовут Екатерина Наконечная, я продакт-менеджер в Lenta tech (ИТ-бренд «Группы Лента»). На маркетплейсах можно бесконечно изучать карточки товаров, отзывы и цены конкурентов, но этого недостаточно, чтобы понять: на какие товары спрос растет и что стоит добавить в ассортимент. В ретейле выигрывает тот, кто быстрее и точнее выводит на полки товары, нужные покупателям именно сейчас. Интуиция важна, но без оперативной аналитики легко ошибиться.
Так, наша служба продвинутых технологий (СПТ) вместе со службой коммерции успешно апробировала решение «ИИ Платформа Тренды». Данный продукт собирает в одном интерфейсе продажи, поисковый спрос, отзывы, рейтинги и динамику по товарам на Ozon, Wildberries и Яндекс.Маркет, а затем помогает отфильтровать позиции с потенциалом.
Оглавление
Как зародилась идея создания платформы
Изначально поиск растущих товаров на маркетплейсах был почти полностью ручным. Категорийные менеджеры и аналитики по отдельности изучали MPStats, Wordstat, карточки товаров, сравнивали продажи, отзывы, поисковый спрос и наличие, а затем решали, стоит ли добавлять товар в ассортимент или развивать его.
Если нужно было проанализировать не одну карточку, а целую категорию, работа занимала несколько часов. При этом проблема была не только в скорости: на разных площадках один и тот же товар может называться по-разному, карточки дублируются, артикулы не совпадают, а рост спроса часто становится заметен слишком поздно, когда возможность уже упущена.
Из-за этого возникали ошибки:
-
один и тот же товар считался разными сущностями на разных площадках;
-
перспективные товары терялись в шуме похожих карточек;
-
решения принимались слишком поздно;
-
часть трендов замечали уже после того, как они стали востребованы покупателями.
Готовые сервисы частично закрывали отдельные задачи, но не давали нам цельную картину. Один инструмент мог показывать продажи, другой — поисковый спрос, третий — остатки или отзывы, но связать это в один рабочий поток было сложно.
Нам не хватало системы, которая помогает принять решение: что именно растёт, почему это растёт и насколько этому можно доверять.
Почему существующие способы не подошли
Мы пытались собрать процесс из готовых сервисов: выгружали данные, сводили их в таблицы и анализировали. Но поняли, что главная проблема не в сборе информации, а в том, чтобы правильно сопоставить данные из разных источников.
Один и тот же товар на разных площадках мог называться по-разному, иметь разные описания или вовсе быть разбитым на несколько карточек. Пока аналитик вручную разбирался с этим, рынок уже успевал измениться. А для трендовых товаров скорость критически важна. Поэтому мы решили разработать собственную платформу.
Как искали решение
-
нам нужно было объединять одинаковые товары с разных площадок в одну сущность;
-
классифицировать товары по категориям;
-
отслеживать динамику продаж, поискового спроса, отзывов и представленности;
-
собирать всё это в одном месте, чтобы менеджер мог понять: товар сейчас растёт, стагнирует или уже теряет интерес аудитории.
Мы попробовали эти подходы:
-
правила на регулярках и словарях;
-
жёсткую ручную нормализацию;
-
классические ML-подходы без LLM;
-
LLM-подход для семантической склейки и классификации.
Самым слабым вариантом оказались только правила. Они работают на простых кейсах, но ломаются на живом e-commerce-контенте, где много шума, синонимов, сокращений и маркетинговых формулировок.
Классические ML-модели помогали лучше, но тоже не решали задачу полностью, особенно там, где требовалось понять смысл названия товара, а не только сравнить строки.
В итоге оставили гибридный подход: правила — там, где нужна жёсткая логика; ML — там, где есть повторяемые паттерны; LLM — там, где нужно семантическое понимание и склейка похожих, но не идентичных объектов.
Почему выбрали LLM
LLM нам понадобилась для задач, где обычные методы начинали путаться. Самый показательный пример — склейка карточек товаров. На словах это выглядит просто, но на деле разные площадки пишут одно и то же по-разному, а иногда в карточке не хватает части атрибутов.
Мы сравнивали несколько вариантов:
-
только правила;
-
embeddings + cosine similarity;
-
классическую модель ранжирования;
-
LLM с дополнительными ограничениями и проверками.
Вариант с embeddings был неплох как предварительный фильтр, но в сложных случаях он путал похожие товары. Особенно это касалось категорий, где много близких по смыслу позиций: разные размеры, комплектации, наборы, серии, версии одной и той же модели. Классическая модель ранжирования тоже помогала, но ей не хватало гибкости на нестандартных формулировках.
LLM оказалась полезнее, потому что умеет учитывать смысл названия, атрибуты, контекст и косвенные признаки одновременно.
Еще больше примеров использования ИИ и ML в Lenta tech — в материалах о геомаркетинге и цифровом клоне покупателя.
Архитектура и подход
С технической точки зрения платформа решает задачу: объединить разрозненные данные маркетплейсов в единую, пригодную для анализа модель.
Вот из чего это состоит:
1. Объединение карточек товаров (entity resolution)
Один и тот же товар живёт в системе под десятком разных названий и SKU на разных площадках. Обычным SQL-джойном это не собрать, поэтому для сопоставления карточек мы завели LLM: она сравнивает товары семантически и склеивает их в единый «глобальный товар». Дальше уже все метрики — продажи, отзывы, динамика — считаются не по карточке, а по товару целиком.
Решение:
-
используется LLM для семантического сопоставления товаров;
-
агрегируются карточки с разных маркетплейсов;
-
все карточки склеиваются в одну запись.
Результат: все метрики (продажи, отзывы, динамика) считаются на уровне реального товара, а не отдельной карточки.
2. Категоризация и мэппинг в каталог
Одна из первых задач — понять, к какой категории относится товар в каждой площадке. На практике это не всегда очевидно: у одного и того же товара на Ozon, Wildberries и Яндекс.Маркет могут быть разные названия, разные атрибуты и даже разная логика разметки. Поэтому категоризация у нас строится не по одному признаку, а по набору сигналов:
-
названию;
-
описанию;
-
характеристикам;
-
контексту из карточки.
Здесь LLM помогает собрать всё это в устойчивую классификацию, а не полагаться на жёсткие правила. В итоге один и тот же товар попадает в сопоставимые категории, и уже можно смотреть не на хаос карточек, а на нормальную картину по сегменту.
3. Проверка представленности
Дальше важно понять не только, что товар существует, но и насколько он вообще заметен на рынке. Иногда товар есть в каталоге, но фактически его невозможно найти через поиск, он плохо представлен по регионам или лежит глубоко в выдаче.
Для этого мы проверяем представленность на разных площадках и сравниваем, где товар реально доступен, а где его фактически нет в продажах.
Такой слой анализа помогает отличить товар, который уже начал расти, от товара, который просто однажды появился в каталоге. Таким образом, можно увидеть, где есть дефицит, где карточка теряется в выдаче и где у конкурента товар уже занял заметную позицию.
4. Анализ поискового спроса
Отдельно смотрим на то, как меняется интерес покупателей в поиске. В отличие от продаж, поисковый спрос показывает не только факт покупки, но и что люди начинают искать чаще, чем раньше. Это позволяет выявлять тренды ещё до того, как рост станет заметен в выручке.
Мы собираем поисковые подсказки, частотность запросов и динамику интереса по ключевым фразам, чтобы понять, какие категории разгоняются. Если запросы растут, а продажи пока только догоняют, это хороший сигнал присмотреться к товару раньше конкурентов.
5. Анализ временных рядов
Когда базовые данные собраны, следующий шаг — посмотреть на них во времени. Важно не просто увидеть, что товар продаётся, а понять, это разовый всплеск, сезонный эффект или устойчивый рост. Для этого строим временные ряды по продажам, спросу и другим метрикам, чтобы отслеживать динамику и выделять тренды.
Дальше ML-модели помогают отделять шум от настоящего движения. В результате можно не только описать, что происходит сейчас, но и прикинуть, куда товар идёт дальше: в рост, в плато или в спад.
В результате менеджер получает не разрозненные цифры по каждой площадке, а единую карточку товара с готовым вердиктом: расти дальше, тестировать или снимать с полки.
Описание продукта: что находится на главном экране
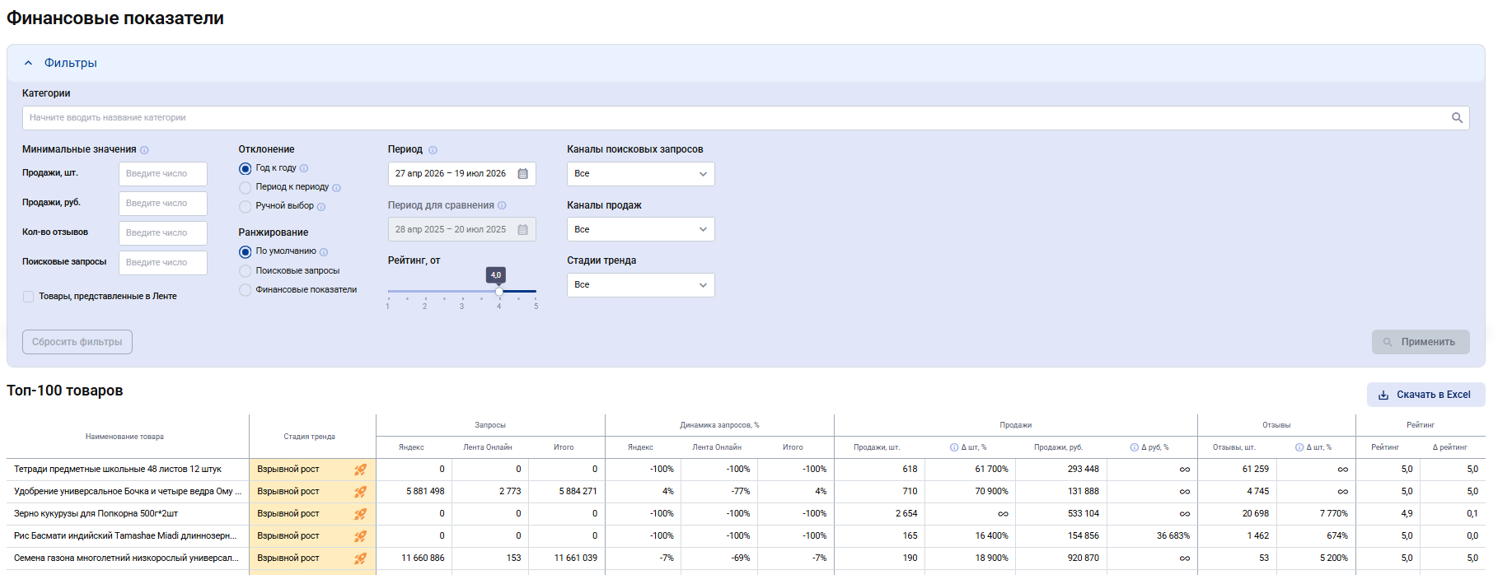
Основная рабочая зона — страница «Финансовые показатели». Здесь отображается список товаров, который можно фильтровать по категории, продажам, выручке, отзывам, поисковым запросам, рейтингу и стадии тренда.
Фильтры работают по принципу пересечения: товар остаётся в выдаче только если подходит сразу по всем условиям. Это удобно, когда нужно не просто собрать длинный список, а найти конкретный сегмент, например товары с продажами выше 1000 штук и рейтингом от 4,5.
Как система понимает, что товар растёт
Одна из самых интересных частей платформы — определение стадии тренда. Система относит товар к одной из пяти фаз: зарождение, рост, сезонный рост, взрывной рост или угасание.
С практической точки зрения это очень полезно. Если товар в фазе «Рост» или «Взрывной рост», — стоит присмотреться внимательнее: спрос уже подтверждён, а окно возможностей ещё открыто. Если же товар уходит в «Угасание», это повод снизить ожидания или вовсе исключить его из рассмотрения.
Что показывает динамика
Платформа умеет сравнивать данные сразу в нескольких режимах: год к году, период к периоду и через ручной выбор промежутков. Это позволяет отделять сезонность от реального изменения спроса и смотреть на товар не в статике, а в контексте.
Например, сравнение год к году помогает понять, растёт ли категория вдолгую, а сравнение период к периоду — заметить быстрый скачок спроса. Для товарной аналитики это критично: один и тот же товар может выглядеть хорошо на короткой дистанции и совсем иначе — на горизонте года.
Карточка товара как следующий шаг
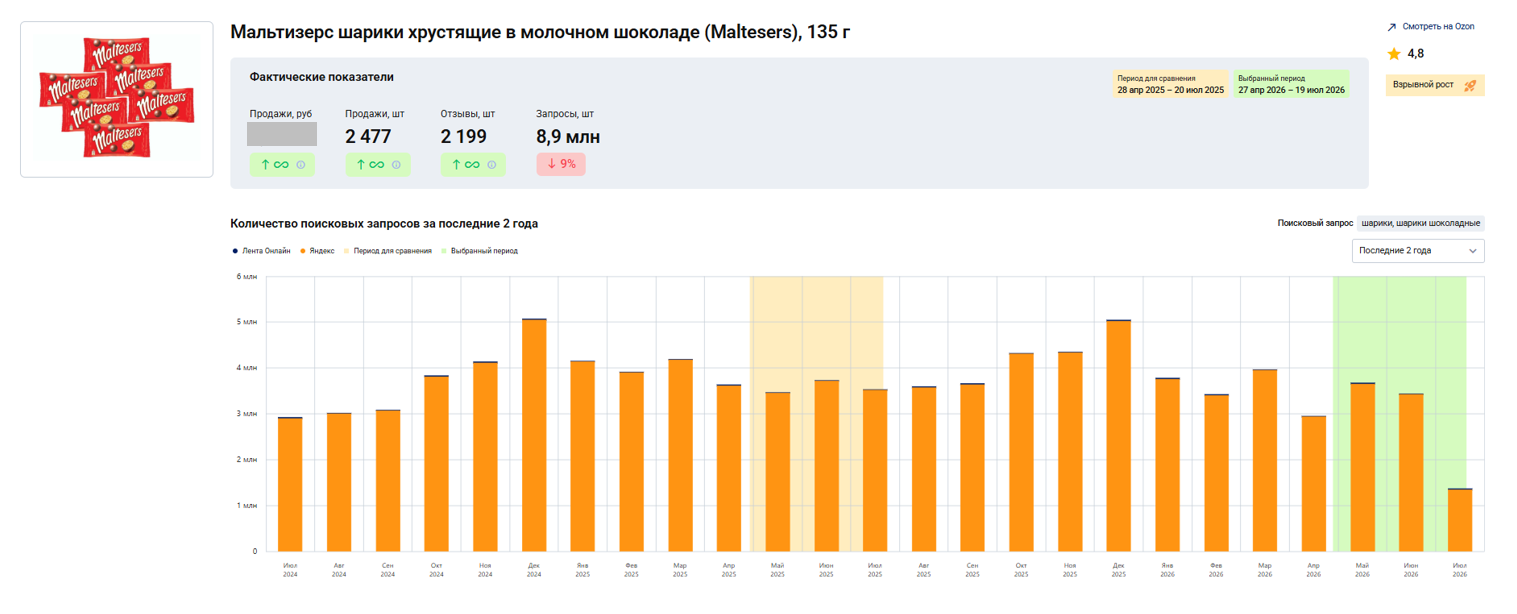
Если товар заинтересовал, его можно открыть из таблицы и перейти в карточку. Там доступна более детальная информация: фото, рейтинги на маркетплейсах, продажи, отзывы, запросы и динамика за выбранный период.
Для товаров, представленных в «Ленте», дополнительно показывается конкурентный анализ с ценами других сетей. Это уже похоже на нормальный рабочий сценарий для коммерческой команды: посмотрели спрос, сравнили с конкурентами, оценили цену и только потом приняли решение.
Поиск и проверка SKU
Помимо главной таблицы, есть отдельный поиск по ключевым словам и экран проверки SKU. Это полезно, когда нужно быстро найти конкретный товар или проверить список позиций без ручного просмотра всей базы.
В проверке SKU можно загружать список товаров в формате xls, до 100 позиций за раз. Такой режим удобен для категорийных менеджеров и аналитиков, которым нужно быстро сравнить собственный список с рыночными данными.
Полученные результаты по продукту
На сегодняшний день платформа уже встроена в цепочку работы с SKU к вводу и используется как главный инструмент для поиска товаров и принятия решения об их вводе.
-
Сократилось время анализа. Если раньше на ручную сводку по категории уходили часы, то теперь предварительная оценка занимает не более 10 минут. Это значит, что категорийный менеджер тратит меньше времени на сбор данных и больше — на само решение.
-
Выросло количество решений, которые можно принять в одном окне. Платформа помогает не просто увидеть товар, а сразу понять, что с ним делать: тестировать, усиливать, наблюдать или исключать.
-
Мы нашли товары, которые без автоматизированного поиска могли бы не попасть в ассортимент. Для нас это важно, ведь иногда один ранний сигнал по росту спроса даёт больше эффекта, чем позднее и дорогое расширение ассортимента.
-
Снизилась нагрузка на команду. То, что раньше требовало ручной сверки нескольких источников, теперь делается автоматически, а человек подключается только в спорных случаях.
Сегодня инструмент используют более 200 сотрудников коммерческой службы. С его помощью уже отобрали и вывели на полки более 150 трендовых SKU (в компании их называют «вкусняшками»). Проект подтвердил свою эффективность, обеспечив рост РТО на 10%.
Планы по развитию продукта
Мы продолжаем развивать платформу и планируем расширить её функциональность за счёт парсинга зарубежных маркетплейсов и обогащения данных. Это позволит нам выявлять трендовые позиции не только на российском рынке, но и находить уникальные товары для ввода в ассортимент нашей сети.
Первое — улучшение качества склейки на сложных категориях, где много похожих товаров. Второе — более точная оценка ранних трендов, чтобы замечать рост ещё до того, как он становится очевидным всем.
Итог
Если смотреть на платформу в целом, её ценность в том, что она сокращает путь от идеи до решения. Пользователь не просто ищет «что продаётся», а отбирает товары по росту спроса, оценке качества, динамике и конкурентной позиции.
Самая сложная и затратная часть проекта — точная склейка карточек и проверка спорных случаев по принципу human-in-the-loop. Именно от качества этой работы зависит, доверится ли категорийный менеджер данным или начнет перепроверять их вручную.
Инструмент «ИИ Тренды» экономит часы на сборе данных — а значит, у команды остаётся время на то, ради чего всё это затевалось: на саму гипотезу о товаре, а не на её сбор по кусочкам.
А вам важно наличие трендовых товаров в магазине?
Автор: kate_nako

