


Перед каждым ML-разработчиком, после обучения прекрасной модели, которая поднимет бизнесу метрики, а тебе годовую премию, возникает вопрос: а как ее задеплоить в сервисе, чтоб она начала работать?
А ты пошел отдыхать.
При этом модель должна не просто работать, а стабильно и быстро, плюс сервис должен иметь широкий набор инфраструктурных функций из коробки! С метриками, конечно же… Иначе как отследить ту невероятную пользу, которую наносит твоя модель?
Все эти задачи решает NVIDIA Triton Inference Server – это опенсорс платформа для инференса моделей машинного обучения, и она успешно отвечает на все эти запросы. Что самое характерное, в некоторых случаях даже код писать не придется, песня же, а?
Но обо всем по порядку, меня зовут Чернышев Стас, я ведущий ML-разработчик в команде поиска MAGNIT OMNI. Начнем с идеи и как мы ее воплотили в жизнь, а потом в технической секции залезем в конфиги и посмотрим, как это все настраивается.
Почему Triton?
До сих пор огромное количество моделей просто оборачивают в REST подобные фреймворки, ярким представителем которых является FastAPI, и это нормальное решение, многие с ним знакомы, хорошая документация, много туториалов. Но есть и минусы: у него отсутствуют специализированные инфраструктурные штуки из коробки:
-
gRPC
-
батчинг входных запросов
-
кэш
-
health check
-
метрики
Все это нужно писать вручную, разбираться, как работает, а затем поддерживать. Кроме того, если вы запустили свой сервис на CPU, то для перехода на GPU инференс нужно серьезно поработать с драйверами для вашего образа в Dockerfile. Но главный недостаток – скорость, на CPU даже инференс одного запроса занимал ~30 мс, что нас категорически не устраивало.
Давайте для наглядности соберем в таблицу наши хотелки и представления о том, что могут предложить популярные фреймворки для инференса:
|
|
FastAPI |
BentoML |
Triton |
|
Динамический батчинг |
вручную |
есть |
есть |
|
Кэш ответов |
вручную |
нет |
есть (локальный / Redis) |
|
hRPC |
вручную |
только в старых версиях API |
есть |
|
Метрики Prometheus |
вручную |
есть |
есть |
|
Инференс без Python |
нет |
нет |
есть (нативные бэкенды) |
BentoML удобен, но инференс происходит в Python-процессах со всеми вытекающими в виде GIL и накладных расходов на каждый запрос. Даже сами разработчики BentoML для ускорения предлагают запускать внутри него Triton. Ну и кэш-ответов: у нас три четверти запросов повторяются, так что кэш из коробки был обязательным пунктом.
Архитектура модели
Прежде чем рассказать, как мы деплоили модель, коротко расскажу, ЧТО мы деплоили :)
В качестве базовой модели эмбеддингов мы используем BERTA — компактную русскоязычную модель, полученную дистилляцией эмбеддингов FRIDA от SaluteDevices.
Модель наследует от FRIDA систему префиксов — в частности, “search_query:” и “search_document:” для асимметричного поиска. По этому критерию мы разделили функционал на две независимых сервиса: эмбеддер запросов и документов. Для интересующихся оставлю ссылку тут – https://huggingface.co/sergeyzh/BERTA
Делим на два сервиса
Так как нагрузочные паттерны очень разные и эмбеддер товаров не должен влиять на эмбеддер запросов, ну и для отказоустойчивости, конечно, решено было разделить их на два.
Эмбеддер запросов работает в онлайне, пользователь вводит запрос, а мы должны быстро вернуть его эмбеддинг. Поэтому первый приоритет – скорость ответа.
Эмбеддинги товаров обновляются при изменении описания товара или модели векторного поиска – тут важнее пропускная способность.
Отказались от Python (почти)
На Python мы оставили только токенизацию — это маленькая модель на Python backend, которая добавляет префикс, зовет токенизатор и передает тензоры дальше. А само тело модели сконвертировали в ONNX и отдали нативному onnxruntime backend (полный список поддерживаемых бэкендов тут). Кстати, это тот самый случай, когда код писать не придется: кладем в репозиторий моделей веса (model.onnx) и config.pbtxt рядом, остальное Triton сделает сам. Это сразу дало серьезное ускорение по сравнению со стандартной реализацией инференса:
Как получали эмбеддинг сразу после обучения:
from sentence_transformers import SentenceTransformer

model_name = "your_best_model_checkpoint"
model = SentenceTransformer(model_name)
query = "search_query: молоко ультрапастеризованное 2.5%"
embedding = model.encode(query)`
И еще одна деталь: модель обучена с matryoshka-лоссом, поэтому первые 192 координаты 768-мерного эмбеддинга сохраняют почти все качество. Наружу мы отдаем именно их, предварительно отнормировав. Вектор занимает в 4 раза меньше места в хранилище, и поиск кандидатов работает быстрее.
Теперь схема моделей в сервисе выглядит следующим образом:
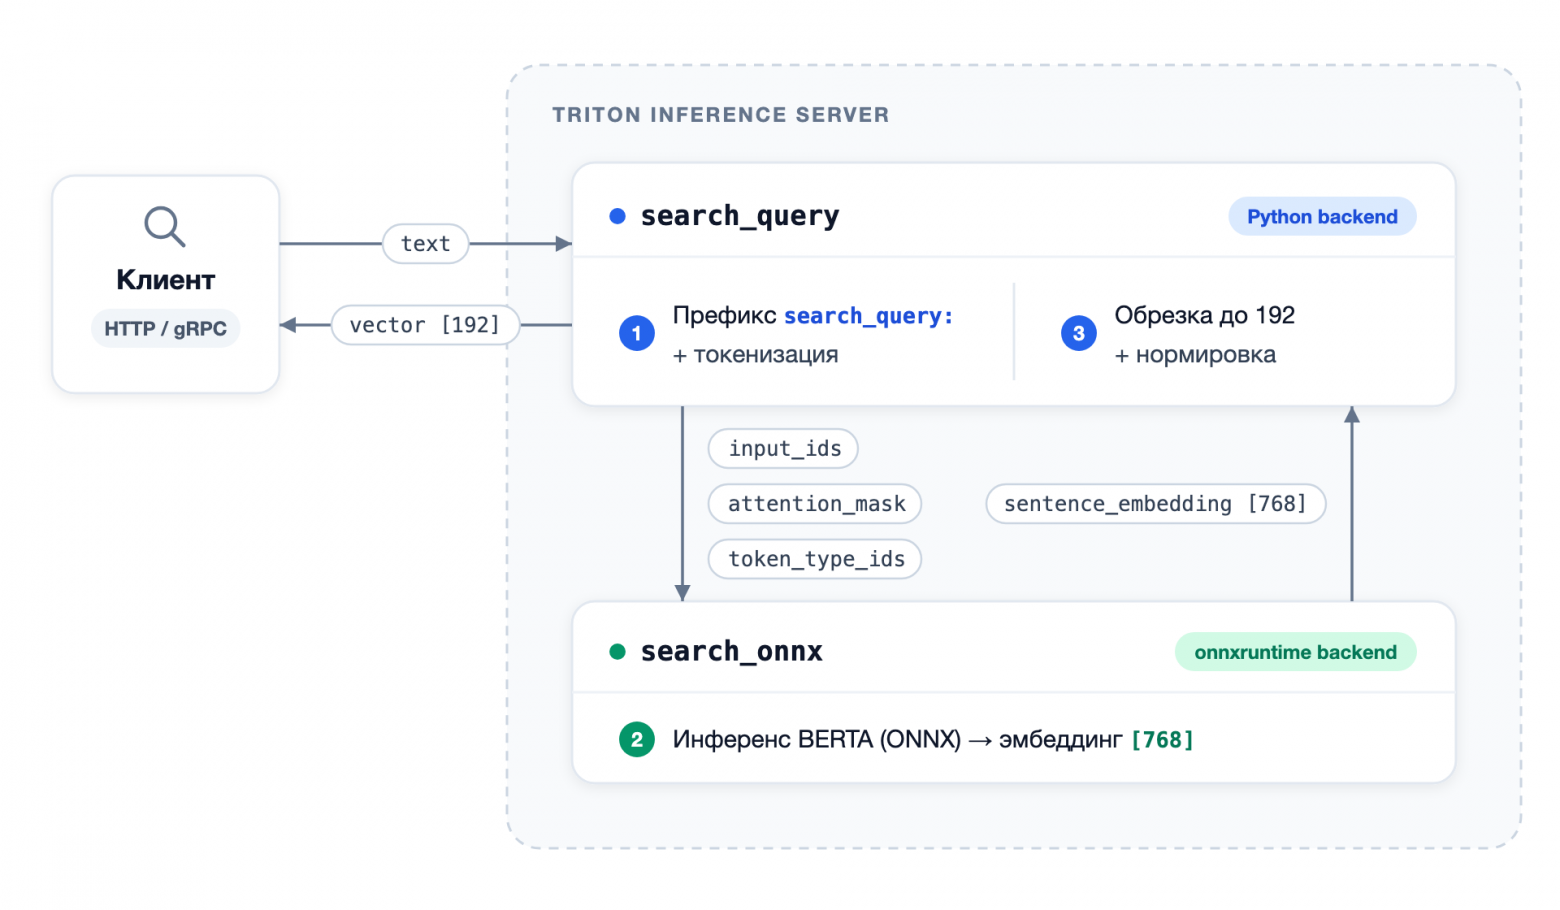
Основная часть готова, осталось подобрать оптимальные параметры работы, об этом подробнее ниже.
Техническая секция: пишем конфиг
Первое, на что стоит обратить внимание, при настройке модели – встроенный кэш, он может быть локальным, а может использовать удаленный Redis.
Включается в config.pbtxt модели:
response_cache {
  enable: true
}
А при старте сервера задается общий размер кэша для всех моделей. Ниже пример, как задать такой параметр:
tritonserver --model-repository ... --cache-config local,size=3221225472Для Redis вместо local указываем –cache-config redis,host=<host> и –cache-config redis,port=<port>.
При нашем профиле нагрузки у эмбеддера запросов часто повторяются одни и те же входные данные, поэтому его использование обязательно и снимает большую часть работы модели. А чтобы после рестарта приложения не обрушивался весь поток трафика на совершенно не готовый к этому сервис, был реализован прогрев: при старте пода прогоняем топ-N запросов, которые покрывают большую часть трафика.
Второе — это батчевание: можно “копить” запросы в батчи и делать параллельный инференс для элементов батча. Задается в config.pbtxt конфиге как-то так:
max_batch_size: 8
dynamic_batching {
  preferred_batch_size: [ 2, 3 ]
  max_queue_delay_microseconds: 3000  # сколько максимум ждем, собирая батч
}
Третье — это количество экземпляров модели. Triton Inference Server позволяет одним изменением параметра создавать два независимых экземпляра модели, в этом же блоке можно выбрать, на чем будет происходить инференс:
instance_group [
  {
    count: 2
    kind: KIND_CPU
  }
]
Отдельно хочу рассказать про параметры для onnxruntime backend.
parameters { key: "intra_op_thread_count" value: { string_value: "5" } }
parameters { key: "inter_op_thread_count" value: { string_value: "1" } }
intra_op_thread_count — сколько потоков onnxruntime использует для параллельного вычисления одного оператора (матричные умножения и т.п.), по сути — сколько ядер получит один экземпляр модели.
inter_op_thread_count — потоки для параллельного выполнения независимых операторов графа; у нас режим выполнения последовательный, поэтому 1. Итого при двух экземплярах: 2 × 5 = 10 ядер под инференс из 12 доступных, остаток забирают токенизация и сам Triton. Важно! Если суммарно потоков окажется больше, чем фактически выделено или имеется, сервис начнет тротлить: latency вырастет, а следом подтянутся и ошибки по таймаутам на клиентах.
Бенчмарки
В нашем случае описанное решение оказалось быстрее FastAPI приблизительно в 3 раза и чуть меньше — относительно Triton, но с инференсом целиком на Python backend.
Вообще же для сервиса запросов, задеплоенного на 12 ядрах и двух подах (=24 ядра), мы уже получили цифры, которых оказалось достаточно, чтобы не задействовать дорогостоящие решения на GPU:
|
Время |
Concurrency |
RPS |
Avg (клиент), мс |
р50, мс |
р90, мс |
р99, мс |
Avg (сервер), мс |
Cache Hit, % |
Errors |
|
8:45 |
10 |
212.8 |
47 |
41 |
58 |
64 |
12.6 |
57 |
0 |
|
8:47 |
20 |
424.3 |
47 |
42 |
61 |
74 |
13.6 |
65 |
0 |
|
8:49 |
30 |
614.3 |
48 |
43 |
64 |
87 |
19 |
72 |
0 |
|
8:51 |
40 |
800.6 |
50 |
44 |
68 |
90 |
22.9 |
75 |
0 |
|
8:53 |
50 |
983.1 |
50 |
45 |
73 |
95 |
27.4 |
76 |
0 |
|
8:55 |
60 |
1145.9 |
52 |
45 |
79 |
100 |
33.4 |
77 |
0 |
|
8:57 |
70 |
1282.5 |
54 |
45 |
87 |
115 |
43.9 |
78 |
0 |
|
8:59 |
80 |
1389.2 |
57 |
46 |
100 |
134 |
58.9 |
79 |
0 |
|
9:01 |
90 |
1483.4 |
60 |
46 |
118 |
150 |
87 |
79 |
0 |
|
9:03 |
100 |
1527.7 |
65 |
45 |
142 |
179 |
110 |
79 |
0 |
|
9:04 |
105 |
1571.1 |
66 |
45 |
149 |
188 |
124 |
79 |
0 |
Клиентские колонки замерялись через ghz с ноутбука и включают сетевой overhead. Avg (сервер) — средняя задержка запросов, дошедших до модели: кэш-хиты в нее не входят, они отдаются за ~0.007 мс. Поэтому при инференсе в 124 мс клиент в среднем видит 66 мс.
Тестирование эмбеддера документов проводилось на таких же двух подах с 12 ядрами. Тексты тут заметно длиннее — среднее описание товара ~136 символов против 1-3 слов в запросе, зато нет таких жестких требований по времени ответа:
|
Время |
Concurrence |
RPS |
Avg (клиент), мс |
р50, мс |
р90, мс |
р99, мс |
Errors |
|
15:45 |
70 |
119.5 |
579 |
562 |
897 |
1128 |
0 |
|
15:50 |
90 |
141.4 |
629 |
601 |
941 |
1170 |
0 |
|
15:54 |
110 |
150.7 |
719 |
703 |
1014 |
1529 |
0 |
|
15:58 |
130 |
149.8 |
854 |
845 |
1243 |
1598 |
0 |
|
16:02 |
150 |
146.5 |
1006 |
973 |
1467 |
1921 |
0 |
|
16:06 |
170 |
147.3 |
1132 |
1084 |
1634 |
2012 |
0 |
|
16:10 |
190 |
145.2 |
1283 |
1290 |
1820 |
2320 |
0 |
Как выбрать образ tritonserver или даже собрать самому под свои нужды
В зависимости от того, какими backend будем пользоваться, и на какой платформе (CPU или GPU) инференсить, подойдут разные версии образа. Они будут отличаться по весу и напрямую влиять на скорость поднятия сервиса — ведь его еще нужно спуллить из хранилища. Список преподготовленных образов можно найти в каталоге NGC: полный -py3, минимальный -py3-min и другие.
Так же можно самому собрать образ в необходимом конфиге: клонируем репозиторий triton-inference-server/server на ветке нужного релиза и запускаем скрипт build.py с необходимыми флагами (все подробности — в документации по сборке). Вот так выглядит пример сборки CPU-only образа под наш стек — python и onnxruntime бэкенды, gRPC + HTTP, метрики и локальный кэш:
git clone -b r26.02 https://github.com/triton-inference-server/server.git
cd server
./build.py -v
    --enable-logging --enable-stats --enable-metrics --enable-cpu-metrics
    --endpoint=grpc --endpoint=http
    --backend=python --backend=onnxruntime
    --cache=local
Что получилось в итоге
Сервис на обычных CPU-ядрах держит >1000 RPS с нормальной скоростью, кэш забирает на себя три четверти работы модели, а почти весь «инфраструктурный код» — это пара config.pbtxt. В нашем случае дорогие GPU так и не понадобились. Так что если ваша модель всё ещё завёрнута в FastAPI, тогда Triton идет к вам.
Модель задеплоена, метрики капают, невероятная польза наносится — можно наконец пойти отдыхать. Ну а годовая премия… посмотрим по метрикам.
P.S. В статье намеренно опущены подробные шаги по тому, как завернуть свою модель в Triton, постарался сфокусироваться на настройке и оптимизации. При первичном изучении технологии мне очень помогла эта статья на Хабре.
Автор: Magnit_OMNI

