


Откройте любую статью-инструкцию по установке LLM, в которой фигурирует Ollama. Уверен, в комментариях к ней автору уже объяснили, насколько он неправ и что единственное верное решение — использовать llama.cpp.
В этой статье запустим Gemma 4 и через Ollama, и напрямую через llama.cpp — и посмотрим, во сколько обходится удобство.
Немного предыстории
В 2023 году появилась Ollama — программа, которая должна была упростить пользователю запуск инференса. Под капотом она использовала llama.cpp. Далее в 2025 году разработчики Ollama написали собственный движок, в том числе для мультимодальных моделей, работающий напрямую с GGML. Новые модели постепенно переводили на него. А в 2026 году Ollama вернулась к llama.cpp — для работы с файлами моделей формата GGUF.
Выбор модели и запуск сервера
Для тестов мы будем использовать квантированную Gemma 4 26B A4B. Gemma 4 — модель от Google, вышедшая весной этого года, впервые полностью открытая (Apache 2.0).
Берем MoE-версию — это архитектура, где внутри модели есть несколько «экспертов», но для каждого запроса используется только часть из них. За счет этого такие модели часто дают хороший баланс между качеством ответа и расходом ресурсов — для версии 26B A4B.
В модели 26 млрд параметров, при этом для обработки каждого токена активируется примерно 4 млрд параметров, отсюда и A4B в названии. В Q4-кванте модель весит 14–18 ГБ, поэтому будем запускать ее на RTX 4090 с 24 ГБ.
Заказываем сервер
Для начала развернем виртуальную машину в облаке. Открываем панель управления, выбираем Продукты → Облачные серверы.
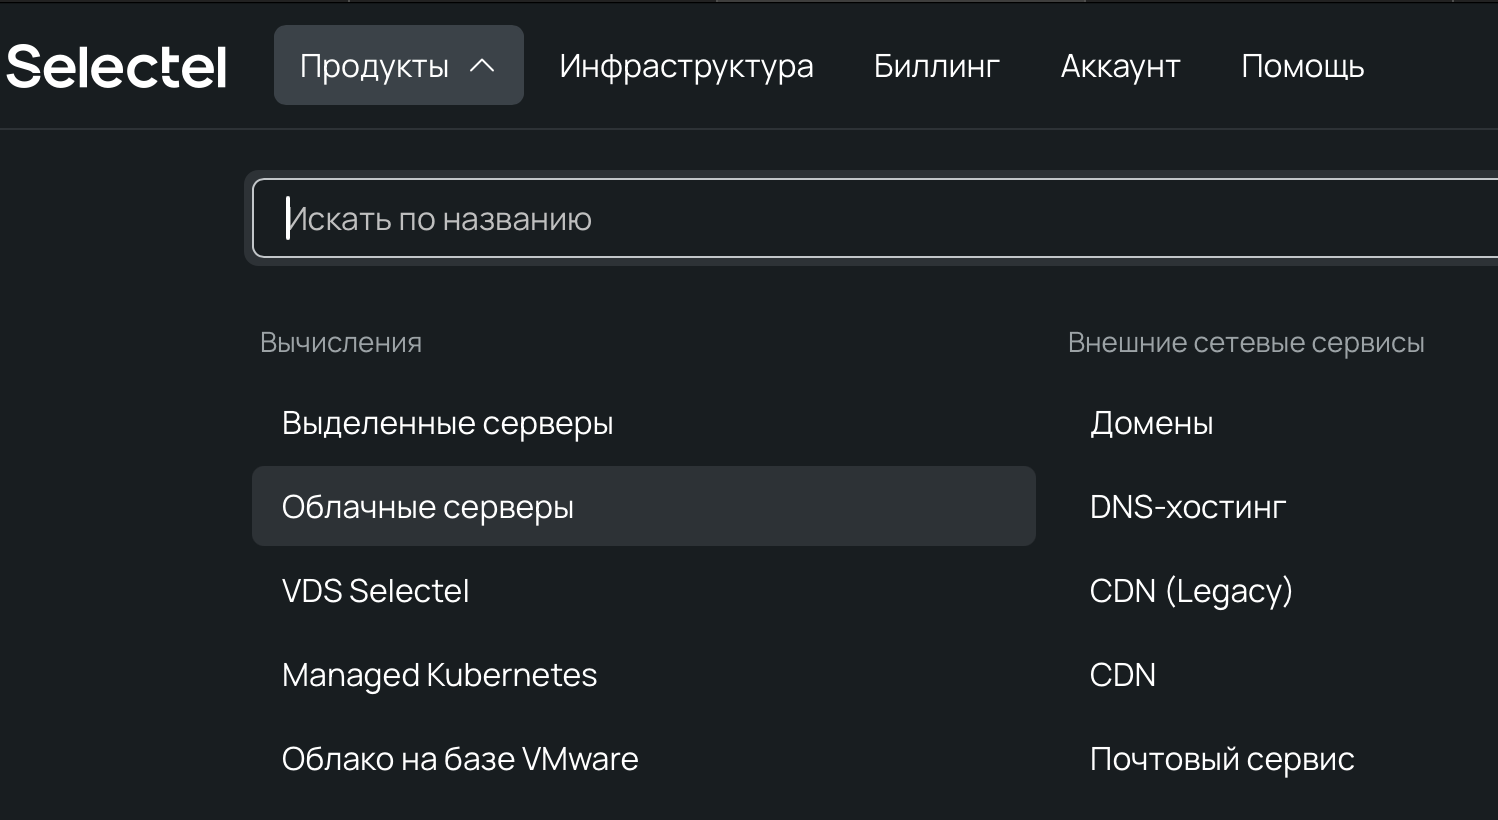
В поле Источник включаем автовыбор образа, с ним в GPU-конфигурации будут установлены драйверы для видеокарты.

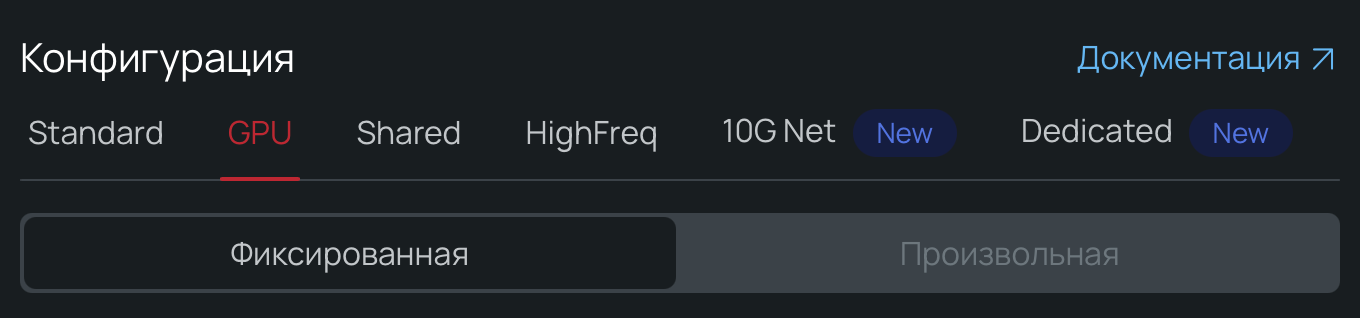
В разделе Конфигурация выбираем вкладку GPU.
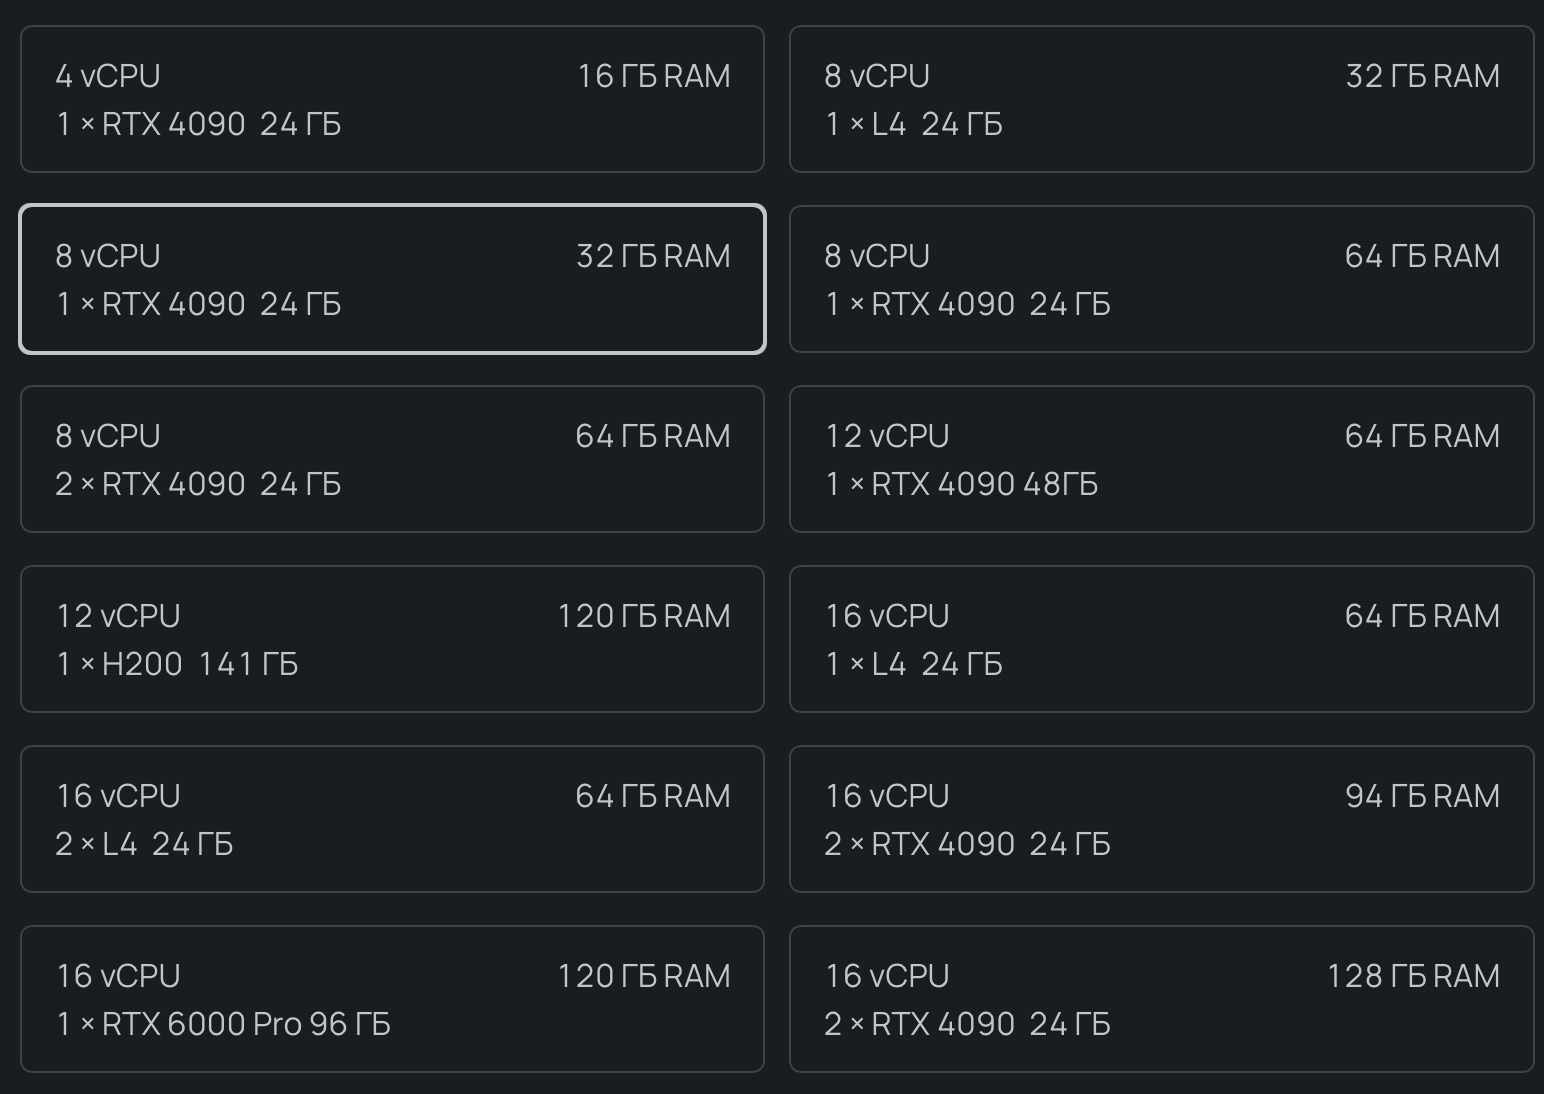
В фильтре по видеокартам выбираем нужную модель. Как я уже говорил, в нашем случае это RTX 4090.
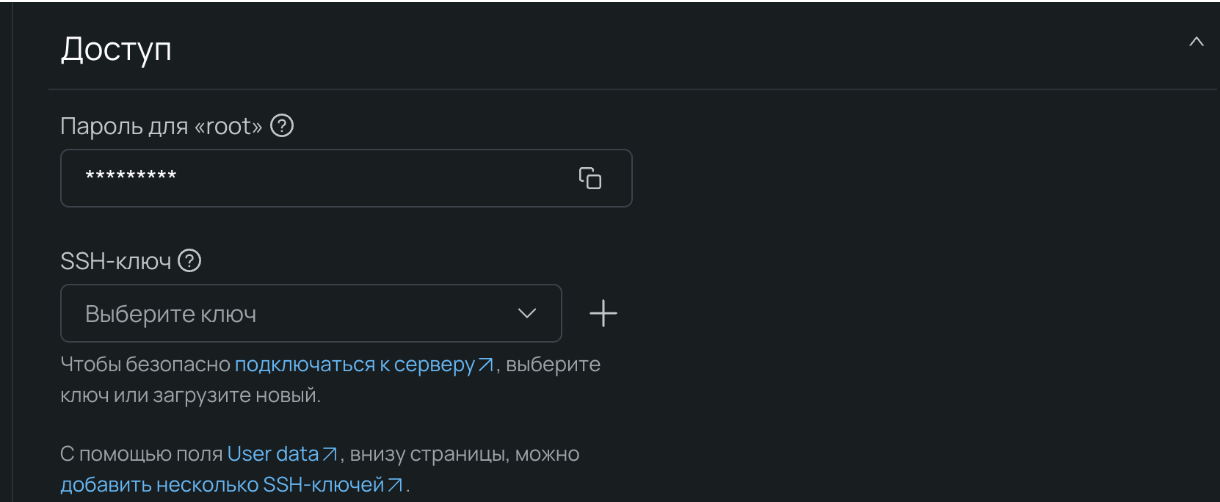
В настройках доступа добавляем свой SSH-ключ и сохраняем пароль суперпользователя (root).
Нажимаем Создать сервер.
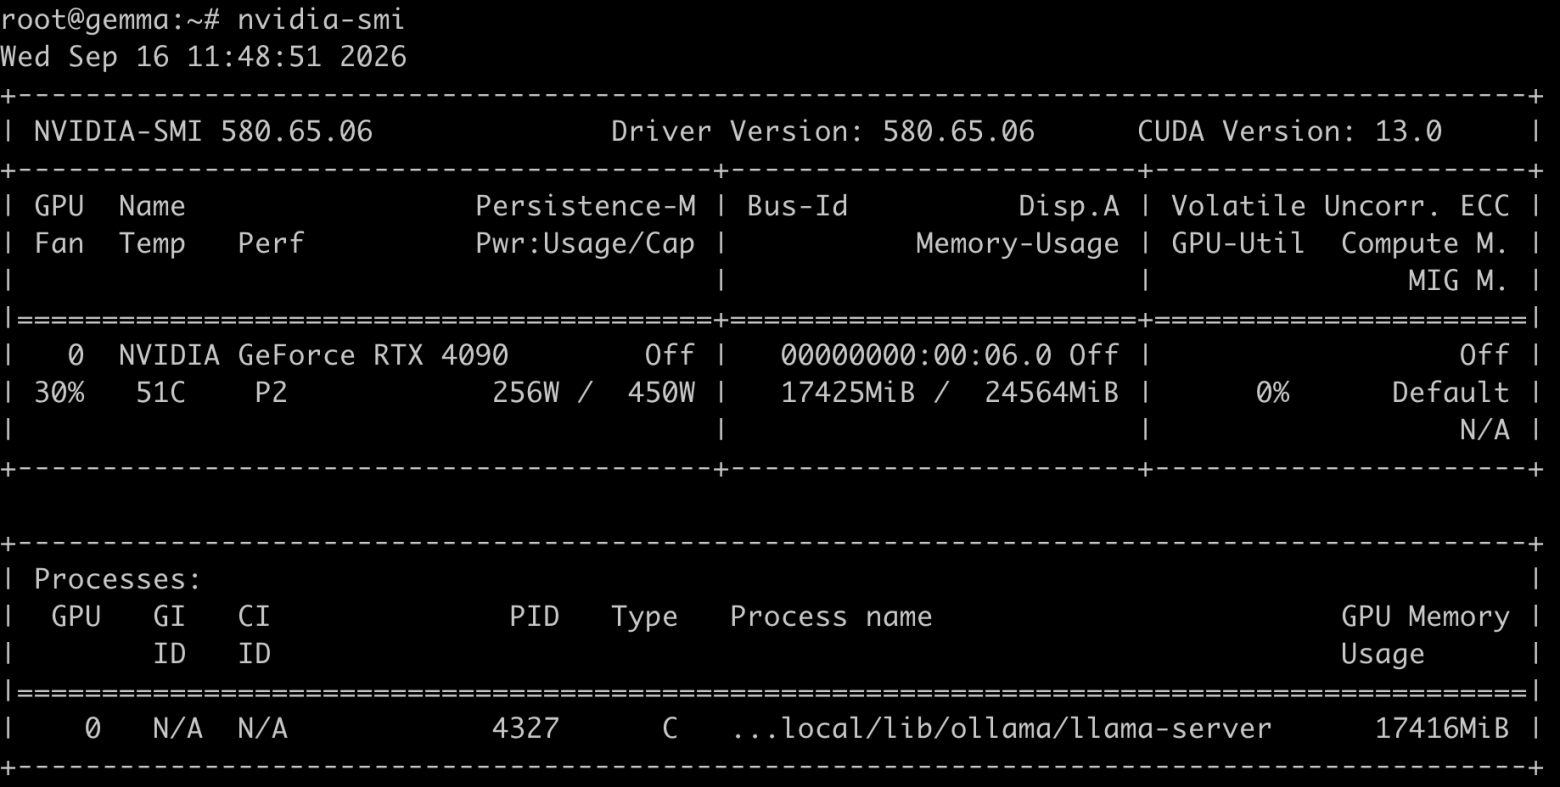
Когда статус изменится на «Готов», подключаемся к серверу по SSH и проверяем доступность видеокарты командой:
nvidia-smi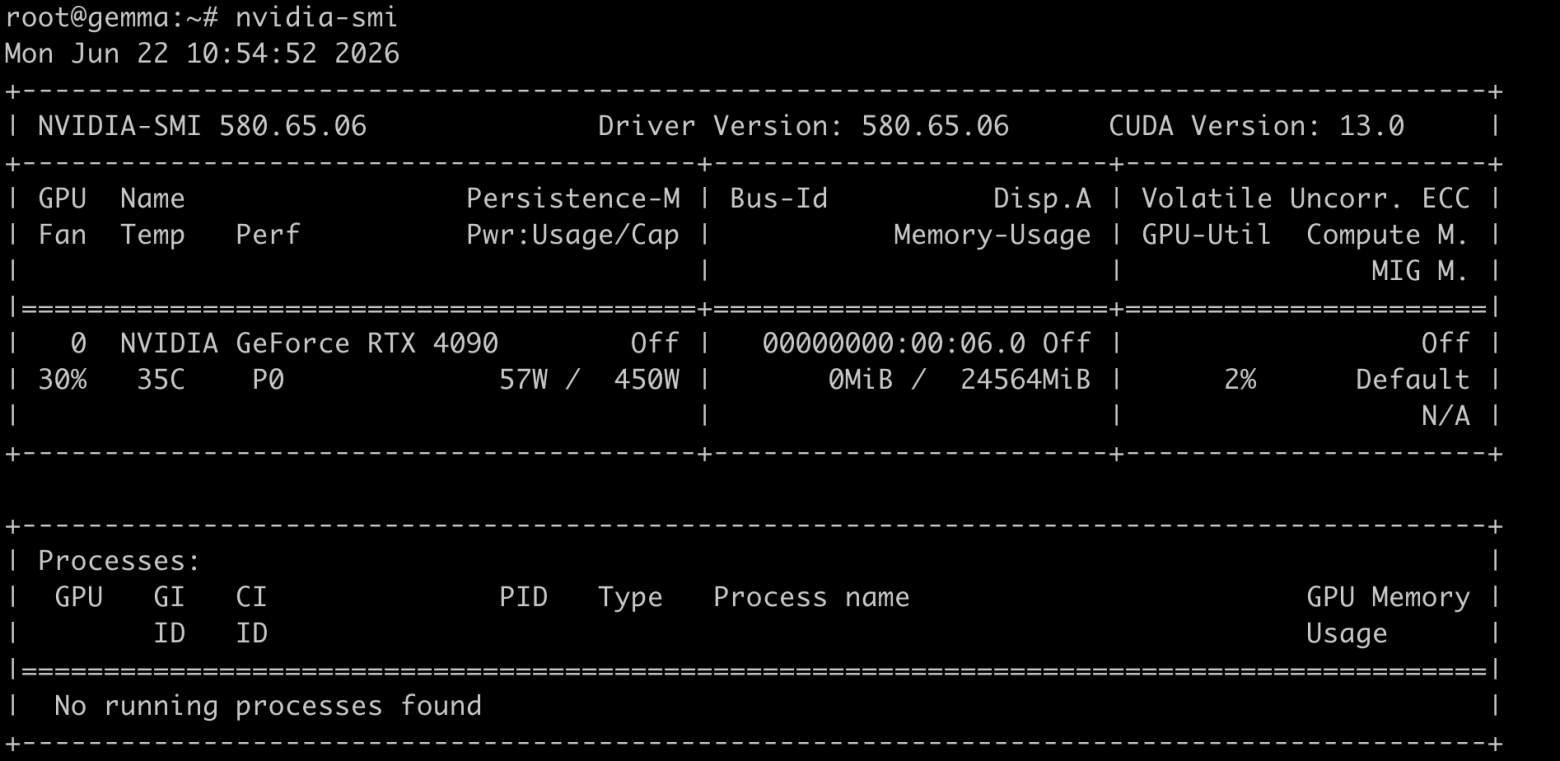
Каталог готовых ИИ‑моделей
Сервис для запуска и управления LLM в облаке Selectel. Выберите модель, конфигурацию и получите готовый эндпоинт для работы с ней.
Ollama
Для начала скачаем и установим все через Ollama. Плюс этого инструмента в том, что он прячет внутрь всю техническую сложность. Вам не нужно компилировать код или возиться с зависимостями. Весь процесс работы напоминает Docker.
Устанавливаем Ollama
Запускаем скрипт установки:
curl -fsSL https://ollama.com/install.sh | sh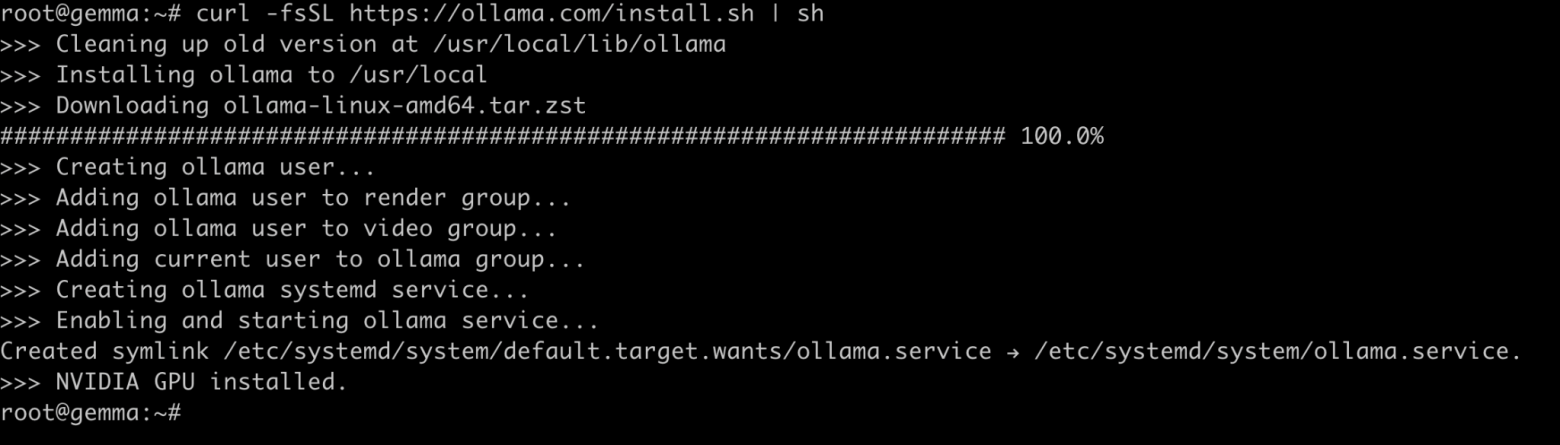
Проверим статус:
systemctl status ollama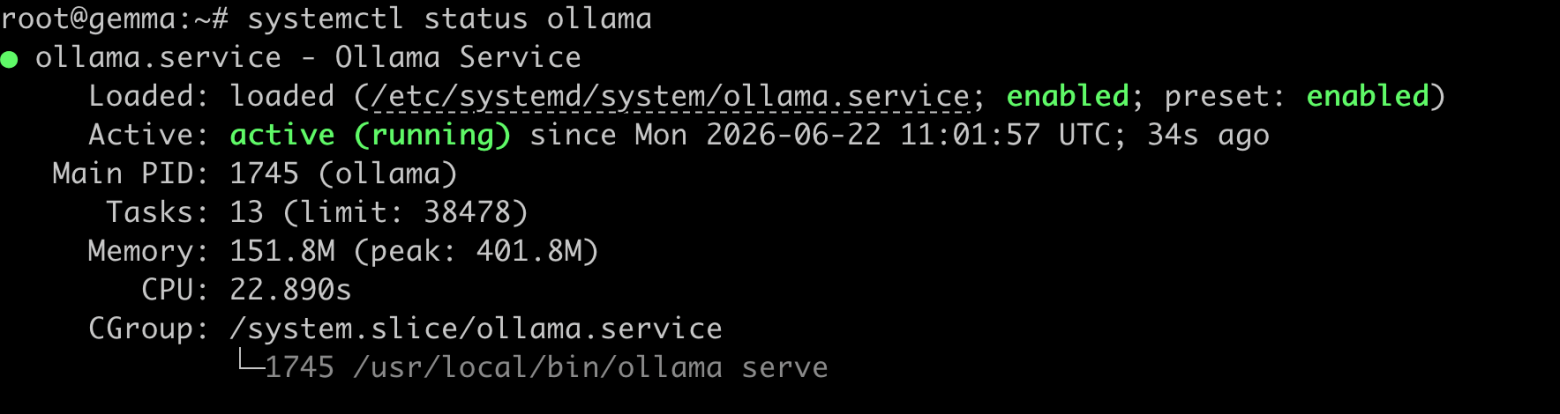
По умолчанию Ollama биндится на loopback-адрес 127.0.0.1:11434 и доступна только локально. Проверить, что порт прослушивается, можно командой:
lsof -i :11434
Скачиваем модель
Ollama предоставляет удобный CLI для работы с моделями:
ollama --help # смотрим, какие есть команды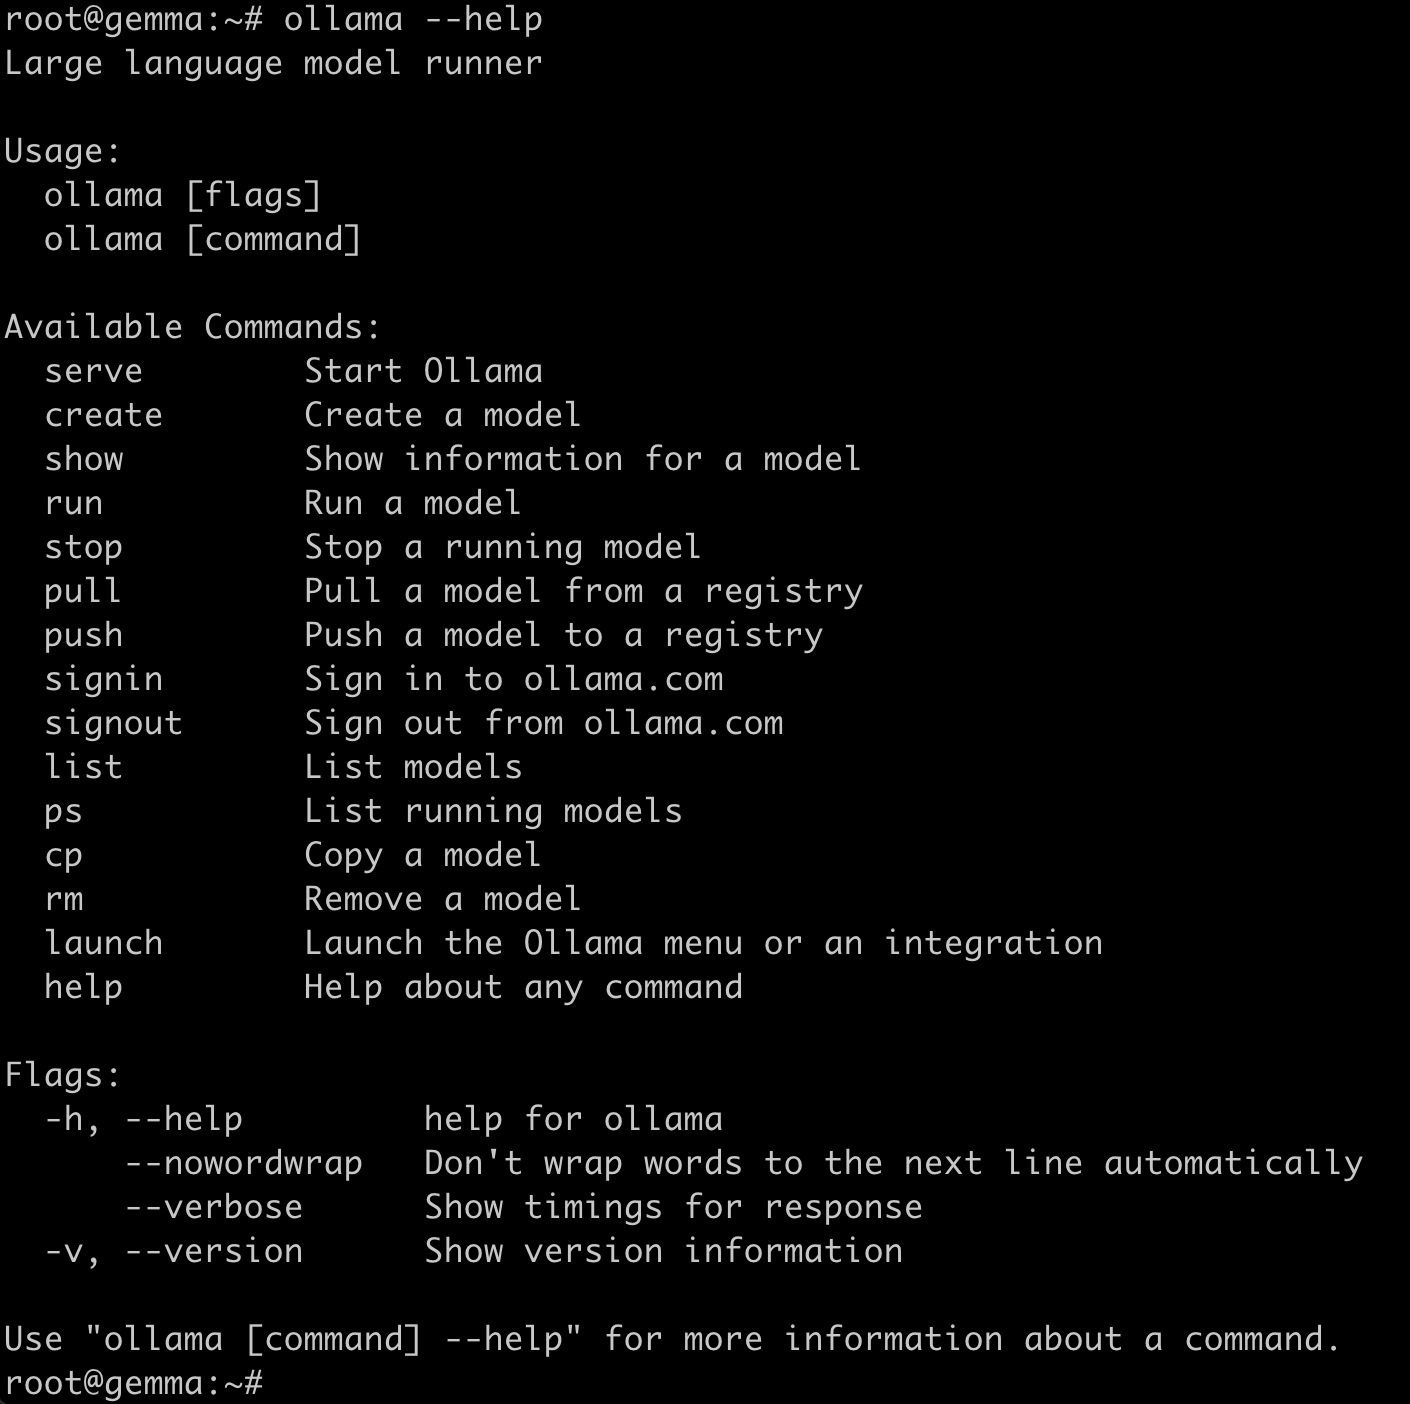
pull, run, rm, ps — почти все как в Docker.
Для скачивания модели используем команду: ollama pull <model>. Если хотим скачать и сразу запустить — ollama run <model>. Естественно, в обоих случаях вместо <model> пишем конкретную модель.
В нашем случае скачиваем модель с Hugging Face командой:
ollama pull hf.co/ggml-org/gemma-4-26B-A4B-it-GGUF:Q4_0
Проверяем API
Проверим, что к Ollama можно обратиться по HTTP. Сначала посмотрим список доступных моделей:
curl http://localhost:11434/api/tagsЕсли все настроено правильно, в ответе будет JSON со списком моделей, которые уже скачаны на сервер:
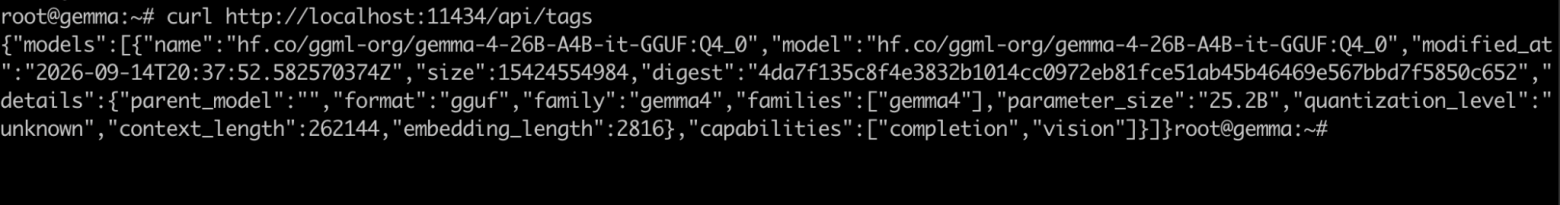
Теперь отправим тестовый запрос в /api/chat. По умолчанию Ollama может отдавать ответ в streaming-режиме — небольшими чанками по мере генерации. Если нужен только готовый ответ, можно указать "stream": false.
Вот как это все будет выглядеть:
curl http://localhost:11434/api/chat
  -H "Content-Type: application/json"
  -d '{
    "model": "hf.co/ggml-org/gemma-4-26B-A4B-it-GGUF:Q4_0",
    "messages": [
      {
        "role": "user",
        "content": "Hello!"
      }
    ],
    "stream": false
  }'
Получаем один финальный ответ в JSON-формате:
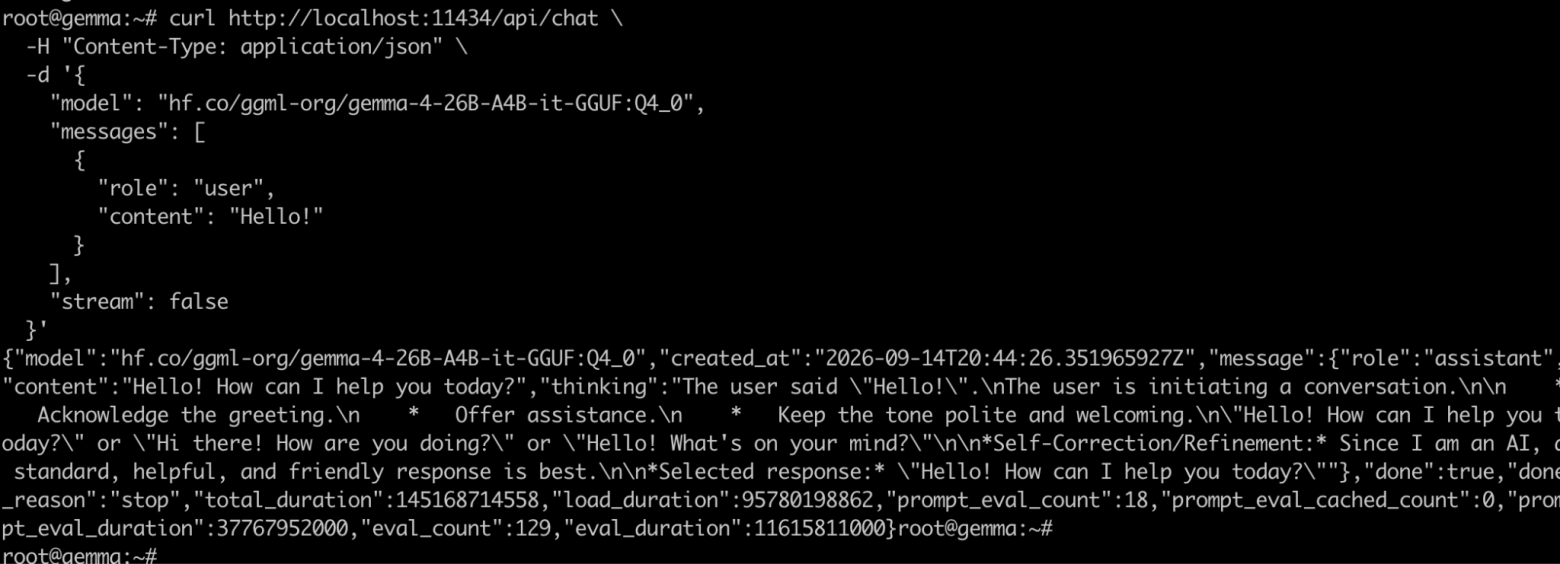
Все работает, можно переходить дальше.
llama.cpp
Теперь запустим ту же модель через llama.cpp, будем придерживаться официальной инструкции.
Устанавливаем llama.cpp
Установим утилиты для сборки:
sudo apt update
sudo apt install -y git cmake build-essential libssl-dev
Склонируем репозиторий с исходным кодом:
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp/
Чтобы использовать все мощности видеокарты, нам потребуется CUDA (Compute Unified Device Architecture) — архитектура от NVIDIA, которая позволяет использовать графический процессор для повышения производительности параллельных вычислений. А для сборки под нее необходим установленный nvcc — (NVIDIA CUDA Compiler) для компиляции программ на языке CUDA C/C++ под GPU.
Автовыбор образа поставил только драйвер видеокарты, проверяем, есть ли nvcc:
nvcc --version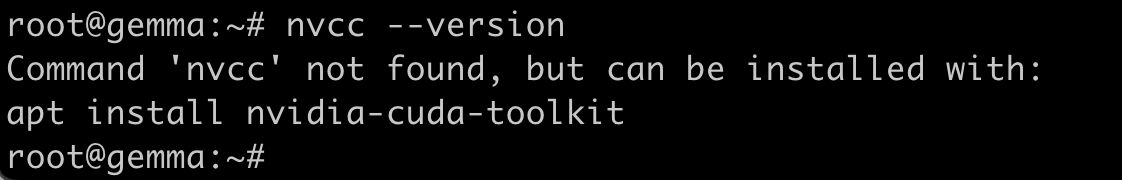
Если команда не найдена, ставим через команду:
apt install nvidia-cuda-toolkit Запускаем сборку с флагом GGML_CUDA=ON — без него cmake соберет CPU-версию:
cmake -B build -DGGML_CUDA=ON
cmake --build build --config Release -j$(nproc)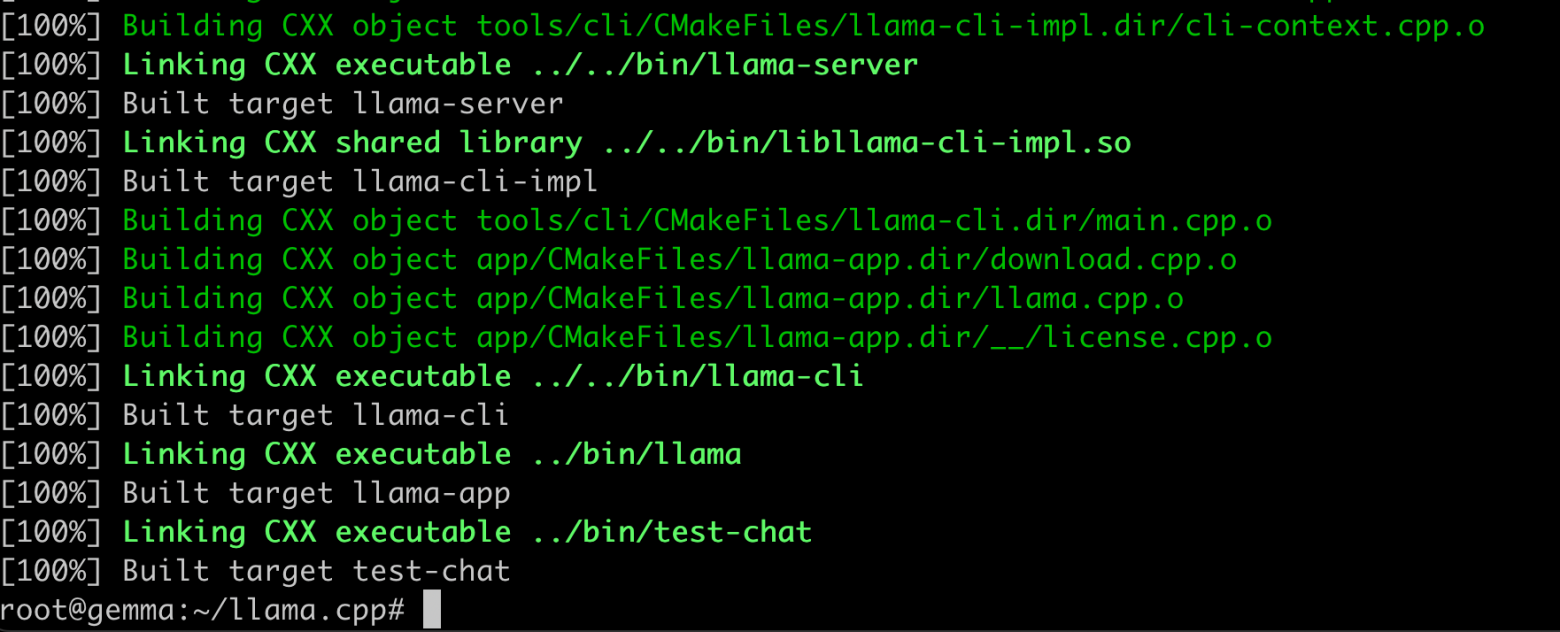
После сборки можно проверить, что llama.cpp видит видеокарту:
./build/bin/llama-server --list-devices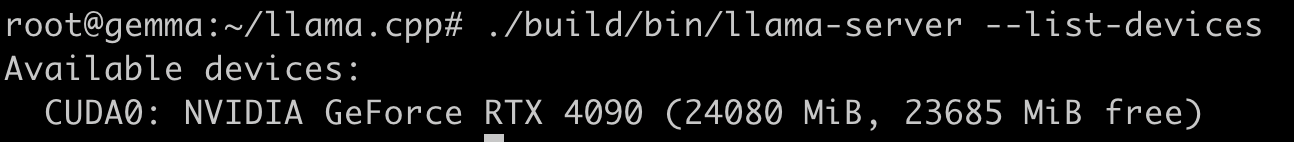
Скачиваем модель
llama.cpp, как и Ollama, умеет загружать модели — достаточно передать репозиторий на Hugging Face через -hf:
./build/bin/llama-cli -hf ggml-org/gemma-4-26B-A4B-it-GGUF:Q4_0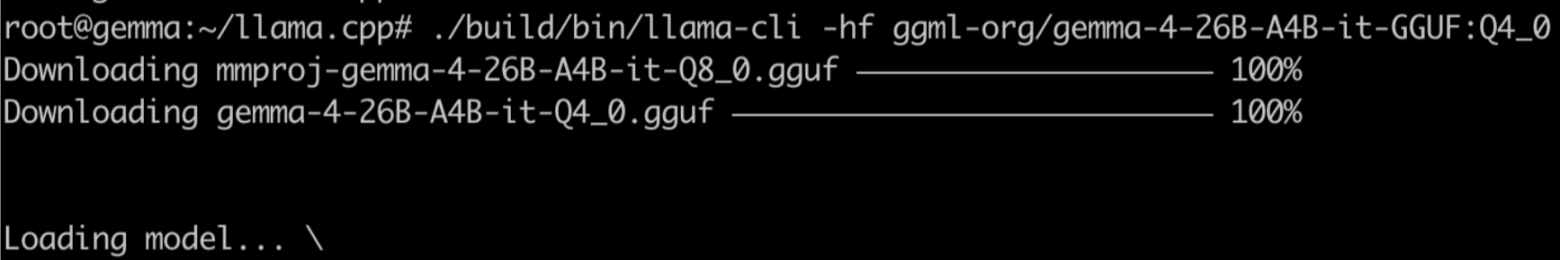
После скачивания мы попадем в CLI-интерфейс, пока он нам не нужен, пишем /exit и Ctrl+C для выхода.
Запускаем llama-server
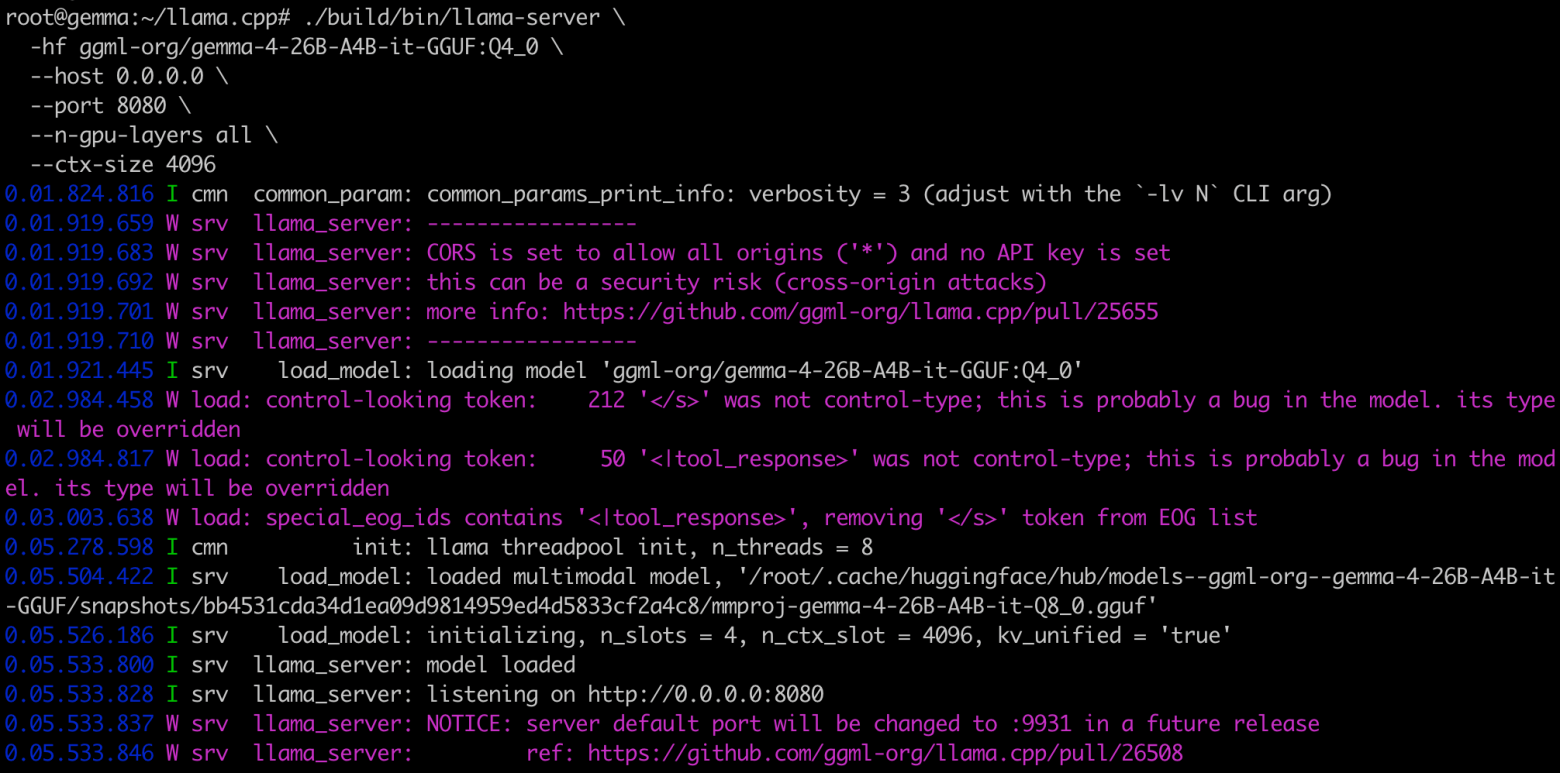
У llama.cpp есть собственный сервер с HTTP API, во многом совместимый с OpenAI. Для честного сравнения с Ollama, пока запустим его в том же режиме — просто выгружаем все на GPU, без ручной настройки:
./build/bin/llama-server
  -hf ggml-org/gemma-4-26B-A4B-it-GGUF:Q4_0
  --host 0.0.0.0
  --port 8080
  --n-gpu-layers all
  --ctx-size 4096
  --parallel 1
--n-gpu-layers all — это позволит разместить на GPU максимально возможное количество слоев модели. --ctx-size 4096 — а так можно задать размер контекста в 4 096 токенов.
Проверяем API
curl http://localhost:8080/v1/chat/completions
  -H "Content-Type: application/json"
  -d '{
    "model": "gemma-4-26b-a4b",
    "messages": [
      {
        "role": "user",
        "content": "Hello!"
      }
    ],
    "stream": false
  }'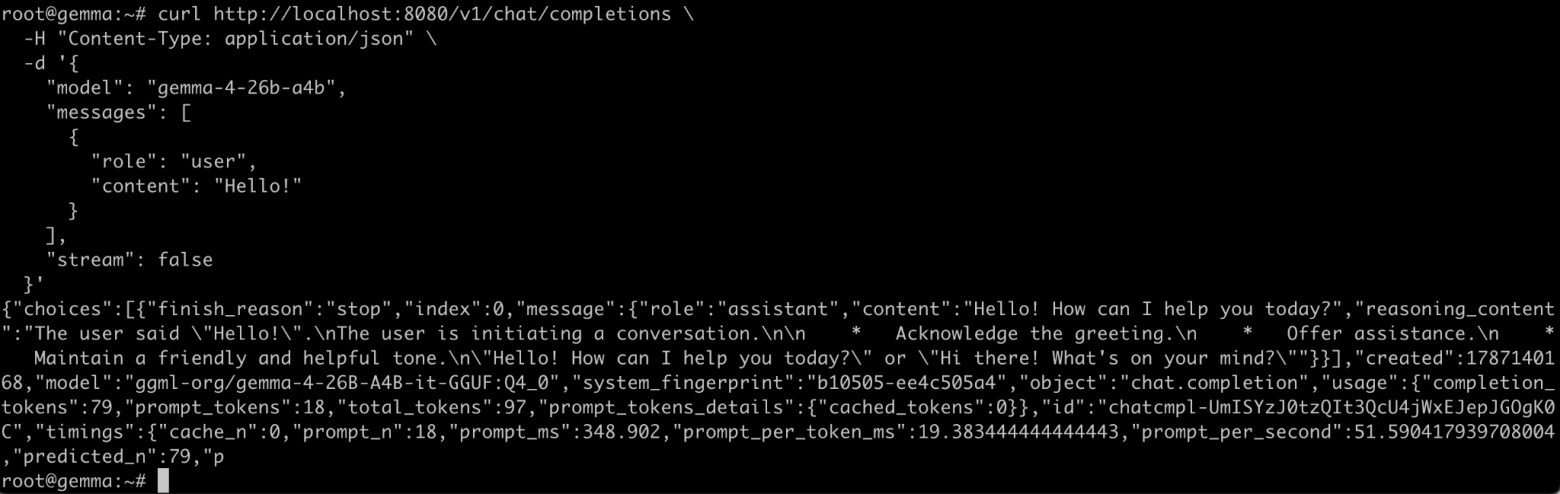
На этом этапе у нас два одинаково работающих сервера с одной и той же моделью в одном и том же кванте. Можно переходить к сравнению.
Бенчмарки
Что будем сравнивать:
-
TTFT (Time To First Token) — сколько времени проходит от отправки запроса до первого токена ответа;
-
ITL (Inter-Token Latency) — задержка между следующими токенами;
-
Output tokens/s — скорость генерации;
-
Request latency — полное время выполнения запроса.
Ручные тесты очень утомительны. А для объективности их нужно повторить несколько раз, поэтому воспользуемся инструментом GuideLLM — утилитой для тестирования серверов инференса LLM.
Создадим виртуальное окружение и установим в нем GuideLLM:
apt install -y python3.12-venv
python3 -m venv ~/llm-venv
source ~/llm-venv/bin/activate
pip install -U pip
pip install 'guidellm[recommended]'
Проверим, что утилита работает:
guidellm --version
Для начала посмотрим на результаты в синхронном режиме (с последовательным выполнением запросов по одному), а потом то же самое проверим параллельно.
GuideLLM умеет сам делать разогревочные запросы и генерировать синтетические данные нужного размера. В командах ниже вы увидите параметры prompt_tokens и output_tokens. Они задают длину входа и ответа соответственно.
В тестах будет 32K входных токенов → 256 выходных.
Ollama
Для Ollama нужно гарантировать тот же контекст 33 792, через API размер контекста не задается — для этого лучше создать отдельный model alias через Modelfile.
cat > Modelfile.32k <<'EOF'
FROM hf.co/ggml-org/gemma-4-26B-A4B-it-GGUF:Q4_0
PARAMETER num_ctx 33792
EOF
И сам alias:
ollama create gemma4-q4_0-32k -f Modelfile.32k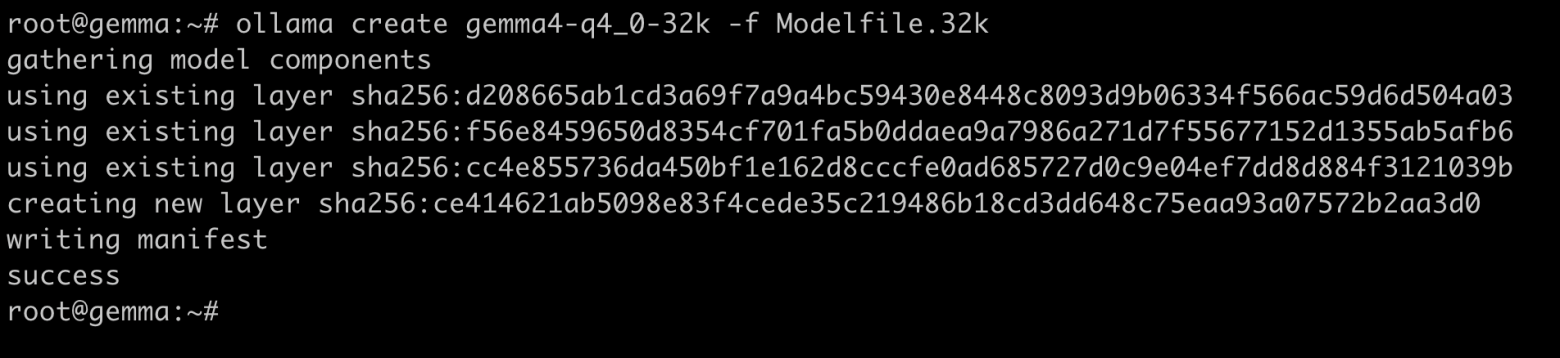
Проверяем:
ollama show gemma4-q4_0-32k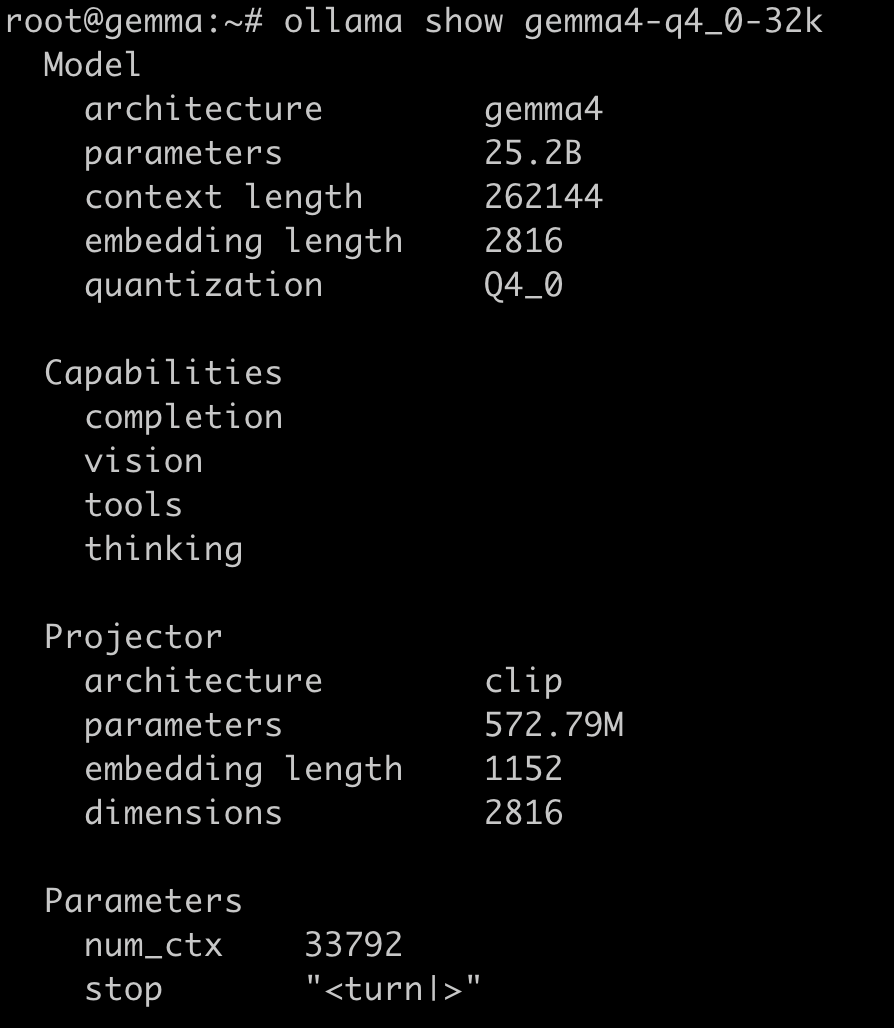
Параметр установлен, идем дальше. Проверим базовый сценарий без параллельной нагрузки: сервер обрабатывает один запрос за раз. Каждый запрос содержит около 32K входных токенов, а ответ ограничен 256 токенами. Всего GuideLLM выполнит 30 одинаковых по размеру запросов.
guidellm run
  --backend '{"kind":"openai_http","target":"http://localhost:11434","model":"gemma4-q4_0-32k","request_format":"/v1/chat/completions","validate_backend":false,"extras":{"body":{"max_tokens":256}}}'
  --tokenizer kind=huggingface_auto,model=google/gemma-4-26B-A4B-it
  --profile kind=synchronous
  --data kind=synthetic_text,prompt_tokens=32768,output_tokens=256
  --constraint kind=max_requests,count=30
  --seed kind=static,value=42
  --output kind=json,path=ollama-32k-sync.json
  --output kind=csv,path=ollama-32k-sync.csv
  --output kind=html,path=ollama-32k-sync.html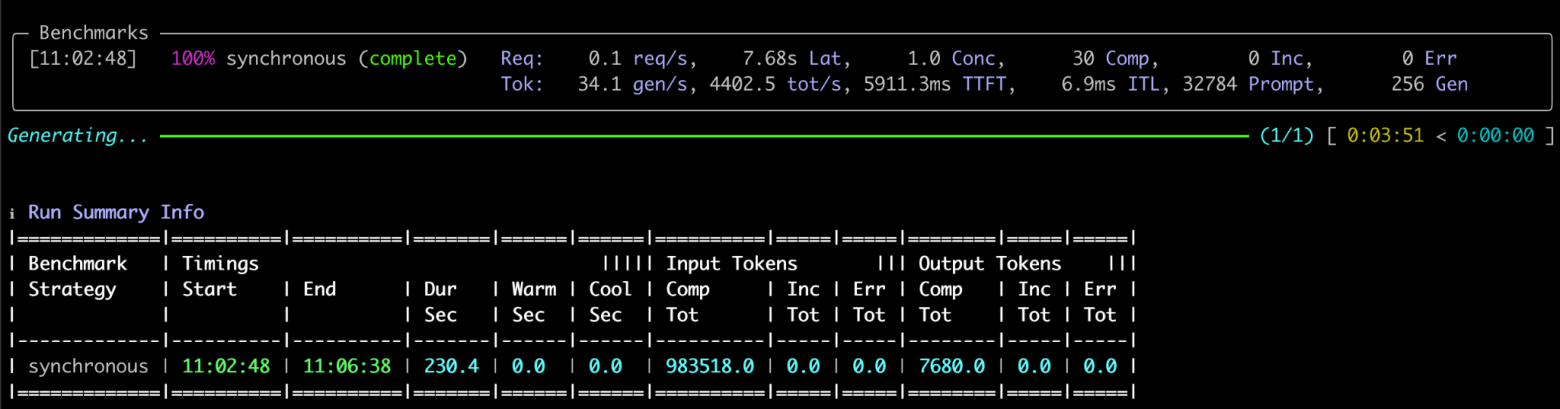
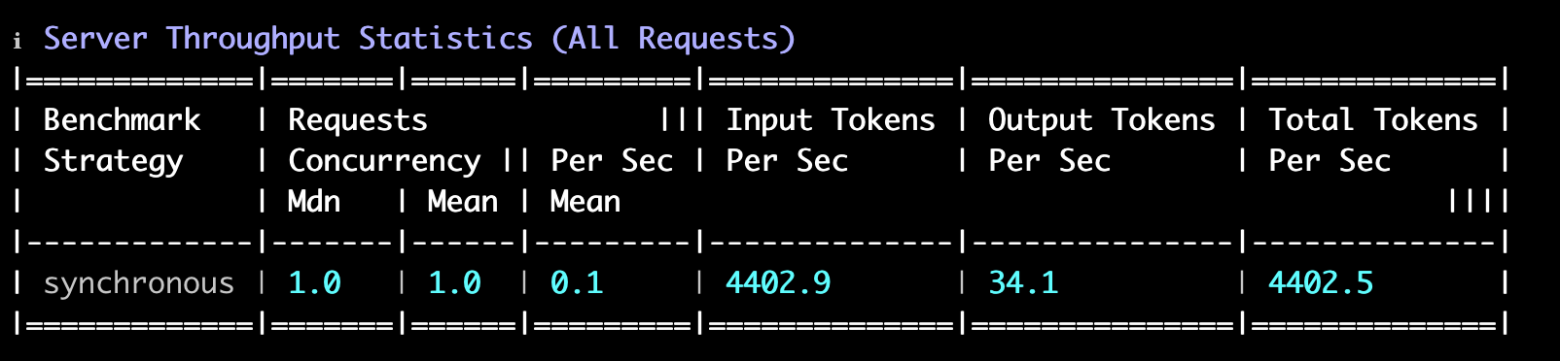
Все 30 запросов завершились успешно. Медианное время выполнения одного запроса составило 7,7 с, из них около 5,9 с пришлось на ожидание первого токена. После начала генерации задержка между токенами составила 6,9 мс. Сервер выдавал в среднем 34,1 выходного токена в секунду.
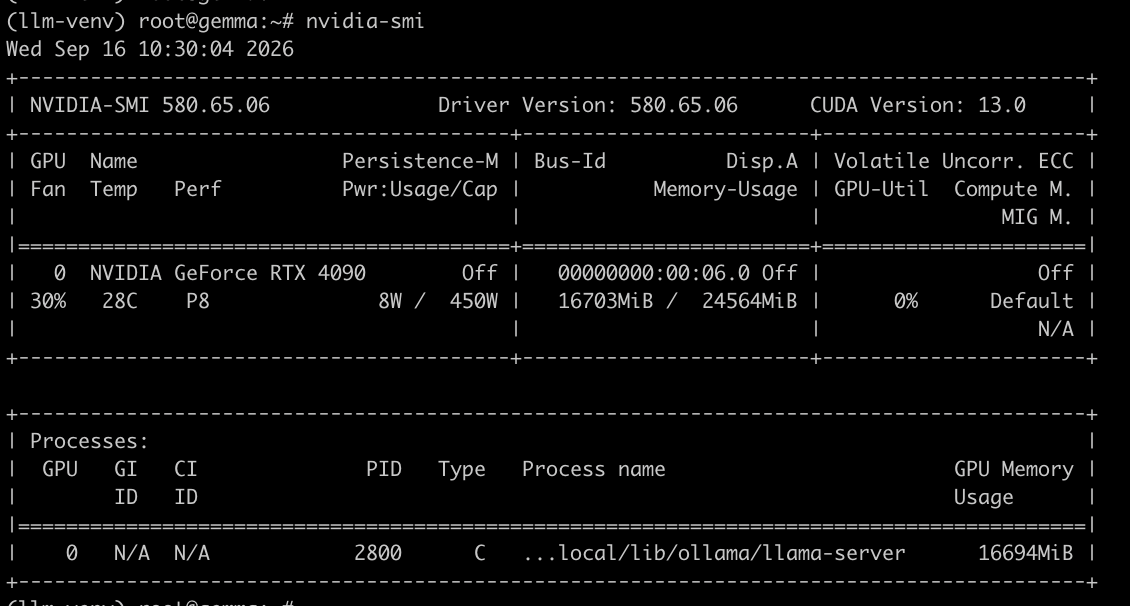
При этом модель с контекстом 32K занимала около 16,7 ГБ VRAM.
Text Metrics и Request Token во всех остальных останутся такими же, поэтому в дальнейшем опустим их. Фактический размер входа составил около 32 800 токенов, выхода — 256 токенов.
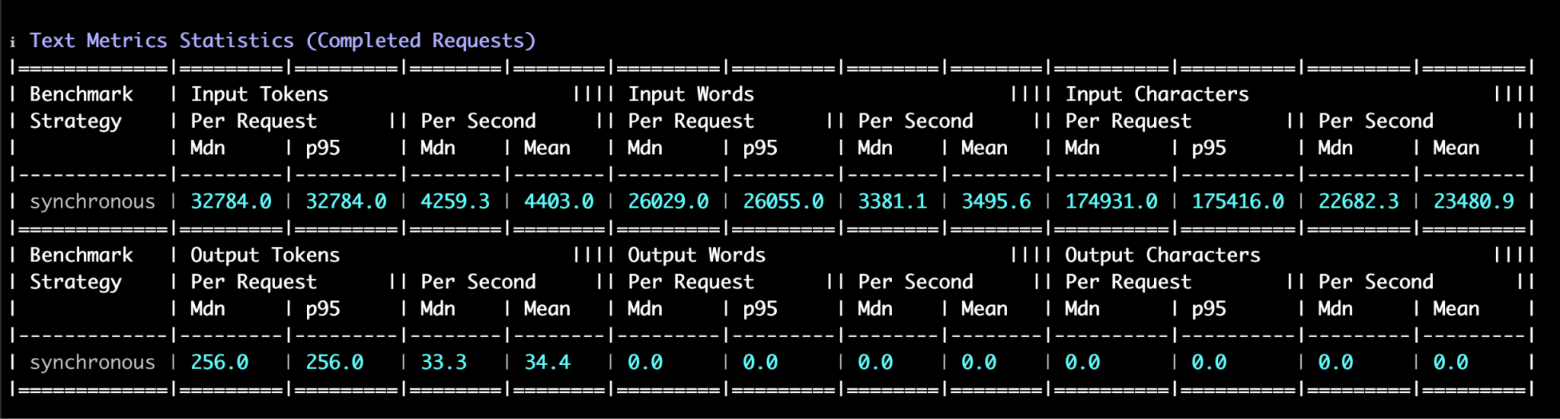
На один запрос пришлось 32 784 входных и 256 выходных токенов, всего 33 040 токенов.
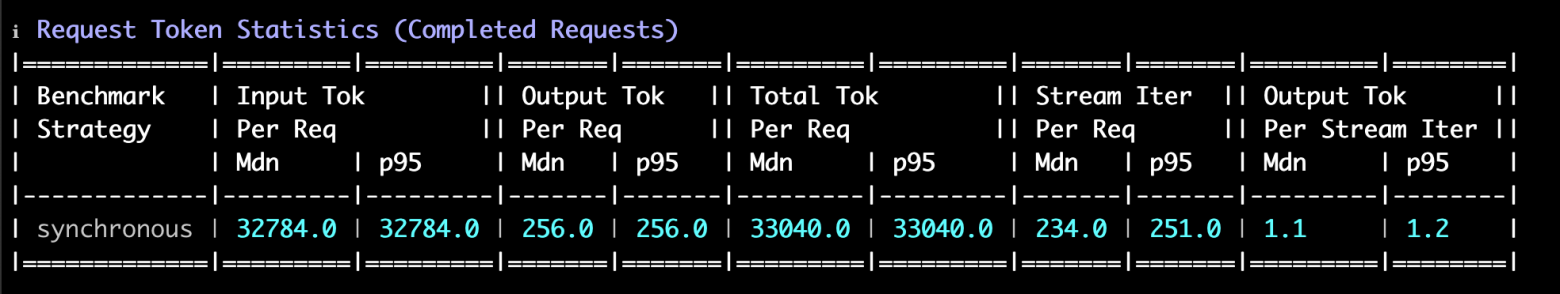
Request Sec Mdn — медианное полное время выполнения запроса составило 7,7 с. первый токен появлялся примерно через 5,9 с, а задержка между последующими токенами составляла около 6,9 мс.
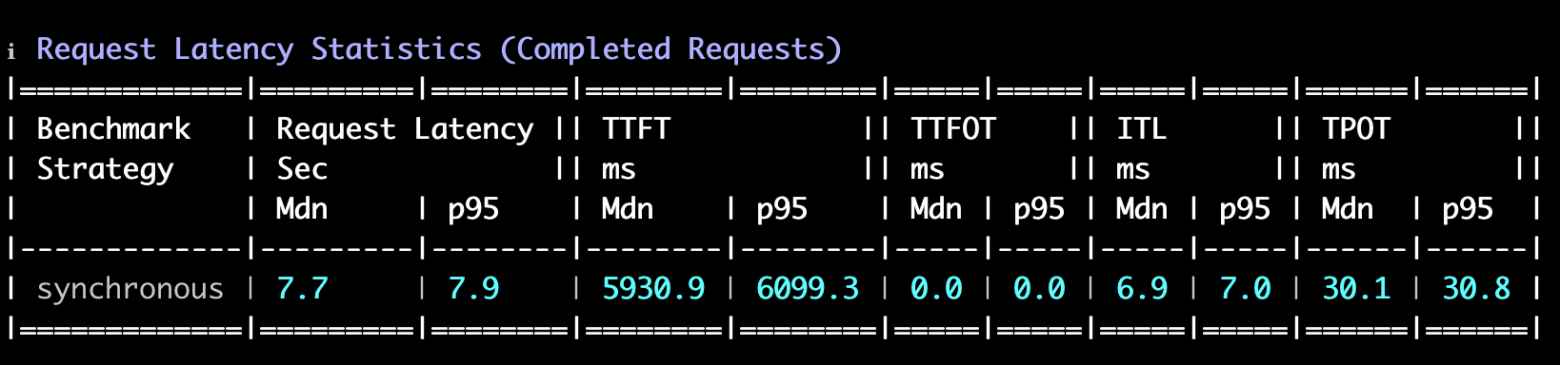
При последовательной обработке сервер выполнял около 0,1 запроса в секунду, обрабатывал примерно 4 403 входных токена/с и выдавал около 34,1 выходного токена/с.
Параллельные запросы. По умолчанию Ollama обрабатывает запросы последовательно. Чтобы два запроса обрабатывались параллельно, нужно увеличить параметр OLLAMA_NUM_PARALLEL до 2.
systemctl edit ollamaДобавим:
[Service]
Environment="OLLAMA_NUM_PARALLEL=2"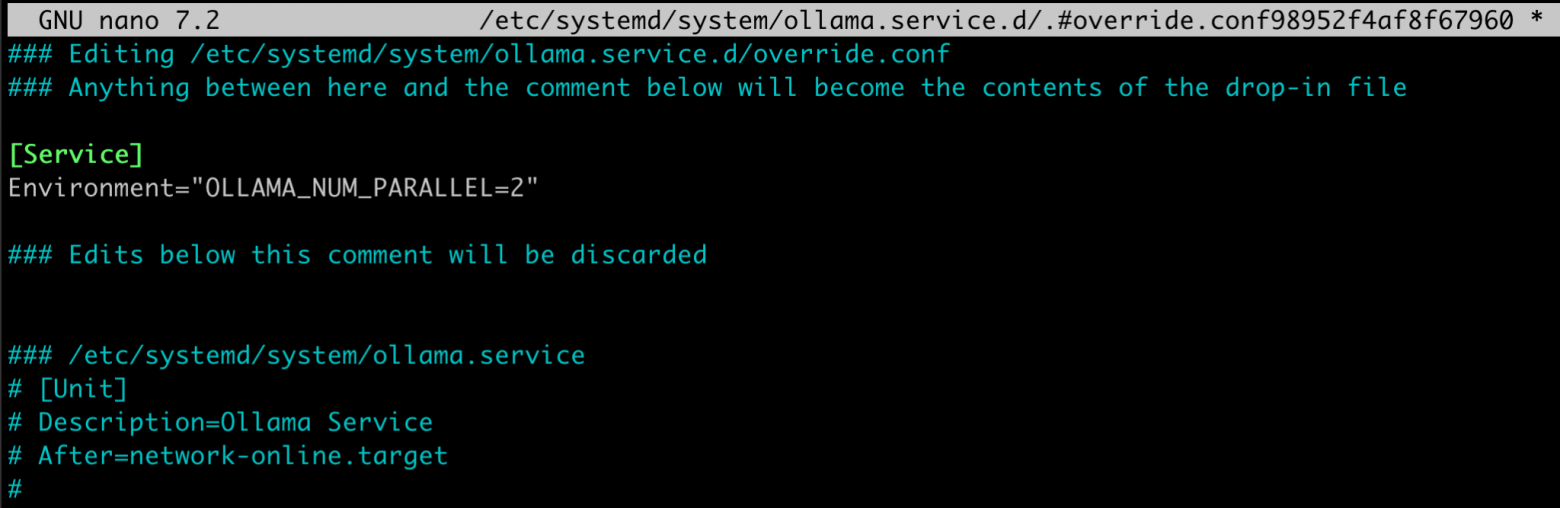
Перезапускаем Ollama:
systemctl daemon-reload
systemctl restart ollama
Запустим тот же тест, но теперь с двумя параллельными запросами:
guidellm run  --backend '{"kind":"openai_http","target":"http://localhost:11434","model":"gemma4-q4_0-32k","request_format":"/v1/chat/completions","validate_backend":false,"extras":{"body":{"max_tokens":256}}}'  --tokenizer kind=huggingface_auto,model=google/gemma-4-26B-A4B-it  --profile kind=concurrent,streams=2  --data
kind=synthetic_text,prompt_tokens=32768,output_tokens=256  --constraint
kind=max_requests,count=30  --seed
kind=static,value=42  --output
kind=json,path=ollama-32k-concurrent-2.json  --output
kind=csv,path=ollama-32k-concurrent-2.csv  --output
kind=html,path=ollama-32k-concurrent-2.html
При двух параллельных запросах медианная задержка составила около 14 секунд, TTFT — примерно 10,3 секунды.
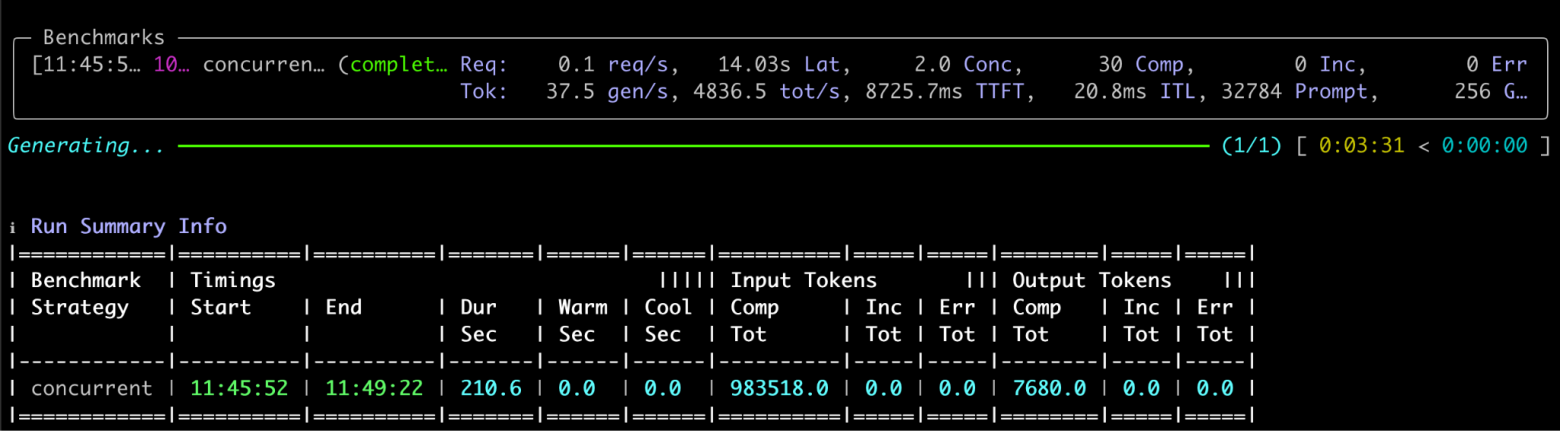
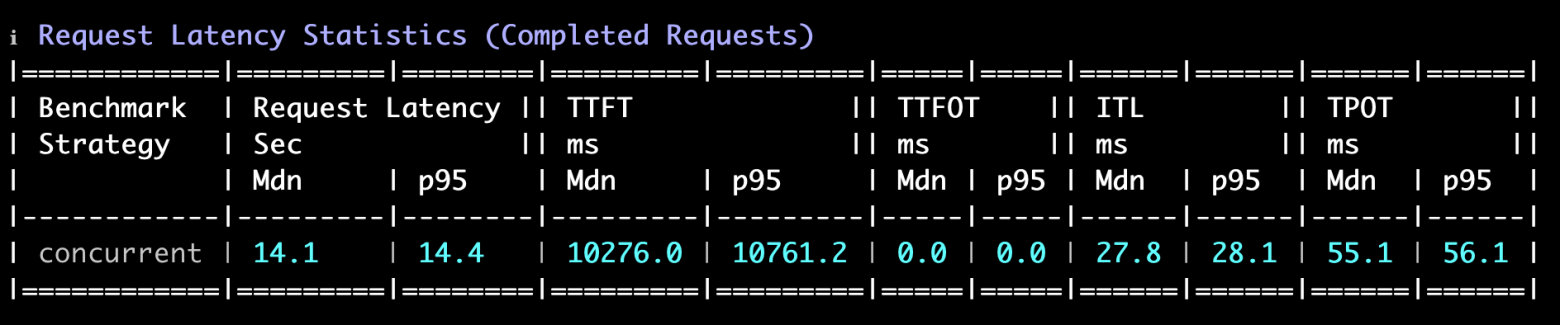
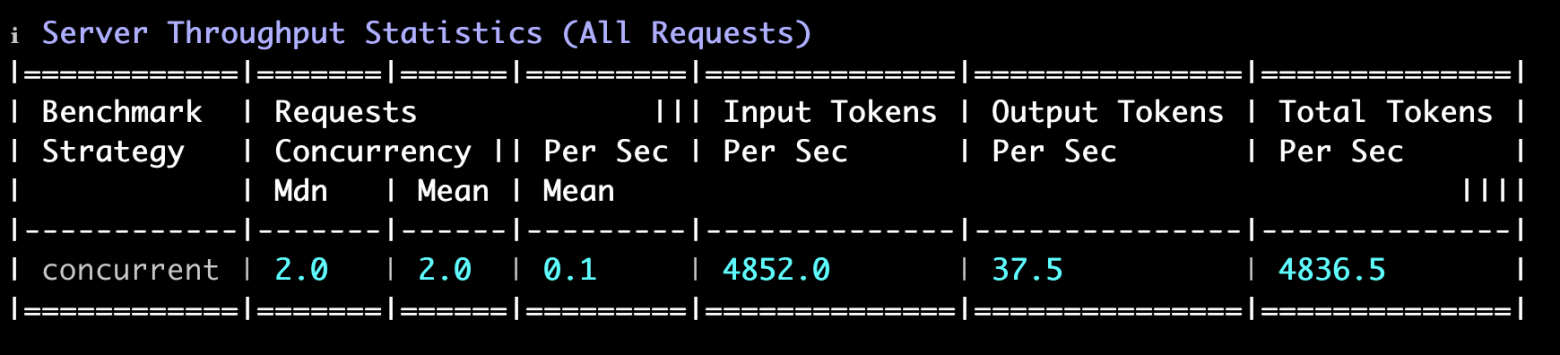
При этом общая скорость генерации выросла умеренно — около 37,5 выходного токена/с и 4 852 входных токенов/с. То есть параллельность немного увеличила throughput, но заметно ухудшила задержку отдельного запроса. Потребление памяти составило 17,4 ГБ VRAM.
Результаты для четырех параллельных запросов: средняя задержка выросла примерно до 28,3 с, TTFT — до 11 с, а общая скорость генерации составила около 36,8 выходного токена/с.
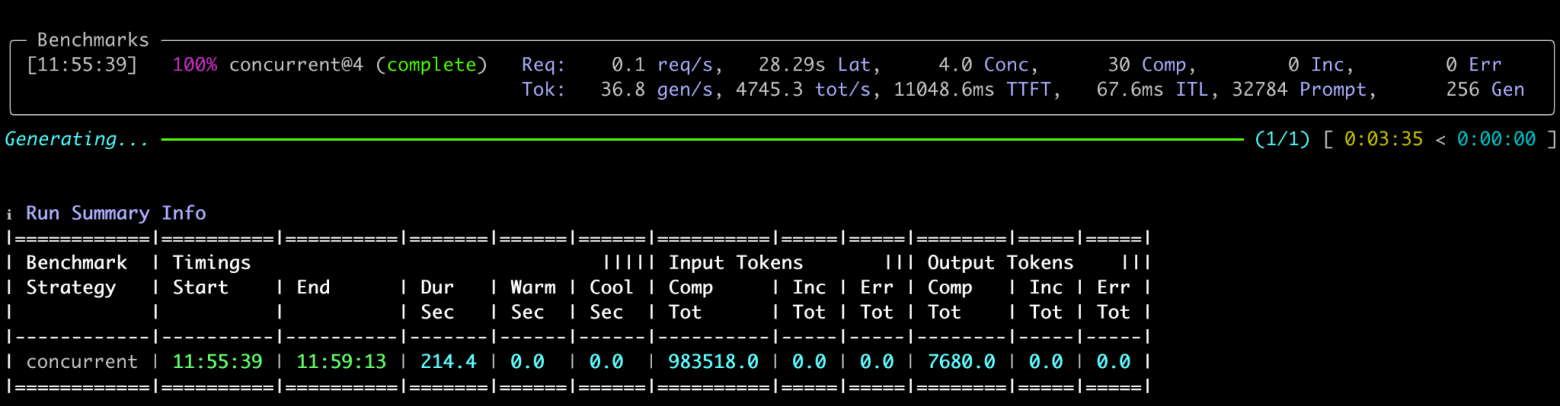
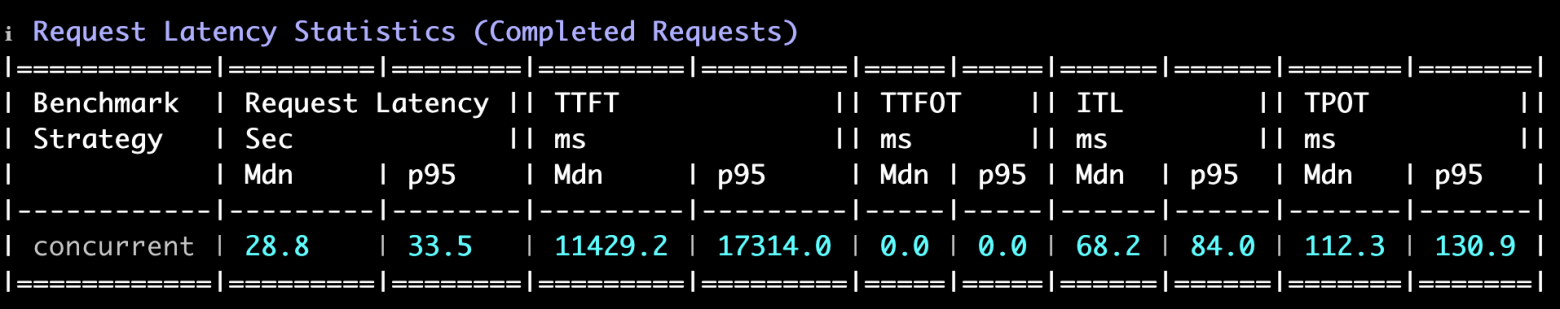
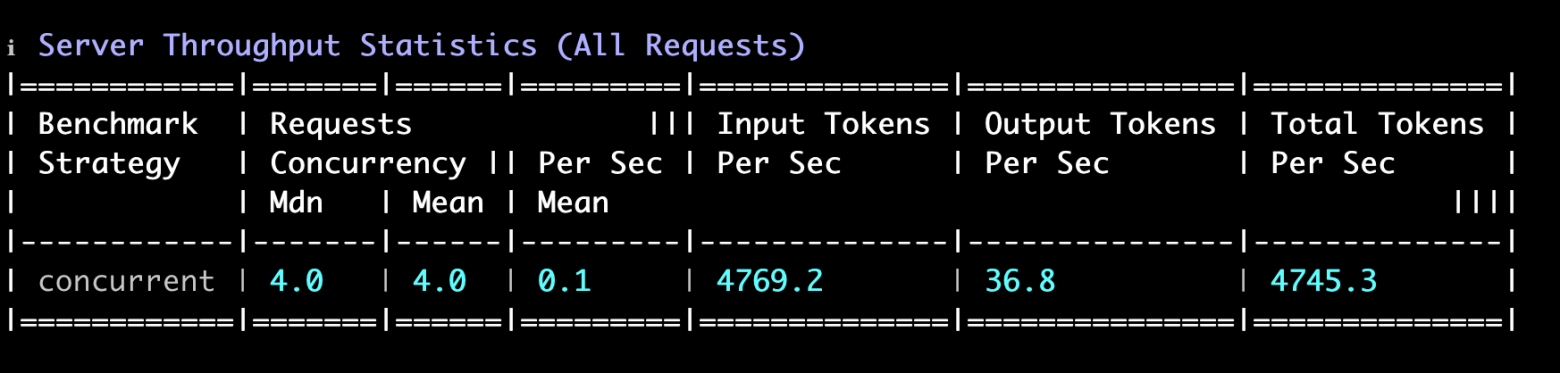
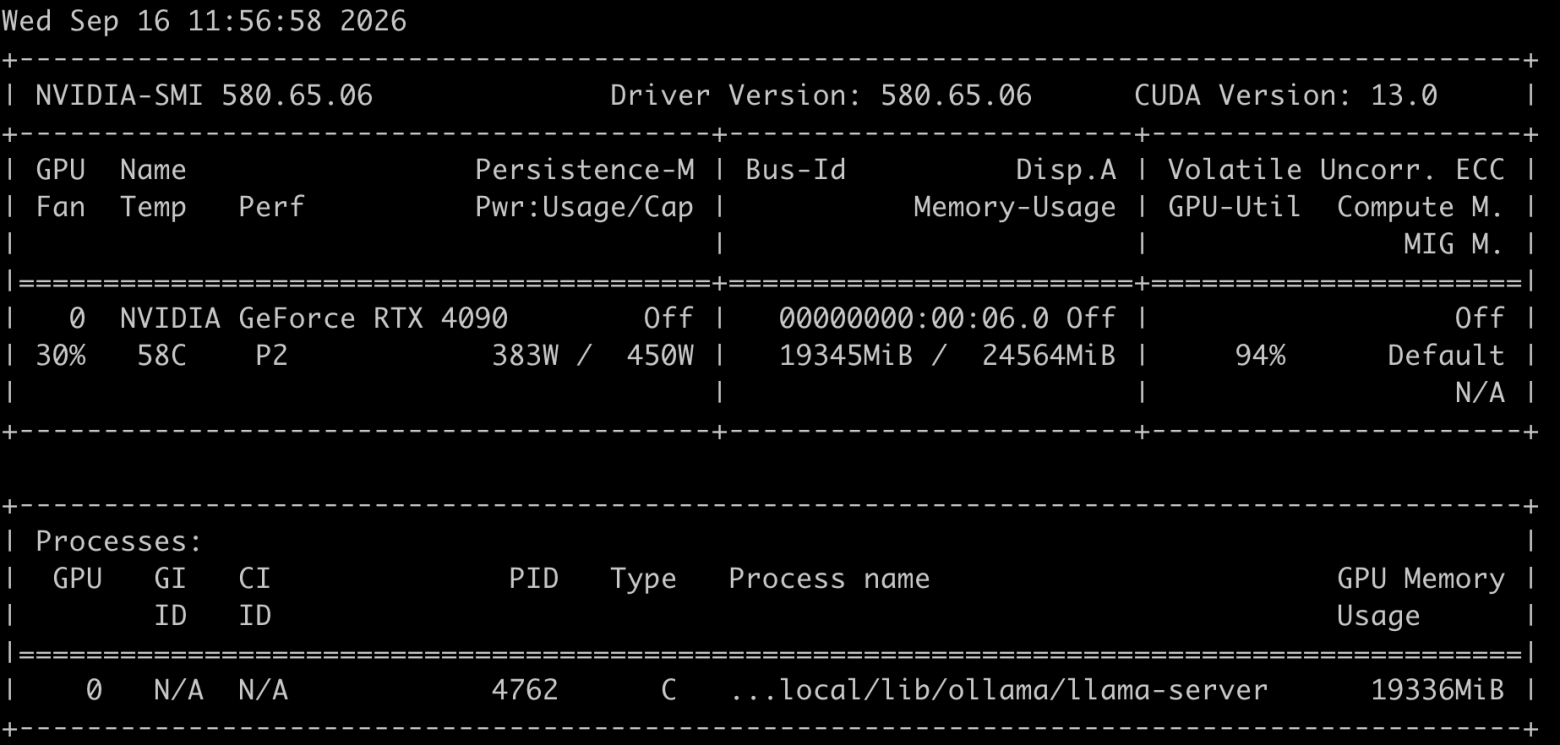
При этом throughput практически перестал расти, а задержка отдельного запроса продолжила увеличиваться. По памяти 19,3 ГБ.
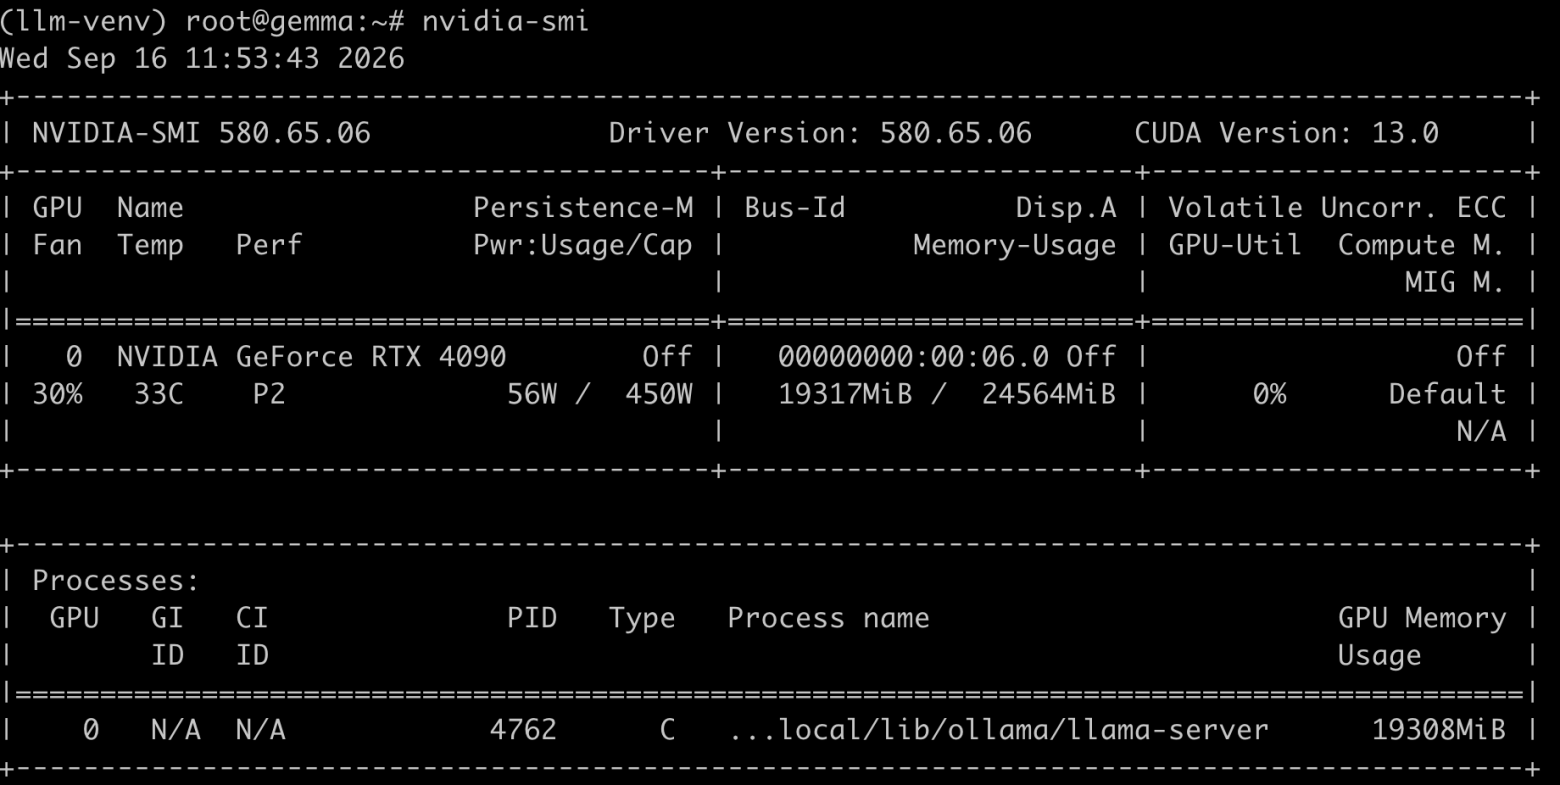
Останавливаем модель в Ollama, чтобы она освободила видеопамять:
ollama stop gemma4-q4_0-32kllama.cpp
Запускаем llama-server с тем же GGUF и размером контекста 32K:
./build/bin/llama-server
  -hf ggml-org/gemma-4-26B-A4B-it-GGUF:Q4_0
  --host 127.0.0.1
  --port 8080
  --n-gpu-layers all
  --ctx-size 33792
  --parallel 1
И запускаем тест — 30 последовательных запросов, 32K входных токенов и 256 выходных:
guidellm run
  --backend kind=openai_http,target=http://localhost:8080,request_format=/v1/chat/completions,validate_backend=false
  --tokenizer kind=huggingface_auto,model=google/gemma-4-26B-A4B-it
  --profile kind=synchronous
  --data kind=synthetic_text,prompt_tokens=32768,output_tokens=256
  --constraint kind=max_requests,count=30
  --seed kind=static,value=42
  --output kind=json,path=llamacpp-32k-sync.json
  --output kind=csv,path=llamacpp-32k-sync.csv
  --output kind=html,path=llamacpp-32k-sync.html
Медианное время выполнения одного запроса составило 7,5 с, TTFT — около 5,7 с, а задержка между токенами — 6,9 мс. Сервер выдавал примерно 35,2 выходного токена/с и обрабатывал около 4 541 входного токена/с.
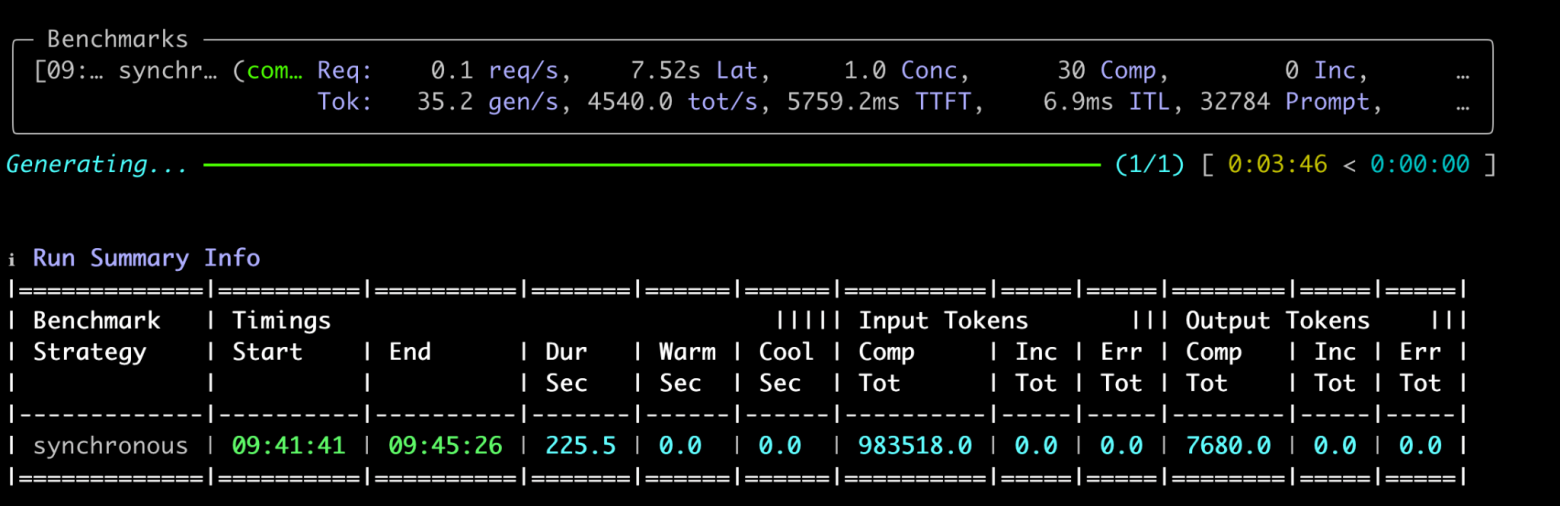
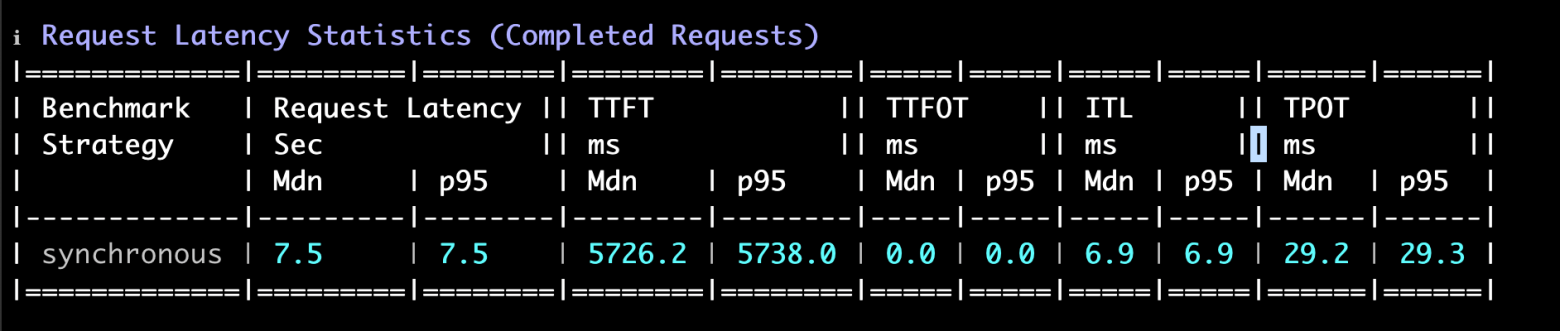
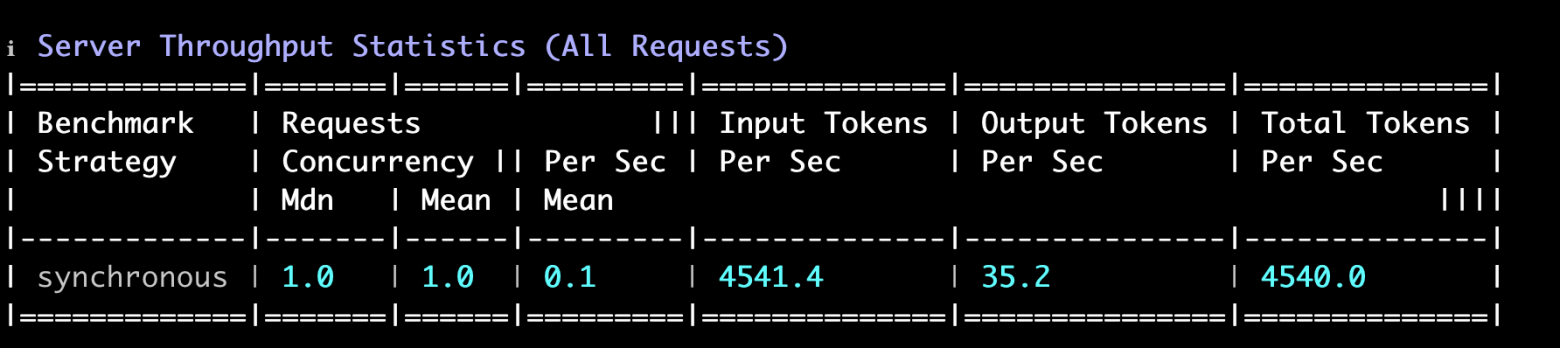
По памяти примерно так же — 16,4 ГБ VRAM. Перезапустим сервер для теста параллельных запросов:
./build/bin/llama-server
  -hf ggml-org/gemma-4-26B-A4B-it-GGUF:Q4_0
  --host 127.0.0.1
  --port 8080
  --n-gpu-layers all
  --parallel 2
  --kv-unified-per-slot 33792
Запустим тест на два параллельных запроса:
guidellm run
  --backend kind=openai_http,target=http://localhost:8080,request_format=/v1/chat/completions,validate_backend=false
  --tokenizer kind=huggingface_auto,model=google/gemma-4-26B-A4B-it
  --profile kind=concurrent,streams=2
  --data kind=synthetic_text,prompt_tokens=32768,output_tokens=256
  --constraint kind=max_requests,count=30
  --seed kind=static,value=42
  --output kind=json,path=llamacpp-32k-concurrent-2.json
  --output kind=csv,path=llamacpp-32k-concurrent-2.csv
  --output kind=html,path=llamacpp-32k-concurrent-2.html
При двух параллельных запросах медианное время выполнения выросло до 13,9 с, TTFT — до 10,3 с, а задержка между токенами — до 24,3 мс.
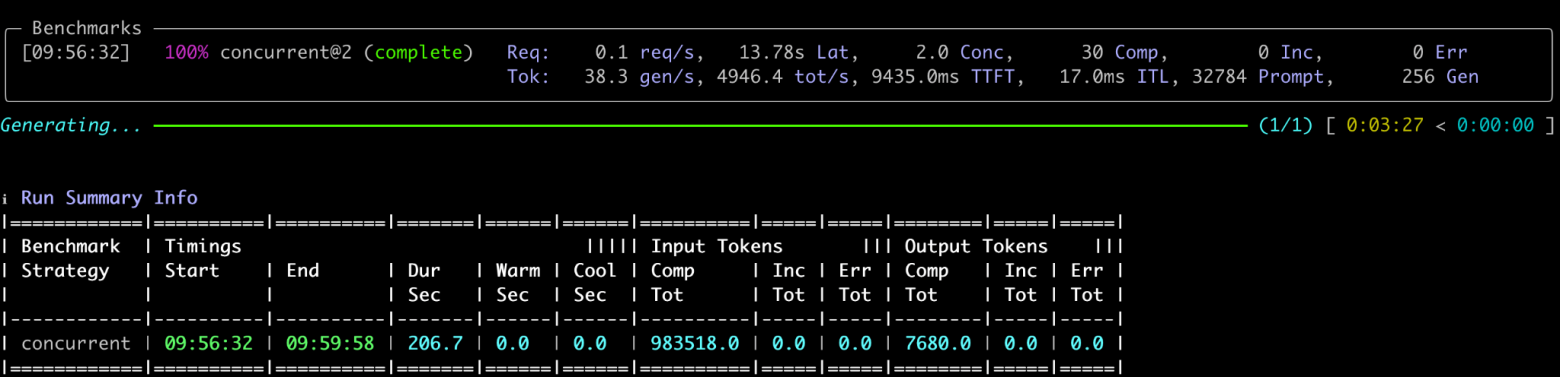
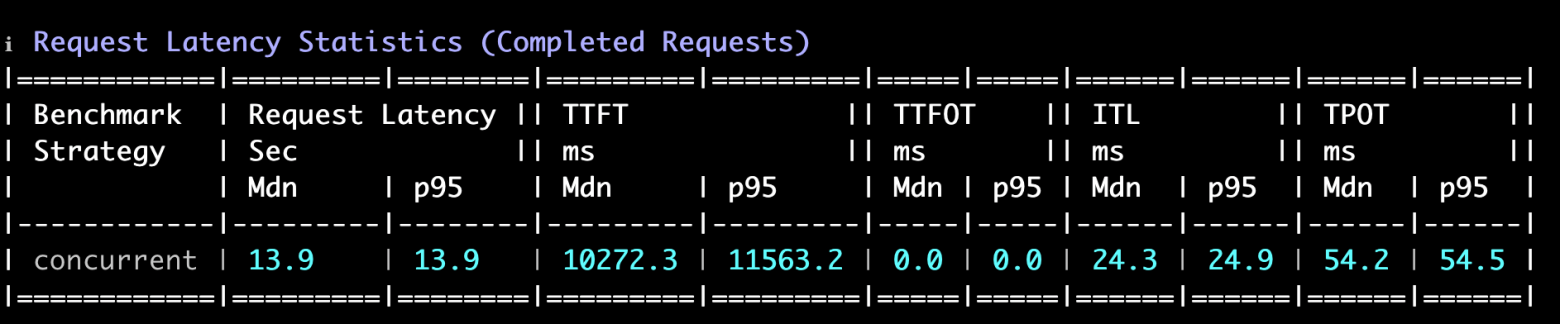
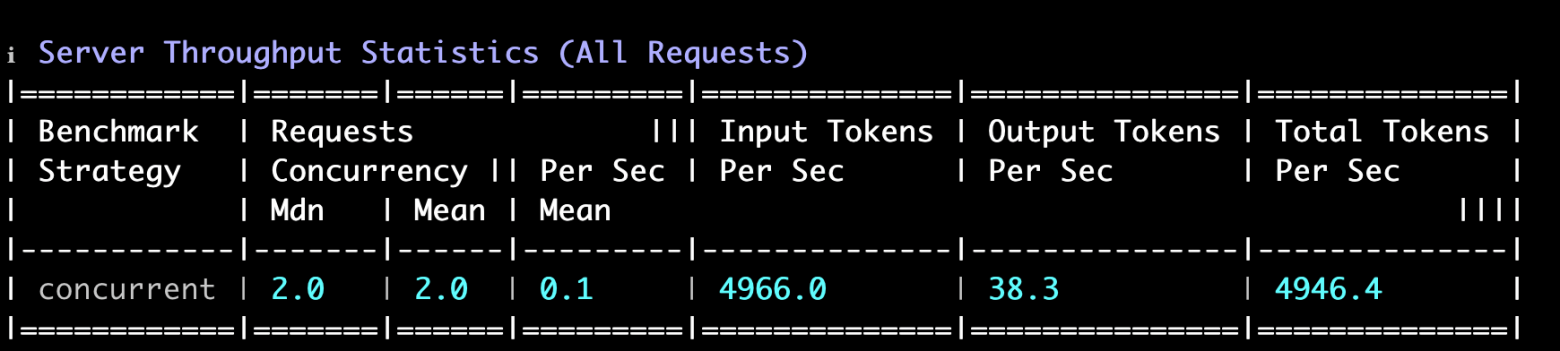
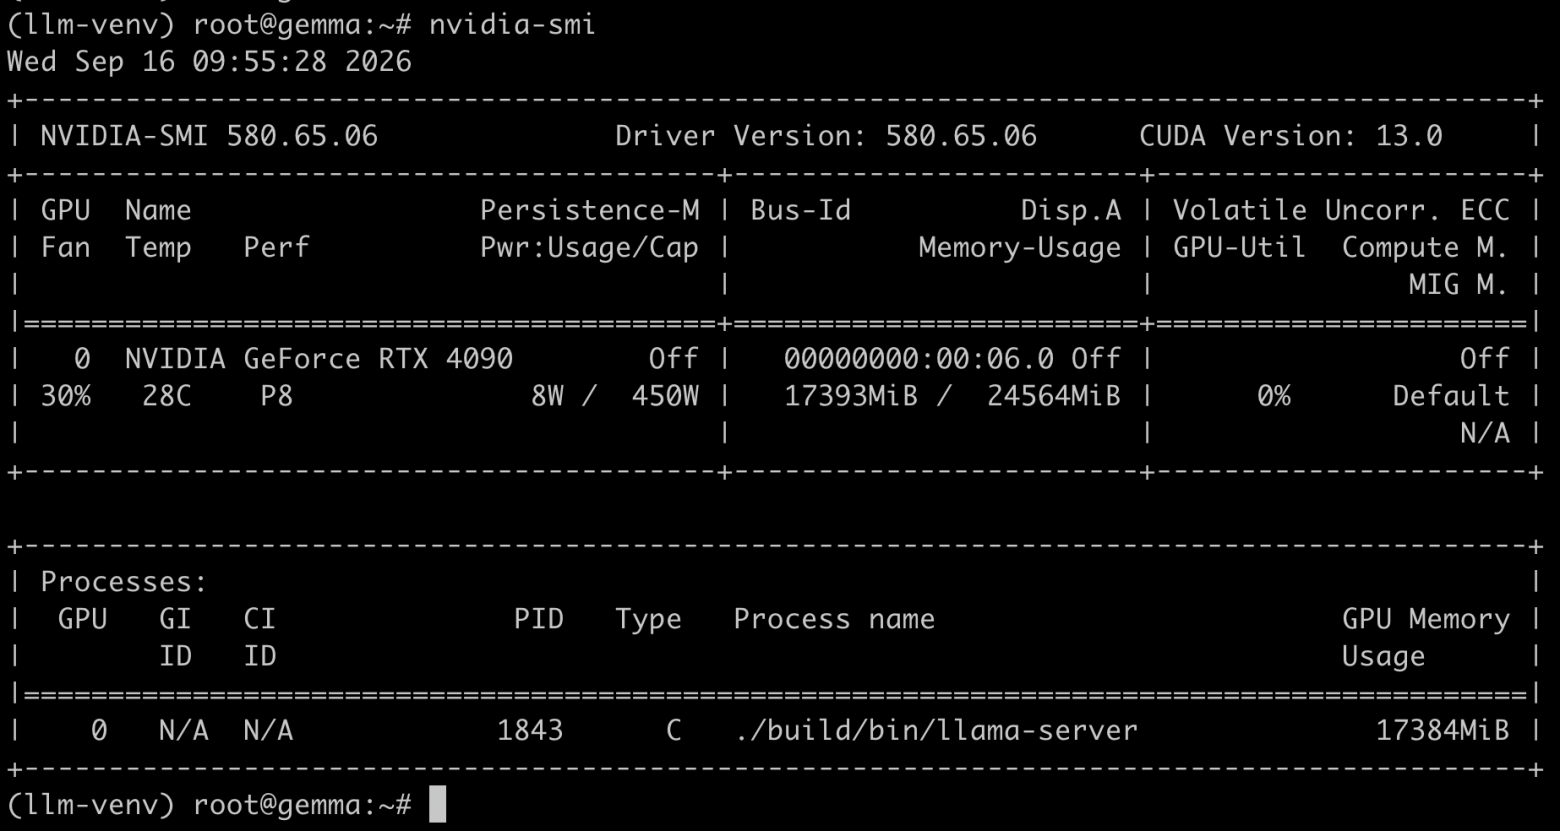
При этом общая пропускная способность сервера увеличилась до 38,3 выходных токена/с и примерно 4 966 входных токенов/с. То есть, как и в случае с Ollama, параллельность немного повысила throughput, но заметно увеличила задержку отдельного запроса. Потребление памяти выросло до 17,4 ГБ VRAM.
Осталось проверить для четырех параллельных запросов. Перезапустим llama-server, увеличив –parallel до 4, а в GuideLLM укажем streams=4.
При четырех параллельных запросах медианное время выполнения выросло до 27 с, TTFT — до 11,3 с, а задержка между токенами — до 62,2 мс.
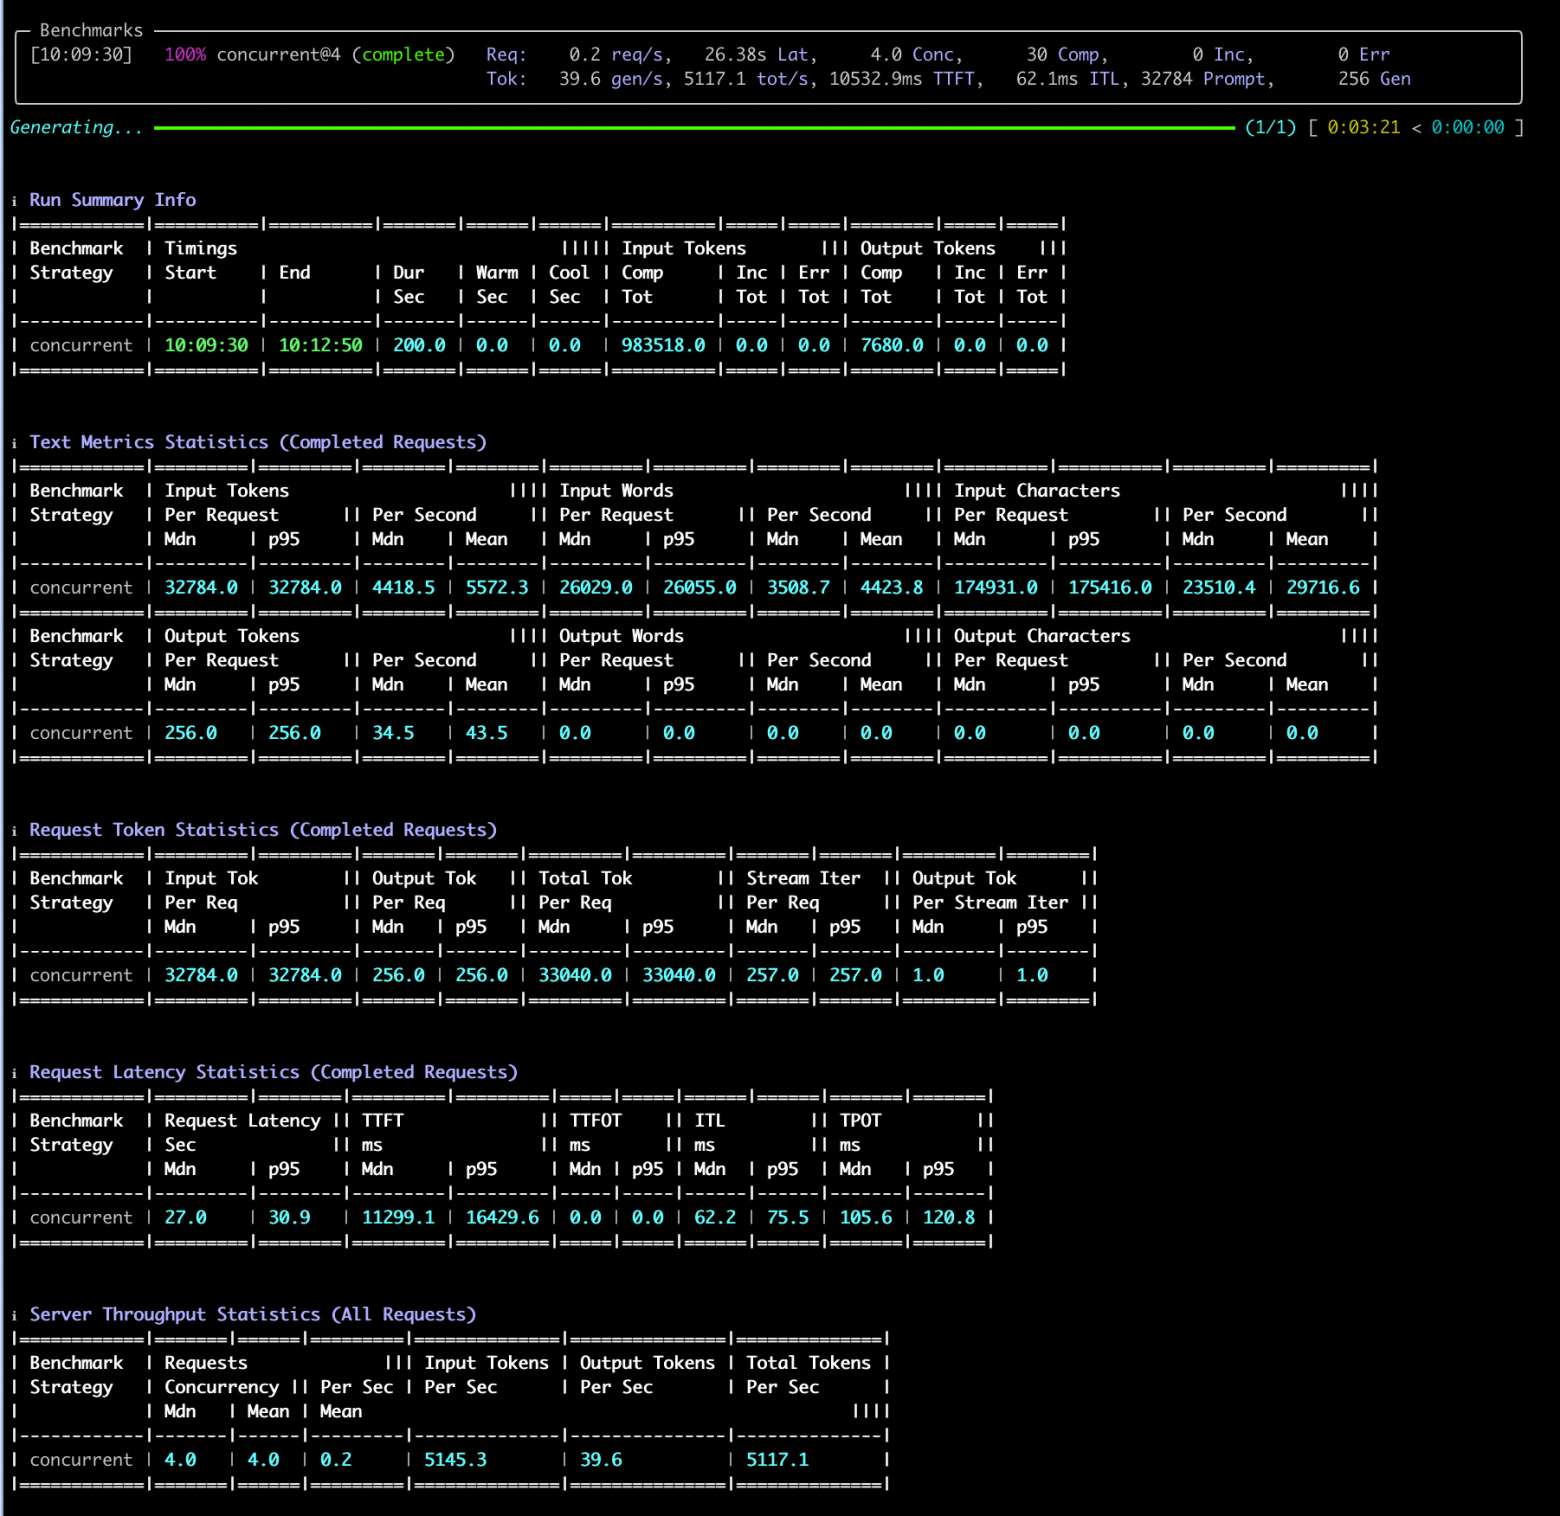
При этом общая пропускная способность увеличилась лишь до 39,6 выходного токена/с и примерно 5 145 входных токенов/с. То есть переход с двух параллельных запросов на четыре дал небольшой прирост throughput, но почти вдвое увеличил задержку отдельного запроса. Потребление VRAM при этом выросло примерно до 19,3 ГБ.
Выводы
|
Backend |
Concurrency |
Latency |
TTFT |
ITL |
Output tok/s |
Input tok/s |
VRAM |
|
Ollama |
1 |
7,7 с |
5,93 с |
6,9 мс |
34,1 |
4 403 |
~16,7 ГБ |
|
llama.cpp |
1 |
7,5 с |
5,73 с |
6,9 мс |
35,2 |
4 541 |
~16,5 ГБ |
|
Ollama |
2 |
14,1 с |
10,28 с |
27,8 мс |
37,5 |
4 852 |
~17,4 ГБ |
|
llama.cpp |
2 |
13,9 с |
10,27 с |
24,3 мс |
38,3 |
4 966 |
~17,4 ГБ |
|
Ollama |
4 |
28,8 с |
11,43 с |
68,2 мс |
36,8 |
4 769 |
~19,3 ГБ |
|
llama.cpp |
4 |
27,0 с |
11,30 с |
62,2 мс |
39,6 |
5 145 |
~19,3 ГБ |
Ollama действительно добавляет небольшие накладные расходы, но в наших тестах они оказались не такими драматическими. На одном запросе разница между Ollama и llama.cpp минимальна, но с ростом параллельной нагрузки llama.cpp постепенно отрывается по throughput и задержкам при практически одинаковом потреблении видеопамяти.
За удобный CLI, управление моделями и более простой запуск мы платим несколькими процентами производительности. Единственное, что напрягает в Ollama — это долгий холодный старт после выгрузки модели из памяти, но это можно настроить. Да, llama.cpp мы тоже никак не тюнили, хотелось сравнить, что называется, «из коробки».
Если вы планируете запускать LLM преимущественно на CPU или вам нужно больше гибкости, есть смысл немного разобраться и выбрать llama.cpp
ИИ‑роутер — доступ к 300+ моделям из одной панели
Подключите OpenAI‑совместимый шлюз по единому API‑ключу. Настраивайте сквозную аналитику, отслеживайте лимиты и квотируйте ресурсы.
Автор: automagician

