


Привет! На связи Андрей Безруков из команды Авито Рекламы. Если вы работаете с обратной связью от пользователей, то наверняка понимаете, что для разбора нужно не только увидеть комментарий о проблеме, но и понять её точный смысл, сохранить все затронутые темы и применить консистентные правила разметки. Наша команда собрала для этого систему из специализированных ИИ-агентов, Python-помощника и обновляемой таксономии.
В этой статье рассказываем, как распределить задачи между инструментами, чтобы они действительно помогали вам быстрее анализировать фидбэк.
Содержание
• Какой была задача
• Как мы пришли к конвейеру
• Глоссарий
• Один комментарий — не всегда одна проблема
• Почему одного агента недостаточно
• Как устроена команда агентов
• Фантастические правила и где они обитают
• Какие ошибки мы учли
• Как мы проверяем качество
• Эталон тоже нужно проверять
• Что система гарантирует, а что нет
• Что получается на выходе
• Как мы используем систему на практике
• Обращение к любимым пользователям
Какой была задача
Когда мы только запустили кабинет Авито Рекламы в июне 2025 года, то регулярно читали от и до все комментарии пользователей. Это очень помогало точнее расставлять приоритеты в бэклоге и быстрее улучшать сервис.
Через год пользователей стало на порядки больше, а продуктовая команда выросла и разделила зоны ответственности. Читать, систематизировать и распределять весь поток вручную стало сложно.
Авито Реклама — это инструмент, который помогает бизнесу привлекать внимание потенциальных клиентов к товарам и услугам.
С помощью рекламных баннеров и видео компании могут:
увеличивать охват и поддерживать имидж бренда;
побуждать пользователя к целевому действию: совершить покупку, оставить заявку или принять участие в акции;
привлекать заинтересованных клиентов на свой сайт, в соцсети или приложение.
Нужно было находить дубли (сообщения одного пользователя по одной теме), выделять и сохранять несколько смыслов внутри одного комментария, оценивать веса тем, распределять фидбэк между командами и готовить содержательные сводки.
Что важнее: одна и та же проблема у нескольких пользователей, которые запускают сотни кампаний, или у сотни пользователей с одной-двумя кампаниями? Это имеется в виду под весами.
При этом разметка должна была строго следовать правилам, сформулированным UX-исследователями, а исходный текст пользователя нужно было сохранять для последующего анализа.
Как мы пришли к конвейеру
Сначала мы попробовали решить вопрос одним агентом: передали ему комментарии, большой список правил и попросили вернуть готовые метки. На коротких примерах это работало, но на длинной очереди качество снижалось. Одной модели приходилось одновременно понимать текст, помнить сотни близких правил, проверять собственный выбор, соблюдать формат и работать с данными.
Поэтому дальше процесс разделили на независимые мини-роли. Смысловые решения оставили ИИ-агентам, а повторяемые и проверяемые операции передали Python. Так знания UX-исследователей одинаково применяются ко всей очереди, а на выходе получается структурированная обратная связь, пригодная для продуктовой работы.
Глоссарий
-
Смысловая тема — одна самостоятельная мысль пользователя, которая может потребовать отдельной реакции продукта.
-
Консёрн — название конкретной боли, вопроса или продуктового запроса.
-
Тег — более широкая продуктовая область: модерация, финансы, таргетинг, поддержка и другие.
-
Таксономия — общий справочник консёрнов, тегов и условий их применения.
-
Субагент — отдельный ИИ-исполнитель с одной ролью, короткой инструкцией и чистым контекстом.
-
Бакет — группа до 50 комментариев, которая проходит весь конвейер как независимая часть запуска.
-
Манифест — служебный список бакетов, их статусов и результатов обработки.
Один комментарий — не всегда одна проблема
Пользователь пишет обратную связь в свободной форме и может одновременно упомянуть модерацию, статистику, поддержку и бюджет. Если сразу искать только одну подходящую метку, часть информации неизбежно потеряется.
Например, фраза «Объявление отклонили без понятного объяснения, поддержка не отвечает, а по креативам не хватает статистики» содержит три темы: неясная причина отклонения, медленный ответ поддержки и недостаточная статистика по креативам.
Единица анализа — не комментарий целиком, а смысловая тема внутри него. Система сначала находит все самостоятельные темы, затем классифицирует каждую и только после этого объединяет результаты в разметку исходного комментария. Такой подход близок к принципу атомарности в исследовательских базах знаний: наблюдение разбивается на минимальные самостоятельные единицы, которые можно повторно использовать в разных аналитических срезах.
Почему одного агента недостаточно
Потому что в одной задаче смешиваются разные виды работ!
Найти все мысли, выбрать точное правило, провести проверку, соблюсти формат и записать данные — всё это разные задачи. Когда модель выполняет их одновременно, получается каша, которую надо расхлёбывать человеку. Но мы стремимся к повышению эффективности, а не наоборот.
Если вы доверяете ИИ разбор фидбэка, нужно помнить три аксиомы:
-
Самопроверка не бывает полностью независимой. После выбора консёрна модель «помнит», как приняла решение, и при повторной проверке склонна его подтверждать. Отдельный проверяющий получает результат в новом контексте и поэтому способен заметить несоответствие тексту или правилу.
-
Большой контекст размывает внимание. Сотни комментариев, близкие категории и длинные инструкции конкурируют за внимание модели. Чем шире контекст, тем выше риск объединить разные темы, пропустить редкое правило или принять завершение одного этапа за конец всей задачи.
-
Агенты тоже устают и ленятся! После долгой работы модель начинает чаще упрощать решения. Причина обычно кроется в перегруженном контексте, нескольких конкурирующих задачах или недостаточно явном критерии завершения.
Для таких задач, как наша, требуется что-то наподобие микросервисной архитектуры, но применительно к ИИ-агентам.
Как устроена команда агентов
В нашей системе есть управляющий агент, Python-помощник, контроллер запуска и несколько семантических субагентов. Каждый получает только те данные, которые необходимы конкретно для его роли.
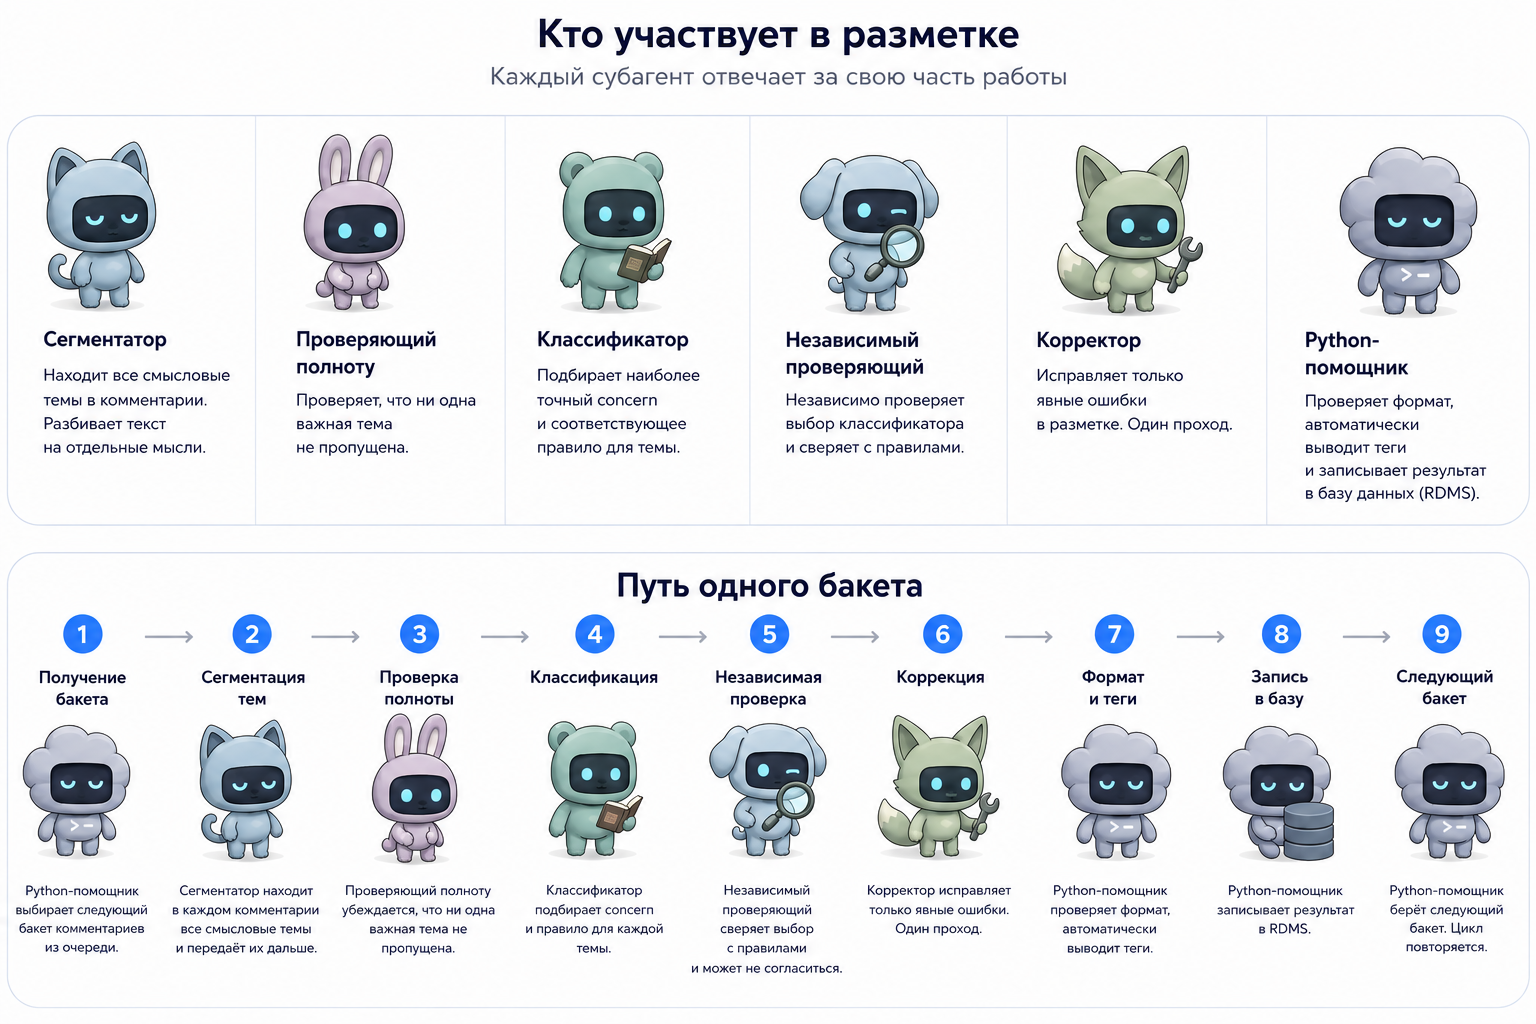
Python-помощник формирует очередь: забирает неразмеченные комментарии из единого источника, фиксирует состав выборки и текущую версию правил, делит очередь на бакеты и создаёт манифест. Уже размеченные строки не подмешиваются в процесс.
Сегментатор выделяет смысловые темы: читает полный комментарий, находит все самостоятельные мысли и сохраняет короткий фрагмент текста, который подтверждает каждую тему. На этом этапе мы не показываем таксономию, поэтому существующие категории не ограничивают поиск смыслов.
Проверяющий полноту (критик полноты) оценивает распределение по сегментам, то есть сравнивает темы с исходными комментариями: добавляет пропущенные, разделяет склеенные и убирает дубли или неподтверждённые выводы.
Классификатор применяет (наконец!) таксономию. Для каждой подтверждённой темы он выбирает категорию и тип сигнала. Решение принимается не по схожести названий, а по расширенным условиям применения и ограничениям для близких правил.
Независимый проверяющий (критик правил) сверяет разметку с текстом и сравнивает выбранный консёрн с правдоподобными альтернативами. Допустимое, но слишком широкое решение получает предупреждение; отклоняется только явное противоречие.
Корректор (повторный классификатор) исправляет явные ошибки, то есть отклонённые решения. Происходит это один раз. Повторной критики нет, чтобы процесс не превратился в бесконечный круговорот.
Python-помощник проверяет структуру ответа, выводит теги из выбранных консёрнов и безопасно записывает итог. Локальная ошибка одной строки не задерживает остальные.
Контроллер запуска берёт следующий бакет. Цикл продолжается, пока каждый бакет в манифесте не получит итоговый статус. Если контроллер завершился раньше времени, управляющий агент запускает новый и продолжает тот же зафиксированный прогон.
(Да, это всё максимально похоже на анекдоты про то, сколько нужно физиков-теоретиков/американцев/психоаналитиков/etc., чтобы вкрутить лампочку…)
Фантастические правила и где они обитают
Продуктовая логика хранится в отдельном справочнике, который поддерживают UX-исследователи и продуктовая команда. Для каждого консёрна мы задаём точное название, продуктовую область, условия применения, ограничения и короткий однозначный пример. Изменение таксономии не требует переносить продуктовые знания в Python-код.
Пример правила
Если пользователь пишет «Объявление отклонили, но непонятно, что исправить», подходит категория «Непонятна причина отклонения». Если он спрашивает, сколько обычно длится проверка, это уже совсем другое правило. Похожих слов недостаточно: классификатор должен проверить смысл и границы применения.
Качество таксономии важнее количества промптов и дополнительных проверок. Если два консёрна описывают почти одно и то же, модель будет колебаться даже при хорошей инструкции. В таком случае полезнее объединить правила или точнее развести их границы, чем усложнять код.
Какие ошибки мы учли
Архитектура решения сложилась в результате нескольких тестовых запусков. Текущая версия предусматривает как минимум восемь крупных проблем, которые мы наблюдали в экспериментах.
-
Длинный комментарий получал одну метку. Классификатор быстро находил знакомый консёрн и переставал замечать остальные мысли. Мы вынесли выделение тем в отдельный этап и добавили независимую проверку полноты.
-
Правило выбиралось по похожему названию. Название выглядело для ИИ подходящим, хотя существенное условие применения не выполнялось. Мы явно разделили условия применения и контрпримеры, а критику стали передавать сильные альтернативы.
-
Критик отклонял допустимые решения, искал идеальный ответ и только добавлял хаоса. Мы сделали его мягче: допустимый ответ сохраняется, отклоняется только доказуемое противоречие.
-
Исправления ходили по кругу. Каждая новая проверка могла запускать ещё одну переразметку. Мы оставили одну точечную повторную попытку без второго круга критики.
-
Корректный смысл ломался из-за формата ответа. Разумная разметка не всегда совпадала с машинным контрактом. Поэтому Python получил фиксированные шаблоны, нормализацию безобидных отклонений и локализацию ошибки на одной строке.
-
Агент останавливался в середине очереди. Завершение одного этапа или бакета выглядело естественной точкой окончания всей задачи. Мы добавили манифест, отдельного контроллера и техническую проверку завершения всех бакетов.
-
Маленькие бакеты расходовали слишком много ресурсов. Для каждой небольшой группы повторялись инструкции, запуск ролей и проверки. Чтобы исправить ситуацию, размер бакета увеличили до 50 комментариев, сохранив свежих субагентов для каждой группы.
-
Консёрн и тег расходились, модель независимо заполняла два связанных поля. Мы перестали выделять тег отдельно: Python однозначно выводит его из консёрна.
Как мы проверяем качество
Для оценки мы собрали контрольную выборку из 196 комментариев, вручную размеченных вместе с UX-исследователями. Комментарии отбирались случайно, с учётом разных источников обратной связи. Ручная разметка хранится отдельно и не передаётся субагентам во время теста.
После запуска мы сравниваем типы сигналов, продуктовые теги и точные консёрны. Отдельно проверяем полноту разметки длинных комментариев, ошибки в ручном эталоне и спорные места таксономии. Если агент выбрал более точное правило, такой случай обсуждается с UX-исследователями, а эталон при необходимости исправляется.
Главная метрика — Micro F1 по консёрнам. Полное совпадение комментария с эталоном — слишком грубая проверка. В длинном отзыве агент может правильно найти три темы и пропустить четвёртую. Поэтому мы отдельно считаем правильные назначения, лишние назначения и пропуски. Micro F1 объединяет точность и полноту по всем темам во всей выборке.
Micro F1 по консёрнам — 83,87%. Показатель отражает, насколько точно и полно система выбирает конкретные пользовательские боли и запросы.
Micro F1 по тегам — 90,27%. Это означает, насколько хорошо найденные темы распределяются по продуктовым областям.
Теги не являются отдельной смысловой задачей модели: Python выводит их из выбранных консёрнов. Поэтому основной показатель — качество самих консёрнов, а теги и типы сигналов служат дополнительными диагностическими срезами.
Эталон тоже нужно проверять
Пользователь часто пишет слишком коротко, и по тексту нельзя определить единственно правильный консёрн. Например, фраза «Не могу пополнить кошелёк» может означать как непонимание сценария, куда нажимать, так и технический сбой. В первом случае подходит финансовая тема, во втором — техническая ошибка.
Для очевидных случаев в эталоне остаётся один ответ. Для объективно неоднозначных мы заранее фиксируем несколько допустимых вариантов. На текущей контрольной выборке 190 комментариев имеют высокую уверенность, а для шести зафиксировано семь дополнительных допустимых вариантов.
Допустимые варианты определяются до оценки нового запуска. Это защищает от подгонки, когда ответ объявляют правильным задним числом только ради роста метрики.
Что система гарантирует, а что нет
Конвейер обеспечивает технически фиксированный состав очереди и версию правил на время запуска, НО НЕ единственно верную трактовку неоднозначного текста.
Мы даём новый контекст для каждой роли и каждого бакета, НО НЕ высокую точность при пересекающихся правилах.
Используются только актуальные консёрны и автоматическое соответствие тегам, НО НЕ гарантирована полнота продуктовой таксономии.
Мы защищены от случайной перезаписи или остановки после локальной ошибки, НО НЕ от ошибок в ручной контрольной выборке.
Система гарантирует завершение только после обработки всех бакетов, НО НЕ появление правил для новых пользовательских смыслов без участия команды.
Говоря в общем, есть то, что невозможно гарантировать одной архитектурой, и качество системы по-прежнему зависит от качества таксономии. Близкие консёрны нужно объединять или точнее разделять, а для новых пользовательских смыслов нужно добавлять правила. Архитектура помогает стабильно применять знания команды, но не заменяет развитие самих знаний.
Что получается на выходе
Для каждого комментария конвейер сохраняет тип сигнала: жалобу, предложение, вопрос, позитив или отсутствие полезного сигнала, а также консёрны всех найденных тем и связанные с ними продуктовые теги. Исходный текст остаётся рядом, поэтому продуктовая команда может перейти от агрегированной картины к конкретным словам пользователя.
В результате необработанный поток комментариев превращается в воспроизводимую систему наблюдений. Её можно использовать для поиска повторяющихся проблем, проверки продуктовых гипотез, оценки приоритетов и развития самой таксономии.
Как мы используем систему на практике
Андрей Безруков
Старший продакт-менеджер
«В Авито мы планируем бэклог разработки по кварталам, а реализацию — по спринтам. В середине квартала я изучаю общий рейтинг проблем из обратной связи, выделяю топ по своей зоне ответственности и потом погружаюсь в конкретные кейсы — читаю прямую речь и связанные логи системы. Раньше, чтобы это собрать, требовалось несколько недель и участие многих коллег.
После изучения кейсов мы с командой ищем решения, которые закроют большинство из них, оцениваем сложность реализации и отбираем, что сделаем в следующем квартале».
Передаю слово коллегам!
Роман Булгаков
Продуктовый аналитик
«Несколько лет назад для разметки такого объёма и качества понадобилась бы отдельная команда специалистов по данным: подготовка обучающей выборки, разработка модели и длительная настройка. Сейчас аналитик вместе с UX-исследователями может быстрее собрать работающий процесс, проверить качество на эталонной выборке и постепенно улучшать правила. Мы тратим в разы меньше времени на подготовку данных и можем перенаправить ресурс в поиск закономерностей и проверку продуктовых гипотез».
Анна Кузьменко
Ведущий UX-исследователь
«Мне нравится, что комментарии пользователей, результаты опросов и регулярные замеры объединены в едином бэклоге и размечены по общей таксономии. Мы можем быстро сориентироваться и вернуться к пользователю, чтобы уточнить контекст и пожелания.
Зона роста тоже есть — регулярное обновление таксономии. Одни проблемы со временем решаются, другие появляются, а интервью могут показать, что под одним тегом скрываются разные причины или несколько тегов описывают одно и то же. Поэтому правила и теги нужно регулярно пересматривать, чтобы разметка отражала актуальное состояние продукта».
Обращение к любимым пользователям
Чтобы сервисы, с которыми вы работаете, действительно улучшались, помогайте нам! Без обратной связи мы не узнаем, что вам нужно для более комфортного взаимодействия с продуктом.
-
Пожалуйста, продолжайте делиться обратной связью, описывайте проблемы и трудности, с которыми сталкиваетесь. Авито Реклама каждый квартал берёт в работу много разнообразных задач: от крошечных исправлений до того, что болит больше всего.
-
Старайтесь описывать не только проблему («Непонятная модерация»), но и конкретный кейс. Расскажите, что пробовали сделать и на каком этапе не получилось разобраться. Детали помогают найти лучшее решение.
-
Давайте нам референсы или описывайте, как, на ваш взгляд, должна работать система. Некоторые функции появились в Авито Рекламе именно благодаря такой обратной связи.
-
Команда видит весь фидбэк, поэтому повторять один и тот же запрос не требуется. Ваша проблема уже ждёт своего часа.
Ждём в комментариях советы по улучшению ИИ-конвейера ;)
Автор: aur

