


Снова всем привет!
Прошло всего несколько дней с того момента как я выложил LSWM [1].
В общем я протестировал и поэкспериментировал эту сеть ещё раз и нашёл СТОЛЬКО проблем, сколько даже ванильный RNN не видел.
В этой статье я попытаюсь их исправить.
Содержание.
В этой статье будет:
-
Теория.
-
Бенчмарки.
-
Плюсы и минусы.
-
Вывод.
Теория.
Начнем с теории.
Хочу сказать – тут будут те же softsign и scaled softsign [2].
И так… Начнём с первой формулы:
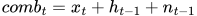
Что такое  ? Это тот же
 , но который я прогнал через softsign. В принципе, можно записать эту формулу как:
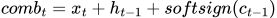
Но, оставим  .
Потом идут первые два гейта (обновлённые):
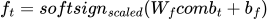
В принципе тот же  .
Теперь  :
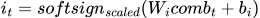
Как видим, я убрал два линейных слоя из прошлой статьи и заменил их одним линейным слоем.
Зачем? Качество – вверх, количество параметров – намного меньше.
Ну а вот теперь самое главное нововведение:

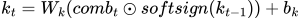
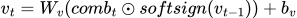
Как видим – мы прогоняем  через три линейных слоя, прям как в трансформере (или в xLSTM). Но, дело не в том что мы просто “прогнали comb_t через три слоя”, дело в том что из-за умножения (поэлементного) comb_t на прошлый q_t, k_t или v_t – в общем, обобщая – новый q_t становится зависим от прошлой истории q_t, k_t становится зависим от прошлой истории k_t, ну, а v_t становится зависим от прошлой истории v_t.
Это одна из причин почему LSWM 2.0 может выдерживать большие последовательности.
Что ж делать дальше?
Дальше только  :
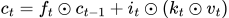
Раньше [3] мы умножали  на обычный
 (грех!).
Сейчас же мы берем ключ и значение нашего комбинированного значения и умножаем их (поэлементно), и вот только  умножаем на результат.
Сеть стала менее чувствительна к сиду и более лучше запоминать!
Потом идет долгожданный  :

Нечего сверхъестественного, просто  прогоняем через softsign.
Потом главное (нет):
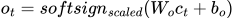
Я решил сделать так, чтобы  был зависим не от
 , а от самого
 .
И это даже сделало качество лучше!
Потом идет:
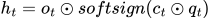
Запрос нашего  умножаем на
 , прогоняем через softsign, и конечно же умножаем o_t на этот результат.
Всё, это вся сеть.
И ещё:
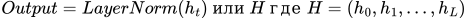
В общем я полностью убрал LWM слой [4].
Как оказалось, LWM слой делал сеть чувствительной к сиду (намного больше чем щас).
Бенчмаркинг.
И так, для начало бенчмаркинг.
Если что датасет – мой, обучение – тоже как тогда [5].
Но, для начало я замерил закон масштабирования (правильно выразился?) в 3д графике:
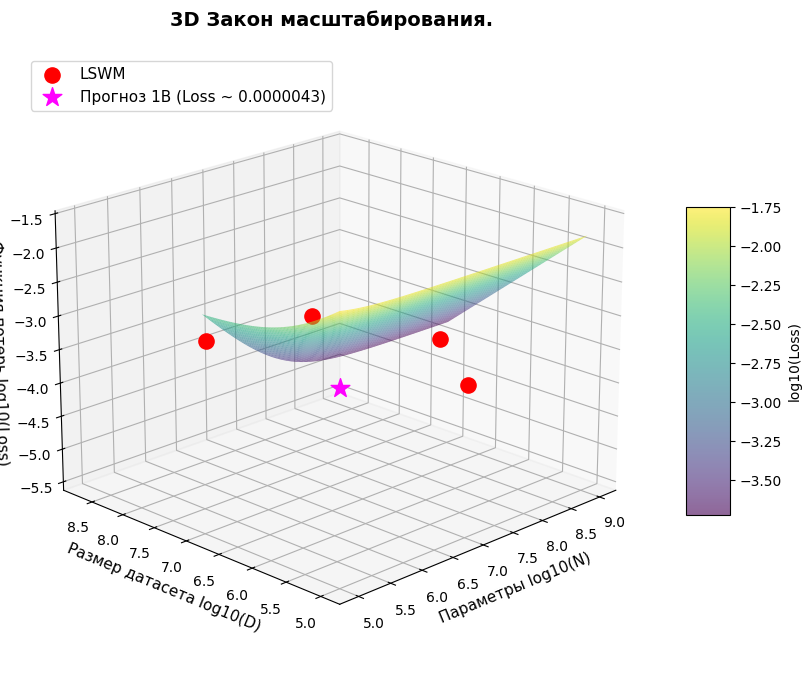
Вот как я тут считал:
-
hidden dim = 128, 400 эпох.
-
hidden dim = 2048, 1200 эпох.
-
hidden dim = 4096, 1500 эпох.
-
hidden dim = 128, 20000 эпох.
И ещё давненько я считал 2д график (log-log):
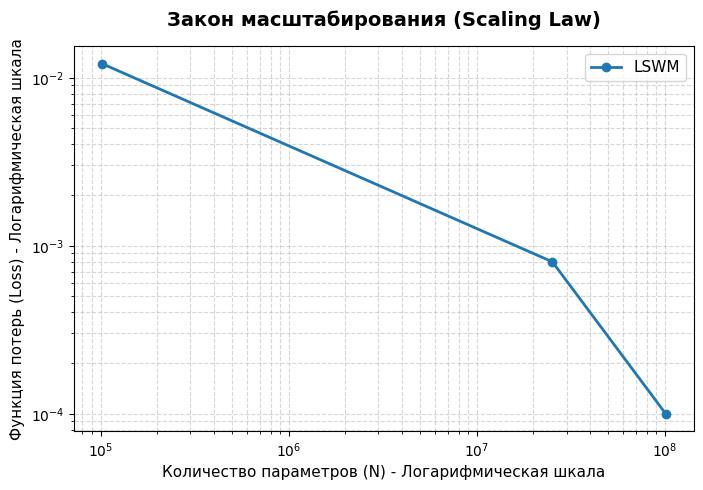
И так. Как видим, кажется, если масштабировать LSWM (если что я замерял по новой версии) – то не будет никаких особо подвохов.
Время делать бенчмарк с остальными.
Я взял тот же датасет, но проверяю модель (то есть инференс делаю) на более БОЛЬШОЙ цепочке, да.
Вот если что сам инференс:
model.eval()

with torch.no_grad():
    tokens_pool = [a, b, c]
    random_noise = []
    for _ in range(1000):
        if _ == 500:
            random_noise.extend([a])
        random_noise.extend([random.choice(tokens_pool), TOKEN_ARROW])

    chain1 = random_noise + [c, TOKEN_Q_1]
    chain2 = random_noise + [c, TOKEN_Q_2]

    test1 = torch.tensor([chain1]).to(device)
    test2 = torch.tensor([chain2]).to(device)

    pred_live = torch.argmax(model(test1), dim=1).item()
    pred_work = torch.argmax(model(test2), dim=1).item()

    print(f"need: 3 answer: {pred_live}")
    print(f"need: 12 answer: {pred_work}")
Э-э-э, ну написано довольно плохо, но оно работает.
Настроил три сети (LSWM, LSTM, GRU) под правильный размер параметров и правильные настройки биасов, и пошёл проверять.
Вот как я проверял:
-
Запускал каждую сеть 10 раз и считал сколько раз отвечала неверно и сколько раз верно.
-
Та, которая показала себя лучше всего (то есть верных ответов больше чем неверных чем у остальных) – та и победила.
Вот результаты:
|
Сеть |
Верных |
Неверных |
Параметров |
|
LSWM (2.0) |
5 |
5 |
101632 |
|
GRU |
3 |
7 |
101632 |
|
LSTM |
4 |
6 |
101672 |
Лосс и качество убрал – потому что я лентяй и забыл считать хотя бы среднее между всеми 10 запусками, но в принципе у всех там 100%-93% качество в основном.
И ещё – я не могу гарантировать что эта статистика верных и неверных всегда будет совпадать с таблицей, но примерно так всегда будет.
Ну, а теперь по самой таблице:
-
LSWM 2.0 переиграла всех.
-
GRU, соответственно, хуже всех.
-
LSTM “на втором месте”.
Это означает что LSWM 2.0 может конкурировать.
Плюсы и минусы.
Плюсы:
-
(В теории) Больше запоминает.
-
Чувствительность к сиду намного меньше (но ещё есть).
-
Обучается не так уж и не медленно.
-
 “принимает решение” на основе существующей памяти (
 ), что может очень хорошо сказаться.
Минусы:
-
Всё чувствительность к сиду присутствует (этот минус можно и не писать, я его считай описал в плюсах…).
-
softsign иногда своими “хвостами” только мешает (но я пока такого не видел).
-
Сеть к сожалению всё равно с трудом проходит задачи по типу Needle in the haystack.
В общем, я считаю что эта версия LSWM достаточно конкурентноспособная, но всё же пока что тестирую ещё.
Вывод.
Засунуть Q, K, V в последовательную Gated RNN – штука рабочая.
Суммирование вместо конкатенирования – очень рабочая идея.
 – очень хорошо.
Но стоит и отметить, что нельзя всё пихать в одну кучу, что я и подтвердил на примере LWM.
P.S: так как проблемы с Github’ом до сих пор – держите код LSWM:
Код.
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as F
import numpy as np

device = torch.device("cuda")

class LSWM(nn.Module):
    def __init__(self, vocab_size, d_model):
        super().__init__()

        self.d = d_model

        self.vocab_size = vocab_size
        self.embedding = nn.Embedding(vocab_size, d_model).to(device)

        self.W_f = nn.Linear(d_model, d_model).to(device)
        self.W_i = nn.Linear(d_model, d_model).to(device)
        self.W_o = nn.Linear(d_model, d_model).to(device)

        with torch.no_grad():
            self.W_f.bias.fill_(3.0)
            self.W_i.bias.fill_(0.0)
            self.W_o.bias.fill_(0.0)

        self.W_q = nn.Linear(d_model, d_model).to(device)
        self.W_k = nn.Linear(d_model, d_model).to(device)
        self.W_v = nn.Linear(d_model, d_model).to(device)

        self.norm = nn.LayerNorm(d_model)

    def softsign_scaled(self, x):
        return (F.softsign(x) + 1.0) / 2.0

    def forward(self, token_seq):
        batch_size, seq_len = token_seq.size()

        x_seq = self.embedding(token_seq)

        h_t = torch.zeros(batch_size, self.d).to(device)
        c_t = torch.zeros(batch_size, self.d).to(device)

        q_t = torch.ones(batch_size, self.d).to(device)
        k_t = torch.ones(batch_size, self.d).to(device)
        v_t = torch.ones(batch_size, self.d).to(device)

        n_t = torch.zeros(batch_size, self.d).to(device)

        for t in range(seq_len):
            x_t = x_seq[:, t, :]

            combined = h_t + x_t + n_t

            f_t = self.softsign_scaled(self.W_f(combined))
            i_t = self.softsign_scaled(self.W_i(combined))

            q_t = self.W_q(combined * F.softsign(q_t))
            k_t = self.W_k(combined * F.softsign(k_t))
            v_t = self.W_v(combined * F.softsign(v_t))

            c_t = f_t * c_t + i_t * (k_t * v_t)
            n_t = F.softsign(c_t)

            o_t = self.softsign_scaled(self.W_o(c_t))

            h_t = o_t * F.softsign(c_t * q_t)

        return self.norm(h_t)
Автор: pureooplover

