


Раз в минуту у нас просыпаются четыре консольные команды. Каждая проходит по таблице чатов — это сотни тысяч строк и около трёхсот тысяч живых пользователей в месяц — и решает, кому бот напишет первым: у кого обновились суточные лимиты, кто начал разговор и замолчал на третьей минуте, у кого закончилась подписка, кому пора показать промо.
Год назад я полез разбираться, почему уведомление об обновлении лимитов приходит с опозданием на несколько минут, хотя команда отрабатывает за секунды и в логе чисто. Оказалось, что за один проход команда обслуживает половину тех, кого сама же выбрала. Не «примерно половину» — ровно половину. Виноват chunk(), который отработал в точности так, как написано в документации.
Проект под NDA, поэтому дальше без имён: продуктовая специфика убрана, сущности переименованы, бизнес-цифры не называются. Механика и грабли настоящие.
Что бот пишет сам
У телеграм-бота есть неочевидное свойство: он умеет начинать разговор. Пользователь не открывает приложение — приложение приходит к нему само. Это одновременно главный канал возврата и главный способ получить блокировку.
Инициативных сообщений у нас четыре вида:
-
обновились суточные лимиты — «заходи, у тебя снова есть чем пользоваться»;
-
человек начал разговор и не написал ни одного сообщения — через три минуты ему приходит второе сообщение от собеседника;
-
закончилась подписка — предложение продлить;
-
давно не заходил — промо.
Каждое — отдельная команда, и все четыре стоят на everyMinute().
Schedule::command('chat:premium-finished')->everyMinute()->withoutOverlapping();
Schedule::command('chat:second-message')->everyMinute()->withoutOverlapping()->runInBackground();
Schedule::command('chat:refill')->everyMinute()->withoutOverlapping()->runInBackground();
Schedule::command('chat:promo')->everyMinute()->withoutOverlapping()->runInBackground();
Почему раз в минуту, а не раз в сутки
Первая версия обновления лимитов была ночным кроном: в полночь пройтись по всем и всем всё выдать. Так делают почти все, и на маленькой базе это работает.
Ломается с двух сторон сразу. Со стороны нагрузки — в полночь ты получаешь один большой UPDATE по всей таблице и пачку из десятков тысяч сообщений, которые надо отправить в течение нескольких минут, потому что «лимиты обновились» через час уже никому не интересно. Со стороны продукта — полночь у всех разная, а у нас пять локалей и пользователи по всем часовым поясам.
Поэтому лимиты стали скользящим окном от активности: у каждого чата своя метка, через сутки после которой ему полагается обновление. Крон перестал быть раздатчиком и стал догонялкой — он ищет тех, кто не заходил дольше суток, обновляет им лимиты и зовёт обратно. Тех, кто зашёл сам, обслуживает вебхук по дороге, без всякого крона.
Побочный эффект приятный: вместо пика на всю базу получается ровный поток. Побочный эффект неприятный: запросы, которые раньше выполнялись раз в сутки и никого не волновали, теперь выполняются 1440 раз в сутки — и вот тут выясняется, как они на самом деле написаны.
Как chunk() читает таблицу
Команда обновления лимитов выглядела так — сокращённо, без локалей и логов:
Chat::query()
    ->join('billings', 'chats.id', '=', 'billings.chat_id')
    ->whereNotNull('billings.tokens_reset_at')
    ->where('billings.tokens_reset_at', '<=', $limit)
    ->where('chats.is_blocked', false)
    ->whereNull('chats.banned_at')
    ->orderBy('billings.tokens_reset_at', 'asc')
    ->select('chats.*')
    ->chunk(120, function ($chats) use ($service) {
        foreach ($chats as $chat) {
            $data = $service->performRefill($chat);   // внутри: tokens_reset_at = null
            $this->sendRefillNotification($chat, $data);
        }
    });
performRefill внутри транзакции выдаёт лимиты и ставит tokens_reset_at = null — это метка «цикл закрыт, новый начнётся при следующей активности». То есть обработанная строка перестаёт подходить под условие выборки. Ровно в этом и проблема.
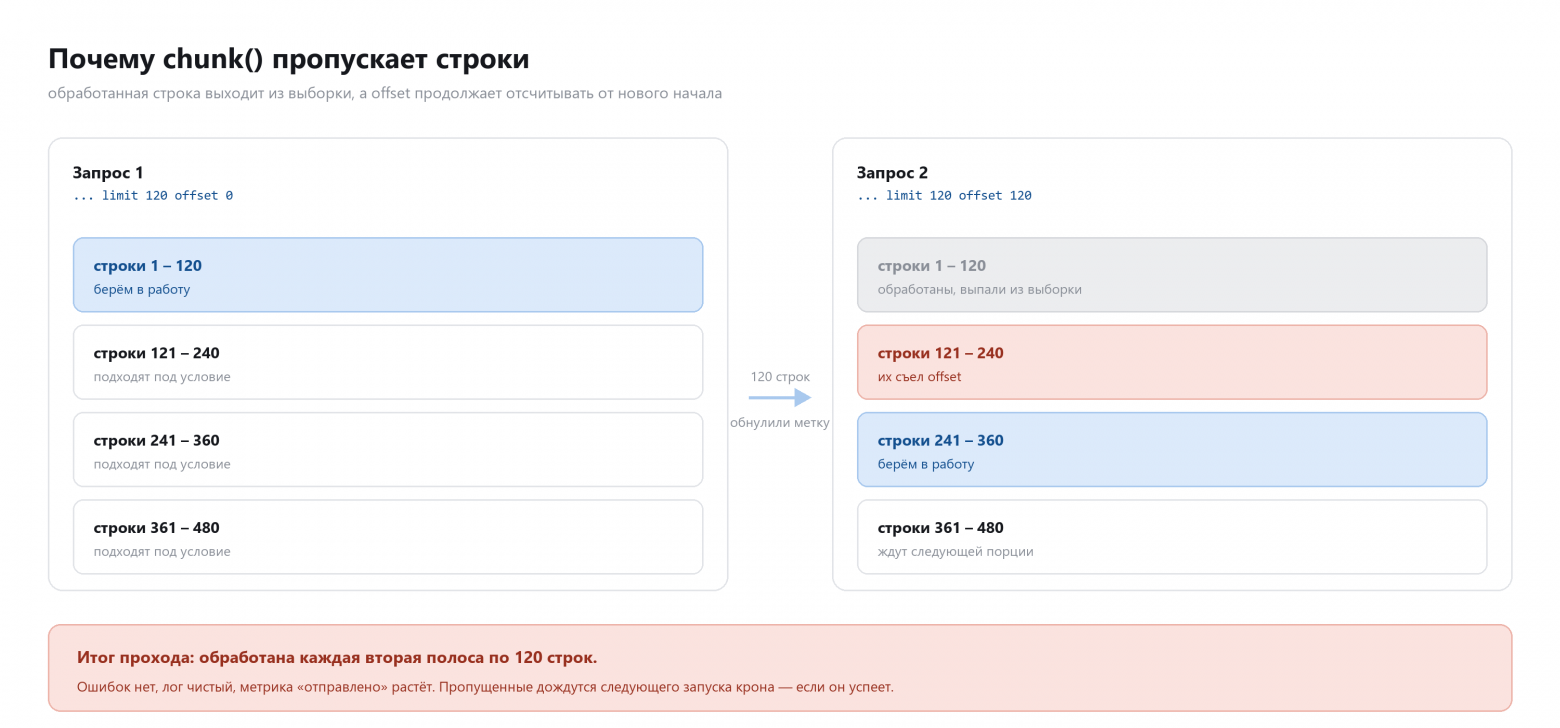
chunk() — это не курсор. Это цикл, который каждую итерацию выполняет отдельный запрос с LIMIT и OFFSET:
-- первая порция
select chats.* from chats join billings ... where billings.tokens_reset_at <= ? ... limit 120 offset 0
-- вторая порция
select chats.* from chats join billings ... where billings.tokens_reset_at <= ? ... limit 120 offset 120
Между двумя запросами мы обнулили метку у первых ста двадцати строк. Ко второму запросу они уже не проходят по условию — выборка сдвинулась на 120 строк влево. А offset 120 отсчитывает от нового начала. Первая порция забрала строки 1–120, вторая забирает 241–360, строки 121–240 не увидит никто.
Дальше по индукции: обслуживается половина, аккуратными чередующимися полосами по 120 строк.
Сколько это стоило на самом деле
Первая реакция была «ну и ладно, следующей минутой догонит». Так и есть: через минуту крон стартует с нуля, сортировка по времени метки ставит пропущенных в начало, и они получают своё.
Но посчитаем. Тысяча чатов в очереди на обновление — это не тысяча за проход, а 500, потом 250, потом 125. Чтобы разгрести тысячу, нужно около десяти минут вместо одной. Пока очередь короткая, это невидимо. В день, когда очередь стала длинной, это стало выглядеть как «уведомления приходят с задержкой» — за эту ниточку я и дёрнул.
Хуже другое: в логе чисто. Команда не падает, каждая обработанная строка честно пишет «отправлено», метрика растёт. Дырка между «сколько подходило под условие» и «сколько обработали» не была видна нигде, потому что первое число никто не считал.
chunkById и почему он не вставляется в одну строчку
Лечится заменой на chunkById(), который вместо OFFSET тащит курсор по первичному ключу:
select ... where billings.tokens_reset_at <= ? and chats.id > ? order by chats.id asc limit 120
Строки, выпавшие из выборки, больше не сдвигают окно: следующий запрос начинается с конкретного id, а не с «отступи 120 от начала». Приём известен как keyset pagination, и он же лечит вторую, менее заметную болезнь OFFSET — растущую стоимость на больших смещениях.
Две вещи, о которых узнаёшь уже на замене.
Первая: chunkById() переопределяет сортировку. Мой orderBy по времени метки был не украшением, а смыслом — «сначала те, кто ждёт дольше всех». После перехода порядок стал по chats.id, то есть по дате регистрации: свежие пользователи начали ждать за спинами тех, кто зарегистрировался два года назад. Справедливость очереди пришлось возвращать иначе — ограничивать верхнюю границу метки и брать пачку целиком, а не полагаться на ORDER BY внутри обхода.
Вторая: с джойном колонку курсора нужно называть полностью, иначе база не поймёт, чей id имеется в виду:
->chunkById(120, function ($chats) { /* ... */ }, 'chats.id', 'id');
Третий аргумент — колонка в запросе, четвёртый — имя ключа в полученной модели. Если перепутать, получишь либо Column 'id' in where clause is ambiguous, либо, что веселее, бесконечный цикл: курсор будет читать не ту колонку и никогда не дойдёт до конца.
Надёжнее: сначала id, потом работа
chunkById чинит сдвиг окна, но не чинит главного: мы по-прежнему читаем и пишем одну и ту же выборку в одном проходе. Там, где проход длинный, я теперь делаю иначе — сначала собираю идентификаторы, потом работаю:
$ids = Chat::query()
    ->join('billings', 'chats.id', '=', 'billings.chat_id')
    ->where('billings.tokens_reset_at', '<=', $limit)
    // ... остальные условия
    ->orderBy('billings.tokens_reset_at')
    ->limit(self::BATCH)
    ->pluck('chats.id');
Выборка зафиксирована, порядок сохранён, а лимит на пачку появился сам собой — и это внезапно самое ценное. Крон, который раз в минуту берёт не больше N чатов, деградирует предсказуемо: при завале растёт задержка, а не время прохода. Крон без такого лимита при завале начинает наезжать сам на себя.
Цена очевидная: между pluck и обработкой строка может измениться, и обрабатывать её уже не надо. Проверять актуальность всё равно придётся, но теперь это дешёвая проверка перед отправкой, а не невидимый пропуск в середине обхода.
С другой стороны — дубликаты
Команда второго сообщения устроена иначе: она не отправляет сама, а ставит задачи в очередь.
->chunk(120, function ($chats) {
    foreach ($chats as $chat) {
        SendSecondMessageJob::dispatch($chat->id)->onQueue('second_message');
    }
});
Здесь тот же сдвиг выборки — джоба выставляет second_message_sent_at, и строка выпадает из условия. Но добавляется беда, зеркальная первой: метка выставляется не сразу, а когда до задачи дойдут руки воркера. Если очередь отстаёт на полторы минуты, следующий запуск крона увидит те же чаты и поставит те же задачи ещё раз.
В самой джобе защита есть:
if ($this->chat->second_message_sent_at !== null) {
    return;
}
Это фильтр, а не защита. Он спасает от последовательного выполнения дублей и не спасает от параллельного: два воркера берут две копии задачи, оба читают null, оба отправляют. Пользователь получает два одинаковых сообщения подряд — выглядит ровно так, как выглядит баг.
Честных вариантов три, и все дешёвые:
-
ShouldBeUniqueна джобе с ключом по идентификатору чата — Laravel возьмёт лок в Redis на время выполнения; -
пометить строку в момент диспатча:
update ... where second_message_sent_at is nullи смотреть на количество затронутых строк; -
уникальный индекс на таблице отправленных и ловля нарушения — так у нас сделаны резервы баланса, про них была отдельная статья.
Мне больше нравится второй: метка ставится тем же запросом, который её проверяет, и рассинхрон между «выбрали» и «пометили» исчезает как класс — без локов и без дополнительной инфраструктуры. У нас пока стоит только проверка внутри джобы, то есть первый вариант из трёх не реализован, а третий применён в другом месте системы.
withoutOverlapping() и сутки тишины
Все четыре команды стоят с withoutOverlapping(), и это правильно: проход по сотням тысяч строк может не уложиться в минуту, и накладываться ему нельзя.
Чего я не знал: у лока есть время жизни, и по умолчанию оно — 24 часа. Лок живёт в кэше, снимается в конце выполнения, и если процесс умер не своей смертью — OOM-killer, kill -9, перезагрузка сервера в неудачный момент, — снимать его некому. Команда молча не выполняется. Ровно сутки.
У нас это случилось один раз, с командой про закончившуюся подписку. Обнаружилось не по мониторингу, а по тому, что за день не пришло ни одного продления.
Schedule::command('chat:premium-finished')->everyMinute()->withoutOverlapping(5);
Пять минут — это «в несколько раз больше, чем самый долгий легальный проход». Дальше остаётся вторая половина проблемы: после суток простоя команда просыпается и видит не десяток строк, а тысячи. А там:
$billings = Billing::where('premium_until', '<', now())->with('telegramChat')->get();
get() без всяких порций. В нормальном режиме это десяток строк в минуту, и жило оно так годами. После суток тишины это память, которой нет. Чинится одной строкой — и, как обычно, чинилось уже после.
Отправка внутри крона
Две команды из четырёх до сих пор отправляют сообщения синхронно, прямо в процессе крона. Выглядит невинно:
foreach ($chats as $chat) {
    $this->sendPromo($chat, $promos->random());
}
Внутри — HTTPS-запрос к Telegram API. Даже при быстрых ответах это сотня-другая миллисекунд на чат, последовательно, в одном процессе. Сто двадцать чатов — полминуты. Тысяча — четыре минуты при минутном расписании, и withoutOverlapping() эти запуски просто съест.
Правильный ответ — крон только выбирает и ставит задачи, отправляют воркеры. У нас так сделана одна команда из четырёх, и это долг, а не архитектурное решение. Отдельная причина сделать именно так: в очереди отправка уже обложена ретраями, приоритетами и лимитами. В кроне соблюдать лимиты Telegram попросту нечем — там нет ни общего счётчика, ни места, где его держать.
Мёртвые души
Любая выборка для рассылки начинается не с того, кого мы хотим позвать, а с того, кого звать нельзя:
->where('chats.is_blocked', false)
->whereNull('chats.banned_at')
->where('chats.is_started', true)
is_blocked ставим не мы, а Telegram: когда пользователь блокирует бота, API на любую отправку отвечает 403. Это единственный способ узнать о блокировке — попробовать написать.
case 403:
    $this->chat->is_blocked = true;
    $this->chat->save();
    break;
Дальше начинается арифметика, которая на старте проекта кажется неважной. Доля заблокировавших только растёт: тот, кто заблокировал бота, не разблокирует его никогда. Через год это заметная часть таблицы, и если выборка её не отсекает, крон каждую минуту честно обходит кладбище — с запросами, с попытками отправки, с местом в очереди, которое могло достаться живому.
Поэтому индекс под эти три колонки появился раньше, чем индекс под саму метку времени.
Индекс, который пришлось перевернуть
Индексов под эти выборки два:
$table->index(['bot_id', 'is_blocked', 'banned_at']);   // chats
$table->index(['chat_id', 'tokens_reset_at']);          // billings
Второй изначально был написан наоборот — ['tokens_reset_at', 'chat_id']. Логика казалась очевидной: фильтруем по времени, значит время первым.
Она была бы верной, будь billings ведущей таблицей в плане. Но план начинается с chats — там отсекается всё лишнее, заблокированные и забаненные, — и в billings мы приходим уже за конкретным chat_id. При таком плане индекс с временем впереди не используется вовсе: ведущая колонка в соединении не участвует.
Миграция короче, чем объяснение:
Schema::table('billings', function (Blueprint $table) {
    $table->dropIndex(['tokens_reset_at', 'chat_id']);
    $table->index(['chat_id', 'tokens_reset_at']);
});
Порядок колонок в составном индексе определяется планом запроса, а не важностью колонок в голове автора. EXPLAIN до и после занимает две минуты, и обе эти минуты я в тот раз пожалел.
Чего не хватало в мониторинге
Всё описанное выше — один класс ошибок: расхождение между «сколько строк подходило под условие» и «сколько мы обработали». Ни одна из них не ловится алёртом на ошибки, потому что ошибок нет.
Что из этого следует для мониторинга:
-
каждая команда в конце должна писать три числа: сколько нашла, сколько обработала, сколько пропустила осознанно;
-
если «нашла» больше суммы двух других — алёрт, независимо от причины;
-
длина очереди на обслуживание — сколько строк подходит под условие прямо сейчас — отдельная метрика с графиком.
Третий пункт, подозреваю, полезнее первых двух: он показывает проблему до того, как её заметит пользователь. У фоновых рассылок вообще нет естественного индикатора здоровья — они по определению работают без человека, который пожалуется.
Сейчас у нас из этих трёх есть только счётчик отправленных, то есть самое бесполезное. Дырку между «нашли» и «обработали» я в своё время нашёл руками, из любопытства, и это худший из возможных способов.
Что я меняю после этой статьи
Пока писал, перечитал все четыре команды подряд, чего давно не делал. Список того, что поеду чинить:
-
chunk()на движущейся выборке остался ещё в двух командах — там же, где и был. -
Дубликаты задач: метку надо ставить в момент диспатча.
-
withoutOverlapping()без явного времени жизни — везде. -
get()без порций в команде про подписку. -
Синхронная отправка в двух командах из четырёх.
Ни один из пяти пунктов не проявляется на тестовой базе в тысячу строк. Все пять проявляются на живой.
Чеклист
Если у вас есть фоновая команда, которая ходит по большой таблице и что-то в ней меняет:
-
chunk()нельзя использовать, если обработка выводит строки из выборки. ТолькоchunkById()или явная пачка идентификаторов. -
chunkById()переопределяет сортировку — если порядок был содержательным, его надо возвращать другим способом. -
С джойном указывайте колонку курсора полностью, вместе с именем таблицы.
-
Лимит на размер прохода нужен всегда: при завале должна расти задержка, а не длительность прохода.
-
Помечайте строку тем же запросом, который её выбирает, а не позже и не в другом процессе.
-
Джоба, идемпотентная только проверкой «если уже сделано — выходим», не идемпотентна.
-
withoutOverlapping()— всегда с явным временем жизни, кратным самому долгому легальному проходу. -
Команда, которая нормально живёт на десяти строках в минуту, обязана пережить сутки простоя. Проверяется руками: остановить, подождать, запустить.
-
Никаких синхронных сетевых вызовов в цикле крона. Крон выбирает, очередь отправляет.
-
Выборка для рассылки начинается с исключений, а не с условий. Заблокированные, забаненные, не стартовавшие — первыми.
-
Порядок колонок в составном индексе проверяется
EXPLAIN, а не рассуждением. -
Логируйте «нашли / обработали», а не «отправлено». Расхождение этих двух чисел — единственный способ увидеть тихий пропуск.
Отдельно любопытно про пятый пункт. Мы ставим метку в момент диспатча и миримся с тем, что при падении воркера пользователь не получит сообщение вовсе. Обратный вариант — метка после успешной отправки — гарантирует доставку ценой дублей. Третьего мы не придумали, а хочется: как вы разруливаете эту развилку у себя?
Автор: i_alakey

