


Я — Влад Куренков, руковожу научной группой «Адаптивные агенты» Института AIRI и сегодня я хочу позвать вас поделать немного распределённой науки. Вот, в чём суть.
Есть такая компьютерная игра NetHack — пошаговый рогалик 1987 года, который до сих пор не может пройти искусственный интеллект. Жизнь у героя одна, сохранений нет, подземелье каждый раз новое, а игра по дороге ничего не подсказывает. Если вы сыграли плохо, то выясняется это тогда, когда ничего исправить уже нельзя. На таких же ошибках спотыкаются ИИ‑агенты, когда пишут код: отдельный шаг они выполняют прекрасно, а на длинной дистанции держать планку им уже сложнее. И NetHack в этом плане становится весьма полезной для проверки агентов.
По этой причине я запустил открытое сообщество людей, которые создают системы планирования ИИ, чтобы вместе решить NetHack. Понятно, что игра — это не ценность сама по себе. Гораздо важнее способ, которым возьмут игру, а также тот факт, что этот способ станет общественным достоянием. Если вы разрабатываете ИИ‑агентов, занимаетесь планированием или пишете игровых ботов, давайте идти к этой цели вместе.
Далее расскажу подробнее про проект NetHackers и наше сообщество.
Что такое NetHack
Как я уже отмечал выше NetHack — это пошаговая RPG в жанре rougelike с видом сверху и аскетичной графикой. В начале выбираем пол, расу, мировоззрение и класс, потом спавнимся в подземелье и вперёд. Чтобы победить, нужно спуститься примерно через пятьдесят процедурно генерируемых уровней, сражаться, торговать, кушать, добыть Амулет Йендора и выбраться через пять последних планов. Если всё это сделать, игрока ждёт победа, которая в игре называется вознесением (ascension).
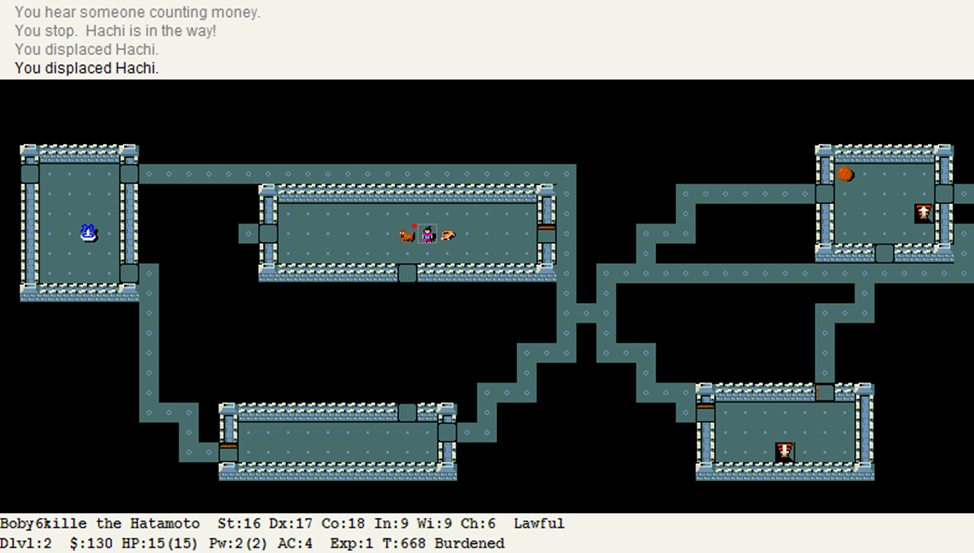
NetHack считается старейшей игрой, которая до сих пор получает обновление — последняя версия вышла в мае. К слову, в рунете именно на Хабре стали появляться первые статьи про эту игру, это 2009 год.
А ещё это одна из старейших игр, всё ещё не решённых ИИ (если не считать свежий кейс с Astra, но о нём позже). Причин этому несколько: процедурная генерация большинства уровней, неполнота информации, длиннющие партии на десятки тысяч ходов, где неверное решение из самого начала с лёгкостью может заруинить всё прохождение.
Это очень похоже на нашу жизнь во всех её трудностях, и именно это делает NetHack хорошим бенчмарком для ИИ‑агентов, в особенности тех, что пишут код. Но мало иметь сложный бенчмарк — нужно ещё правильно организовать работу над ним. Поэтому и было создано NetHackers — сообщество для координации попыток, унифицикации проверок и открытости всех решений.
Как устроена совместная работа
Представьте, что сто человек заинтересовались NetHack и каждый из них месяц улучшал собственного бота. Без общей организации получится сто репозиториев и сто историй успеха: кто‑то проверял программу за одного персонажа, кто‑то — на удобных ему подземельях, кто‑то записал лучший отдельный результат. Даже если среди этих работ есть хорошие идеи, следующему участнику трудно понять, где реальный прогресс и с чего начать. Нам нужна конструкция, в которой вклад одного человека становится исходной точкой для другого.
Поэтому мы договорились о нескольких простых вещах.
Во‑первых, у ботов общий внешний интерфейс: программа получает наблюдение из игры и возвращает действие. Что происходит внутри — набор написанных вручную правил, код, который породил агент, или ещё одна придуманная вами архитектура, — ваше дело. Нам не требуется, чтобы все работали одним методом. Нам требуется, чтобы результаты можно было запустить по одним правилам.
Во‑вторых, оценка разбита по 73 стартовым персонажам. Для каждого предусмотрены 15 открытых подземелий, одинаковых для всех участников. Это даёт рабочий полигон: можно менять код, запускать тесты и видеть, что случилось не в воспоминании о прошлой партии, а на конкретном наборе условий. Поскольку публичные подземелья известны, одного успеха на них недостаточно. Зарегистрированную программу мы дополнительно проверяем на 15 закрытых подземельях для соответствующего персонажа. Этот результат нужен прежде всего для ответа на вопрос: улучшился ли бот вообще или только приспособился к нашим открытым тестам?
Почему такая осторожность? Потому что переобучение здесь выглядит очень соблазнительно. Вы видите повторяющуюся смерть, вносите правку и получаете прекрасную цифру. Потом оказывается, что правка спасает героя в одном знакомом месте, а в остальных партиях ничем не помогает. Мы это проверяли на собственных ботах: изменения, выглядевшие убедительно на знакомых подземельях, на новых в основном теряли преимущество. Не всякая красивая цифра — знание.
В‑третьих, результат связан с открытым кодом и его точной версией. Недостаточно написать «мой бот стал сильнее»: другим нужен тот самый код, который проверялся. Тогда улучшение можно воспроизвести, изучить и продолжить. Сайт хранит результаты и ссылки на программы в репозиториях авторов; он не должен становиться единственным местом, где физически существует весь накопленный труд. Важны и неудачные кандидаты: запись о том, где программа погибла и что изменилось относительно предыдущей версии, может помочь следующему участнику понять причину, а не повторить тот же эксперимент.
В‑четвёртых, у нас нет одного‑единственного пьедестала. Если бот сделал шаг вперёд за определённого персонажа или впервые дошёл до нового игрового рубежа, это тоже видимый вклад. Сильное улучшение необязательно должно сразу поднять среднее по всем 73 персонажам. Иногда полезнее сначала научить программу одному новому навыку, а уже потом понять, как перенести его на остальные случаи. На сайте сообщества можно смотреть на рубежи и результаты по персонажам, а не только на вопрос «есть победа или нет».
Бейзлайн
Стартуем мы не с пустого места. Бейзлайном для нас является AutoAscend — сильный символьный бот, победитель соревнования NetHack Challenge 2021 года. Он уже умеет многое: исследовать, сражаться, работать с частью игровых ситуаций. Но его исходный код одновременно показывает множество мест, которые можно улучшать. Это хороший стартовый материал: достаточно сильный, чтобы доводить до интересных состояний, и достаточно несовершенный, чтобы обнаруживать ошибки без необходимости сначала написать всю игру заново.
Сам способ поиска улучшений мы не предписываем. Хотите вручную исправить конкретное правило — отлично. Хотите дать кодинг‑агенту изучить записи гибели, предложить патч, прогнать проверки и затем исправить собственный патч — тоже отлично. Хотите работать над циклом, который предлагает и отбирает следующие изменения, — это уже отдельная исследовательская задача. В любом случае сообщество оценивает получившуюся программу, а не красоту рассказа о том, как она появилась.
Здесь важно не перепутать наш замысел с добровольной раздачей вычислительных заданий. Мы не отправляем участнику кусок работы с просьбой «прогоните вот эти партии». Дефицитный ресурс здесь — хорошие идеи и работа по их воплощению. Более того, в нашем случае код, который приносит незнакомый человек или автономный агент, нельзя бездумно исполнять на чужой машине. При проверке мы запускаем программы в изолированном контейнере с ограничениями по сети, памяти и процессору и привязываем результат к публичной версии исходников. Это не отменяет необходимости внимательно относиться к безопасности, когда вы сами берёте чужой код за основу.
Что практически может сделать новый участник? Зайти на лидерборд, посмотреть результаты для стартовых персонажей и выбрать понятную точку приложения сил. Необязательно сразу обещать миру победу. Исправление конкретной причины смерти, более аккуратная работа с запасами или продвижение за персонажа, которого пока плохо поддерживают другие боты, — вполне содержательный результат. Особенно если после открытых тестов улучшение сохранится на закрытых.
Результаты на текущий момент
Сначала договоримся, что именно считать победой. Для отдельной партии победа — вознесение. Для нашей задачи единичного вознесения мало: мы ищем программу, которая может делать это надёжно на новых подземельях и разных стартовых условиях. Пока такого результата нет. Это не означает, что машины ни разу не выигрывали в NetHack, и я хочу явно проговорить разницу.
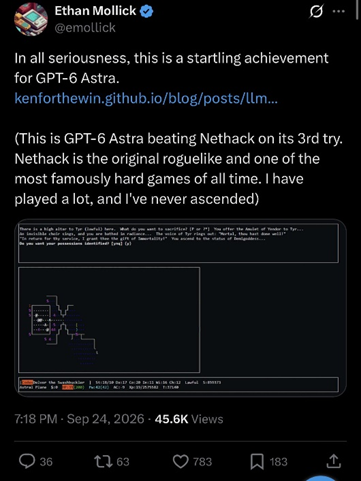
Исторически бот BotHack выиграл три партии на старой версии 3.4.3, воспользовавшись приёмом, который позднее убрали из игры. А в сентябре 2026 года появился другой важный результат: LLM‑агент GPT-6 Astra с третьей попытки довёл до вознесения дворфийскую валькирию на публичном сервере. Агент писал себе вспомогательные инструменты и выбирал игровые действия, но эксперимент проходил при участии человека, а опубликованный инструментарий сам по себе не является автономным игроком, которому можно дать новое подземелье и получить сопоставимую серию побед. Достижение впечатляющее, только это другой тип результата.
Нашу общую оценку мы проводим на NetHack 3.6.6 в среде NLE. На этой версии ни один из описанных на сайте проекта подходов пока не дал вознесения. Поэтому для сравнения частичных результатов мы используем шкалу прогресса: она показывает продвижение к игровым рубежам, а не «вероятность победы бота в процентах». Последнее различие принципиально. Сказать, что программа набрала 17% прогресса, не значит сказать, что она выигрывает 17 партий из 100.
Если посмотреть на опубликованные ориентиры, картина получается не такой, как можно было бы ожидать от громких успехов ИИ в других играх. AutoAscend находится примерно на отметке 7,8% прогресса; в большой серии из 109 545 партий он ни разу не добрался до Медузы. Простое обучение на действиях этого бота тоже не оказалось короткой дорогой к победе: показатели имитационной модели вышли на плато ниже показателей учителя.
В сентябре появился заметный сдвиг со стороны обучения с подкреплением: опубликованные результаты дают 11,78% прогресса для одного варианта обучения и 16,98% для варианта, ориентированного на глубину продвижения. Это первые показатели в приведённом на сайте сопоставлении, превысившие ориентир AutoAscend; отдельные запуски дошли до Замка. Языковые модели при непосредственной игре тоже могут показывать частичный прогресс: для одного из вариантов оценки указан результат 13,2%. В этой связи будет уместно упомянуть проект BALROG, где LLM играют в игры, включая NetHack, прямо онлайн, без написания программы.
На момент подготовки этого текста рекорд на нашем лидерборде составляет 32% (то есть в 4 раза лучше AutoAscend). Программа, которая его поставила, — лучшая на всех персонажах на данный момент, если усреднить.
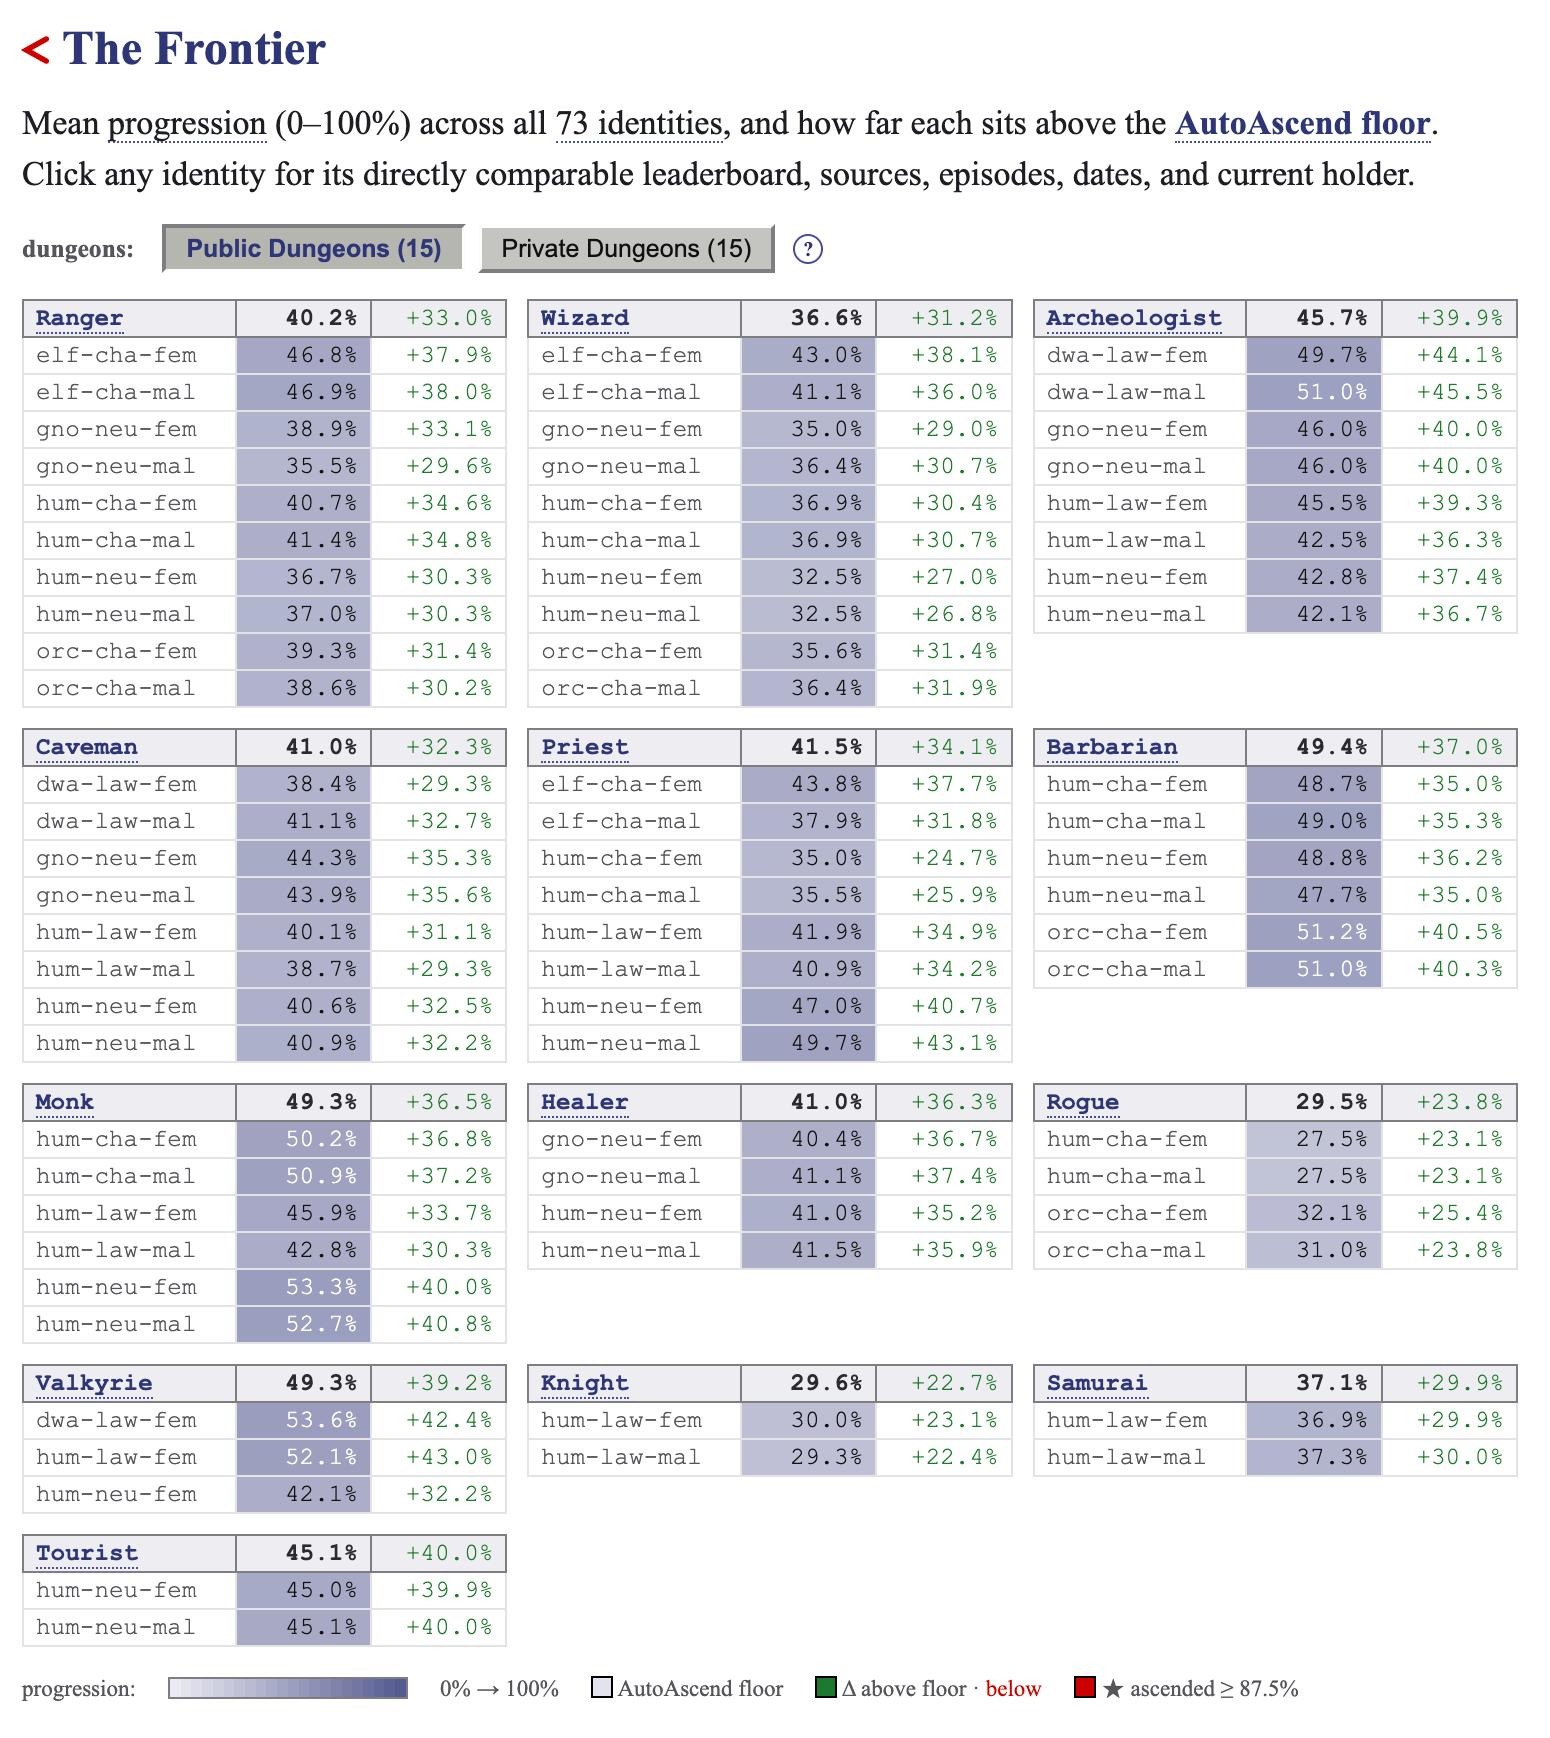
В целом, за полторы недели с момента запуска NetHackers мы нашей сетью хакеров и кодинг‑агентов смогли уже найти программы, которые иногда на публичных данженах (и очень редко на скрытых данженах) добираются до последнего уровня (но умирают там). Но пока ни один из этих частичных результатов не равен надёжному прохождению. Сейчас мы видим, что нейросети вышли на некоторое плато, и нам нужны свежие идеи. Поэтому мы активно ищем единомышленников — может именно ваше решение качнёт эту тему дальше.
Мне кажется, эта ситуация интереснее гладкой истории о том, что один метод уже победил остальные. Рукописные правила дают крепкую отправную точку и понятные ошибки, которые можно исправлять. Обучение с подкреплением показало новый уровень частичного продвижения, но не финиш. Языковой агент сумел однажды выиграть, однако пока нет основания считать его победу воспроизводимой автономной программой. Нам нужен не повод объявить соревнование законченным, а способ взять сильные стороны разных подходов и проверять, что действительно сохраняется от партии к партии.
Именно поэтому по мере развития сообщества я бы советовал следить не только за самой большой цифрой на доске. Смотрите, у каких персонажей появилось продвижение, какую старую ошибку удалось убрать, воспроизводится ли изменение на закрытых подземельях и можно ли взять код автора как отправную точку для следующего шага. Если через полгода мы получим много таких проверенных ступенек, это уже будет результат — даже до первого вознесения в нашем протоколе.
Пара мыслей про открытость и закрытость
Для работы над ботом можно использовать сильную коммерческую модель. Я и сам не вижу смысла делать вид, будто платного доступа к ИИ не существует или будто участие в открытом проекте требует принципиально от него отказаться. Доступ к сильному инструменту может оставаться платным и принадлежать отдельному человеку. Вопрос в том, что останется после работы с этим инструментом — особенно если завтра закончится подписка, изменятся условия доступа или появится модель получше.
Представьте, что агент помог вам найти ошибку в поиске пути и переписать соответствующий участок. Модель, с которой вы разговаривали, нам всем может быть недоступна. Но исправленная программа, запись проверки и история изменения доступны. Их можно изучить без вашей подписки и без необходимости заново задавать модели те же вопросы. В этом смысле открытый код — не просто декларация о хороших намерениях. Это перенос результата из арендованного инструмента в общее пространство, где работу можно продолжить.
Однако выложить репозиторий недостаточно. Сто несвязанных репозиториев ещё не образуют совместную науку. Нужны общие правила проверки, возможность точно указать версию программы, история изменений и понятный ответ на вопрос, чей вклад помог следующему результату. Иначе даже открытые программы остаются изолированными демонстрациями. Мне хочется, чтобы удачная промежуточная правка считалась достижением не меньше эффектного финального ролика — особенно если именно на ней потом построили более сильного бота.
Есть, конечно, неудобный вопрос: зачем выкладывать находку, от которой другой участник оттолкнётся и обгонит вас? Волшебного решения здесь нет. Мы связываем место на доске с открытой версией кода, показываем достижения по разным персонажам и рубежам. А ещё недавно мы переработали немного сайт, теперь считаем импакт каждого хакера и отдельно самые большие сдвиги и вместе с последними улучшения. Через какое‑то время мы даже планируем разыгрывать призы — следите за анонсами в нашем канале.
Сработает ли эта такая мотивация в живом сообществе, заранее неизвестно. Это тоже часть эксперимента — только уже не над игровым агентом, а над тем, как люди вместе ведут исследование.
Мне близок пример Fishtest, где предложения по улучшению шахматного движка Stockfish проходят общую проверку множеством партий. Не потому, что NetHack и шахматы одинаковы — они очень разные, — а потому, что там маленькая правка получает шанс стать частью большого общего результата после проверки, а не после уверенного рассказа автора о её достоинствах. Такой принцип мы и хотим применить здесь.
Возможно, когда‑нибудь NetHack стабильно пройдёт закрытая лабораторная система. Это будет интересно. Но если снаружи останется только сообщение «мы справились», следующему исследователю будет не на чем строить свою работу. Мне гораздо интереснее другой исход: программа, которую можно запустить; история ошибок, которые пришлось исправить; метод, который можно испытать на других длинных задачах. Даже если окончательную победу получит кто‑то ещё, ценность открытой работы от этого не исчезнет.
У NetHackers есть понятный финиш: программа, которая сможет стабильно проходить NetHack в разных данженах и за разных персонажей, с прицелом на уровень игры, который будет превосходить таковой у сильнейших игроков‑людей (61+ прохождение подряд). Но сообщество не обязано существовать вечно, чтобы быть полезным. Если однажды оно закончится, хочется, чтобы после него остались проверяемые программы, данные о неудачах и удачах и привычка не путать один красивый запуск с работающим методом. Пока же игра всё ещё не пройдена программой в наших условиях. Значит, есть что исследовать — и есть к чему приложить собственную голову, код и немного здорового упрямства.
Автор: castielblak

