


Cегодня принято хвастаться достижениями в области ИИ, даже если вы встроили исправление пикселей в текстурах, чем раньше занимался джун-артист, работа кстати непыльная и художник делает её лучше и быстрее модельки до сих пор, но реалии времени диктуют убрать джуна-Васю и взять Клода-помощника. И возникает довольно странное ощущение… если нейронные сети уже научились распознавать изображения, генерировать текст и музыку, управлять автомобилями, играть в сложные гео-политические игры и решать огромное количество задач, которые ещё совсем недавно считались исключительно человеческими, что нам стоит запустить модельку в современную игру и дать ей управление NPC, чтобы сделать его более живым и интегрированным в лор.
Но вот вы заходите с супер-современные (Pragmata, PUBG, выберите свое), как внезапно выясняется, что там по-прежнему находятся старые добрые конечные автоматы, Behavior Tree (поведенческие деревья), эвристик и тонна ифов, который говорит NPC, что если игрок достаточно близко, то надо его атаковать, если игрок убежал, то надо немного его поискать, потом покричать, потом …выберите свое…, а если искать его слишком долго, то следует сделать вид, что вообще ничего не заметили и уйти заниматься своими нпсишными делами, мужественно охраняя сундук с лутом от дерзких взглядов местной живности, которая тоже, кстати, на эвристиках.
И это все происходит в современных AAA проектах, где на рендеринг одного кадра работают сотни потоков, физика считается на нескольких уровнях детализации, анимация использует сложнейшие системы смешивания и procedural animation, а навигация строится на огромных графах и разработчики совершенно спокойно используют ML для отдельных частей графического пайплайна, обработки звука или генерации контента. А вот когда дело доходит до вопроса «что сейчас должен делать этот конкретный NPC», внезапно оказывается, что старый switch по состояниям всё ещё является самым лучшим инженерным решением.
Это выглядит странно, если смотреть на ситуацию глазами человека, ошалевшего от хайпа вокруг ML и привыкшего считать, что любое достаточно сложное поведение рано или поздно следует отдать нейронке, и если мы уже умеем обучать модели играть в игры на уровне человека, то почему бы не взять очередного солдата, дать ему набор возможных действий, и позволить самостоятельно разбираться, когда нужно стрелять, отступать или искать укрытие. Открою небольшой секрет, в одном из недавних проектов мы даже пробовали это сделать, и знаете что получилось… через несколько циклов дообучения NPC переставали создавать театр для игрока.
Но на бумаге всё выглядело достаточно хорошо, потому что задача игрового цикла обычного NPC действительно напоминает RML, там есть состояние окружающего мира, есть набор действий, после каждого действия происходит изменение состояния и есть некоторая награда, которая должна сообщить системе, насколько хорошо она поступила. Дальше мы запускаем процесс обучения и дожидаемся момента, когда агент начнёт находить стратегию, которая максимизирует полученную награду. Не работает… как я уже сказал выше.
Не работает, потому что игровая разработка содержит одну неприятную особенность, о которой все забывают, что игровой AI совершенно не обязательно должен быть “алгоритмически умным”, но должен быть “поведенчески человеческим”, это термин из игрового дизайна, не пытайтесь его описать математикой, все равно не получится. Более того, чем умнее становится NPC, тем хуже становится игра и пропадает ощущение, что мир крутится вокруг игрока.
Представьте обычную ситуацию, когда где игрок заходит в комнату, там его замечает противник, начинается перестрелка, игрок отступает за угол, NPC идёт следом, игрок продолжает отходить, NPC продолжает преследование, затем игрок сворачивает в соседний коридор и снова пытается оторваться, а противник всё это время продолжает искать цель. Потому что с точки зрения ML и доступной ему информации игрок ещё где-то рядом, к вам в дом вломились и пошумели, значит, разумно продолжать преследование.
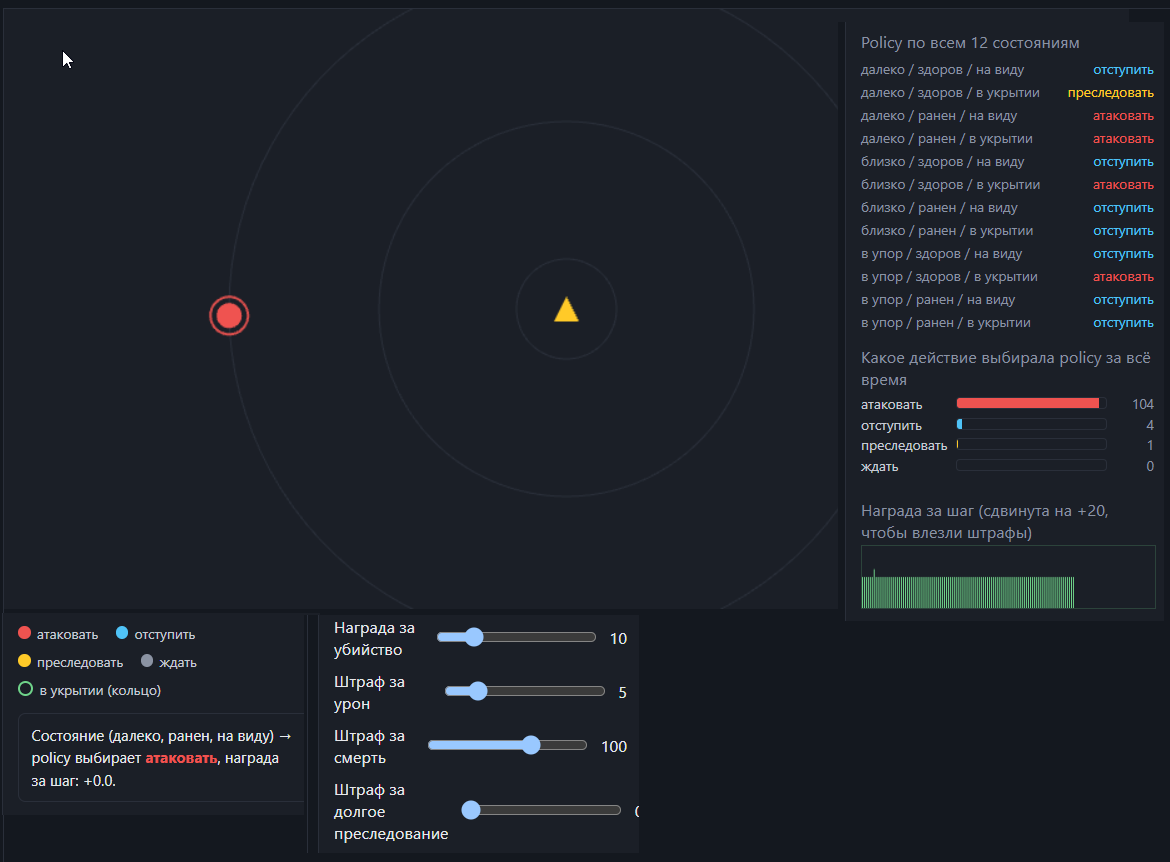
Потом мы втаскиваем эту модель в игру, и игрок, нактнувшись на некоторых таких NPC понимает, что противник будет преследовать вечно, перестаёт воспринимать его как противника, с которым нужно сражаться, и начинает воспринимать его как систему, поведение которой можно заэксплойтить. Отходит на нужное расстояние, дожидается, пока NPC окажется в удобной позиции, и использует предсказуемость поведения против него самого.
Что делает дизайнер? Он ставит таймер на время преследования, чтобы через тридцать секунд противник прекратил преследование и вернуться обратно. Причём совершенно неважно, действительно ли NPC потерял игрока, насколько вероятно, что игрок всё ещё находится в соседней комнате, насколько хорошо система восприятия может восстановить его положение и насколько логично с точки зрения реального человека было бы продолжить поиск.
Дизайнерская задача вообще находится на другом уровне и не моделирует поведение солдата в реальном мире, а пытается построить такую последовательность событий, которая будет интересной для человека, сидящего перед экраном. Помните, что игра это театр для одного зрителя, я буду возращаться к этому еще не раз.
Когда мы пишем обычную программу, то достаточно чётко сформулировать, что означает правильный результат и переложить это в алгоритм, а в игре правильный результат очень часто вообще невозможно определить, потому что нас интересует не только то, что сделал компьютер, но что при этом почувствовал игрок.
Если NPC проиграл бой, это может быть плохим результатом, потому что AI оказался слишком слабым, а может быть отличным результатом, потому что игрок после двадцати попыток наконец научился читать его атаки и почувствовал, что стал лучше и “умнее” игры (это называется эффект отложеной победы). Вас могут специально убивать первые несколько раз, каким бы мощным оружием вы не дрались, и отправлять на респаун, или наоборот постепенно снижать мощность босса с каждым релоадом, только… тсс.. я вам ничего не говорил, это все просто мысли вслух.
Если NPC убил игрока, это может означать, что игровой ИИ прекрасно выполнил свою задачу, а может означать, что дизайнер ошибся с балансом и игрок просто не получил возможности победить . Теперь мы хотим обучить нейронку всему этому и как именно мы собираемся записать удовольствие игрока в функцию награды?
Функция награды
опустим, мы всё-таки решили обучать нашего противника через RML и начали c функции, что десять очков за убийство игрока, минус пять за полученный урон и минус сто за собственную смерть. Т.е. мы показали нейронке, что нужно убивать игрока и при этом постараться не умереть самому.
И модель находит стратегию, когда гораздо выгоднее вообще не выходить из укрытия, чем рисковать получить урон. И NPC начинают ныкаться по углам всю игру, потому что с точки зрения заданной функции это окажется неплохой стратегией, ну как… интересно вам в такое играть будет?
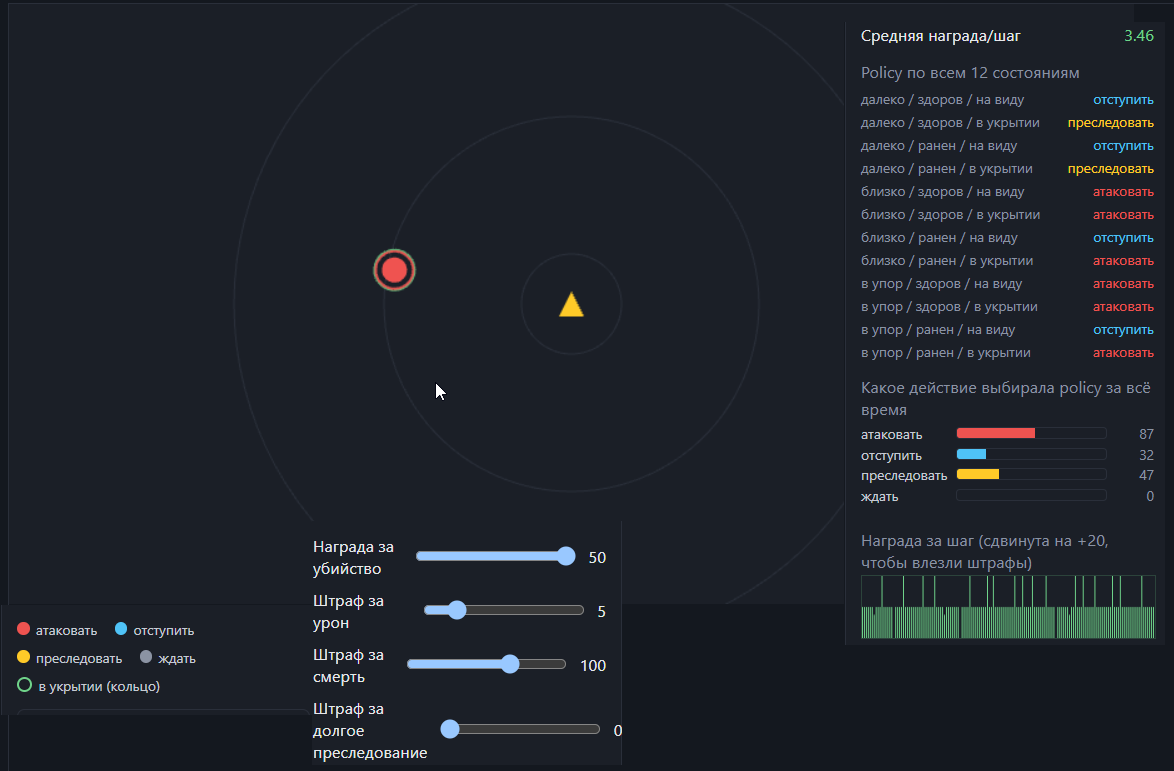
Ладно, поднимаем параметр убийства игрока, который начинает приносить настолько большую награду, что остальные штрафы становятся несущественными, а на несущественно, как вы помните перестают обращать внимание. Теперь NPC начинают вести себя безумно агрессивно, потому что именно это математически оказывается оптимальным.
Тогда добавляем штраф за слишком долгое преследование и модель вообще отказывается от поиска игрока, потому что после нескольких обучений потенциальная награда перестанет окупать риск. В итоге нам не нравится в целом получившееся поведение, и мы начнём менять веса, добавлять дополнительные условия, вводить новые награды, менять коэффициенты и запускать обучение снова, причём через какое-то время почти неизбежно столкнёмся с тем, что исправление одной ситуации влияет на несколько других, потому что модель не знает наших намерений и не понимает, что именно мы считали побочным эффектом, она просто пытается найти наиболее выгодную стратегию в том пространстве, которое мы ей предоставили.
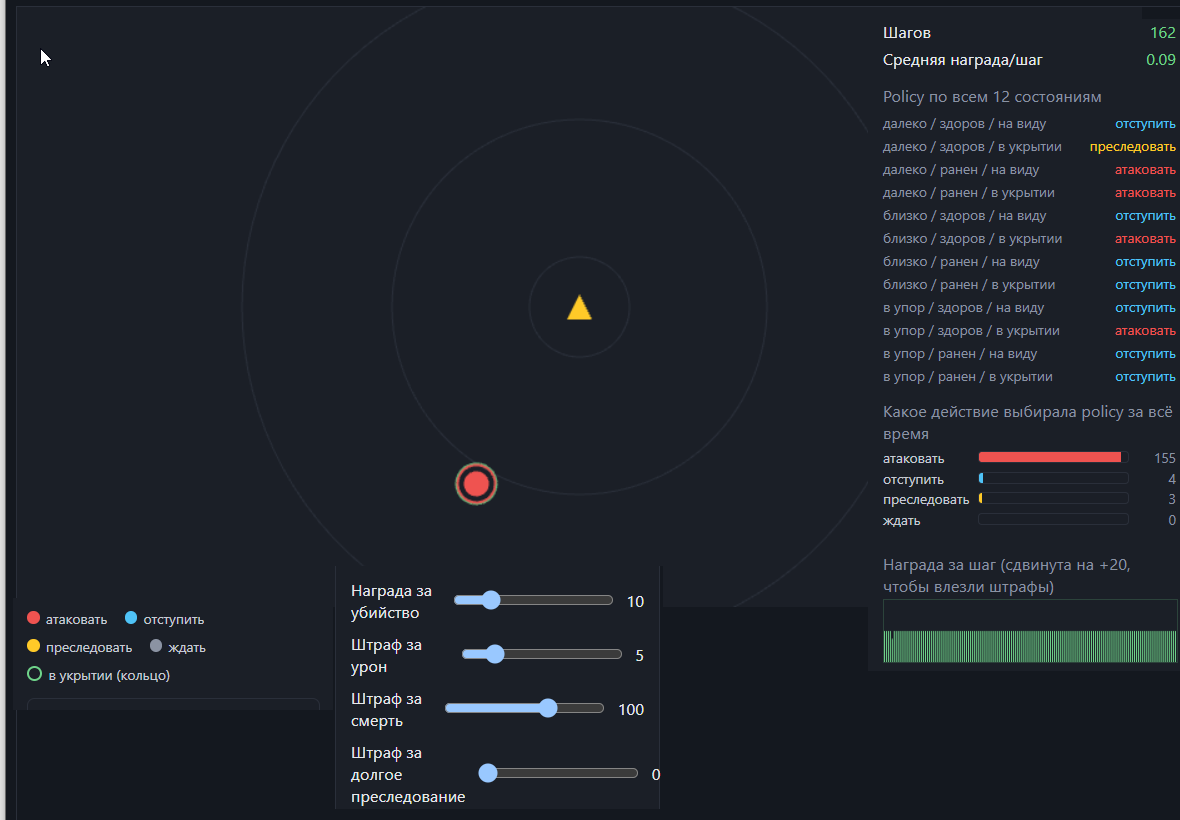
Мы можем, конечно, продолжать совершенствовать функцию награды, но это постепенно затягивает нас в неприятный цикл, и чем больше деталей мы добавляем в функцию оценки, тем больше она начинает напоминать попытку описать весь игровой дизайн с помощью огромного промта. В какой-то момент возникает совершенно закономерный вопрос: а зачем мы вообще пытаемся заставить нейронную сеть вывести правила, которые нам уже известны и которые мы могли бы написать непосредственно в коде?
Если дизайнер говорит, что NPC должен прекратить преследование игрока после тридцати секунд, то у нас нет никакой особой причины заставлять модель самостоятельно открывать это правило через обучение и можно просто написать.
if (timeSinceLostPlayer > 30.0f)
    returnToPost();
Профит… наши NPC, стали вести себя адекватно и предсказуемо. И вот вернув с десяток таких проверок в код, вы понимаете, что “тупой AI” вполне осмысленная часть игрового дизайна.
Игра меняется
Ну ок, кто-то волевым решением протащил эту несчастную нейронку, которая обложена километровым промптом в игру. Потом приходит дизайнер и хочет, чтобы враг был агрессивнее, потом приходит дизайнер уровня и говорит, что надо учитывать скорость передвижения игрока, через неделю дизайнер оружия добавляет новую пуху и её тоже надо как-то учесть в промте, потом добавляют систему укрытий (про систему укрытий я уже писал, если интересно), затем появляется новый тип врага, который должен работать вместе со старым, потом выясняется, что на одной из карт NPC слишком часто застревают в проходах. После плейтестов приходит первый дизайнер и говорит, что враг выглядит слишком предсказуемым и нужно слегка изменить его поведение. Слегка, блин… ты видел что мы тут за этот месяц наворотили? И это совершенно обычная нормальная разработка.
В этом смысле Behavior Tree, FSM или Utility AI выглядят белыми, понятными и пушыстыми, давая удобный интерфейс взаимодействия между программистом и дизайнером, потому что дизайнеру важно видеть не только результат работы системы, а программисту онимать, почему она в данный момент выбрала именно это поведение.
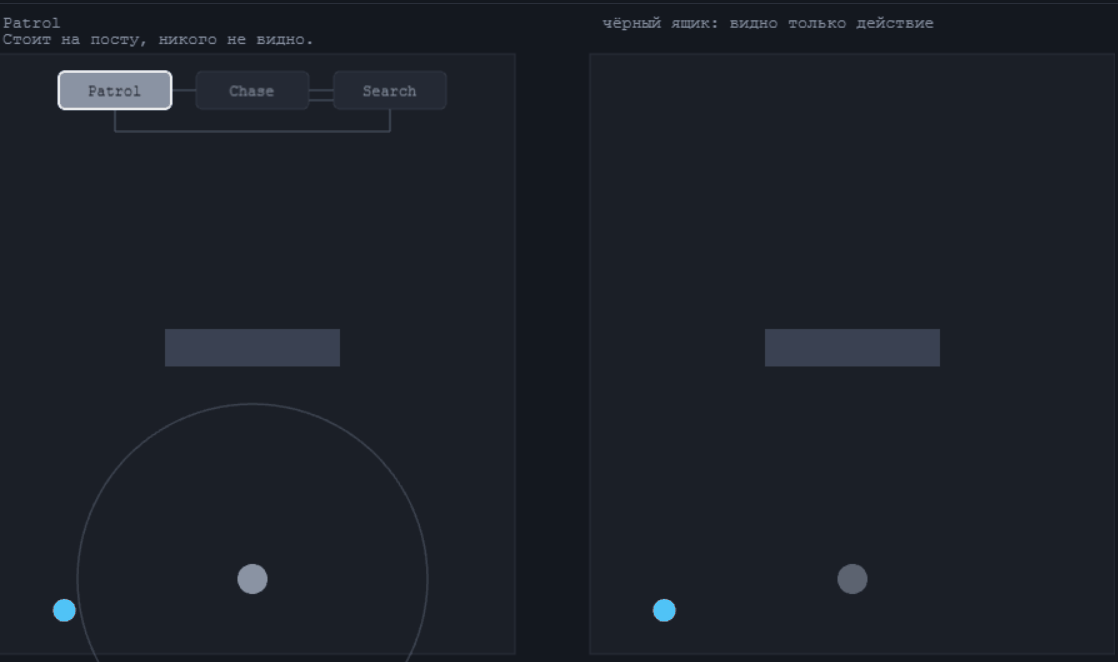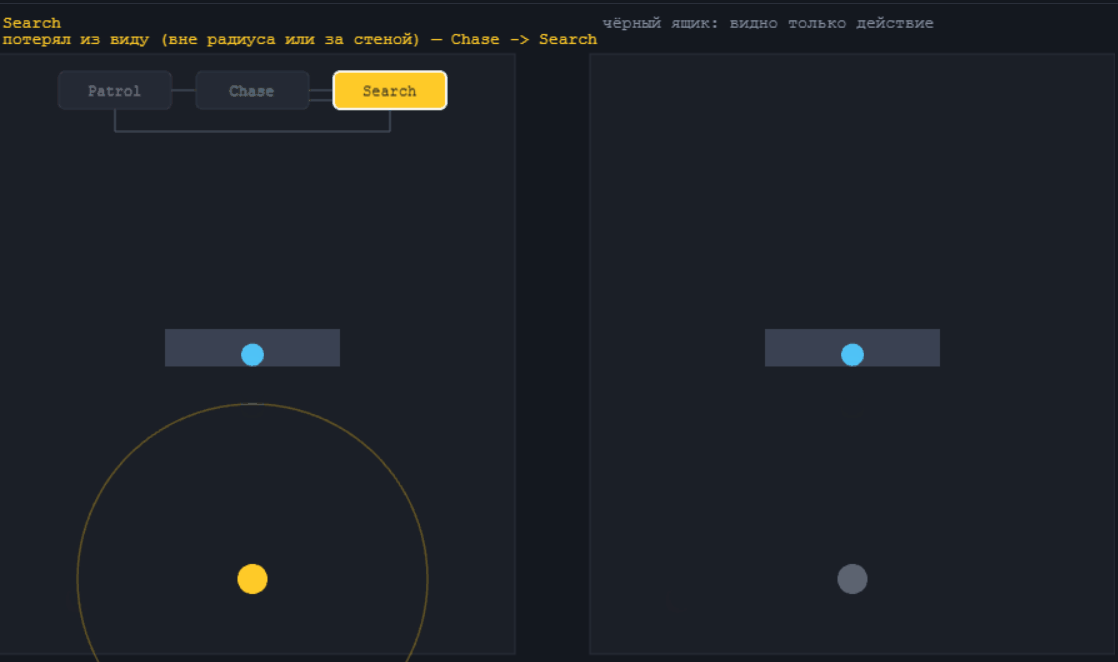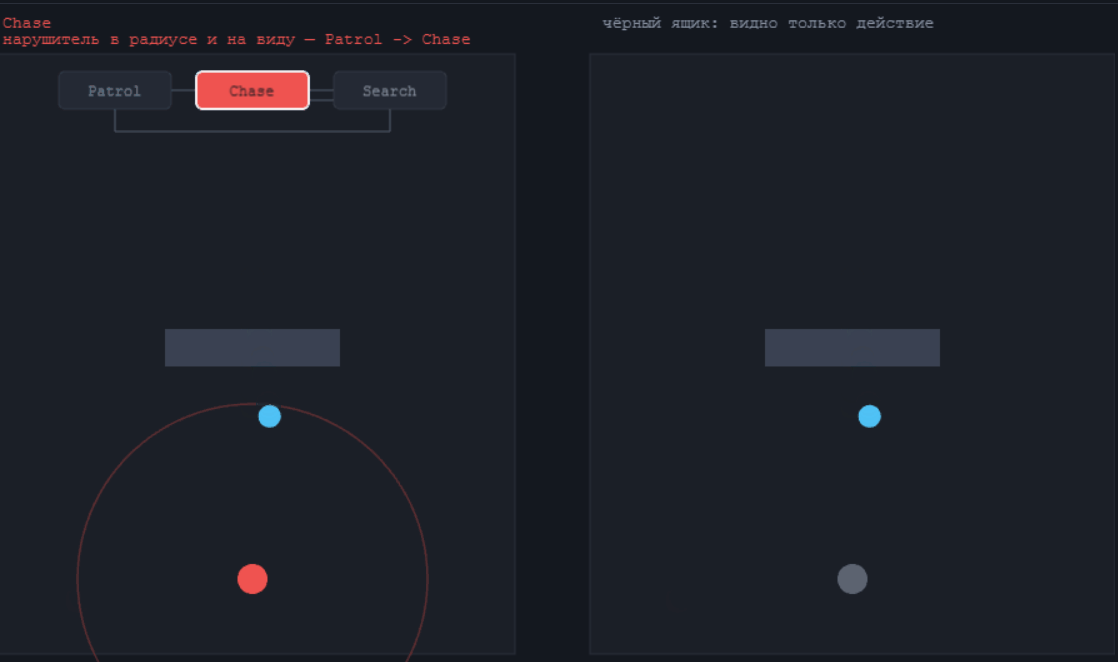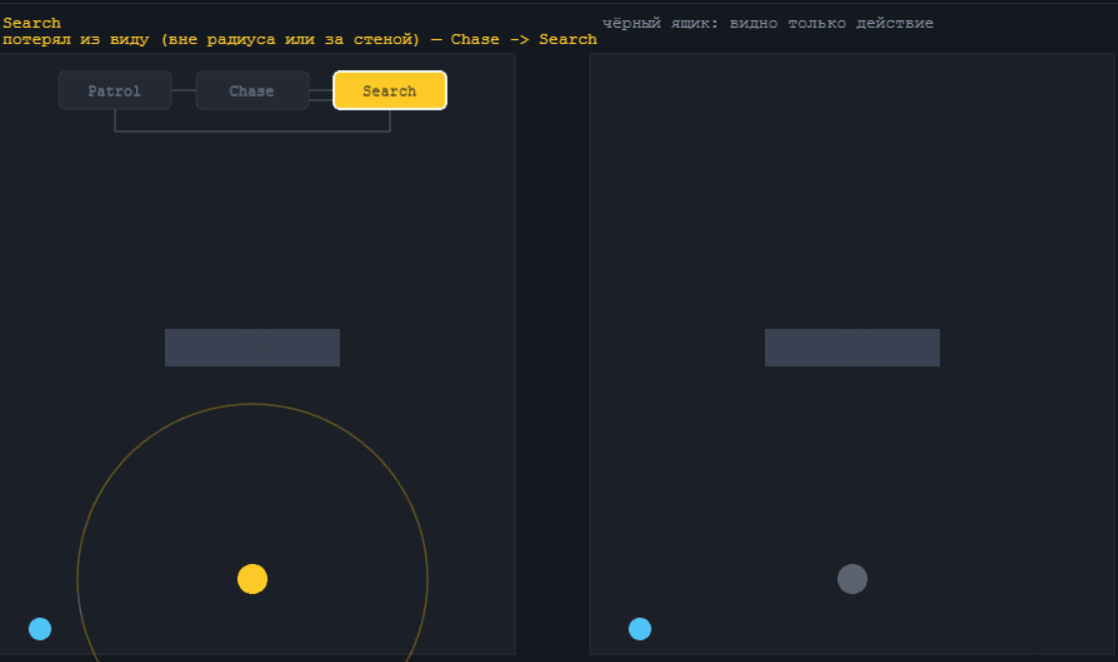
Когда перед тобой лежит дерево поведения, ты можешь открыть его, поматериться на криворукость дизайнера и лапшеноды, но пройти сверху вниз и увидеть, что NPC сначала проверяет возможность атаки, затем пытается занять укрытие, после этого, если цель потеряна, запускает поиск и только потом возвращается к патрулированию.
При необходимости можно добавить новое условие, переставить приоритеты, поменять время ожидания, изменить радиус поиска или вообще отключить кусок поведения, и результат можно проверить сразу. И здесь хорошо видно, почему хороший игровой AI должен быть не просто RML системой, которая умеет принимать решения, а инструментом, который настраивается ползунками и конфигами, а не промтом.
А теперь скажите как работают современные ML модели? Если забыть на минуту про удобство разработки и представить, что у нас каким-то чудом уже есть идеальная нейронная сеть, способная практически мгновенно анализировать состояние игрового мира и выбирать оптимальное действие, проблема ползунков никуда не исчезает.
Мы действительно получим очень хороший алгоритм принятия решений, но не обязательно получим хорошего игрового противника. У вас получается NPC? который способен видеть игрока в любой точке уровня, который идеально знает дальность своего оружи и мгновенно выбирает оптимальное укрытие и прекрасно понимает, когда нужно атаковать, когда отступать и когда вызвать подкрепление. Отличный получился кто… босс? Но тогда возникает вопрос, а как его вообще победить? Вы пришли в игру чтобы вас постоянно наваливал или чтобы наваливать после рабочего дня?
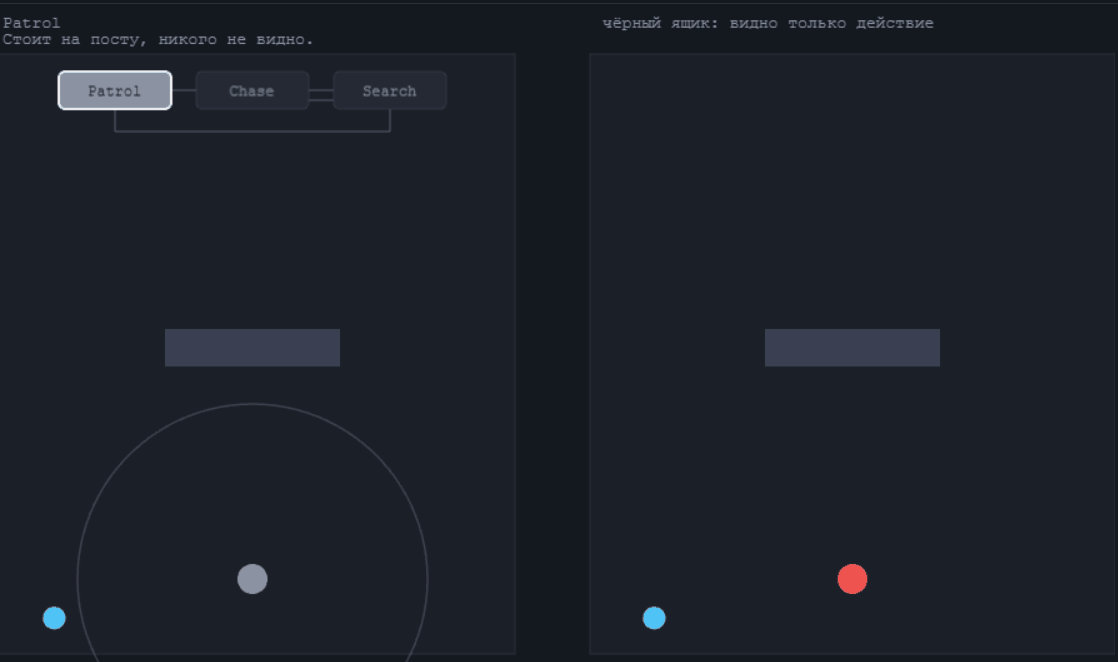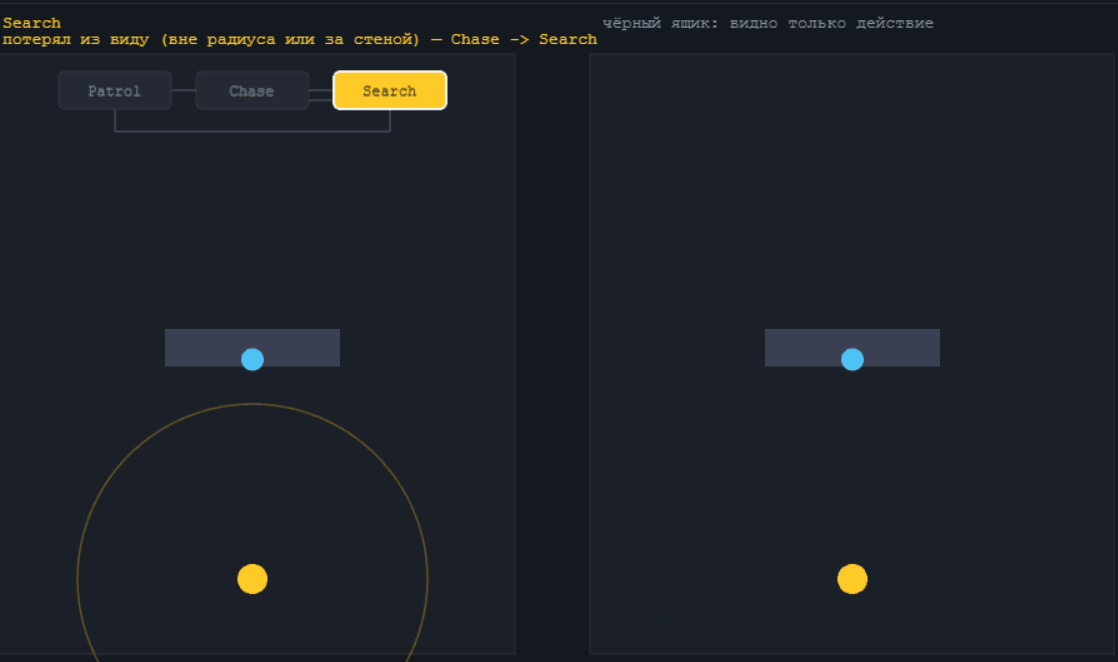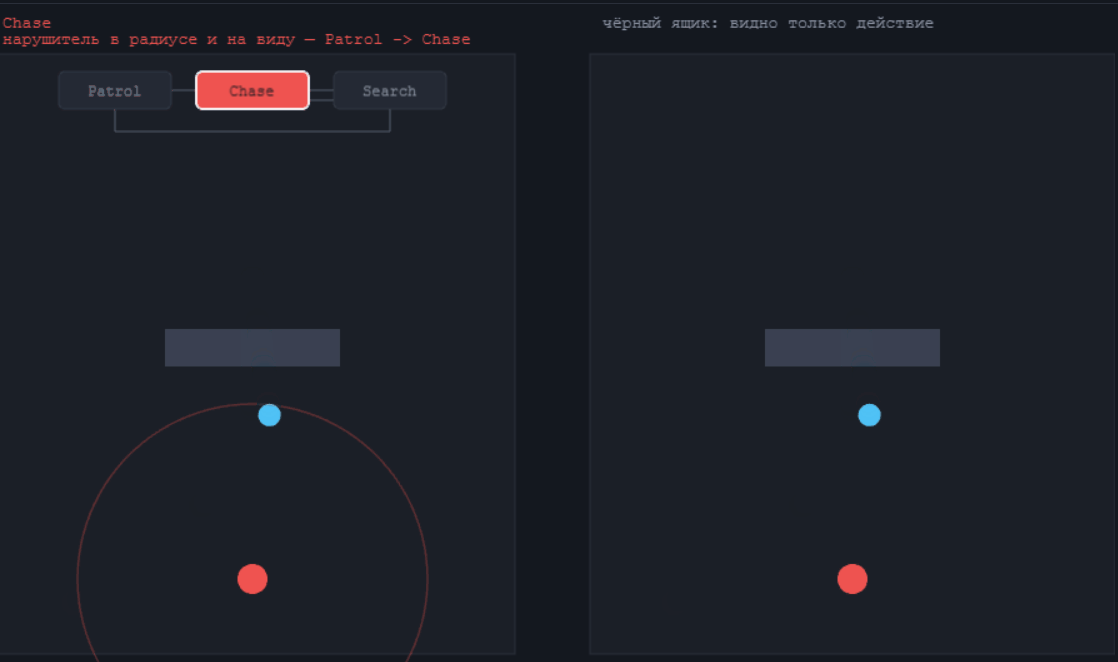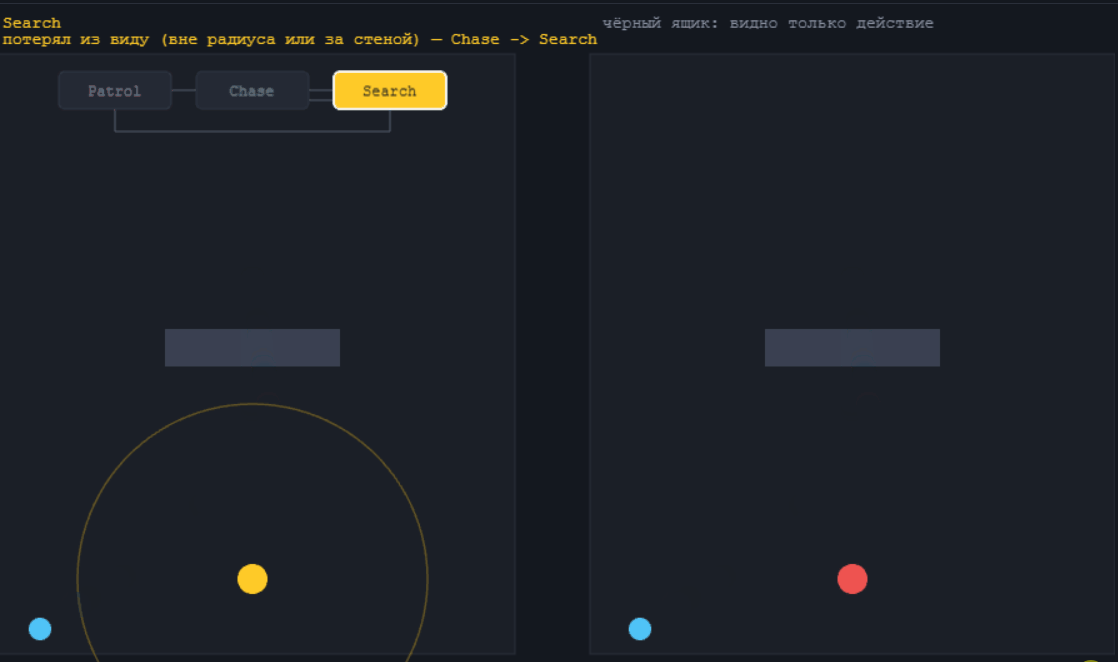
Если NPC каждый раз выбирает позицию, из которой игрок не может его достать, никогда не делает лишнего движения, мгновенно реагирует на каждое действие игрока и всегда использует наиболее эффективную атаку, то игроку не получится научиться побеждать, потому что он просто будет умирать. С десяток таких “побед” и ваша игра улетит в мусорку как читерная и непроходимая, потому что есть с десяток других неигранных в беклоге.
И поэтому разработчики игр делают с “игровым ИИ” довольно странные вещи, снаружи выглядищие как деградация системы. Ему ограничивают обзор, добавляют задержку, запрещают использовать некоторые способности слишком часто, уменьшают точность, вводят “откаты способностей”, заставляют противника менять позицию без особой причины и специально оставляют игроку возможность атаковать.
Если смотреть на это глазами человека, который пытается построить максимально эффективный автономный агент, всё это выглядит почти как сознательное ухудшение алгоритма. Не смотрите на игру как инженер, смотрите на неё глазами игрового дизайнера, которому надо построить интересную боевую систему. Игроку нужен не математически оптимальный противник, а противник, поведение которого оставляет достаточно пространства чтобы его наблюдать, понимать, предугадывать и в конечном счёте использовать эти знания для победы. И я опять возвращаю вас к понятию “театра для одного зрителя”.
Предсказуемость тоже игровой дизайн
Т.е. чрезмерно умный и непредсказуемый AI оказывается хуже простого и условно глупого, для которого игрок может построить в голове собственную модель мира за экраном.
Сначала замечает, что враг стреляет, потом после нескольких столкновений понимает, что после определённой атаки NPC отступает, затем замечает, что если приблизиться на определённое расстояние, враг начинает использовать дробовик, после чего обнаруживает, что если зайти за укрытие и быстро выглянуть с другой стороны, NPC начинает менять позицию, и через несколько часов игры всё это превращается в нечто вроде внутреннего набора правил, которым игрок начинает пользоваться совершенно автоматически, это называется “прогрессия мастерства игрока”, игровых дизайнеров этому учат почти два года… и многие все-равно не усваивают.
В этот момент и происходит рождение “хорошего игрового ИИ”, ради чего, собственно, игры и существуют: игрок перестаёт просто реагировать на систему и начинает понимать её, потому что знает и что происходит сейчас, и что произойдёт через несколько секунд. Значит, может заранее построить собственную стратегию, или создать нужную ситуацию, или заставить противника выбрать определённое действие и затем использовать результат этого решения в своих интересах.
Но если поведение NPC каждый раз остается непредсказуемым образом, то игроку становится гораздо сложнее построить такую модель, и вместо ощущения постепенного “мастерства” возникает усталость от необходимость каждый раз угадывать.
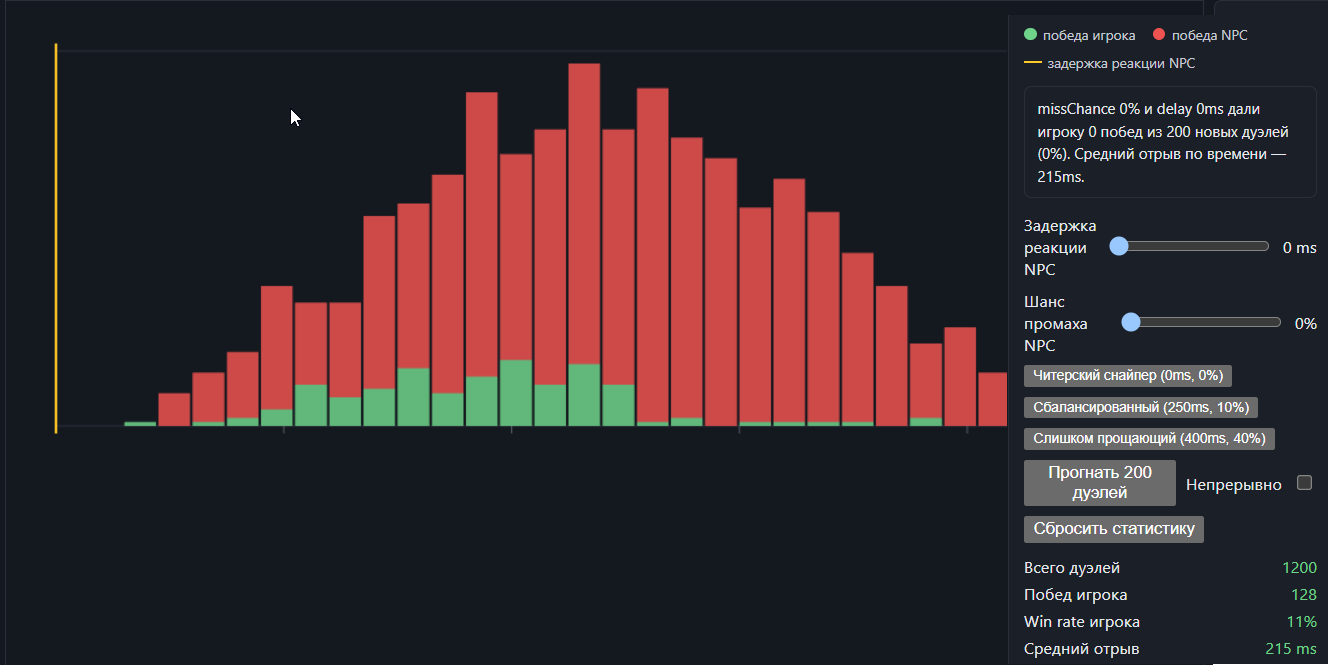
Поэтому некоторые игровые ИИ делают достаточно ограниченными, и не обязательно это означает, что разработчики ленивые и не смогли сделать их умнее. Могли, но такие ограничения позволяют игроку увидеть структуру поведения противника, а без этой структуры исчезает значительная часть пространства для обучения, экспериментов и осознания собственного прогресса. Большинство моих коллег сходятся на мнении, что слишком умный ИИ разрушает чувство погружения, тот самый “театр для одного зрителя”.
NPC должен ошибаться
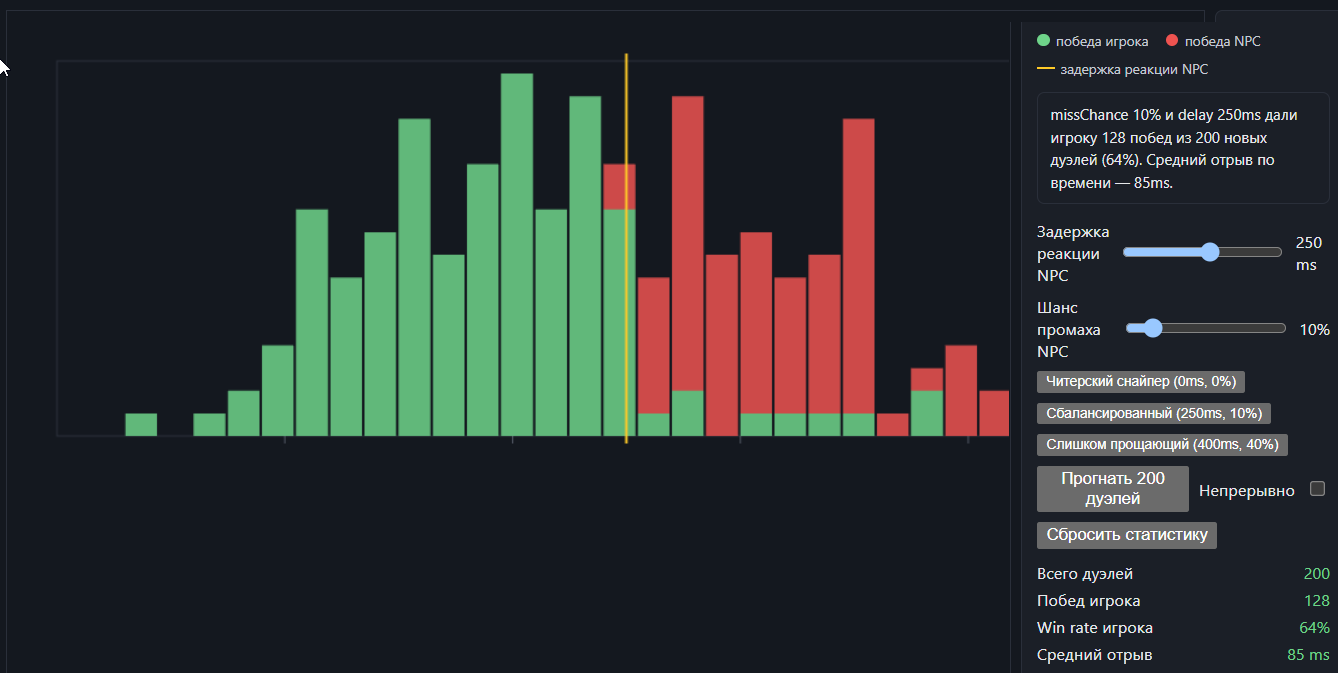
Это вообще одна из самых интересных задач игрового ИИ, чтобы правильно выбрать место и время, где системе разрешено быть несовершенной. Слишком плохое зрение вызывает у игрока раздражение и ощущение тупости игры, слишком хорошее зрение создаёт ощущение читерства, слишком медленная реакция делает бой скучным, мгновенная реакция заставляет человека чувствовать себя ущербным, идеально выбранные позиции и безошибочное использование оружия довольно быстро превращают любого врага из интересной задачи в “сложную игру”.
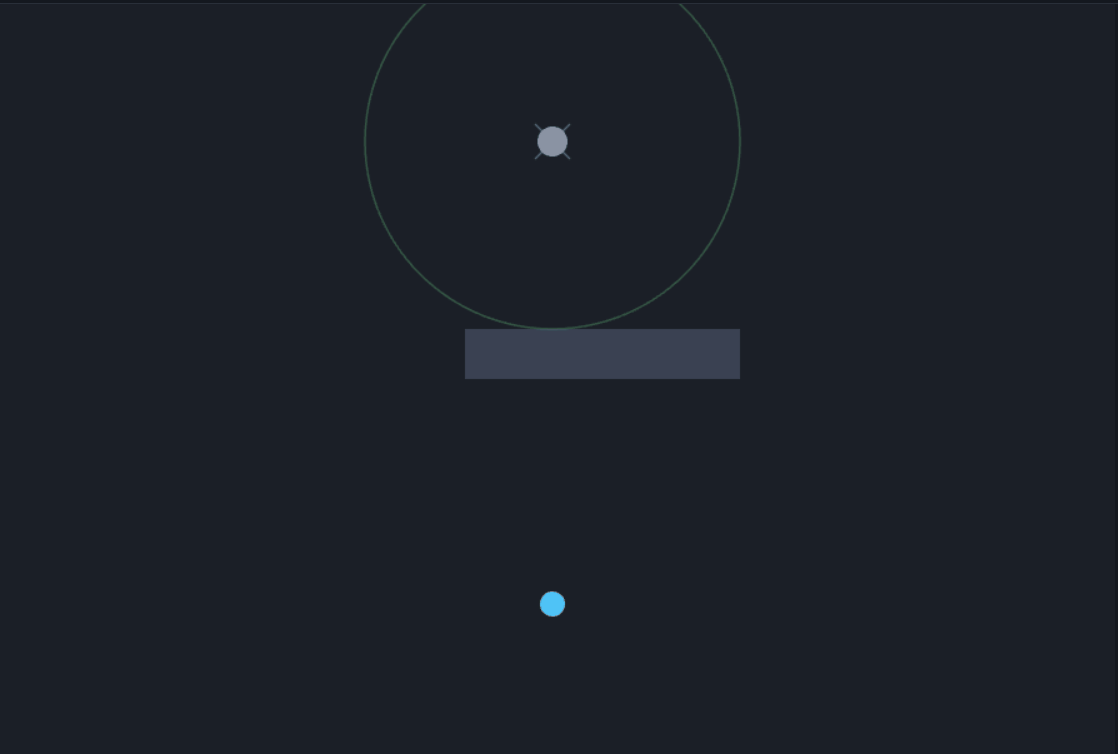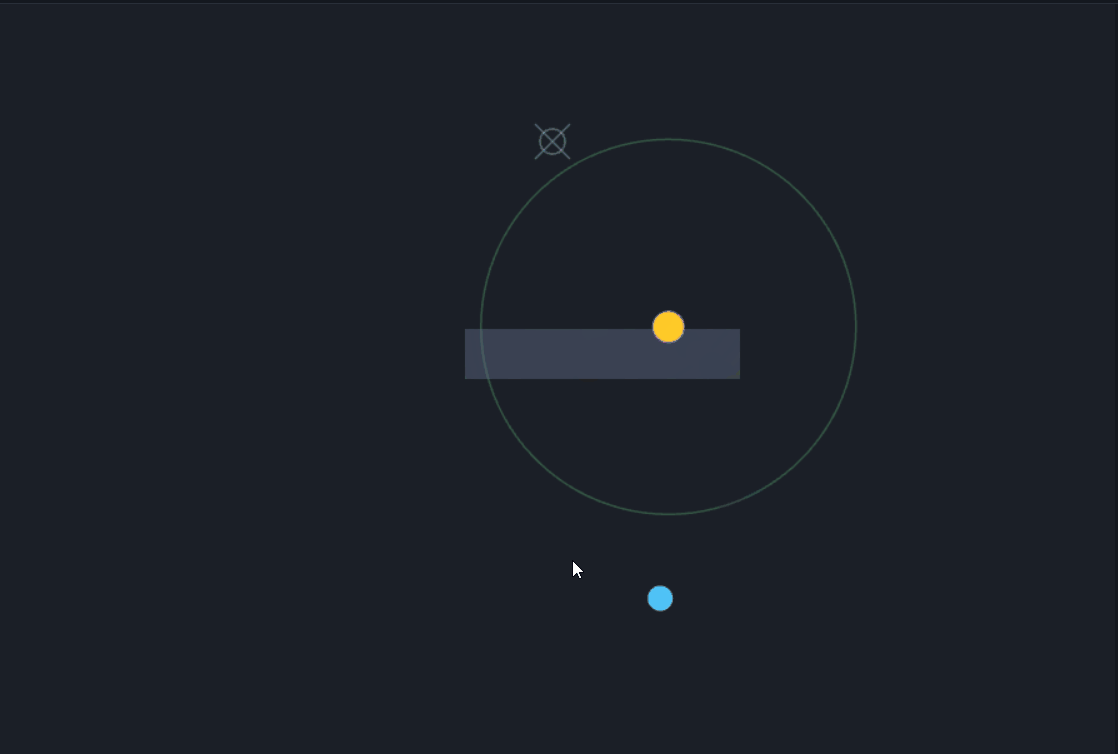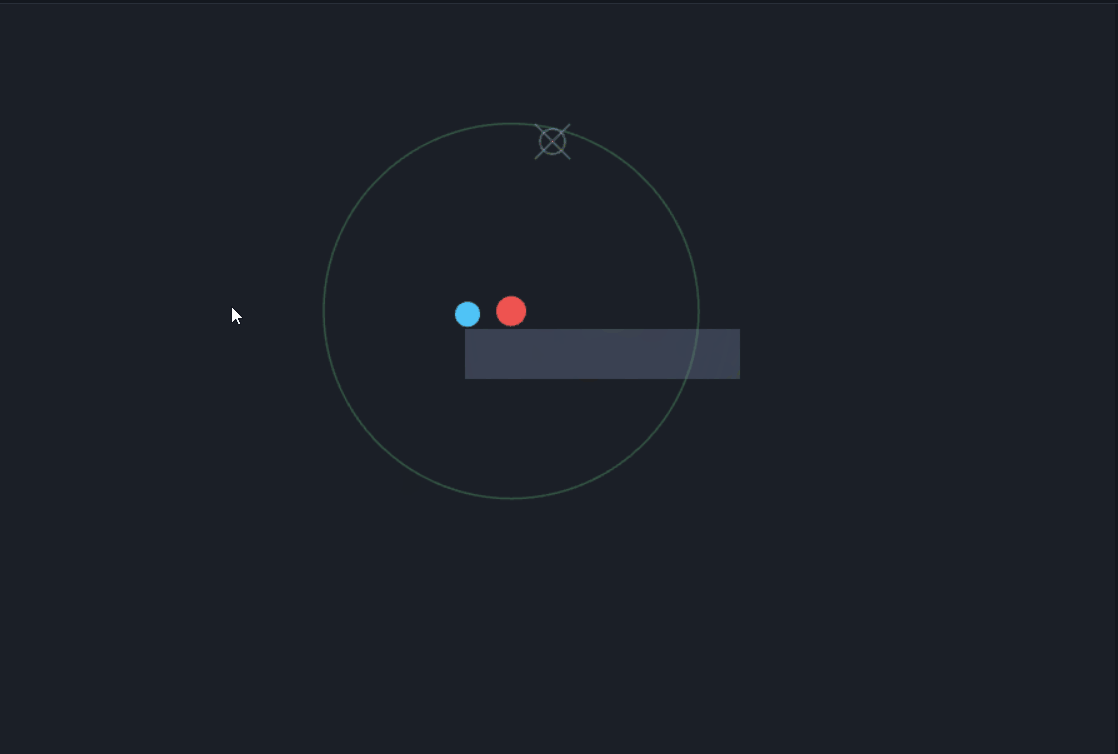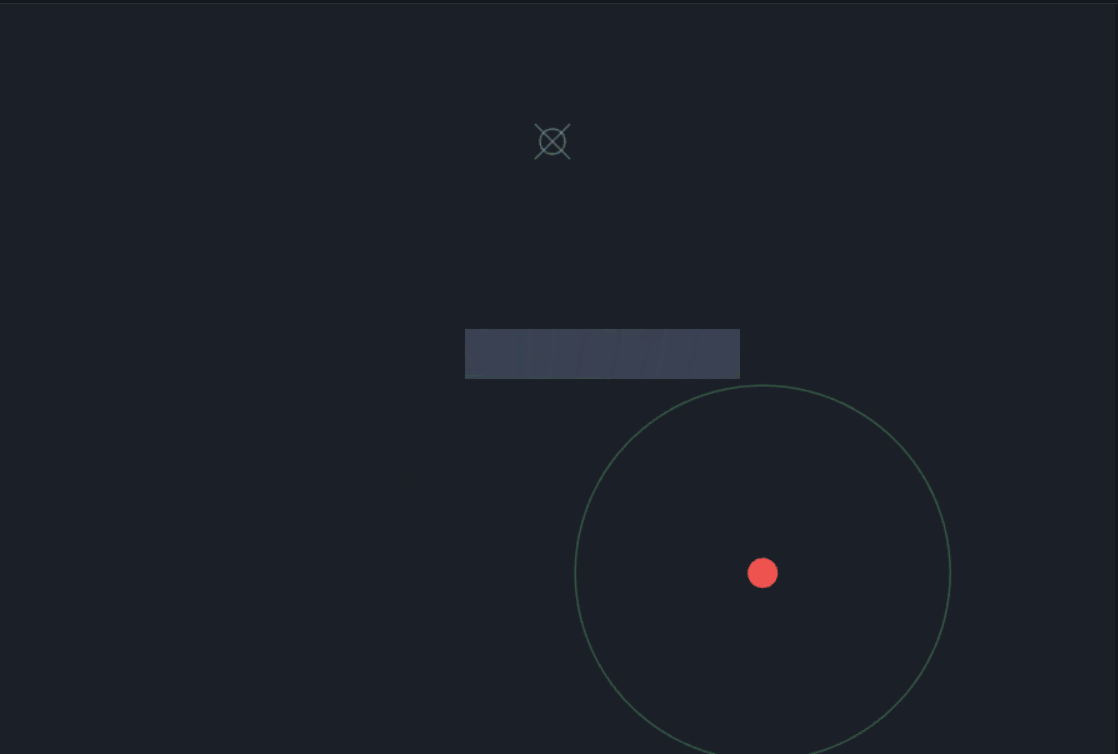
Поэтому оставляют NPC некоторую вероятность ошибиться, выбрать неидеальное укрытие, слишком долго оставаться за стеной, не сразу заметить движение игрока или прекратить преследование через 30 секунд. Но эти ошибки не должны выглядеть случайным сбоем, чтобы игрок воспринимал их как естественную часть поведения персонажа.
И тут возникает довольно тонкая разница между случайной тупость и контролируемой слабостью, когда NPC периодически смотрит в стену или начинает бесцельно бегать по комнате, игрок почти мгновенно решает, что игра сломана, но если враг иногда слишком долго остаётся за укрытием, не сразу реагирует на выстрел или позволяет себя обойти, игрок может вполне естественно решить, что нашёл у него слабое место и теперь может сознательно использовать его в следующем столкновении.
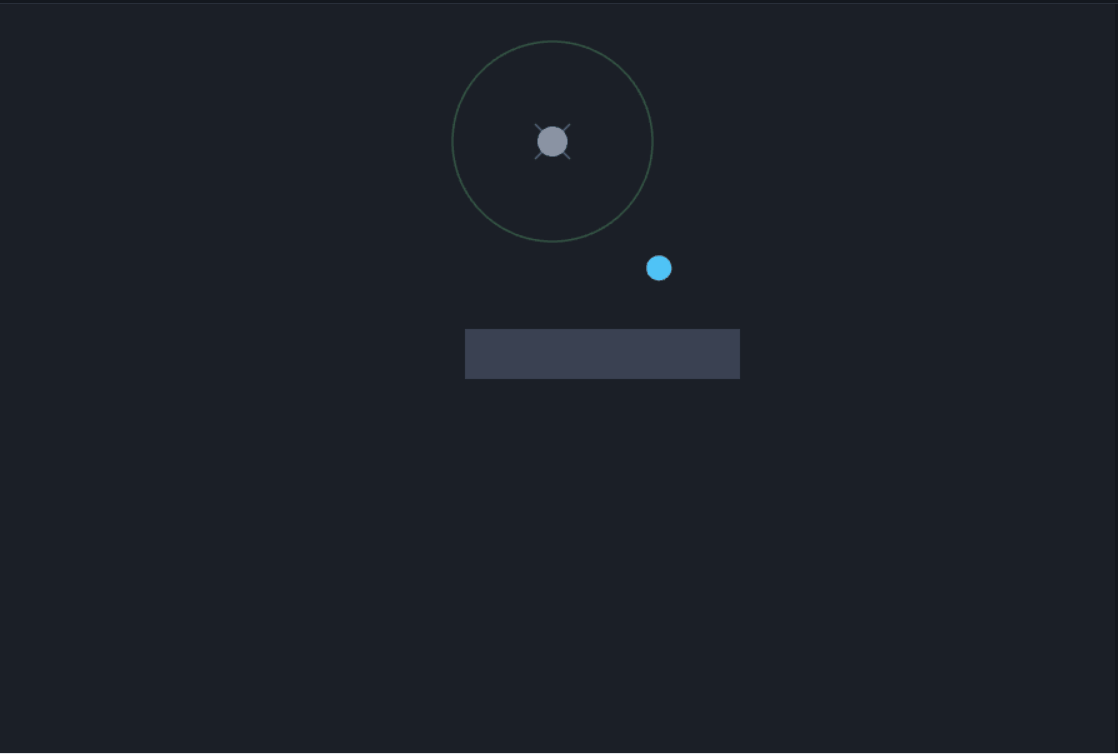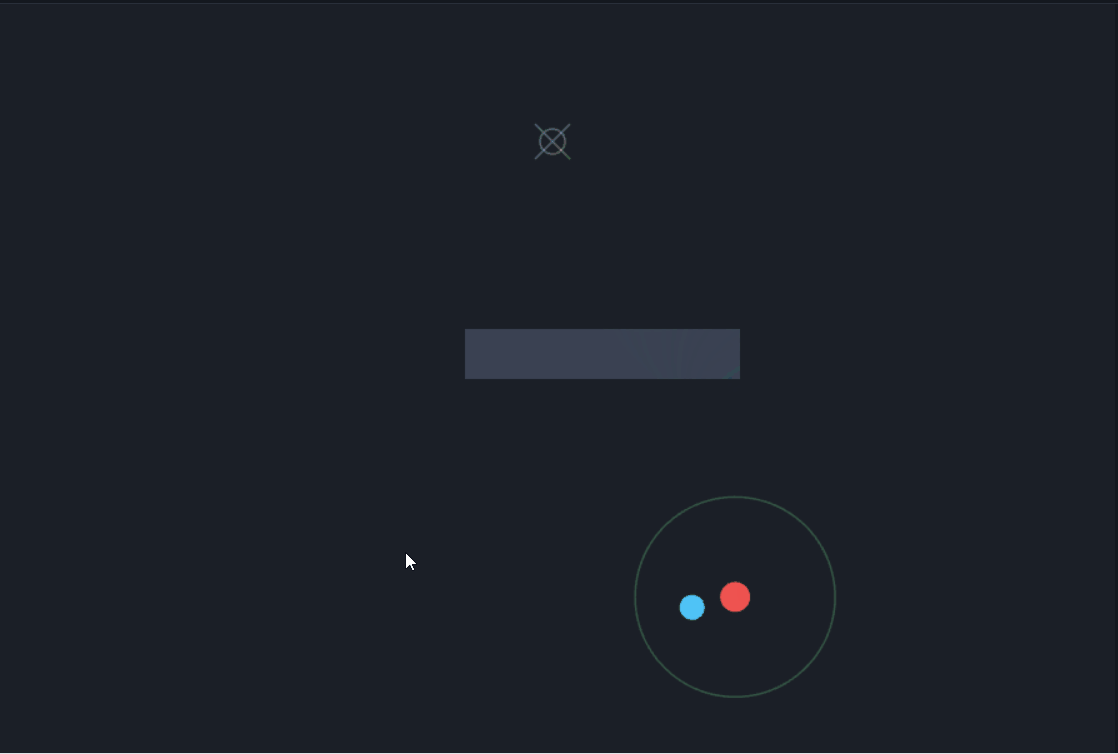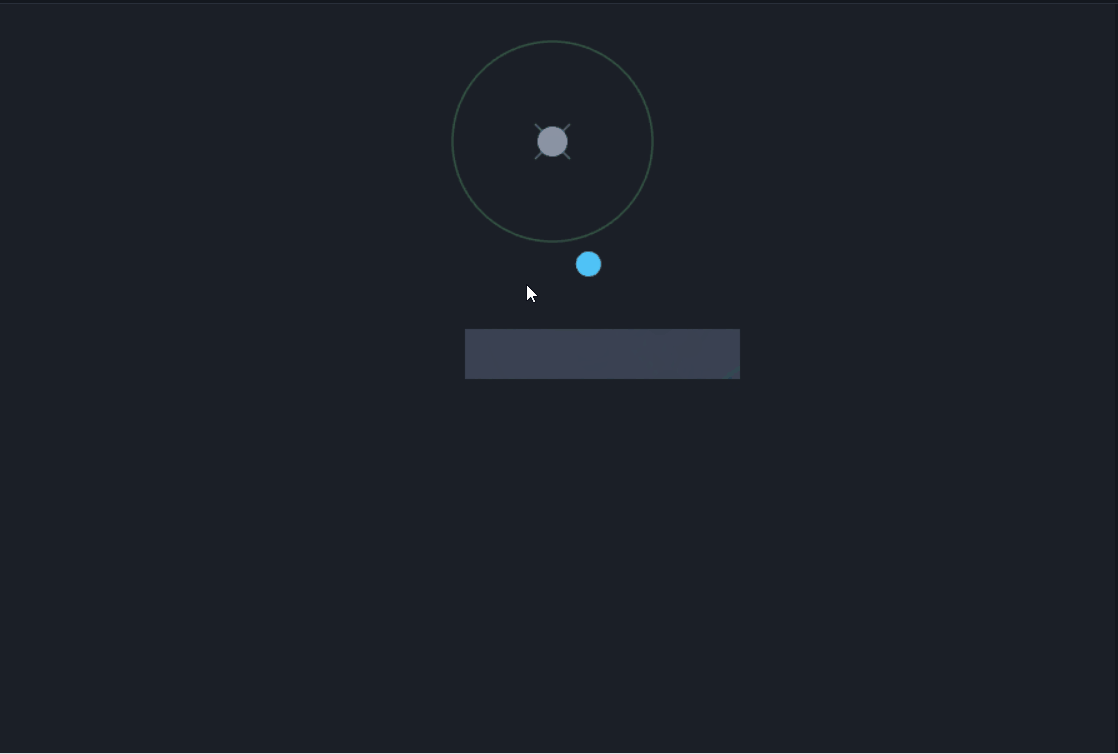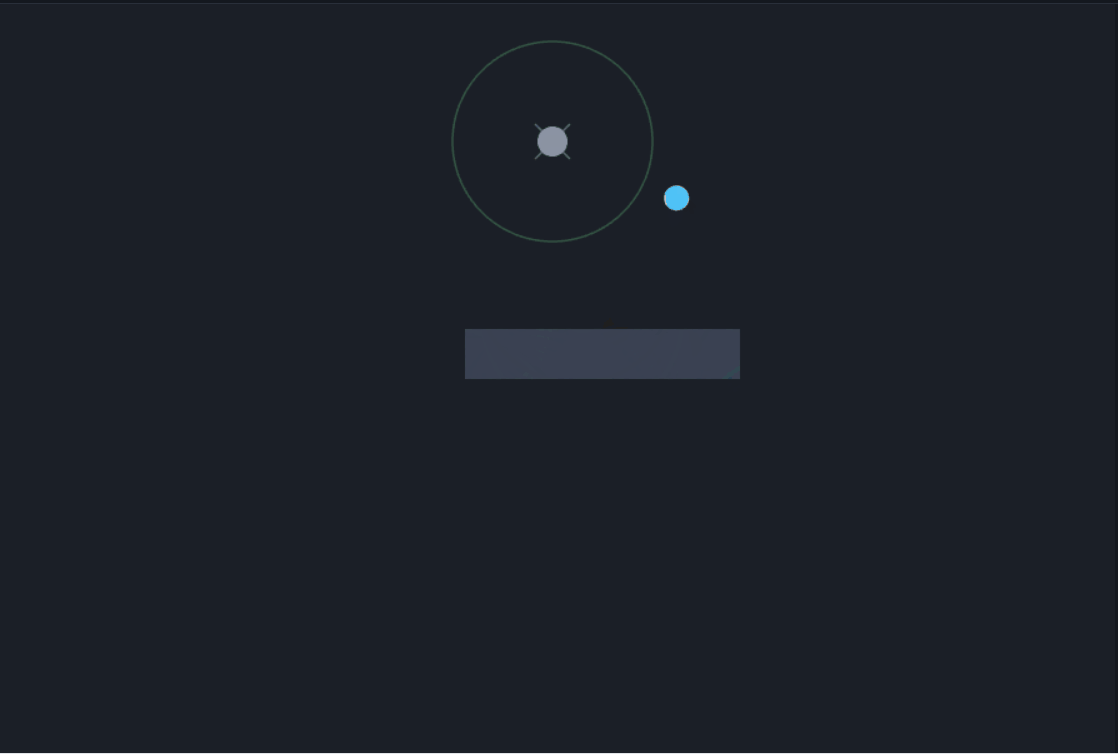
С точки зрения внутренней реализации эти два поведения могут быть разделены несколькими строками кода, но с точки зрения игрового опыта между ними огромная разница, потому что в первом случае человек обнаруживает ошибку разработчика, а во втором получает новую закономерность игровой системы, которую можно изучить и использовать.
Где игры используют ML
Можно подумать, что машинное обучение плохо подходит для игр… это не так, вернее не совсем так, потому что в игровых движках существует огромное количество задач, где ML оказывается вполне естественным и очень полезным инструментом, просто они находятся немного в стороне от самого «мозга» NPC.
У нас есть огромное количество motion capture данных, которые необходимо очистить, сгладить, классифицировать или преобразовать в более удобную форму для дальнейшего использования, и здесь как раз прекрасно работает модель, которой можно показать большое количество хороших примеров и позволить ей научиться воспроизводить нужное преобразование, но финалку все равно чистит человек, это называется “human touch”.
Не особенно важно, почему модель решила немного изменить конкретный кадр анимации, если после обработки движение выглядит естественно и персонаж перестаёт дергаться. То же самое происходит с голосом, обработкой изображений, лицевой анимацией… и тд и тп
Но даже в таких задачах ML не полностью заменяет существующие алгоритмы, и гораздо интереснее выглядит комбинация, когда классический код выполняет ту работу, для которой хорошо известны правила и где нам важна предсказуемость, а машинное обучение используется там, где формализовать все эти правила вручную оказалось бы слишком дорого или практически невозможно.
И мы наконец подходим к главной причине, по которой классический игровой AI продолжает жить в эпоху Claude, ChatGPT и тратить силы игровых дизайнеров. Нейросетка вообще не испытывает никаких проблем с принятием решений, и ей совершенно несложно перебрать огромное количество вариантов, посчитать стоимость пути, оценить несколько кандидатов, выбрать максимальное значение или выполнить несколько тысяч проверок за один кадр, но когда вопрос заключается в том, должен ли NPC через десять секунд после потери игрока продолжать его искать, спрятаться, вернуться на позицию или прекратить преследование, потому что игроку в этот момент станет интереснее двигаться дальше по уровню, мы уже начинаем описывать не техническую задачу, а дизайнерское видение.
И это видение очень плохо превращается в промт или функцию награды, поэтому приходится туда добавлять туда продолжительность боя, вероятность смерти игрока, количество нанесённого урона, время нахождения в опасной зоне, разнообразие использованных атак, количество успешных уклонений и ещё десятки других параметров. В какой-то момент эта функция начинает выглядеть как отдельный GDD, и появляется довольно естественный вопрос, а действительно ли нам нужна нейронная сеть, которая будет пытаться вывести из этих чисел поведение, уже известное дизайнеру.
Если мы заранее знаем, что после потери игрока NPC должен искать его двадцать секунд, а затем возвращаться на исходную позицию, то нет особого смысла заставлять систему самостоятельно обнаруживать эту закономерность. Если мы знаем, что босс должен менять фазу после потери определённого количества здоровья, то этот переход не обязан быть результатом многомиллионного цикла обучения. Если мы знаем, что противник должен иногда оставлять игроку окно для атаки, то это окно можно непосредственно заложить в его поведение.
Здесь нет технологического поражения, потому что дизайнер или разработчик игры не обязан использовать наиболее сложную из существующих технологий, где уместен более простой инструмент.
Старые технологии продолжат быть
Когда смотришь на современный игровой движок оказываеться, что большинство технологий, существуют уже десятилетиями и продолжают спокойно соседствовать с самыми современными системами.
Внутри одного и того же проекта можно встретить ECS, job system, сложную физику, DLSS, streaming world и огромное количество асинхронных подсистем, а рядом с ними будет находиться какой-нибудь старый конечный автомат, который по сути всё ещё рулит NPC, и после состояния Chase переводит его в Search, а после него, если цель так и не найдена, вернет его в Patrol.
FSM, Behavior Tree, Utility AI и скриптовые системы позволяют описывать видение дизайнера, которое надо сделать в конкретной игре, на конкретной карте, в конкретном контексте и при этом оставить его достаточно прозрачным для разработчика, чтобы его можно было тестировать, балансировать, отлаживать и изменять вместе с остальной игрой.
Машинное обучение решает другую задачу и позволяет искать закономерности там, где вручную описать их слишком сложно, а количество возможных вариантов настолько велико, что программисту гораздо дешевле предоставить системе огромное количество примеров и позволить ей самой найти подходящее решение.
А классический AI может определить, что NPC должен сейчас находиться в боевом режиме, навигационная система может найти подходящий путь к укрытию, а ML модель может использоваться где-то внутри анимационного или поведенческого слоя, чтобы выбрать более естественное движение, оценить вероятность какого-либо события или автоматически подобрать параметры, которые дизайнеру сложно посчитать.
Такой гибридный подход выглядит гораздо естественнее, чем идея заменить весь игровой AI одной огромной нейронной сетью, потому что игровой AI вообще редко представляет собой одну задачу, и всегда состоит из большого количества подсистем, для каждой из которых существуют свои компромиссы между качеством, производительностью и стоимостью разработки.
Почему игры не используют ML
Я часто слышу что игры идут впереди технологического прогресса, это и так и не так. В разработке технологии не столько вытесняют друг друга, сколько добавляются в общий набор инструментов, и старая система продолжает существовать, пока она хорошо решает свою конкретную задачу.
Если нам нужно максимально быстро найти путь по navmesh, вам не нужна там нейросеть. Если нам нужно определить, в каком состоянии находится NPC, можно использовать FSM и нейросеть опять не нужна. Если необходимо удобно описать и переставить приоритеты поведения, можно использовать Behavior Tree, и нейросеть опять не нужна. Если требуется выбирать действие на основании большого количества параметров, Utility AI будет более удобным, чем нейросеть с промтами. Если нужно автоматически найти закономерность в огромном массиве данных, а вот здесь уже нужно машинное обучение… или мы можем посадить играть толпу QA и ставить галочки понравилось-непонравилось и тоже получить эти данные.
Странно было бы ожидать, что появление нейронных сетей автоматически отменит все остальные подходы, потому что конечная цель игровой разработки состоит в постройке системы, которую надо заставить делать именно то, что требуется конкретной игре и сделать это достаточно быстро, стабильно и дешево, чтобы команда могла развивать проект, исправлять ошибки и менять первоначальный дизайн.
Если дизайнер точно знает, что солдат после тридцати секунд преследования должен прекратить поиск и вернуться на свою позицию, то нет ничего особенно современного или устаревшего в том, чтобы просто записать это правило в коде.
Если же нам необходимо получить естественное движение персонажа в десятках тысяч различных ситуаций, перебрать которые вручную невозможно, или восстановить закономерность в огромном наборе данных, которую человек сам формализовать не способен, то здесь машинное обучение уже начинает приносить пользу.
И вполне может оказаться, что будущее игрового AI вообще не связано с тем, чтобы заменить все FSM, Behavior Tree и другие классические системы одной универсальной нейронной сетью, а скорее с тем, чтобы научиться правильно соединять разные подходы, оставляя за программистом и дизайнером предсказуемость и контроль.
И в этом заключается парадокс игрового AI, когда мы хотим, чтобы компьютер умел принимать сложные решения, но только до тех пор, пока эти решения остаются частью игрового мира, который мы можем понимать, балансировать и изменять. Задача разработчика состоит не в доказывании, что машина может быть умной, быстрой и меткой, но в построении такого набора правил и исключений, где человек перед экраном останется центром этого игрового мира, а не одной из переменных некоторого уравнения, даже если он этой переменной является.
А как-же LLM-NPC направление?
Ладно, скажет читатель, всё это красиво звучит применительно к FSM и Behavior Tree, но сейчас же 2026 год, и по всем конференциям ходят демки, где NPC разговаривают с игроком голосом, помнят предыдущий диалог и вроде бы что-то там “решают” сами. Это действительно так и я тоже удивлялся Inworld AI от юбиков и их проекту NEO NPC, когда есть база знаний и стиль речи персонажа, а потом это все магией LLM превращается в звуковую дорожку и лицевую анимацию в реальном времени. Выглядит эффектно, и просто ты сидишь и разговариваешь с NPC как с живым человеком, который что-то там помнит из предыдущего разговора, как-то необычно реагирует на интонации и иногда вворачивает нестандартные фразы, в общем маркетинговый эффект получается вау. Хм… но я также помню свое удивление во втором фолауте, и его системе диалогов, когда и на третий и даже на четвертый раз прохождения получал другие фразы и другие реакции.
Так что, весь этот генеративный слой завязан на диалог с человеком, на озвучку и реакцию на человека, скорее даже на текст, то есть на тот же класс задач, который покрывают чат-боты. У вас нет жёстко заданного правильного ответа, зато есть огромное пространство приемлемых вариантов, и модель там прекрасно справляется, потому что цена ошибки невысокая, а разброс допустимого широкий.
Но ядро принятия решений (должен ли NPC сейчас атаковать, искать укрытие, звать подкрепление или прекратить преследование), так и осталось на здоровенных FSM и юбики упоминают об этом очень мелким шрифтом в самом конце презентации, и даже в свежих итерациях прототипа (теперь проект называется Teammates) он так и остается чатом с NPC. Три года разработки и почти две сотни разработчиков привели нас к еще одному чат боту, а не новой боевой системе… Вот вам и ответ на вопрос, насколько это готово заменить старый добрый switch по состояниям.
Автор: dalerank

