


В моей рекомендательной системе LightGBM выбирает до 20 товаров из набора до 300 кандидатов. Разбор промахов показал: товары из последующих зарегистрированных покупок чаще терялись до ранжирования. Я расширила отбор до 370 кандидатов и проверила, даст ли это больше попаданий.
Система построена на Coveo SIGIR eCOM 2021, Public Data Release 1.0.0 — обезличенных данных интернет-магазина о просмотрах, поисковых запросах и покупках. Её устройство разобрано в предыдущей статье, код — в RecSys-Coveo.
Где терялись целевые товары
Цель — товары из зарегистрированных покупок после рекомендации. Если хотя бы один из них оказался в первых 20, засчитываю попадание. Hit@20 — доля попаданий среди сессий с целью. Отсутствие записи о покупке не считаю промахом. Момент рекомендации, окно цели и правила допуска описаны во второй статье; здесь они не менялись.
Система может рекомендовать только товары из исторического каталога: 14 314 SKU, обезличенных идентификаторов товаров. Каталог, граф и статистики построены по 50 000 ранних сессий — периоду  .
Исходную модель я оценила на отложенном периоде  . Из 60 000 сессий зарегистрированная цель была у 748. Получилось 441 попадание, или 58,96% Hit@20. Остальные 307 промахов я разделила по этапам:
|
Причина промаха на |
Сессии |
|---|---|
|
Ни одного целевого товара нет в историческом каталоге |
172 |
|
Цель есть в каталоге, но ни один целевой товар не попал в кандидаты |
106 |
|
Цель есть среди кандидатов, но не вошла в первые 20 рекомендаций |
29 |
|
Всего |
307 |

Это числа сессий, а не товаров. Если в сессии купили несколько товаров, для попадания достаточно найти хотя бы один. Каждая сессия с промахом относится только к одной строке таблицы.
В 278 из 307 промахов ранжировщик не получил целевого товара. Увеличение числа кандидатов могло помочь при потерях отбора, но не при отсутствии товара в каталоге. Причины самого отсутствия эта таблица не устанавливает.
Покрытие кандидатов — доля сессий с целью, в которых хотя бы один целевой товар попал в промежуточный набор. Его наличия достаточно для покрытия, но ещё не для Hit@20. Поэтому при одном знаменателе действует граница из спецификации:
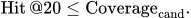
Разница между метриками — максимально возможный прирост Hit@20 без изменения отбора.
Что изменила
Я проверила гипотезу: короткие списки сходства описаний и изображений отсекают полезных кандидатов, а расширение этих списков даст больше попаданий.
Квоту описаний увеличила с 40 до 80, изображений — с 30 до 60. Квота ограничивает число товаров от одного источника до объединения списков. Остальные квоты, каталог, граф и статистики  не меняла. Общий предел вырос с 300 до 370 кандидатов, итоговая выдача осталась прежней — до 20 товаров.
Повторные SKU объединяются, свободные места заполняются популярными товарами. Поэтому дополнительные 70 мест не означают 70 новых товаров из описаний и изображений в каждой сессии. Оба источника расширены одновременно: их отдельный вклад здесь не измерен.
Почему пришлось переобучить модель
Новые квоты меняют признаки не только добавленных, но и прежних кандидатов.
В условном примере товар X уже выбран графом и занимает шестидесятое место в списке сходства описаний:
|
Сведения о товаре X |
Квота описаний 40 |
Квота описаний 80 |
|---|---|---|
|
Есть среди кандидатов благодаря графу |
Да |
Да |
|
Выбран также по сходству описаний |
Нет |
Да |
|
Позиция в списке текстового источника |
Не используется |
60 |
Балл сходства мог быть рассчитан в обеих версиях, но признаки источника и позиции изменились. Старую строку признаков нельзя просто перенести в новый набор.
При обучении целевые товары сравниваются с остальными кандидатами запроса. Расширение набора меняет пары, их нормировку и веса перестановок. Даже прежние кандидаты после переобучения не обязаны сохранить порядок.
Для варианта на 370 кандидатах пересчитала все признаки и переобучила LightGBM на прежних 50 000 сессиях  , с прежними параметрами. Цель есть у 625 сессий; обучающие пары возникают только при наличии целевого кандидата и кандидата вне цели. Пропущенные цели не добавляла задним числом — это была бы утечка будущих покупок в отбор.
Это проверка расширения квот вместе с переобучением, а не добавления товаров к ответам неизменной модели.
Два выигрыша и три потери
Модели сравнила на отдельной выборке  . Это 50 000 целых сессий, отобранных независимо от покупок: 625 с зарегистрированной целью и 49 375 с неизвестным исходом.
Сессии не пересекаются с обучающей выборкой. Модели отвечали на одни и те же запросы с одинаковым доступным контекстом.
Заранее закрепила правило: выбирать 370, только если вариант пройдёт проверки и даст больше попаданий. При равенстве — сохранять исходную модель.
|
Показатель на |
300 кандидатов |
370 кандидатов |
|---|---|---|
|
Цель найдена среди кандидатов |
414 (66,24%) |
431 (68,96%) |
|
Попадание в первые 20, Hit@20 |
389 (62,24%) |
388 (62,08%) |
|
Цель найдена, но не попала в первые 20 |
25 |
43 |

Проценты рассчитаны по всем 625 сессиям с целью, даже если целевого товара нет в каталоге или среди кандидатов. Резервных ответов и отказов доставки не было: потери после отбора относятся к ранжированию.
Покрытие выросло на 2,72 процентного пункта. При этом цель нашлась среди кандидатов, но осталась за первой двадцаткой в 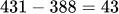 сессиях против
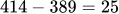 — на 18 сессий больше.
Вариант 370 дал два новых попадания и потерял три прежних. В остальных 620 сессиях оба варианта попали либо оба промахнулись. Изменились пять исходов, итоговая разница — одно попадание. Совпадение исходов не означает совпадения порядка товаров.
Прирост покрытия на 17 сессий не объясняет два новых попадания: сводка не показывает, дали ли их добавленные кандидаты.
Hit@20 и NDCG@20 дали разные результаты
NDCG@20 изменился с 0,48768 до 0,48999. В отличие от Hit@20, он учитывает не только наличие целевого товара, но и его позицию.
Условный пример: единственный целевой товар поднялся с пятнадцатого места на второе. Hit@20 не изменился, NDCG@20 вырос. В другой сессии цель опустилась с двадцатого места на двадцать первое — попадание потеряно. В сумме одна метрика может вырасти, а другая — снизиться.
Функция обучения session_lambdas_v1 использует веса изменения NDCG@20, а не прямую оптимизацию Hit@20. Но это не устанавливает причины наблюдавшихся перестановок: примеры выше условные. Причины изменений конкретных позиций в этом эксперименте пока не разобраны.
Почему я оставила 300 кандидатов
Я оставила 300 кандидатов: вариант 370 не выполнил заранее заданное условие выбора — не дал больше попаданий.
Статус статистического вывода — insufficient: недостаточно обосновано, как учитывать зависимость сессий по времени; требуемая точность заранее не задана. Одно попадание разницы не доказывает ни превосходство 300, ни равенство моделей. Универсального вывода о нужном числе кандидатов здесь нет.
Скорость здесь не сравниваю: таймер включал неодинаковую диагностику, а отдельного замера recommend нет.
Гипотеза появилась после разбора  , поэтому он уже не подходит для независимого подтверждения результата. 58,96% на
 и 62,24% на
 получены на разных сессиях; их разница не показывает улучшение модели. Влияние на продажи и качество на актуальном ассортименте неизвестны: A/B-проверки не было.
Код эксперимента доступен в репозитории проекта, команды — в инструкции воспроизведения.
Автор: YaninaK

