


Как сравнивали модели на RTX 4090
В одном из экспериментов Kwangju Shin запустил Qwen3.8-27B примерно со 100 токенами в секунду. Для ускорения использовалась DFlash2, технология спекулятивного декодирования, которая позволяет небольшой вспомогательной модели предлагать сразу несколько следующих токенов для проверки основной моделью.
После получения рабочего локального API автор решил проверить Qwen3.8-Flash-Next на том же компьютере. Интерес представляла возможность улучшить качество ответов без увеличения ожидания, сохранив при этом достаточно ресурсов для других приложений.
Конфигурация тестового ПК:
|
Компонент |
Характеристика |
|---|---|
|
Видеокарта |
NVIDIA GeForce RTX 4090 |
|
Видеопамять |
24 ГБ |
|
Оперативная память |
64 ГБ |
|
Операционная система |
Windows |
|
Движок для Flash |
Strata |
|
27B |
Q4 + DFlash2 |
|
Контекст 27B |
32K токенов |
|
Квантование Flash |
IQ2_XS, IQ3_XXS, IQ3_S |
|
Основная конфигурация Flash |
IQ3_XXS |
Для нового сравнения производительность 27B измерялась заново. Это важно, поскольку предыдущий результат около 100 токенов в секунду был получен с Q3-квантованием на коротких запросах с кешированным вводом. В новом тесте использовались Q4-веса, DFlash2 и другое ограничение контекста. Поэтому сравнивать старые 100 токенов в секунду с новыми результатами Flash как показатели одинаковых условий было бы некорректно.
Для запуска Flash использовалась Strata, открытый движок инференса с локальным API, совместимым с OpenAI.
В тестировании одновременно работал только один локальный сервер. Дополнительно те же задания отправлялись в удаленный API, но эти результаты использовались как ориентир: облачная инфраструктура и сетевые задержки не сопоставимы напрямую с локальным запуском.
Как большая MoE-модель работает на одной RTX 4090 и 64ГБ ОЗУ
Согласно официальной карточке Qwen, архитектура Flash-Next включает 125 млрд параметров в основной модели, из которых на токен активируются около 6 млрд. Дополнительно используются 51 млрд параметров n-gram embedding и около 4 млрд параметров MTP. Общий масштаб модели достигает примерно 180 млрд параметров. Основная часть Flash построена по принципу Mixture-of-Experts (MoE). Вместо выполнения всех экспертных блоков для каждого токена система выбирает только необходимые.
В Flash-Next предусмотрены 512 экспертов, из которых при обработке токена задействуются десять маршрутизируемых и один общий. Декодер содержит 48 слоев, где сочетаются Gated DeltaNet, Qwen Sparse Attention и MoE.
Qwen3.8-27B устроена иначе. Это плотная модель с 27 млрд параметров и 64 слоями, поэтому при генерации используется значительно большая доля ее весов. Разница в архитектуре помогает объяснить, почему более крупная Flash потенциально способна генерировать текст быстрее. При этом все ее экспертные веса по-прежнему необходимо где-то хранить.
На каком языке 3.8-27B отвечает быстрее?
Первый этап тестирования проводился с отключенным режимом рассуждений. Измерялась скорость декодирования, то есть выдача токенов после обработки входного запроса.
Основное сравнение выглядело следующим образом:
|
Язык |
Qwen3.8-27B Q4 |
Flash IQ3_XXS |
Преимущество Flash |
|---|---|---|---|
|
Английский |
~80 ток/с |
~126 ток/с |
~1,58 раза |
|
Корейский |
~50 ток/с |
~118 ток/с |
~2,36 раза |
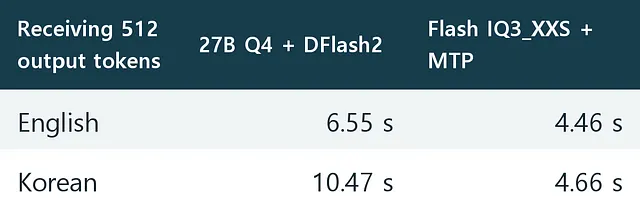
На английском Flash обеспечила примерно 58-процентное увеличение скорости генерации. На корейском ее преимущество оказалось более чем двукратным.
Последний результат особенно интересен, но не доказывает аналогичного превосходства Flash на русском языке: отдельного русскоязычного измерения в эксперименте нет. Для дополнительной проверки использовались запросы с ограничением генерации в 512 токенов. В каждом случае проводилось три измерения, а для сравнения использовалась медиана.
Все проверяемые запросы достигли установленного ограничения. Поэтому измерения показывают время получения заданного объема текста, но не время выполнения задачи до окончательного ответа.
В таких условиях Flash выглядит привлекательно для короткого ввода и большого количества генерируемого текста. Например, это может быть подготовка черновиков, объяснений или программного кода, когда задержка перед началом генерации невелика. Но у AI-агентов входные запросы часто устроены сложнее. Они могут содержать документы, историю переписки, результаты работы инструментов и большие фрагменты кода. Именно такой сценарий изменил результаты сравнения.
Как показала себя 27В на новом документе
Следующий эксперимент проверял обработку ранее не встречавшегося документа.
Автор передал моделям текст объемом 10 934 токена и попросил извлечь из него информацию. При отправке того же текста через удаленный API его токенизатор насчитал 11 643 токена.
Кеширование входного запроса в этом тесте не использовалось. Все пять проверенных конфигураций ответили правильно, но время выполнения заметно различалось.
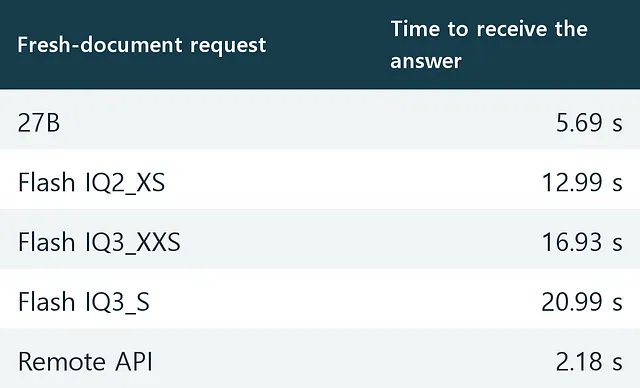
Несмотря на преимущество в скорости генерации, Flash выполняла запрос примерно в 2,98 раза дольше.
Для ясности разделим обработку запроса на две стадии:
-
Prefill представляет собой обработку входных токенов. Модель должна прочитать предоставленный текст и подготовить внутреннее состояние для дальнейшей генерации.
-
Decode начинается после обработки входа. На этом этапе модель последовательно генерирует новые токены.
Скорость, которую обычно показывают в бенчмарках как tokens per second, часто относится именно ко второй стадии. Но пользователь ожидает завершенный ответ, и его время ожидания зависит от обеих. У Flash с ее большим набором экспертов, распределенных между несколькими уровнями памяти, обработка свежего документа может потребовать значительных дополнительных затрат. Поэтому высокая скорость decode не гарантирует низкую общую задержку.
Здесь есть важное методологическое ограничение. Проверка нового документа проводилась только один раз для каждой конфигурации, поэтому ее нельзя использовать для утверждения, что 27B всегда почти втрое быстрее на длинных входных данных. Тем не менее эксперимент показал конкретную ситуацию, в которой преимущество Flash по генерации не привело к более быстрому выполнению задания.
Для локального агента это особенно существенно. После вызова инструмента агент часто получает новый объемный результат, который необходимо обработать перед следующим действием. Подобные задержки способны накапливаться на протяжении всей задачи.
Качество ответов победителя
Следующим критерием стало качество выполнения заданий.
Составлен небольшой набор проверок, включающий вычисления, извлечение информации из документов, планирование и оптимизационные задачи. Всего было получено 45 ответов на 28 различных вопросов с учетом повторных запусков.
Задачи не были представлены как стандартизированный бенчмарк, а выборка слишком мала для надежного ранжирования моделей. Зато она позволила обнаружить конкретные различия в поведении квантованных версий.
Как скорость ответа повлияла на корректность ответов
Конфигурация IQ2_XS, использующая более сильное сжатие весов, неоднократно ошибалась при расчете распределения ресурсов. Это снижало практическую пользу ускорения. Полученный за меньшее время ответ приходилось дополнительно проверять, а иногда и исправлять.
IQ3_XXS показала более стабильное поведение. После исключения одного некорректно сформулированного вопроса все завершенные ответы этой конфигурации были правильными. Однако пять раз модель исчерпывала доступный бюджет выходных токенов, так и не сформировав окончательное решение.
Qwen3.8-27B также правильно выполнила все задания, которые успела завершить, но оставила четыре незаконченных ответа. По результатам этой небольшой проверки качество 27B и Flash IQ3_XXS оказалось близким. Здесь важно разделять ошибку и незавершенный ответ. Если модель исчерпала ограничение в 8192 токена, это еще не доказывает, что она не смогла бы решить задачу при большем бюджете генерации.
Что изменилось после увеличения лимитов
Доступный бюджет генерации увечили с 8K до 16K токенов.
При таком ограничении Flash IQ3_S завершила одну задачу, которую остальные локальные конфигурации не смогли довести до ответа. Удаленный API успешно решил обе. Однако на каждую задачу приходилось только по одному дополнительному запуску. Поэтому результат можно рассматривать как направление для дальнейшей проверки, но не как доказательство превосходства IQ3_S.
В эксперименте обнаружилась и ошибка в самих тестовых вопросах. Один запрос касался количества товара, но не было уточнения, нужны нам упаковки или отдельные единицы. Несколько моделей ответили «семь упаковок», тогда как ожидаемым значением были 168 отдельных предметов.
После исправления формулировки все пять конфигураций дали правильный ответ. Этот случай показывает еще одну особенность оценки локальных LLM. Низкий результат иногда связан с неоднозначностью задания, а увеличение бюджета генерации может изменить исход проверки. Поэтому корректность тестовых вопросов важна не меньше выбора модели.
По имеющимся измерениям нельзя уверенно заключить, что Flash IQ3_XXS качественно превосходит 27B. Для такого вывода понадобились бы более крупная выборка, повторные запуски и единые критерии оценки завершенности ответов.
Почему размер квантованной модели имеет значение
Дополнительный контекст дает репозиторий ISTA-DASLab, содержащий квантованные сборки Flash-Next.
|
Вариант |
Размер основных весов |
Размер n-gram таблицы |
Общий объем |
|---|---|---|---|
|
IQ2_XS |
39,2 ГБ |
28,8 ГБ |
68,0 ГБ |
|
IQ3_XXS |
47,0 ГБ |
28,8 ГБ |
75,8 ГБ |
|
IQ3_S |
54,8 ГБ |
28,8 ГБ |
83,6 ГБ |
Это размеры файлов соответствующих сборок, а не результаты измерения оперативной памяти в эксперименте Towards AI. N-gram таблица может оставаться на SSD и загружаться по мере необходимости. Но основные веса, KV-кеш и служебные структуры по-прежнему требуют значительных ресурсов. Дополнительные гигабайты RAM позволяют использовать менее агрессивное квантование, поддерживать большие контексты или оставлять больше данных в оперативной памяти. Однако производительность при этом зависит от движка, скорости памяти и процессора.
Разница особенно заметна при сравнении с альтернативными конфигурациями. Например, тестирование Flash-Next на RTX 4090 с 192 ГБ RAM, где основная часть модели находилась в оперативной памяти. В отдельных измерениях удалось получить более 110 токенов в секунду даже при большом контексте. Этот результат согласуется с возможностью быстрого локального инференса Flash, но получен с другим объемом памяти, настройками и программным окружением. Он не отменяет ограничений системы Kwangju Shin.
Стоит ли переходить с Qwen3.8-27B на Flash-Next
По результатам эксперимента Qwen3.8-27B оказалась более удобной для постоянной работы на компьютере с RTX 4090 и 64 ГБ RAM.
Она обеспечивала достаточно высокую скорость генерации, быстрее справилась с проверенным документом и оставляла значительно больше свободной оперативной памяти. При этом небольшая выборка заданий не выявила убедительного преимущества Flash IQ3_XXS по качеству ответов.
Но выбор может измениться в зависимости от характера нагрузки.
Когда предпочтительнее Qwen3.8-27B:
-
Локальный AI-агент должен работать постоянно.
-
Компьютер одновременно используется для других задач.
-
Агент часто получает новые документы и большие результаты инструментов.
-
Важны стабильное время ответа и запас оперативной памяти.
Когда стоит рассмотреть Flash-Next:
-
Основная нагрузка связана с генерацией больших объемов текста.
-
Есть возможность выделить модели почти все ресурсы компьютера.
-
Доступно больше 64 ГБ RAM.
-
Требуется проверить преимущества MoE-архитектуры на собственных задачах.
-
Допустимо запускать модель по необходимости, освобождая память после завершения работы.
Если агент выполняет ограниченное количество сложных операций и не обязан постоянно находиться в памяти, Flash можно использовать как отдельный инструмент для определенных заданий. Однако по имеющимся данным нельзя гарантировать, что она будет выполнять такие задачи качественнее 27B. Эксперимент показал преимущество в скорости генерации, но не подтвердил аналогичное преимущество в качестве.
Чтобы не тратить время на ежедневный мониторинг десятков AI-релизов, я делаю это за вас: тестирую новые модели и обновления и публикую в ДругОпенсурса только то, что действительно стоит внимания. Там же короткие выводы из тестов и мои наблюдения о том, что реально полезно в работе.
Автор: Nikita_Pro_IT

