


TL;DR: Хотел полную автоматизацию “встреча → протокол в канале Teams”. Получил полуавтоматику с ручным шагом в 30 секунд. Сэкономил 20-30 минут на каждую встречу за $0.33 в месяц. Разбираю что сработало, где упёрся в ограничения Microsoft, и стоила ли игра свеч. Весь проект — от идеи до работающего flow — собран в диалоге с Claude.
Проблема
Я delivery-менеджер, веду несколько команд. После каждой встречи нужен протокол: кто был, что обсудили, кто что делает.
Раньше это выглядело так:
Делаю заметки во время встречи — постоянно останавливаю участников, прошу повторить или уточнить формулировку, чтобы записать осмысленный вывод. Пока записываю — беседа уходит вперёд, теряю контекст. Фокус на записи вместо управления групповой динамикой. Если встреча короткая и плотная — заметки не успеваю, приходится потом переслушивать запись и восстанавливать по памяти. 15-20 минут (или больше, если переслушиваю).
Пишу протокол из заметок — структурирую, формулирую action items, проверяю что никого не забыл. 10 минут.
Форматирую и отправляю в канал — привожу в читаемый вид, копирую в Teams. 10 минут.
30-40 минут на встречу. При 3-5 встречах в день — это полтора-два часа чистого времени на документирование. И это не считая когнитивной нагрузки от постоянного переключения между “слушать” и “записывать”.
В Teams есть транскрипция. В 2026 году есть LLM, которые умеют структурировать текст. Почему бы не соединить?
Целевая архитектура (мечта)
Teams Meeting (с включённой записью)
        ↓ автоматически
OneDrive /Recordings
        ↓ триггер Power Automate
Получить транскрипт через Graph API
        ↓
Отправить в LLM
        ↓
Опубликовать в канал Teams
Ожидание: Полная автоматизация, я только провожу встречу.
Что получилось (реальность)
Teams Meeting (с включённой записью)
        ↓ автоматически
OneDrive /Recordings (.mp4)
        ↓ вручную (30 сек)
Кликнуть по ссылке на запись → Скачать транскрипт .vtt
        ↓ триггер Power Automate
Отправить в LLM
        ↓
Опубликовать в канал Teams
Что происходит: Видео сохраняется в OneDrive автоматически при нажатии “Записать встречу” в Teams. А вот транскрипт — нет. После завершения встречи нужно кликнуть по ссылке на запись и в открывшемся окне нажать “Скачать” → выбрать формат .vtt. Сохраняю в ту же папку /Recordings — и дальше flow подхватывает.
Один ручной шаг остался. Но вместо 30-40 минут — 30 секунд + ожидание генерации.
Почему не получилось полностью автоматизировать
Ограничение 1: Teams не автосохраняет транскрипты
Teams автоматически сохраняет .mp4 записи в OneDrive. Но .vtt файл с транскриптом — нет. Его нужно скачать вручную из интерфейса Teams после встречи.
Я проверил Teams Admin Center, политики PowerShell — настройки для автосохранения транскриптов не существует (на момент написания статьи).
Ограничение 2: Graph API для транскриптов — это боль
Попытался обойти через Microsoft Graph API:
-
Ловим триггер на
.mp4файл -
Получаем Meeting ID через API
-
Скачиваем транскрипт
-
Отправляем в LLM
Что пошло не так:
Проблема 1: Endpoint /me/calendarView не работает с Application permissions — только с Delegated. Пришлось использовать /users/{email}/calendarView.
Проблема 2: Фильтр isOnlineMeeting eq true не поддерживается для calendarView. Пришлось получать все события и фильтровать в flow.
Проблема 3: Главное разочарование — endpoint /users/{userId}/onlineMeetings возвращает только встречи, созданные через API. Встречи из Outlook/Teams календаря там не появляются.
Это означает, что получить Meeting ID для обычной календарной встречи через Graph API с Application permissions — невозможно (или я не нашёл способа).
Рабочее решение: пошаговая инструкция
После всех экспериментов остановился на простом варианте с ручной загрузкой .vtt.
Архитектура flow
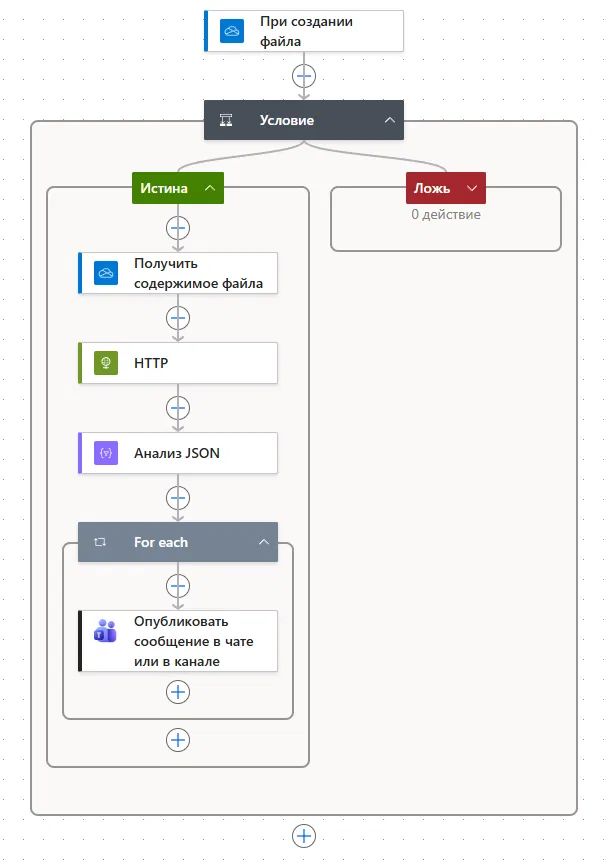
📁 При создании файла в /Recordings
         ↓
❓ Условие: имя файла заканчивается на .vtt?
    ├── ✅ Да → Получить содержимое файла
    │            ↓
    │         HTTP POST в LLM API
    │            ↓
    │         Анализ JSON (ответ)
    │            ↓
    │         For each → Опубликовать в канал Teams
    │
    └── ❌ Нет → (ничего не делаем)
Шаг 1: Триггер и условие
Триггер: OneDrive for Business → “При создании файла”
-
Папка:
/Recordings
Условие: Фильтруем только .vtt файлы
-
Левое поле (через fx):
triggerOutputs()?['headers']?['x-ms-file-name'] -
Оператор:
заканчивается на -
Правое поле:
.vtt
Почему не
.docx? Изначально пробовал экспортировать транскрипт в Word. Но.docx— это ZIP-архив с XML внутри. При отправке в LLM через Power Automate передаются бинарные данные, и модель получает мусор..vtt— plain text, передаётся как есть.
Шаг 2: Получить содержимое файла
Действие: OneDrive for Business → “Получить содержимое файла”
-
Файл: динамический контент → “Идентификатор файла” из триггера
Шаг 3: HTTP запрос к LLM
Действие: HTTP
|
Поле |
Значение |
|---|---|
|
Method |
|
|
URI |
Headers:
|
Ключ |
Значение |
|---|---|
|
Authorization |
|
|
Content-Type |
|
Body:
json
{
  "model": "gpt-5.6-luna",
  "messages": [
    {
      "role": "system",
      "content": "You are a meeting notes assistant. Generate structured meeting minutes in the same language as the transcript. Use format: # Meeting Minutes, **Date:**, **Attendees:**, ## Discussion Summary, ## Action Items (table with columns: Action, Responsible, Deadline), ## Notes. IMPORTANT: Output ONLY the meeting minutes, do NOT include any thinking, reasoning, or <think> tags."
    },
    {
      "role": "user",
      "content": "Generate meeting minutes from this transcript:nn[ДИНАМИЧЕСКИЙ КОНТЕНТ: Содержимое файла]"
    }
  ],
  "max_tokens": 4000
}
Важно про промпт:
“in the same language as the transcript” — протокол будет на языке встречи (у меня русский)
Явно указываю формат с таблицей Action Items — так удобнее отслеживать задачи
“do NOT include any thinking” — некоторые модели (типа DeepSeek, MiniMax) добавляют
<think>блоки с рассуждениями, это засоряет вывод
Шаг 4: Парсинг ответа
Действие: “Анализ JSON” (Parse JSON)
Content: Body из HTTP-шага
Schema:
json
{
  "type": "object",
  "properties": {
    "choices": {
      "type": "array",
      "items": {
        "type": "object",
        "properties": {
          "message": {
            "type": "object",
            "properties": {
              "content": {
                "type": "string"
              }
            }
          }
        }
      }
    }
  }
}
Шаг 5: Публикация в Teams
Действие: Microsoft Teams → “Опубликовать сообщение в чате или канале”
|
Поле |
Значение |
|---|---|
|
Опубликовать от имени |
Бот Flow |
|
Опубликовать в |
Канал |
|
Команда |
Ваша команда |
|
Канал |
Meeting minutes (или любой другой) |
|
Сообщение |
(через fx) |
Результат
После загрузки .vtt файла в папку, через 30-60 секунд в канале появляется готовый протокол:
markdown
# Meeting Minutes

**Date:** 2026-09-15
**Attendees:** Алексей, Мария, Дмитрий, Елена

## Discussion Summary

Обсудили статус текущего спринта. Задача по интеграции с внешним
сервисом отстаёт на 2 дня из-за изменений в спецификации со стороны
партнёра. Договорились о переносе релиза на следующую неделю.

Рассмотрели результаты A/B теста новой формы регистрации.
Конверсия выросла на 12%. Решили раскатывать на всех пользователей.

## Action Items

| Задача | Ответственный | Срок |
|--------|---------------|------|
| Обновить спецификацию API | Дмитрий | 17.09 |
| Уведомить стейкхолдеров о переносе | Алексей | 16.09 |
| Подготовить тест-кейсы для интеграции | Елена | 18.09 |
| Раскатить новую форму регистрации | Мария | 16.09 |

## Notes

- Следующий статус-митинг — пятница 10:00
- Ретро по спринту запланировано на понедельник
Грабли, на которые наступил
1. Выбор модели
Не все модели одинаково полезны:
|
Модель |
Проблема |
|---|---|
|
MiniMax-M2 |
Добавляет |
|
Некоторые модели |
Не поддерживают |
|
Дешёвые модели |
Таймауты на длинных транскриптах |
Решение: Тестируйте на реальных транскриптах перед продом. Я остановился на GPT-5.6 Luna (через корпоративный API).
2. Таймауты
Длинные встречи (1+ час) генерируют большие транскрипты. LLM может не успеть ответить за стандартный таймаут Power Automate.
Решение:
-
Уменьшить
max_tokensесли не нужны детальные протоколы -
Или настроить retry policy в HTTP-действии
3. Формат .vtt vs .docx
.docx — бинарный формат (ZIP с XML). При передаче через Power Automate в LLM улетает мусор.
.vtt — plain text с таймкодами. Выглядит так:
WEBVTT

00:00:05.000 --> 00:00:08.000
<v Алексей>Всем привет, начинаем встречу.</v>

00:00:08.500 --> 00:00:12.000
<v Мария>Привет! У меня апдейт по задаче.</v>
LLM отлично понимает этот формат и игнорирует таймкоды при генерации протокола.
Что не получилось и почему
Graph API: почему полная автоматизация невозможна
Я потратил ~6 часов на попытку автоматизировать получение транскриптов через Microsoft Graph API. Вот что узнал:
Шаг 1: Регистрация приложения в Azure AD — ок, 15 минут.
Шаг 2: Получение разрешений — нужен IT-администратор для admin consent. Ок, согласовал.
Шаг 3: Получение списка встреч
GET /users/{email}/calendarView?startDateTime=...&endDateTime=...Работает. Но фильтр $filter=isOnlineMeeting eq true не поддерживается. Приходится получать все события и фильтровать в flow.
Шаг 4: Получение Meeting ID
GET /users/{email}/onlineMeetings?$filter=JoinWebUrl eq '{url}'Не работает. Возвращает 404.
После долгих экспериментов нашёл причину в документации Microsoft:
“The onlineMeetings resource represents meetings that were created programmatically using the Create onlineMeeting API.”
Встречи, созданные через Outlook или Teams календарь, не доступны через этот endpoint.
Это означает, что для 99% корпоративных встреч Graph API бесполезен для получения транскриптов с Application permissions.
Выводы
Стоимость
GPT-5.6 Luna: $0.20/1M input tokens, $1.20/1M output tokens
Расчёт на одну встречу (30 минут):
-
Транскрипт: ~10,000 токенов → $0.002
-
Протокол: ~1,000 токенов → $0.0012
-
Итого: ~$0.003 (менее 1 цента)
При 5 встречах в день:
-
$0.015/день × 22 рабочих дня = ~$0.33/месяц
-
Это примерно 25 рублей в месяц
ROI
|
Метрика |
До |
После |
|---|---|---|
|
Время на протокол |
30-40 мин |
30 сек + ожидание |
|
Когнитивная нагрузка на встрече |
Высокая (записываю) |
Низкая (слушаю) |
|
Стоимость |
$0 |
~$0.33/месяц |
|
Время на настройку |
— |
~4 часа (с граблями) |
При 3-5 встречах в день экономия — 1.5-2 часа ежедневно.
Окупаемость настройки — 2-3 дня.
Где ИИ реально помог
-
Структурирование — LLM отлично превращает поток речи в структурированный документ
-
Выделение action items — модель хорошо понимает “кто что должен сделать”
-
Мультиязычность — работает на любом языке транскрипта
Где ИИ создал иллюзию продуктивности
-
“Сейчас быстро автоматизирую через API” — потратил 6 часов на борьбу с ограничениями Microsoft
-
“Любая модель подойдёт” — нет, нужно тестировать на реальных данных
Что бы сделал иначе
-
Сразу начал бы с .vtt — не тратил время на эксперименты с .docx
-
Не лез бы в Graph API — ручной шаг в 30 секунд не стоит 6 часов разработки
-
Раньше протестировал бы модели — выбор модели критичен
Итого
Полная автоматизация “встреча → протокол” в Microsoft Teams пока невозможна из-за ограничений платформы. Но даже частичная автоматизация с одним ручным шагом даёт:
-
Экономию 1.5-2 часа в день
-
Возможность полностью сфокусироваться на встрече
-
Консистентный формат протоколов
-
Стоимость — копейки (~$0.33/месяц)
Если у вас есть доступ к LLM API и Power Automate — попробуйте. Настройка займёт пару часов, а профит будет каждый день.
Этот проект был реализован в диалоге с Claude (Anthropic). Поиск решений, отладка ошибок Graph API, написание промптов и даже эта статья — всё делалось в переписке с ИИ-ассистентом. Такой формат “парного программирования с LLM” сэкономил несколько часов на изучение документации и дебаг.
Автор: Tezarium
Автор: Tezarium

