


В моём тренажёре Prod is Down каждый игрок получает свой сломанный «сервер». На самом деле это контейнер, но игрок об этом думать не должен: он набирает те же команды, что и на настоящем дежурстве. systemctl restart nginx, journalctl -u api, free -m, top.
Из коробки половина этих команд в Docker либо не работает, либо врёт. Ниже четыре места, где контейнер выдаёт себя.
1. systemctl: PID 1 — не systemd
В обычном контейнере первым процессом запускается ваш entrypoint, а не systemd. Даже если пакет systemd стоит в образе, systemctl не с кем разговаривать:
$ systemctl restart nginx
System has not been booted with systemd as init system (PID 1). Can't operate.
Failed to connect to bus: Host is down
Вариантов три, и у каждого своя цена:
|
Вариант |
Что даёт |
Чем платите |
|---|---|---|
|
Настоящий systemd как PID 1 |
Всё работает как на сервере: юниты, |
Нужны доступ к cgroup, tmpfs на |
|
Замена systemctl |
Скрипт читает юнит-файлы и сам запускает |
Подмножество systemd: что-то из юнитов будет проигнорировано |
|
Свой скрипт запуска |
Ровно то, что нужно вашим сервисам |
Всё, чего в нём нет, придётся дописывать самому |
В Prod is Down сервисы кейса поднимает отдельный шаг entrypoint — pd-systemd-boot, а терминал запускается последним. Первый вариант для меня отпадал сразу: в контейнере сидит незнакомый человек с sudo, и давать ему привилегированный контейнер ради настоящего systemd нельзя.
2. Сигналы и зомби: чем особенен PID 1
У первого процесса две обязанности, о которых на сервере заботится systemd, а в контейнере – никто.
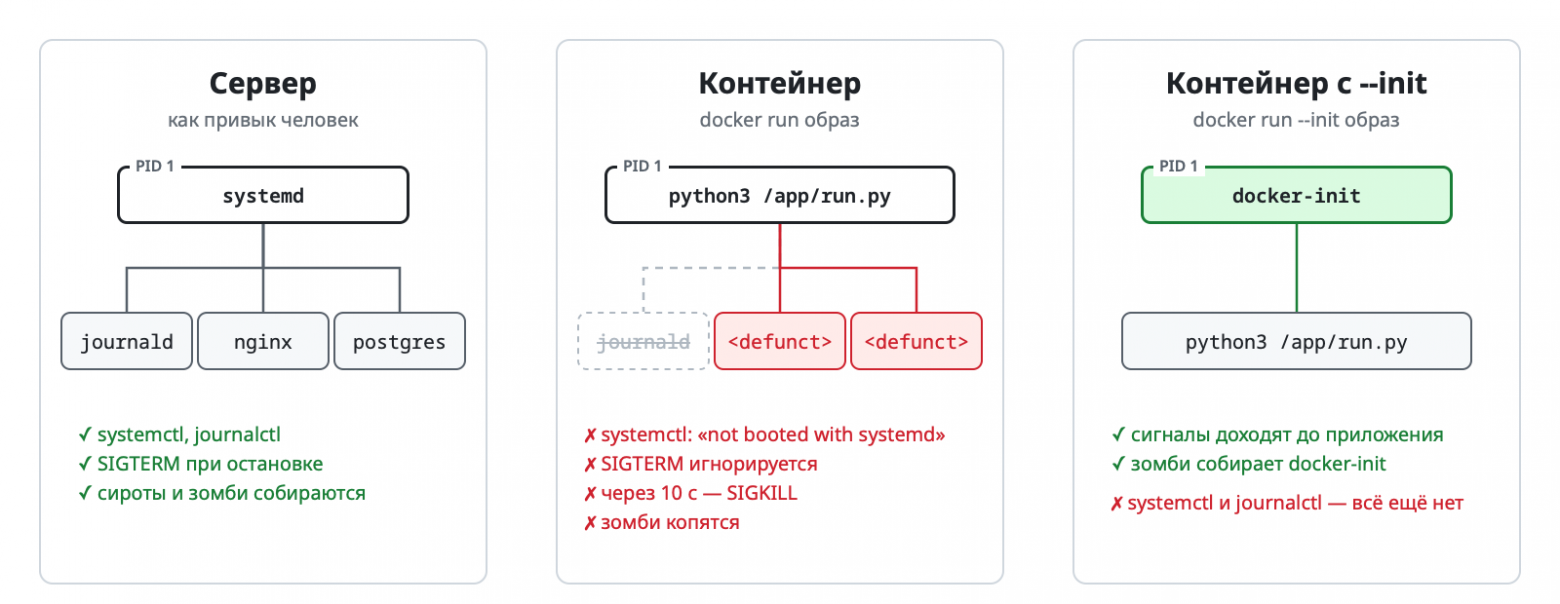
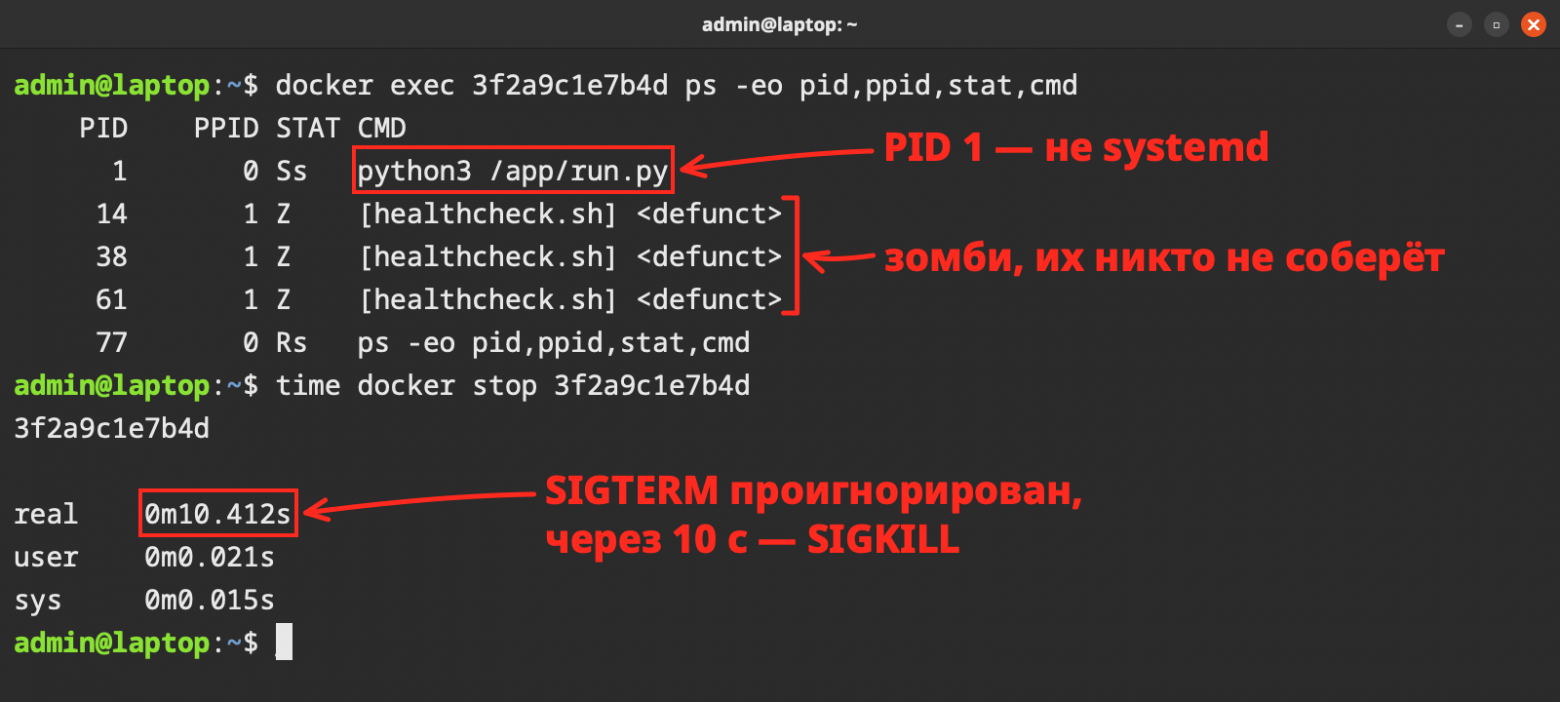
сСигналы. Ядро не применяет к PID 1 действие по умолчанию. Если скрипт не установил обработчик SIGTERM, сигнал просто игнорируется. docker stop ждёт 10 секунд и добивает контейнер SIGKILL, а сервисы внутри не успевают завершиться чисто.
Зомби. Когда родитель умирает, его дети переходят к PID 1, и он должен забирать их статус выхода. Обычное приложение этого не делает, и в ps копятся процессы <defunct>. В тренажёре это вдвойне неприятно: игрок ищет в ps причину инцидента и находит мусор, который к кейсу отношения не имеет.
Лечится одним флагом: docker run -init (в compose – init: true). Первым процессом станет маленький init из комплекта Docker. Он передаст сигналы вашему entrypoint и будет собирать зомби. А в самом entrypoint последний процесс стоит запускать через exec, чтобы не оставлять лишний слой bash.
3. journalctl и логи
Нет systemd – нет и journald. Игрок набирает первую команду любого разбора и получает:
$ journalctl -u nginx
No journal files were found.
При этом у Docker свои логи, и они тоже не помогают: docker logs собирает только stdout и stderr первого процесса. Всё, что nginx или PostgreSQL пишут в свои файлы, туда не попадает. Да и игроку изнутри контейнера docker logs недоступен.
Потому решите заранее, где человек будет искать причину:
-
либо сервисы пишут в привычные файлы в
/var/log, и вы проверяете, что они там правда появляются: многие образы направляют логи в stdout симлинком; -
либо
journalctlдолжен работать, и тогда нужен journald или замена systemctl, которая умеет отдавать логи сервиса.
Худший вариант – когда логи не пишутся никуда. На настоящем сервере такого не бывает, и человек долго ищет ошибку там, где её нет.
4. free и top показывают хост, а не лимиты
Контейнеру выдали 512 МБ и четверть ядра. Игрок набирает free -m и видит всю память сервера, а top и nprocпоказывают все его ядра. Эти утилиты читают /proc/meminfo и /proc/stat, а в обычном Docker это файлы хоста. nproc учитывает --cpuset-cpus, но не квоту.
Для тренажёра это ловушка. В кейсе про утечку памяти free покажет гигабайты свободного места, а OOM killer всё равно придёт. У контейнера свой потолок, и виден он только в cgroup:
cat /sys/fs/cgroup/memory.max       # 536870912 — настоящий лимит
cat /sys/fs/cgroup/memory.current   # сколько занято сейчас
cat /sys/fs/cgroup/cpu.max          # 25000 100000 — четверть ядра
Решений два. LXCFS (ссылка на GitHub) подменяет /proc/meminfo и компанию так, чтобы они показывали лимиты контейнера, и привычные утилиты начинают говорить правду. Или можно показывать цифры самому. Дашборд Prod is Down, например, считает CPU от лимита контейнера: процесс, съевший свою четверть ядра, выглядит как привычные 100%.
И одно предупреждение. В песочницах вроде gVisor /proc эмулируется, и часть цифр ведёт себя по-своему. Всё, что увидит человек, проверяйте в том рантайме, в котором он будет работать.
Итог
Если контейнер должен выглядеть для человека как сервер, проверьте четыре вещи:
-
Кто у вас PID 1 и что отвечает на
systemctl. -
Кто передаёт сигналы и собирает зомби (
--init). -
Где человек найдёт логи сервиса и работает ли
journalctl. -
Что показывают
free,topиnproc: лимиты контейнера или хост.
Автор: verin_is

