


Stratum — внутренняя бессерверная платформа Netflix для обработки медиаконтента, созданная на основе более чем десятилетнего опыта разработки крупномасштабных распределённых систем. Она выполняет самые разные задачи: кодирование, упаковку, проверку и оценку качества медиаданных. Эта обработка обеспечивает воспроизведение контента, показ рекламы, работу студий, создание эмбеддингов для ИИ и многое другое.
Разработчики создают функции Stratum, упаковывая код приложения и зависимости операционной системы в OCI-образы. Затем Stratum запускает эти контейнеры как пакетные задания на вычислительной платформе Netflix Titus. Выполнение функций инициируют вышестоящие сервисы.
Каждый день Stratum управляет сотнями тысяч контейнеров, обслуживая нагрузки с резкими всплесками активности, высокими требованиями к пропускной способности и чувствительностью к задержкам. Stratum — основная платформа Netflix для обработки медиаконтента, поэтому она должна масштабироваться по мере появления в каталоге новых форматов: подкастов, прямых трансляций, спортивных событий, рекламы, а также контента региональных вещателей, таких как TF1 во Франции.
Чтобы запросить ресурсы для функции, её владельцы задают ограничения на процессор, память, диск и сеть в YAML-конфигурации:
functionName: VideoEncoder.encodeV1
resources:
  numCpus: 8
  memoryInMB: 18000
  diskSizeInMB: 50000
  networkInMbps: 1000
Вручную поддерживать оптимальные значения сложно: инфраструктура Netflix развивается, типы инстансов EC2 обновляются, приложения меняются. Поэтому ресурсы часто выделяют с избытком с самого начала либо конфигурация со временем постепенно перестаёт соответствовать реальным потребностям. Неоптимальное выделение ресурсов — общая проблема крупных бессерверных платформ. Оно увеличивает когнитивную нагрузку на разработчиков функций и эксплуатационные расходы владельцев платформы.
В этой статье мы расскажем, как создали Stratum Resource Tuner (SRT) — систему, которая автоматически и безопасно подбирает ресурсы контейнеров, работающих в промышленной среде, без участия человека. Мы разберём реальные примеры, механизмы обеспечения безопасности и уроки, которые извлекли, когда одно из автоматических изменений привело к проблемам.
Проблема: избыточное выделение ресурсов
Когда разработчики создают новую функцию Stratum, они обычно копируют YAML-конфигурацию ресурсов у существующей функции или рассчитывают ресурсы на самый неблагоприятный сценарий. После запуска в промышленной среде к этим настройкам редко возвращаются — до первого сбоя. А после сбоя ресурсы зачастую увеличивают с ещё большим запасом.
Ручная настройка ресурсов не масштабируется по нескольким причинам:
-
Высокие трудозатраты и риски. Чтобы уменьшить выделенные ресурсы, приходится днями наблюдать за метриками и подбирать настройки методом проб и ошибок. Это отвлекает инженеров от других важных задач. Если сократить ресурсы слишком сильно, можно получить инцидент в промышленной среде. Поэтому ручная настройка оказывается занятием с высоким риском и небольшой отдачей.
-
Непрерывное развитие инфраструктуры и кодеков. Облачные провайдеры регулярно обновляют оборудование. Объём ресурсов, оптимальный для предыдущего поколения оборудования, на новом незаметно становится избыточным. Параллельно Netflix развивает стандарты обработки медиаконтента и совершенствует алгоритмы кодирования, включая AV1, AV2 и пространственное аудио. Настройки, подобранные для одного кодека, могут оказаться неоптимальными после выхода улучшенного алгоритма.
-
Изменение характера нагрузки. Netflix осваивает новые типы медиаконтента: видеоподкасты, спортивные трансляции, интерактивные рекламные форматы, адаптируемые с помощью ИИ, и интеграции с крупными вещателями, такими как TF1 во Франции. Из-за этого потребности в ресурсах могут меняться непредсказуемо, а фиксированные ограничения контейнеров перестают соответствовать нагрузке.
-
Рост стоимости оборудования. Огромный мировой спрос на инфраструктуру для ИИ подталкивает вверх цены на серверное оборудование и DRAM. Поэтому неиспользуемая память контейнеров обходится всё дороже.
-
Масштаб платформы усиливает потери. При масштабах Netflix даже небольшой избыток ресурсов, умноженный на сотни тысяч запусков контейнеров в день, приводит к значительным потерям вычислительных мощностей во всей платформе Stratum.
Чтобы оценить масштаб проблемы, мы проанализировали исторические данные об использовании ресурсов в задачах Stratum. Телеметрия подтвердила нашу гипотезу: избыточное выделение ресурсов встречалось часто, потери вычислительных мощностей накапливались, а для устойчивого решения требовалось принципиально пересмотреть управление конфигурациями ресурсов.
Знакомьтесь: Stratum Resource Tuner
Для решения этих проблем мы создали Stratum Resource Tuner (SRT), который автоматически подбирает ресурсы контейнеров Stratum. Наша конечная цель — полностью избавить пользователей от необходимости задавать конфигурацию ресурсов вручную. Мы начали с нескольких высокопроизводительных рабочих нагрузок с невысокими требованиями к задержкам. На них приходится основная часть потребления ресурсов — 70–80%.
Небольшое уточнение терминологии: в этой статье мы используем «подбор ресурсов» (right-sizing) и «настройку» (tuning) как синонимы. Под уменьшением ресурсов (downsizing) понимается снижение лимитов, а под увеличением (upsizing) — их повышение. Поскольку наша цель — оптимизация затрат, в статье мы сосредоточимся на уменьшении выделенных ресурсов.
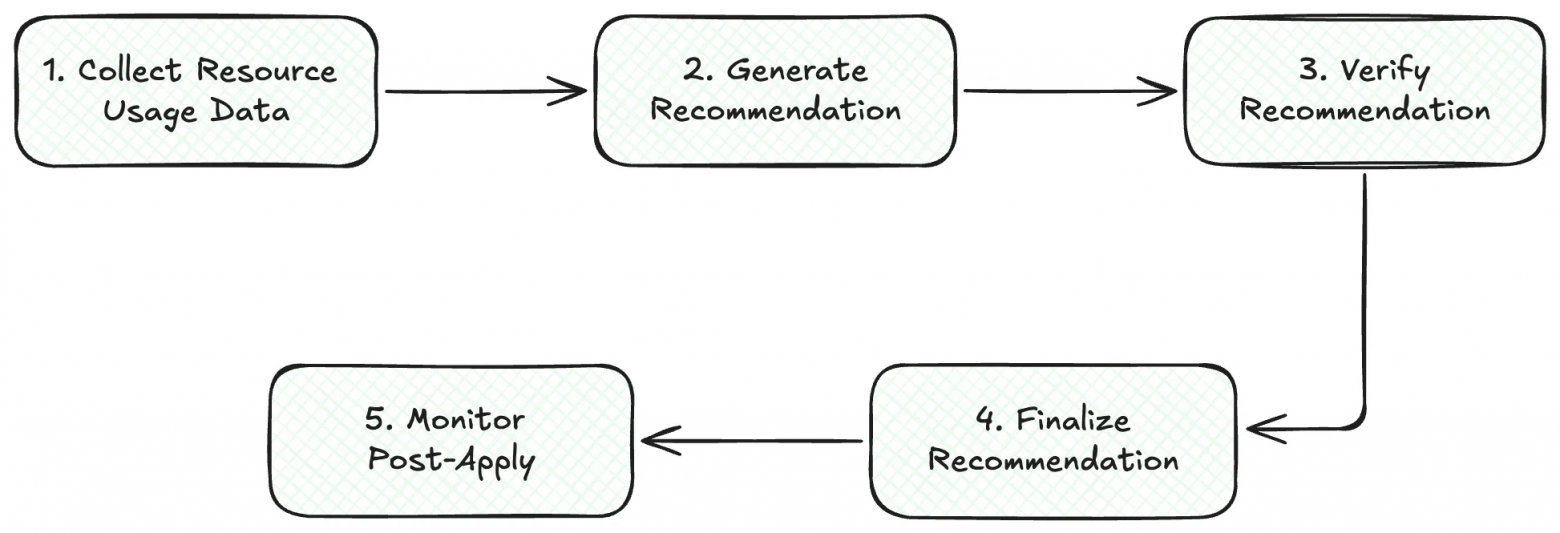
По умолчанию автоматический подбор ресурсов отключён. Владельцы функций должны самостоятельно включить его отдельно для каждого типа ресурсов: процессора, памяти, сети или диска. После подключения SRT работает без участия человека, выполняя пять шагов:
-
Собрать метрики использования ресурсов по всем запускам функции.
-
Сформировать рекомендацию для каждого типа ресурсов, например процессора или памяти.
-
Проверить рекомендацию с помощью экспериментов.
-
Применить или отклонить рекомендацию на основе результатов экспериментов.
-
Отслеживать метрики после применения, чтобы выявлять аномалии.
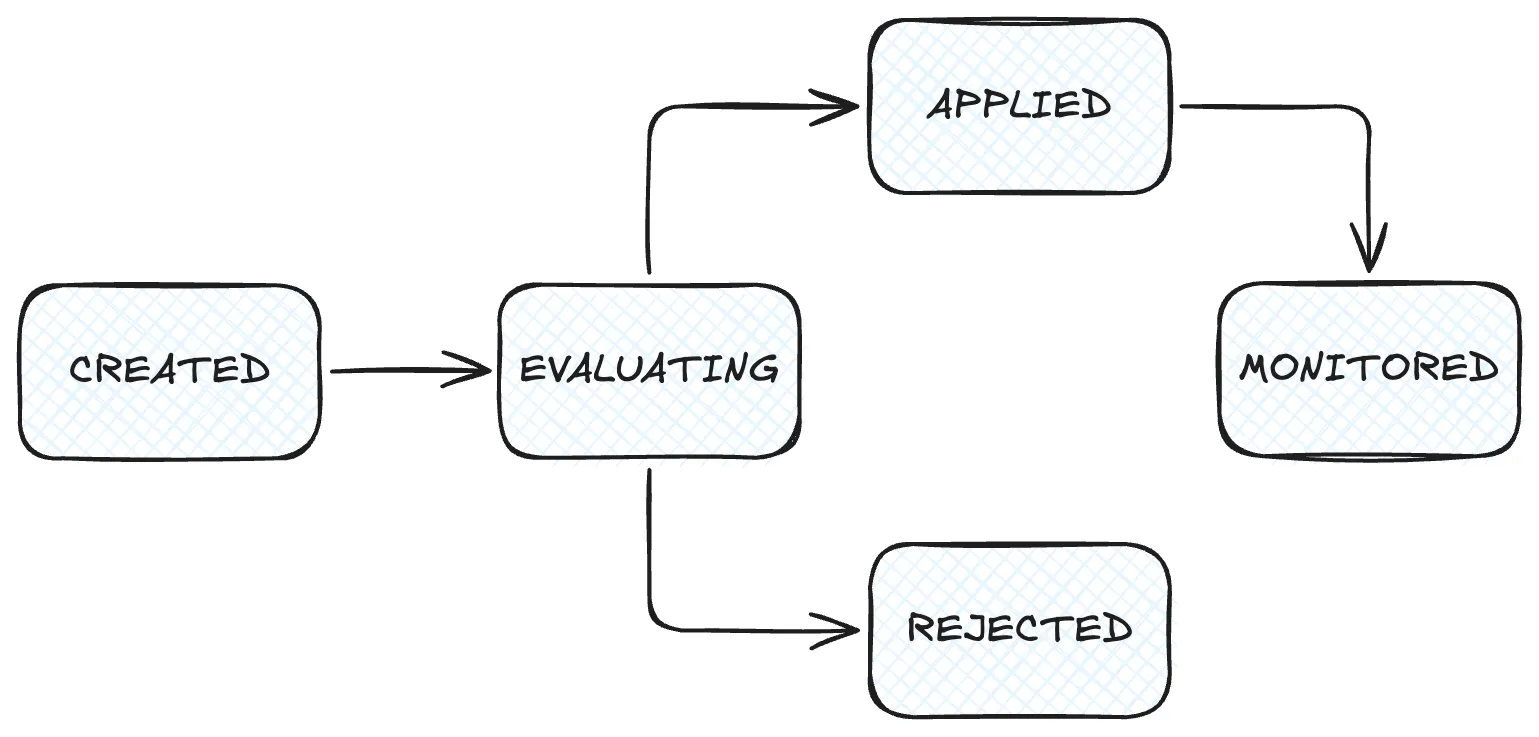
«Рекомендация» — ключевое понятие SRT и основная единица работы системы. По мере выполнения описанных шагов SRT проводит рекомендацию через несколько стадий:
-
CREATED: рабочий процесс, запускаемый по расписанию, сформировал рекомендацию.
-
EVALUATING: выполняется проверка рекомендации, и SRT анализирует результаты.
-
APPLIED: все эксперименты прошли успешно, и SRT автоматически применила рекомендованную конфигурацию.
-
REJECTED: хотя бы один эксперимент завершился неудачей, поэтому конфигурация функции осталась без изменений.
-
MONITORED: SRT отслеживает метрики в течение периода наблюдения после применения рекомендации, чтобы убедиться в стабильности работы.
В следующих разделах мы подробно рассмотрим каждую из этих стадий. Чтобы проиллюстрировать процесс, проследим реальный цикл настройки VideoEncoder.encodeV1 — функции кодирования видео с высокой пропускной способностью, для которой удалось успешно уменьшить избыточно выделенные объёмы памяти и процессорных ресурсов.
Все рассматриваемые ниже рабочие пороги и ограничения безопасности можно настраивать отдельно для каждой функции с учётом особенностей нагрузки и допустимого уровня риска.
Сбор метрик
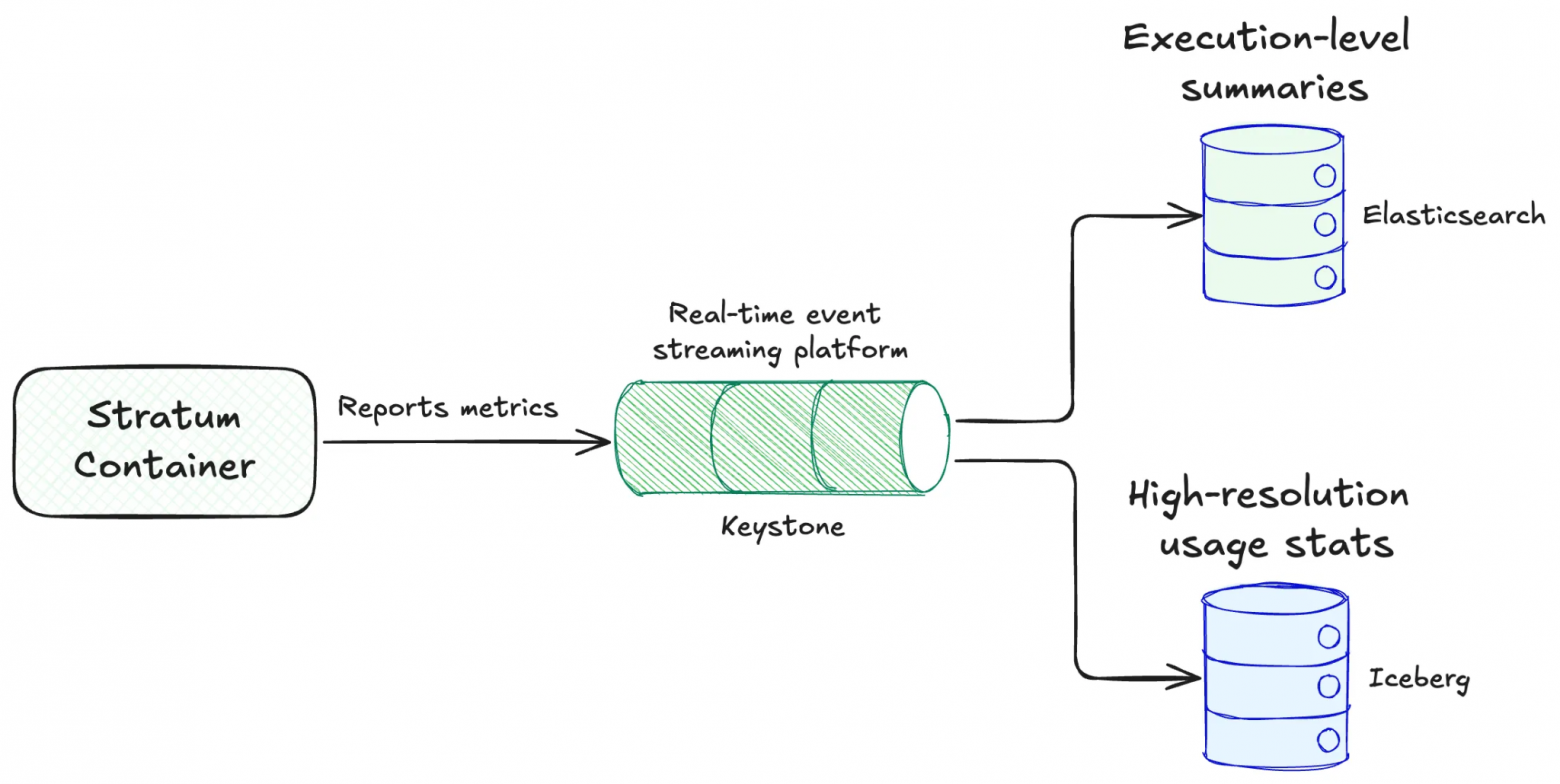
Для формирования рекомендаций нужен надёжный механизм сбора метрик. Каждый контейнер Stratum передаёт метаданные о выполнении функции, характеристики инфраструктуры и показатели использования ресурсов — процессора, памяти, диска и сети — с интервалом менее минуты.
Эти метрики проходят через Keystone, платформу Netflix для потоковой обработки событий в реальном времени, и поступают в два отдельных хранилища:
-
Хранилище сводных данных о выполнении: хранит сводные метрики каждого запуска, проиндексированные в Elasticsearch для быстрого точечного поиска. Это краткосрочное хранилище, которое позволяет запрашивать и изучать отдельные запуски.
-
Долгосрочное хранилище подробных метрик: хранит исходные метрики использования ресурсов с высокой временной детализацией в таблицах Iceberg. Запросы к нему выполняются медленнее, зато оно содержит историю за несколько месяцев, необходимую для анализа тенденций использования ресурсов.
Для каждого запуска, представленного в виде спана (span), создаётся одна запись. Вот как выглядят записи для одного спана нашей функции VideoEncoder.encodeV1.
В Elasticsearch запись содержит сводную информацию о завершённом спане, идентификатор которого указан в tags.stratum.spanId:
{
  "tags.stratum.spanId": "38536313f65f060a",
  "tags.functionName": "VideoEncoder.encodeV1",
  "tags.stratum.phase": "run",
  "tags.stratum.success": true,
  "tags.stratum.retriedWithMoreResources": false,
  "tags.stratum.function.execDurationSecs": 26,
  "tags.cpuCount": 8,
  "tags.memoryInMB": 18000,
  "tags.diskInMB": 50000,
  "tags.networkInMbps": 1000,
  "tags.titusTaskId": "06e1a7c0-2502-4a54-905f-b13a1e786107",
  "tags.instanceType": "r7a.24xlarge",
  "tags.nf.region": "us-east-1",
  "ts": 1780743028000
}
В Iceberg запись содержит те же метаданные, а также временной ряд показателей использования ресурсов, собранных в течение этого спана с интервалом менее минуты:
{
  "span_id": "38536313f65f060a",
  "function_name": "VideoEncoder.encodeV1",
  "phase": "run",
  "success": true,
  "start_epoch_secs": 1780743002,
  "end_epoch_secs": 1780743028,
  "runtime_secs": 26,
  "cpu_requested": 8,
  "memory_mb_requested": 18000,
  "disk_mb_requested": 50000,
  "network_mbps_requested": 1000,
  "titusTaskId": "06e1a7c0-2502-4a54-905f-b13a1e786107",
  "instance_type": "r7a.24xlarge",
  "tags.stratum.retriedWithMoreResources": false,
  "env": "prod",
  "resource_usage": [
   { "cpu_usage": 1.13, "memory_mb": 3701.37, "disk_mb": 20120.4, "net_in_mb": 221.09, "net_out_mb": 0.12 },
   { "cpu_usage": 2.25, "memory_mb": 3584.09, "disk_mb": 25410.1, "net_in_mb": 0.02, "net_out_mb": 0.05 },
   { "cpu_usage": 4.16, "memory_mb": 6750.79, "disk_mb": 30400.5, "net_in_mb": 165.90, "net_out_mb": 0.38 },
   ...
  ]
}
Формирование рекомендаций
Рабочий процесс Conductor ежедневно запускается по расписанию, считывает из Iceberg данные об использовании ресурсов за последний месяц и формирует рекомендации для каждой функции и каждого типа ресурсов. Рекомендации создаются и для функций, владельцы которых не включили автоматический подбор ресурсов, — это позволяет заранее оценить потенциальную экономию.
Каждая рекомендация сохраняется в хранилище рекомендаций. Благодаря этому мы можем по мере необходимости запрашивать и фильтровать их по функции, типу ресурсов или статусу.
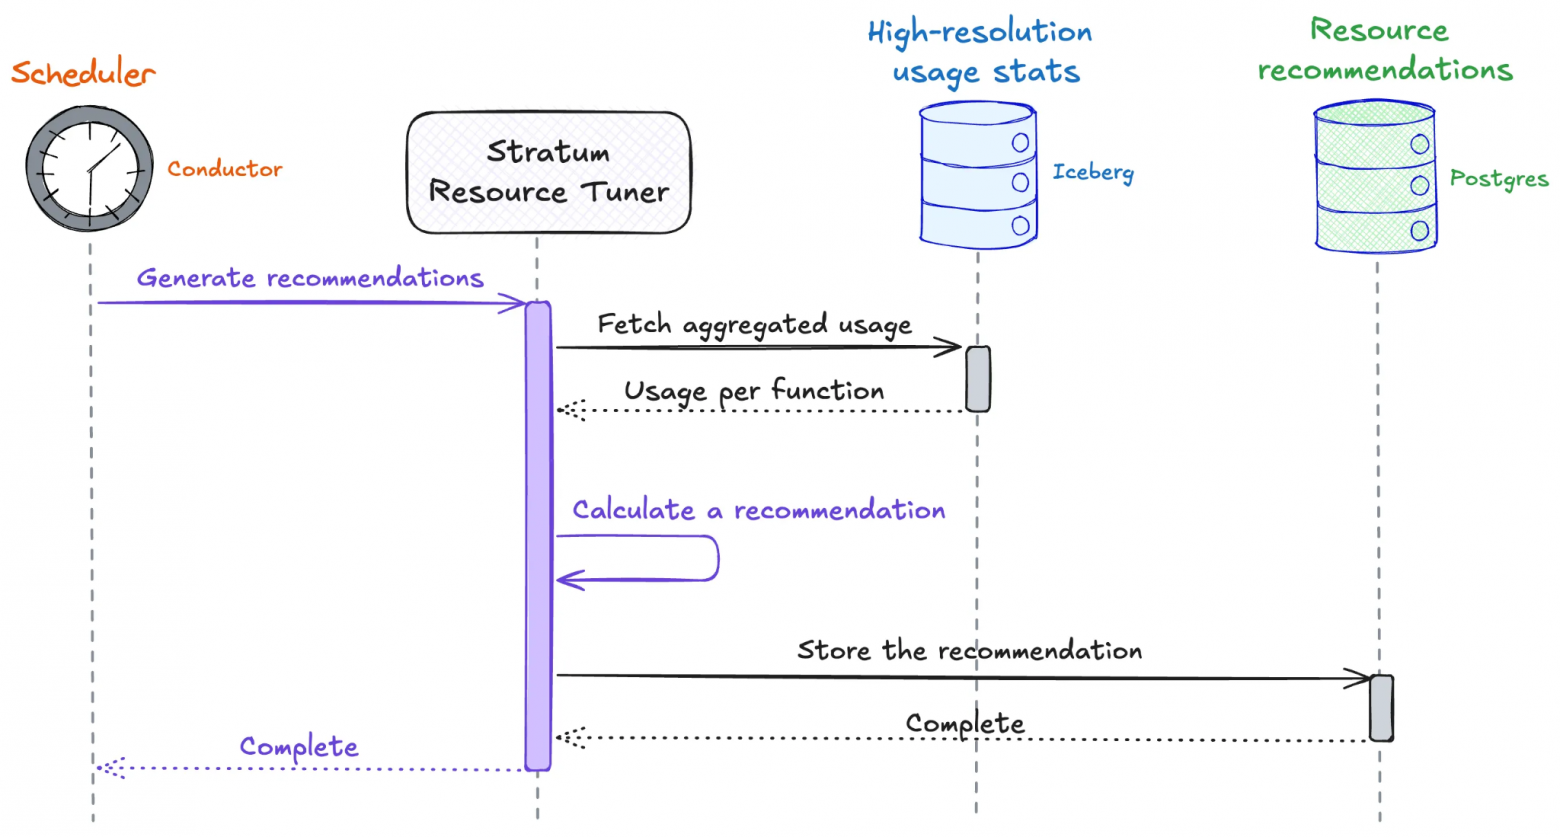
Для каждой функции и каждого типа ресурсов рабочий процесс применяет следующую логику формирования рекомендаций:
-
Отбор по типу нагрузки. Мы настраиваем ресурсы только для нагрузок с высокой пропускной способностью. Это позволяет сосредоточиться на изменениях, которые дают наиболее существенную экономию в масштабах всего парка контейнеров.
-
Агрессивная настройка процессора и сети. Мы ориентируемся на p99 использования без дополнительного запаса. Процессор и сеть — ресурсы, потребление которых можно ограничить без аварийного завершения: если контейнер изредка достигает лимитов, функция может просто выполняться немного медленнее.
-
Осторожная настройка памяти и диска. Мы ориентируемся на p99,9 использования и добавляем запас безопасности. Нехватка оперативной памяти или места на диске приводит к аварийному завершению, например с ошибкой Out of Memory (OOM) или Out of Disk (OOD), поэтому такой запас необходим.
-
Ограничения безопасности при изменениях. Мы отбрасываем рекомендации, если абсолютное сокращение ресурсов слишком мало, чтобы оправдать эксплуатационные затраты. Для памяти и диска максимальное сокращение за один цикл ограничено 15%. Этот предел появился по итогам первых запусков в промышленной среде.
Рабочий процесс создаёт новые рекомендации в состоянии CREATED. Если для данной функции и типа ресурсов уже существует рекомендация в этом состоянии, SRT перезаписывает её, обновляя расчёты. После перехода рекомендации из состояния CREATED её поля recommended_value и stats становятся неизменяемыми. При последующих ежедневных запусках система создаёт новую рекомендацию с уникальным идентификатором, а не изменяет существующую запись.
Вот как выглядят рекомендации для разных типов ресурсов функции VideoEncoder.encodeV1 в исходном состоянии CREATED.
Рекомендация для процессора:
{

  "function_name": "VideoEncoder.encodeV1",
  "env": "prod", "resource_type": "CPU",
  "current_value": 8, "recommended_value": 4,
  "status": "CREATED",
  "resource_cost_usd_per_hour": ***,
  "stats": {
    "usage": { "p99": 4.16, "p999": 4.57 },
    "execution": {
      "total_fn_executions": 748762182,
      "success_fn_executions_pct": 99.75,
      "total_fn_exec_runtime_hr": 88102723
    },
    "window": { "start": "2026-05-05T00:00:00Z", "end": "2026-06-05T00:00:00Z" }
  },
  "experiment_inputs": null,
  "experiment_workflow_execution_id": null,
  "outcome_message": null,
  "finalized_at": null
}
Рекомендация для памяти — сокращение на 15% за один шаг:
{
  "id": "2edb734a-6184-4f5e-8ffa-23004bd665d7",
  "function_name": "VideoEncoder.encodeV1",
  "env": "prod", "resource_type": "MEMORY_MB",
  "current_value": 18000, "recommended_value": 15300,
  "status": "CREATED",
  "resource_cost_usd_per_hour": ***,

  "stats": {
    "usage": { "avg": 5296.43, "p99": 6750.8, "p999": 7820.3 },
    "execution": {
      "total_fn_executions": 748762182,
      "success_fn_executions_pct": 99.75,
      "total_fn_exec_runtime_hr": 88102723
    },
    "window": { "start": "2026-05-05T00:00:00Z", "end": "2026-06-05T00:00:00Z" }
  },
  "experiment_inputs": null,
  "experiment_workflow_execution_id": null,
  "outcome_message": null,
  "finalized_at": null
}
По мере прохождения рекомендацией своего жизненного цикла SRT заполняет остальные параметры.
При переходе к проверке SRT меняет статус рекомендации на EVALUATING, записывает целевые настройки эксперимента и связывает рекомендацию с текущим запуском рабочего процесса, который отслеживает эксперимент.
После завершения проверок статус меняется на APPLIED или REJECTED. При этом сохраняются подробности результата и время завершения для последующего анализа.
Повторный запуск с увеличенными ресурсами
Мы осторожно подходим к формированию рекомендаций, отдавая приоритет стабильности системы, а не предельной эффективности. Поскольку рекомендации опираются на исторические данные об использовании ресурсов, они не всегда позволяют предвидеть резкие скачки потребления или новые профили нагрузки, возникающие при обработке тяжёлых запросов, с которыми функция раньше не сталкивалась.
Для обработки таких неожиданных скачков мы разработали защитный механизм. В каждом контейнере, ресурсы которого настраивает SRT, работает процесс наблюдения. Он отслеживает использование памяти и диска во время выполнения функции. Если потребление превышает заданные пороги — 85% для памяти без учёта кеша или 95% для диска, — процесс помечает запуск как высокорисковый, отменяет выполнение и повторно ставит задание в очередь для запуска в контейнере с увеличенными ресурсами:
new_container_size = original_container_size * 1.5Коэффициент 1,5 применяется только к объёму памяти и диска.
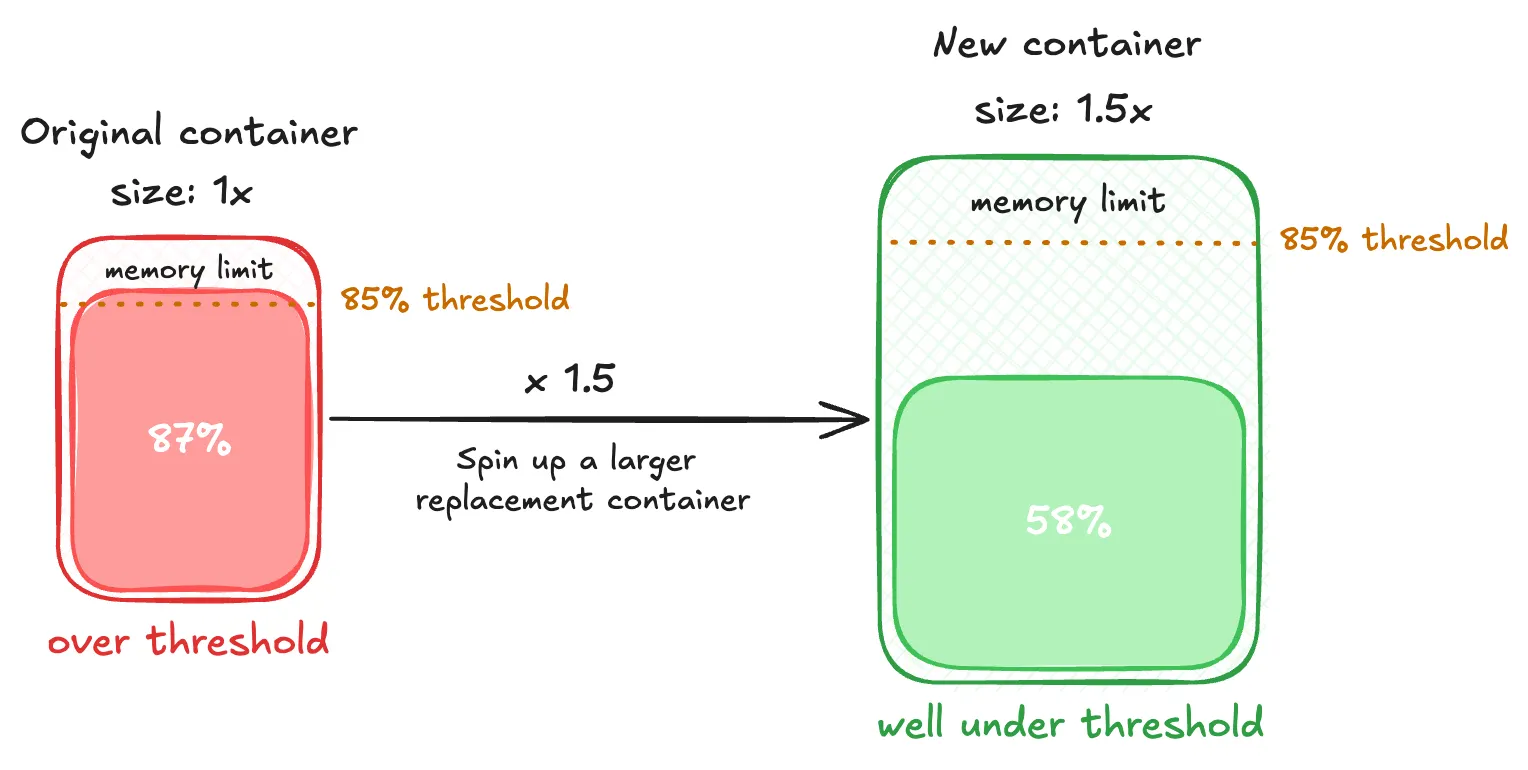
Механизм повторного запуска с увеличенными ресурсами служит нашей страховкой: контейнеры с большим объёмом ресурсов используются только при повторных попытках, позволяя автоматически восстанавливаться в редких нештатных ситуациях. Хотя такие нечастые повторы увеличивают затраты на вычисления и задержки, они позволяют поддерживать оптимальную повседневную конфигурацию без необходимости заранее выделять ресурсы под редкие, особенно ресурсоёмкие случаи.
Для нашей функции VideoEncoder.encodeV1, если при обработке тяжёлого задания потребление памяти в текущем контейнере объёмом 18 000 МБ превышает порог 85% — 15 300 МБ, — система прерывает выполнение и запускает его повторно в контейнере с 27 000 МБ памяти.
Мы бы предпочли запускать повторные попытки по факту ошибок OOM или OOD, а не по достижении заданных порогов. Однако технические ограничения текущей архитектуры затрудняют обнаружение самих этих событий. Пока мы совершенствуем механизмы обнаружения, фиксированные пороги служат надёжным временным решением.
SRT автоматически включает механизм повторных запусков для всех функций, у которых активирован автоматический подбор памяти или дискового пространства. Каждый контейнер Stratum сообщает о повторных запусках. Эти события поступают в Elasticsearch и Iceberg вместе со стандартной телеметрией производительности.
Проверка рекомендаций
Перед применением каждая рекомендация должна пройти двухэтапную проверку под управлением рабочего процесса Conductor. На стадии EVALUATING SRT проводит два типа экспериментов:
-
Синтетический эксперимент: недорогая проверка с низким риском, позволяющая выявить очевидные ухудшения до внедрения в промышленную среду.
-
Эксперимент в промышленной среде: проверка изменений на разнообразных реальных нагрузках, которая повышает уверенность в их безопасности.
Рекомендация допускается к проверке в промышленной среде только после успешного прохождения синтетического эксперимента. Если для функции с включённым автоматическим подбором ресурсов ожидают проверки несколько рекомендаций, SRT в первую очередь проверяет те, которые обещают наибольшую экономию.
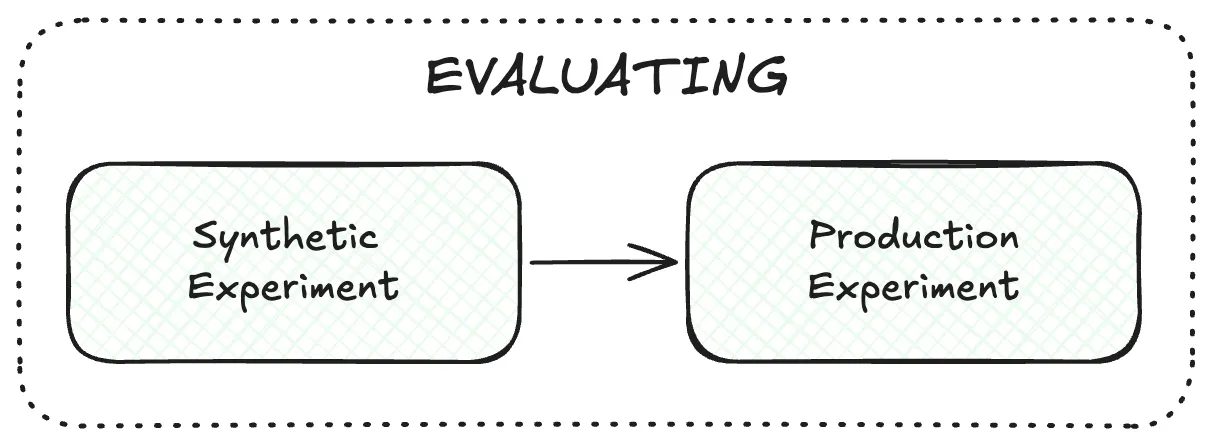
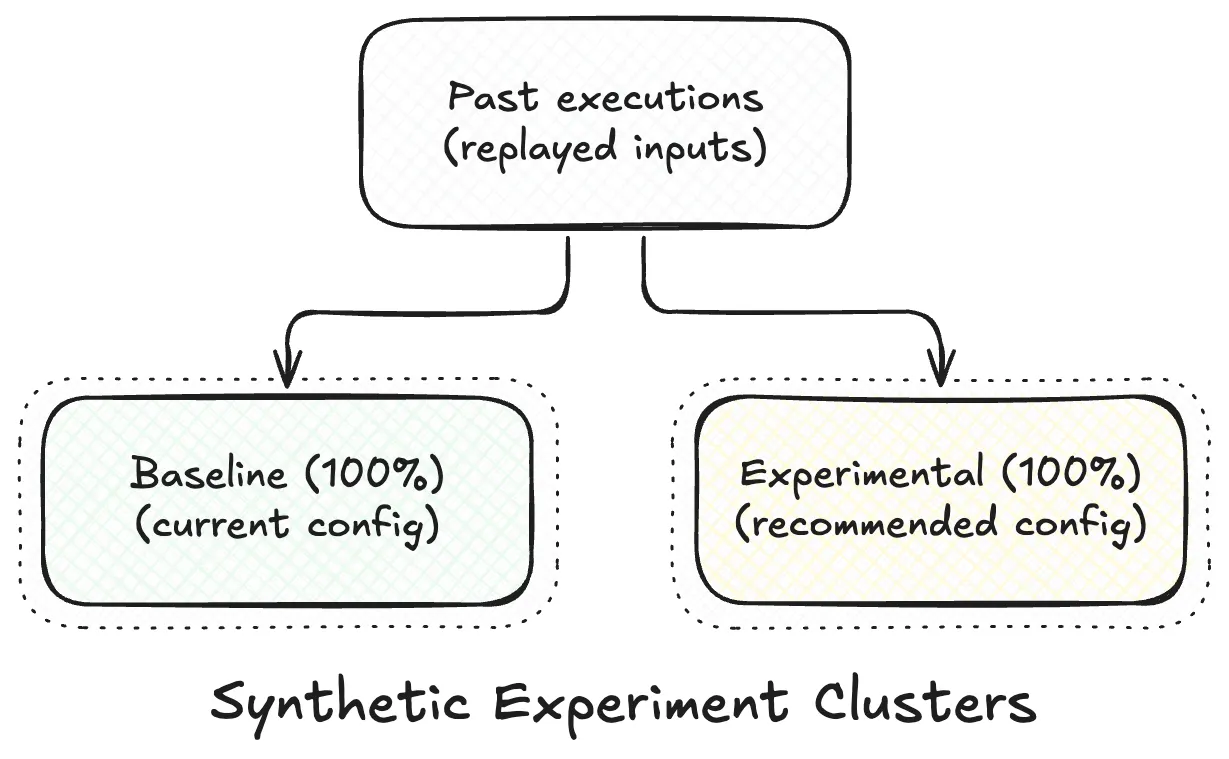
Синтетический эксперимент:
-
Выполняется в тестовой среде, изолированной от промышленного трафика.
-
Создаёт два кластера: один с текущей конфигурацией, другой — с рекомендованной.
-
Одновременно воспроизводит одинаковые наборы запросов на обоих кластерах без разделения трафика: каждая конфигурация обрабатывает 100% тестовых запросов.
-
Обычно длится 1–2 часа.
-
Выполняется до конца без проверок для досрочного завершения.
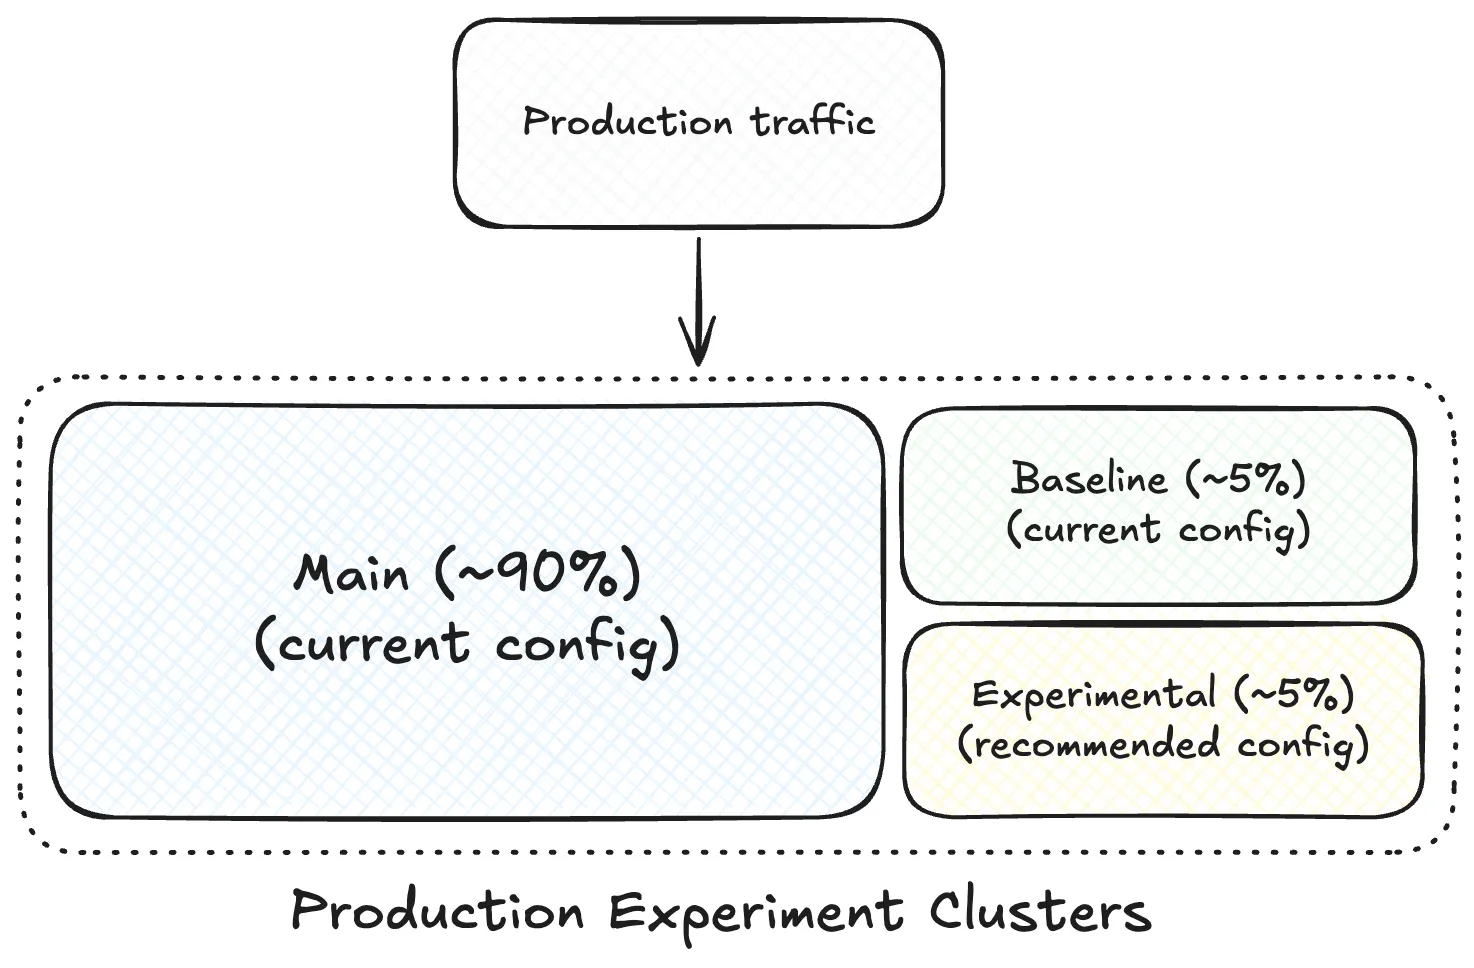
Эксперимент в промышленной среде:
-
Выполняется на реальном пользовательском трафике, разделённом на три потока:
-
Около 90% остаётся на основном кластере с текущей промышленной конфигурацией.
-
Около 5% направляется на контрольный кластер с текущей промышленной конфигурацией.
-
Около 5% направляется на экспериментальный кластер с рекомендованной конфигурацией.
-
-
Сравнивает рекомендованную конфигурацию с контрольным кластером сопоставимого размера, чтобы обеспечить сходные профили трафика.
-
Обычно длится от одного дня до недели в зависимости от объёма трафика.
-
Досрочно прекращается при обнаружении ухудшений.
На платформе Stratum параллельно с экспериментами SRT проводятся и другие эксперименты. Чтобы избежать чрезмерного дробления трафика, эксперименты SRT имеют более низкий приоритет и уступают ресурсы активным экспериментам с более высоким приоритетом.
Трафик поступает неравномерными всплесками, между которыми могут проходить дни и даже недели затишья. Процесс проверки учитывает такой характер нагрузки и не предполагает постоянного потока запросов.
Вернёмся к рекомендации по памяти для VideoEncoder.encodeV1 — с 18 000 до 15 300 МБ. Её проверка запускается со следующими параметрами:
{
  "recommendationId": "2edb734a-6184-4f5e-8ffa-23004bd665d7",
  "syntheticExperiment": { "numberOfExecutions": 3000 },
  "productionExperiment": {
    "enabled": true,
    "maxContainers": 20, // max containers shift to baseline & experimental clusters
    "upGateTimeoutMinutes": 10080, // time to wait for traffic to start flowing
    "maxRunDurationMinutes": 1240, // max time to run the experiment once traffic starts
    "minSamples": 500 // min executions needed on both clusters before evaluating
  }
}
На обоих этапах рекомендация проходит две последовательные проверки. Если любая из них завершается неудачей, проверка рекомендации немедленно прекращается:
-
Повторные запуски с увеличенными ресурсами. При сокращении памяти и дискового пространства доля таких запусков за время эксперимента не должна превышать 1%.
-
Время выполнения. Сравнивается медианное время выполнения, чтобы исключить искажения из-за выбросов. В зависимости от нагрузки допускается замедление до 10–15% относительно контрольной конфигурации. Этот порог настраивается отдельно для каждой функции.
Если рекомендация успешно проходит оба этапа проверки, SRT меняет её статус на APPLIED и применяет конфигурацию к основному промышленному кластеру. Если на любом этапе проверка завершается неудачей, SRT присваивает рекомендации статус REJECTED и сохраняет текущую конфигурацию. В обоих случаях SRT отправляет уведомления.
Для VideoEncoder.encodeV1 оба этапа прошли успешно:
{
  "outcome": "APPLIED",
  "syntheticExperiment": {
    "result": "SUCCESS",
    "samples": { "baseline": 3000, "experimental": 3000 },
    "medianExecutionSecs": { "baseline": 59.0, "experimental": 59.0 },
    "slownessIncreasePct": 0.0,
    "retryRatePct": { "baseline": 0.0, "experimental": 0.0 }
  },
  "productionExperiment": {
    "result": "SUCCESS",
    "samples": { "baseline": 50361, "experimental": 49790 },
    "medianExecutionSecs": { "baseline": 196.0, "experimental": 198.0 },
    "slownessIncreasePct": 1.0,
    "retryRatePct": { "baseline": 0.0, "experimental": 0.0 }
  }
}
Рекомендация перешла в состояние APPLIED, и объём памяти для VideoEncoder.encodeV1 был установлен на постоянной основе в 15 300 МБ. Столь же успешно прошла проверка рекомендации для процессора: число выделенных ядер сократилось с восьми до четырёх.
Мониторинг после применения
Успешное прохождение экспериментов не завершает жизненный цикл рекомендации. Обновление кода функции, изменение входных параметров или вычислительной среды Titus/EC2 со временем могут повлиять на поведение в промышленной среде. Чтобы обеспечить безопасность конфигураций и повысить доверие к автоматической настройке, мы ввели непрерывный мониторинг после применения изменений.
Мы отслеживаем метрики в течение 90 дней, используя два скользящих временных окна: короткое — 30 минут — и длинное — 24 часа. Для каждого заданы пороги оповещения: доля повторных запусков в 3% за 30 минут или 2% за 24 часа вызывает автоматическое уведомление.
В установившемся режиме базовая доля повторных запусков составляет около 0,1%, а значения до 2–3% укладываются в допустимые эксплуатационные колебания. За последние три месяца большинство применённых рекомендаций сохраняли стабильность.
VideoEncoder.encodeV1 несколько месяцев работает с подобранной конфигурацией без превышения порогов. Однако с VideoEncoder.encodeV2 возник сложный пограничный случай: сокращение памяти на 50% прошло все проверки и обеспечивало стабильную работу в течение двух недель, после чего неожиданное изменение характера трафика привело к росту доли повторных запусков выше 60%.
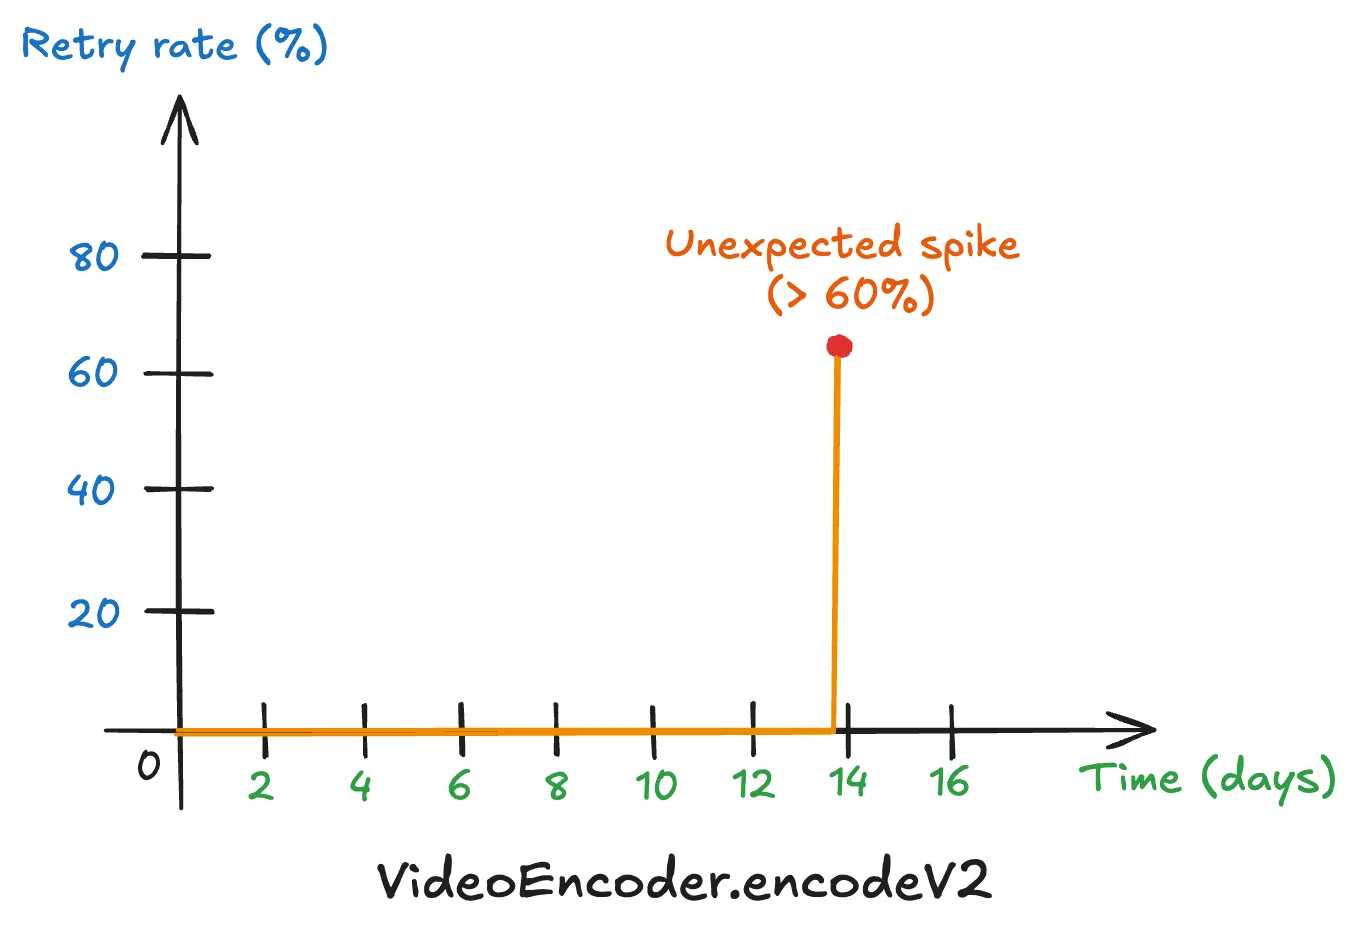
В ранних версиях автоматического отката не было, поэтому инженеры вручную разбирали нештатные ситуации. Этот инцидент показал необходимость автоматического устранения проблем и подтолкнул нас к созданию механизма отката для самостоятельного восстановления системы.
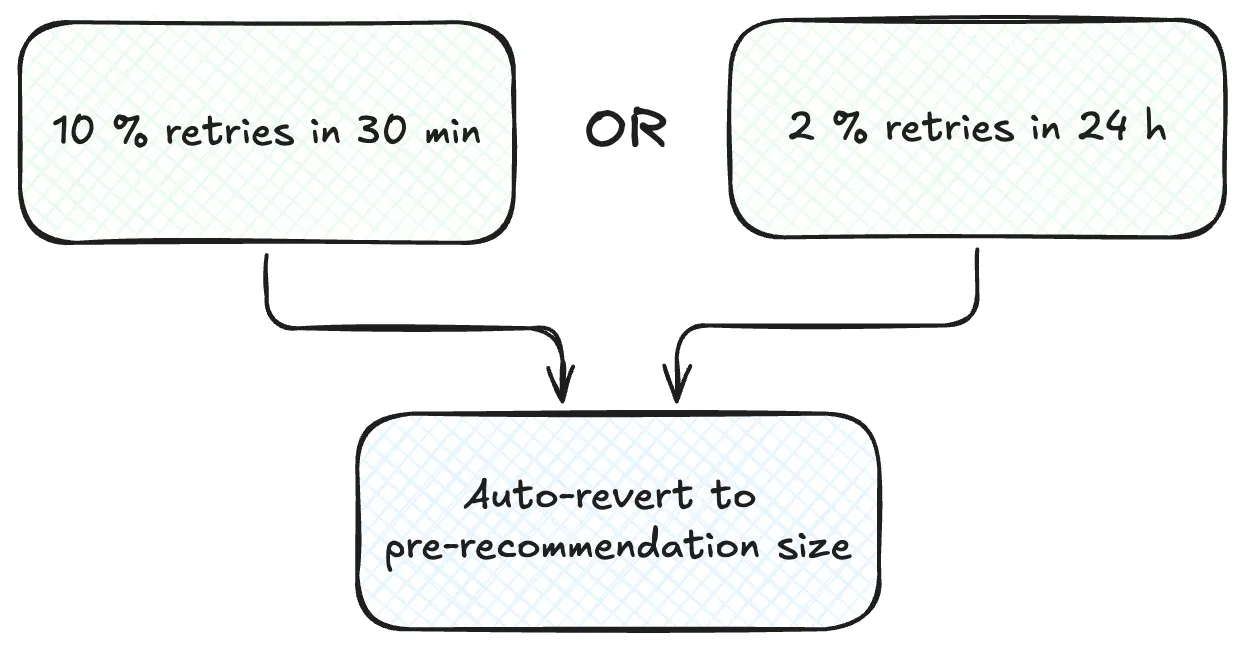
Сейчас автоматический откат работает по двум временным окнам:
-
Последние 30 минут: доля повторных запусков в 3% вызывает предупреждение, а 10% — автоматический откат.
-
Последние 24 часа: доля повторных запусков в 2% вызывает и оповещение, и автоматический откат.
При превышении порога автоматического отката система немедленно возвращает конфигурацию функции к значениям, действовавшим до применения рекомендации.
Мы намеренно сохраняем простую логику отката: восстанавливаем последнюю заведомо стабильную конфигурацию, а не пытаемся динамически подбирать ресурсы во время инцидента.
Инцидент с VideoEncoder.encodeV2 также изменил наши правила формирования рекомендаций для памяти и диска. Теперь SRT не сокращает ресурсы сразу до целевого значения, а уменьшает их постепенно, шагами по 15%, переходя к следующему шагу только после подтверждения стабильности. Кроме того, мы добавили глобальный аварийный выключатель, позволяющий отключить автоматический подбор ресурсов для всех функций при неожиданных проблемах или побочных эффектах.
Также мы ввели обязательную паузу — обычно одну неделю — перед запуском новых экспериментов для функции. Этот перерыв позволяет оценить производительность при разных профилях промышленного трафика и выявить возможные риски до применения следующих рекомендаций.
Чего мы достигли
Избыточные ресурсы контейнеров и постепенное отклонение конфигураций от оптимальных значений не обязательно должны быть неизбежной платой за использование бессерверных вычислений в большом масштабе. Создав Stratum Resource Tuner, мы превратили ручной подбор ресурсов с постоянной оглядкой на риски в автоматизированный процесс с самостоятельным восстановлением после сбоев. На реальных нагрузках, в том числе благодаря урокам неожиданных скачков потребления ресурсов, мы убедились: непрерывный подбор ресурсов может безопасно и существенно повышать эффективность инфраструктуры.
Первоначально мы сосредоточились на задачах кодирования видео с высокой пропускной способностью. Это позволило снизить общие затраты Stratum на вычисления на 10%, и потенциал дальнейшей экономии ещё есть. Например, для VideoEncoder.encodeV1 удалось сократить использование процессорных ресурсов на 50%, а памяти — на 40%, без ухудшения производительности или роста доли повторных запусков.
Однако пограничные случаи, такие как VideoEncoder.encodeV2, преподали важные уроки: резкое сокращение ресурсов за один шаг может создавать скрытые риски, а ручное устранение инцидентов замедляет восстановление. Поэтому мы усилили защитные механизмы Stratum Resource Tuner: ограничили сокращение памяти и диска до 15% за цикл и добавили автоматический откат при превышении порогов повторных запусков. С этими мерами повторная настройка VideoEncoder.encodeV2 позволила стабильно сократить объём памяти на 20% без последующих инцидентов.
Наши основные приоритеты на будущее:
-
Расширить применение SRT за пределы задач кодирования с высокой пропускной способностью, охватив больше функций и типов нагрузки.
-
Продолжить оптимизацию ресурсов в регионах с ограниченной доступностью вычислительных мощностей.
-
Перейти от оповещений по факту проблем к упреждающему автоматическому увеличению ресурсов для функций, которым их не хватает.
-
Поэкспериментировать с намеренным увеличением ресурсов для нагрузок, чувствительных к задержкам, чтобы оценить прирост производительности и сократить время выполнения функций.
-
Перейти от запаздывающих сигналов о сбоях OOM/OOD к сигналам, позволяющим предвидеть такие сбои, и тем самым повысить точность настройки.
Присоединяйтесь к русскоязычному сообществу разработчиков на Spring Boot в телеграм — Spring АйО, чтобы быть в курсе последних новостей из мира разработки на Spring Boot и всего, что с ним связано.
Автор: spring_aio

