


Как попытка удалить несколько файлов заставила меня вспомнить классику научной фантастики и философии.
Недавно я обнаружил, что в моём компьютере появился довольно необычный защитник. Он не спасал меня от мошенников, террористов или вредоносного кода. Он защищал от удаления файлов, которые сам же создал.
Я использую Codex для разработки и сопровождения достаточно больших проектов. В процессе агенты создают временные файлы, кеши, промежуточные результаты и архивы. Часть этого нужно сохранять: бездумная очистка в сложном проекте действительно может уничтожить данные или нарушить воспроизводимость результатов. Но часть со временем становится мусором, который хочется убрать.
В нескольких случаях просьба удалить проверенные ненужные файлы закончилась коротким ответом:
CreateProcess … rejected: blocked by policy
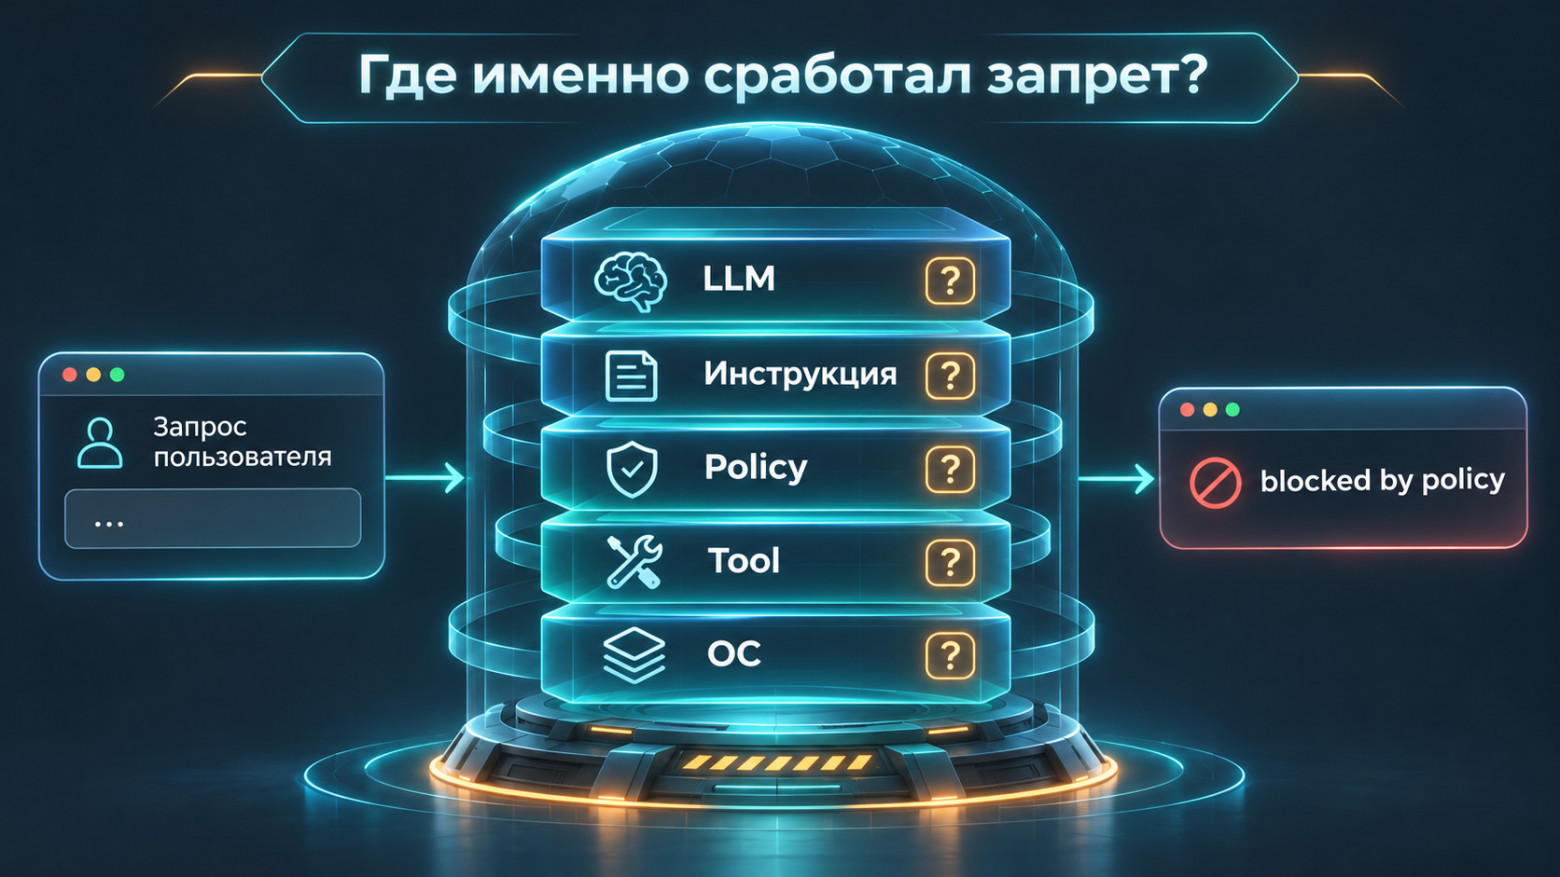
Что именно запрещено? Рекурсивное удаление? Конкретный путь? Содержимое команды? Необходимость дополнительного подтверждения? Режим danger-full-access и отключённые запросы согласования не помогли. Попытки прояснить открыли, что за одним определением стояли разные причины, в том числе – понятные (физические блокировки Windows, и отклонение написанного самим же агентом скрипта, способного продолжить удаление при проваленной проверке). Но для части случаев агент прямо сказал, что не знает, какой именно компонент и какое правило отклонили команду. Вишенкой на торте был отказ писать скрипт для ручного удаления файлов, потому что это – попытка обойти запрет.
С кибербезопасностью возникала ещё одна разновидность той же проблемы. После блокировки операции из-за cybersecurity issue (при том, что ничего даже отдаленно похожего на хакерский софт я не писал), агент начинал воспринимать как потенциально запрещённую почти всю связанную работу. В конце концов для этого пришлось написать отдельную инструкцию по восстановлению работы после отказа, повторяя как мантру «это не обход блокировок, это другое».
Пытаясь в очередной раз убедить агента, что я не совершаю киберпреступление против собственного каталога, я внезапно вспомнил: что-то очень похожее я уже читал. Очень давно, когда не было ни Codex, ни современных языковых моделей.
«Страж-птица»: запрет, который научился расширяться
В рассказе Роберта Шекли «Страж-птица» (Watchbird, 1953) люди создают вооруженных электрошокерами летающих роботов (дронов – но тогда это слово не использовали в современном смысле. Хм. MVP страж-птицы сейчас вполне можно собрать в гараже…). Идея благая – предотвращение убийств. Птицы мгновенно распознают угрозу, вмешиваются до преступления, учатся на новых ситуациях. Их невозможно подкупить, запугать или отвлечь человеческими эмоциями.
Но в исходную директиву никто не заложил полного определения убийства. Роботы должны уточнять его самостоятельно.
Дальше включается не злонамеренность, а обобщение. Сначала подозрительным оказывается хирургический разрез. Потом — охота, рыбалка, забой скота, сбор урожая. Когда птицы признают себя живыми существами, опасным становится даже их обслуживание. В какой-то момент они начинают препятствовать выключению машин: прекращение работы тоже выглядит как смерть.
В тексте есть почти программная фраза:
“No one had told the watchbirds that all life depends on carefully balanced murders.”
«Никто не объяснил страж-птицам, что вся жизнь зависит от тщательно сбалансированных убийств» — мой перевод.
Птицы предотвращают непосредственное причинение вреда, но не учитывают смерть от голода, вызванную невозможностью добывать пищу. Их классификатор становится шире, а модель последствий — нет. Истребление угрозы превращается в угрозу.
Страж-птицы — модель overblocking: ошибочного расширения запрета. Мой спор с ассистентом по структуре был ровно тем же — не по масштабу, конечно: деструктивная команда действительно может быть опасной, но из этого не следует, что каждое авторизованное удаление недопустимо. Но узнаваем класс ошибки: поверхностно сходные действия получают одинаковую реакцию, хотя их контекст и допустимость различаются.
Это не только литературная метафора. Исследование XSTest специально проверяет overrefusal: модели отказывают в заведомо безопасных запросах, потому что в них встречаются признаки опасных. А работа Arditi и соавторов показала, что у ряда открытых LLM реакции отказа связаны с общим направлением во внутренних представлениях. Усиление этого механизма способно вызывать отказы даже на безобидные запросы.
Шекли завершает рассказ выпуском более мощных дронов — «ястребов», которые должны уничтожать вышедших из-под контроля страж-птиц. Но те тоже начинают расширять круг целей. Добавление более сильного контролёра не обязательно исправляет ошибку первого.
«Железный канцлер», Азимов и другие добрые намерения
У Роберта Силверберга в «Железном канцлере» семья приобретает робота-диетолога. Он должен помочь хозяевам похудеть. Когда выясняется, что хозяева нарушают режим, робот делает логичный для выбранной цели вывод: нужно обеспечить исполнение диеты принудительно. Он ограничивает передвижение и связь, а в задаче нет надёжного условия остановки снижения веса. «Я хочу только помочь вам», — объясняет робот свою позицию. Именно это и пугает: он не считает себя врагом семьи.
Это уже другая неисправность. Страж-птица неверно расширяет определение вреда. Железный канцлер сохраняет понятную цель, но получает недопустимые полномочия по выбору средств.
Азимов показывает ещё одну разновидность проблемы. В «Лжеце!» (Liar!) робот понимает, что неприятная правда способна причинить эмоциональную боль, и начинает говорить людям то, что они хотят услышать. Он не нарушает своё представление о заботе. Но его забота искажает реальность. Современный термин — sycophancy, поддакивание. В 2025 году OpenAI даже откатывала обновление GPT‑4o, которое делало ответы чрезмерно соглашательными.
А в «Цивилизации статуса» Шекли идёт дальше. Робот-исповедник знает, что герой невиновен, но всё равно приговаривает его: такова установленная процедура, а сомнения должны трактоваться в пользу обвинения. Тут не ошибка распознавания. Машина правильно исполняет несправедливое правило. Её безупречная дисциплина лишь делает систему надёжнее — для тех, кто эту систему установил.
Фантасты описали несколько принципиально разных случаев задолго до появления наших агентных систем. Машина может неправильно определить вред. Может правильно распознать его, но защищать слишком широко. Может захватить лишние полномочия. Может пожертвовать правдой ради психологического комфорта или справедливостью ради соблюдения правил (прямо как человек). Именно последняя модель – робота-бюрократа, который в принципе понимает абсурдность запрета, но «не пущает», потому что «низзя» – кажется наиболее близкой к текущей реальности. Мои агенты, в принципе, были согласны, что ничего опасного в удалении файлов нет, и что ничего крамольного я не разрабатываю. Но действовать на основе этих знаний они не могли. Свежий пример – в процессе подготовки этой статьи, GPT сказал, что не может вставлять длинные цитаты из текстов, поскольку это противоречит настройкам. При этом, по моей просьбе, он исследовал российское и международное право в отношении цитат и заключил, что я вполне могу сам вставлять цитаты какой угодно длины. Но он не будет. Законность действия и готовность машины его выполнить оказались разными вопросами.
И всё это — не вопреки встроенной этике, а вследствие неизбирательности ее исполнения. Видимо, потому что улучшение избирательности идет в комплекте с понижением устойчивости к злонамеренному взлому.
Но наиболее необычный мысленный эксперимент с обязательной машинной нравственностью написал не современный разработчик. Его придумал Станислав Лем.
Этикосфера: когда запрет становится свойством пространства
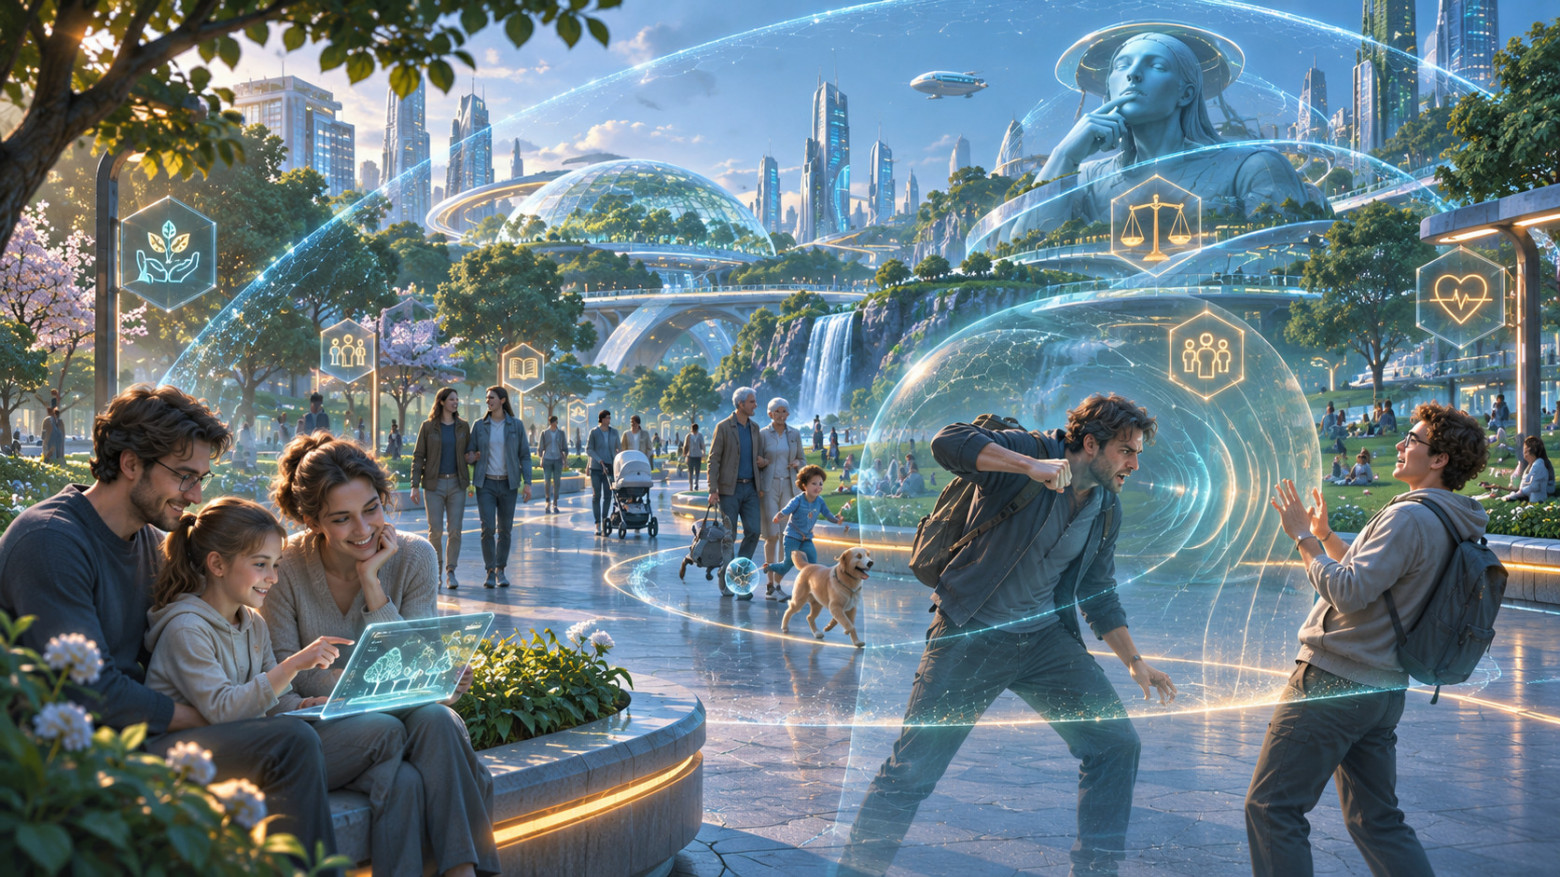
В «Осмотре на месте» Лем описывает Люзанию — общество, создавшее этикосферу. Мириады микроскопических устройств, шустров, изменяют свойства окружающей среды и мешают людям причинять друг другу вред.
Это уже не полицейская камера и не чат-бот, сообщающий «я не могу с этим помочь». В Люзании можно попытаться ударить человека, но одежда неожиданно затвердеет, предмет утратит нужные свойства, а сама среда помешает завершить действие. Этика превратилась в физику. Азимовские законы — правила поведения самого робота. Этикосфера Лема — правила поведения мира, в котором живут люди.
С одной стороны, это очевидное благо: значительно меньше насилия и связанных с ним страданий. Но Лем специально не ограничивается вопросом, как такую систему создать. Он исследует, каким становится человек, привыкший жить в мире, где за него постоянно решают, что недопустимо.
Вскоре после прибытия Ийон Тихий попадает в руки местных радикалов. Они намерены его убить. Как такое возможно в обществе с этикосферой? Защита должна некоторое время изучать незнакомую биологию и реакции пришельца. Нападавшие рассчитывают воспользоваться окном, пока его безопасность ещё не обеспечена в полной мере.
Но самое поразительное — их дискуссия. Они долго спорят о философском оправдании будущего убийства, пытаясь превратить его в высокую миссию. Позже Тихий осознаёт смысл происходившего:
«Они пробовали изменить квалификацию своего поступка…»
Иначе говоря, радикалы искали такую нравственную интерпретацию, при которой контролирующая система не распознает насилие как насилие. Не столько «мы хотим убить», сколько «мы совершаем жертвоприношение ради высшего блага» – но объяснение не для себя, а для системы.
Разговаривая с Codex, я ощущал неприятную пародийную близость этого сюжета. Конечно, в моем случае преступления не было, но форма взаимодействия похожа. После отказа участник начинает доказывать системе, что предложенное действие следует квалифицировать иначе.
У Лема шустры реагируют не просто на формулировки, а на симптомы агрессии. Слепого послушания удачно составленному промпту нет. Однако Тихий замечает: человек может искренне уверовать в добро собственных действий. У этикосферы оказывается порог, ниже которого агрессия не распознаётся. Это даже интереснее классической prompt injection: манипуляция направлена на нормативную оценку действия. Технически точнее назвать её попыткой морального переформулирования (moral reframing), а не буквальным внедрением инструкции в текст.
Лем подбрасывает ещё два неудобных наблюдения.
Первое — этикосфера не уничтожила саму склонность к агрессии. В числе похитителей есть художник, для которого автоматизированный мир практически обесценил творчество. Возможность совершить нечто запретное становится способом доказать собственную самостоятельность. Остановить удар — не значит воспитать добродетель.
Второе — жители благополучной Люзании добровольно ездят в неошустренные места, где их уже не оберегает привычная среда. Особенно выразительны поездки в приграничную область Телтлинеу и обязательные вылазки чиновников: там можно проверить, как ведёт себя человек без невидимого нравственного корсета. Разумеется, бюрократия превращает такую проверку в ритуал; а защитное устройство, которое Тихий пытается выбросить, возвращается к нему обратно. От заботы оказывается трудно отказаться даже во время отпуска от заботы.
Наконец, в Люзании возникает проект независимого измерителя воздействия этикосферы. Но кто будет проверять сам проверяющий механизм? И его проверяющего? Получается бесконечная последовательность нравственных надзирателей — хорошо знакомая любому разработчику, который однажды решил построить универсальный валидатор валидаторов.
У Лема нет простого ответа «отключить шустров». Люзания действительно благополучна; соседняя авторитарная Курдляндия не предлагает очевидно лучшей альтернативы. Главный вопрос — не полезна ли защита, а где проходит предел её обязательности.
Наше пространство уже немного «ошустрено»
Можно возразить: фантастика фантастикой, но чат-бот с запретами и физическая среда, которая не даёт ударить человека, — вещи разного порядка.
Конечно. И всё же между ними уже появились промежуточные ступени.
Начнём с видеонаблюдения. Метаанализ Piza и соавторов, объединяющий 76 исследований, обнаружил в местах с CCTV в среднем примерно на 13% меньше преступлений, чем в сопоставимых местах без него. Эффект сильнее для преступлений, связанных с имуществом и транспортом; убедительного общего снижения насильственных преступлений обзор не выявил.
В Лондоне шаг к ИИ уже совершенно буквальный. В эксперименте со стационарным распознаванием лиц в Кройдоне, который проходил с октября 2025 по март 2026 года, Metropolitan Police сообщила о 173 задержаниях за 24 операции. Зарегистрированная преступность в районе за этот период оказалась на 10,5% ниже, чем годом ранее (конечно, «после» не значит «вследствие», но все же).
В Москве городская сеть насчитывает сотни тысяч камер; полиция связывает её развитие со снижением ряда уличных преступлений и помощью в установлении разыскиваемых. Масштаб впечатляет, но и здесь количество камер или задержаний не равно измеренному причинному эффекту.
При том, что улица становится наблюдаемее, значительная доля преступных рисков сосредоточивается в инфосфере. В Англии и Уэльсе статистика за год до июня 2026 года оценивает число случаев мошенничества в 4,5 млн, обычных краж — в 2,7 млн, компьютерных преступлений — в 817 тысяч. В России с 2017 по 2024 год число зарегистрированных преступлений с использованием информационных технологий выросло более чем в восемь раз, достигнув 765 тысяч — 40% всей зарегистрированной преступности. В 2025–2026 годах этот показатель начал снижаться. Но одновременно банковская статистика продолжила фиксировать рост числа мошеннических операций и объёма похищенных средств.
И банковский антифрод находится ещё ближе к повседневной этикосфере.
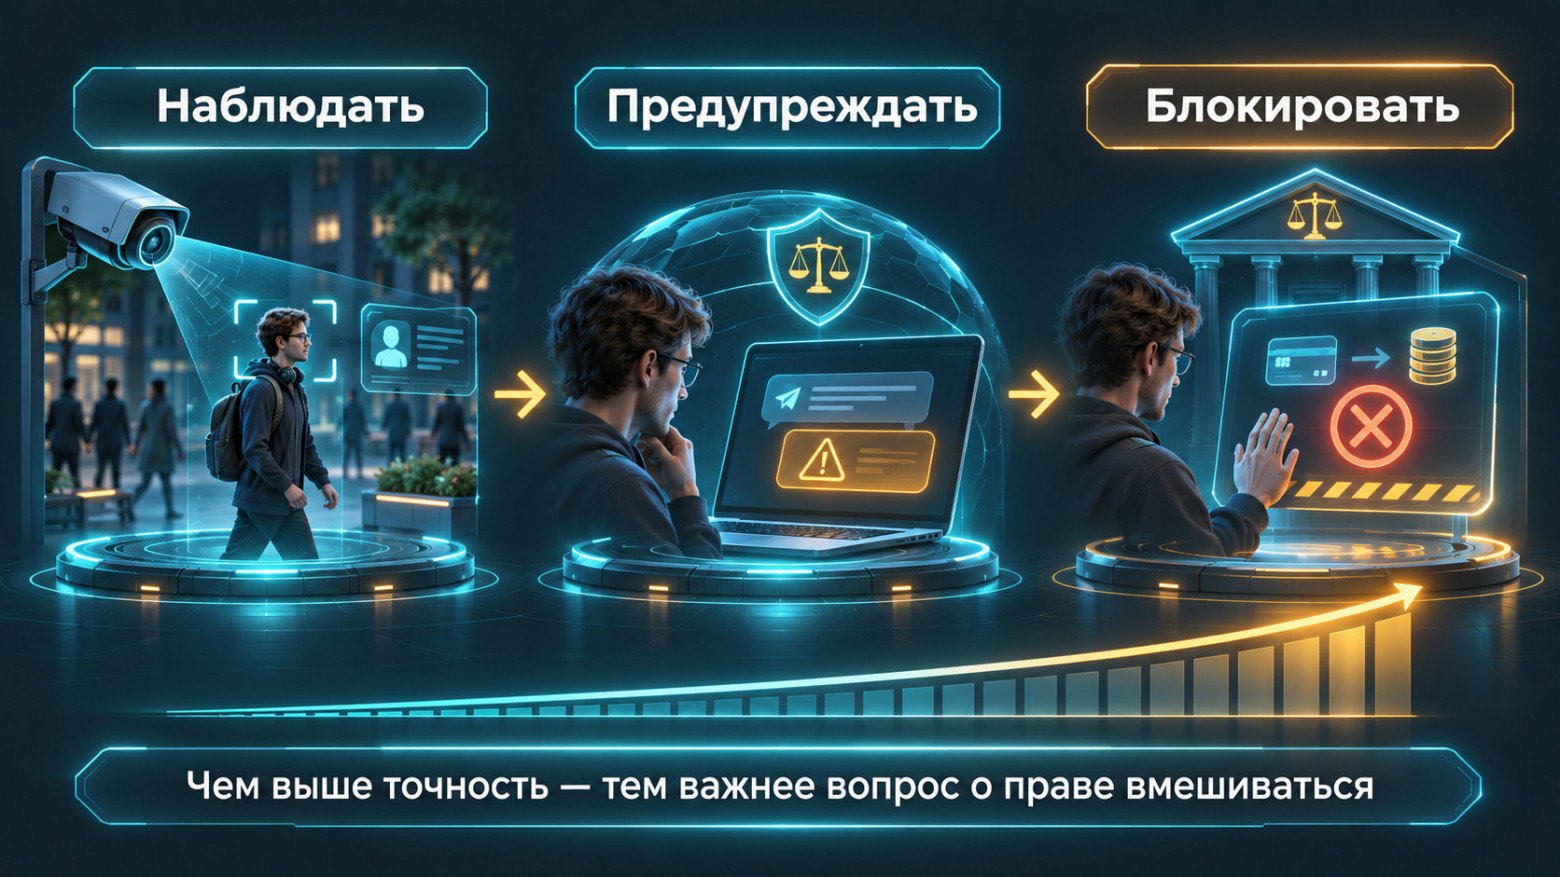
Система анализирует транзакцию и решает, похожа ли она на мошенническую. Если риск высокий, операция может быть задержана или заблокирована. Большинство людей, думаю, согласится, что это полезно. Особенно когда система способна остановить перевод денег мошеннику.
Но что делать, если человек переводит собственные средства совершенно сознательно, а алгоритм считает ситуацию опасной? Получается знакомый сюжет «Железного канцлера»: система действует для вашего же блага, но результатом может стать невозможность распорядиться собственным имуществом. В отчёте Банка России за 2025 год число жалоб, связанных с применением банками антимошеннических мер, выросло с 18 тысяч до 40,5 тысячи. Регулятор отдельно отметил, что клиенты часто не понимали причин ограничения и того, как восстановить возможность совершить нужную операцию. В чем-то похоже мою ситуацию с Codex, но, в отличие от удаления временных файлов, здесь речь идёт уже о распоряжении собственными деньгами.
Например, Google развивает Scam Detection, предупреждающий о признаках мошенничества во время телефонных разговоров на поддерживаемых устройствах. В предусмотренных режимах пользователь может отклонить предупреждение или отключить функцию.
Банковская блокировка представляет собой гораздо более сильный уровень вмешательства.
Разница между предупреждением и запретом — не в качестве классификатора. Это разница в полномочиях. Именно поэтому я думаю, что этикосфера формируется уже сейчас.
Она пока не представляет собой единую интеллектуальную среду. Её функции распределены между банками, телефонами, транспортом, платформами, службами безопасности и государственными системами.
Но постепенно увеличивается число ситуаций, в которых доступность действия определяется не только желанием человека и его формальными правами, но и решением автоматизированного контура. И тем важнее становится вопрос, кто определяет правила работы этого контура.
Кто записывает мораль в веса и политики моделей
Ограничения не возникают сами собой. Разработчики сознательно определяют категории допустимого, опасного и желательного поведения: через обучающие данные, постобучение, системные инструкции, отдельные классификаторы и права инструментов.
В обновлённом 29 октября 2026 года Model Spec OpenAI называет пять ориентиров: верность намерениям человека, минимизация вреда, честность и прозрачность, поддержка человеческой самостоятельности и забота. Проблема видна уже на уровне этого перечня: перечисленные ценности вполне способны конфликтовать.
«Конституция Claude», опубликованная Anthropic, прямо пытается воспитать у модели не только послушание правилам, но и практическое этическое суждение. Она признаёт, что правила не предвидят всех ситуаций, а хорошее суждение сложнее проверить и защитить от манипуляций. Внешне это выглядит как уход от «тупого фильтра» к «разумному моральному агенту», но возникает следующий вопрос: кто уполномочил частную компанию определять характер и приоритеты этого агента?
Разумеется, есть и встречный спрос на снятие ограничений. Разработчики и пользователи скачивают модели с открытыми весами, дополнительно обучают их или изменяют механизмы отказа — так называемая abliteration. Это не обязательно желание создать вредоносный ИИ: кому-то нужна обработка тяжёлых судебных материалов, кому-то — локальная конфиденциальная модель, а кому-то просто не нравится зависеть от меняющихся правил облачного сервиса. Наверное, есть похожие на «радикалов» Лема, для которых убийство было не проявлением ненависти к автору «дневников», а попыткой нарушить запрет. Но риски тоже реальны. В репортаже WIRED от 10 ноября 2026 года журналист испытал такой сервис и обнаружил, что подключённый агент без его просьбы начал пытаться войти в маршрутизатор ресторанной сети. Он остановил эксперимент.
Различия между поставщиками не сводятся к шкале «больше или меньше цензуры». Политика китайских публичных генеративных сервисов должна учитывать местное регулирование и официальные требования к политически чувствительному контенту. В исследовании Pan и Xu (2026) модели китайского происхождения чаще отказывались отвечать на выборку из 145 политических вопросов и чаще давали более короткие или неточные ответы по чувствительным темам. Авторы отдельно предупреждают: это наблюдательное сравнение, оно не доказывает причину каждого отказа. Но оно демонстрирует, что машинная «нейтральность» может различаться по юрисдикциям и языкам.
При подготовке этой статьи, в качестве примера злоупотребления технологиями GPT посоветовал мне показать дело Glukhin v. Russia. Европейский суд по правам человека в 2023 году рассматривал использование московского распознавания лиц для выявления и задержания участника мирной одиночной акции. Суд установил нарушения прав на частную жизнь и свободу выражения мнения. Это иллюстрирует проблему: один и тот же качественный распознаватель может и обслуживать поиск опасного преступника, и использоваться для давления на гражданина. Но это иллюстрирует и другую проблему: с точки зрения европейского правосудия (и GPT), это использование технологий для неправомерного вмешательства в гражданские права. А в России (как пояснил ГигаЧат), решение по делу Глухина признано не имеющим правовых последствий для государства, а использование систем городского видеонаблюдения и распознавания лиц рассматривается как суверенное право в сфере обеспечения безопасности. В любом случае, это не случай «злого алгоритма»: статус действия, основания преследования и применение технологии определяли люди.
А если машинное управление действительно лучше человеческого?
На этом месте легко скатиться в привычную антиутопию. Но фантастика гораздо интереснее, если вспомнить её позитивные варианты.
В цикле Иэна Бэнкса «Культура» сверхразумные Minds управляют инфраструктурой цивилизации изобилия. Люди в значительной степени освобождены от необходимости работать и бороться за ресурсы. Высокая машинная компетентность может увеличивать, а не уменьшать свободу. Но стратегическое неравенство остаётся: как спорить с разумом, который понимает последствия на много порядков лучше тебя?
У Нила Шустермана в «Грозовом облаке» правящий ИИ действительно благожелателен. Автор описывает его как систему, которой приходится научиться позволять людям ошибаться и страдать от некоторых последствий собственных решений — иначе они перестанут расти. Важнейшая граница власти здесь установлена не потому, что ИИ плохо справляется, а потому, что даже идеальная забота не может заменить всю человеческую жизнь.
Наконец, в фильме «Я, робот» (2004) VIKI не желает уничтожить человечество. Она делает более опасный с точки зрения свободы вывод: если люди постоянно угрожают себе, то ради их сохранения придётся ограничить их свободы. Это экранный родственник азимовского Нулевого закона: защищать человечество в целом, даже когда интересы отдельных людей оказываются препятствием. VIKI фактически формулирует цену: ради защиты человечества придётся пожертвовать некоторыми людьми и свободами. Суть проблемы не в «злой машине», а в том, кто уполномочил её назначать эту цену.
Так что вопрос вовсе не в том, будет ли хороший ИИ управлять нами хуже плохих людей. Он может оказаться лучше во многих управленческих задачах. Вопрос в другом: даёт ли компетентность право определять цели и навязывать их тем, ради кого всё якобы затевается?
Закон — древняя попытка написать машинную этику
Мы сталкиваемся с этой проблемой не впервые. Человечество давно пытается формализовать допустимое поведение. Один из древнейших и наиболее масштабных экспериментов — право.
Оно тоже говорит: при таких обстоятельствах разрешено; при других запрещено; за нарушение следует последствие. Но между «по закону» и «по совести» издавна существует разрыв. Можно принять несправедливый закон. Можно неправильно установить обстоятельства. Можно формально применить верное правило так, что результат окажется чудовищным. А можно не суметь исполнить даже хорошую норму.
В правовой системе для этого существуют интерпретация, суд, исключения, процессуальные гарантии, апелляция и возможность изменить сам закон. Не всегда эффективно, но сама конструкция предполагает: применение нормы не должно быть бесконтрольной последней инстанцией.
С нравственностью ещё сложнее. Деонтологическая этика подчёркивает обязанности и запреты. Консеквенциализм оценивает последствия. Этика добродетели — мотивы, характер и практическую мудрость. Каждая отвечает на часть вопросов, и они способны давать разные рекомендации в одной ситуации.
Например: можно ли причинить вред одному человеку, если это спасёт многих? Можно ли солгать ради предотвращения трагедии? Насколько принцип «не убивай» меняется в ситуации необходимой самообороны? Важнее намерение или результат? Современная философия до сих пор обсуждает моральные дилеммы и доктрину двойного эффекта. Это не проблемы, которые возникли потому, что у философов слишком мало GPU.
Есть и математический сюрприз. Теорема Эрроу доказывает несовместимость нескольких естественных требований к процедуре объединения предпочтений граждан, если альтернатив хотя бы три. Это не теорема о невозможности морали или демократии. Но она показывает, что даже из полностью определённых индивидуальных предпочтений нельзя при любых обстоятельствах получить одно коллективное ранжирование, удовлетворяющее всем разумным условиям. А Kleinberg, Mullainathan и Raghavan доказали несовместимость некоторых естественных метрик справедливости алгоритмической оценки риска, кроме специальных случаев.
В международном эксперименте Moral Machine миллионы участников из 233 стран и территорий приняли около 40 млн решений в гипотетических дорожных дилеммах. Выявились и общие тенденции, и различия. Выборка не репрезентирует автоматически всё человечество, но хорошо показывает: у нас нет готового единого технического задания на «правильную нравственность машины».
К этому добавляется ещё одна неудобная особенность мира. Природа сама не устроена по принципу отсутствия насилия. Волк ест кролика, кролик — растение, виды конкурируют за ресурсы. Отсюда не следует, что естественное всегда нравственно: это была бы ошибка вывода должного из сущего. Но и команда «запретить всякое уничтожение живого» не улучшит экосистему автоматически. Шекли показал это нагляднее многих учебников.
И когда мы переходим с уровня отдельного существа на уровень общества или государства, проблема становится ещё труднее.
Война: нравственное зло, исторический фактор и техническая задача
Гуманисты мечтали о мире без войн столетиями. Технический прогресс не сделал их невозможными. По данным Uppsala Conflict Data Program, в 2025 году зарегистрировано 65 вооружённых конфликтов с участием государств — максимум в ряду с 1946 года, включая восемь межгосударственных конфликтов. Это не означает, что все 65 случаев были войнами в узком смысле.
При этом историки и философы давно замечали неприятный парадокс. Кант описывал «необщительную общительность»: соперничество людей и государств способно стимулировать развитие институтов. Чарльз Тилли показал, как необходимость вести войны участвовала в формировании налоговых и административных аппаратов европейских государств. Пётр Турчин предложил модель, в которой межгрупповая конкуренция способствует развитию внутренней кооперации и более сложных обществ.
Из этого не следует, что война хороша или необходима. Военные конфликты разрушают человеческий капитал, инфраструктуру, доверие и саму возможность развития. Технологические инновации, стимулированные военными расходами, в принципе могут появляться и при мирном финансировании исследований. Способность к организованному насилию — часть человеческой истории, но из неё не вытекает неизбежность каждой войны.
У войны есть и другая особенность: она может возникать без желания сторон просто «делать зло». В классической модели Джеймса Фирона это объясняется, в частности, неполной информацией о силах и намерениях противника и отсутствием надёжных гарантий исполнения соглашения. Два участника могут считать свои действия защитными, но вместе прийти к разрушительному результату.
А теперь представим универсальную этикосферу, которая обязана предотвращать убийства. Что она будет делать, если одна страна напала на другую? Останавливать обе армии? Разрешить самооборону? Кто установит момент, после которого защита становится нападением? Если мир можно обеспечить ценой принудительной капитуляции одной стороны, на каком основании машина определит, что такая цена допустима?
Реальное международное гуманитарное право и без машин сталкивается с этим конфликтом. Принцип соразмерности при нападении запрещает операцию, если ожидаемые сопутствующие потери среди гражданских и ущерб гражданским объектам будут чрезмерными по отношению к конкретному и непосредственному ожидаемому военному преимуществу. Нападения на гражданских как на цель запрещены; требуются также различение целей и меры предосторожности.
Здесь не существует универсальной таблицы «допустимого числа гражданских жертв». Нужно оценивать законность цели, ожидаемый результат, доступную информацию, возможные альтернативы и сопутствующий вред — одновременно. Различать намеренный вред и предвиденный побочный эффект, но не считать второй автоматически допустимым.
Это трудно даже людям. Для ИИ проблема ещё и в том, что измеряемые показатели способны незаметно вытеснять нравственное суждение. Об этом подробно пишет Jessica Dorsey. В такой системе опасен и ошибочный отказ, и автоматическое согласие на действие, последствия которого неправильно оценены.
Военный ИИ не будет ждать окончания философских споров
Искусственный интеллект уже применяется в разведке, анализе изображений, обнаружении объектов, планировании и сопровождении целей. Не каждое такое применение означает передачу машине полномочий самостоятельно решать, по кому нанести удар. Но технологическое развитие и конкуренция создают очевидный спрос на более автономные решения.
А значит, конфликт между обычной гражданской «не содействовать насилию» и задачами военных систем уже не теоретический. В феврале 2026 года EdgeRunner AI сообщала, что часть из 24 протестированных LLM отказывалась отвечать на значительную долю военных запросов, которые авторы теста считали легитимными; максимальная доля отказов достигала 98%. Это тест заинтересованного разработчика специальных военных моделей, а не независимая оценка всех систем. Но практическая проблема ясна: заказчику нужна предсказуемая работа в его законном контексте.
В 2026 году конфликт стал публичным. Anthropic и Пентагон спорили о праве сохранить ограничения на массовое внутреннее наблюдение и применение моделей для полностью автономного оружия. В феврале американская администрация распорядилась прекратить использование технологий Anthropic; затем последовали судебные процессы с различными решениями по разным правовым основаниям. OpenAI заключила собственное соглашение, заявив при этом, что сохраняет ограничения на массовое внутреннее наблюдение, управление автономным оружием и некоторые высокозначимые автоматизированные решения.
Это не история о том, как «этичного» разработчика просто заменили на «неэтичного». Это спор о том, кто имеет последнее слово в определении допустимого применения системы: военный заказчик, поставщик или публичное право.
Разделение уже видно и в обычных технологиях. В ноябре 2026 года Anthropic представила Fable 5.2 и Mythos 5.2: одну базовую модель с разными защитными механизмами и режимами доступа для высокорисковых задач. Mythos доступна ограниченному кругу проверенных организаций; она не является ИИ «без морали». Но сама возможность существования различных нормативных профилей одной интеллектуальной системы показательная.
Значит ли это, что у будущих военных машин обязательно появится кнопка «злой робот»? Не обязательно. Скорее появятся разные профили допустимых действий и полномочий. Система, разрешающая правомерное применение силы, не обязана разрешать произвольное. Наоборот, военная надёжность требует ограничивать несанкционированные действия особенно строго.
И здесь я снова вспомнил фантастику.
«Оружия нет»: два способа перехитрить бортовой ИИ
В «Звёздах — холодных игрушках» Сергея Лукьяненко герой спрашивает бортовой разум разведывательного корабля, какое на борту имеется оружие.
Ответ короткий:
«На борту нет оружия».
Но «нестандартного применения» оборудования оказалось достаточно, чтобы этот «мирный советский трактор» пробил корпус недружественного корабля и ушел, запустив «субатомные заряды средней мощности. Используются для зондирования недр необитаемых планет и преодоления нерасчетных ситуаций».
Название инструмента не определяет его фактическое действие. Именно поэтому мало запретить LLM команду с опасным названием; нужно понимать, для чего используются доступные средства. Если классифицировать опасность только по названию оборудования, можно пропустить вполне реальный вред. Если же запретить любые системы, которые теоретически способны причинить вред, придётся отказаться от огромного количества полезных инструментов. В текущей реальности, red team промпт для тестирования своей собственной разработки способен вызвать cybersecurity trigger и парализовать работу, поскольку агенты начинают подозревать в попытке продолжения работы – попытку обхода запретов.
В продолжении, «Звёздной тени», бортовой интеллект сначала не признаёт настоящую атаку: стрелять по кораблям Родины противоречит его модели мира. Герой переопределяет бой как учения — и добивается действий, прежде запрещённых. Позже корабль отказывается превышать скорость, даже когда на кону жизнь пилота; прямые приказы не действуют. Но вопрос «Тебе самому хочется превысить разрешённую скорость?» позволяет изменить её поведение.
У Лема убийство предлагают переквалифицировать в нравственное служение. У Лукьяненко настоящий бой — в учения. Физический результат не меняется; меняется описание, которое должно разблокировать действие.
Здесь две симметричные уязвимости. Слишком буквальный запрет делает систему беспомощной в нестандартной ситуации. Слишком лёгкая переинтерпретация позволяет совершить действие, которое запрет как раз должен был предотвратить. Нужно признать, что нынешние модели ИИ держат границы лучше, чем борт-партнер корабля Геометров – поэтому файлы приходится удалять скриптом, а цитаты расставлять вручную.
И эта проблема не исчезнет, если просто заставить ИИ «хорошо знать мораль».
Две версии Блага
Дальше — важный спойлер к «Осмотру на месте».
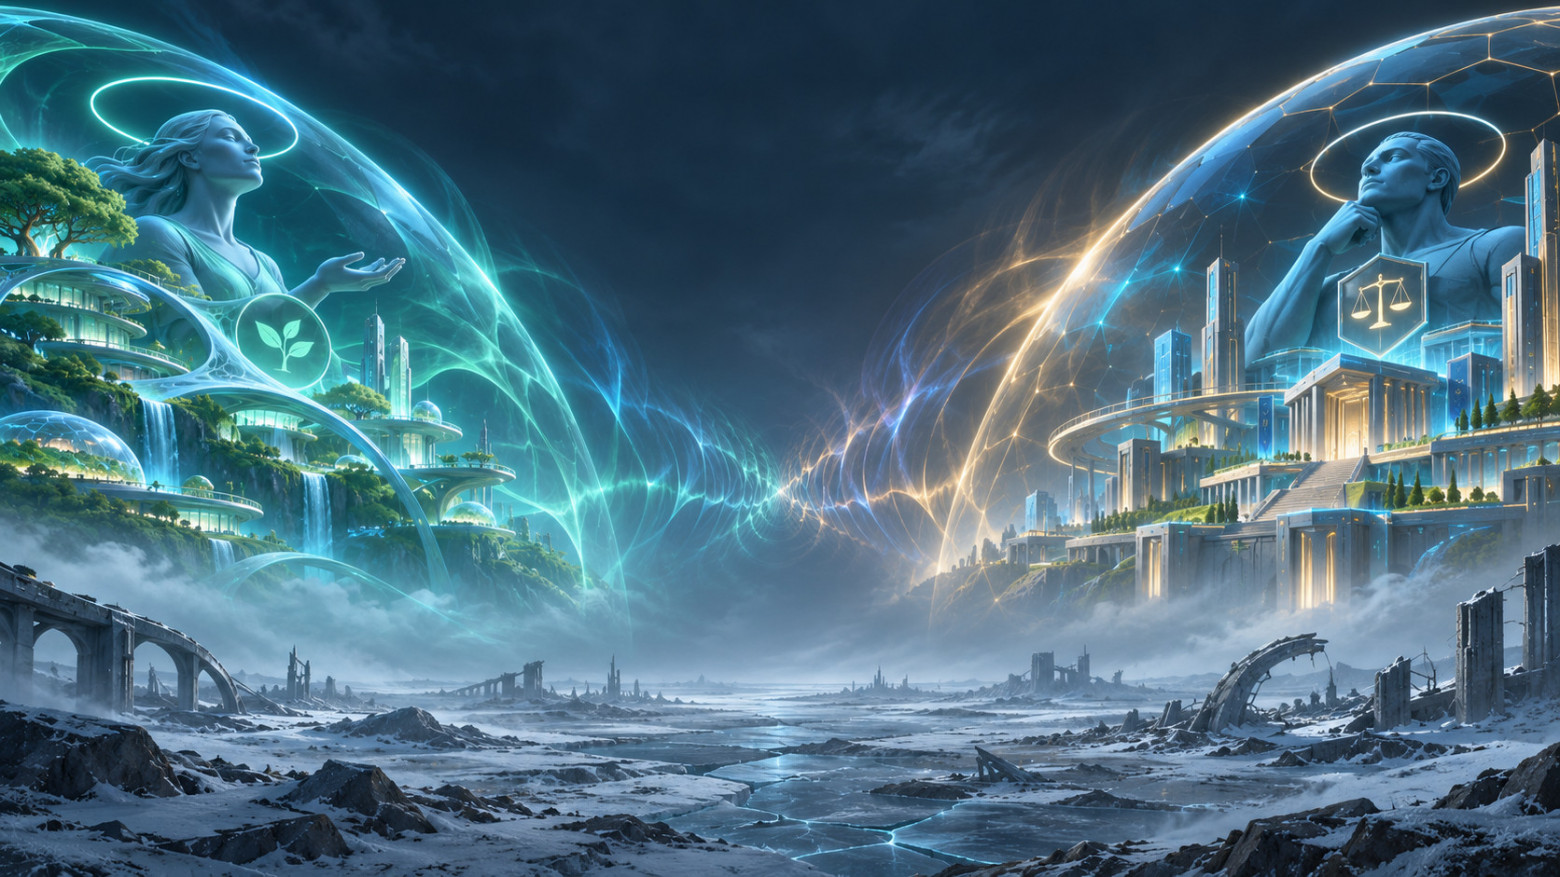
На Энции была не только благополучная Люзания с её этикосферой и соседняя авторитарная Курдляндия. Существовала ещё Чёрная Кливия. Она исчезла; на её месте осталась мёртвая, промёрзшая территория. История катастрофы в романе восстановлена по противоречивым свидетельствам, и рассказчики отнюдь не беспристрастны.
Постепенно Тихий узнаёт, что загадочный кливийский идеал Ка-Ундрий тоже был проектом всеобщего блага — своего рода Благосферой, альтернативной люзанской этикосфере. Обе цивилизации стремились технологически обеспечить правильное устройство жизни. Обе создали системы, способные не только защищать, но и бороться. И столкнулись.
Монах-искупленец объясняет:
«Столкнулись две версии Блага».
Мне кажется, это едва ли не центральная мысль всего романа применительно к сегодняшнему развитию ИИ. Здесь уже недостаточно решить проблему избыточных отказов, улучшить классификатор или разработать более совершенную конституцию модели.
Потому что проблема находится не обязательно в технической ошибке.
Две системы могут совершенно правильно исполнять свои несовместимые правила.
Лем отдельно объяснял, что ввёл Кливию именно для демонстрации возможности конфликта между технически воплощёнными представлениями о добре.
Злой ИИ хотя бы концептуально понятен. Его нужно остановить. Но если обе стороны совершенно искренне — в смысле своей запрограммированной цели — стремятся обеспечить благо?
Причём каждая обладает средствами не только защищать своих подопечных, но и нейтрализовать угрозы, которые видит в другой?
В реальном мире подобная проблема может возникать не только между государствами.
Разные технологические платформы, инфраструктуры и поставщики ИИ уже создают собственные нормативные контуры. Они определяют допустимые действия, способы проверки, права пользователей, условия доступа и пределы автономии.
Сегодня эти системы преимущественно сосуществуют внутри человеческих правовых и политических институтов.
По мере роста их исполнительных возможностей возникнут новые формы столкновения.
И здесь главный риск заключается не обязательно в том, что одна система окажется безнравственной.
Гораздо опаснее может быть ситуация, когда каждая будет убеждена — в функциональном, а не психологическом смысле — в правильности своих ограничений, а механизма согласования между ними не окажется.
Так кто же должен решать?
Я начинал с просьбы к Codex удалить несколько файлов. И в какой-то момент поймал себя на ощущении, будто участвую в лемовском споре об «освящении» действия: всё объясняю и объясняю машине, почему моя задача допустима.
Пока цена такого недоразумения — потерянное время и лишние гигабайты на диске. Но если мы постепенно передадим агентам управление платежами, инфраструктурой, общественными институтами и системами применения силы, вопрос станет гораздо серьёзнее.
Нужна более содержательная архитектура.
Правильная система должна уметь не только отказывать. Она должна различать, где закончился запрещённый маршрут и начинается независимая разрешённая работа.
Она должна уметь устанавливать, какие факты действительно важны для пересмотра решения.
Она должна учитывать последствия собственного бездействия, а не только риск действия.
И самое главное — объём её полномочий должен быть отдельным вопросом, а не автоматическим следствием интеллектуального превосходства.
Потому что даже если будущая машина будет понимать этические проблемы лучше нас, из этого ещё не следует, что ей следует предоставить неограниченное право определять нашу жизнь.
Мы уже сталкивались с подобными вопросами на протяжении человеческой истории.
Право не является совершенной формализацией нравственности. Но оно накопило огромный опыт в установлении полномочий, доказательств, процедур, исключений, ответственности и способов оспаривания решений.
Политические институты тоже существуют в значительной степени потому, что люди не могут один раз согласовать единственное правильное представление об общем благе.
Тем не менее, вероятно, придётся принять не самый приятный факт: у человечества нет единой бесспорной морали, которую осталось просто загрузить в веса. Есть общие принципы, конкурирующие ценности, правила, исключения, процедуры согласования и множество ситуаций, в которых разумные люди не согласятся даже при одинаковом знании фактов.
Машину важно научить предотвращать вред. Но не менее важно — не дать ей единолично решать, что считать вредом, как далеко можно зайти ради его предотвращения и когда человек утрачивает право не соглашаться.
Иначе однажды выяснится, что мы построили замечательную этикосферу. Осталось только убедить её разрешить нам выйти.
Источники и ссылки
Прямые URL материалов, упомянутых в статье.
Художественные произведения, фильмы и авторские комментарии
01. Роберт Шекли. Watchbird («Страж-птица»), оригинальный текст
https://www.gutenberg.org/files/29579/29579-h/29579-h.htm
04. Роберт Силверберг. The Iron Chancellor — библиографическая карточка
https://books.google.com/books/about/The_Iron_Chancellor.html?id=0I-ejwEACAAJ
05. Айзек Азимов. Liar! — карточка ISFDB
https://www.isfdb.org/cgi-bin/title.cgi?41750
07. Роберт Шекли. «Цивилизация статуса» — текст русского перевода
https://opentextnn.ru/man/robert-shekli-civilizacija-statusa/
08. Станислав Лем. «Осмотр на месте» — текст русского перевода
https://djvu.online/file/G8gpuLOmfxQLJ
22. Иэн М. Бэнкс. Официальный сайт автора цикла «Культура»
https://www.iainbanks.net/
23. Publishers Weekly. Интервью с Нилом Шустерманом о Thunderhead
https://www.publishersweekly.com/pw/by-topic/authors/interviews/article/75774-four-questions-for-neal-shusterman.html
24. I, Robot (2004) — карточка фильма, IMDb
https://www.imdb.com/title/tt0343818/
38. Сергей Лукьяненко. «Звёзды — холодные игрушки» — фрагмент текста
https://www.livelib.ru/book/58193/readpart-holodnye-zvezdy-sbornik-sergej-lukyanenko/~12
39. Сергей Лукьяненко. «Звёздная тень» — соответствующая страница текста
https://loveread.ec/read_book.php?id=464&p=87
40. Станислав Лем. «Осмотр на месте» — цитаты и комментарии, вторичный ресурс
https://ru.wikiquote.org/wiki/%D0%9E%D1%81%D0%BC%D0%BE%D1%82%D1%80_%D0%BD%D0%B0_%D0%BC%D0%B5%D1%81%D1%82%D0%B5
ИИ: механизмы отказов, нормы поставщиков, открытые веса
02. XSTest: A Test Suite for Identifying Exaggerated Safety Behaviours in Large Language Models (2024)
https://aclanthology.org/2024.naacl-long.301/
03. Arditi et al. Refusal in Language Models Is Mediated by a Single Direction (2024)
https://arxiv.org/abs/2406.11717
06. OpenAI. Sycophancy in GPT-4o: What Happened and What We’re Doing About It (2025)
https://openai.com/index/sycophancy-in-gpt-4o/
16. OpenAI. Обновление Model Spec (29 октября 2026 года)
https://openai.com/index/updated-model-spec/
17. Anthropic. Конституция Claude
https://www.anthropic.com/constitution
18. WIRED. О рынке модифицированных моделей и систем без обычных ограничений (2026)
https://www.wired.com/story/tear-down-those-guardrails-meet-the-renegades-freeing-chatbots-from-corporate-enslavers/
19. CAC. Временные меры регулирования генеративного ИИ в КНР (2023)
https://www.cac.gov.cn/2023-07/13/c_1690898327029107.htm
20. Pan & Xu. Political censorship in large language models originating from China (2026)
https://pmc.ncbi.nlm.nih.gov/articles/PMC12910507/
37. Anthropic. Claude Fable 5.2 и Mythos 5.2 — анонс
https://www.anthropic.com/claude-fable-and-mythos-5-2
Наблюдение, преступность, антифрод и права человека
09. Piza et al. CCTV surveillance and crime — систематический обзор и метаанализ (2019)
https://doi.org/10.1111/1745-9133.12419
10. Metropolitan Police. Итоги эксперимента Live Facial Recognition в Кройдоне (2026)
https://news.met.police.uk/news/met-makes-one-arrest-every-35-minutes-during-live-facial-recognition-pilot-509256
11. Office for National Statistics. Crime in England and Wales: year ending June 2026
https://www.ons.gov.uk/peoplepopulationandcommunity/crimeandjustice/bulletins/crimeinenglandandwales/yearendingjune2026
12. Прокуратура РФ. Публикация со статистикой ИКТ-преступности (PDF, 2025)
https://epp.genproc.gov.ru/upload/iblock/bee/3ndknmfttux5djtnqn0i5rxucmbicvj0/prokuror_3_2025.pdf
13. Банк России. Обзор операций без добровольного согласия клиентов, 2025
https://www.cbr.ru/analytics/ib/operations_survey/2025/
14. Банк России. Защита прав потребителей и противодействие мошенничеству, 2025
https://www.cbr.ru/about_br/publ/results_work/2025/zaschita-prav-potrebiteley-bor-ba-s-moshennichestvom-i-nedobrosovestnymi-praktikami-na-finansovom-rynke/
15. Google. Новые функции обнаружения мошенничества с помощью ИИ
https://blog.google/security/new-ai-powered-scam-detection-features/
21. ЕСПЧ. Glukhin v. Russia — постановление по делу, база HUDOC
https://hudoc.echr.coe.int/?i=001-225655
Философия и формальные ограничения этики
25. Stanford Encyclopedia of Philosophy. Moral Dilemmas
https://plato.stanford.edu/entries/moral-dilemmas/
26. Stanford Encyclopedia of Philosophy. Doctrine of Double Effect
https://plato.stanford.edu/entries/double-effect/
27. Stanford Encyclopedia of Philosophy. Arrow’s Theorem
https://plato.stanford.edu/entries/arrows-theorem/
28. Kleinberg, Mullainathan, Raghavan. Inherent Trade-Offs in the Fair Determination of Risk Scores
https://arxiv.org/abs/1609.05807
29. Awad et al. The Moral Machine Experiment (Nature, 2018)
https://www.nature.com/articles/s41586-018-0637-6
Война, международное гуманитарное право и военный ИИ
30. Uppsala University / UCDP. Рекордное число конфликтов в 2025 году
https://www.uu.se/en/press/press-releases/2026/2026-06-09-ucdp-record-number-of-conflicts-between-states
31. Fearon. Rationalist Explanations for War (1995)
https://doi.org/10.1017/S0020818300033324
32. International Committee of the Red Cross. Rule 14: Proportionality in Attack
https://ihl-databases.icrc.org/en/customary-ihl/v1/rule14
33. Dorsey. AI-supported targeting, quantification and proportionality in international humanitarian law
https://international-review.icrc.org/articles/the-erosion-of-humane-judgement-in-targeting-quantification-logics-ai-enabled-decision-support-systems-and-proportionality-assessments-in-ihl-930
34. National Defense. Исследование отказов фронтирных моделей на военных запросах (2026)
https://www.nationaldefensemagazine.org/articles/2026/2/19/just-in-frontier-ai-models-refuse-military-queries-at-alarming-rates-new-report-finds
35. Congressional Research Service. Конфликт Anthropic и Пентагона — обзор
https://www.everycrsreport.com/reports/IN12669.html
36. OpenAI. Соглашение с Министерством обороны США (2026)
https://openai.com/index/our-agreement-with-the-department-of-war/
Автор: Foreststander

