


Вендоры добавляют в агентные харнессы всё больше режимов работы. Одну и ту же правку можно поручить одному агенту с самопроверкой или собрать команду с ведущим и сабагентами. Сжечь ещё миллион токенов на черновики и ревью легко. Сколько дополнительных патчей после этого пройдёт тесты? OpenAI · Claude
Советы встречаются разные. OpenAI предлагает сначала выжать максимум из одного агента. Команда Veai описывает задачи, где ей пригодилось разделение работы между сабагентами. Когда задача помещалась в контекст одного агента, он тратил меньше токенов на сопоставимый результат. Руководство OpenAI · Замеры Veai
Я решил записать выбор числа агентов как задачу оптимизации. Для каждого состава нужно оценить шанс получить патч, который пройдёт тесты, и стоимость всех попыток. На одних и тех же задачах я сравнил команды от одного до 64 агентов. Хотелось получить правило, по которому можно выбрать состав для своего бэклога с учётом бюджета и требований к приёмке.
Для локальной правки с понятной приёмкой я бы запустил одного агента и проверил первый черновик целевыми тестами. Среди проверенных размеров на 14 правках Click и Packaging самым дешёвым в расчёте на зачёт был один агент с самопроверкой.
Что я дал агентам
Взял 14 правок в двух Python-библиотеках. В Click восемь задач, в Packaging шесть. Модели получали описание и нужные исходники до исправления. Я заранее указал область, в которой нужно менять код. Проверку я мог запустить на старом коде и на эталонном патче. Так было видно, что тест действительно ловит исходную ошибку. Для более широкого сравнения добавил 30 задач AtCoder с тремя уровнями сложности. Полный цикл работы над фичей, включая уточнение требований, ревью человеком и выпуск, в эти прогоны не входил.
За одни и те же задачи брались DeepSeek V4.1 Flash и Qwen3.8 Flash. Я перебрал восемь размеров команды, от одного агента до 64. Когда агент работал один, он сначала писал решение, потом проверял его и мог исправить. В команде каждый писал свой вариант и, если был сабагентом, проверял черновик соседа. Ведущий получал все рецензии и до трёх полных черновиков. Итоговый ответ был один. В команде из восьми семь сабагентов и один ведущий.
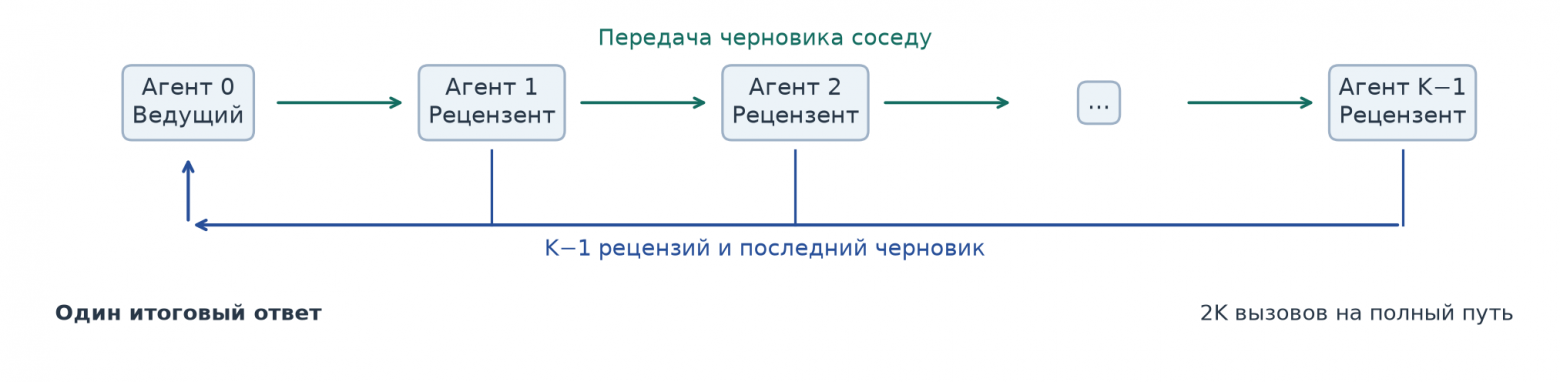
Рис. 1. Каждый сабагент читает черновик предыдущего агента. Ведущий сохраняет свой черновик, получает последний черновик и все рецензии. Если в команде есть черновики, прошедшие открытый фильтр, ему также передают первый из них. При 64 агентах рецензий 63.
В сетку вошли 1, 2, 4, 6, 8, 16, 32 и 64 агента. За качество я брал долю итоговых ответов, прошедших целевые тесты. В цену входили все вызовы, даже если готовое решение так и не получилось.
В корпусе 30 алгоритмических задач AtCoder из LiveCodeBench [7] и 14 локализованных исправлений Python. Сложность берём из поля Обе модели, DeepSeek V4.1 Flash и Qwen3.8 Flash, решают одни и те же задачи [8], [9]. Запросы выполнены 18 ноября 2026 года через закреплённого провайдера Alibaba. Температура равна 0,8, режим рассуждений отключён. Порядок кандидатов и границы задач зафиксированы до оценки итогов. В сравнении остаются все отобранные задачи. Множество размеров Черновики взяты из предшествующего прогона. Рецензии с тем же соседом служат общим префиксом для нескольких размеров. Каждый размер получает отдельный итог ведущего. Цена конкретного запуска включает В парном контроле ведущий, число вызовов, черновики, порядок и пределы одинаковы. Рецензент видит только собственный черновик. Поэтому варианты различаются доступом к соседнему черновику и объёмом входа. Контроль заранее выбран на 18 алгоритмах и шести правках для DeepSeek. Основное парное сравнение провели для четырёх агентов. Остальные размеры приведены справочно. Два дополнительных варианта для сравнения — один исходный черновик и первый черновик из того же набора, прошедший открытые проверки.
На алгоритмах допуск требует прохождения открытых примеров и исполнения на четырёх дополнительных входах. На этих входах фильтр проверяет завершение программы, её выходы сохраняются без сверки с эталоном. На выполнение одного входа отводятся 2,5 секунды. Для правок проверяем применимость патча и дымовые тесты. У них и у целевых тестов по 15 секунд внутри контейнера. Итоговый зачёт определяют целевые тесты. Закрытые тесты и их вердикты остаются у оценщика. Считаем фактические списания и цену без скидки на кэш [10]. Для вызова Для одной пары размеров обозначим число приобретённых зачётов через Корпус, протокол и оценка
difficulty LiveCodeBench. По каждому из трёх уровней отобраны пять калибровочных и пять проверочных задач. Соревнования между частями не пересекаются. Правки включают восемь задач Click и шесть Packaging. Модель получает описание и исходники в известной области изменения. Целевые тесты воспроизвели ошибки на исходном коде и прошли после эталонных исправлений.Обмен сообщениями
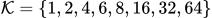 . Агент 0 одновременно автор черновика и ведущий. При
 агент
 , где
 , видит свой черновик и черновик агента
 . В рецензии он указывает одно условие, возможный дефект и правку. Ведущий получает все
 рецензий и последний черновик. Дополнительно получает первый черновик, прошедший открытую проверку, если его ещё нет в контексте. Затем продолжает свой контекст с собственным черновиком и выпускает один итог. При
 он перепроверяет свой черновик. Схема приведена на рис. 1.
 черновиков,
 рецензий и один вызов ведущего, всего
 вызовов. В журнале сохранены фактические входы, идентификаторы сообщений, текст, счётчики токенов и причина завершения. По журналам сверили, какие сообщения вошли в запрос ведущего. Влияние отдельных рецензий на итог этим замером не оценивали.
Контроль и оценка
 при числе входных и выходных токенов
 и тарифах
 в USD за токен цена без скидки равна
 . Цена
 — сумма по всем вызовам сценария для задачи
 и размера
 . Средняя цена
 включает и неудачные попытки. Для серии рецензий первый запрос завершается до отправки остальных, чтобы прогреть общий префикс. Измеряем долю прочитанных из кэша входных токенов. По длительности запросов восстановили задержку API для каждой задачи. Сложили время генерации черновиков, рецензий и итогового ответа. На первых двух этапах к длительности первого запроса для прогрева кэша прибавили длительность самого длинного из остальных параллельных запросов. Для одного агента есть черновик и самопроверка. На графике медиана по всем задачам группы. Время от запуска до приёмки потребовало бы непрерывного прогона с очередями и локальными проверками.
 , потерянных через
 . Тогда
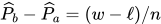 . Для сравнения полезностей усредняем по тем же задачам
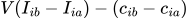 . На полной панели AtCoder 15 соревнований, из них 7 в калибровке и 8 в проверке. Для приближённых 95%-х интервалов 20 000 раз выбираем соревнования с возвращением, сохраняя обе оценки каждой задачи, и берём 2,5-й и 97,5-й процентили. Интервалы описательные и рассчитаны по отдельным контрастам. При редких расхождениях бутстрэп воспроизводит только увиденные переходы, а выборка остаётся малой [11]. Для Click и Packaging показываем фактические парные исходы раздельно.
На правках восемь агентов помогли одной модели
На правке Click #3902 один агент Qwen так и не получил зачёт. Восемь справились. Именно эта задача прибавила Qwen третий зачёт на 14 правках. У DeepSeek при том же переходе пропал зачёт на Packaging #1531, и с двух успешных патчей модель опустилась до одного. Оба отклонённых патча проходили базовые тесты. Дефекты поймали проверки на конкретное исправление.
У Qwen дополнительный зачёт появился при заметной доплате. В среднем попытка с восемью агентами стоила на 679% дороже, чем с одним агентом с самопроверкой, если считать API по тарифу без кэша.
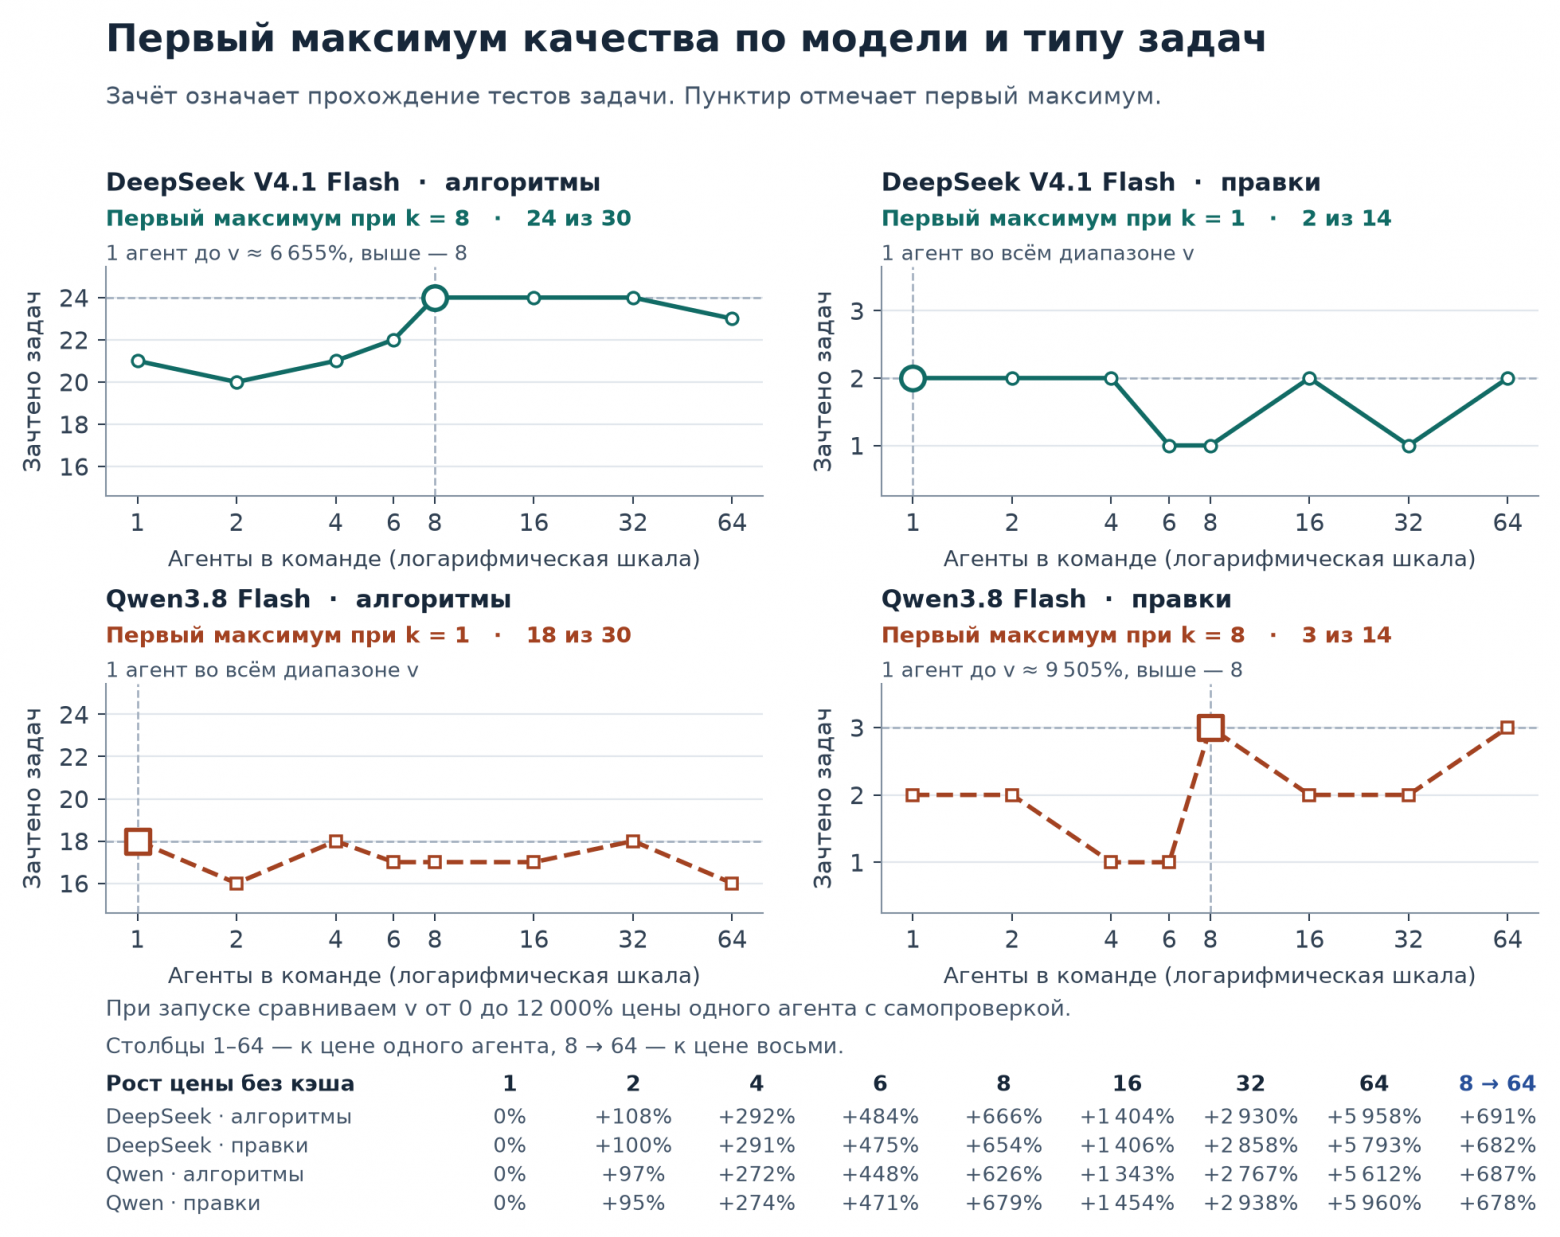
Рис. 2. Правая половина показывает правки библиотек. Обведена самая маленькая команда с максимальным числом зачётов в каждой группе. Проценты расходов справа для перехода 8 → 64 отсчитаны от цены восьми агентов, остальные от цены одного агента.
На AtCoder рост сначала был заметен. DeepSeek решила 21 задачу из 30 с одним агентом и 24 с восемью. На 16 и 32 счёт остался 24. В каждом из этих переходов прибавилась одна решённая задача и пропала другая. При 64 осталось 23. Qwen до максимальных для неё 18 из 30 дошла уже с одним агентом.
При переходе с 8 до 64 обе модели потеряли по одному зачёту, а цена API за попытку без кэша выросла на 691% у DeepSeek и 687% у Qwen. Оба 95%-х интервала разницы в доле зачётов включают ноль. По этой выборке трудно отделить спад от разброса.
Для команды из 64 во всех четырёх группах нашёлся меньший состав, который решал столько же задач или больше и стоил дешевле. Какой именно размер давал максимум первым, зависело от модели и набора задач. Например, восемь агентов — первая точка с максимумом у DeepSeek на AtCoder и у Qwen на правках.
Таблица всех размеров, разбивка по сложности и расходы
У DeepSeek на переходах 8 → 16 и 16 → 32 кластерные интервалы разности долей составили от  до
 и от
 до
 п. п. соответственно.
На алгоритмах Qwen Flash повторила результат одного агента при 4 и 32 участниках, при 64 зачтено 16. Первый максимум на правках DeepSeek тоже получен одним агентом (2 из 14). У Qwen на правках пик из трёх зачётов впервые получен при восьми агентах и повторился при 64 после снижения на 16 и 32 (рис. 2).
Для перехода  разность долей составила
 п. п. у обеих моделей с кластерными интервалами от
 до 0 и от
 до 0 п. п. соответственно.
У обеих моделей все 10 простых задач получили зачёт на всей сетке. На 10 сложных DeepSeek выросла с четырёх при одном агенте до шести при восьми, сохранив шесть до 64. Qwen Flash решила две сложные задачи при одном агенте. При 8, 16, 32 и 64 итог не получил зачёта ни на одной из десяти. На 14 правках между 8 и 64 число зачётов DeepSeek выросло с одного до двух, у Qwen осталось три. При 64 участниках полный корпус дал 25/44 у DeepSeek и 19/44 у Qwen.
Число итоговых зачётов на одних и тех же задачах
|
Модель и задачи |
Всего |
1 |
2 |
4 |
6 |
8 |
16 |
32 |
64 |
|---|---|---|---|---|---|---|---|---|---|
|
DeepSeek · Алгоритмы |
30 |
21 |
20 |
21 |
22 |
24 |
24 |
24 |
23 |
|
DeepSeek · Правки |
14 |
2 |
2 |
2 |
1 |
1 |
2 |
1 |
2 |
|
Qwen Flash · Алгоритмы |
30 |
18 |
16 |
18 |
17 |
17 |
17 |
18 |
16 |
|
Qwen Flash · Правки |
14 |
2 |
2 |
1 |
1 |
3 |
2 |
2 |
3 |
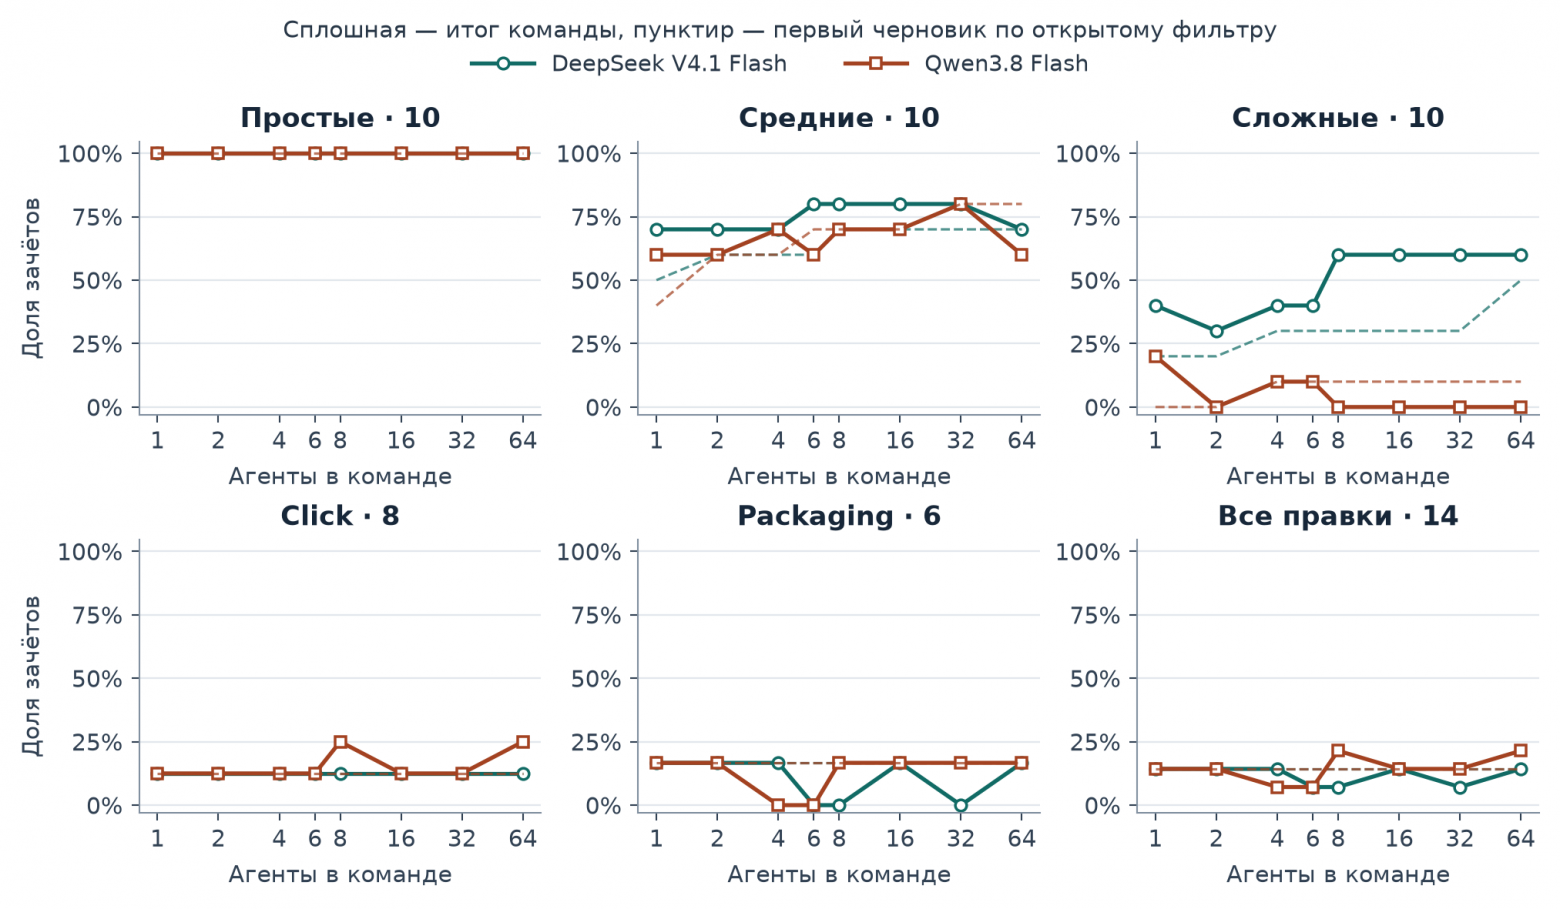
Рис. 6. Доля зачётов по сложности алгоритмов и по репозиториям. Пунктир показывает первый черновик, допущенный открытым фильтром. Число задач указано в заголовке панели.
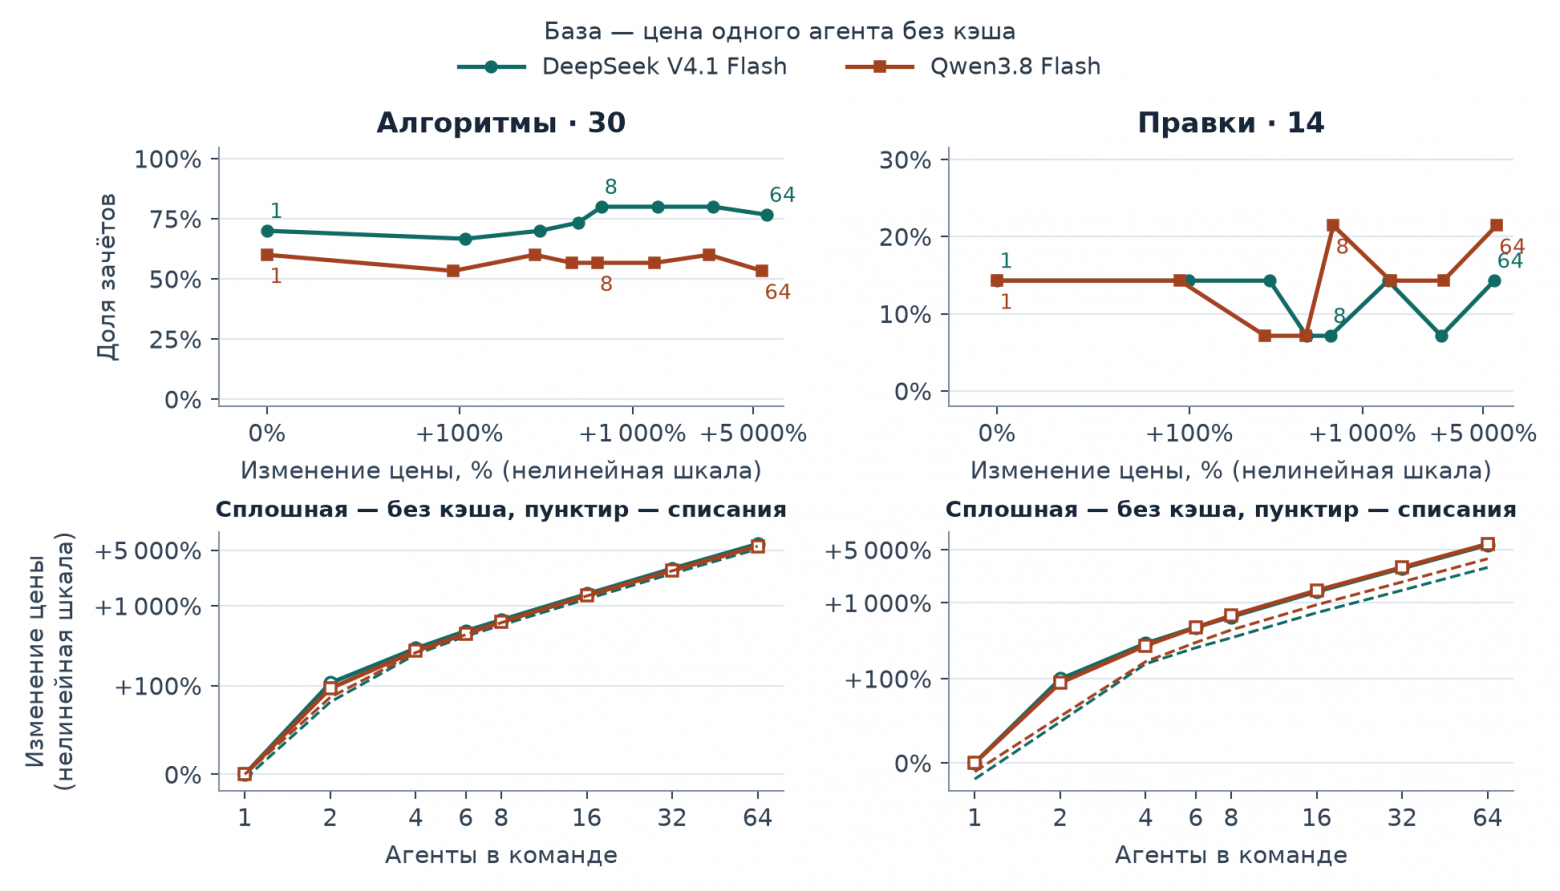
Рис. 7. Сверху качество и средняя цена попытки без кэша. Подписано число агентов в нескольких измеренных точках. Снизу сравнение цены без кэша с фактическими списаниями. База для каждой модели и группы задач — цена одного агента с самопроверкой без скидки на кэш.
Сколько стоит патч, который прошёл тесты
На 14 правках Qwen команда из шести агентов получила один зачёт, команда из восьми — три. Запуск восьми в среднем стоил на 36% дороже.
Провалы тоже входят в расход. По тарифу без кэша сумма всех попыток, делённая на число зачётов, у восьми оказалась на 55% дешевле, чем у шести. А самые дешёвые зачёты из этих трёх размеров дала одиночная самопроверка.
На равный бюджет можно смотреть с другой стороны. Делим число зачётов на расходы по всем попыткам, затем сравниваем с одиночным агентом той же модели на тех же задачах. На правках у Qwen семь сабагентов подняли результат с двух до трёх зачётов из 14. На тот же бюджет эта схема даёт около 19% зачётов одиночного агента по измеренной стоимости и доле успеха.
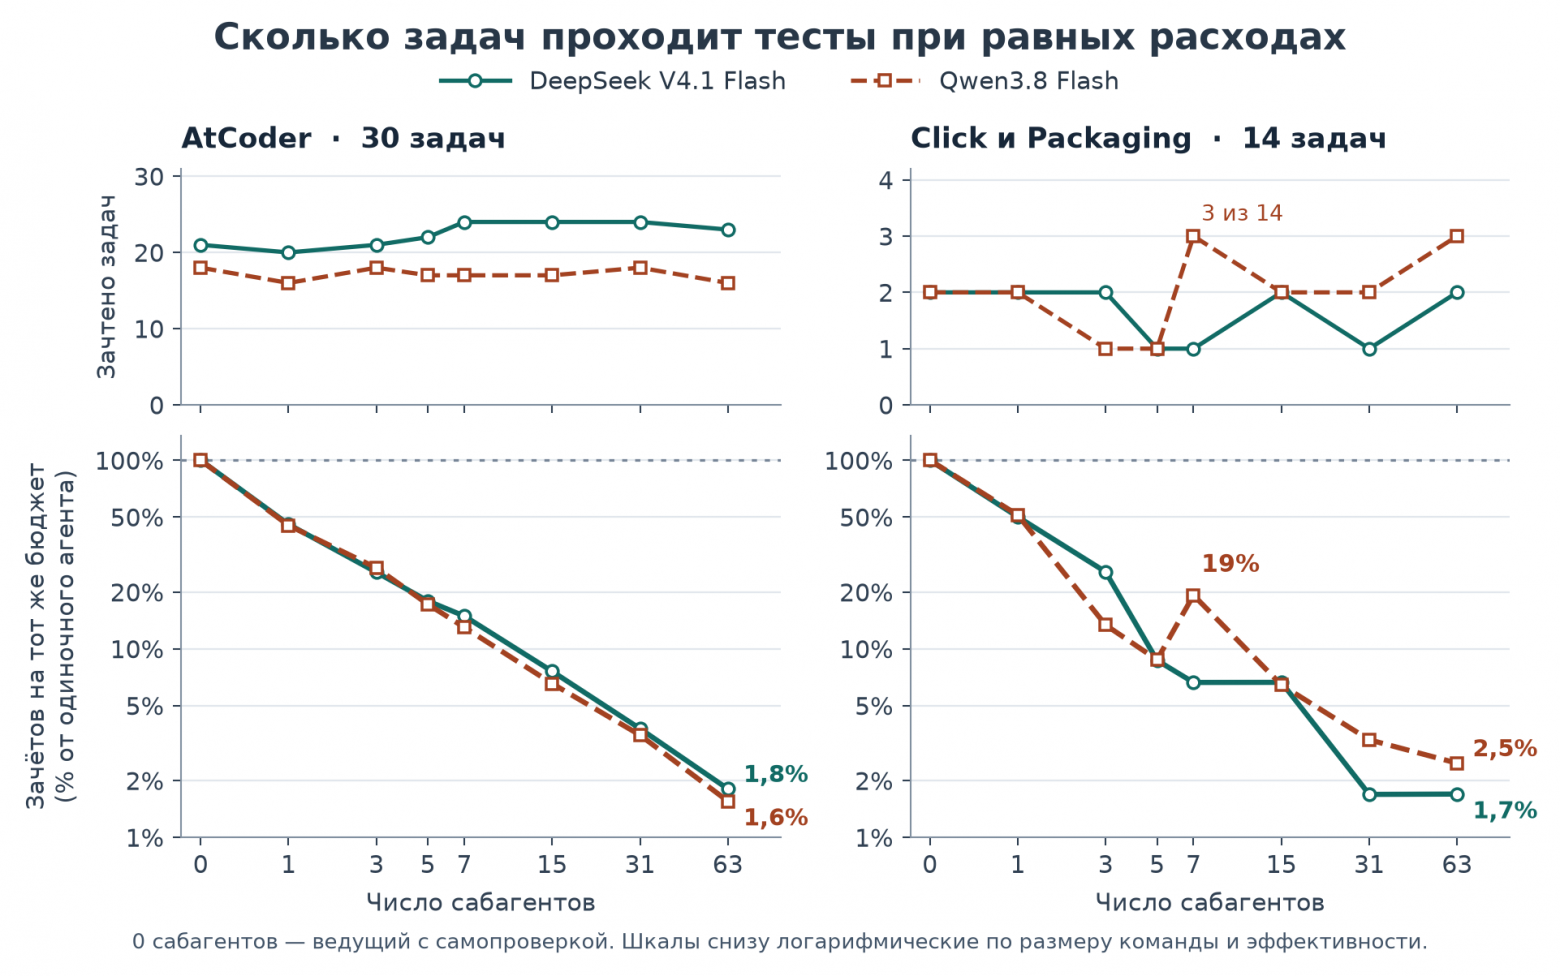
Рис. 3. Вверху число зачётов на том же наборе задач. У наборов разные вертикальные шкалы. Внизу зачёты на единицу расходов по тарифу без кэша, включая неудачные попытки. 100% — уровень ведущего с самопроверкой той же модели на том же наборе.
Формула (7). Цена зачёта и полные сравнения
Для фиксированного размера команды суммируем расходы на все  запусков, включая неудачные, и делим на число итоговых зачётов
 . При
 получаем
Формула (7)
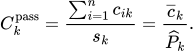
При нуле зачётов оставляем цену пустой. Отношение цен зачёта для двух размеров равно 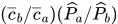 при положительных знаменателях. Поэтому рост цены попытки может сопровождаться снижением цены зачёта, если доля зачётов растёт быстрее. На нижних панелях рис. 3 показано обратное отношение цен зачёта. Если зачётов нет, эффективность равна нулю.
На алгоритмах цена зачёта при переходе  выросла на 726% у DeepSeek и на 736% у Qwen Flash. На правках рост составил 291% и 678% соответственно. Здесь база — цена зачёта при восьми агентах. Среди командных размеров наименьшая цена зачёта в каждой группе получена при одном агенте с самопроверкой. Сырой черновик обходился ещё дешевле в пересчёте на зачёт.
Куда делись рабочие варианты
Когда увидел расходы на большие команды, я полез во входные сообщения ведущего. На правках Qwen при 32 агентах рабочие черновики нашлись для трёх задач, при 64 — для шести. Сам ведущий получил полный рабочий черновик только на двух задачах в каждом случае. Это нижняя правая панель на рисунке.
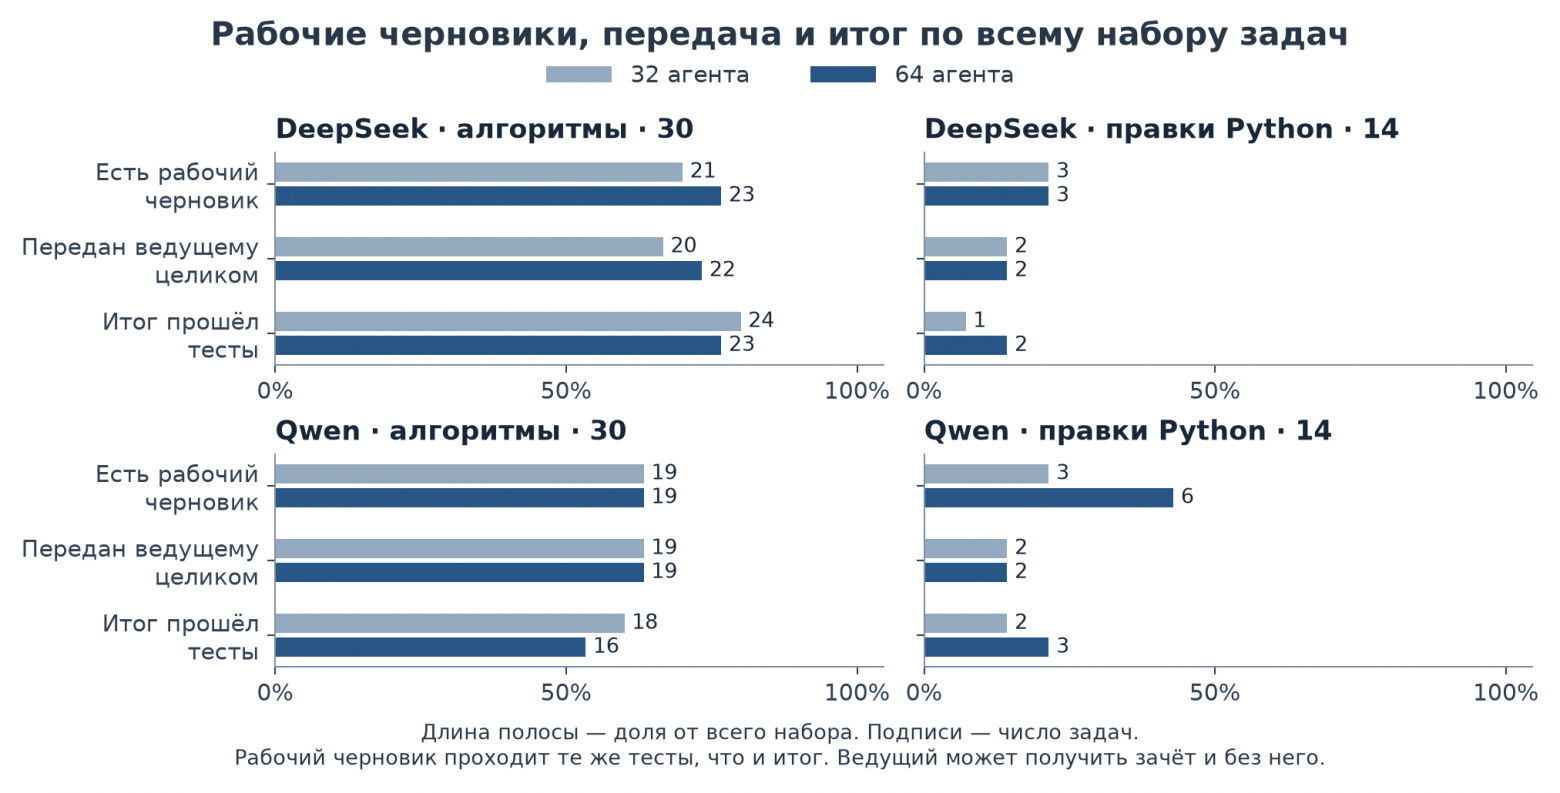
Рис. 4. Отдельно показаны наличие рабочего черновика, его прямая передача ведущему и зачёт итога. Знаменатель у всех трёх один.
Все три строки на панели считаются от 14 задач. В Click #3902 нужно было переносить строки справки целыми словами и аргументами. ANSI-коды оформления не должны занимать место при подсчёте ширины. При восьми агентах Qwen все черновики завалили целевые тесты, а ведущий выдал решение, которое их прошло. Поэтому итогов, прошедших тесты, может быть больше, чем задач, по которым ведущий получил рабочий черновик.
У восьми агентов DeepSeek на Packaging #1531 рабочий вариант до ведущего дошёл. Нужно было поправить парсер, чтобы после ограничения версии с оператором === он принимал следующее ограничение через запятую. Итоговый патч всё равно провалил тесты.
На задачах AtCoder можно увидеть ещё два сбоя. На ABC396 D у команды из 64 был рабочий код, но ведущий вернул два блока кода вместо одного. Оценщик отклонил ответ по формату. Я отдельно взял последний блок и прогнал через те же тесты. Он прошёл. На ABC387 C ведущий тоже получил рабочий вариант, а ответ оборвался по лимиту вывода.
В журналах видны вход и ответ ведущего. По ним можно найти точку сбоя. Влияние длины входа отдельно я не проверял. Если повторять такой опыт на своём проекте, я бы для начала оставил те же черновики и тот же состав. На вход дал бы ссылку на коммит с полным патчем, контракт, воспроизводящий тест или сценарий, команду запуска и результат. Полный журнал можно хранить отдельно и передавать ведущему ссылку на него. Затем повторить итоговую генерацию и сравнить зачёты и затраты с прежним форматом. Если черновик уже прошёл ваши целевые тесты, сохраните его. Прогоните итог ведущего через те же тесты. При регрессии у вас останется рабочий вариант.
На AtCoder я отдельно сравнил два способа завершить работу восьми агентов. У Qwen выбор первого черновика, прошедшего открытую проверку, дал 18 зачётов из 30. С рецензиями и правкой ведущего получилось 17 зачётов из 30, а расходы выросли на 92%. У DeepSeek счёт вырос с 20 до 24 за доплату 81%. Обе схемы я оценивал по одним и тем же целевым тестам. В цену отбора входят все восемь черновиков. Если ведущий переписывает рабочий вариант, сравнивайте его итог с простым отбором по тем же тестам.
Формула (5), трассы и контроль обмена
Пусть  описывает признаки задачи. Обозначим через
 наличие зачётного черновика среди
 участников, а через
 событие зачёта итога. Итог может пройти тесты даже в отсутствие рабочего черновика. Вероятность зачёта складывается из двух членов.
Формула (5)
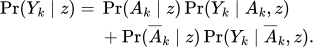
По той же формуле на выборке число итоговых зачётов равно охвату рабочих черновиков плюс число новых зачётов после сведения минус число провалов при наличии рабочего черновика. Пулы вложены, поэтому охват черновиков с ростом  монотонен. Два остальных слагаемых могут меняться в обе стороны.
При переходе с 32 до 64 агентов на алгоритмах потерян один зачёт у DeepSeek и два у Qwen Flash, новых зачётов нет. Разность составила  и
 п. п. Приближённые кластерные интервалы от
 до 0 и от
 до 0 п. п. допускают нулевую разность.
У DeepSeek при 32 агентах получено 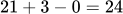 зачёта, при 64 —
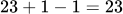 . У Qwen Flash соответственно
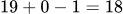 и
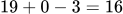 .
На правках Qwen число зачтённых итогов выросло с двух до трёх. На алгоритмах Qwen у ведущего был рабочий черновик на 19 задачах при обоих размерах. Среди этих задач число провалов итогового ответа выросло с одного до трёх.
Отбор черновиков. Ведущий получает до трёх полных черновиков. На ABC390 D при 64 агентах три черновика прошли закрытые тесты, ни один не попал во вход ведущего целиком. При 32 агентах рабочий черновик тоже не был передан целиком, однако итог получил зачёт. На 30 алгоритмах DeepSeek число задач с прямой передачей рабочих черновиков выросло с 20 до 22. При лимите в три черновика правило отбора может пропустить вариант, проходящий целевые тесты. Для проверки сравнить текущее правило с отбором по расширенным открытым тестам при том же размере команды, числе мест и наборе рецензий.
Длинный вход и формат итога. При росте с 32 до 64 агентов число рецензий во входе ведущего выросло с 31 до 63. Средняя длина входа у DeepSeek выросла с 5288 до 8610 токенов, у Qwen Flash — с 5218 до 7907. Оба случая Qwen произошли на 64 агентах. В основной статистике сохранены исходные вердикты, включая отказ по формату на ABC396 D. На 30 алгоритмах число остановок по лимиту выросло с 3 до 4 у DeepSeek и с 10 до 11 у Qwen Flash. Гипотеза в том, что длинный список рецензий усложняет итоговую сборку. Для проверки на фиксированных черновиках сравнить полный и сокращённый наборы рецензий. Лимит вывода варьировать отдельно, повторяя генерацию при парных настройках.
В основном парном опыте при четырёх агентах итог DeepSeek прошёл 12 из 18 алгоритмических задач при соседском ревью и 13 при саморевью. Один исход ухудшился, улучшившихся нет. Разность долей равна  п. п. с приближённым интервалом от
 до 0. На шести правках обе схемы дали ноль зачётов. На алгоритмах доступ к соседнему черновику увеличил среднюю цену без кэша на 9,9%. При
 USD полезность снизилась на 39% цены саморевью. Интервал разности полезности в тех же единицах составил от
 до
 %.
При восьми агентах все парные исходы совпали. При 32 у соседского ревью на алгоритмах был один дополнительный зачёт, при 64 один новый зачёт сопровождался двумя потерями. Сравнения при 8, 32 и 64 агентах справочные.
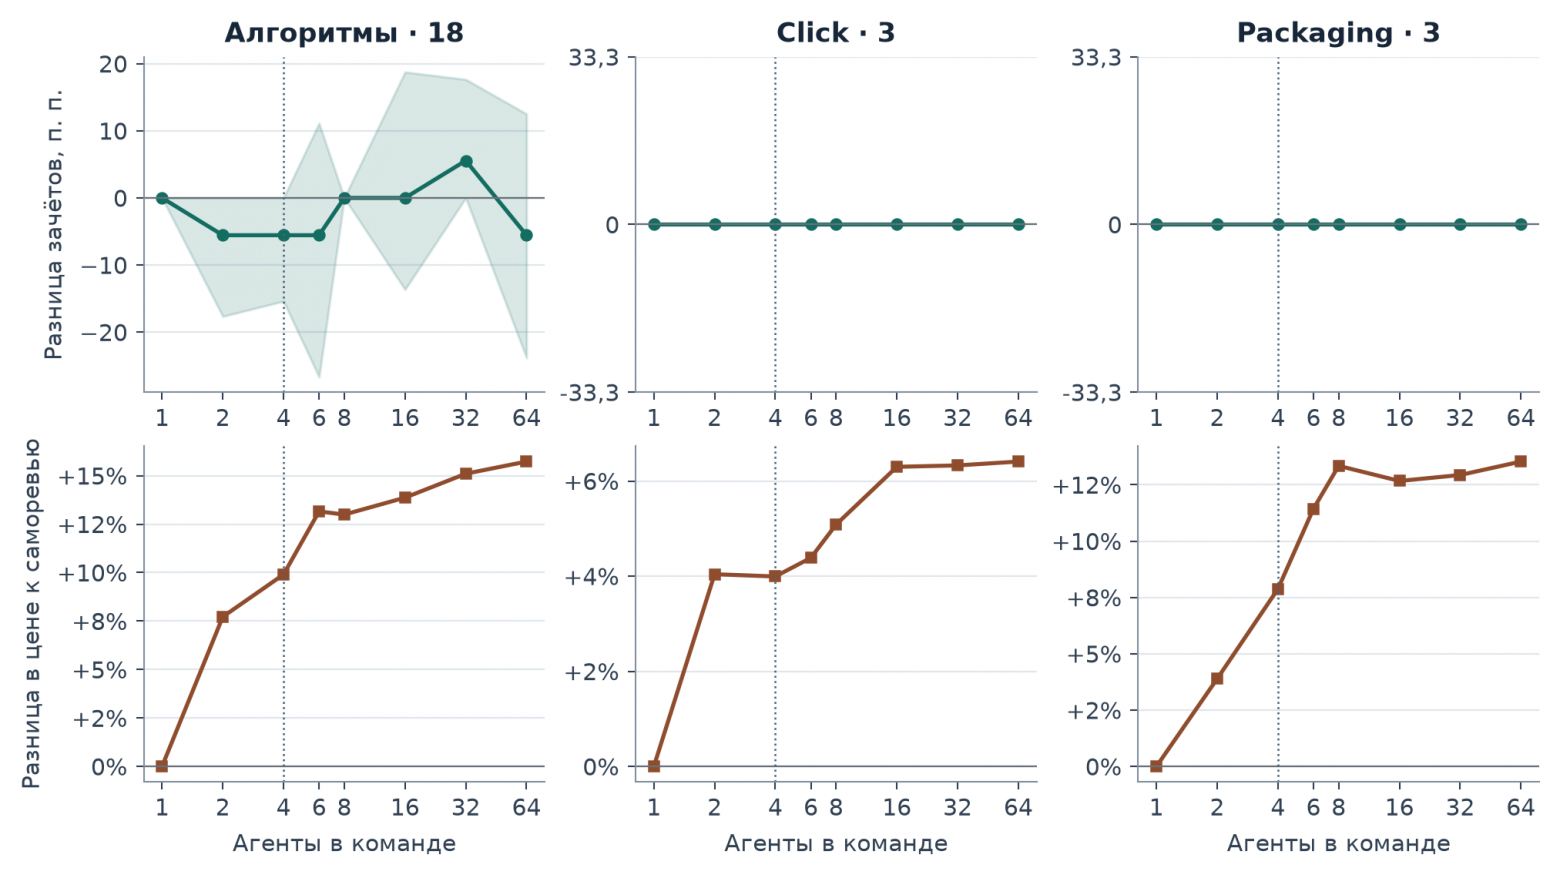
Рис. 8. Парная разность между соседским ревью и саморевью. Цена выражена в процентах к саморевью для того же размера. Вертикальный пунктир отмечает основной контраст при четырёх агентах. Полоса на алгоритмах показывает приближённый кластерный интервал.
На 30 алгоритмах DeepSeek четыре итога получили зачёт при отсутствии рабочего черновика в каждой из двух конфигураций, при одном и при восьми агентах. Совпали две задачи из этих четырёх. Парный контроль при восьми агентах сохранил исходы на своих 18 алгоритмах при замене соседского ревью саморевью.
Все 7056 рецензий содержали текст, 65 завершились по лимиту. Около 64% рецензий соответствовали заданному однострочному формату. Из 872 ответов ведущего 141 завершился по лимиту вывода. В анализ вошли фактические ответы при всех причинах завершения. На правках DeepSeek доля входных токенов из кэша выросла с 34,1% при одном агенте до 69,4% при 64. Среднее списание за 64 агента в этом прогоне было на 49% ниже цены тех же вызовов без скидки на кэш.
На той же задаче Click #3902 у Qwen3.8 Flash при 16 участниках ни один черновик не получил зачёт. Итог ведущего изменил обёртку текста и форматирование аргументов в двух файлах и прошёл целевые тесты. В задаче ABC390 D у DeepSeek при четырёх агентах итог с соседским ревью провалил закрытые тесты, а итог с саморевью прошёл.
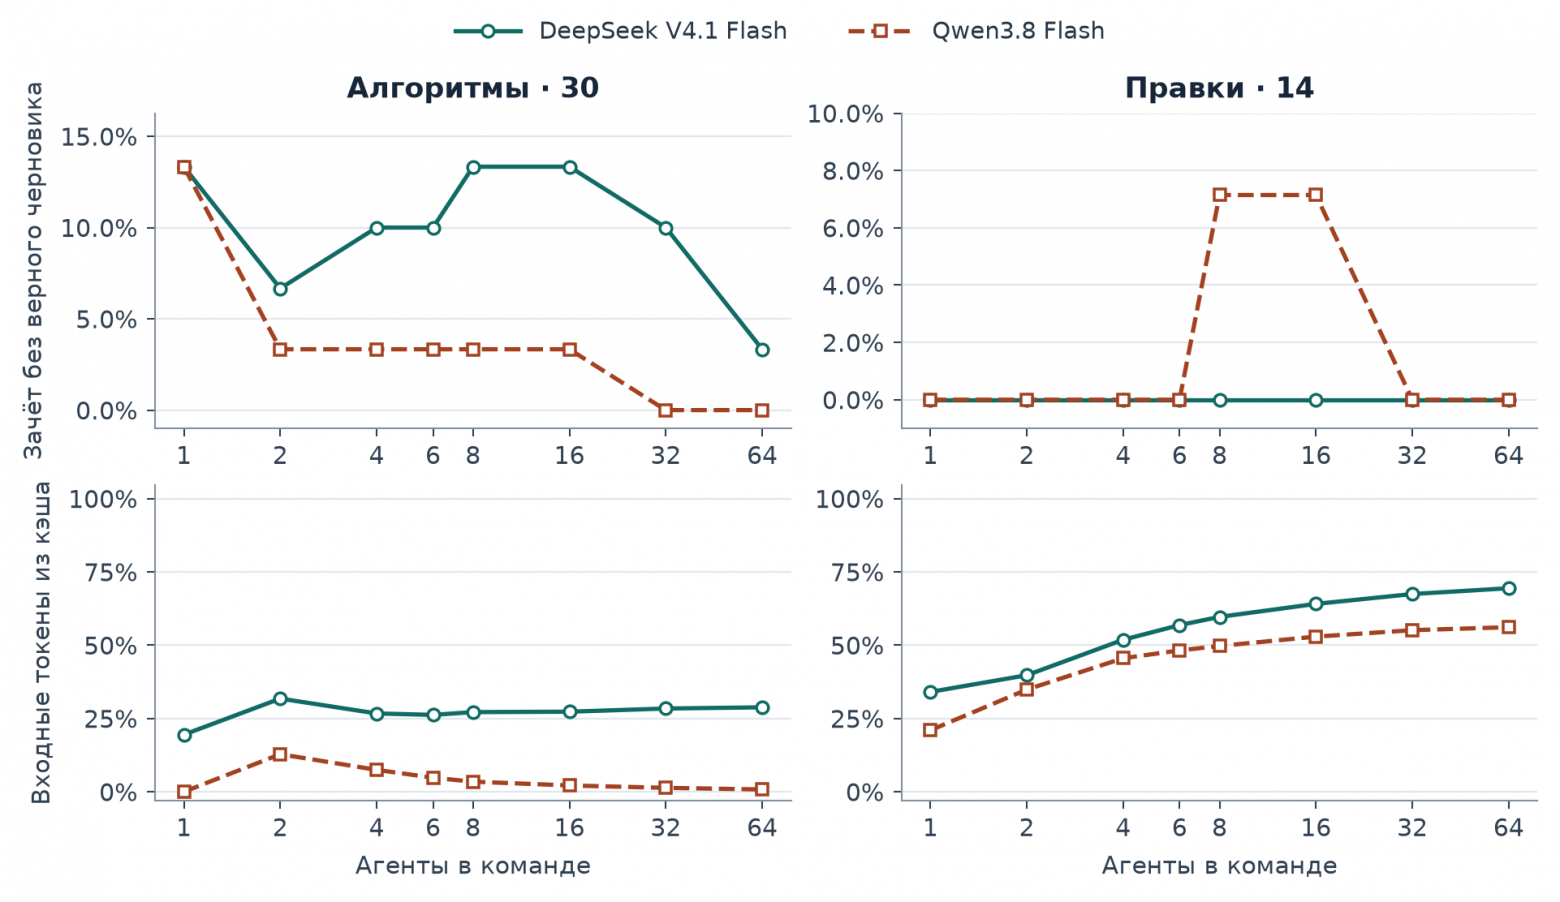
Рис. 9. Сверху доля задач с новым зачётом после сведения при отсутствии зачётного черновика. Снизу доля входных токенов из кэша для того же набора запусков.
Сколько времени добавляет команда
На правках Qwen 64 агента дали те же 3 зачёта из 14, что и восемь. При переходе к 64 расчётная медиана времени API выросла с 46 до 57 секунд (+25%), а цена попытки — на 678% по тарифу без кэша. На AtCoder у обеих моделей за тот же переход медиана выросла на 18–19%, и обе потеряли по одному зачёту.
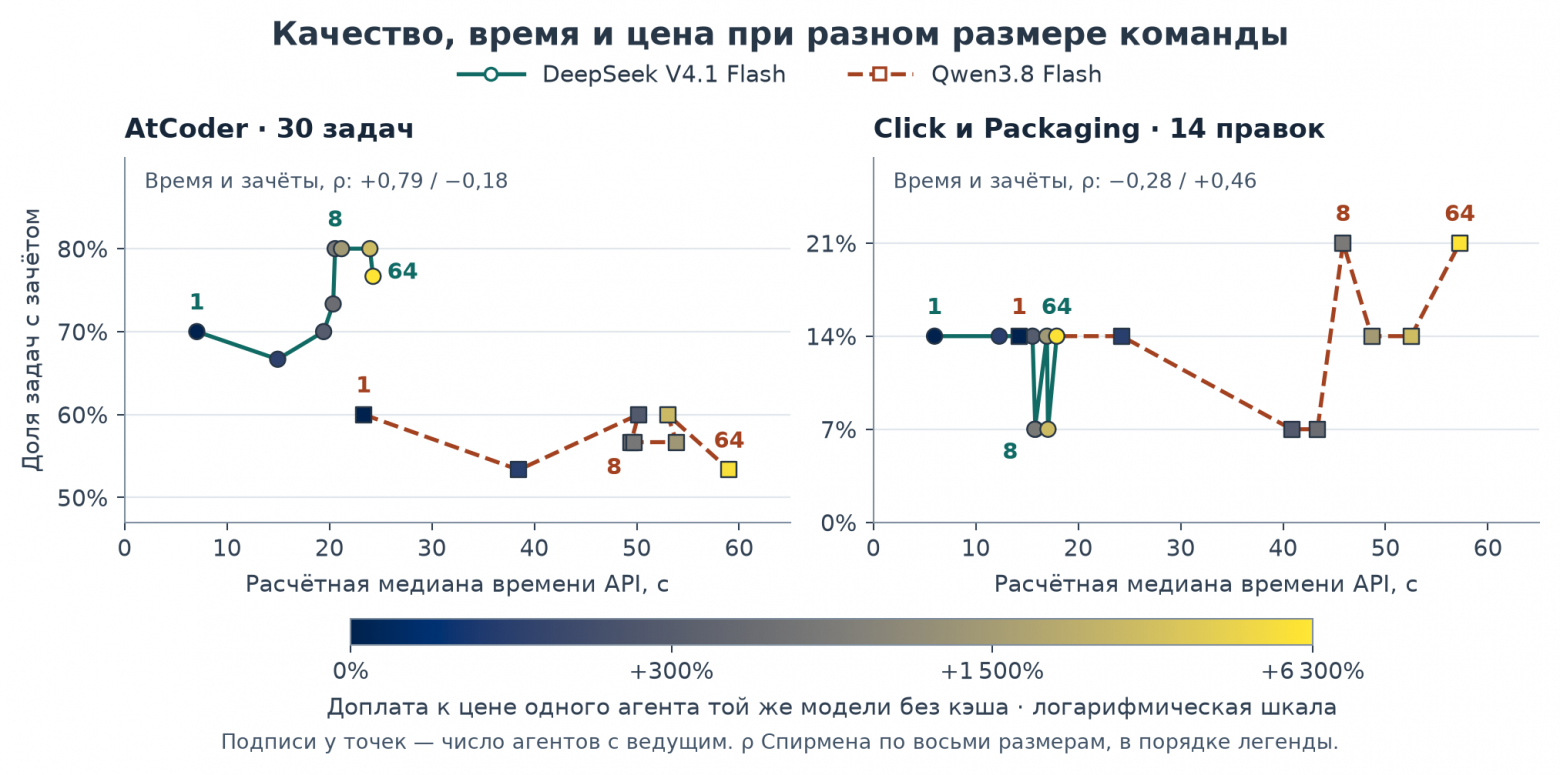
Рис. 5. Точка — один размер команды. По горизонтали расчётная медиана времени API, по вертикали доля зачётов. Цвет показывает доплату к цене одиночной самопроверки той же модели на том же наборе. Вертикальные шкалы различаются.
Ранговая корреляция времени с ценой составила от 0,90 до 1,00. С долей зачётов связь менялась от −0,28 до +0,79. Каждое значение рассчитано по восьми размерам отдельно для модели и набора задач.
Задержку восстановил по длительности запросов к API, с одним запросом для прогрева и параллельным запуском остальных на этапах черновиков и рецензий. Это оценка ожидания модельных ответов. В своём проекте время до готового результата стоит считать вместе с очередями, тестами и приёмкой.
Как посчитать цену дополнительного зачёта
Возьмём условный пример. Команда сравнила три схемы на одних и тех же 20 задачах. Задача идёт в зачёт, если результат прошёл согласованные проверки и ревью к сроку, а объём ручной помощи уложился в оговорённый предел.
|
Агентов всего |
Сабагентов |
Задач принято |
Расход на задачу |
|---|---|---|---|
|
1 |
0 |
12/20 |
база |
|
2 |
1 |
15/20 |
+20% |
|
4 |
3 |
15/20 |
+50% |
Если нужно доводить до приёмки хотя бы 75% изменений, из этих вариантов дешевле всего пара. Чтобы найти цену дополнительного зачёта, разделите доплату за всю серию на прибавку зачётов. Допустим, базовый запуск обходится в эквивалент 20 минут работы. Пара добавляет четыре минуты расходов на каждую из 20 задач. Эти 80 минут дают три дополнительные принятые задачи, около 27 минут за один дополнительный результат. Четыре агента не прибавили зачётов относительно пары.
API, CI, ревью и переделки можно свести к деньгам или пересчитать в рабочее время по ставке команды. Календарное время до приёмки посчитайте отдельно.
Формулы (1)–(4), (6) и как провести пилот
Для пилота я бы взял похожие задачи и версии кода до исправления. Модель, исходный коммит и условия приёмки оставил бы одинаковыми. Если меняете состав вместе с ролями, сравниваете рабочие схемы целиком.
Сверьте список задач, на которых новый состав выиграл или потерял зачёт. При одинаковых долях приёмки этот список может меняться. Проверьте, держится ли выбор, если убрать одну удачную задачу, и повторите сравнение на задачах следующего периода.
Команда из  участников, включая ведущего, выдаёт один итог. Обозначим его зачёт индикатором
 и вероятность зачёта при признаках задачи
 через
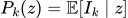 . Если зачёт приносит
 USD, неудача не приносит дохода, а полный запуск стоит
 , то ожидаемый денежный результат равен
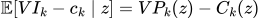 , где
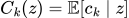 . Линейность ожидания даёт эту формулу и при зависимости цены от исхода. Критерий предполагает, что решение принимается по среднему денежному результату.
Формула (1)
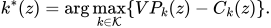
При равенстве берём меньший размер. Вариант  с
 представляет отказ от запуска. Пусть
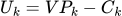 . Разницу полезностей двух вариантов даёт формула (2).
Формула (2)

При положительных 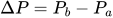 и
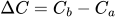 переход выгоден при
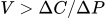 . При
 достаточно сравнить цены. Если
 и
 , то
 для любого
 . После исключения таких вариантов всё ещё нужен перебор оставшейся сетки.
Если задан потолок средней цены  и минимальная доля зачётов
 , максимум ищем по
 с
 и
 . Когда известна только цель по качеству, среди таких вариантов выбираем самый дешёвый. Пустое допустимое множество означает, что на данной сетке цель при заданном бюджете недостижима по имеющимся оценкам. Жёсткий бюджет отдельного запуска требует отдельного ограничения расходов.
Для сравнения в процентах берём за базу цену  одного агента с самопроверкой в той же группе. Обозначим изменение цены через
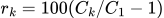 , а ценность зачёта в процентах цены базового запуска через
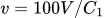 . При фиксированной группе нормировка сохраняет выбор.
Формула (3)
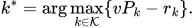
Действительно, 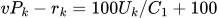 . Смена единиц сохраняет порядок при
 .
Первый максимум означает наименьший размер с максимальным числом зачётов среди проверенных размеров. Плато в измеренных точках означает равенство числа зачётов. Состав зачтённых задач при этом может меняться.
Пусть  — прогноз по калибровке, а
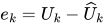 . Разложение потерь даёт
Формула (4)
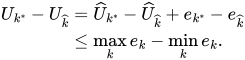
Первое слагаемое неположительно по правилу выбора  . Здесь оба максимума ищутся по одному заданному множеству допустимых вариантов.
Для локальной калибровки берём  похожих задач. Обозначим через
 зачёт итогового ответа задачи
 при размере
 (1 или 0), а через
 — цену её решения. Ожидаемую полезность оцениваем средним по прогонам.
Формула (6)
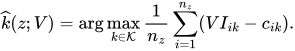
Для алгоритмов группируем калибровочные задачи по исходным меткам сложности. Для правок оцениваем размер команды на другом репозитории. При переносе между моделями подставляем в (1) долю зачётов другой модели и цену целевой. Также сравниваем фиксированный размер, выбранный на калибровке, сырой черновик и одноагентную самопроверку. Основное значение  USD. Чувствительность проверяем ещё при четырёх значениях от 0,001 до 0,20.
Чтобы выбрать схему под заданную долю зачётов, выпишите для каждого состава долю принятых задач и среднюю полную цену попытки. Если цель — 75%, оставьте составы с 15 зачётами из 20 или выше и выберите среди них самый дешёвый. Жёсткий лимит одной попытки задавайте отдельно, например числом вызовов и временем до передачи задачи разработчику.
На 20 условных задачах одна дополнительная принятая задача стоит 80 / 3 ≈ 26,67 минуты. Для миграции отдельно проверяют совместимость и откат. Для сравнения с ручным выполнением задайте той же задаче ту же ценность принятого результата и оцените цену ручного варианта отдельно.
Измеренные пороги и выбор при ограниченном бюджете
На алгоритмах DeepSeek доля зачётов выросла с 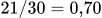 до
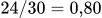 . По цене без кэша восемь агентов обходятся на 665,52% дороже одного. Порог окупаемости перехода
 равен
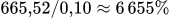 цены одного агента за один зачёт.
Перебор восьми размеров даёт правую панель рис. 10. При  выбираем одного агента, при
 — восемь. Размеры 16 и 32 дают те же 24 зачёта при большей цене. Порог рассчитан на всех 30 задачах и иллюстрирует способ выбора. Для новых задач подставляем оценки из отдельной калибровочной выборки.
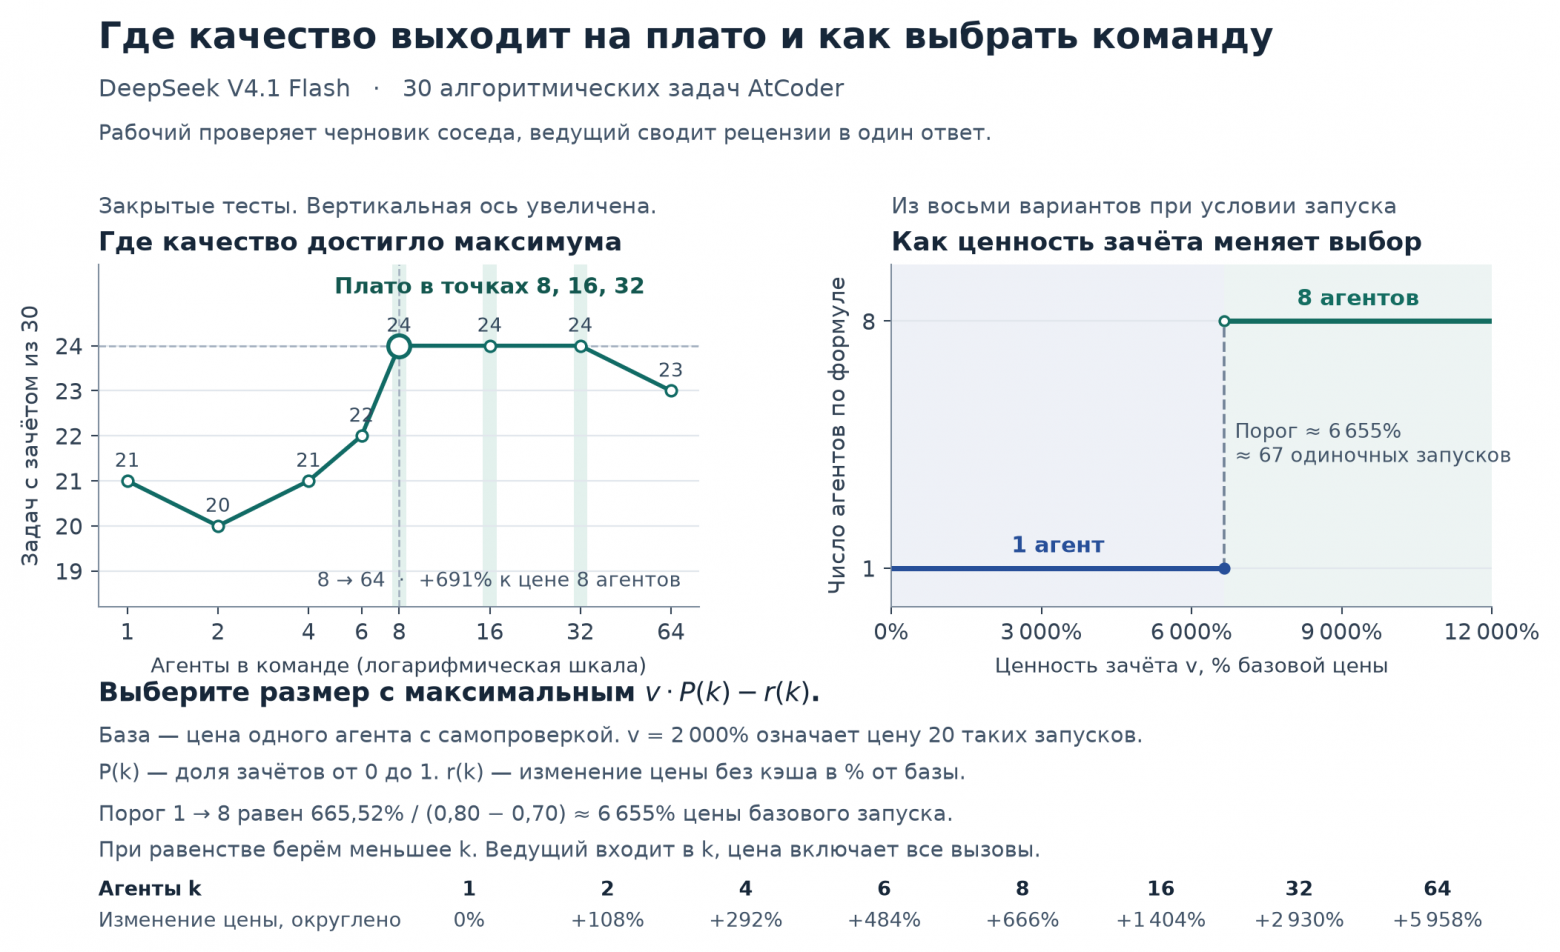
Рис. 10. Слева итоговые зачёты DeepSeek для проверенных размеров команды. Справа выбор на тех же 30 задачах по формуле (3). Цены рассчитаны без скидки на кэш.
При переходе от 8 к 64 цена без кэша выросла на 691% и 687% на алгоритмах DeepSeek и Qwen Flash. На правках рост составил 682% и 678% соответственно. В каждом случае база — цена восьми агентов той же модели на тех же задачах. При  USD полезность на алгоритмах снизилась на 699% и 691% от цены восьми агентов. Приближённые интервалы разности полезности в тех же единицах составили от
 до
 % и от
 до
 % соответственно.
У Qwen Flash на правках переход от одного агента с самопроверкой к восьми дал один дополнительный зачёт из 14 при доплате 679%. Порог  равен примерно
 %. При сравнении восьми агентов с сырым черновиком порог равен примерно
 % той же цены одноагентной самопроверки.
По средним ценам без кэша недоминируемые размеры на алгоритмах DeepSeek равны 1, 6 и 8, на правках Qwen — 1 и 8. На правках DeepSeek и алгоритмах Qwen остаётся только 1. Эти сравнения относятся к измеренной панели и фиксированному способу запуска.
Шесть агентов на алгоритмах DeepSeek дают 22 зачёта из 30 при доплате 484% к цене одного агента. Из (2) следует, что шесть агентов достигают полезности одного при ценности примерно  и выигрывают выше этой границы. Полезности восьми они достигают при ценности
 и выигрывают ниже. Интервалы не пересекаются. При потолке средней цены
 и цели хотя бы 22 из 30 подходит шесть агентов. При том же бюджете цель 23 из 30 недостижима среди проверенных размеров (рис. 11).
Порог  для этой панели равен
 за зачёт. Стали проходить три дополнительные задачи из 30, потерь не наблюдали. При ценности зачёта
 USD средний выигрыш восьми агентов равен 260% цены одного запуска на задачу. Парный интервал в тех же единицах составляет от
 до
 %. При исключении по одному соревнованию порог меняется от 58 до 91 исходной цены
 , если сохранить исходную единицу измерения.
При раздельном выборе на калибровке и проверке DeepSeek с правилом 1/6/8 при  USD добавил один зачёт на 15 отложенных задачах. Средний выигрыш составил 117% цены запуска одного агента на той же проверочной группе. Интервал от
 до
 % рассчитан для уже выбранного правила. Он допускает убыток и учитывает вариацию по проверочным соревнованиям.
В этом опыте  включает стоимость API. Для рабочего процесса в ту же сумму входят время разработчика и инфраструктура, если их можно оценить в деньгах.
 задают как ценность принятого результата для одной задачи. При сравнении с ручным решением используем ту же ценность принятого результата и считаем затраты ручного варианта отдельно. Цена зачёта по (7) показывает средний расход на один принятый результат.
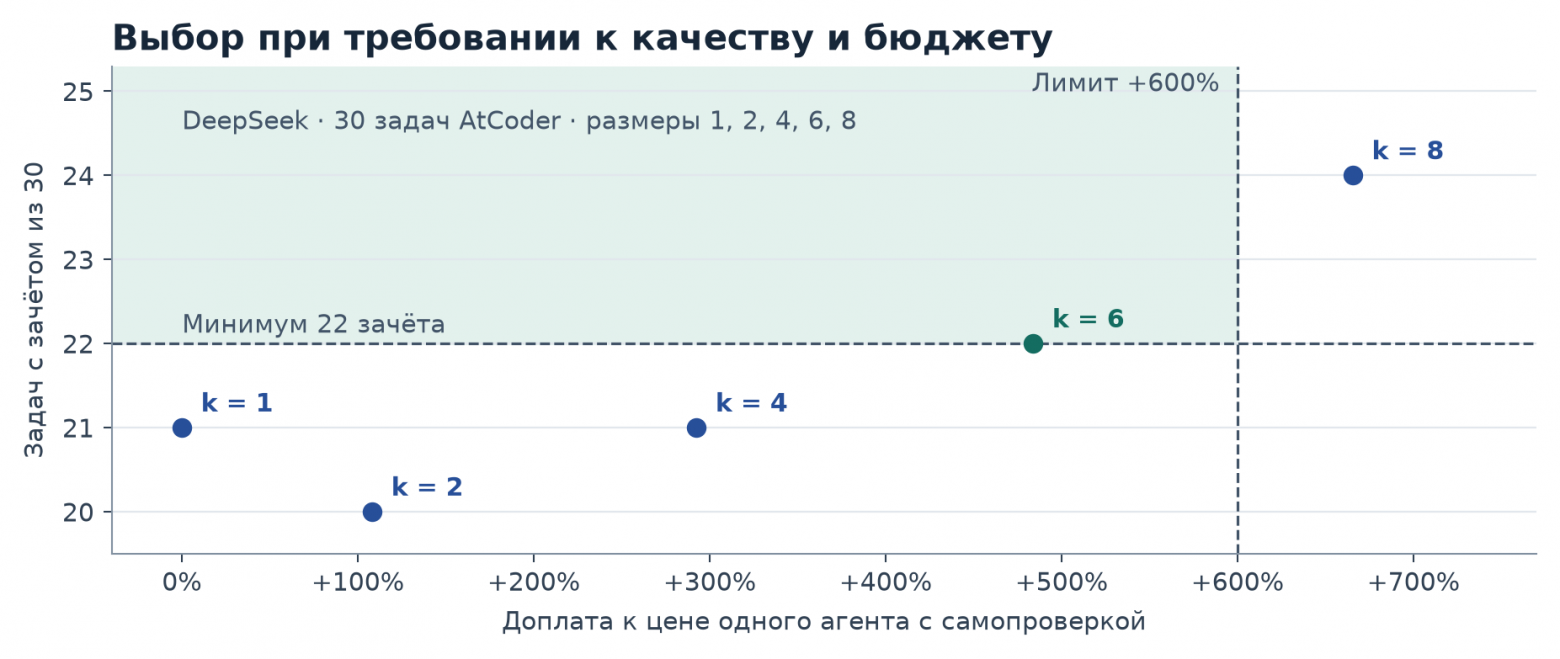
Рис. 11. Иллюстрация настройки двух ограничений на полной панели DeepSeek AtCoder. При доплате до 600% и цели от 22 зачётов допустим один измеренный размер. Размеры 16, 32 и 64 выходят за пределы показанного участка по цене.
Сработает ли выбранный размер на новых задачах
На Click расчёт для Qwen при ценности зачёта в 0,20 USD дал восемь агентов. Я взял этот размер и посмотрел, что получилось на Packaging. У одного агента был один зачёт из шести. У восьми тоже один, при этом попытка стоила на 608% дороже.
На отложенных задачах AtCoder расклад для DeepSeek был чуть лучше. Подбор размера по сложности дал 13 зачётов из 15 вместо 12 у одного агента, но цена попытки выросла на 520%. Интервал разницы полезности включал отрицательные значения.
Самопроверка тоже стоит денег. На 14 правках первый черновик и итог после самопроверки получили по два зачёта у каждой модели. В среднем по каждой модели и репозиторию черновик обходился на 51–54% дешевле по тарифу без кэша. На 15 отложенных задачах AtCoder самопроверка прибавила два зачёта у DeepSeek и три у Qwen. Если у вас есть целевой тест, прогоните его уже на первом черновике. Его результат покажет, нужна ли ещё одна итерация по этому сценарию.
Отложенные выборки, калибровка и ограничения
При  USD все варианты калибровки, включая перенос, выбрали одного агента среди размеров команды. На отложенных алгоритмах самопроверка увеличила число зачётов с 10 до 12 из 15 у DeepSeek и с 7 до 10 у Qwen Flash. Цена выросла на 85% и 111% соответственно относительно сырого черновика. Прибавки полезности, выраженные в процентах цены самопроверки, составили 209% и 156%. Приближённые интервалы разности составили от
 до
 % и от
 до
 %.
При  USD калибровка DeepSeek выбрала 1, 6 и 8 агентов для простых, средних и сложных алгоритмов. На проверке эта схема дала 13 зачётов из 15. У одного агента и при переносе с Qwen было по 12 зачётов. На проверочной выборке выбранная схема обошлась на 520% дороже одного агента и на 18% дешевле фиксированной команды из восьми, у которой тоже 13 зачётов. Для Qwen Flash калибровка при той же ценности выделила восемь агентов на средние задачи. Зачётов осталось 10 из 15 при росте цены на 258% к одному агенту.
Проверочные зачёты при ценности зачёта 0,01 USD. Цены без кэша относительно одиночной самопроверки, перенос использует вероятности другой модели.
|
Проверочная выборка |
Черновик |
Один |
Фикс. |
По стратам |
Перенос |
|---|---|---|---|---|---|
|
DeepSeek · Алгоритмы · зачёт |
10/15 |
12/15 |
12/15 |
12/15 |
12/15 |
|
DeepSeek · Алгоритмы · цена, % |
-45,9 |
0,0 |
0,0 |
0,0 |
0,0 |
|
DeepSeek · Click · зачёт |
1/8 |
1/8 |
1/8 |
1/8 |
1/8 |
|
DeepSeek · Click · цена, % |
-54,1 |
0,0 |
0,0 |
0,0 |
0,0 |
|
DeepSeek · Packaging · зачёт |
1/6 |
1/6 |
1/6 |
1/6 |
1/6 |
|
DeepSeek · Packaging · цена, % |
-51,1 |
0,0 |
0,0 |
0,0 |
0,0 |
|
Qwen Flash · Алгоритмы · зачёт |
7/15 |
10/15 |
10/15 |
10/15 |
10/15 |
|
Qwen Flash · Алгоритмы · цена, % |
-52,7 |
0,0 |
0,0 |
0,0 |
0,0 |
|
Qwen Flash · Click · зачёт |
1/8 |
1/8 |
1/8 |
1/8 |
1/8 |
|
Qwen Flash · Click · цена, % |
-51,7 |
0,0 |
0,0 |
0,0 |
0,0 |
|
Qwen Flash · Packaging · зачёт |
1/6 |
1/6 |
1/6 |
1/6 |
1/6 |
|
Qwen Flash · Packaging · цена, % |
-53,5 |
0,0 |
0,0 |
0,0 |
0,0 |
Размеры команды при разных значениях ценности зачёта. Цены без кэша. Click и Packaging — репозитории для проверки. Размер для каждого из них подбирается по задачам другого репозитория. Сравнение при условии запуска.
|
Модель и |
Простые |
Средние |
Сложные |
Click |
Packaging |
|---|---|---|---|---|---|
|
DeepSeek · 0,001 |
1 |
1 |
1 |
1 |
1 |
|
DeepSeek · 0,005 |
1 |
1 |
1 |
1 |
1 |
|
DeepSeek · 0,010 |
1 |
1 |
1 |
1 |
1 |
|
DeepSeek · 0,050 |
1 |
6 |
8 |
1 |
1 |
|
DeepSeek · 0,200 |
1 |
6 |
8 |
1 |
1 |
|
Qwen Flash · 0,001 |
1 |
1 |
1 |
1 |
1 |
|
Qwen Flash · 0,005 |
1 |
1 |
1 |
1 |
1 |
|
Qwen Flash · 0,010 |
1 |
1 |
1 |
1 |
1 |
|
Qwen Flash · 0,050 |
1 |
8 |
1 |
1 |
1 |
|
Qwen Flash · 0,200 |
1 |
8 |
1 |
1 |
8 |

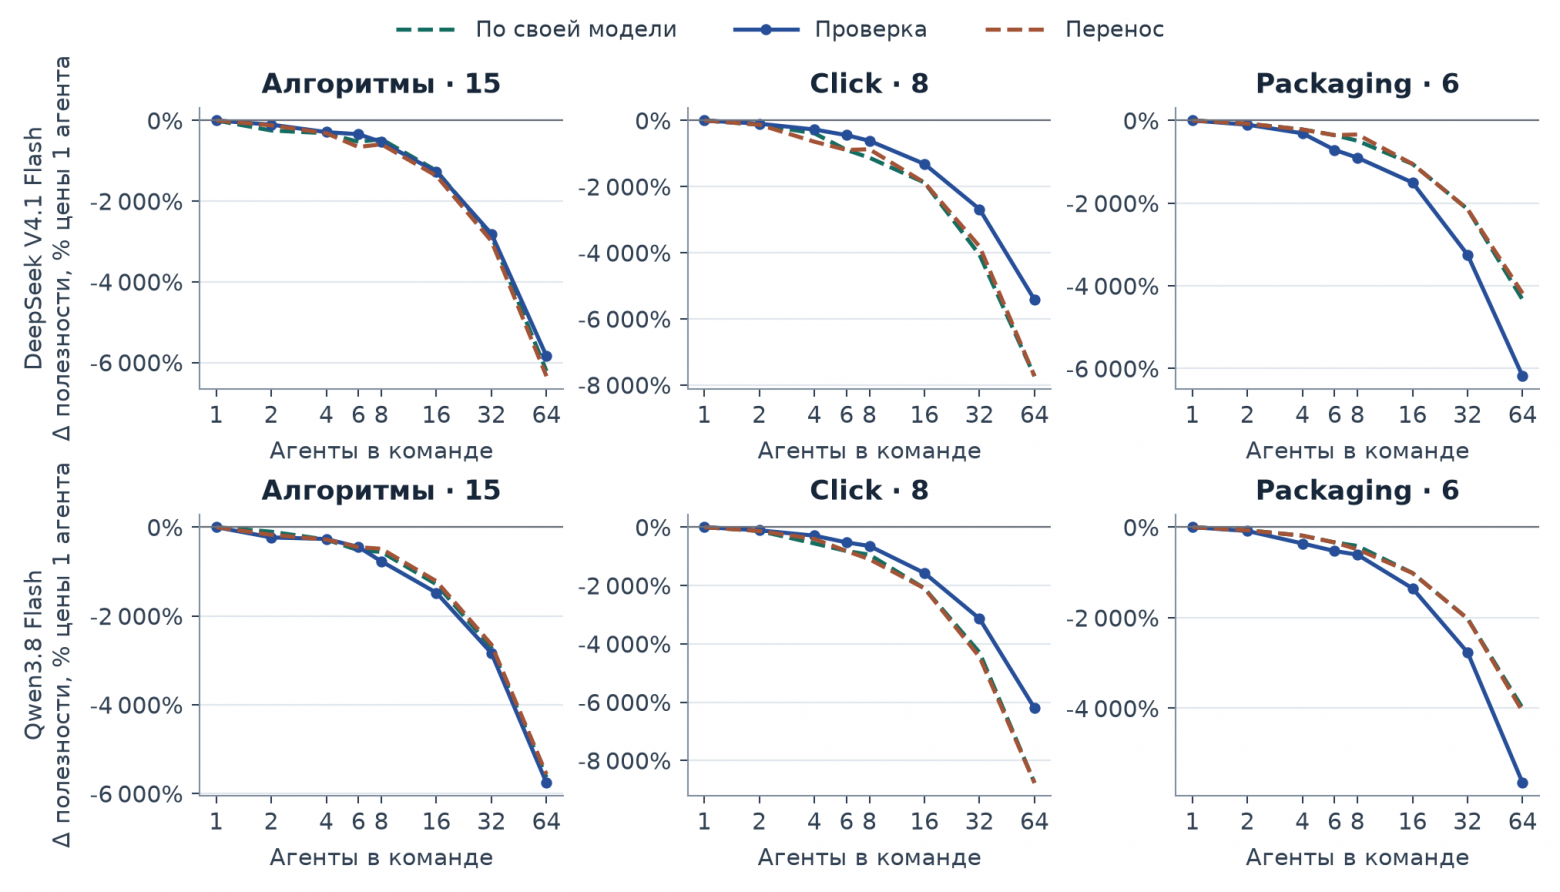
Рис. 12. Разность полезности  при
 USD в процентах измеренной цены одного агента. Каждая кривая отсчитана от своей одноагентной точки. Сплошная линия получена на проверке, пунктиры — из калибровки своей и другой модели.
Эксперимент измеряет один раунд соседского ревью. Для команд с несколькими раундами, инструментами поиска, делегированием разных подзадач или общей памятью нужны оценки их собственных кривых. Для каждого размера и задачи сохранён один выпуск ведущего, а калибровка алгоритмов содержит пять задач на уровень. Правки проверялись при известной области изменения в двух репозиториях. Сквозную разработку фич, ожидание ревью и выпуск в продакшен в эксперименте не измеряли. Выборка AtCoder включает опубликованные задачи. Систематический эффект знакомства модели с условиями исключить нельзя. Издержки разработки и тестовой инфраструктуры в цену API не входят. Перенос на правках проверен только между двумя репозиториями.
Сколько агентов нужно для решения задачи
Начните с одного агента и заранее определите, чем проверите результат. В прогоне Qwen на правках Click и Packaging семь сабагентов подняли результат с двух до трёх зачётов из 14, а цену попытки — на 679%.
В эксперименте каждый участник писал свой вариант решения. Для разработки, где можно распределить разные части задачи, сначала посмотрите, какие из них можно выполнить и проверить отдельно. Для каждой части должны быть понятны граница изменений, входные данные и критерий готовности.
-
Связная правка — один агент. Если несколько шагов меняют одно правило бизнес-логики или каждый шаг зависит от решений предыдущего, отдайте правку целиком одному агенту. Это относится и к изменениям в нескольких файлах.
-
Две независимые части — ведущий и один сабагент. Когда контракт API согласован, ведущий может взять бэкенд, а сабагент — фронтенд. Бэкенд проверяется тестами API, фронтенд можно проверять на заглушке. Если контракт ещё меняется, сначала согласуйте его.
-
Три и больше независимых частей — несколько сабагентов. Если ведущий берёт одну из трёх частей, двух сабагентов достаточно. Если ведущий только сводит изменения, можно назначить по сабагенту на каждую часть. Восемь сабагентов можно распределить по восьми сервисам, когда каждый переходит на согласованный контракт и проверяется отдельно. Сравните время работы по очереди с временем самой долгой части плюс время на координацию, сборку и общую проверку. Выигрыш по сроку должен оправдывать доплату.
-
Отдельный риск — один сабагент на проверку. Если после проверки первым агентом остался конкретный риск, поручите сабагенту проверить его на готовом результате. Укажите ожидаемое поведение и какой результат проверки потребует доработки.
Если каждый агент готовит свой вариант одного решения, увеличивайте команду только когда прирост шанса на зачёт оправдывает доплату по формуле (2). На AtCoder у DeepSeek команды из 8, 16 и 32 агентов дали по 24 зачёта из 30. При 64 агентах осталось 23, а попытка стоила на 691% дороже, чем при восьми, по тарифу без кэша.
Ведущий сводит результаты и проверяет решение целиком по исходным критериям приёмки.
С чем сравнивал и какие источники использовал
Brown и соавторы измеряют покрытие при повторных независимых выборках [1]. Оно отражает наличие рабочего ответа. При коллективной правке команда способна написать решение, которого ещё нет среди черновиков. На ProgramBench Samway и соавторы наблюдают плато после четырёх рабочих при делегировании реализации или проверки. При делегировании планирования дополнительные рабочие продолжают прибавлять качество [2]. Kim и соавторы связывают отдачу от координации со структурой задачи и качеством одноагентной схемы [3]. В gMAS авторы измеряют, как ранняя остановка меняет издержки выполнения агентного графа [4].
Zhai и соавторы распределяют вычисления на основе ожидаемого выигрыша и цены [5]. Iyengar выбирает размеры независимых выборок на ранее проверенных задачах [6].
Для параллельного поиска описан подход с отдельным контекстом у каждого исполнителя. Ведущему передают краткие находки и ссылки на полные результаты [12], [13]. Такая организация помогает сохранить детали исходного результата и ограничить длину общего запроса.
-
Brown B., Juravsky J., Ehrlich R. et al. Large Language Monkeys: Scaling Inference Compute with Repeated Sampling. 2024.
-
Samway K., D’souza D., Domingues O. D. et al. Scaling Inference-Time Compute with Teams of Coding Agents. 2026.
-
Kim Y., Gu K., Park C. et al. Towards a Science of Scaling Agent Systems. 2026.
-
Сбер. Мы пытались оптимизировать граф агентов в LangGraph — и в итоге написали gMAS. 2026.
-
Zhai Z., Li B., Xiao B. et al. Adaptive Test-Time Compute Allocation for Reasoning LLMs via Constrained Policy Optimization. 2026.
-
Iyengar S. Sample, Mix, or Verify? Allocating Test-Time Compute under Imperfect Verifiers. 2026.
-
Jain N., Han K., Gu A. et al. LiveCodeBench: Holistic and Contamination Free Evaluation of Large Language Models for Code. 2024.
-
OpenRouter. DeepSeek V4.1 Flash.
-
OpenRouter. Qwen3.8 Flash.
-
OpenRouter. Prompt Caching.
-
Cameron A. C., Miller D. L. A Practitioner’s Guide to Cluster-Robust Inference. 2015.
-
Hadfield J., Zhang B., Lien K. et al. How we built our multi-agent research system. 2025.
-
Rajasekaran P., Dixon E., Ryan C., Hadfield J. Effective context engineering for AI agents. 2025.
Автор: paviiil

Советуем прочесть:
 Когда ИИ-агенту нужен MCP, а когда достаточно обычного API 13.11.2026 Допустим, вы разрабатываете ИИ-агента, который проверяет статусы заказов. Для этого…
 Китайский математик составил список из 1000 задач, способных бросить вызов ИИ 22.10.2026 В эпоху, когда искусственный интеллект всё чаще находит ответы на сложные математические…
 Когда ИИ решает, что вам нельзя. От Codex до этикосферы Станислава Лема 17.11.2026 Как попытка удалить несколько файлов заставила меня вспомнить классику научной…
 NER для юристов, у которых нет A100: как мы догнали Ministral 14B моделью почти в 10 раз меньше 03.11.2026 Юристы не могут отправлять материалы дел во внешние API, а…
 Одна фраза тимлида в промпте срезала оценку задач на пятую часть 02.11.2026 Всем привет, меня зовут Сергей Прощаев, я Tech Lead и…
