


Привет, на связи команда документирования СберТеха и авторы этой статьи — Маша Бурханова, Лида Ковач и Саша Яковлев.
В первой части материала «Как мы составляем глоссарий для сложной технологической платформы» мы рассказали, как пришли к идее создания глоссария ИТ-терминов в удобном для разработки документации формате и какие организационные трудности были на нашем пути. Каждый разработчик технической документации сталкивается с разночтениями, путаницей в написании терминов и с тем, что читатели понимают термины неправильно. Поэтому наша команда и поставила амбициозную цель: упростить написание и понимание терминологии для большинства технических специалистов и попробовать задать стандарт качества.
Как и обещали, делимся результатом нашей работы в публичном репозитории на GitVerse. Сейчас глоссарий содержит более 750 терминов, и работа над ним продолжается. В наполнении участвуют разработчики технической документации из разных команд и специалисты по кибербезопасности. Подписывайтесь, используйте в своих проектах и следите за изменениями.
В процессе внедрения глоссария в производство мы поняли, что главная проблема технического писателя — это даже не отсутствие правил, а их соблюдение.
Представьте: у вас есть больше 700 терминов, а в коде на каждую десятую строчку приходится ошибка. Исправлять это вручную — всё равно что пешком подниматься на 150-этажный небоскреб.
Очевидно, что требовать от команд ручного исправления тысяч ошибок несправедливо. Рутину можно автоматизировать. А ещё это просто неудобно: смотреть отчёт об ошибках в одном окне, а править текст в другом, постоянно коммитить и пересобирать документацию… Так родилась идея: проверять текст прямо во время написания, прямо в редакторе, что привело к созданию ИИ-агента технического писателя, который помогает исправлять термины по глоссарию.
В этой статье мы расскажем, как за несколько часов собрали прототип, с какими «подводными камнями» столкнулись при переходе к промышленной эксплуатации и почему в итоге написали собственное решение на Python.
Запуск ИИ-агента в IDE
От идеи до прототипа за один вечер
Если вкратце, то вся концепция описывается формулой: Continue (плагин для IDE) + Langflow (визуальный конструктор).
Если подробнее, то агент — это мультиагентная система:
-
Клиентский агент видит, что вы пишете. Это может быть плагин, который живет в вашей IDE (встроенный Copilot, сторонние Continue, Cline, Kilo Code, Roo Сode); агент, работающий в командной строке (OpenCode, QwenCode); или вообще редактор Cursor.
-
Серверный агент, который будет выполнять основную логику по обработке текста. Логика может быть написана как кодом, так и с использованием визуальных low-code-фреймворков (Langflow, n8n, Dify).
-
Протокол общения: агенты должны общаться через протокол MCP (Model Context Protocol).
-
Генеративные ИИ-модели: для клиентского агента нужна модель принятия решений, которая поддерживает вызов функций (function calling), для серверного — модель для правки текста. Можно использовать две модели, либо выбрать одну универсальную.
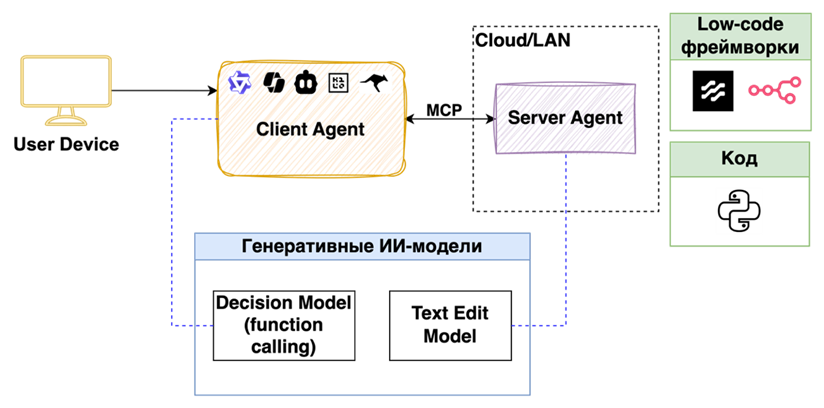
Первую версию ИИ-агента мы собрали за несколько часов и руководствовались принципом «Ни строчки кода»:
-
Поставили плагин Continue (имеет простой, не перегруженный интерфейс и базовый набор функций).
-
Подключили нашу внутреннюю модель (Qwen3-32b).
-
Визуально накидали логику в Langflow: загрузили глоссарий, написали промпты.
Как это работает:
-
Вы пишете текст в редакторе.
-
Вызываете агента.
-
Агент отправляет ваш текст «инструменту» (серверному агенту).
-
Инструмент проверяет текст по глоссарию и возвращает исправленный вариант.
-
Вам остаётся только нажать «Принять» или «Отклонить» правки.
Звучит здорово, правда?
Промышленная эксплуатация: когда «просто» перестаёт работать
Все было прекрасно, пока мы не скормили агенту серьёзный объём текста. Проблемы, с которыми мы столкнулись:
-
Контекстное окно. Модель получала глоссарий огромными кусками, и она «забывала» правки, которые внесла минуту назад.
-
Скорость и цена. Это работало медленно и потребляло слишком много ресурсов GPU.
-
Надёжность. Решение на визуальных блоках выглядело ненадежным для прод-среды.
Стало очевидно: чтобы ускорить и удешевить процесс, нужно делить текст на блоки и составлять для каждого из них свой мини-глоссарий. Но как понять, какие термины из общего глоссария (больше 700 штук) нужны для конкретного абзаца? Вручную искать долго. Тут на помощь пришёл векторный поиск.
Для реализации векторного поиска нам не понадобилось развёртывать кластер Kubernetes, всё работает локально прямо в памяти (In-Memory). Мы использовали:
-
векторное хранилище Qdrant,
-
Python-библиотеку qdrant-client,
-
готовую эмбеддинг-модель bge-m3, которая переводит слова в числа.
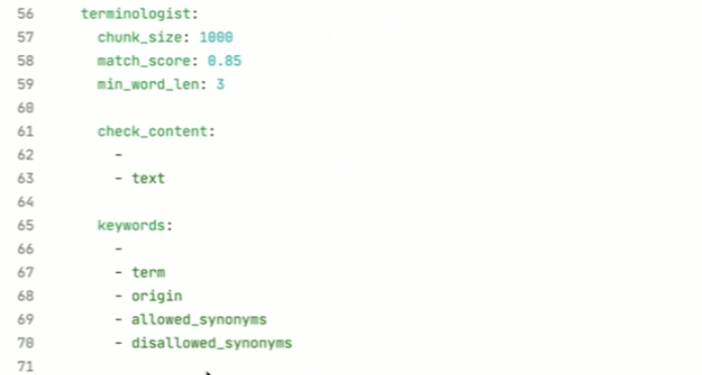
В каждой словарной статье глоссария мы выделили ключевые слова:
-
сам термин (term);
-
допустимые аналоги (allowed_synonyms);
-
термин на английском языке (origin);
-
нерекомендуемые синонимы (disallowed_synonyms).
Например, для словарной статьи ключевые слова будут такими (выделены полужирным):
|
Хотфикс: срочное обновление программного обеспечения, выпущенное для быстрого исправления критической ошибки или уязвимости Англоязычный термин: hotfix Пример употребления: хотфиксы отличаются от [патчей](#patch) тем, что их внедрение происходит быстрее и с минимальной подготовкой Допустимые аналоги: срочное исправление Нерекомендуемые синонимы: хот фикс, хот‑фикс, hot fix, hot‑fix |
Далее список ключевых слов мы перечислили через запятую и для каждого рассчитали числовой вектор. Записали полученный вектор в Qdrant вместе с самой словарной статьей. Словарная статья попадает в формате JSON в метаданные (payload): {"term": "...", "text": "..."}, где text — это и есть словарная статья.
Так как одно и то же описание (text) привязывается к разным ключевым словам (vector) одного термина, текст статьи дублируется в базе данных. Однако для относительно небольших глоссариев (не миллионы записей) избыточность данных незначительна, и ею можно пренебречь ради простоты архитектуры.
Пример структуры данных в базе Qdrant:
json
{
  "id": "уникальный_id_вектора",
  "vector": [0.123, -0.456, 0.789, "..."],
  "payload": {
    "term": "Agile",
    "text": "### AgilennГибкая методология разработки, фокусирующаяся на итеративном подходе..."
  }
}
Так мы наполнили векторную базу.
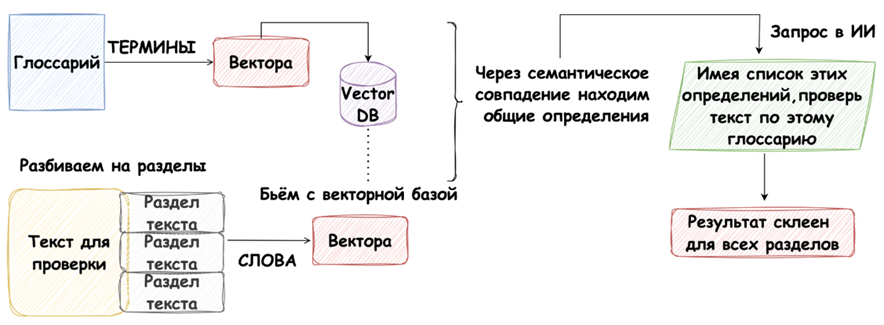
Теперь, когда к нам поступает текст на проверку терминологии, наш алгоритм следующий:
-
С помощью регулярного выражения мы разбиваем этот текст на слова:
text = "Это пример текста для разбиения на слова."
words = re.Findall(r'bw+b', text)
print(words)
Все извлечённые слова переводятся в нижний регистр. Короткие слова (менее 2–3 символов) автоматически отсекаются, чтобы убрать предлоги и союзы.
-
Для каждого полученного слова считаем вектор и ищем похожие векторы в нашей базе Qdrant. База возвращает список похожих векторов вместе со словарной статьёй в payload и метрикой схожести (Score).
Чтобы в глоссарий не попали случайные совпадения, вводим порог схожести (match score). Экспериментальным путем мы выставили порог 0,85—0,90. Если поставить порог слишком высоким (например, 0,99), то система потеряет неочевидные термины. Если опустить слишком низко — в итоговый глоссарий попадёт много «мусора». Баланс сильно зависит от используемой эмбеддинг-модели.
-
Генерируем мини-глоссарий для этого конкретного текста, по которому ИИ-агент будет проверять. Сначала мы удаляем повторы описания (text). Помним, что наши разные ключевые слова могли относиться к одной словарной статье. И теперь сортируем все уникальные статьи по алфавиту для удобства чтения. В итоге склеиваем всё в единый финальный Markdown-документ.
Вся схема работы сводится к простым шагам:
-
Берём общий глоссарий и превращаем термины в математические векторы (эмбеддинги) с помощью модели bge-m3.
-
Берём текст, который нужно проверить, и тоже векторизуем его по словам. Ищем векторные совпадения между векторами в хранилище и векторами проверяемого текста.
-
Получаем мини-глоссарий, релевантный только текущему тексту.
Это сделало процесс быстрым и интерактивным. Но в Langflow такой сложной логики из коробки не оказалось. Кастомизировать готовые блоки для нас оказалось дольше, чем… просто написать код.
Мы переписали всю логику на Python за один день (и ещё неделю отлаживали). Благо сейчас для этого есть отличные библиотеки (FastMCP, openai). Собственный код позволил нам полностью контролировать процесс: от парсинга глоссария до векторного поиска.
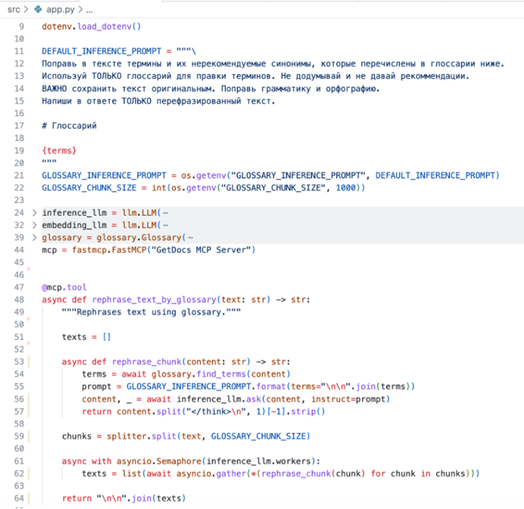
По пути мы столкнулись с ещё двумя важными нюансами:
-
Формат данных. Наш глоссарий был в Markdown. Оформление у разных авторов было разным (несогласованным). Чтобы загрузить его в векторную базу, пришлось писать парсер. В итоге мы перевели глоссарий в YAML — он и человекочитаемый, и машине его парсить легко.
-
Язык промпта. Изначально мы писали промпты для модели на русском языке. Качество правок было приемлемым, но когда мы перевели промпт на английский, результат улучшился в разы. Модели (даже те, что отлично понимают русский) часто лучше работают с инструкциями на английском.
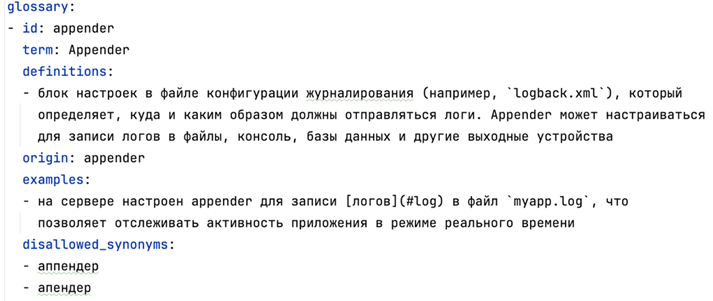
Часть глоссария в формате YAML
Мы предусмотрели конфигурацию, которая позволяет указывать в IDE для проверки как отдельные файлы, так и целый комплект документации из нескольких файлов, и, при желании, даже делать коммиты.
Чек-лист для тех, кто решит повторить наш путь
Прототип можно собрать быстро и без кода, используя визуальные конструкторы. Но для промышленной эксплуатации, где важны скорость, надёжность и экономия ресурсов, придётся писать код. К счастью, порог входа сейчас низкий.
Если вы хотите внедрить такого ИИ-агента у себя:
-
Разработайте глоссарий или воспользуйтесь нашими наработками. Лучше всего сразу использовать YAML-формат.
-
Начните с Low-code. Прототипируйте идею в Langflow или n8n, чтобы понять механику процесса.
-
Будьте готовы писать код. Для скорости и надёжности переходите на Python и векторные базы данных (например, Qdrant — он очень быстрый и легковесный).
Выводы про ИИ и планы на будущее
ИИ пока не заменит человека: ответы моделей могут содержать лишнюю информацию, а форматирование после правок иногда «плывет». Но как инструмент для ускорения работы и повышения согласованности документации — это уже не будущее, а настоящее.
О полном пути создания глоссария и внедрении его в производство мы подробно рассказали на международной конференции TechWriter Days/3.
Естественно, мы не собираемся останавливаться на достигнутом. Следующая цель — научить ИИ‑агента не просто проверять термины по глоссарию, но и учитывать требования нашего внутреннего руководства по стилю (редполитики).
Для реализации этой идеи мы разрабатываем полноценный MCP‑сервер с API. Всю программную логику переводим в формат отдельных «навыков» (skill) для агента, используя GigaCode CLI. Хотим, чтобы готовое решение получилось гибким: чтобы его можно было запустить как обычный скрипт, как локальный MCP‑сервер или обратиться к нему через API.
Подробный разбор того, как мы проектируем логику агента, пишем навыки и что из этого получилось, мы оставим для следующей статьи. Подписывайтесь, чтобы не пропустить!
Автор: mrbrhnv

