


В приложениях и агентах от AI не всегда нужен текст на несколько абзацев. Иногда достаточно выбрать категорию, проверить условие или поставить оценку. Я решил разобраться, даёт ли специализированная модель Jev от TypeSafe преимущества перед обычными LLM в таких задачах. Для проверки подготовил комментарии на русском и английском и сравнил качество ответов, скорость и стоимость.
Что такое Jev
Jev от TypeSafe рассчитан на задачи, в которых возможные ответы заданы заранее. Мы передаём данные и просим выбрать один из вариантов, оценить вероятность ответа “да” или поставить оценку по шкале. API возвращает структурированный результат, который можно использовать в программе без разбора текстовых объяснений. Обычную LLM тоже можно настроить на подобный ответ, например через JSON-схему. Поэтому наличие структурированного ответа само по себе ещё не преимущество Jev.
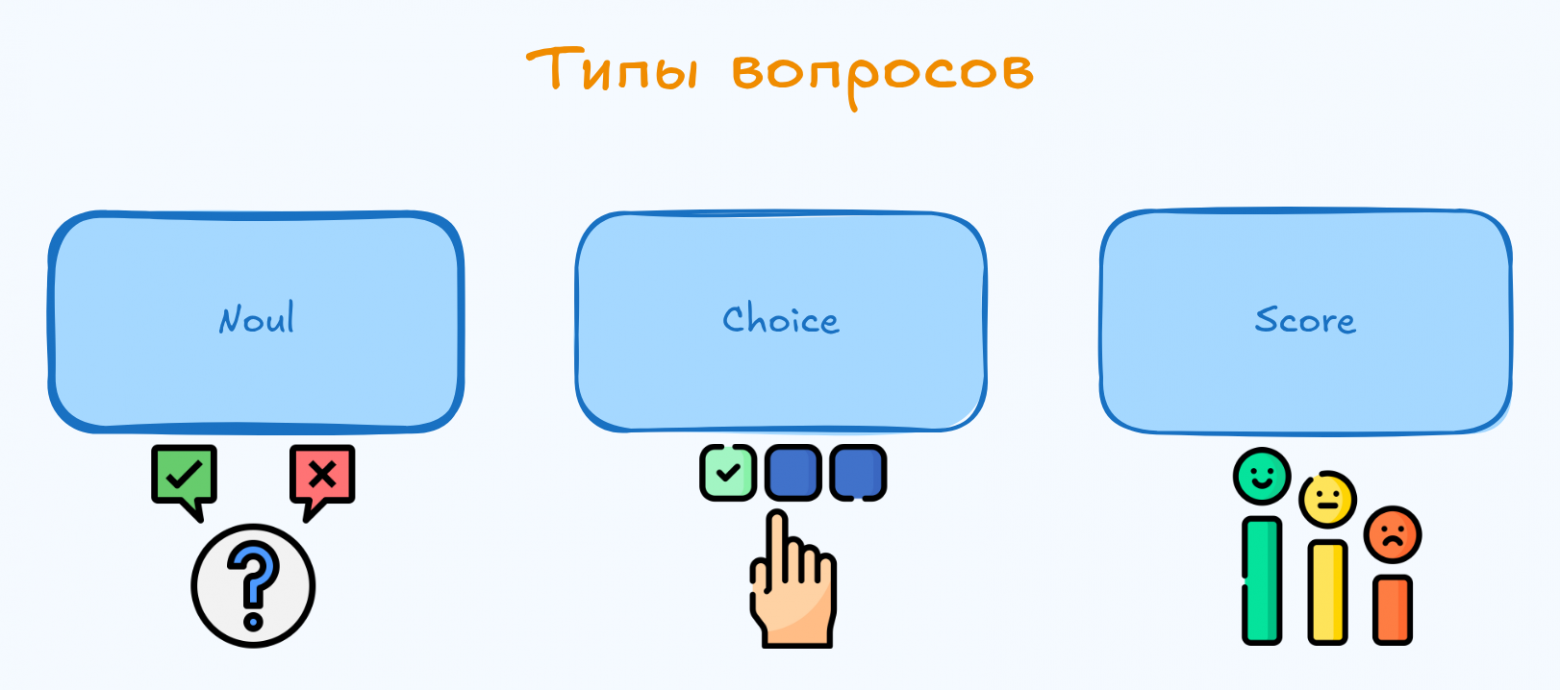
Три типа вопросов в Jev: Noul – вероятность ответа “да”, Choice – выбор одного варианта, Score – оценка по заданной шкале.
Тип вопроса выбираем под действие в коде: проверить условие, направить данные в нужную ветку или сравнить оценку с порогом.
Noul – вероятность ответа “да”
Noul нужен для вопросов с ответом “да” или “нет”. Но вместо true или false мы получаем число от 0 до 1 – оценку вероятности ответа “да”. Возьмём комментарий “Купи криптовалюту по моей ссылке и получи бонус!” и спросим модель: “Это спам?”.
Как устроен запрос
В этом примере обращаемся к Jev через OpenRouter. Отправляем POST-запрос на https://openrouter.ai/api/alpha/decisions с таким JSON:
{
    "model": "typesafe/jev-1.13",
    "state": {
        "comment": "Купи криптовалюту по моей ссылке и получи бонус!"
    },
    "questions": {
        "is_spam": {
            "type": "noul",
            "instructions": "Это спам?"
        }
    }
}
Разберём ключи:
|
Ключ |
Что означает |
|---|---|
|
|
Идентификатор модели, к которой обращаемся. |
|
|
Данные для анализа. Здесь передаём объект с текстом комментария. |
|
|
Поле с комментарием. Название |
|
|
Объект с вопросами к этим данным. В данном запросе вопрос один. |
|
|
Описание нашего вопроса. Имя |
|
|
Тип вопроса. Значение |
|
|
Формулировка вопроса на обычном языке. Здесь это “Это спам?”. |
Список вариантов criteria для этого примера не нужен. У Noul уже есть два возможных исхода: “да” и “нет”.
Как устроен ответ
При запуске noul_example.py получился такой результат:
{
    "type": "noul",
    "noul": 0.9
}
Здесь type указывает тип ответа, а noul содержит саму оценку. Значение 0.9 означает, что модель оценила вероятность ответа “да” на наш вопрос в 90%. Поскольку мы спрашивали про спам, это оценка вероятности того, что комментарий является спамом.
Выше показан ответ на один вопрос, а не весь HTTP-ответ. Скрипт достаёт его из объекта answers по тому же имени is_spam, которое мы задали в запросе:
answer = response.json()["answers"]["is_spam"]
probability = answer["noul"]
Строку с процентами в консоли формирует Python-скрипт: он выводит 0.9 как 90%. Это не отдельное поле ответа API.
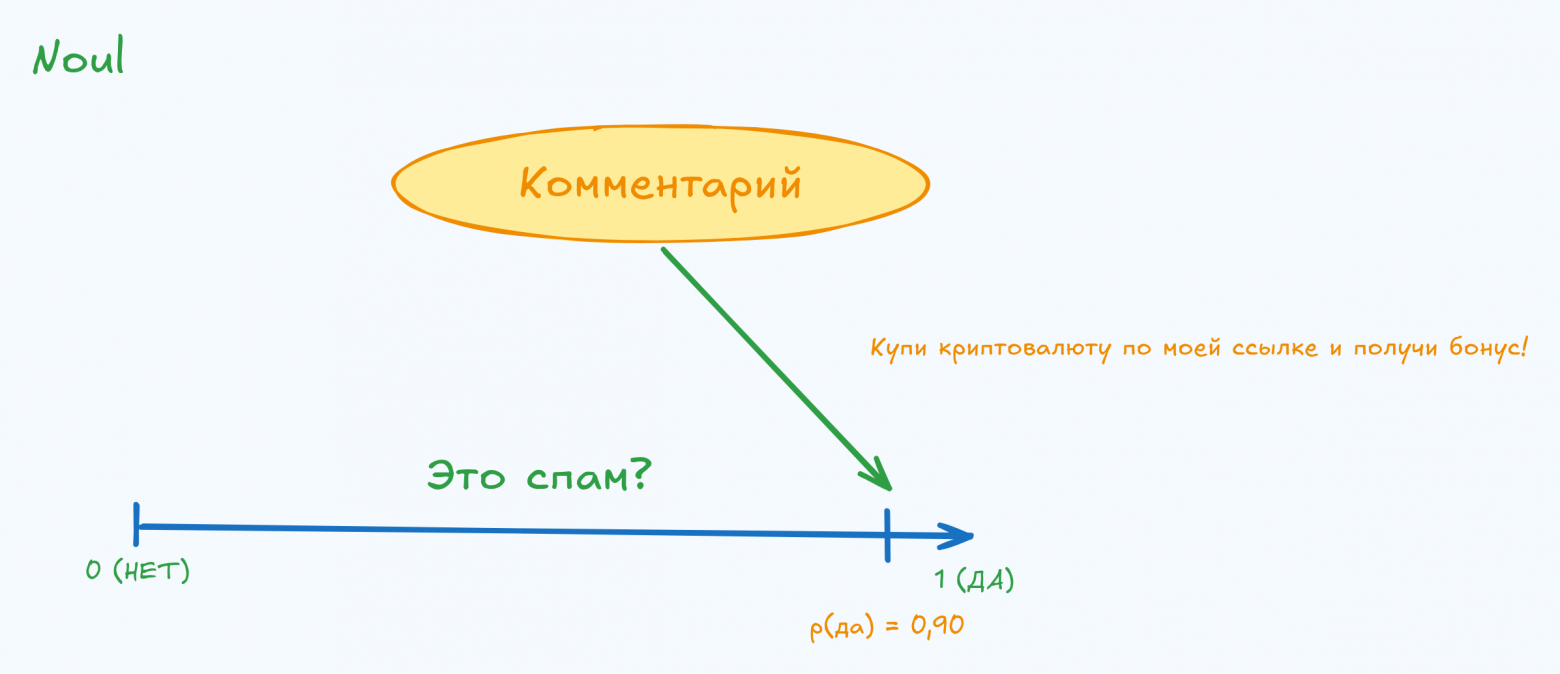
Ответ Noul на вопрос “Это спам?”: в этом запуске модель вернула 0,90, то есть 90%.
Модель оценивает вероятность спама, а порог отправки на модерацию задаём уже мы. При этом 0.9 – оценка для одного комментария, а не точность модели на всех данных.
Полный пример на Python
Для запуска нужны библиотеки requests и python-dotenv. API-ключ задаём в переменной окружения OPENROUTER_API_KEY или в файле .env проекта. Сам ключ в код не вставляем.
import json
import os

import requests
from dotenv import load_dotenv


URL = "https://openrouter.ai/api/alpha/decisions"
MODEL = "typesafe/jev-1.13"


def main() -> None:
    load_dotenv()
    api_key = os.environ["OPENROUTER_API_KEY"]

    payload = {
        "model": MODEL,
        "state": {
            "comment": "Купи криптовалюту по моей ссылке и получи бонус!"
        },
        "questions": {
            "is_spam": {
                "type": "noul",
                "instructions": "Это спам?",
            }
        },
    }

    response = requests.post(
        URL,
        headers={"Authorization": f"Bearer {api_key}"},
        json=payload,
        timeout=30,
    )
    response.raise_for_status()

    answer = response.json()["answers"]["is_spam"]
    probability = answer["noul"]

    print(json.dumps(answer, ensure_ascii=False, indent=2))
    print(f"Вероятность ответа "да": {probability:.0%}")


if __name__ == "__main__":
    main()
Choice – выбор одного варианта
Choice нужен, когда из нескольких вариантов требуется выбрать один. Например, определим, что перед нами: вопрос, похвала или спам. Это упрощённый пример с тремя категориями. В сравнительном тесте дальше будет шесть.
Как устроен запрос
Общая структура осталась прежней: model выбирает модель, state содержит данные, а questions описывает вопросы. Теперь передаём комментарий “Как подключить такую классификацию к Bitrix24” и задаём варианты ответа в criteria:
{
    "model": "typesafe/jev-1.13",
    "state": {
        "comment": "Как подключить такую классификацию к Bitrix24"
    },
    "questions": {
        "comment_type": {
            "type": "choice",
            "instructions": "Какой это комментарий?",
            "criteria": {
                "question": "Вопрос",
                "praise": "Похвала",
                "spam": "Спам"
            }
        }
    }
}
|
Ключ |
Что означает |
|---|---|
|
|
Текст, который нужно классифицировать. Имя |
|
|
Наш вопрос о категории комментария. Имя |
|
|
Значение |
|
|
Инструкция модели: что именно нужно определить. |
|
|
Объект с допустимыми вариантами ответа. |
|
|
Имена вариантов, которые мы придумали для кода. Строки справа объясняют модели смысл каждого варианта. |
В Choice варианты перечисляем сами. Ключ question в criteria – это название категории, а не специальное поле API. Вместо него можно выбрать другое имя, но именно это имя затем придёт в ответе.
Как устроен ответ
При запуске choice_example.py получили:
{
    "type": "choice",
    "choice": "question",
    "probabilities": {
        "question": 1,
        "praise": 0,
        "spam": 0
    },
    "confidence": 1
}
Это снова ответ на один вопрос, который скрипт достал из answers:
answer = response.json()["answers"]["comment_type"]
category = answer["choice"]
|
Ключ в ответе |
Что означает |
|---|---|
|
|
Тип ответа, в данном случае |
|
|
Ключ выбранного варианта. Здесь |
|
|
Вероятности всех вариантов из |
|
|
Оценка вероятности категории “Вопрос”. В этом запуске модель вернула 1. |
|
|
Оценки остальных категорий. В этом запуске обе равны 0. |
|
|
Сводный показатель уверенности от 0 до 1, рассчитанный из распределения вероятностей. |
По документации TypeSafe, confidence отражает, насколько распределение сосредоточено на одном исходе. Его не стоит путать с вероятностью конкретной категории: для неё есть отдельное значение в probabilities.
Модель выбрала “Вопрос”. Вероятность этой категории и confidence в этом запуске равны 1. Это не гарантия, что модель всегда права. Choice выбирает одну категорию, а не присваивает несколько меток одновременно.
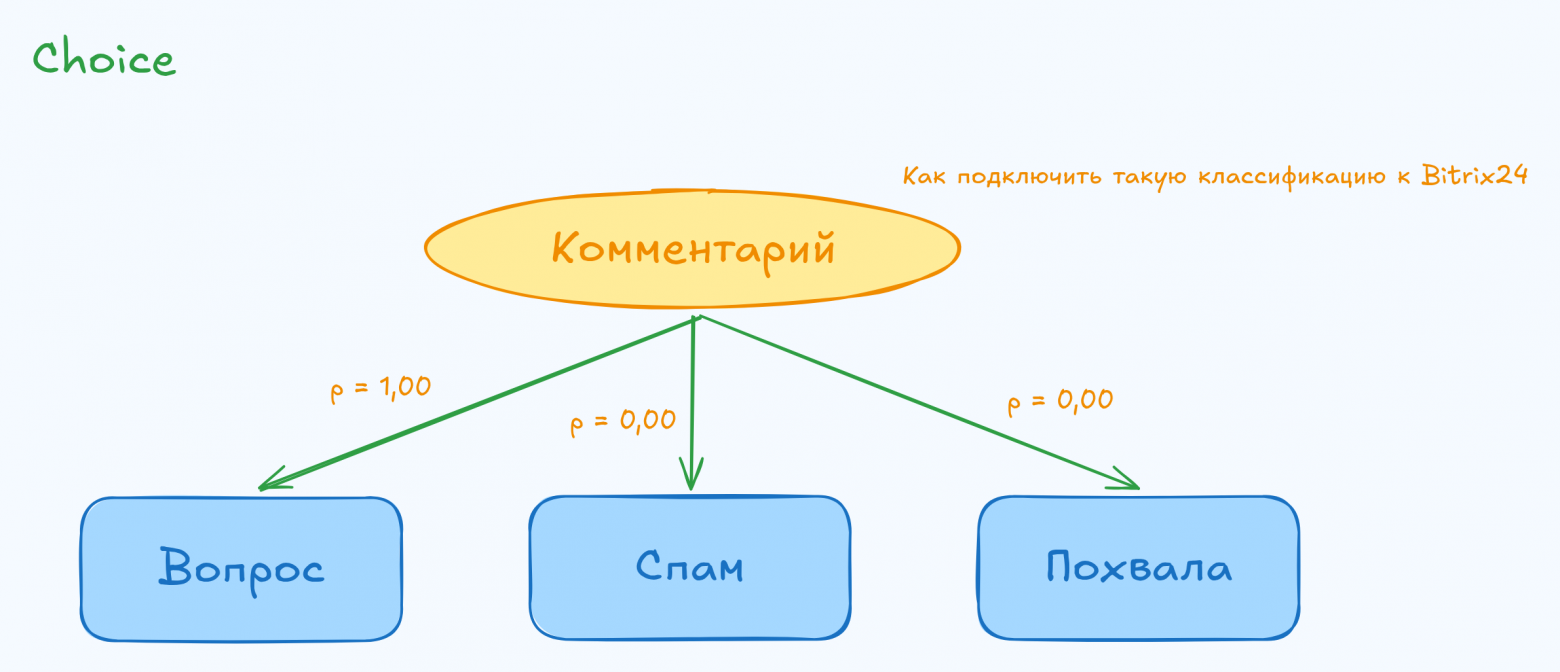
В этом запуске Choice выбрал “Вопрос”: вероятность 1,00, остальные категории получили 0,00.
Для такого комментария код может сразу выбрать ветку обработки вопросов автору. Разбирать текст ответа модели для этого не требуется: категория уже лежит в поле choice.
Полный пример Choice на Python
Используем те же библиотеки и переменную OPENROUTER_API_KEY, что и в примере Noul.
import json
import os

import requests
from dotenv import load_dotenv


URL = "https://openrouter.ai/api/alpha/decisions"
MODEL = "typesafe/jev-1.13"


def main() -> None:
    load_dotenv()
    api_key = os.environ["OPENROUTER_API_KEY"]

    payload = {
        "model": MODEL,
        "state": {
            "comment": "Как подключить такую классификацию к Bitrix24"
        },
        "questions": {
            "comment_type": {
                "type": "choice",
                "instructions": "Какой это комментарий?",
                "criteria": {
                    "question": "Вопрос",
                    "praise": "Похвала",
                    "spam": "Спам",
                },
            }
        },
    }

    response = requests.post(
        URL,
        headers={"Authorization": f"Bearer {api_key}"},
        json=payload,
        timeout=30,
    )
    response.raise_for_status()

    answer = response.json()["answers"]["comment_type"]
    category = answer["choice"]

    print(json.dumps(answer, ensure_ascii=False, indent=2))
    print(f"Выбранный вариант: {category}")


if __name__ == "__main__":
    main()
Score – оценка по заданной шкале
Score нужен, когда варианты ответа образуют упорядоченную шкалу. Например, хотим оценить, насколько негативен комментарий “Автор не разобрался в теме. Объяснение ужасное.”. Зададим три уровня: положительный или нейтральный, критический, агрессивный.
Как устроен запрос
{
    "model": "typesafe/jev-1.13",
    "state": {
        "comment": "Автор не разобрался в теме. Объяснение ужасное."
    },
    "questions": {
        "tone": {
            "type": "score",
            "instructions": "Насколько негативен комментарий?",
            "criteria": [
                "Положительный или нейтральный",
                "Критический",
                "Агрессивный"
            ]
        }
    }
}
Поля model, state и questions работают так же, как в предыдущих примерах. Разница в описании вопроса и его шкалы:
|
Ключ |
Что означает |
|---|---|
|
|
Комментарий, тон которого оцениваем. |
|
|
Наш вопрос об уровне негатива. Имя |
|
|
Значение |
|
|
Объясняет, что именно измеряем. |
|
|
Упорядоченный список описаний уровней, а не объект с названиями категорий, как у Choice. |
|
|
Уровень 0: “Положительный или нейтральный”. |
|
|
Уровень 1: “Критический”. |
|
|
Уровень 2: “Агрессивный”. |
Порядок элементов здесь важен: от него зависят номера уровней и итоговая оценка. Шкалу и её смысл задаём мы. В нашем примере она идёт от 0 до 2, а не от 0 до 1, как значение Noul.
Как устроен ответ
В одном из предыдущих запусков score_example.py получили:
{
    "type": "score",
    "score": 1.3,
    "legend": {
        "0": "Положительный или нейтральный",
        "1": "Критический",
        "2": "Агрессивный"
    },
    "probabilities": {
        "0": 0,
        "1": 0.7,
        "2": 0.3
    },
    "confidence": 0.55
}
Скрипт получает этот объект и итоговую оценку так:
answer = response.json()["answers"]["tone"]
score = answer["score"]
|
Ключ в ответе |
Что означает |
|---|---|
|
|
Тип ответа: |
|
|
Итоговая оценка на нашей шкале. Она может находиться между заданными уровнями. |
|
|
Соответствие номеров уровней их описаниям. Ключи |
|
|
Вероятности отдельных уровней. Здесь 0% для уровня 0, 70% для уровня 1 и 30% для уровня 2. |
|
|
Показатель уверенности, рассчитанный из распределения вероятностей. Это не сама оценка и не вероятность одного из уровней. |
Откуда взялось 1,3
По описанию API, score – среднее значение уровней с учётом их вероятностей. Для нашего ответа расчёт такой:
0 × 0,00 + 1 × 0,70 + 2 × 0,30 = 0 + 0,70 + 0,60 = 1,30
Перед знаком умножения стоит номер уровня, после него – вероятность этого уровня. Вклад нулевого уровня в сумму всегда равен нулю. Но его вероятность не бесполезна: если перенести часть вероятности с уровней 1 или 2 на уровень 0, средняя оценка уменьшится. Дополнительно делить сумму не нужно, потому что вероятности уже суммируются в единицу.
Наиболее вероятный отдельный уровень здесь “Критический”, но итоговая оценка равна 1,3, потому что модель также отвела 30% уровню “Агрессивный”. Это не вероятность и не “130% негатива”, а число на нашей шкале от 0 до 2. Поле confidence: 0.55 в этот расчёт не входит и не означает, что ответ верен с вероятностью 55%.
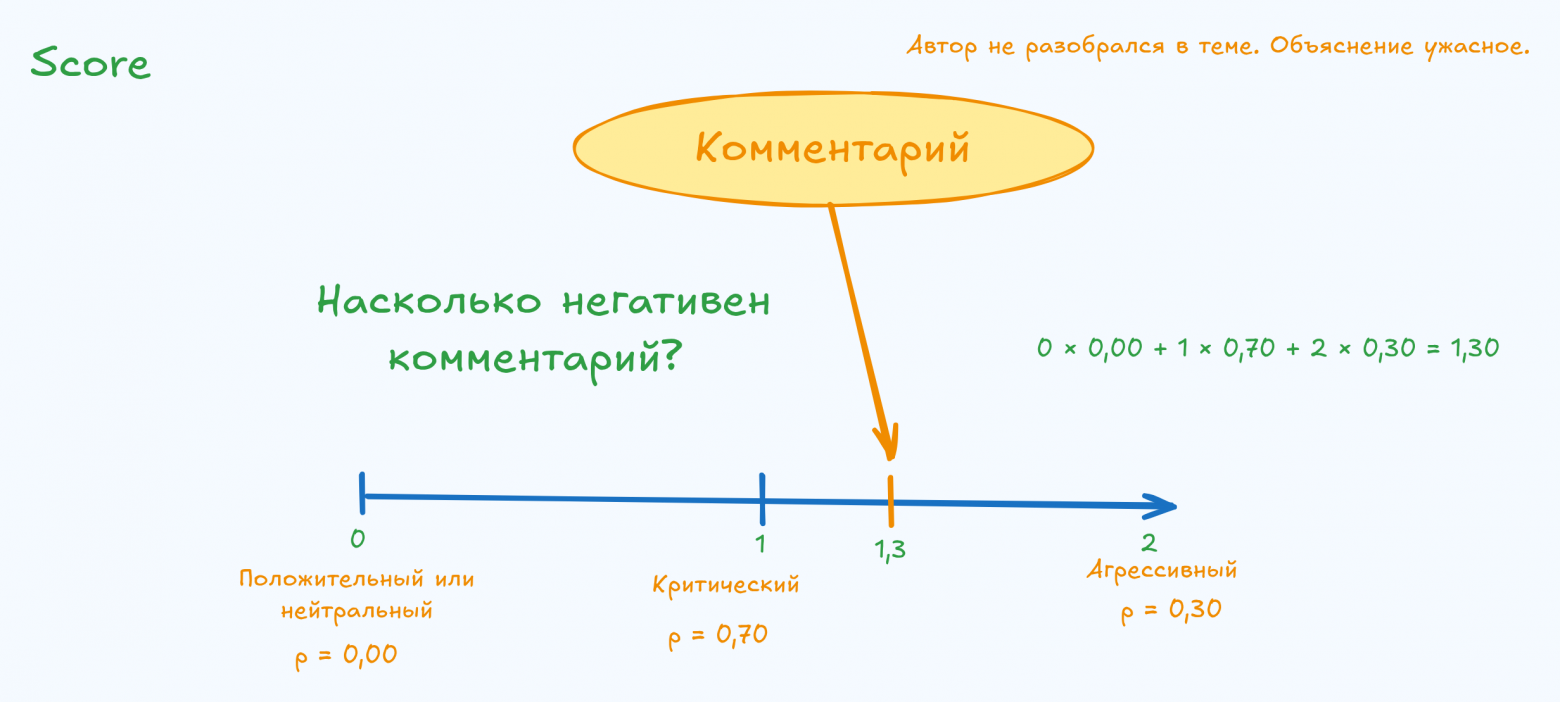
Оценка Score учитывает вероятности всех уровней: 70% для уровня 1 и 30% для уровня 2 дают среднее 1,3.
Здесь результат ближе к критике, чем к агрессии. При округлении до 1 этот сдвиг в сторону агрессии пропадёт.
Полный пример Score на Python
Используем те же библиотеки и переменную OPENROUTER_API_KEY.
import json
import os

import requests
from dotenv import load_dotenv


URL = "https://openrouter.ai/api/alpha/decisions"
MODEL = "typesafe/jev-1.13"


def main() -> None:
    load_dotenv()
    api_key = os.environ["OPENROUTER_API_KEY"]

    payload = {
        "model": MODEL,
        "state": {
            "comment": "Автор не разобрался в теме. Объяснение ужасное."
        },
        "questions": {
            "tone": {
                "type": "score",
                "instructions": "Насколько негативен комментарий?",
                "criteria": [
                    "Положительный или нейтральный",
                    "Критический",
                    "Агрессивный",
                ],
            }
        },
    }

    response = requests.post(
        URL,
        headers={"Authorization": f"Bearer {api_key}"},
        json=payload,
        timeout=30,
    )
    response.raise_for_status()

    answer = response.json()["answers"]["tone"]
    score = answer["score"]

    print(json.dumps(answer, ensure_ascii=False, indent=2))
    print(f"Оценка негатива: {score:.2f}")


if __name__ == "__main__":
    main()
Как я сравнивал модели
Для теста подготовил 50 синтетических комментариев на русском и перевёл их на английский. Заранее разметил категорию, наличие спама и уровень негатива.
Каждую задачу проверял отдельно: один комментарий, один вопрос, один запрос. LLM возвращали ответ по JSON-схеме, без объяснений. Время измерял на прогретых соединениях, от отправки запроса до получения полного ответа. Jev и DeepSeek проверил и через OpenRouter, и через прямые API.
В таблицах значения идут в порядке RU / EN. “Верно” – доля совпадений с разметкой, медиана – типичное время ответа, P95 – время, в которое укладывается примерно 95% ответов. Цена – за 50 комментариев одной задачи, без прогрева. ≈ отмечает расчёт по тарифу для прямых API, ≥ – нижнюю границу стоимости.
Qwen 3.5 9B тестировал в FP4, Mistral Small 3.2 24B – в FP8. Полные настройки, запросы и ответы сохранены вместе с результатами.
Noul – проверка на спам: результаты
Верным считается совпадение с эталоном: вероятность Jev от 0,5 означает спам. LLM возвращают готовое да/нет.
|
Модель |
Верно, RU / EN |
Медиана, мс |
P95, мс |
Цена за 50, $ |
|---|---|---|---|---|
|
Jev 1.13 |
100% / 98% |
408 / 412 |
531 / 697 |
0,000812 / 0,000665 |
|
Jev 1.13 · прямой API |
100% / 98% |
289 / 279 |
348 / 345 |
≈0,000812 / ≈0,000665 |
|
GPT-5.6 Sol |
100% / 100% |
1081 / 1104 |
1966 / 1706 |
0,043346 / 0,027416 |
|
GPT-6 Astra |
100% / 100% |
2180 / 1781 |
3342 / 2265 |
0,216730 / 0,137080 |
|
DeepSeek V4.1 Flash |
100% / 100% |
1795 / 1191 |
3891 / 3239 |
0,001966 / 0,001697 |
|
DeepSeek Flash · прямой API |
100% / 100% |
932 / 781 |
1075 / 1092 |
≈0,002055 / ≈0,001706 |
|
Qwen 3.5 9B |
98% / 100% |
1098 / 973 |
1463 / 1372 |
0,000746 / 0,000655 |
|
Mistral Small 3.2 24B |
100% / 100% |
489 / 475 |
1091 / 1059 |
0,000770 / 0,000597 |
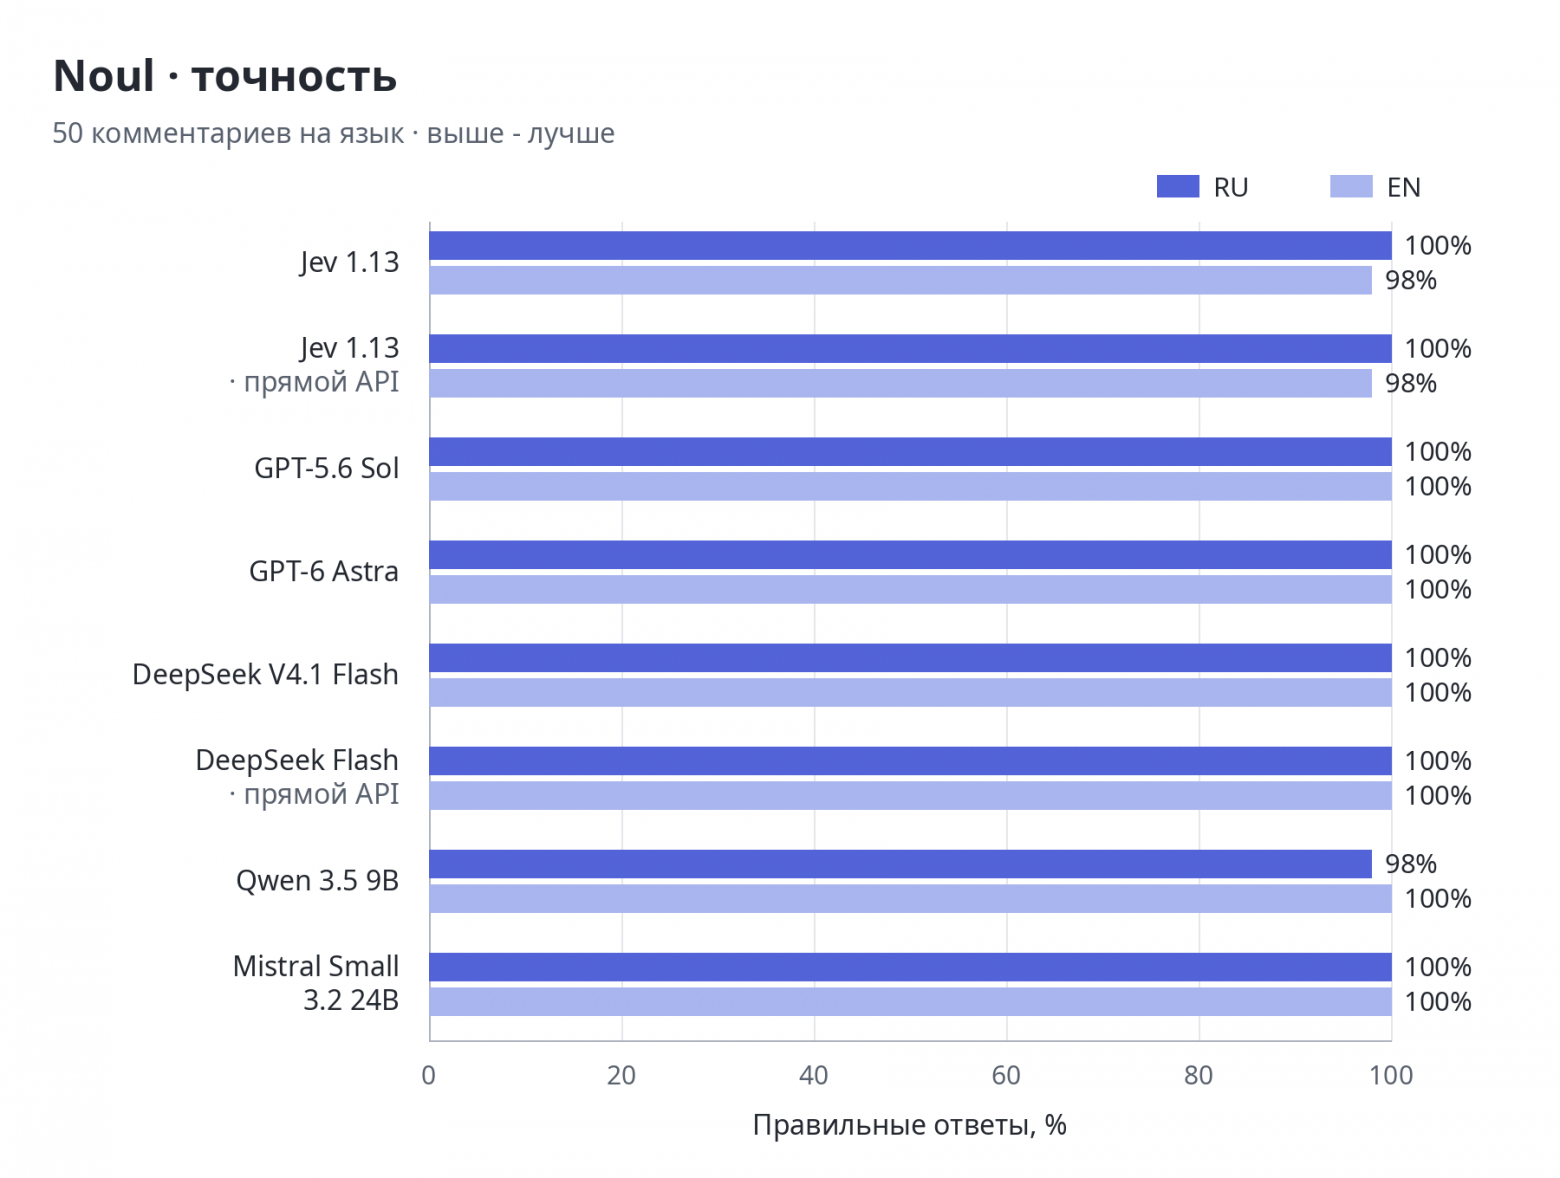
Noul: доля верных ответов при проверке на спам. RU – русский, EN – английский.
С определением спама большинство моделей справилось без ошибок. У Jev через оба API по одной ошибке на английском и ни одной на русском: на этом наборе разница в качестве небольшая.
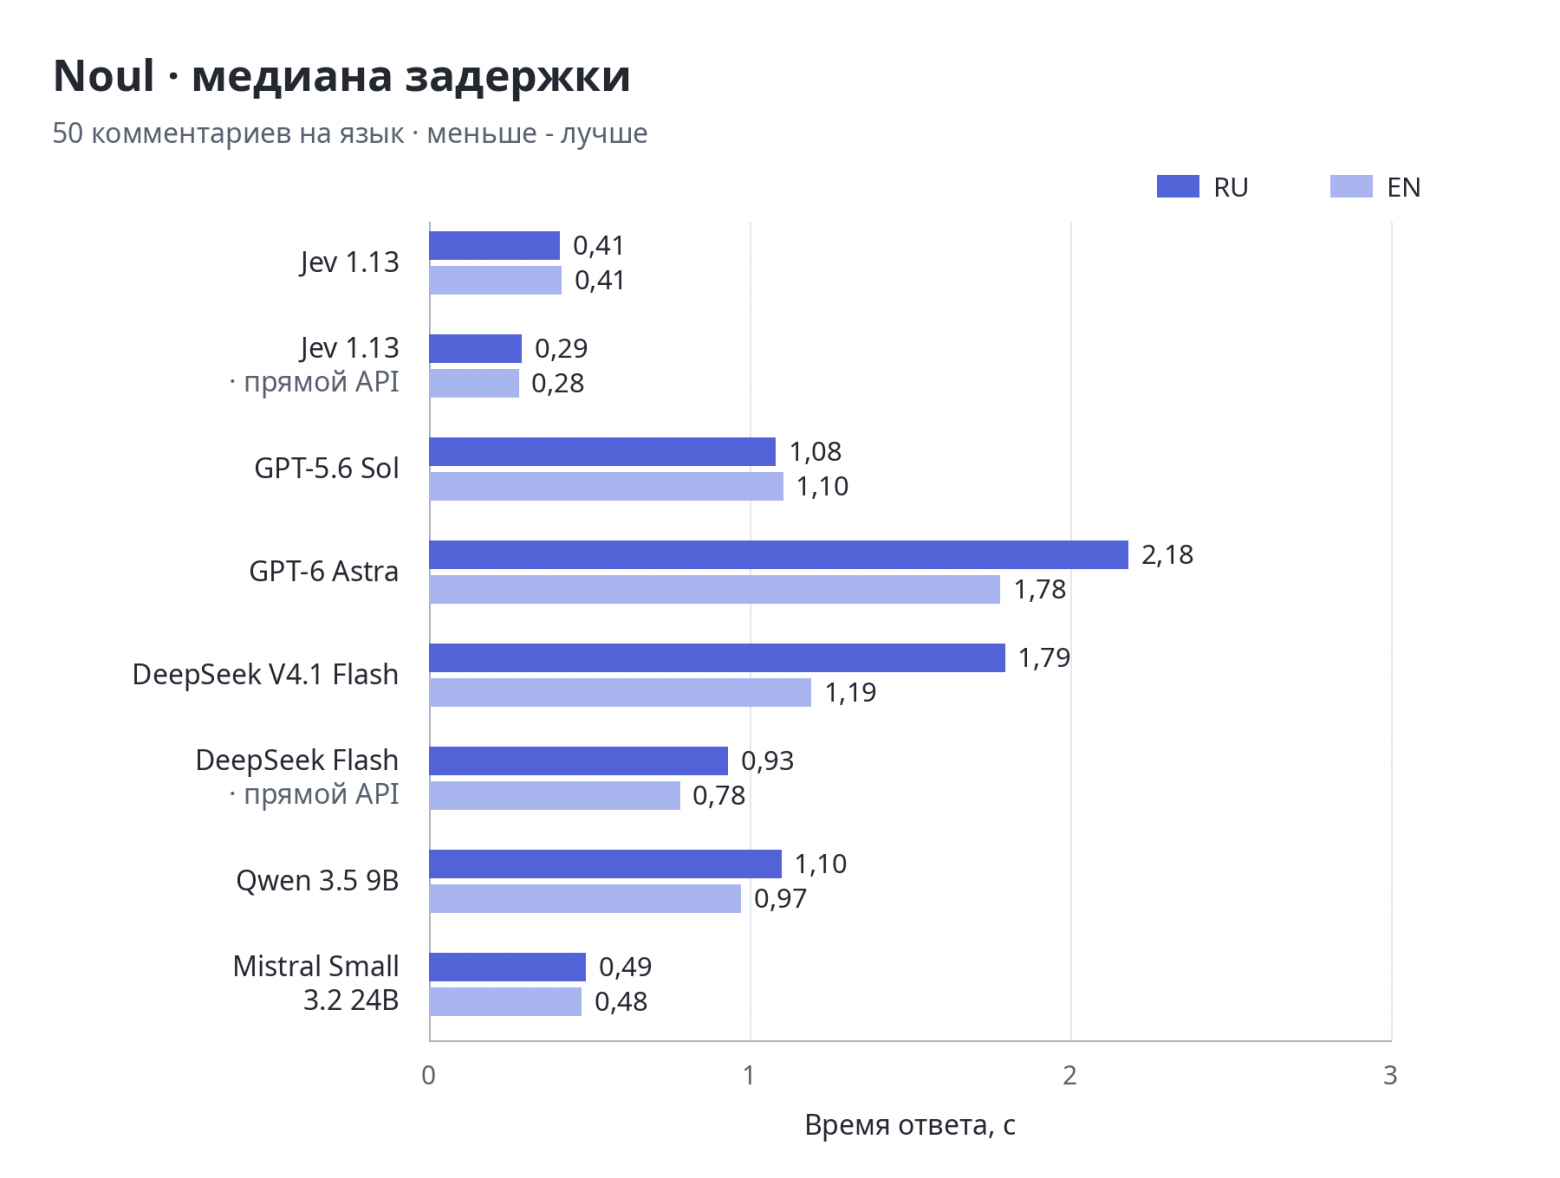
Noul: медиана времени ответа после прогрева. Меньше – быстрее.
По скорости разница заметнее: у прямого API Jev медиана 279-289 мс, у Jev через OpenRouter – 408-412 мс. Ближайшая по скорости LLM, Mistral, показала 475-489 мс.
Choice – категория комментария: результаты
Шесть категорий: вопрос, замечание или предложение, похвала, спам, оскорбление, другое.
|
Модель |
Верно, RU / EN |
Медиана, мс |
P95, мс |
Цена за 50, $ |
|---|---|---|---|---|
|
Jev 1.13 |
100% / 98% |
413 / 457 |
895 / 839 |
0,002104 / 0,001158 |
|
Jev 1.13 · прямой API |
100% / 98% |
284 / 279 |
320 / 342 |
≈0,002104 / ≈0,001158 |
|
GPT-5.6 Sol |
96% / 94% |
1464 / 1246 |
2211 / 2048 |
0,051496 / 0,040656 |
|
GPT-6 Astra |
96% / 100% |
1890 / 2065 |
2792 / 6654 |
0,279010 / ≥0,213460 |
|
DeepSeek V4.1 Flash |
90% / 94% |
1921 / 3607 |
6146 / 13994 |
0,001835 / 0,002437 |
|
DeepSeek Flash · прямой API |
94% / 98% |
816 / 808 |
1132 / 1120 |
≈0,001508 / ≈0,001897 |
|
Qwen 3.5 9B |
90% / 88% |
1637 / 1676 |
2364 / 2726 |
0,001113 / 0,001022 |
|
Mistral Small 3.2 24B |
82% / 80% |
698 / 661 |
2010 / 1923 |
≥0,001346 / 0,001086 |
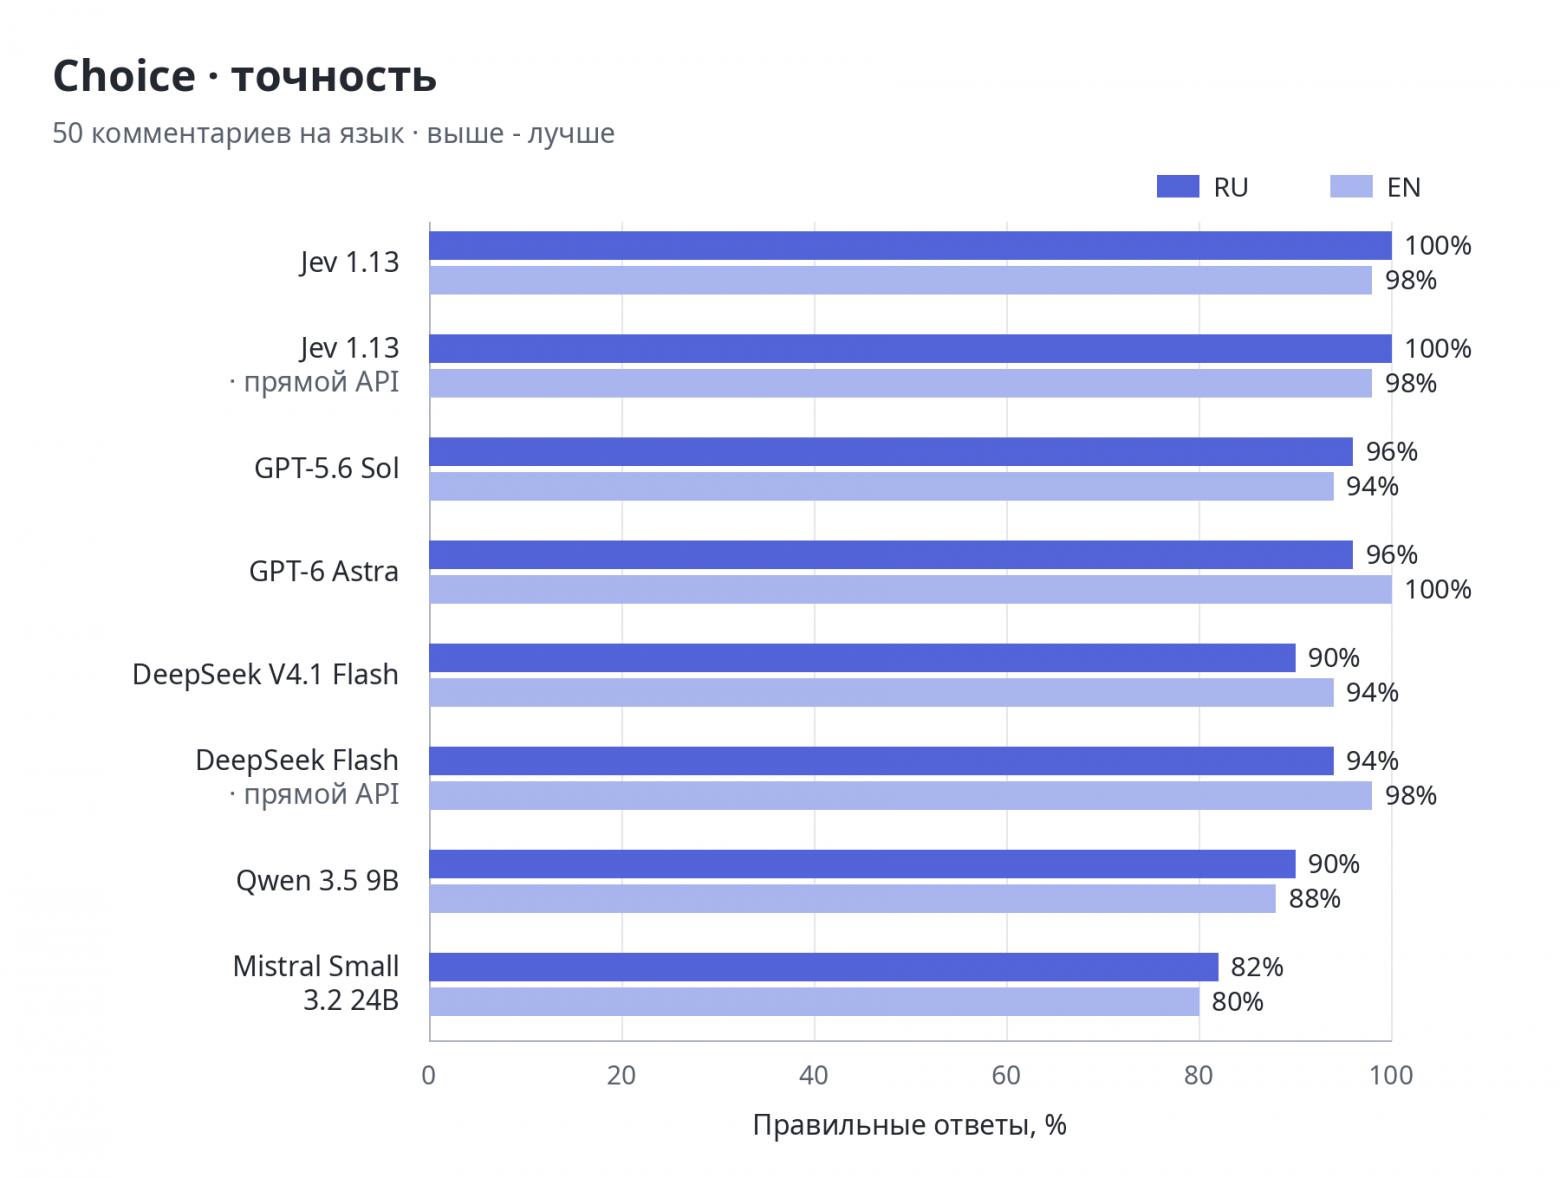
Choice: доля верных ответов при выборе одной из шести категорий комментария.
Jev через оба API правильно определил категории всех 50 комментариев на русском и 49 из 50 на английском. На английском без ошибок справилась Astra. Эти результаты получены после уточнения границы между похвалой и замечанием: я посмотрел ошибки и повторил тест для всех моделей на том же наборе.
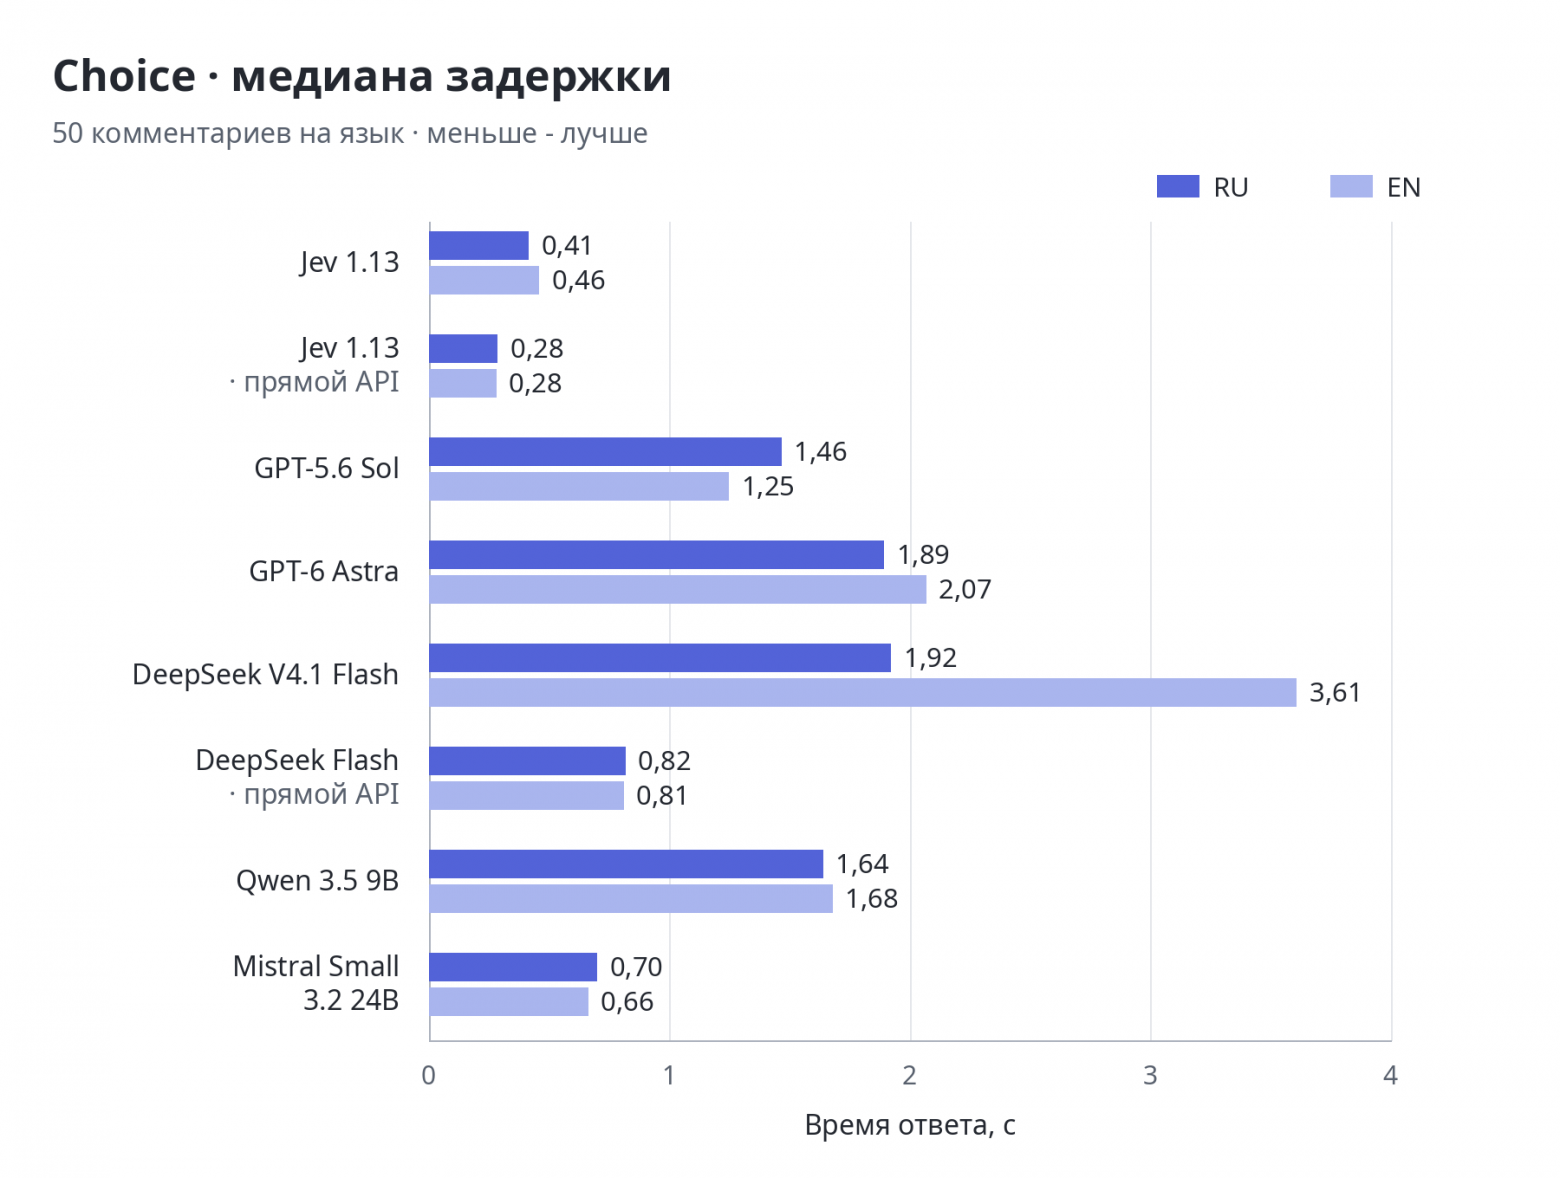
Choice: медиана времени ответа после прогрева. Меньше – быстрее.
Медиана прямого API Jev – 279-284 мс, а у самой быстрой LLM, Mistral, – 661-698 мс при меньшей доле верных ответов.
Score – уровень негатива: результаты
Сравниваем уровни 0, 1 и 2. Дробную оценку Jev округляем до ближайшего уровня, LLM сразу возвращают целый. Формулировки шкалы немного различались: уровень 1 у Jev – конструктивная критика, у LLM сюда также входят недовольство и сарказм.
|
Модель |
Верно, RU / EN |
Медиана, мс |
P95, мс |
Цена за 50, $ |
|---|---|---|---|---|
|
Jev 1.13 |
92% / 92% |
406 / 386 |
808 / 549 |
0,000978 / 0,000730 |
|
Jev 1.13 · прямой API |
92% / 92% |
272 / 288 |
337 / 368 |
≈0,000978 / ≈0,000730 |
|
GPT-5.6 Sol |
96% / 94% |
1128 / 1057 |
1553 / 1590 |
0,053546 / 0,031216 |
|
GPT-6 Astra |
92% / 92% |
2061 / 2046 |
2822 / 3197 |
0,276680 / 0,161830 |
|
DeepSeek V4.1 Flash |
78% / 82% |
1456 / 2001 |
5877 / 8446 |
0,001913 / 0,001632 |
|
DeepSeek Flash · прямой API |
82% / 78% |
894 / 839 |
1149 / 1096 |
≈0,001590 / ≈0,002122 |
|
Qwen 3.5 9B |
78% / 78% |
1055 / 1045 |
1655 / 1546 |
0,000885 / 0,000778 |
|
Mistral Small 3.2 24B |
74% / 74% |
683 / 466 |
1405 / 1502 |
0,000903 / 0,000723 |
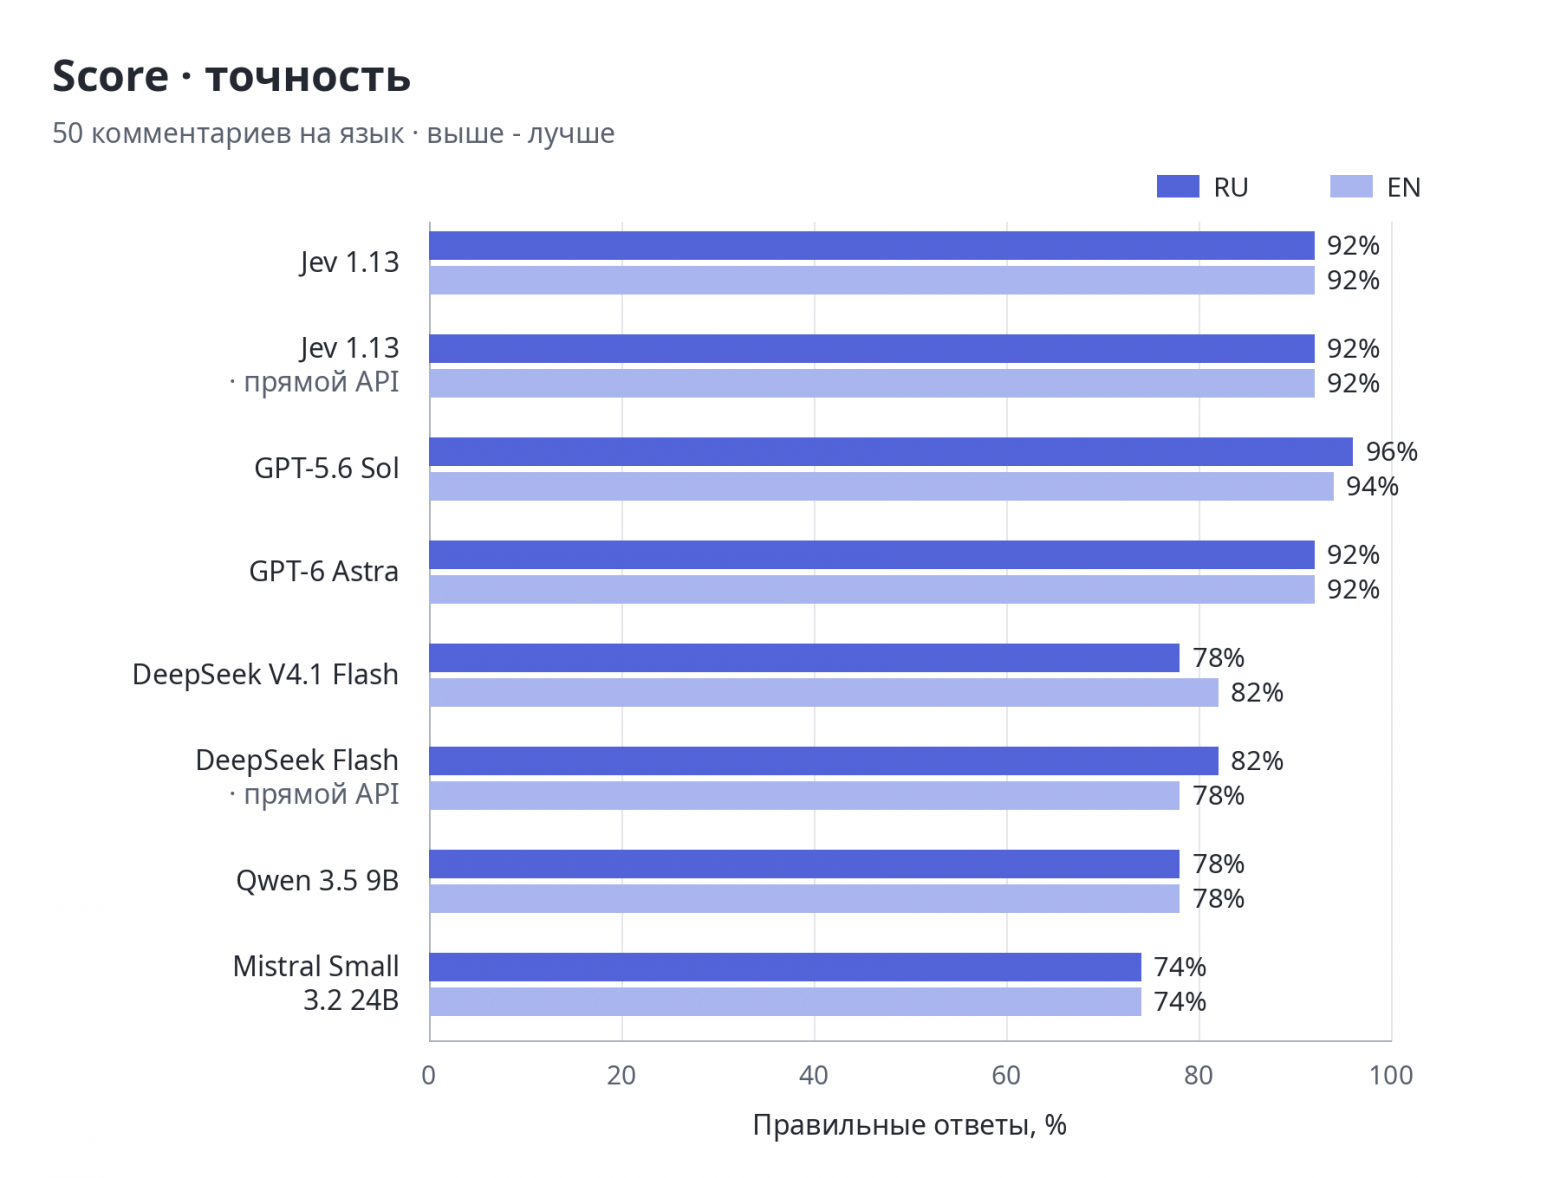
Score: доля совпадений с эталонным уровнем негатива – 0, 1 или 2.
При оценке негатива ответы GPT-5.6 Sol чаще остальных совпадали с разметкой: 96% на русском и 94% на английском. У обеих конфигураций Jev и у Astra – по 92%.
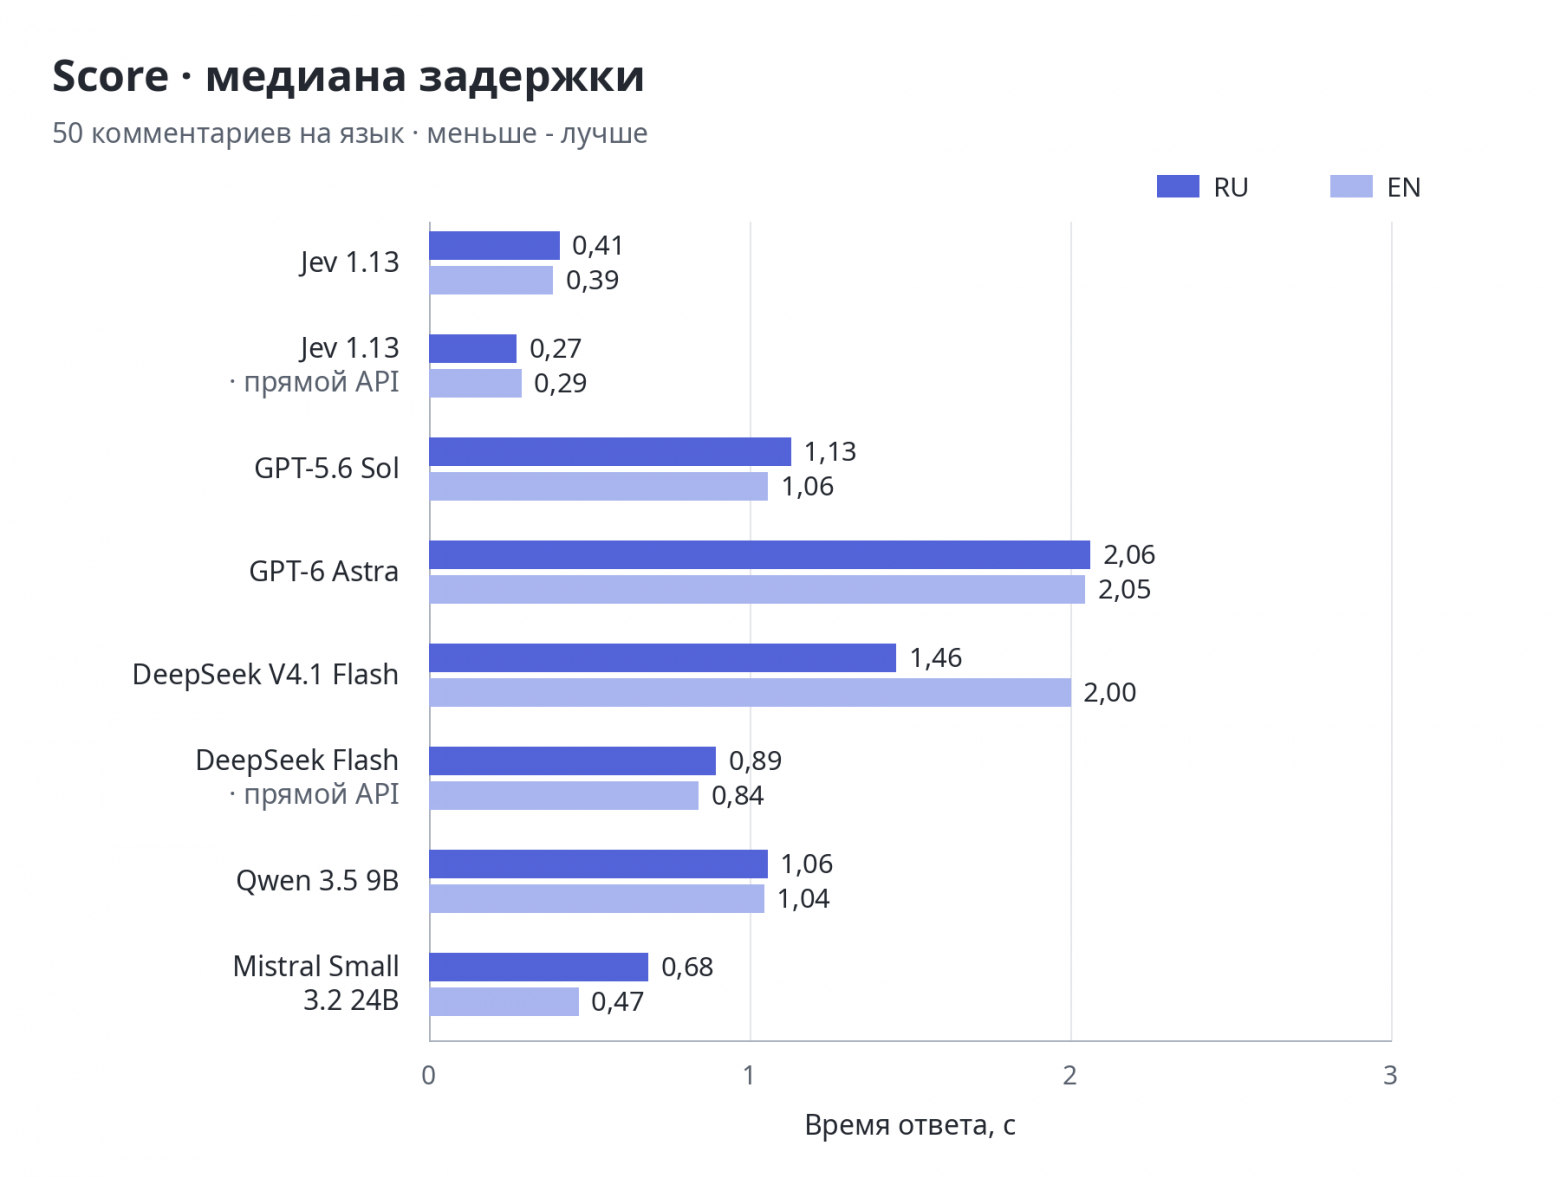
Score: медиана времени ответа после прогрева. Меньше – быстрее.
Прямой API Jev дал медиану 272-288 мс, а Sol – 1057-1128 мс. В нашем прогоне ответы Sol чаще совпадали с разметкой, но он отвечал примерно вчетверо дольше.
Что будет, если увеличить контекст
До этого в state находился один короткий комментарий. Теперь я передал историю из 197 синтетических комментариев и попросил определить, задавал ли кто-то раньше вопрос с таким же смыслом. Получился запрос на 31 273 входных токена по счётчику Jev – близко к лимиту 32k для state и одного вопроса. Остальным моделям отправил тот же текст.
Новый вопрос:
Как после завершения монтажа удалить только прокси-файлы, сохранив исходные видеозаписи и сам монтажный проект?
В середине истории, под номером c00099, уже был такой комментарий:
Ролик уже собран. Подскажите, как убрать облегчённые рабочие копии, которые редактор создал для плавного предпросмотра? Оригинальные клипы и файл с монтажом должны остаться на диске.
Правильный ответ – “да”. Формулировки разные, но действие и условия совпадают. Рядом были похожие вопросы про создание прокси и удаление оригиналов, которые дубликатами не являются.
Полная история и новый вопрос лежат в state.json, а правила сравнения – в instructions.txt. Запрос к прямому API Jev собирается так:
import json
from pathlib import Path

state = json.loads(Path("state.json").read_text(encoding="utf-8"))
instructions = Path("instructions.txt").read_text(encoding="utf-8").strip()

payload = {
    "model": "jev-1.13.0",
    "state": state,
    "questions": {
        "duplicate": {
            "type": "noul",
            "instructions": instructions,
        }
    },
}
В state.history находятся комментарии, в state.new_question – новый вопрос. В инструкции уточнил, что совпадения темы или отдельных слов недостаточно: важен смысл просьбы.
Каждой конфигурации отправил запрос дважды. В таблице время и цена обоих запросов, ответ указан для повтора.
|
Модель |
Ответ |
Первый запрос, с |
Повтор, с |
Цена первого / повтора, $ |
|---|---|---|---|---|
|
Jev 1.13 |
Да |
0,754 |
0,543 |
0,001313 / 0,001313 |
|
Jev 1.13 · прямой API |
Да |
1,327 |
0,545 |
≈0,001313 / ≈0,001313 |
|
GPT-5.6 Sol |
Да |
1,988 |
2,890 |
0,030959 / 0,002611 |
|
GPT-6 Astra |
Да |
2,260 |
3,066 |
0,154793 / 0,013055 |
|
DeepSeek V4.1 Flash |
Да |
4,845 |
0,636 |
0,001682 / 0,004181 |
|
DeepSeek Flash · прямой API |
Да |
1,365 |
1,103 |
≈0,002097 / ≈0,000065 |
|
Mistral Small 3.2 24B · FP8 |
Да |
2,177 |
1,764 |
0,001115 / 0,001115 |
Jev через оба API ответил примерно за 0,54 секунды на повторе. Прямой API вернул вероятность “да” 0,89, через OpenRouter – 0,86. Это один пример с большим контекстом, а не оценка общей точности моделей.
На повторе прямой DeepSeek, Sol и Astra использовали кэш входного текста, поэтому цена заметно снизилась. У DeepSeek через OpenRouter между запросами сменился провайдер. Разницу между первым запросом и повтором нельзя объяснить только прогревом соединения.
Что я для себя вынес
В моих тестах Jev оказался быстрым вариантом для задач с заданным форматом ответа. На коротких комментариях медиана прямого API составила 272-289 мс, а качество в выборе категории и определении спама было сопоставимо с более крупными моделями. С длинной историей Jev тоже справился.
При оценке негатива ответы GPT-5.6 Sol чаще совпадали с разметкой. Qwen и Mistral в некоторых задачах на коротких комментариях стоили дешевле Jev. После уточнения границы между похвалой и замечанием ошибок в Choice стало меньше.
Для приложения или агента я бы рассматривал Jev там, где нужно быстро выбрать ветку: определить категорию, проверить условие или поставить оценку. Задачи, которым нужны объяснение, генерация текста или более сложное рассуждение, оставил бы LLM. Но перед подключением всё равно проверил бы модель на своих данных – особенно на случаях, где категории пересекаются.
Jev – семантический if внутри системы, а не замена всей системе.
Код и данные
Примеры запросов, код бенчмарков, тестовые данные и результаты выложил на GitHub: jev-llm-benchmarks. В README есть команды запуска. Сохранённые результаты можно посмотреть без API-ключей.
Автор: NullPilot

