


Выучить язык – это абстрактная цель
Всем привет!
Я долгое время пытался выучить английский язык. Но цель “выучить язык” ощущалась слишком большой и недостижимой. Мне казалось, что сколько бы усилий я ни прилагал, реально пользоваться английским языком я смогу только в каком-то далеком будущем. Изучение новой темы грамматики или зазубривание нового списка слов не давало ощущения прогресса. Это демотивировало и приводило к тому, что изучение языка хотелось забросить.
Но я решил поставить себе вполне измеримую цель: Прочитать любимую книгу в оригинале. Такая цель достижима, а ее выполнение дает ощущение прогресса не когда-то потом, а прямо сейчас.
Традиционный подход
Я открыл книгу и начал читать, чтобы оценить масштаб проблемы. Приходилось переводить чуть ли не каждое второе слово. Это делало процесс медленным и утомительным. Однако я понял, что не все слова одинаково важны. Некоторые слова многократно повторялись, и я решил такие слова заранее изучить.
Частотный подход
Введем несколько терминов:
-
“Лемма” – начальная словарная форма слова. Например: go.
-
“Словоформы” – различные грамматические формы одного слова. Для go это: go, goes, went, gone, going.
-
“Словоупотребление” – отдельный случай употребления слова в тексте. Например, если слово go и его словоформы встречаются в книге 100 раз, это соответствует 100 словоупотреблениям.
-
Далее, когда я пишу «Слово», я имею в виду именно его начальную словарную форму.
Применение частотного подхода к изучению иностранных языков многократно упоминалось на Хабре. Вот интересные статьи, где используется этот метод: [1, 2, 3]. Кратко рассмотрим суть подхода на примере.
Книга “The Catcher in the Rye” (рус. “Над пропастью во ржи”) Джерома Дэвида Сэлинджера состоит из 75901 словоупотребления. Если все встретившиеся словоформы привести к начальной форме (лемматизировать), получится 3085 уникальных слов. При этом такие слова, как I, be, the, and, встречаются тысячи раз, в то время как значительная часть слов (1105 слов) встречается по одному разу.
Скрытый текст
Статистика может немного отличаться в зависимости от редакции книги, алгоритмов обработки и лемматизации текста, но общая картина останется примерно такой же.
Для каждого слова частота рассчитывается с учетом всех его словоформ, например, частота глагола go включает все вхождения словоформ go, goes, went, gone, going.
Незнание частого слова приводит к тому, что человек запинается чуть ли не в каждом предложении. Незнание редкого слова вызывает только одну или несколько запинок в течение всей книги, при этом общий смысл текста обычно остается понятным.
Посмотрим на охват текста наиболее частыми словами.
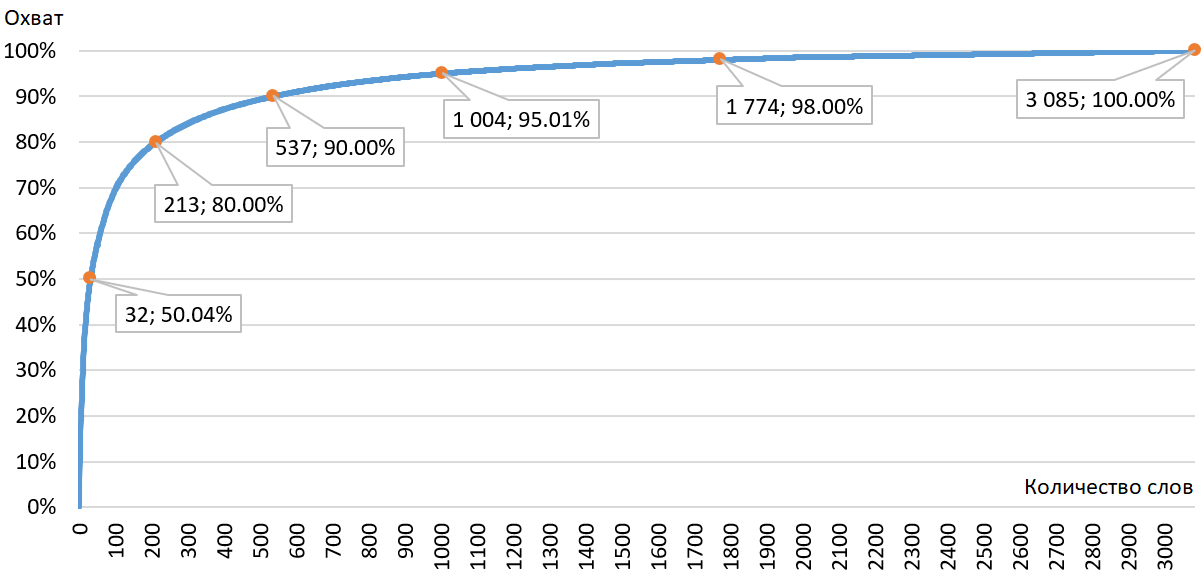
Первые 32 наиболее частых слова охватывают 50% словоупотреблений в тексте. 213 наиболее частых слов уже составляют 80% словоупотреблений книги.
Согласно исследованиям [4, 5], для комфортного чтения нужно знать слова, покрывающие 95–98% словоупотреблений в тексте. Это не строгое правило, полнота понимания текста плавно растет с увеличением количества известной лексики. Для разных людей и разных текстов этот уровень может быть разным. Я при подготовке ориентируюсь на 90% покрытие словоупотреблений. За счет того, что часть оставшихся слов может быть заранее известна, плюс оставшиеся слова могут быть производными от уже изученных или понятны из контекста, суммарное покрытие знакомых словоупотреблений как раз получается близким к рекомендуемому диапазону.
Для 90% покрытия словоупотреблений в книге “The Catcher in the Rye” необходимо знать 537 наиболее частых слов. Выучить столько слов является большой, но выполнимой задачей.
Я смоделировал, как человек, словарный запас которого покрывает ровно 90% словоупотреблений, видит текст книги. Для этого я заменил в книге “The Catcher in the Rye” все слова (и словоформы), не вошедшие в словарь из 537 самых частых слов (и их словоформ), на “blah-blah“. Для такого человека текст книги будет выглядеть вот так:
“If you really want to hear about it, the first thing you will probably want to know is where I was blah-blah, and what my lousy blah-blah was like, and how my parents were blah-blah and all before they had me, and all that blah-blah blah-blah kind of crap, but I do not feel like going into it, if you want to know the truth. In the first place, that stuff bores me, and in the second place, my parents would have about two blah-blah blah-blah if I told anything pretty blah-blah about them…”
При таком количестве “blah-blah” сложно полностью понять сюжет книги, особенно если вы раньше не читали ее в переводе.
Я начинал чтение англоязычных книг с адаптированной литературы, где лексика упрощена, и знание буквально нескольких сотен слов было достаточно для комфортного чтения. Затем я перешел к произведениям, которые уже читал в русскоязычном переводе. Примерно после десяти книг я стал читать совершенно новые для себя книги сразу в оригинале.
Специфичность
При чтении научно-популярной литературы я столкнулся с тем, что простого частотного подхода недостаточно. Специализированная литература наполнена тематической лексикой и терминами, которые могут не попасть в диапазон покрытия 90%, но при этом несут большую смысловую нагрузку.
Для быстрого погружения в предметные области я провожу оценку относительной частоты слов и выбираю те слова, которые в данной книге встречаются гораздо чаще, чем в языке в целом. Отношение частоты слова в книге к частоте во всем языке я называю “специфичностью”.
При достаточном уровне владения языком можно вообще не ориентироваться на частотный словарь и процент покрытия. При подготовке к чтению специализированной литературы можно анализировать только специфичность слов и изучать только специализированную лексику и термины.
Для оценки применимости такого подхода я взял книгу “A Brief History of Time” Стивена Хокинга и выбрал все слова со специфичностью 20 и выше, но с условием, что каждое слово используется в книге более трех раз. За базовый частотный словарь я беру wordfreq, который создавался на большом корпусе текстовой информации из разных источников и тематических областей. Полученные слова я разметил по категориям: астрофизика и космология, физика и астрономия, научная тематика и общеязыковые слова. Вот результаты:
|
Категория |
Количество слов |
Доля |
|
Астрофизика и космология |
47 |
22,2% |
|
Физика и астрономия |
85 |
40,1% |
|
Научная тематика |
64 |
30,2% |
|
Общеязыковое слово |
16 |
7,5% |
|
Всего специфичных слов |
212 |
|
Среди специфичных слов 92,5% оказались связаны с наукой, а 62,3% непосредственно относятся к физике, астрофизике, астрономии или космологии. Примеры найденных слов: relativity, singularity, supergravity, antiparticle, gluon, graviton, quark, wormhole.
Доведение перевода до автоматизма
Для комфортного чтения перевод слов должен происходить автоматически, без запинки. В идеале нужно начать понимать значение слова вообще без перевода на русский язык. Такой степени знания слов мне удается достичь за счет метода интервальных повторений, который позволяет эффективно переносить слова в долговременную память [6].
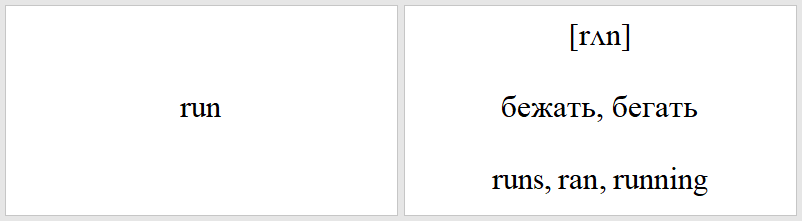
Для каждого слова я делаю двустороннюю карточку. С лицевой стороны я пишу английское слово. С обратной стороны – транскрипцию, перевод и различные словоформы.
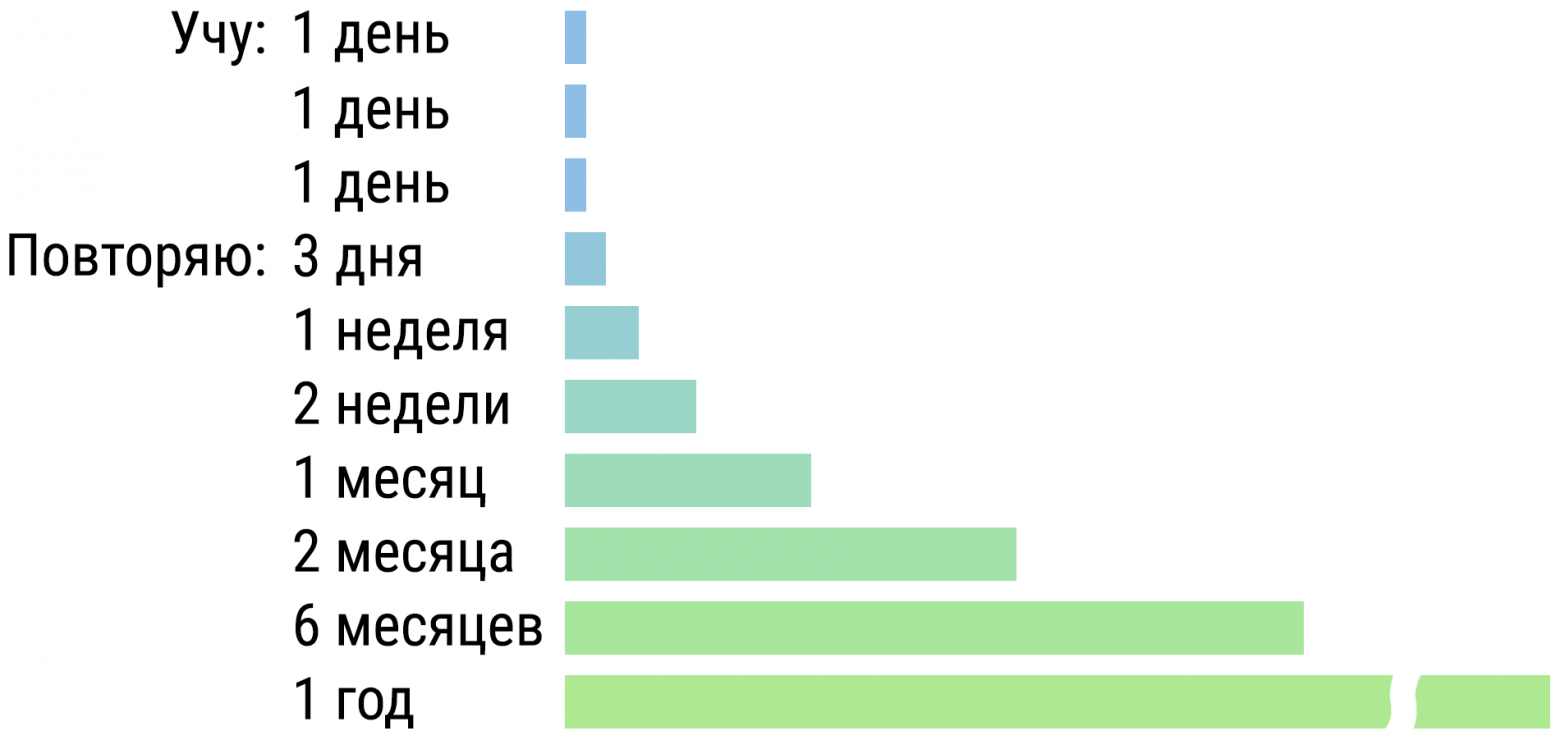
Каждое слово я учу три дня. Затем я повторяю слова с интервалами между повторениями в 3 дня, 7 дней, 2 недели, 1 месяц, 2 месяца, полгода и год.
Слова я объединяю в группы и учу стопками. Дату следующего повторения я пишу на верхней карточке в стопке. При повторе я смотрю на слово и пытаюсь вспомнить произношение и перевод, затем переворачиваю карточку и проверяю себя. Если я ошибаюсь, то скидываю слово в более молодую стопку.
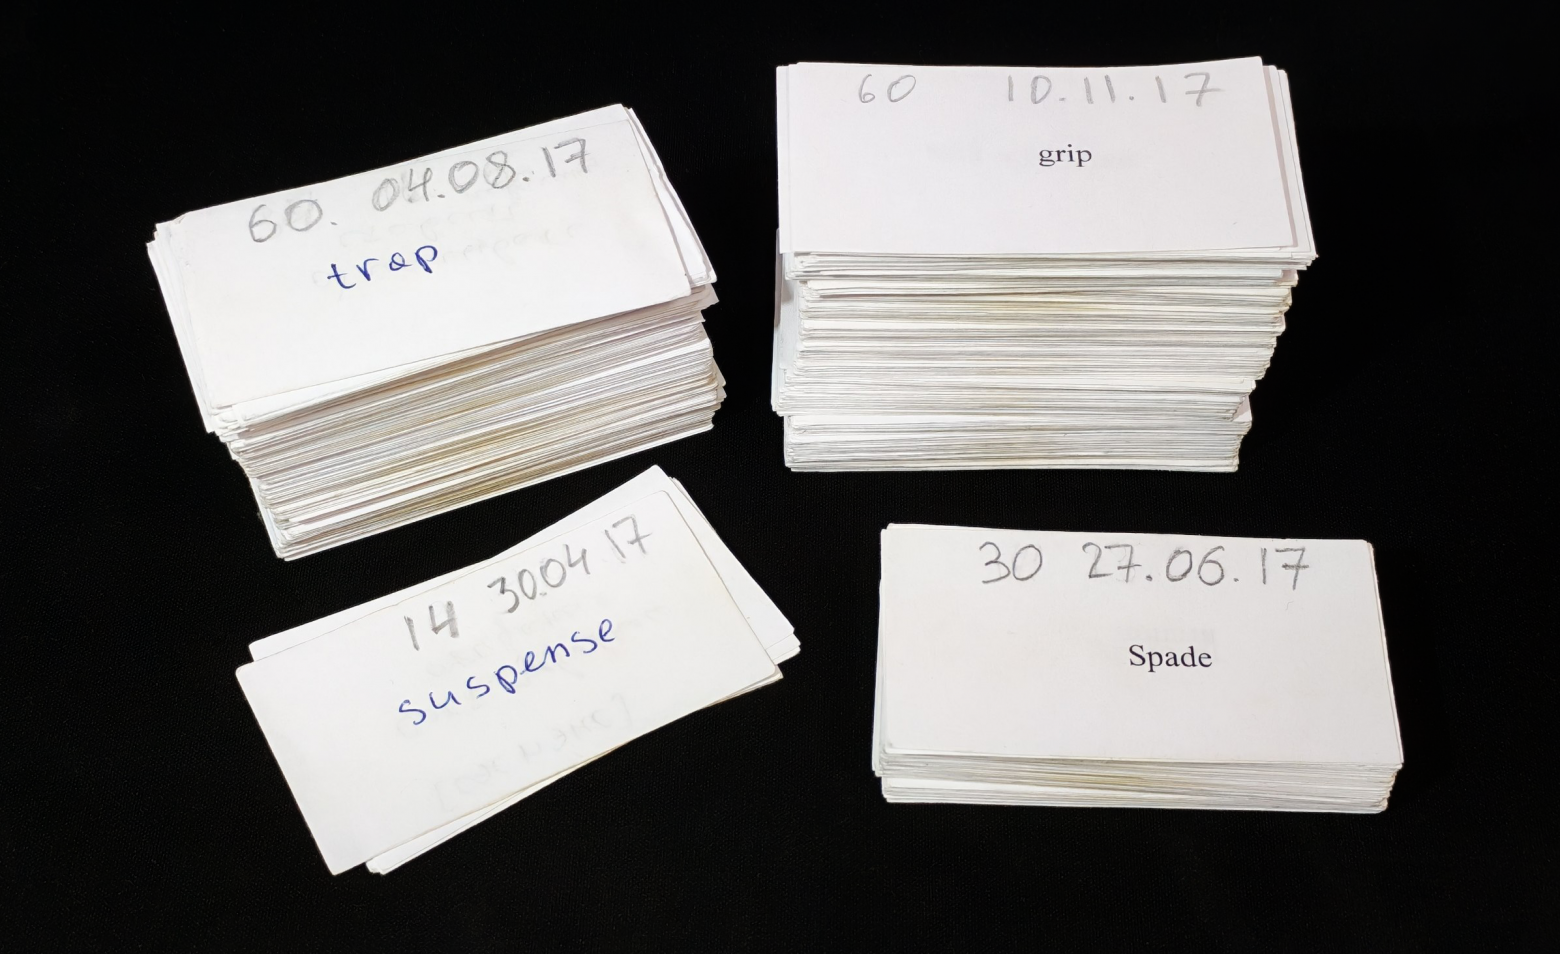
Это самый трудоемкий и времязатратный этап, но именно тяжелый труд по изучению и повторению слов делает эту методику эффективной.
Я начинаю читать книгу при прохождении большей частью слов этапа “1 месяц”, при чтении “трудные” слова быстро доучиваются, потому что часто встречаются в контексте книги.
Эффект накопления и рост сложности
Прелесть в том, что наиболее частые слова в разных текстах сильно пересекаются. Я провел частотный анализ небольшой выборки книг на английском языке и получил, что списки топ-1000 самых частых слов каждого произведения пересекаются между собой в среднем на 55%.
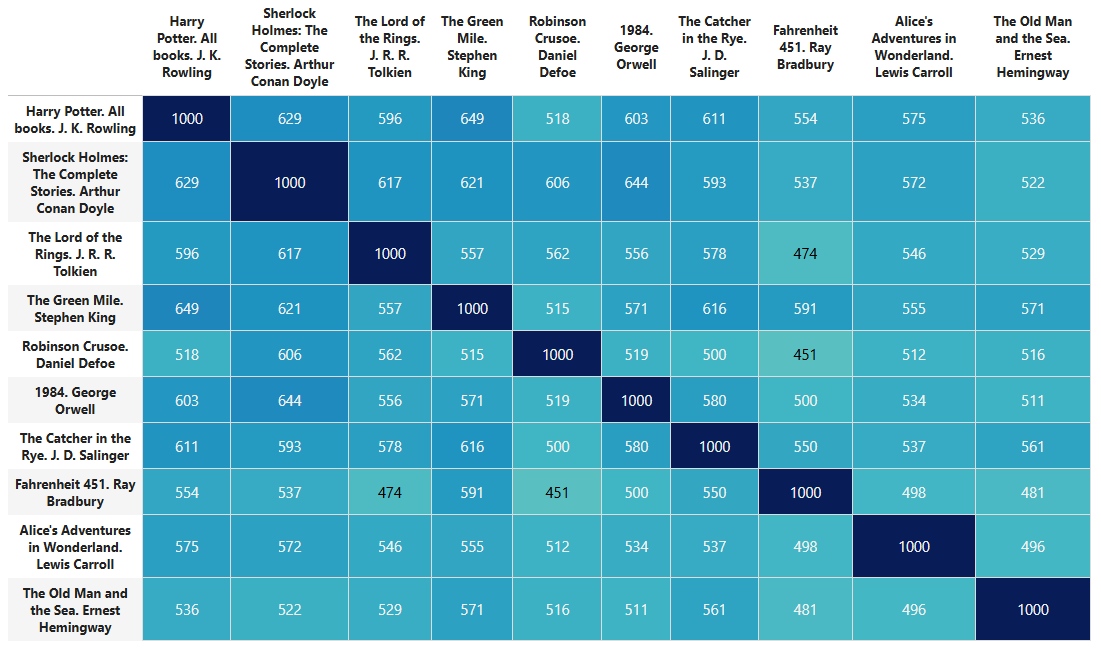
Поэтому каждое следующее произведение дается легче предыдущего. С каждой новой книгой приходится учить меньше слов, либо можно намеренно повышать сложность произведений.
Грамматика
Чем лучше вы знаете грамматику, тем лучше вы будете связывать в единый смысл известные слова. Я начинал чтение адаптированной литературы после повторения базовых школьных тем.
Параллельно чтению книг я изучал грамматику по синему учебнику Мёрфи (English Grammar in Use. Intermediate. Raymond Murphy).
По моему мнению, этого учебника вполне достаточно для чтения и просмотра фильмов и сериалов.
Развитие аудирования и просмотр сериалов
Для развития понимания английской речи на слух я слушал аудиоверсии прочитанных книг.
Тот же статистический подход я использовал для просмотра сериалов. Я собирал субтитры всех эпизодов конкретного сериала, составлял и учил список наиболее частых слов. Затем я начинал просмотр с субтитрами, а через некоторое время без субтитров.
Наслаждение прогрессом
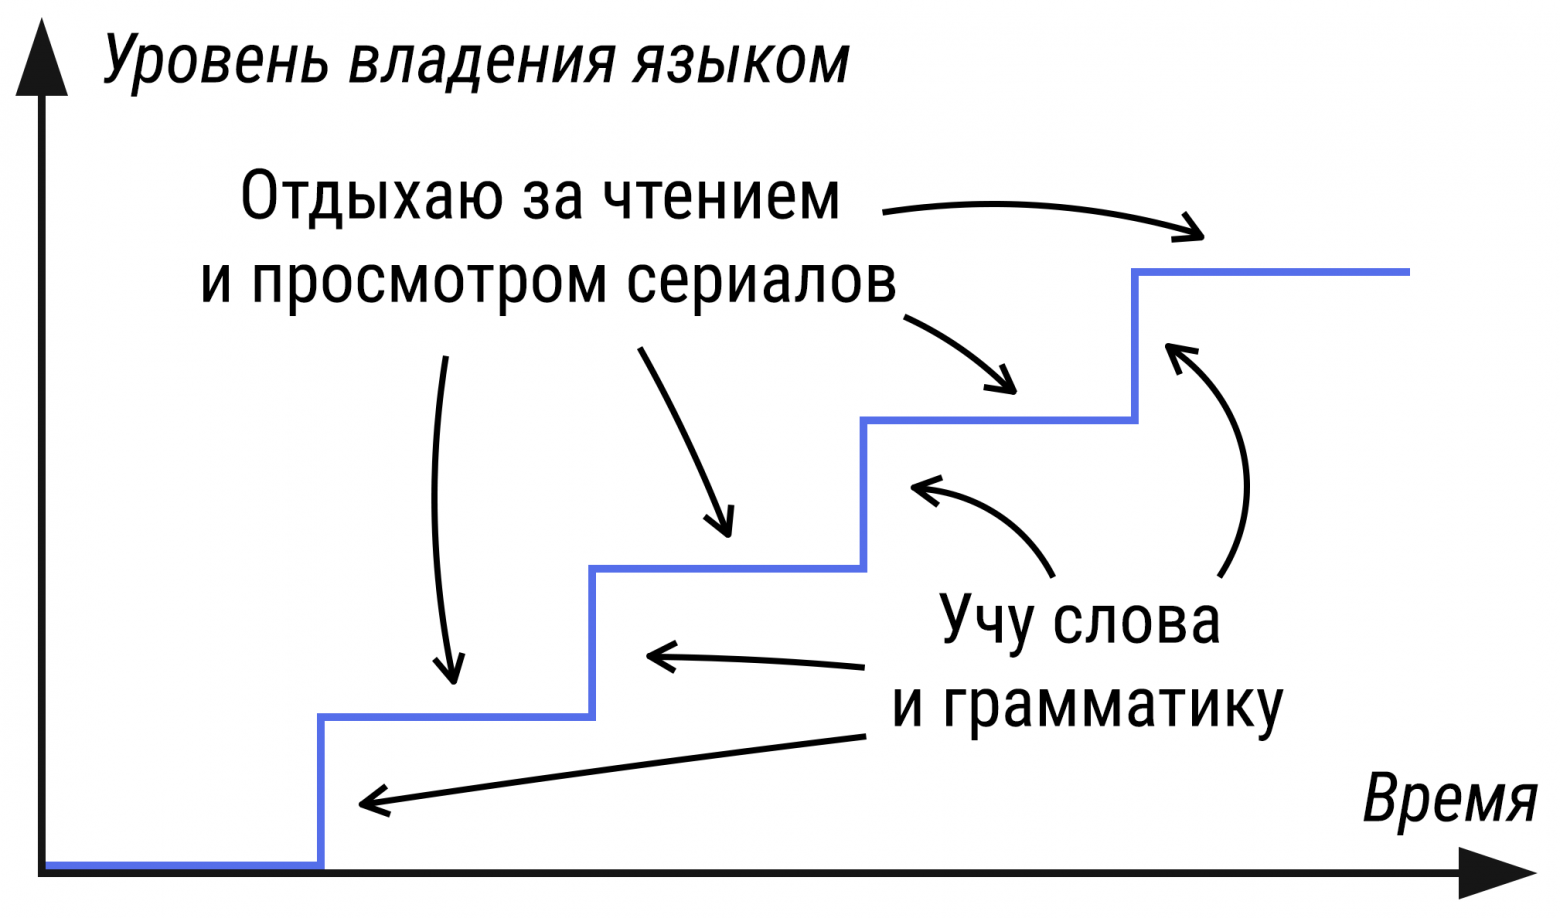
При таком подходе изучение языка происходит этапами. Этот процесс я представляю себе как лестницу, где каждая ступенька – это маленькая цель. Я будто бы сначала быстро карабкаюсь вверх, изучая большое количество слов в короткое время, а затем наслаждаюсь результатом за чтением любимой книги или просмотром любимого сериала. Чередование нагрузок и отдыха позволяет мне не выгорать и наслаждаться прогрессом.
Порядок подготовки слов
Ручная подготовка слов к изучению – это самый долгий и утомительный этап методики. Постепенно я автоматизировал отдельные части процесса подготовки слов и создания карточек, что в итоге привело к появлению приложения Word by Heart.
GitHub: https://github.com/EgorTatarnikov/WordByHeart
YouTube: https://youtu.be/1IjTnEf85Ak?si=-1Oi9XMk0RGHBNNs
В приложение я передаю TXT-файл с книгой или субтитрами сериала.
Далее приложение обрабатывает текст и подготавливает слова для изучения в несколько этапов:
-
Предобработка текста. Исходный текст подготавливается к анализу.
-
NLP-анализ. Лемматизация и POS-теггинг (определение частей речи) слов с помощью библиотеки spaCy.
-
Подсчёт частотности и специфичности. Расчет статистики вхождений слов, сравнение частоты слов в произведении с общеязыковой частотой из библиотеки wordfreq.
-
Грамматическое дополнение. На основе данных spaCy добавляются словоформы, полезные для изучения, например основные формы глаголов и множественное число существительных.
-
Получение транскрипции. Создание фонетической IPA-транскрипции с помощью eSpeak NG.
-
Отбор слов. Слова выбираются по частотности, покрытию текста и специфичности. В программу можно добавить уже известные слова, которые будут исключены из итогового списка для изучения.
-
Перевод слов. Перевод выполняется через локальный словарь Kaikki или через GPT-6 Luna. Для перевода через LLM нужен API-ключ OpenAI. В модель передаются лемма, часть речи, словоформы и примеры употребления слова в контексте книги для более точного перевода.
-
Подготовка результатов. Создание сводной таблицы, итогового списка слов и двусторонних карточек для изучения.
Далее я распечатываю сформированные страницы с карточками, разрезаю на карточки и приступаю к изучению.
Ограничения методики
-
Представленная методика развивает навыки пассивного владения языком: чтение и аудирование. Для развития навыков говорения и письма необходимы другие подходы.
-
Для некоторых лемм, особенно местоимений и неправильных глаголов, приходится запоминать большое количество словоформ. При этом именно такие слова часто несут важную грамматическую информацию. Для изучения склонений местоимений и спряжений глаголов я использовал отдельные таблицы.
-
В английском языке часто употребляются составные слова, фразовые глаголы, фразеологизмы и другие многословные конструкции. Анализ таких лексических единиц (анализ n-грамм) мог бы улучшить качество подготовки к чтению, однако для моих целей существующего подхода пока достаточно.
Итог
Представленная методика позволила мне начать реально пользоваться английским языком уже на ранних этапах обучения. Изучение языка перестало быть бесконечным процессом движения к абстрактной цели. Маленькими шагами я углубляю знания, и на каждом этапе я фиксирую прогресс реальным достижением: прочтением книги или просмотром сериала. Чередование этапов трудоемкого заучивания слов и относительно легкого чтения книг и просмотра сериалов позволяет не забрасывать изучение языка. Использование английского языка постепенно превратилось в интересный досуг, который приносит удовольствие и пользу.
Список литературы:
-
Чтение книг в оригинале, как один из способов изучения английского языка. https://habr.com/ru/articles/873704/
-
Сколько английских слов надо выучить для свободного общения и чтения статей? https://habr.com/ru/companies/skyeng/articles/344186/
-
Ключевые слова в иностранном языке или как увеличить свой словарный запас? https://habr.com/ru/articles/982660/
-
Marcella Hu Hsueh-chao and Paul Nation (2000), “Unknown Vocabulary Density and Reading Comprehension”. https://openaccess.wgtn.ac.nz/articles/journal_contribution/Unknown_vocabulary_density_and_reading_comprehension/12560354
-
Benjamin Kremmel, Bimali Indrarathne, Judit Kormos, Shungo Suzuki (2023), “Unknown Vocabulary Density and Reading Comprehension: Replicating Hu and Nation (2000)”. https://onlinelibrary.wiley.com/doi/10.1111/lang.12622
-
Cepeda, N. J., Pashler, H., Vul, E., Wixted, J. T., & Rohrer, D. (2006). Distributed practice in verbal recall tasks: A review and quantitative synthesis. Psychological Bulletin, 132(3), 354–380. https://escholarship.org/uc/item/3rr6q10c
Автор: TatarnikovEgor

