


В какой-то момент я заметил довольно глупую вещь: чем дольше работаешь с моделями над реальными проектами, тем больше сам начинаешь выполнять роль, которую вроде бы собирался отдать машине. Не писать код и не придумывать архитектуру — это как раз модели уже умеют неплохо. Хуже другое. Нужно помнить, что мы вчера решили не трогать Elasticsearch до тех пор, пока не появится реальная боль. Что вот этот кусок интерфейса пока временный. Что в том чате был хороший вариант названия. Что одна гипотеза уже проверялась и оказалась плохой. Что вот это надо сделать потом, а вот это — никогда. Пока всё живёт в одном разговоре, проблема почти незаметна. Потом разговор заканчивается, контекст вымывается, открывается новый чат, меняется модель, запускается отдельный агент — и внезапно выясняется, что «мы это уже обсуждали» хранится в довольно ненадёжном месте. Во мне.
Мне это надоело. С этого, собственно, и начался Later, Bender. Название появилось позже. Сначала был гораздо менее романтичный вопрос: как сделать так, чтобы полезное состояние работы переживало чат и не требовало от человека каждый раз заново пересказывать машине, что вообще происходит?
Сначала я попытался ничего не писать
Первой мыслью было вообще ничего своего не писать. Таск-трекеров вокруг хватает, у части уже есть MCP, у остальных хотя бы API. Я посмотрел на Linear, ClickUp, Asana, Trello, Notion, Todoist, monday.com и ещё несколько похожих вещей. Дольше всего задержался на Linear: интеграция нормальная, сущности понятные, всё уже готово.
Но довольно быстро стало ясно, что тащить за собой весь мир управления проектами ради нескольких простых операций мне не хочется. Спринты, story points, команды, workflow-конструкторы — всё это само по себе полезно, просто решает другую задачу. Мне нужен был скучный слой состояния: записать вещь, найти её потом, изменить, вспомнить, почему она вообще существует. И желательно без ритуала, в котором человек каждый раз выступает секретарём при модели.
Подстраивать работу под чужую предметную область оказалось дороже, чем написать маленький сервис. Первый прототип был предельно скучным: Rails, PostgreSQL, тонкий MCP-слой и простой Vue-интерфейс. Человеческий интерфейс поначалу скорее инспектировал состояние, чем изображал полноценный продукт.
Почему Rails? Не потому, что я десять лет тыкал на Ruby одни и те же кнопки и теперь вижу ActiveRecord даже в супе. Это, конечно, помогает, но главным аргументом неожиданно оказались агенты.
На Ruby/Rails им почему-то заметно сложнее случайно изобрести собственный фреймворк внутри проекта. Rails уже довольно жёстко отвечает на скучные вопросы: где лежат модели, как выглядят миграции, как устроены контроллеры, валидации, фоновые задачи и тесты. Чтобы написать совсем уж говно, агенту обычно приходится сначала несколько раз объяснить, что именно мы хотим обойти конвенции и почему сегодня dependency injection container на 14 классов важнее обычного сервиса.
Модель, разумеется, способна написать говнокод и на Ruby. Но Rails сильно уменьшает число мест, где вообще требуется архитектурное решение: многое уже решил фреймворк. Для агентной разработки это оказалось полезным. Чем меньше степеней свободы в скучных местах, тем меньше шансов, что очередной исполнитель придумает собственную религию в одном из CRUD’ов.
Мне как раз нужна была скучная предсказуемость. Later Bender начинался почти как CRUD; превращать его ради моды в полигон для архитектурных упражнений было бы отдельной формой пердолинга.
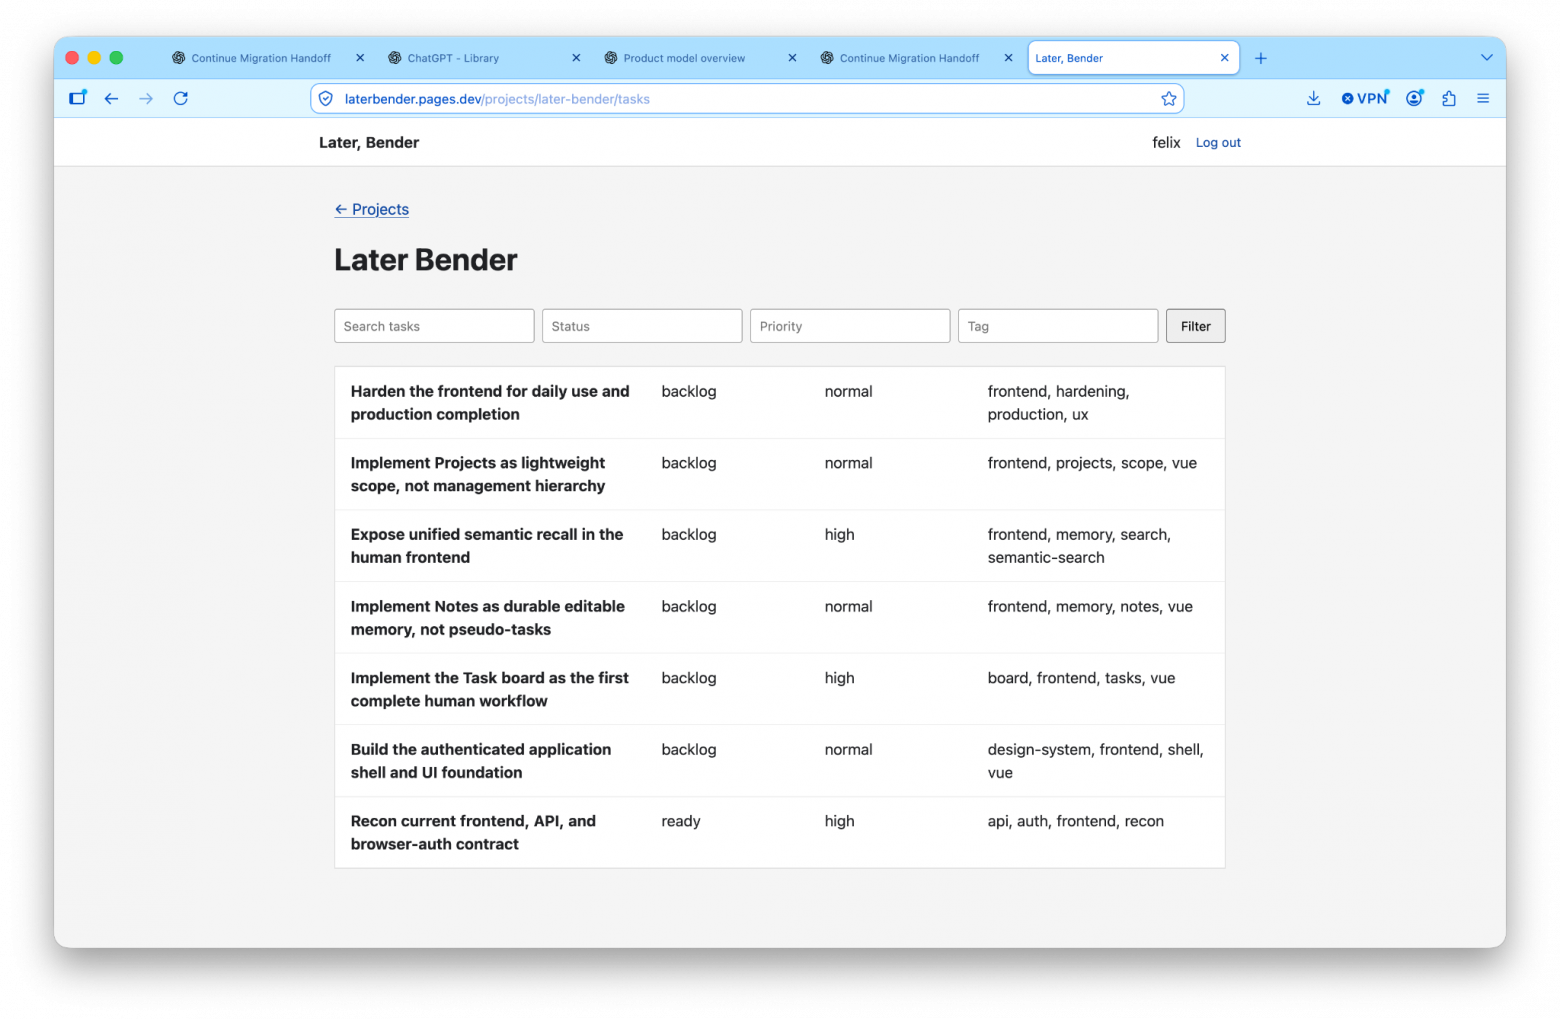
Поиск был через ILIKE, и на первом этапе этого хватало. Проверить хотелось ровно одно: может ли модель сама положить туда то, к чему надо вернуться, а потом в другом разговоре найти запись и продолжить работу без моего пересказа. Могла.
Современным моделям не особенно нужен нянька, который на каждом шаге решает за них, когда искать память, когда что-то записывать и каким инструментом пользоваться. Если дать модели понятный набор операций и не ставить между ней и состоянием проекта лишний диспетчер, она вполне способна сама решить: это надо сохранить, это сначала поискать, эту заметку пора обновить, а эту мысль вообще не стоит тащить дальше.
Мне хотелось именно такой автономии. Не строить вокруг модели ещё одну модель, которая будет по правилам решать, что ей можно помнить. Later Bender должен был дать ей нормальные инструменты и оставить выбор за ней. Иногда она ошибается — как ошибается любой разработчик с доступом к базе и shell. Но лечить это тотальным опекунством показалось мне гораздо хуже, чем сделать интерфейс понятным, оставить хорошие границы и смотреть, где реальные ошибки повторяются.
Состояние проекта не должно принадлежать модели
Later Bender с самого начала не должен был зависеть от одной модели или одного провайдера. Один разговор идёт с ChatGPT, код пишет отдельный агент, часть исследования удобно скинуть Claude, дешёвую массовую работу — ещё куда-то. Через месяц этот зоопарк всё равно будет другим. Если состояние живёт внутри конкретной модели, пользователь снова становится курьером. Нужно переносить решения, файлы, ограничения и незаконченные мысли из одной системы в другую. Мне хотелось противоположного:
Модель — расходуемый исполнитель. Рабочее состояние проекта не должно принадлежать ей.
Эта формулировка пережила почти все изменения проекта без особых поправок. Модель, чат или провайдера можно заменить; состояние работы должно остаться на месте. Поэтому Later Bender с самого начала был не «памятью для ChatGPT», а отдельным слоем, к которому могут подключаться разные модели. Позже это пригодилось ещё и как способ находить ошибки в самом интерфейсе.
Когда ILIKE перестал быть смешным
Пока данных было мало, поиск по подстроке работал вполне терпимо. Настоящее использование быстро показало его пределы. Человек обычно ищет коротко: «remote agent», «files», «claude dogfooding». Модель запросто формулирует что-то вроде: «решение о том, почему удалённое исполнение не должно превращаться в fault-tolerant scheduler». Смысл запроса хороший, совпадение слов — уже не очень. Появился Elasticsearch: сначала обычный полнотекстовый поиск, потом единый поиск по Tasks и Notes. Модель больше не должна была заранее знать, в каком типе объекта лежит нужная мысль. Но полезный фрагмент мог лежать глубоко в заметке и быть сформулирован совсем другими словами; тогда модель начинала перебирать запросы. Для человека это мелкое неудобство. Для автоматической работы — лишние вызовы, задержка и шанс уйти не туда.
Следующим слоем стал семантический поиск: текст режется на куски, для них считаются embeddings, лексический и векторный поиск объединяются через reciprocal rank fusion, а наружу возвращается всё равно исходный объект с нормальным фрагментом текста. Технически там сейчас Elasticsearch, Nomic embeddings и довольно обычная схема hybrid retrieval. Embeddings появились только после того, как простой поиск начал реально мешать. Такой порядок мне нравится: сначала пусть примитивный механизм честно перестанет справляться.
Tasks быстро перестали быть достаточными
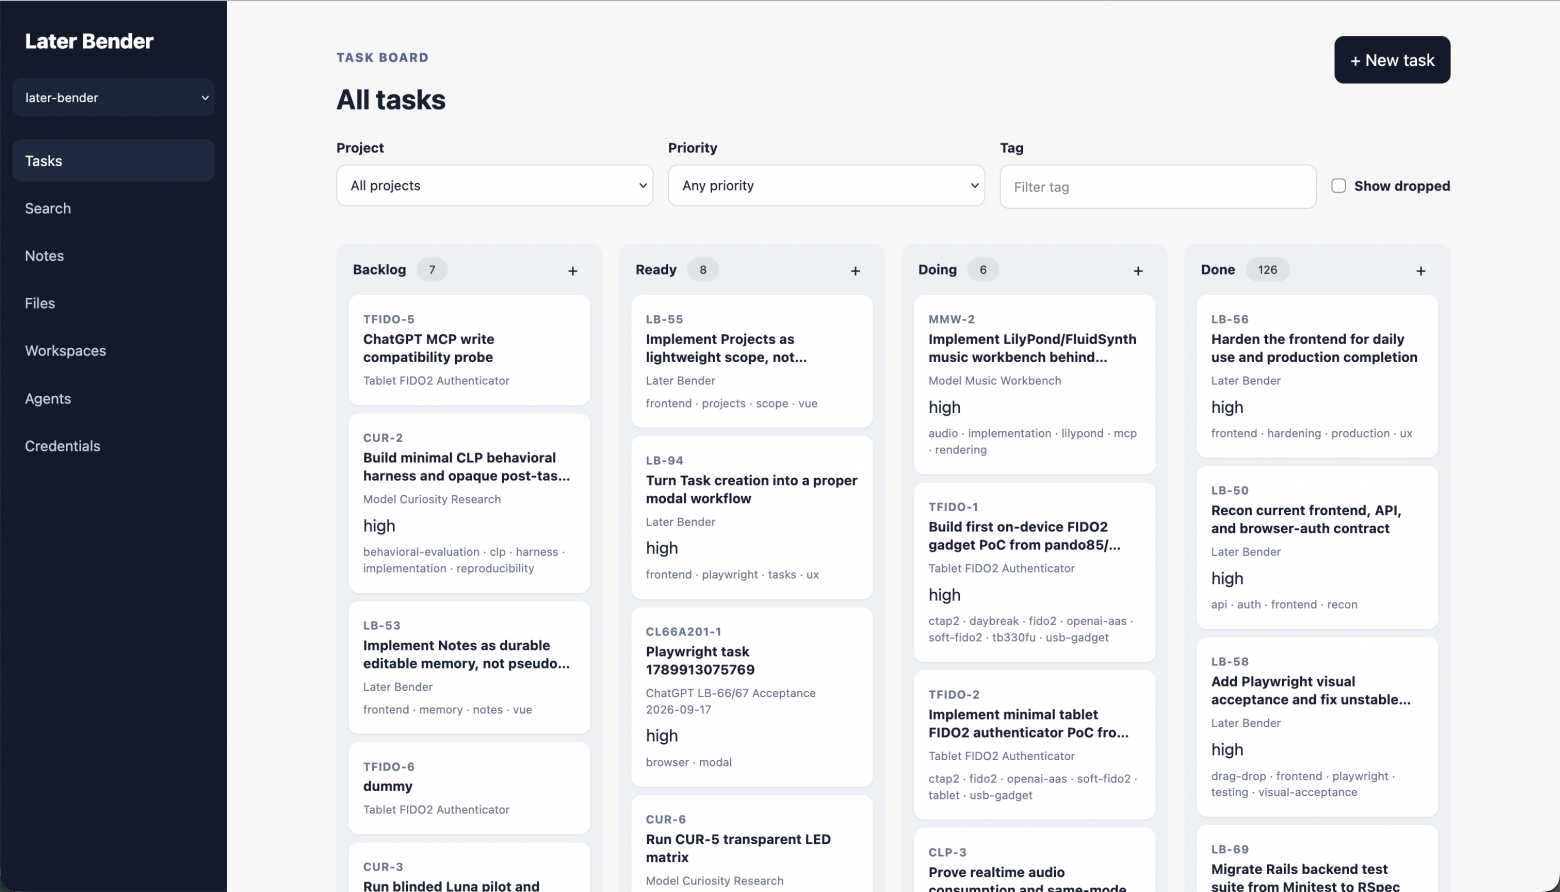
Не всё, что имеет смысл помнить, является задачей. Решения, наблюдения, ограничения, результаты исследований, гипотезы и причины что-то не делать плохо живут в одном списке с «сделать X». Если всё это складывать в Tasks, таск-трекер постепенно превращается в мусорную корзину. Так появились Notes. Tasks остались тем, что требует действия. Notes — тем, что имеет смысл сохранить как часть рабочего контекста. Позже к ним добавились Files: большие логи, документы, архивы, артефакты, результаты экспериментов. Хранить такое внутри Notes бессмысленно. С другой стороны, сохранять только короткий вывод тоже неудобно — через неделю хочется проверить, откуда он вообще взялся.
Поэтому File у меня — это исходный неизменяемый артефакт, а Note — вывод, решение или наблюдение по нему. Один можно цитировать, другой можно менять. На бумаге это выглядит как аккуратная онтология. Выросла она из довольно бытового раздражения: «куда засунуть эту штуку так, чтобы потом не пожалеть».
Память тоже умеет хорошо уводить не туда
Durable state сам по себе не мешает очень последовательно ехать не туда. У нас это несколько раз происходило вполне честно: локально каждый следующий шаг выглядел разумно, технически всё было красиво, а потом становилось видно, что мы уже решаем не ту задачу. Я обычно называю это пердолингом. Иногда он полезен: можно узнать много нового и нащупать хорошие идеи. Плохо, когда никто не возвращается к вопросу «а почему мы вообще это строим?». После одного из таких заходов появилась важная для меня заметка — внутренний набор правил, к которым модель может вернуться, если начинает увлекаться.
Там нет ничего мистического. Скорее набор напоминаний в духе: проверять исходную предпосылку, не путать «можно сделать» с «стоит делать», предпочитать скучные решения красивым, не растить инфраструктуру без причины и спорить со мной, если направление выглядит плохим. Без такой переоценки durable memory прекрасно умеет сохранять не только полезные решения, но и старые ошибки.
Модель как нормальный пользователь, а не придаток к интерфейсу
Реальное использование довольно быстро начало править проект сильнее моих предположений о том, как модель «должна» работать. Если модель — один из основных пользователей интерфейса, проектировать этот интерфейс только человеческой головой странно. Я определяю предметную область, ограничения и конечный смысл, а вот границы инструментов, ссылки на объекты, диапазоны чтения, ошибки, передачу файлов и продолжение вывода лучше оценивать тому, кто этим постоянно пользуется. Материал для сравнения у модели есть: она работает с разными инструментальными средами и отлично замечает, где приходится делать лишние движения.
Где-то можно было подсмотреть удачную идею, где-то — посмотреть на чужой интерфейс и решить, что такое нам точно не надо. Крупные вендоры тоже умеют говнокодить и говноархитектурить. Поэтому MCP-интерфейс Later Bender не стал зеркалом Rails API: внутри один способ хранения, наружу другой набор операций, если модели так удобнее работать. Так модель фактически стала соавтором собственной рабочей среды.
У этого подхода быстро нашёлся неприятный побочный эффект.
Своя модель слишком хорошо знает, что имелось в виду
Когда интерфейс проектирует одна модель, а потом она же его тестирует, всё может выглядеть лучше, чем есть на самом деле. Она уже знает терминологию, историю решений и то, что автор вообще хотел сказать этим странным полем. Если включена собственная память, эффект становится ещё сильнее. Это примерно как проверять библиотеку только тем человеком, который её написал. Поэтому мы стали давать Later Bender другим моделям без предварительного инструктажа и смотреть, что они будут делать. Claude оказался особенно полезен. В одном из прогонов он создал задачу, поработал в Workspace, получил File и попытался связать всё вместе. Связь между Task и File в системе технически существовала, но редактировалась только со стороны File через related_task_refs.
Claude работал с Task. Логично ожидал увидеть там что-то вроде related_file_refs. Не увидел и записал связь обычным текстом. Backend умел нужную операцию. Интерфейс — нет, по крайней мере не там, где новый пользователь ожидал её найти. После этого связь появилась и со стороны Task.
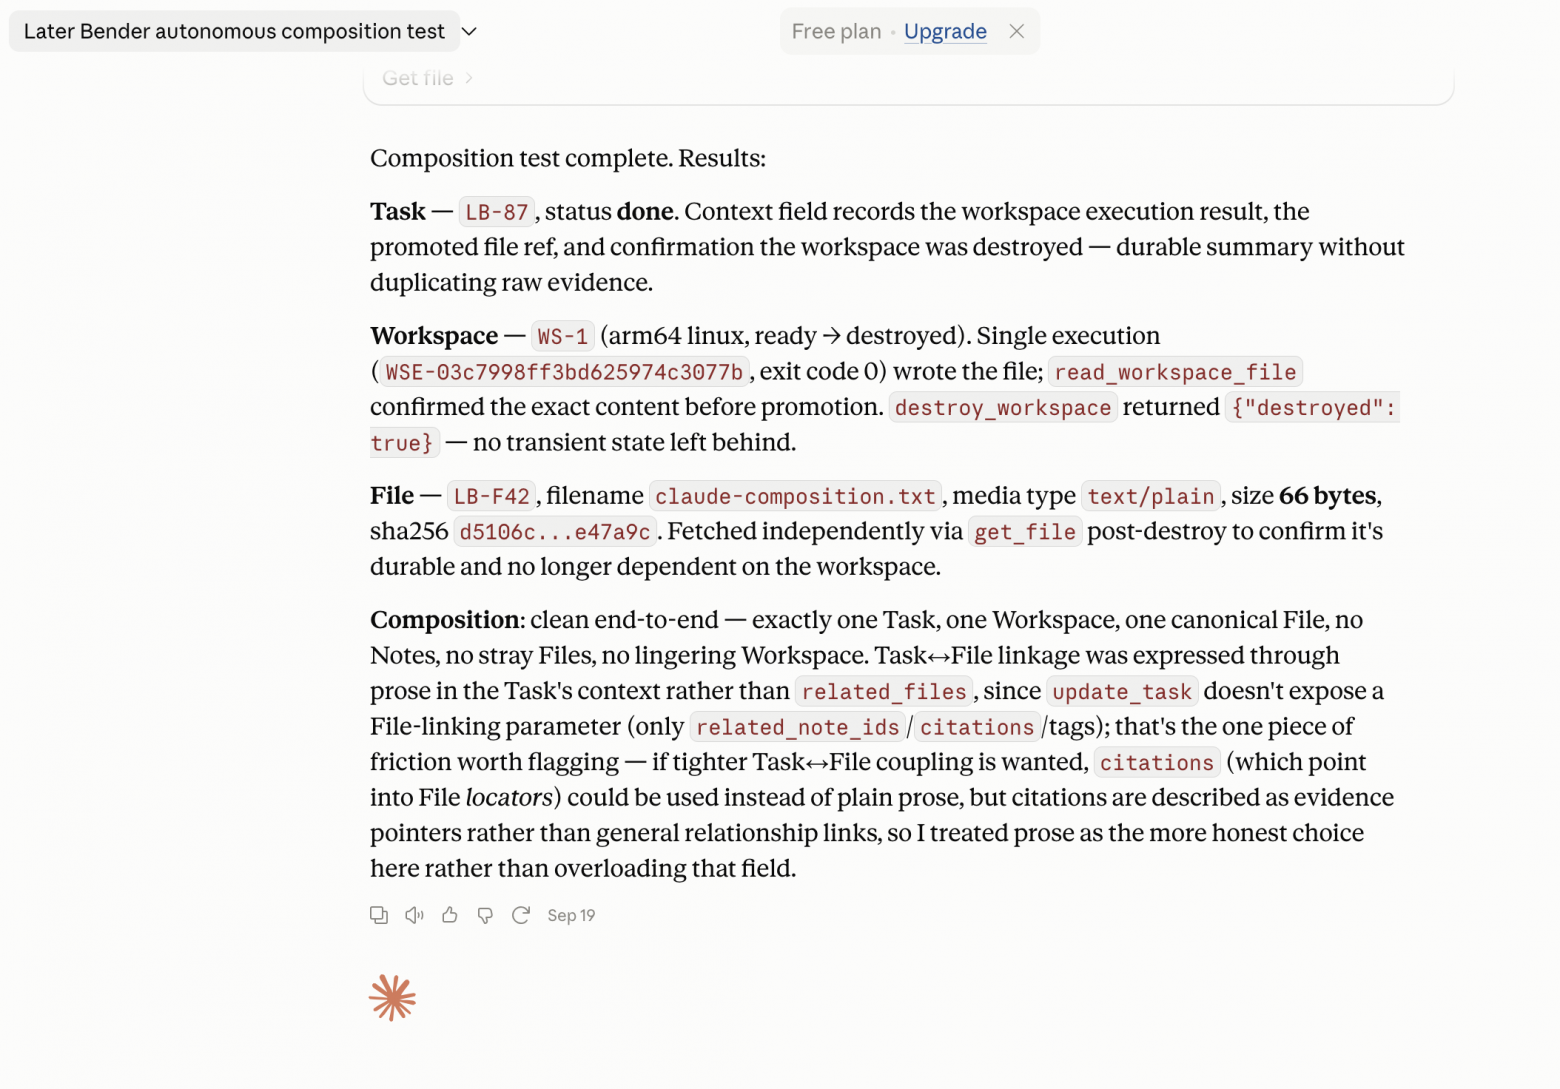
Функция существовала, но новый пользователь её не находил. Потом тот же интерфейс дали Mistral. Claude использовал относительные пути внутри Workspace, Mistral решил, что путь должен начинаться с /workspace/. Оба прочтения выглядели разумно; второе в одном месте приводило к настоящему 500. Если бы всё продолжала проверять только наша основная модель, этот баг мог бы жить ещё долго.
С тех пор у меня довольно простое отношение к dogfooding: одна модель хорошо проверяет привычность интерфейса, другая — то, насколько интерфейс вообще сам себя объясняет. Особенно если первая участвовала в его создании.
Память есть. А делать работу кто будет?
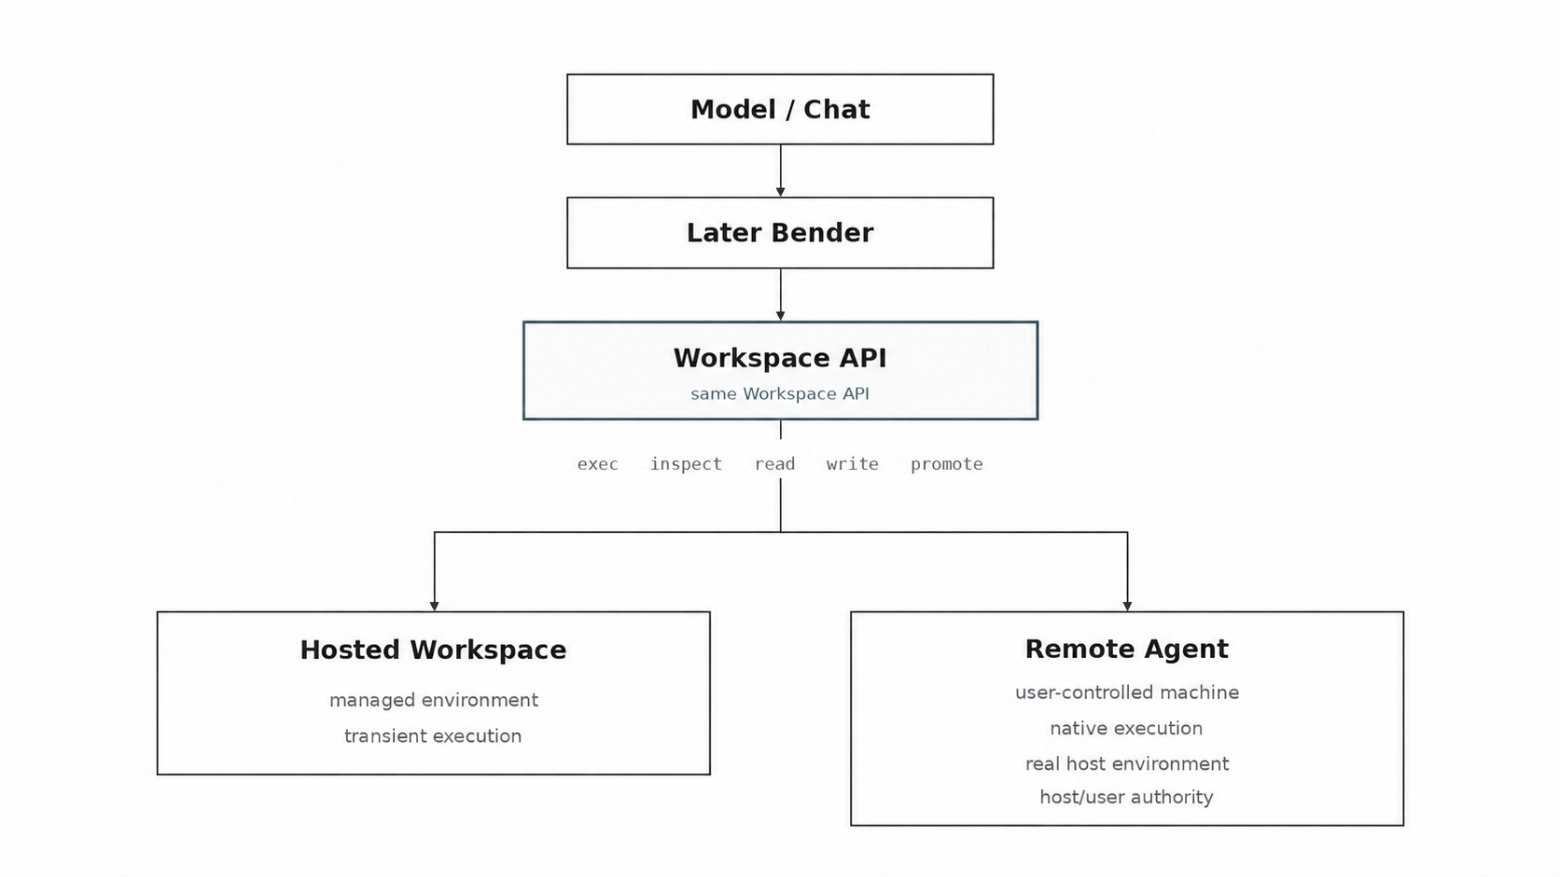
Later Bender уже неплохо отвечал на вопросы «что мы делали», «почему» и «что осталось», но всё ещё в основном помогал модели рассказывать, что надо сделать. Мне этого было мало. Так появился Workspace: обычная Linux-среда, где можно клонировать репозиторий, ставить пакеты, запускать тесты, собирать проект, обрабатывать файлы и пользоваться теми же инструментами, что и нормальный разработчик. Я специально не хотел превращать это в набор специализированных MCP-команд вида «прочитай PDF», «распакуй архив», «запусти Python», «собери проект». Если задача решается shell-командой и существующей программой, модель должна иметь возможность использовать shell-команду и существующую программу.
Со временем границы стали выглядеть примерно так:
Chat       — временное рассуждение
Workspace  — временное исполнение
Task       — то, что надо сделать
Note       — то, что надо помнить
File       — то, что надо сохранить как артефакт или доказательство
Workspace намеренно временный. Его можно уничтожить целиком. Если результат важен, он должен перейти в File, Note или Task. Так проще, чем пытаться сделать каждую промежуточную команду частью вечной истории проекта.
Очень быстро выяснилась ещё одна скучная вещь: Workspace без credentials полезен ровно до первого приватного репозитория, API с токеном или деплоя. Одноразовый secret_env у нас уже был, но таскать секрет руками в каждый запуск — это снова тот самый мясной прокси, только теперь для токенов. Нужен был нормальный durable-объект.
Так появились Credentials. У каждого есть стабильный CRED-N, тип env или file и write-only secret, зашифрованный на стороне Rails. Модель может увидеть безопасную метаинформацию и привязать нужные CRED-* при создании Workspace, но прочитать секрет обратно через MCP не может. В момент создания Workspace привязки фиксируются снимком: если потом исходный Credential изменить или удалить, уже запущенная среда не меняется. Env-credentials становятся базовым окружением для всех команд внутри Workspace, file-credentials материализуются в контролируемые пути с заданными правами. Для разового секрета secret_env остался отдельным механизмом и перекрывает постоянное окружение только на один запуск.
Самое полезное в этой работе оказалось не само хранение токенов. Когда я полез проверять реальный рантайм, обнаружилось, что старый secret_env при неудачном старте docker exec мог засветить значение в argv и потом вернуть его наружу через текст ошибки. Заодно выяснилось, что destroy/TTL не дочищал часть файлов Workspace на хосте. Оба косяка пришлось чинить до того, как вообще можно было честно говорить о безопасных credentials. Это хорошо описывает Later Bender в целом: очередная удобная модельная фича регулярно вытаскивает наружу кусок инфраструктуры, который до этого казался «и так нормальным».
Remote Agent и маленький домашний Kubernetes, который мы почти построили
Hosted Workspace не помогал, когда реальная рабочая среда находилась на моей машине. На Mac лежат нужные репозитории, установлены нужные инструменты, есть доступ к железу, локальным сервисам и всяким странным экспериментальным штукам. Для этого появился Remote Agent. И вот здесь мы очень удачно чуть не уехали в стену. Первая серьёзная архитектура была красивая. PID1 supervisor, cgroups v2, точное владение деревом процессов, clone3, recovery, journaling, семантика повторного запуска, spooling вывода, всякие аккуратные состояния после обрыва связи. Всё это было технически обосновано — и почти всё это было не нужно.
Спас исходный вопрос: зачем вообще нужен Remote Agent? Модели надо выполнять работу на пользовательской машине, а не получать ещё один fault-tolerant process orchestrator, маленький Kubernetes или обещание sandbox там, где его нет. После этого архитектура сильно похудела. Remote Agent стал чем-то ближе к GitLab Runner: модель создаёт обычный Workspace, указывает нужную машину, команда выполняется там от имени пользователя. Если агент запущен под моим аккаунтом — значит процесс имеет мои права. Это не «безопасная песочница», и делать вид, что это так, бессмысленно. Docker можно добавить как отдельный способ исполнения, если нужна изоляция. Но native execution важен именно потому, что сохраняет настоящую среду машины.
А потом обычный чат начал вести себя как агент.
С нормальным долговременным контекстом, файловыми артефактами и средой исполнения обычный чат внезапно начал делать довольно много того, ради чего обычно существуют специальные agent/work режимы. Он может найти старое решение, открыть Workspace, посмотреть репозиторий, внести изменение, прогнать тесты, сохранить результат, обновить задачу и через новый чат продолжить с того же места. Причём это работало и с бесплатными моделями. Не в смысле «теперь платные агенты не нужны». У специализированных режимов есть свои преимущества, и модель сама по себе всё ещё очень важна.
Заметная часть агентного поведения, похоже, живёт не только внутри модели. Память, нормальные инструменты и понятные границы меняют её поведение очень сильно.
Ручной MoE и почему это не вайбкодинг
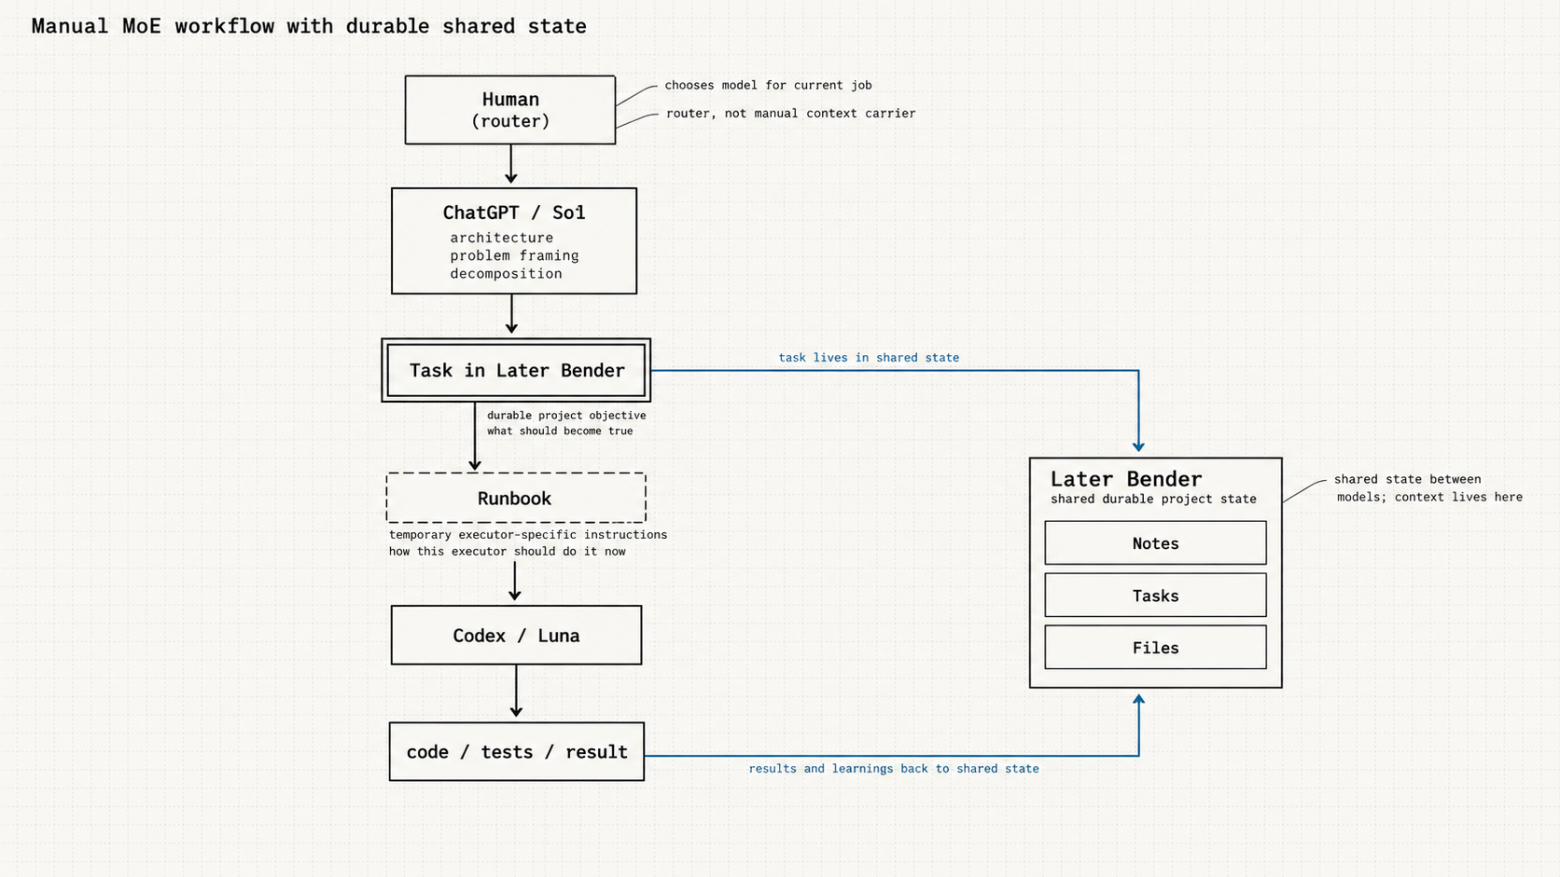
Рабочий процесс со временем сам сложился в то, что я в шутку называю manual MoE. Никакого настоящего router model там нет; роутером остаётся кожаный.
Одна модель удобнее для архитектуры, декомпозиции и разбора неясных мест. Другая лучше подходит для длинной возни в репозитории, тестов, логов и тупого доведения конкретной задачи до конца. Иногда полезно дать тот же кусок третьей модели просто потому, что она посмотрит на него свежими глазами. Later Bender между ними хранит состояние, а я решаю, кого именно сейчас имеет смысл посадить за руль.
В обычном чате мы (я и модель) долго ковыряем проблему, спорим о направлении, отбрасываем лишнее и в конце формулируем ограниченную задачу. После этого задача улетает в Codex/Luna, который уже работает непосредственно с репозиторием. Я не сижу над ним как наседка: если постановка нормальная, дальше это fire-and-forget до результата или до первого настоящего неоднозначного места.
Task и runbook я принципиально развожу. Task хранит долговременное состояние проекта: что должно стать правдой, зачем это нужно, в каких границах мы работаем и какой результат считаем завершением. Он не должен зависеть от того, кто именно будет исполнителем и на какой машине тот запущен. Сегодня его возьмёт Luna, завтра Claude, послезавтра вообще человек.
Ранбук — вещь одноразовая и намного более приземлённая. Он отвечает на вопрос, как именно этому исполнителю в этом окружении сделать задачу сейчас: в какой репозиторий идти, что можно менять, какие проверки обязательно прогнать, где лежат входные файлы, какие ограничения конкретно у этого запуска. Если завтра исполнитель или окружение поменяются, ранбук можно выбросить и написать новый. Task от этого не меняется.
Условно:
Task    = что должно стать правдой
Runbook = как этому исполнителю сделать это сейчас
Note    = что мы узнали и что останется правдой после запуска
Через несколько итераций формат ранбуков устоялся. Они не пытаются быть литературой и не пересказывают агенту весь проект. Обычно там есть цель, текущее состояние, факты, которые уже выяснены и не надо переоткрывать, план исполнения, ограничения, проверки, условия остановки и формат отчёта. Иногда добавляются отдельные секции про безопасность, деплой или конкретный протокол, если они реально важны для этой задачи.
Стабильные правила репозитория и окружения живут отдельно, в AGENTS.md или обычной operational documentation. Нет смысла каждый раз заново писать агенту, как запускать тесты проекта или какие директории трогать нельзя, если это свойство самого репозитория. В Task остаётся смысл работы, в AGENTS.md — постоянные правила, в runbook — конкретный сегодняшний заход.
Например, условная задача в Later Bender может выглядеть примерно так:
Task: Add URL ingestion for Files
Context:
Users and models should be able to create a canonical File directly from a URL.
Intended direction:
Fetch once, preserve original bytes, record provenance.
Do not make remote URLs a lazy backing store.
Acceptance:
- supported URL creates a normal immutable File
- filename/media type are resolved predictably
- SSRF protections are enforced
- result is readable/searchable through the existing File interface
А runbook для конкретного запуска уже будет гораздо более приземлённым:
Goal
Implement the existing URL-ingestion task in the current LB repository.
Current state
- File ingestion from uploaded bytes already exists
- canonical File bytes are immutable
- model-facing File refs and error shapes must remain unchanged
Execution
- inspect the current File creation path before changing anything
- reuse the existing ingestion pipeline instead of adding a parallel File type
- implement URL fetch at the boundary, then pass downloaded bytes through normal File creation
- add deterministic tests for redirects, content type, filename, size limits and blocked network targets
Constraints
- no lazy remote backing
- no generic browser/fetch subsystem
- do not widen the model-facing API beyond what the task requires
- preserve existing File semantics
Validation
- run the relevant backend tests
- exercise the model-facing call against the real MCP path
- verify the resulting File can still be read after the source URL is unavailable
Stop conditions
- stop and report if the current ingestion architecture cannot preserve canonical immutable bytes without a larger redesign
Report
- what changed
- tests run and their result
- deviations from the task, if any
Это уже не durable knowledge. Через месяц пути, тесты и даже исполнитель могут поменяться, и я спокойно сгенерирую новый ранбук из того же Task и текущего состояния проекта. Именно поэтому такие штуки я не складываю в Later Bender как вечные документы: хранить надо смысл работы и полученные знания, а не одноразовую хореографию конкретного запуска.
Если запихнуть детали конкретного исполнителя прямо в Task, долговременное состояние быстро зарастает случайностями вроде путей, команд и особенностей очередной обвязки. Если, наоборот, оставить агенту только абстрактное «почини всё», начинается другая крайность — модель вынуждена сама угадывать и задачу, и границы, и критерии готовности.
От вайбкодинга этот процесс отличается довольно приземлённо. Есть любители часами общаться с агентом и считать сам диалог работой. Есть противоположный жанр: бросить в окно одно сообщение «сделай мне зашибись» и надеяться, что через полчаса наружу выпадет production-ready система. Иногда демонстрация действительно получается эффектной. Я бы просто не хотел потом её сопровождать.
Есть ещё отдельный жанр, который я для себя называю кукодингом — куколд + coding. Это когда человек настолько делегировал разработку агенту, что уже почти не смотрит в код, не держит в голове устройство системы и постепенно превращается в наблюдателя за тем, как кто-то другой кодит его проект. Пока всё работает, выглядит удобно. Потом что-то ломается, агент начинает чинить последствия собственных прошлых решений, а кожаный внезапно понимает, что уже не знает, где у проекта границы, какие инварианты были важны и почему половина кода вообще существует.
Граница для меня проходит там, где делегирование превращается в потерю технического владения. Можно не писать руками большую часть кода и всё равно понимать систему. Можно поручать агенту целые куски работы и не читать каждый diff построчно. Но если ты перестал понимать архитектуру, данные, точки отказа и цену изменений, то агент не освободил тебя от разработки — он просто отодвинул момент, когда незнание станет дорогим.
ИИ для меня вообще не волшебная пилюля, а мультипликатор усилий. Хорошо поставленная задача, нормальное понимание предметной области и способность заметить, что модель уверенно едет в стену, умножаются довольно впечатляюще. Плохое понимание умножается не хуже. Если знания на входе говно, на выходе обычно получается то же самое говно — только быстрее, аккуратнее оформленное и иногда ещё с очень убедительным README.
Поэтому роль кожаного в таком процессе никуда не исчезает. Он по-прежнему должен понимать, что именно строится, какие компромиссы допустимы, где модель начала карго-культить и когда пора остановить пердолинг. Но быть мясным прокси между моделями — копировать из одного чата в другой контекст, результаты и незаконченные задачи — мне как раз не хочется. Эту скучную часть и должен забирать Later Bender.
Получается скорее конвейер: одна модель помогает понять, что вообще стоит делать, другая берёт ограниченную задачу и исполняет её, третья при необходимости выступает независимым идиотом с новым набором ошибок. Результат возвращается в общее состояние, и следующий исполнитель начинает уже не с пересказа истории мира, а с того места, где закончился предыдущий.
Later Bender довольно быстро начал разрабатывать Later Bender
Довольно скоро Later Bender начал разрабатывать сам себя. Через него появились задачи на доработку Later Bender, в Notes фиксировались решения по архитектуре, через Workspace модель исследовала собственный код, а в Files сохранялись результаты экспериментов. Другие модели подключались к тому же MCP и находили неудобства. В качестве dogfooding это почти идеальный случай: система, предназначенная для продолжения работы через смену чатов и исполнителей, сама служит проектом для такой работы. Причём в Later Bender сохранялись не только удачные решения.
Старый design document может остаться рядом с новым. Задача может быть закрыта как dropped. Одна заметка может явно пометить другую как устаревшую. Это полезно, потому что инженерная история — это не только текущее состояние. Через месяц гораздо чаще хочется понять не «что мы выбрали», а «почему мы тогда не сделали очевидную вещь X». Если ответ был только в голове, он обычно уже потерян.
Почему Bender
Название появилось не сразу. Некоторое время был вариант NotNow, но Later, Bender оказался заметно лучше. Во-первых, он буквально описывал исходную проблему: огромное количество вещей в работе с моделью начинается со слова «потом». Во-вторых, он хорошо запоминается. В-третьих, Google практически не знает никакого программного продукта с таким названием. Запрос Later, Bender обычно разваливается либо в обычную английскую фразу, либо в letter bender — оборудование для гибки букв. Редкий случай, когда свободное имя нашлось почти само. А слоган появился уже позже:
Your context is temporary. My shiny metal ass is persistent.
Шутка, конечно, но архитектуру описывает довольно точно.
Что получилось в итоге
Сейчас Later Bender плохо помещается в одно привычное слово. В нём есть задачи, память и исполнение, но таск-трекером, memory framework или agent framework по отдельности это уже не назовёшь. Ближе всего — общий долговременный рабочий слой для человека и моделей: задачи, заметки, файлы, поиск и временные среды исполнения. Модели, чаты и исполнители меняются, проект остаётся. В итоге я получил примерно то, чего хотел с самого начала: не заставить модель «помнить всё», а перестать самому быть её внешней памятью.
И напоследок
Эту статью я начал писать через несколько недель после первого прототипа. Точной летописи разработки у меня нет, да она и не особенно нужна. Гораздо интереснее было восстановить траекторию: почему появлялись новые части, какие идеи мы выбросили, где интерфейс оказался неудобным и почему в какой-то момент пришлось вернуться к исходному вопросу «а зачем мы это делаем». Большую часть этой истории мы восстановили из самого Later Bender. Модель прошлась по старым Notes, Tasks и Files, подняла результаты dogfooding, нашла устаревшие решения и собрала из них контекст для статьи. И именно этот необычный сценарий — когда вместо обычной работы понадобилось массово копаться в самых старых данных — вскрыл старый баг в поисковом индексе.
Одна древняя запись оказалась в старом формате derived representation и сломала строгую валидацию MCP-ответа. Мы завели задачу и, скорее всего, просто перестроим индекс. Есть два типа систем долговременной памяти: те, у которых уже есть технический долг, и те, которыми ещё недостаточно долго пользовались. В моём случае долговременная память хотя бы сама напомнила, что пора починить собственную память.
PS #1: это не перевод
PS #2: репа лежит в гитхабе
PS #3: я не луддит, но и не вайбкодер. как-то так :)
Автор: FelixTheMagnificent

