


Я не люблю писать документацию. Чек-листы, планы тестирования, блоки проверок, схемы — вот это всё.
Не люблю, потому что, пока ты это пишешь, теряется время на главное: разбираться и тестировать систему, с которой ты работаешь.
Идея её автоматизации жила у меня с первого дня в ИТ — тогда мне её жизненно не хватало.
Но понятного пути, как это реализовать, не было ни в голове, ни в OSS, нигде.
Ну или я не нашёл — такой вариант тоже не отметаю.
Позже я увидел и саму проблему целиком: между аналитиком и тестировщиком нет конвейера. Требования живут в Confluence, тест-план — в голове и Excel, а посередине — ручной труд с копипастой.
Вот этот разрыв я и придумал как закрыть.
Дальше — история того, как я это делал: вскрытием собственного концепта и 58 специализированными блоками в финале.
Я собрал конвейер «ТЗ → канонизация → тест-дизайн → прогон» из 58 специализированных блоков с гейтами доверия: каждый критерий приёмки заземляется цитатой из исходника, серые зоны превращаются в вопросы, а не в угаданную конкретику, повторы бесплатны за счёт кэша. Проверил на синтетическом ТЗ с заложенными болезнями: 9 ловушек из 10 поймал автомат, десятую — человек с вопросником от машины; 26 вопросов стейкхолдерам за 90 секунд, 20 серых зон, 37 BDD-сценариев за 26 минут. Где платформа врёт и что не доработано — тоже в тексте.
Летом щёлкнуло
Идея оформилась буквально летом — как всё-таки зайти на сторону автоматизации документации.
Тут помог и опыт ранее реализованных проектов, и в целом текущая скорость развития и роста моделей.
Первоначальная формулировка была наивно простой: я хочу, чтобы документация писалась автоматически.
Как это реализовать, как продумать и разобрать всё на косточки — на это потребовалось время.
Суть: возложить на модель создание чернового варианта документации, который остаётся валидировать.
Так быстрее погружаешься в задачу и сразу выходишь на границу «тестирование / доработка документации» — процесс становится параллельным, а не последовательным.
Живёшь в последовательной парадигме — попадаешь в цикл: новая задача уже готова, а документацию написать полноценно не успеваешь (говорю исключительно про себя).
Июль: первый блин
Первый подход был сделан в июле: сформировал концепт — как должны работать внутренние агенты, как читать, что выделять из ТЗ, как вообще его обрабатывать.
Главная соль — формировать документацию ДО разработки, а не после.
Взглянуть на задачу раньше, чем ты получаешь её итог в виде готовых кнопок, функций, интеграций.
Тут всё получилось не так радужно, не увидел прямой перспективы в концепте, отложил его “На подумать”.
После Конференции: вскрытие
Сходив на очередную Конференцию я увидел, что идеи и задачи в целом схожи в комьюнити, и захотелось попробовать себя: как у меня получится реализовать задуманное.
Был взят июльский концепт, проанализирован, разобран до косточек — и тут я понял его несостоятельность.
Всё было слишком широким и обширным, каждый блок пытался объять необъятное.
По моему опыту подобные решения не приводят к качественному результату — именно поэтому в предыдущем проекте, распознавании фото, я делал около сотни промптов и роутинг ради одной-единственной задачи.
Тут задача была куда нетривиальнее: разобрать на блоки и подблоки техническое задание.
Из первичных четырёх блоков система выросла в 32 блока тестирования и 26 аналитики.
Из четырёх блоков — 58
Каждый блок отвечает за конкретно свою задачу.
Технически это многоагентная наследуемая структура, которая работает как часы, — потому что используется паттерн LangGraphLangChain.
Структура получилась натурально микросервисной: у каждого модуля собственное назначение, последовательности вызовов для каждой задачи, состояния, ограничения и технический навык. Жить в монолите тут не получилось бы: невозможно добавлять и варьировать блоки, изменять их последовательности обработки.
До этого, впрочем, я тоже дошёл не сразу :)
На макроуровне — экосистема из двух платформ и общей инфраструктуры, конвейер «ТЗ → тесты».
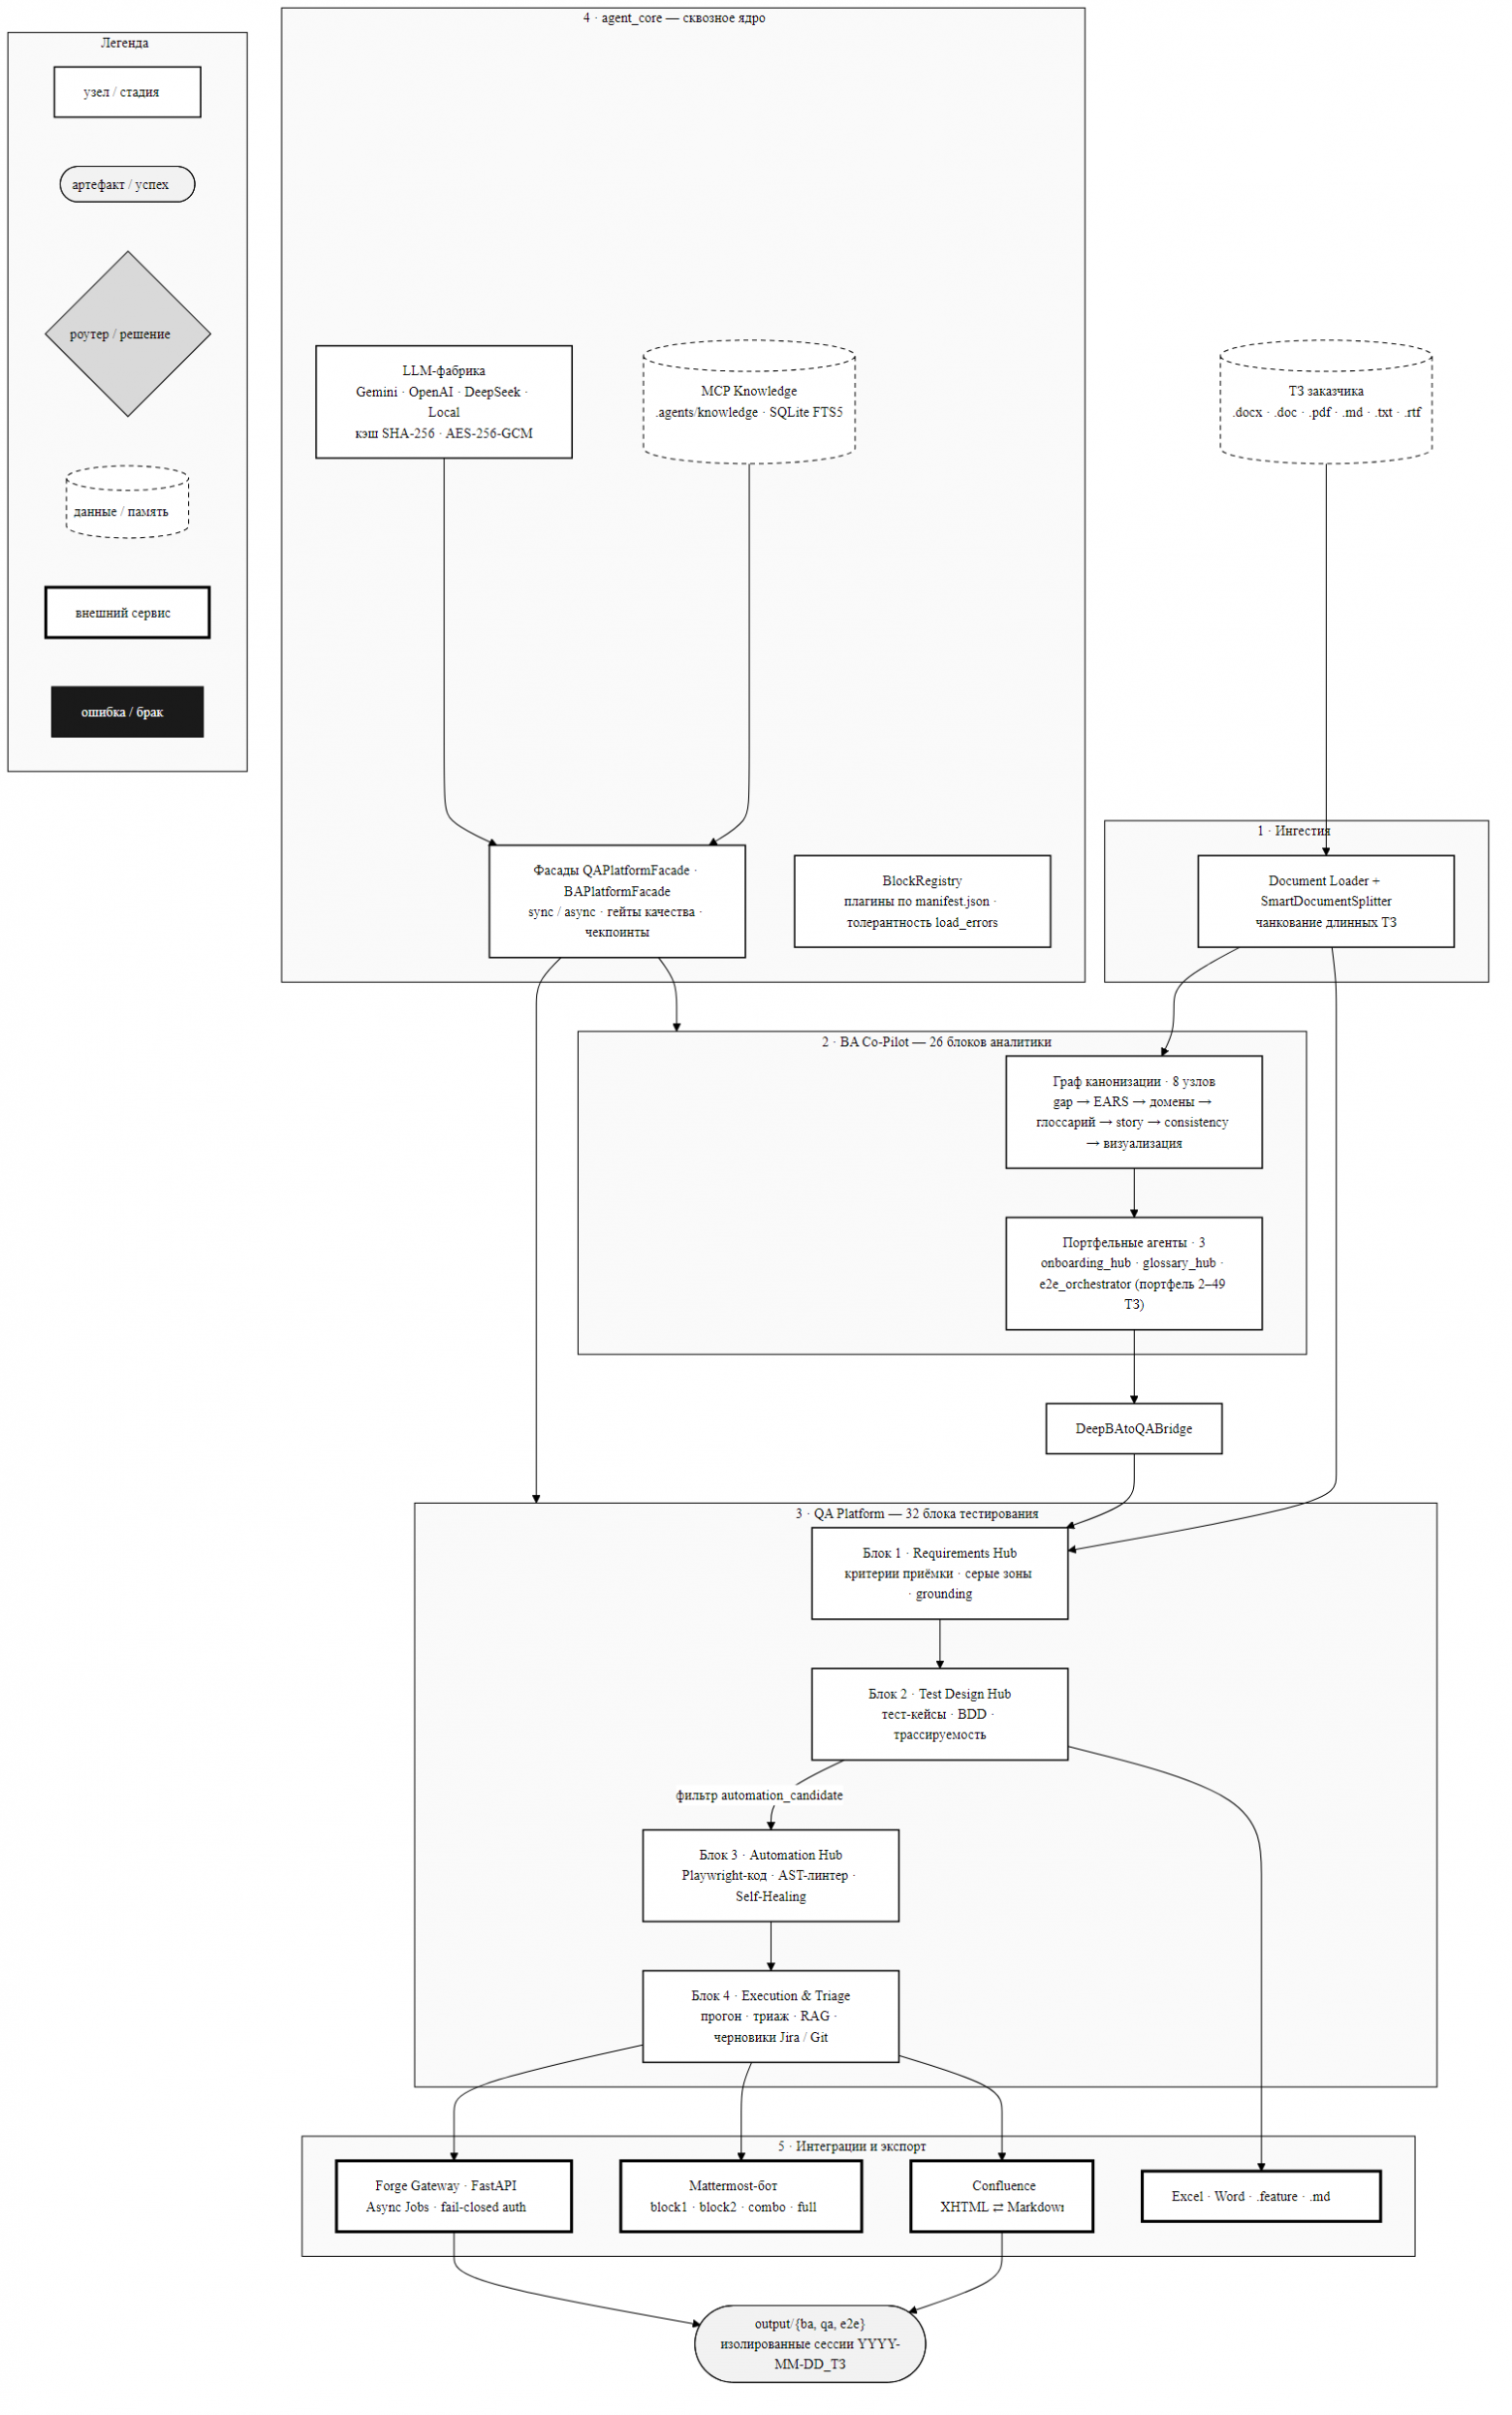
BA Co-Pilot — инструменты бизнес-аналитика: канонизация требований в EARS, User Stories (INVEST) и Use Cases, матрица CRUD с аудитом жизненного цикла сущностей, стресс-тест противоречий между разделами ТЗ, поиск «белых пятен» с готовым опросным листом для стейкхолдера, мастер-глоссарий и онбординг-паспорт для новых участников.
QA Platform — четыре ступени: Requirements Hub (критерии приёмки, серые зоны) → Test Design Hub (тест-кейсы, чек-листы, Gherkin BDD, трассируемость) → Automation Hub (Playwright TS/Python, AST-линтер, контур Self-Healing) → Execution & Triage (прогон в песочнице, триаж, черновики действий для Jira).
Сверху это скреплено мостом и обвязкой:
-
мост BA → QA: канонизированная спецификация запускается в QA-конвейер без ручного переноса; мульти-ТЗ режим — анализ портфеля из 2–10+ ТЗ с выявлением межсистемных коллизий и «оборванных» цепочек;
-
интеграции: Confluence (двунаправленная конвертация Wiki/XHTML ⇄ Markdown, публикация артефактов), Jira (черновики задач с маппингом приоритетов), Mattermost-бот, экспорт в Excel и Word (тест-планы в фирменном стиле), REST-шлюз на FastAPI с асинхронными задачами — всё это умеет подниматься в Docker одной командой;
-
любая модель через OpenAI-совместимый API: облачные провайдеры или полностью локальный контур (Ollama / vLLM) — данные наружу не уходят в принципе;
-
кэш ответов LLM: повторный анализ того же документа не расходует токены, прогоны воспроизводимы;
-
плагины: новые блоки конвейера добавляются как отдельные модули, без правки ядра — платформу можно наращивать под любую специфику.
Форматы на входе: .docx, .doc, .txt, .md, .rtf, .pdf, для BA — ещё и веб-архивы Confluence (.mhtml). Запуск — двойным кликом по батнику, drag&drop файла на батник, консолью или через Docker.
В архиве версий теперь целый выводок предшественников; на каком по счёту «МАЯК» я остановился, честно, уже не скажу — имя осталось, потому что задача та же:
быть ориентиром в тумане требований.
Почему я не верю одному промпту
Зачем конвейер, если можно скормить ТЗ модели и попросить тест-план?
А потому что в этой задаче LLM галлюцинирует уверенно и красиво:
-
модель «додумывает» требование, которого в ТЗ нет, и строит на него полноценный тест-кейс — выглядит безупречно;
-
в сводке красуется «покрытие 100%», хотя часть критериев вообще не извлеклась, а часть извлеклась из воздуха;
-
неоднозначность («система должна отвечать быстро» — это 500 миллисекунд или 5 секунд?) молча превращается в конкретику — угаданную. Потом тест падает на проде не потому, что код плохой, а потому что поведение никто так и не определил;
-
один и тот же промпт в двух сессиях даёт разные наборы кейсов, и понять, что изменилось, невозможно.
Отсюда принцип, на котором стоит вся платформа:
LLM предлагает — гейты проверяют — человек смотрит только то, что не сошлось.
Это моя вторая статья про недоверие к моделям: в ScanReader я не верил модели на чтении документов; МАЯК — про то же недоверие, но на создании.
Конвейер: сверху и в разрезе
Сверху — пять ступеней:
ТЗ (.docx/.pdf/.mhtml/...)
  → BA Co-Pilot: канонизация EARS, глоссарий, CRUD, вопросники
  → мост BA → QA
  → QA: Блок 1 (требования) → Блок 2 (тест-дизайн) → Блок 3 (автотесты) → Блок 4 (прогон и триаж)
  → артефакты: Markdown, Word, Excel, Gherkin .feature, версии для Confluence
Путь одного документа по конвейеру — артефакт за артефактом:
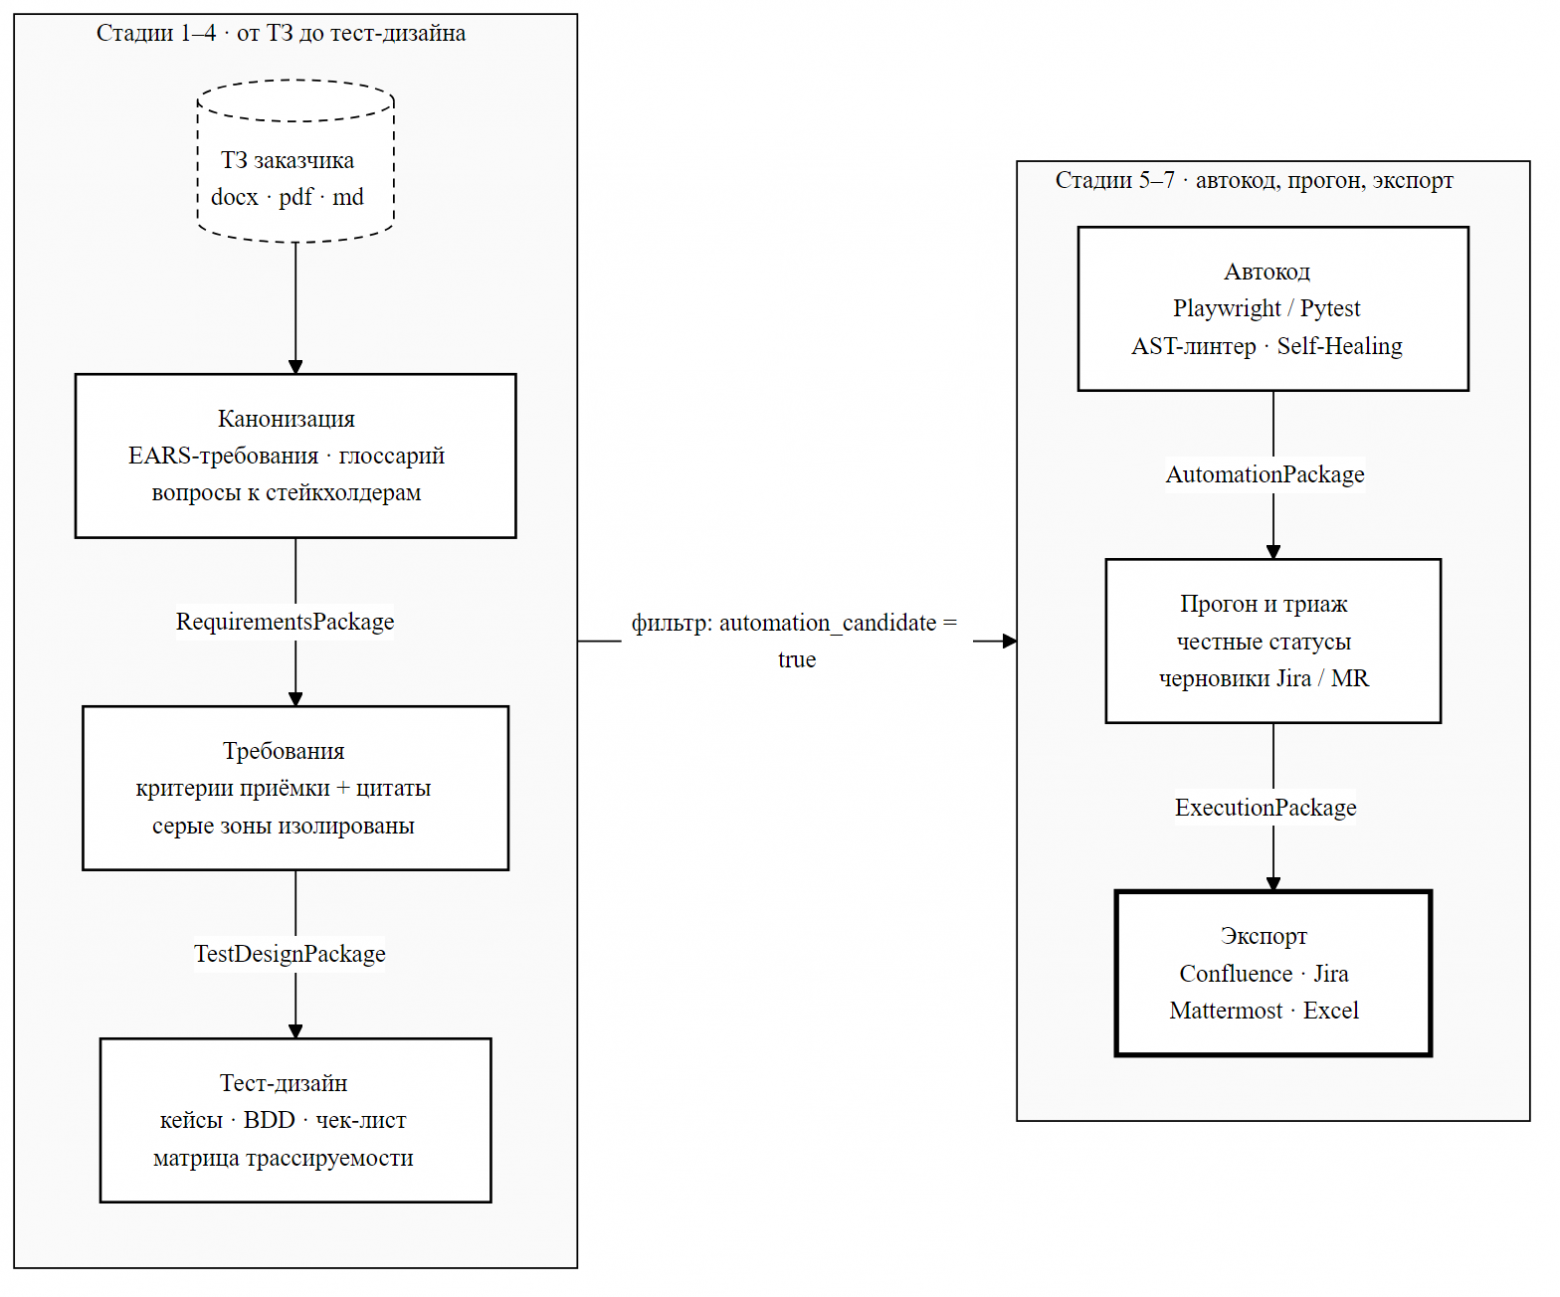
В разрезе — та самая микросервисность. Те самые 32 блока тестирования и 26 аналитики раскрываются в узлы графов и их суб-шаги: у каждого — собственная задача, собственное состояние, собственный контракт данных.
Фрагменты зафиксированных последовательностей (топологии графов):
Блок 1: scout → reader (map-reduce слияние чанков) → ambiguity_checker → package_assembler
Блок 2: architect → traceability → checklist → bdd → e2e_journey → assembler
Блок 3: generator → linter (AST) → self-healing роутер → assembler
Блок 4: runner → triage → rag_embedder → git_manager → jira_slack → assembler
BA:     gap_detector → ears_standardizer → domain_clustering → glossary →
        story_usecase → consistency_guard → process_visualizer → assembler
Петля Self-Healing из Блока 3 — крупным планом:
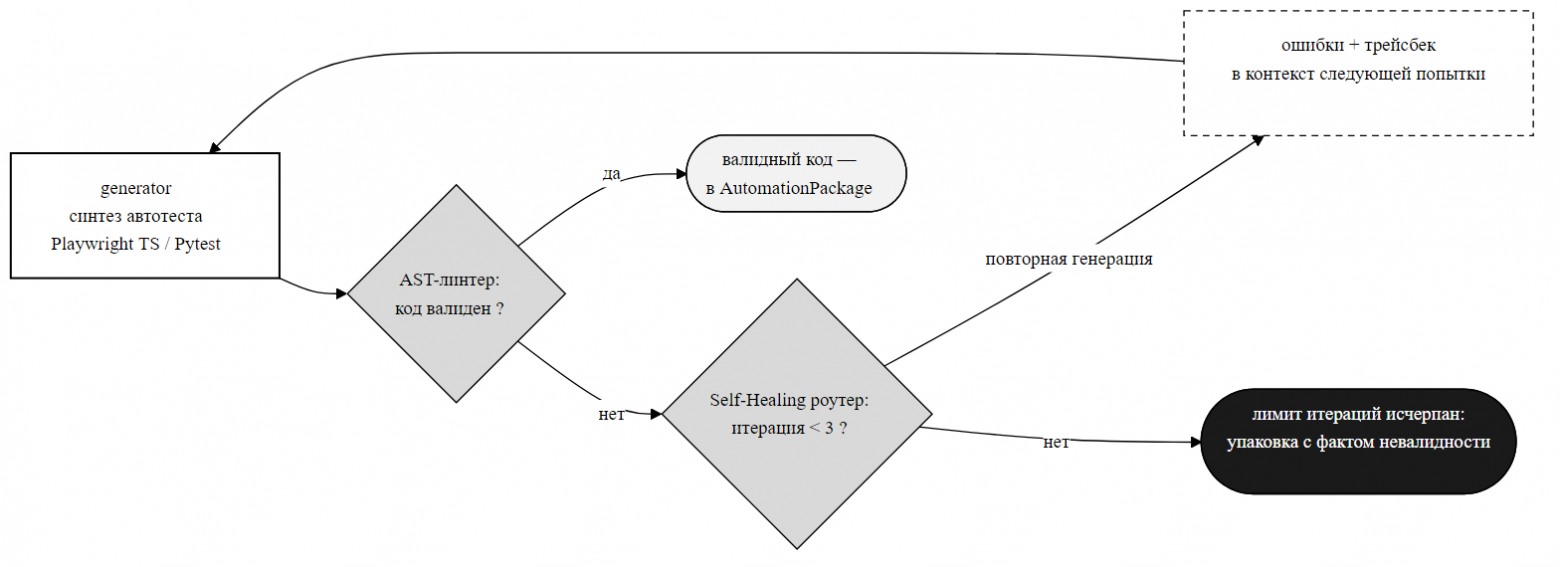
Контракты данных всех узлов — типобезопасные Pydantic v2-схемы, порядок вызовов зафиксирован инвариантами (осознанный выбор: предсказуемость конвейера важнее «гибкости на бегу»), ответы LLM проходят обязательную очистку и валидацию. Добавлять новые блоки и собирать из них разные сценарии (block1, block2, combo, full) можно без риска для остального конвейера — реестр плагинов толерантен даже к сломанным модулям (они попадают в load_errors, не убивая процесс). Ровно та наращиваемость, которой не хватало монолиту.
Каждый запуск пишет артефакты в изолированную папку сессии (дата_Название_ТЗ), прогоны не затирают друг друга.
Если LLM недоступен — платформа честно сообщает об этом и работает на кэше, а не выдумывает результат.
Как МАЯК говорит «не знаю»
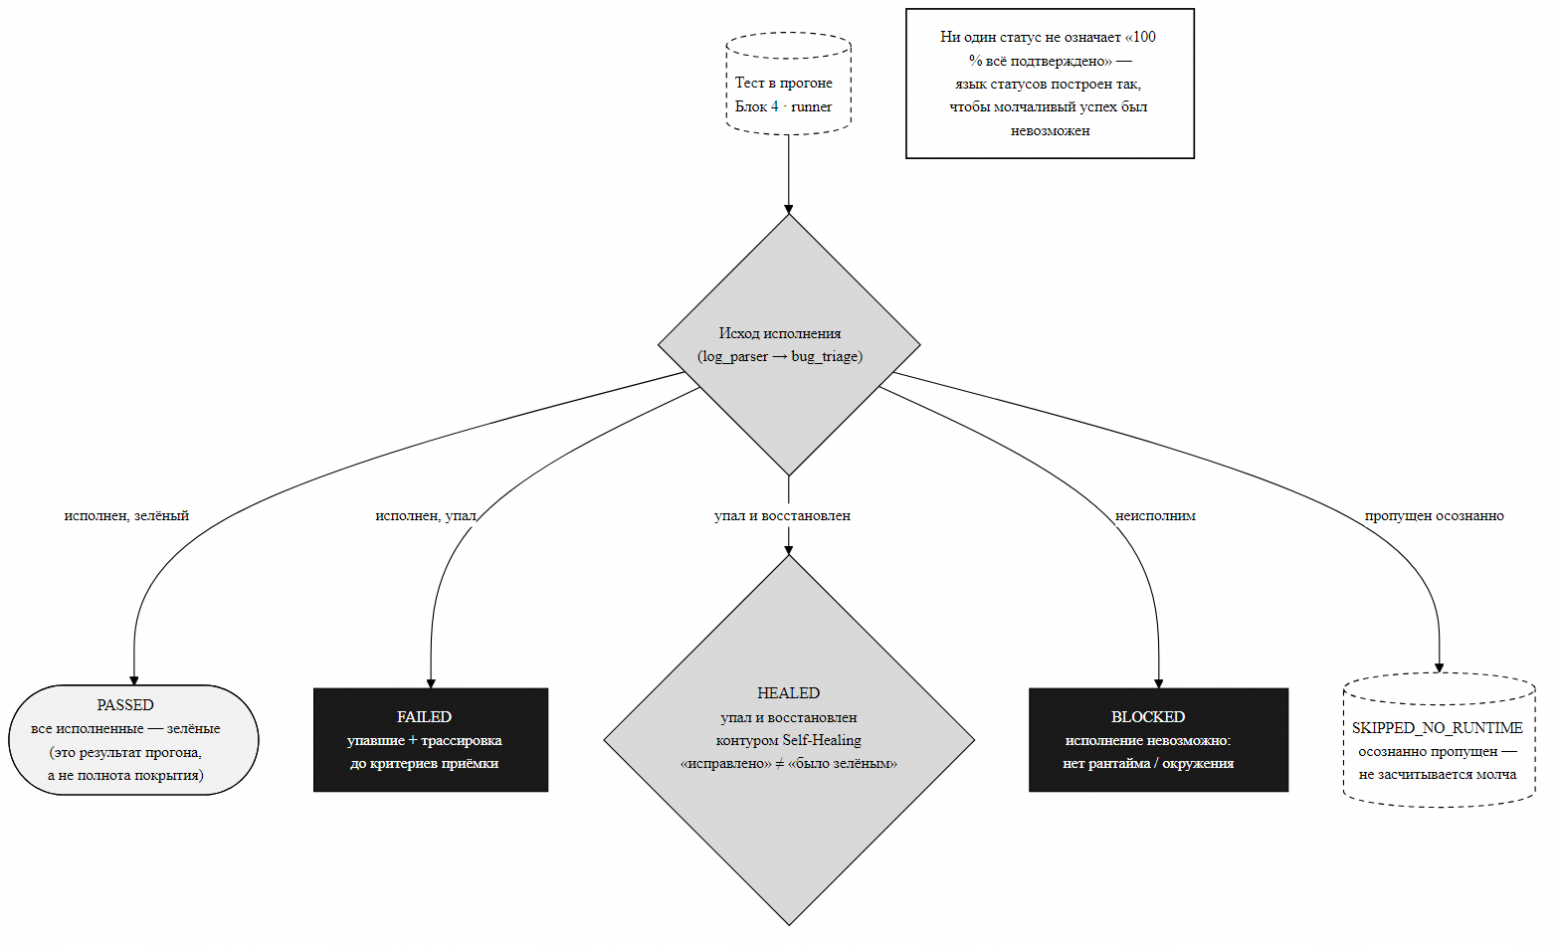
Собственно, чего я жду от машины, которой не доверяю: чтобы она честно говорила, что именно проверено, а что нет. Платформа никогда не говорит «100% подтверждено» — и вот чем это обеспечивается:
-
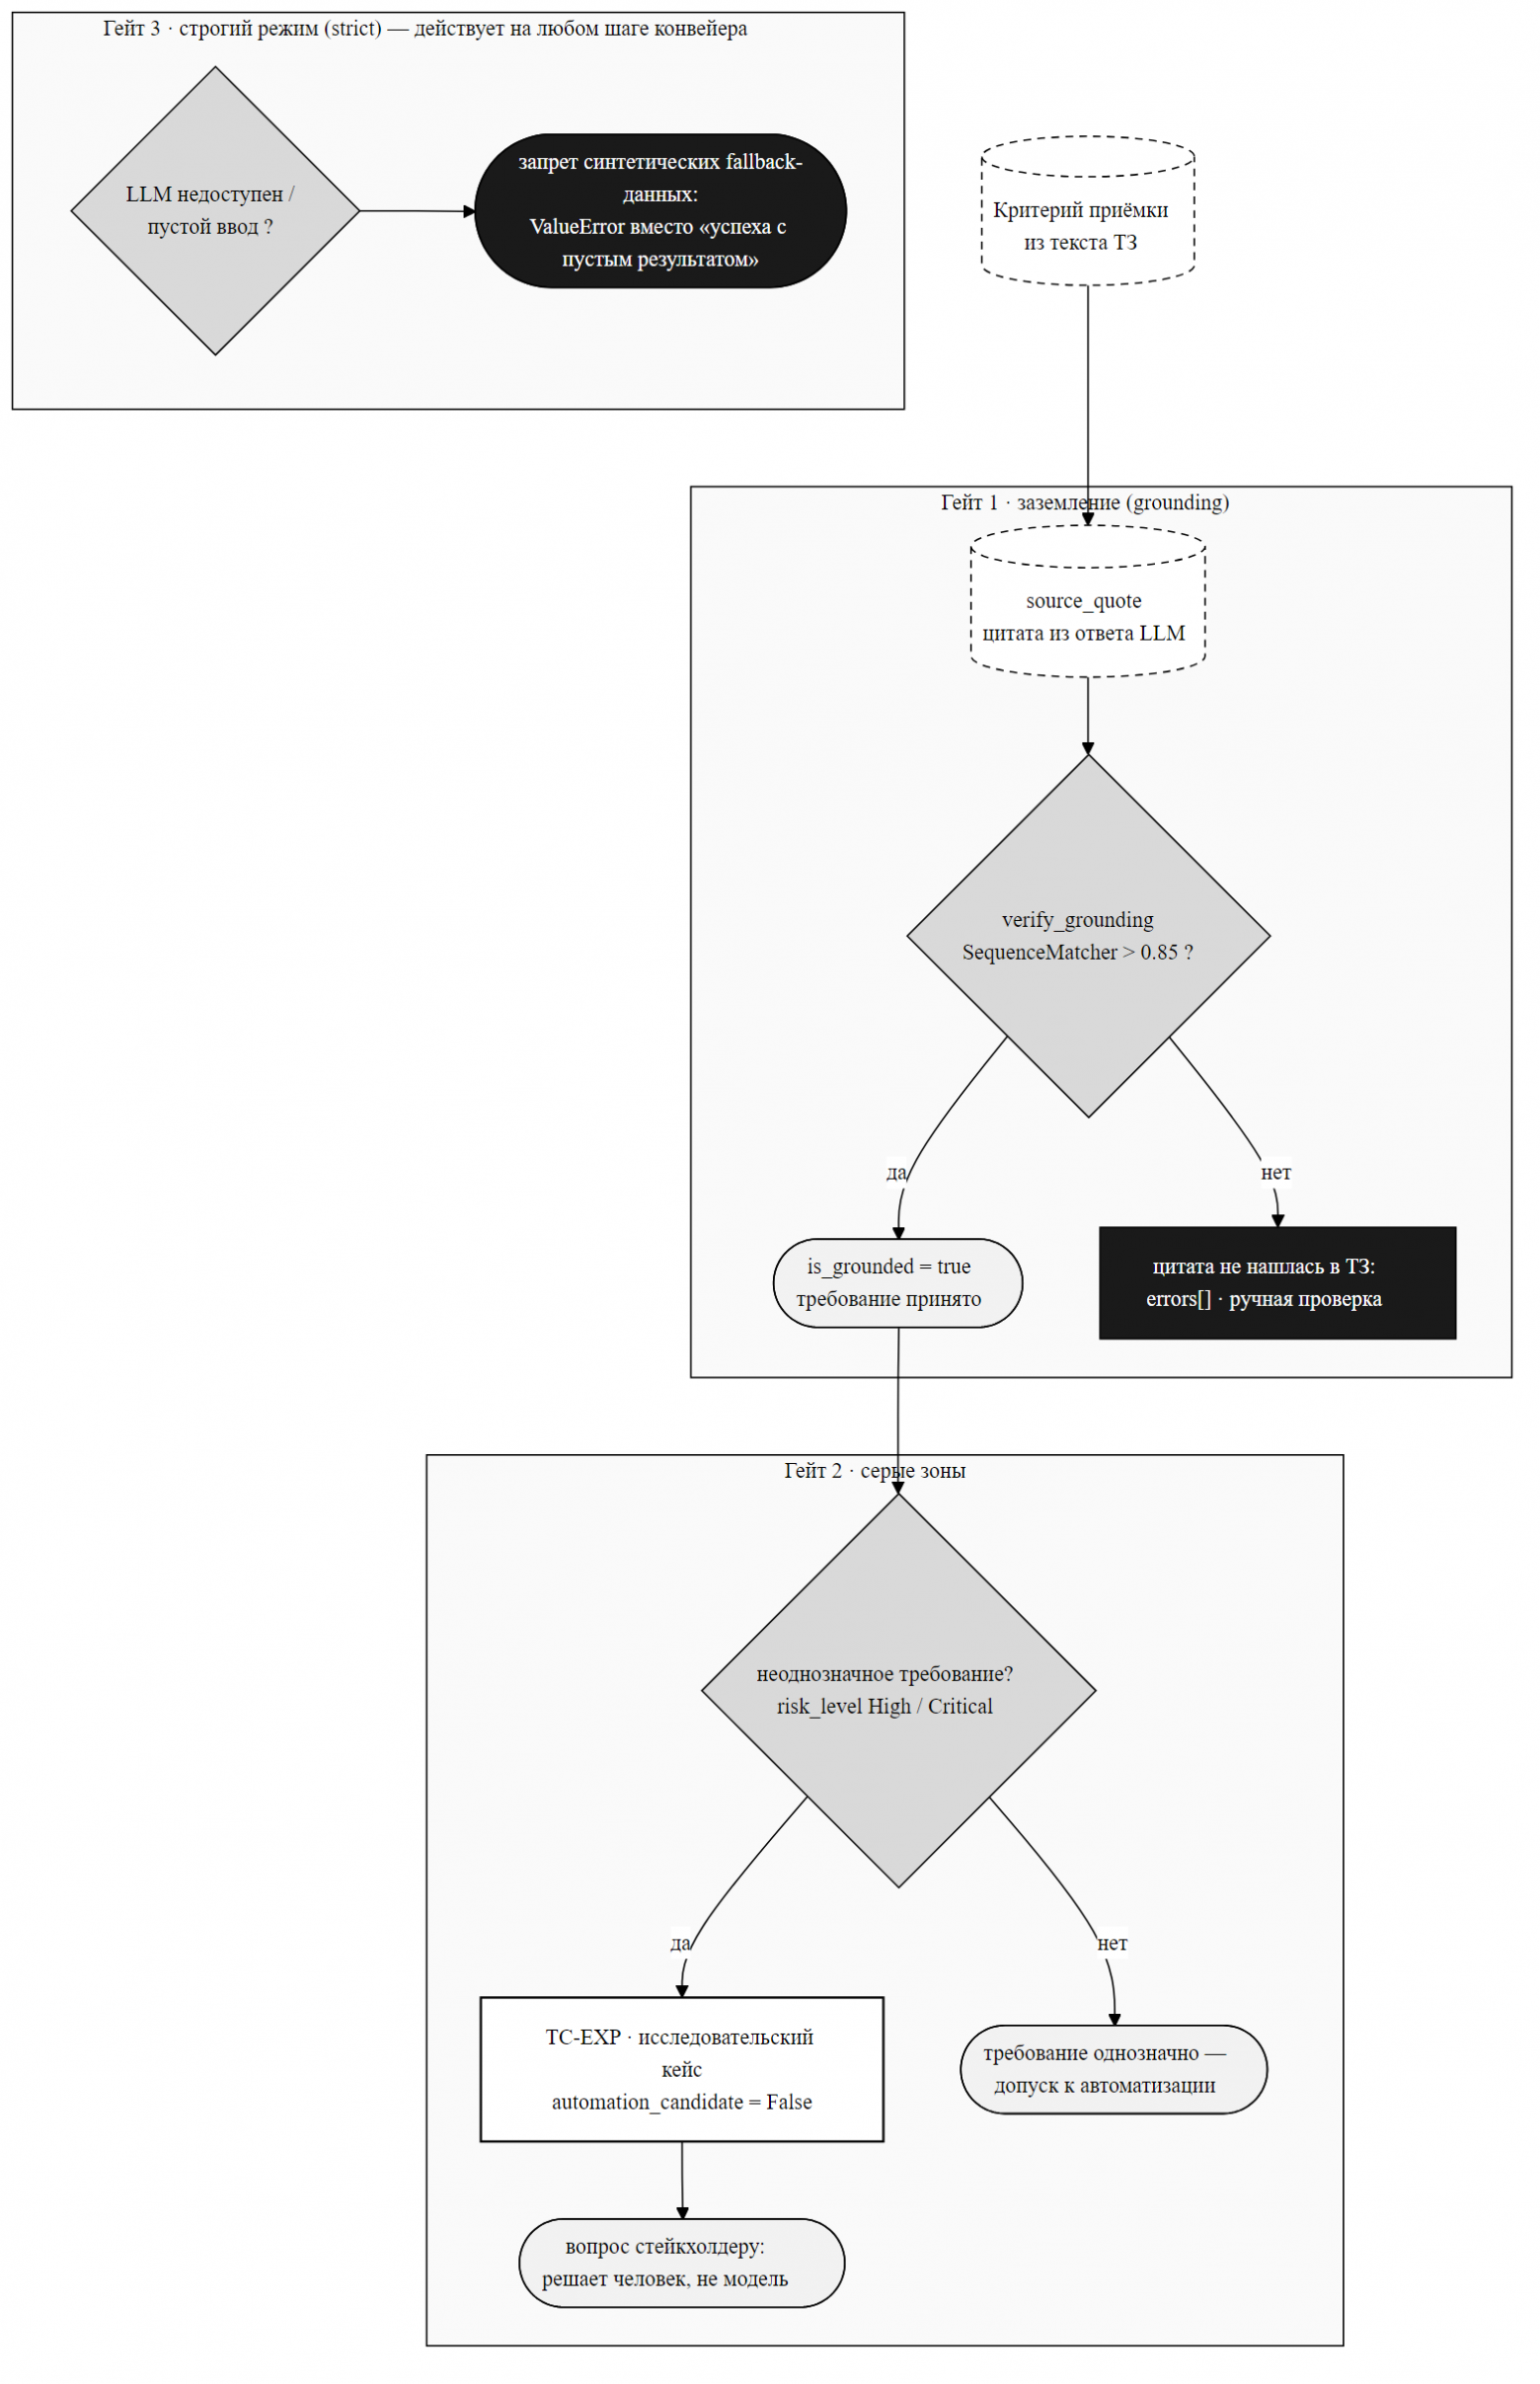
заземление требований: каждый критерий приёмки обязан подтверждаться цитатой из исходного текста ТЗ. Цитата не нашлась — требование помечается, а не молча пропускается;
-
серые зоны не маскируются: неоднозначные места ТЗ превращаются в вопросы к стейкхолдеру, а не в угаданную конкретику;
-
изоляция серых зон от автоматизации: тест-кейсы, построенные на неоднозначных требованиях, физически не допускаются к генерации автотестов. Автоматизация не должна «угадывать» поведение за аналитиков;
-
строгий режим: при сбоях LLM запрещены синтетические fallback-данные; пустой ввод — гарантированная ошибка вместо «успеха с пустыми результатами».
Барьеры до кода — как устроены гейты:
Статусы прогона — это то, как Маяк взаимодействует с человеком:
|
Статус |
Что это значит |
Что делаю я |
|---|---|---|
|
|
все исполненные тесты зелёные |
читаю как результат прогона, а не как полноту покрытия |
|
|
есть упавшие, трассировка до критериев — в отчёте |
разбираю через триаж |
|
|
тест упал и восстановлен контуром Self-Healing |
помню: «исправлено автоматически» ≠ «всегда было зелёным» |
|
|
исполнение невозможно (нет рантайма/окружения) |
чиню окружение, а не делаю вид, что прогон был |
|
|
тест осознанно пропущен |
не даю ему засчитаться молча |
Появление статусов — от исхода исполнения:
Проверка на себе: ТЗ с секретиками
Прежде чем писать это, я прогнал платформу на себе.
Взял синтетическое ТЗ «Система заказа гостевых пропусков» — написал с нуля, без клиентских данных, 3,3 тысячи символов — и заложил туда болезни живых ТЗ: противоречие по времени отмены (один пункт разрешает отмену «до начала визита», другой блокирует её за 15 минут), «быстро», «по возможности», «несколько» и безразмерный «большой поток».
Такое ТЗ не жалко показать целиком, поэтому дальше — живые фрагменты вывода, а не пересказ.
|
Прогон |
На выходе |
Время |
Токены |
|---|---|---|---|
|
QA: анализ и тест-дизайн (Блоки 1+2) |
32 критерия, 20 серых зон, 54 кейса, 120 пунктов чек-листа, 37 BDD |
26,5 мин |
~270k |
|
BA: опросный лист |
26 вопросов по четырём ролям |
90 сек |
~14k |
|
BA: стресс-тест противоречий |
10 коллизий, CRUD-аудит 4 сущностей |
13,4 мин |
~194k |
Все 32 критерия заземлены цитатами из исходника — ни один не выдуман.
Покрытие критериев тест-кейсами — 81,2%, и платформа сама предупреждает о шести непокрытых, вместо «100% готово».
Коллизия по отмене — как её видит платформа (AMB-12 из отчёта, дословно):
В окне 15 мин–2 часа отмена требует подтверждения администратора, но не определено: что происходит при молчании администратора до начала визита (заявка активна, гость приезжает — дедлок); может ли администратор аннулировать пропуск в последние 15 минут, когда отмена «блокируется системой»; и то, что блокировка «на уровне интерфейса» не защищает от прямого вызова API — ограничение обходится на серверной стороне.
Вопрос стейкхолдеру:
Утвердите финальную матрицу отмены: (а) более 2 ч — сотрудник отменяет сам; 15 мин–2 ч — подтверждение администратора, при молчании N минут — эскалация или автоматическая отмена; менее 15 мин — только аннулирование администратором? (б) Подтвердите, что правило 15 минут валидируется на сервере.
BDD из границы «2 часа» (дословно из .feature):
Сценарий: [TC-3] Отмена за 1 ч 59 мин до визита: заявка переходит в «Отменена» только после подтверждения администратора
  Дано Заявка №103 (гость Сидоров Сидор Сидорович, визит сегодня в 15:00, статус «Новая»). Системное время — 13:01 (до визита 1 час 59 минут — верхняя граница класса «менее 2 часов»). Доступен администратор системы.
  Когда Сотрудник открывает «Мои заявки» и нажимает «Отменить заявку» для №103
  Тогда Система отображает сообщение «Отмена менее чем за 2 часа до визита требует подтверждения администратора»
  И До подтверждения администратором статус заявки №103 не меняется на «Отменена»
  И После подтверждения администратором статус заявки №103 — «Отменена»
Не «проверить отмену заявки», а верхняя граница класса, конкретные данные и наблюдаемое поведение — такое можно отдавать автоматизации и стейкхолдеру на подпись.
Два вопроса из опросного листа (из 26, дословно):
Архитектору (SLA): Каковы точные числовые NFR: целевое время отклика API (P95/P99, мс), число одновременных пользователей и пиковый RPS в дни конференций? — «быстро» и «устойчиво при большом потоке» неизмеримы: проектировать инфраструктуру не на что.
Юристу/DPO: Какие ПДн гостей обрабатываются, на каком правовом основании, где хранятся и включена ли система в реестр операторов ПДн? — обработка без основания — прямой риск по 152-ФЗ.
А теперь честное, без чего цифры выше — враньё.
Первое: закладка «большой поток» QA-блоком не поймана — формулировка не выглядит неоднозначной, пока не спросишь «сколько именно»; поднял её опросный лист.
Считаю честно: 9 ловушек из 10 — автомат, десятая — человек с вопросником от машины на руках.
Второе: BA-канонизация местами обогащает текст — в коллизию SLA доставки письма она сама дописала «1 минуту», которой в ТЗ нет (в исходнике только «не позднее 5 минут»), а нумерация требований местами поехала (дубли REQ-26/27).
Я нашёл это только сверкой с исходником.
Вывод тот же, что во всей статье: машина ускоряет, финальная истина — ревью человеком.
Цифры без фанфар
-
862 автоматических теста с гейтом покрытия ≥ 85% (фактически 87.69%) на четырёх зонах платформы. Важно: это покрытие кода самого инструмента — оно говорит о том, что платформа не разваливается при рефакторингах, а не о «правильности» ваших тест-планов;
-
полный сьют прогоняется за 20 минут; каждый старый баг в платформе закрыт регресс-тестом;
-
это внутренние измерения зрелости кода, а не сравнение с рынком — открытого бенчмарка «ТЗ → тест-дизайн» в природе нет;
-
экономию токенов даёт кэш: повторный анализ неизменённого документа бесплатен;
-
200+ реальных ТЗ через платформу — счёт набит не синтетикой, а папками сессий: каждое честное «не сошлось» оборачивалось правкой, и версии платформы итерировались по живым проколам;
-
пилот на коллегах внутри компании — по итогам внесены коррективы. Это не цифра зрелости кода, а проверка на людях: где платформа удобна и где мешает, знаю не из догадок.
Кто что получает
-
Аналитик — вопросы, а не загадку. Белые пятна и противоречия ТЗ собираются в опросный лист — на созвон с Product Owner выходишь с конкретикой.
-
QA-инженер — исключения, а не всё подряд. Серые зоны помечены, трассируемость «критерий → кейс» есть у каждого пункта, покрытие чек-листа считается отдельной метрикой и не подменяет покрытие тест-кейсами.
-
Руководитель — портфель целиком. Мульти-ТЗ анализ: коллизии между системами, оборванные цепочки, сводный Master Test Plan по десяткам документов.
-
Новый участник — онбординг за вечер. Онбординг-паспорт и глоссарий проекта генерируются из тех же ТЗ.
-
Интегратор — без ритуалов. Артефакты публикуются в Confluence, приоритеты маппятся в Jira, отчёты уходят тредами в Mattermost.
|
Роль |
С чего начать |
|---|---|
|
Бизнес-аналитик |
канонизация ТЗ → вопросник стейкхолдеру → глоссарий → Confluence |
|
QA (ручное) |
комбо Блоков 1+2 → чек-лист и тест-план → Excel/Word |
|
QA (автоматизация) |
полный конвейер 1→4 → ревью спек → линтер → прогон |
|
Ведущий QA |
Master Test Plan по портфелю + Delta Diff при обновлении ТЗ |
|
DevOps / интегратор |
Docker-шлюз, асинхронные задачи, REST API |
И сразу про ожидания, чтобы никто не иллюзировал: «замены аналитика», «замены QA», «100% качества требований», «готовых к продакшену автотестов без ревью» и «работы на любом ТЗ» — не будет.
Реалистичная картина: машина извлекает, канонизирует и проверяет согласованность, человек разбирает серые зоны и принимает решения.
А что у соседей
Прямого аналога — системы, которая идёт от ТЗ через канонизацию требований к тест-дизайну с гейтами доверия — я не нашёл ни в open source, ни в SaaS.
Искал честно; звёздность GitHub указана на октябрь 2026, проверяется руками.
Соседи по задачам:
|
Категория |
Примеры |
Что дают |
Чего не хватает нам |
|---|---|---|---|
|
Enterprise ALM-сьюты |
Tricentis (Tosca + qTest + Copilot), Siemens Polarion, Jama Connect |
полный цикл «требования → тесты → прогон», трассируемость, governance |
единственные закрывают сопоставимый объём — но это облачные enterprise-лицензии «ценник по запросу», и LLM-моста от ТЗ там нет |
|
Test management |
TestRail, Zephyr, qTest |
хранение кейсов, трассируемость |
не генерируют ничего, всё руками |
|
AI test automation (SaaS) |
Testim, mabl, Functionize, testRigor |
запись/самолечение UI-тестов, кейсы из plain English |
работают от кода приложения, а не от ТЗ; данные наружу; нет BA-контура |
|
Spec-driven OSS |
GitHub spec-kit (139k звёзд, MIT), Kiro (AWS) |
канонизация требований в спеку и задачи для кодинг-агента |
останавливаются на «задачах»: ни тест-дизайна, ни исполнения, ни интеграций |
|
Браузер-агенты OSS |
browser-use (117k звёзд), Stagehand, Playwright MCP |
живой агент ходит по реальному приложению и верифицирует поведение |
не работают от ТЗ: нет канонизации, трассируемости, честных статусов |
|
Кодинг-агенты |
Claude Code и подобные |
билет Jira → готовые Playwright-тесты |
нет методологии тест-дизайна и трассируемости до требований |
|
«Спросить у ChatGPT» |
любой чат |
быстрый черновик |
нет конвейера, статусов, гейтов, трассируемости и экспортов; результат невоспроизводим |
|
Каркасы |
LangGraph, MetaGPT (70k звёзд) и прочие |
конструктор для сборки своего |
это субстрат, а не решение — МАЯК собран как раз из такого субстрата, но сам им не является |
Картина, в общем, забавная.
Аналоги продают тот же объём, но за заоблачные деньги и без генерации от ТЗ.
Свежая волна OSS — spec-kit, browser-use — сильнее нас каждый в своей вертикали (спеки, живое исполнение), но решает соседние задачи и останавливается там, где начинается наша работа.
Пустой остаётся именно связка: ТЗ → канонизация → тест-дизайн → прогон, с честными статусами и локальным контуром.
Вклад проекта — не «ещё одна GPT-обёртка», а эта связка плюс enterprise-интеграции. При этом внутри — обычные открытые компоненты.
Каков итог всего этого?
Пробуйте, дерзайте – самые сумасбродные мысли реализуемы)
Вопрос лишь в вашем упорстве и желании получить результат – но результат не просто для галочки, а воспроизводимый, контролируемый
Так же прикладываю 2 своих открытых библиотеки:
Отрисовка схем, починка, контроль – через неё собственно и отрисованы все схемы, которые вы видите https://github.com/Riper21/MermaidGuard
Создание матриц трассируемости, тест-дизайна – он так же есть внутри проекта, его результаты вы видите ниже https://github.com/Riper21/TestCraft
Автор: AntonUdyurminsky

