


Мужик в клетке
В первой статье я довольно скептически прошёлся по карточкам в духе Anki: слово в столбике – ярлык в пустоту. А вчера одна собака в парке заставила меня сесть и проектировать карточки для своей же системы. Только не такие.
Идём мы с женой вчера по парку и видим: посреди газона решётка, как тюрьма, а внутри стоит один мужик. Мы такие: о, мужик плохо себя вёл в парке, ему тут персональную тюрьму построили. Поржали. Потом дошло, что это площадка для дрессировки собак, а его собака просто носилась где-то в стороне, мы её заметили только потом.
И я спрашиваю: а как «собака» по-португальски? Жена: блин, забыла. Я тоже. Два года языка, слово из первой сотни, а в голове пусто. Так и шли по парку, перебирая варианты, пока не вытащили: cão. Обрадовались и начали перечислять всех животных, которых знаем.
А сегодня утром я проснулся, вспомнил вчерашнюю собаку – и в голове сразу, без малейшей паузы, выскочило cão. Вчера двадцать минут мучений, сегодня ноль. И мне это показалось подозрительно знакомым.
Знаю, но не успеваю
Собака – смешной случай. Но за ним стоит проблема, которая бесит меня в португальском больше всего, и я уверен, что не только меня.
Тебе говорят фразу. В ней слово, которое ты точно знаешь: учил, писал, слышал в сериале, но значение не приходит сразу. Мозг полез за ним в дальний ящик. Пока он там роется, собеседник сказал ещё два предложения, и ты их пропустил: внимание было занято поиском. В итоге стоишь и хлопаешь глазами, хотя по отдельности знаешь каждое слово.
Это не «не знаю слово». Это «знаю, но медленно». И это две разные болезни. Первую лечит любое приложение. Вторую, как выяснилось, не лечит почти никто, потому что почти никто её не меряет.
А утреннее cão было ровно её обратной стороной: слово, которое вчера доставалось двадцать минут, сегодня выскочило мгновенно. Значит, скорость доступа к слову тренируется. Вопрос – чем и как часто.
Тут я и сел копать, что об этом известно науке. Ждал готового ответа, а нашёл половину ответа и одну дырку, в которую придётся лезть самому.
Что про это говорит наука
У психолога Роберта Бьорка есть модель, где у каждого воспоминания две силы. Сила хранения: насколько глубоко слово лежит. Сила доступа: насколько легко оно достаётся прямо сейчас. Они живут отдельно. Cão у меня лежало глубоко, а вот достать его вчера было почти невозможно.
И дальше парадокс, ради которого стоит знать эту модель. Сильнее всего хранение растёт не тогда, когда слово достаётся легко, а когда оно почти ушло и ты его с трудом выцарапал. Бьорк называет это желательными трудностями. Повторить слово, которое и так вылетает мгновенно, почти бесполезно. Двадцать минут мучений в парке были идеальной тренировкой.
Это подтверждается и экспериментами. В 2006-м Рёдигер и Карпик показали эффект тестирования: попытка вспомнить даёт больше, чем повторное прочтение, хотя сразу после занятия всё выглядит наоборот. Пайк и Роусон в 2009-м добавили, что чем труднее было извлечение во время тренировки, тем лучше слово держится потом. А Корнелл, Хейс и Бьорк – что даже неудачная попытка вспомнить, после которой ты видишь ответ, полезнее, чем просто показ ответа.
Вывод для системы: встреча со словом и вспоминание слова – разные события. Слово мелькнуло в сериале и ты его узнал – это перечитывание. Ты его откопал сам – это тренировка.
Как часто повторять
Самое большое исследование интервалов – Сепеда и коллеги, 2008. Больше 1350 человек учили факты, повторяли их через разный промежуток, до 3,5 месяца, и проходили финальный тест через срок до года. Чем дальше тест, тем длиннее должна быть пауза перед повтором – но не пропорционально. Если проверка через неделю, повторять стоит через день-два, то есть через 20-40% срока. Если через год – через месяц-полтора, всего 5-10%.
И там же есть асимметрия, которая для меня оказалась важнее самих процентов: слишком короткий интервал вредит гораздо сильнее, чем слишком длинный.
Второе: форма расписания почти не важна. Карпик и Бауэрншмидт в 2011-м сравнили растущие, равные и сужающиеся интервалы. Сама разнесённость повторов дала огромный эффект – порядка двухсот процентов прироста долгосрочного запоминания против повторов подряд. А вот преимущества у какой-то конкретной схемы не нашлось. Так что идеальная формула вида 1-3-7-21 не нужна, нужно просто не повторять подряд.
Почему одни слова быстрые, а другие нет
Один из самых старых результатов психолингвистики – эффект частотности: частые слова распознаются быстрее редких. Разница тут не в том, знаешь ты слово или нет, а во времени доступа. Частое слово разогнано тысячами встреч. Редкое ты тоже знаешь, но доставал его десять раз за два года, и оно так и осталось медленным.
А Норман Сегаловиц много лет изучал автоматизацию лексического доступа во втором языке: время реакции продолжает падать ещё долго после того, как точность упёрлась в сто процентов. То есть слово, которое ты «уже знаешь», можно разгонять дальше. Именно этот этап обычно и считают законченным.
Где наука молчит
Все исследования интервалов, которые я нашёл, меряют «вспомнил или нет», а не «за сколько». Как интервал должен зависеть от скорости правильного ответа, готовых чисел нет. Эту дырку придётся закрывать своими данными – как именно, ниже, в разделе про алгоритм.
Почему не просто Anki
Логичный вопрос: так поставь Anki и не изобретай. Интервалы там есть, алгоритм FSRS вообще хорош. Но у меня к нему три претензии, и все три вылезли из того, что выше.
Первая: Anki оптимизирует точность, а не скорость. Ему всё равно, вспомнил ты слово за полсекунды или за пять, и то и другое – «помню». Кнопки «легко» и «трудно» есть, но это субъективная самооценка, а не секундомер. А в разговоре вся разница именно в этих четырёх с половиной секундах.
Вторая: Anki не знает, что ты видишь в жизни. Он одинаково гоняет слово, которое ты встречаешь сто раз в день, и слово, которое попадается раз в месяц. Первое тренирует сама жизнь, ему карточка не нужна. Второе как раз и тормозит, но в общей колоде у него нет никакого приоритета.
Третья: Та, из-за которой я ругал карточки в первой статье. Карточка «португальское слово – русский перевод» тренирует маршрут mesa – «стол» – смысл. Ускоряет перевод, а не понимание. А в разговоре слово прилетает не текстом, а звуком, и не одно, а склеенным с соседями.
Что я строю
Из всего этого сложилась фича, которую я сейчас делаю на сайте. Снаружи она похожа на Anki, внутри устроена наоборот.
Карточка, которая звучит
Ты выставляешь, сколько раз в день получать уведомления. Приходит уведомление с голосовым: слово, вырезанное из живой фразы и короткий кусок в два-три слова вокруг, а не чистый синтез отдельного слова – про то, почему ровная речь вредна, я писал во второй статье.
Послушал, попытался вспомнить, перевернул. На обороте не перевод слова, а фраза из твоего же контента, где оно встречалось, и её перевод. Слово возвращается в своё облако смысла, а не к русскому ярлыку.
Каждый раз фраза другая, и голос тоже. Если слово попадалось в десяти местах, система крутит их по очереди, а остальные лежат под кнопкой «где ещё встречалось». Это та же идея high variability training, что и со звуками, только для смысла: слово, которое ты встречал в разных контекстах и разными голосами, потом достаётся из любого нового.
В обе стороны
Я гонял первые карточки и в какой-то момент понял, что сделал не совсем то, что было с собакой в парке, мы ведь не слово на слух не поняли, мы его сказать не могли. А я построил карточку, которая тренирует обратное: услышал – понял. Та же болезнь, только в другую сторону, и ей нужна своя карточка, видишь слово и фразу на русском, говоришь его по-португальски, переворачиваешь и слышишь оригинал. Таймер у обратной стартует с показа. Понимание и говорение разгоняются отдельно, так что у каждого направления своя устойчивость и свой интервал: слово может быть быстрым на слух и тормозить на выходе.
Одна кнопка и секундомер
На карточке одна кнопка: «не вспомнил». Не нажал – значит, вспомнил. Никаких четырёх анковских градаций, в которых все путаются.
Скорость система меряет сама. Для карточки на слух – от конца аудио до переворота. Переворот и есть момент «я закончил вспоминать». Получается три состояния из одного клика и одного таймера: перевернул быстро – слово в порядке, интервал растёт сильно; перевернул медленно, но кнопку не нажал – слово есть, но тормозит, интервал растёт слабо; нажал «не вспомнил» – слово возвращается раньше.
Карточка в обратную сторону устроена так же, только без аудио и без переворота. На лице – перевод фразы из твоего же контента, в нём подсвечено одно слово, и нужно сказать его по-португальски. Не «как переводится стол», а что ты сказал бы в этой ситуации. Зажал кнопку, сказал, отпустил. Секундомер идёт от показа карточки до нажатия: сколько ты думал, прежде чем открыть рот. Распознавание речи сверяет сказанное с целевым словом и показывает процент совпадения; совпало – ответ засчитан без единого клика. Не совпало – решаешь сам: сказал верно, просто плохо услышало, или правда не вспомнил. Говорить негде – жмёшь «не могу говорить», и до конца порции такие карточки отвечаются переворотом, как слуховые.
Это два разных навыка, и считаются они раздельно: у каждого слова две скорости, «узнать» и «сказать», и свой интервал у каждой. Узнать mesa на слух и достать mesa, когда нужен «стол», разные маршруты в голове, и ускоряется каждый своим.
Сколько ждать после провала
Интуитивно хочется вернуть забытое слово через десять минут. По Сепеде это худший вариант: слишком короткий интервал вредит сильнее всего, а вспомнить слово, которое видел десять минут назад, слишком легко, чтобы это было тренировкой.
В моём случае новых слов в этих карточках нет: всё прошло через диктовку и лежит в моих текстах. Забытое слово – это слово с сильным хранением и просевшим доступом, а такое по Бьорку переучивается быстро. Поэтому после провала оно возвращается через день-два, а не через минуты. Передержать дешевле, чем недодержать.
Только то, что тормозит
Главное отличие от Anki – откуда берутся слова и в каком порядке. Система знает все мои слова и все места, где каждое встречалось: в текстах, в диктовке, в добавленных фильмах. Для каждого слова есть, как часто его подкидывает твой собственный контент, и есть, как часто его надо доставать, чтобы оно не тормозило.
Где контент сам справляется, карточки не нужны: частотные слова выпадают из очереди сами, их естественный интервал короче любого карточного. А наверх всплывает длинный хвост – слова, которые ты знаешь, но жизнь подкидывает раз в пару недель, и всякий раз мимоходом. Именно на них ты и стоишь в разговоре с открытым ртом.
Встреча в фильме при этом сдвигает таймер слова чуть-чуть, но не обнуляет: это узнавание, а не вспоминание. А первая карточка по каждому слову – по сути не тренировка, а замер. По времени переворота сразу видно, разогнано слово или нет.
Как считается интервал
Главный трюк простой: новую математику я не изобретаю, я меняю определение успеха. Классические системы считают вероятность вспомнить слово. Я считаю вероятность вспомнить его быстро – быстрее порога, который успевает за разговором. Перевернул дольше порога – для алгоритма это не успех: кнопку не нажал, слово не ушло, но и интервал не растёт. Всё остальное – стандартная машинерия, только целится она в скорость.
У каждой карточки одно число — устойчивость S, в днях. Вероятность быстро вспомнить слово падает с каждым днём после того, как ты его в последний раз вытащил, и карточка приходит, когда эта вероятность опускается до целевой, скажем 0,85.
После каждого показа S пересчитывается. Вспомнил быстро – растёт, и тем сильнее, чем ниже была вероятность в момент показа: это Бьорк, переведённый в формулу, трудное извлечение даёт больше. Чем ближе к порогу, тем рост меньше, за порогом – ноль: слово остаётся с тем же интервалом. Нажал «не вспомнил» – S падает вдвое, но не до нуля, и слово приходит не раньше чем через сутки.
В формуле четыре буквы. q – скорость ответа от 0 до 1: на уровне своих самых быстрых – около единицы, на пороге – около нуля. a – насколько сильно растёт S при лучшем ответе. b – насколько больше награда за слово, которое почти ушло. c – какая доля S остаётся после промаха.
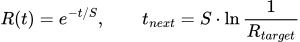
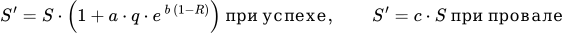
Под конкретного человека
Подстраиваются три вещи.
Порог скорости. Нормы у всех разные: кто-то быстрее тапает, кто-то читает с телефона в метро. Поэтому порог считается по самому человеку – по тому, как быстро он переворачивает частые слова, которые точно знает. Медленно – это медленно для тебя, а не для среднего пользователя.
Коэффициенты a, b, c. Стартовые берутся общие, а после пары сотен карточек подбираются по логам: так, чтобы модель лучше всего предсказывала реальные ответы этого человека. Так работает оптимизатор FSRS, только он учится на нажатых кнопках, а мой – на секундомере.
Целевой уровень R. Он зависит от того, сколько уведомлений в день человек готов получать. Выставил пять – система сама поднимет планку и оставит в очереди только самые просевшие слова.
Чего я пока не знаю
Цифр по этой фиче у меня ещё нет, она только строится. Я не знаю, насколько реально упадёт время вспоминания и перенесётся ли это ускорение из карточки в живой разговор. Карточка — это всё-таки тихая комната, а не родительское собрание, где все говорят одновременно.
Не знаю и того, как именно интервал должен зависеть от скорости. Наука тут молчит, так что первые коэффициенты будут на глаз, а дальше их придётся подбирать по логам – своим и семьи. Через пару месяцев покажу, что получилось, в том числе если не получилось.
И да, я понимаю иронию: человек, который в первой статье ругал карточки, пишет статью о том, как делает карточки. Только карточки оказались ни при чём. Претензия была к тому, что они тренируют, а не к самой форме.
Вопрос в зал
У вас бывает, что слово вроде знаешь, но пока вспоминаешь, разговор ушёл? На каком языке и на каких словах – частых или редких?
И если вы сидите на Anki или другой SRS: замечали, что карточка у вас «легко», а в живой речи то же слово тормозит?
Автор: jey_k

