


Посетитель открыл товар A. По истории переходов с ним связан B, по описанию похож C, по изображению — D. Сам A тоже стоит оставить: посетитель его посмотрел, но покупка ещё не зарегистрирована. Как из этих предложений собрать список, в котором не больше 20 рекомендаций?
На этом примере разберу систему, которую я собрала на Coveo SIGIR eCOM 2021, Public Data Release 1.0.0. Из исторического каталога на 14 314 SKU она отбирает до 300 кандидатов, рассчитывает для них признаки и передаёт их в LightGBM. Модель расставляет товары по местам, а локальный HTTP API возвращает до 20 рекомендаций. Модель обучена, результаты оценки приведу в конце.
Код: RecSys-Coveo.
В предыдущей статье я разобрала цель и ограничения записей о покупках. Здесь разберу отбор товаров, расчёт признаков и обучение ранжировщика — модели, которая задаёт порядок выдачи.
Сначала напомню правила времени. Сессия — события с общим идентификатором в Coveo, SKU — идентификатор товара. События с одинаковой отметкой времени считаю одним блоком: их внутренний порядок неизвестен. Выдача формируется один раз, после первого блока с просмотром товара с корректным SKU, если к концу этого блока в сессии ещё нет зарегистрированной покупки.
Модель видит только события, доступные к моменту выдачи. Цель — различные SKU зарегистрированных покупок после выдачи в той же сессии. Окно наблюдения заканчивается через 24 часа или на последней опубликованной записи — что наступит раньше.
Что граф знает о товаре
До обработки запросов я собираю каталог, граф и статистики товаров по 50 000 сессий периода A_G. Наличие покупки не влияет на отбор сессий. Следующие 50 000 сессий, из периода B, идут на обучение ранжировщика. Такое разделение не даёт будущей покупке из B превратиться в ребро графа и подсказать ответ для той же сессии.
Вершины графа — товары. Между ними есть три типа направленных связей:
-
просмотр → просмотр;
-
просмотр → добавление в корзину;
-
просмотр → покупка.
Если после просмотра A посетитель купил B, сессия вносит вклад в связь третьего типа. Обратное ребро B → A из этого не возникает. По ребру также нельзя определить, заменяют товары друг друга или дополняют: оно отражает последовательность действий.
После просмотра товара A ищу последующие просмотры, добавления в корзину и покупки других товаров в той же исторической сессии. В текущей конфигурации учитываю только следующие десять блоков с товарными событиями и только действия, произошедшие не позднее чем через 30 минут после просмотра A. Между событиями внутри одного блока связи не строю: их порядок неизвестен. Чем больше промежуток между событиями, тем меньше вес пары — он убывает экспоненциально.
Если в одной сессии встретилось несколько пар A → B одного типа, беру максимальный вес. Затем складываю вклады разных сессий. Одна сессия добавляет ребру не больше единицы, поэтому повторные открытия одних карточек сами по себе не создают сильную связь.
В текущей конфигурации ребро должно встретиться хотя бы в трёх сессиях. Для каждого товара и типа связи сохраняю до 100 соседей с наибольшим весом. Связи товаров с малой суммой весов дополнительно ослабляю. Для нашего запроса с одним просмотром A балл кандидата B по одному типу связи выглядит так:
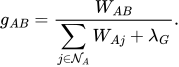
Здесь  — суммарный вес сохранённого ребра,
 — сохранённые соседи A, а
 — параметр ослабления. Если ребра нет, балл равен нулю.
Без добавки в знаменателе единственный слабый сосед после нормировки получил бы единицу. Добавка уменьшает его влияние. Полученный балл описывает силу связи, но не является вероятностью покупки.
Если доступных просмотров несколько, их связи объединяются с большим весом у более свежих просмотров. Для каждого из трёх типов связей остаётся отдельный сигнал. Веса графа рассчитаны по истории; ранжировщик использует их как признаки.
Где искать, если связи не хватило
Товар C может быть похож на A, даже если их редко смотрели в одной сессии. Здесь помогают метаданные. Coveo предоставляет векторы описаний и изображений — числовые представления товаров. Я использую их готовыми и не обучаю модели, которые их построили. У описаний и изображений отдельные пространства: их координаты между собой не складываются.
В каждом пространстве корректные векторы товаров нормируются. Из векторов просмотренных товаров строится взвешенная сумма, которая снова нормируется. Получается представление текущего интереса; кандидаты сравниваются с ним по косинусному сходству. В нашем примере просмотр один, поэтому направление совпадает с вектором A. Если в первом блоке несколько просмотров, они учитываются вместе.
Поисковый запрос до выдачи может дать ещё один источник кандидатов. Согласно описанию Coveo, вектор запроса совместим с векторами описаний товаров — с ними он и сравнивается. Совместимость с векторами изображений не предполагается.
В текущей конфигурации берётся последний доступный поисковый блок. Если он непригоден или старше десяти минут, источник отключается: к более раннему блоку расчёт не возвращается. Последующие клики из поисковой записи не становятся признаками запроса.
Пропущенный вектор нельзя без пояснений заменить нулём. Нулевое косинусное сходство бывает и у корректных перпендикулярных векторов. Поэтому вместе с баллом модель получает маску доступности — признак того, удалось ли его рассчитать. Если представление интереса построить нельзя, соответствующий источник не предлагает товары.
Поиск соседей выполняется точным сравнением с векторами допустимого каталога. Это может помочь товару со слабой историей внутри каталога. Товар за его пределами таким способом в рекомендации не попадёт.
Как собрать 300 кандидатов
Граф, описания, изображения и поиск дают отдельные списки со своими баллами. К ним добавляю недавно просмотренные товары и историческую популярность. Начальные квоты основной конфигурации зафиксированы до оценки:
|
Источник |
Начальная квота |
|---|---|
|
Три типа связей графа |
3 × 50 = 150 |
|
Сходство описаний |
40 |
|
Сходство изображений |
30 |
|
Близость к поисковому запросу |
50 |
|
Недавно просмотренные товары |
20 |
|
Историческая популярность |
10 |
|
Всего |
300 |
После объединения уникальных товаров может оказаться меньше суммы квот. Поискового запроса может не быть, у графа может не хватить соседей, а B может прийти сразу из графа и сходства описаний.
Повторяющиеся SKU объединяются. Для B сохраняется информация об обоих источниках: откуда он пришёл, с каким баллом и на какой позиции. Свободные места заполняются популярными товарами до 300 кандидатов или до исчерпания допустимого каталога. Популярность — число различных исторических сессий с просмотром товара. Начальная квота в десять мест не ограничивает это заполнение, поэтому кандидаты остаются и при недоступности части источников.
Просмотренный A не исключается: его ещё могут купить. Уже купленные товары исключаются, хотя в этом эксперименте сам запрос разрешён только до первой зарегистрированной покупки.
Будущая цель в отборе не участвует. Если нужного товара нет среди кандидатов, ранжировщик уже не сможет его вернуть.
Одна строка на кандидата
Объединить списки недостаточно: нужно задать общий порядок. Графовый балл отражает историческую связь, косинус — сходство представлений, популярность — частоту просмотров. Эти числа имеют разный смысл. Для каждого кандидата я собираю строку признаков, по которой ранжировщик рассчитывает общий балл.
В основной схеме 93 столбца. В них входят баллы и поддержка графовых связей, сходство описаний и изображений, поисковый контекст, просмотры кандидата в текущей сессии, состояние корзины и сессии. Есть категория, ценовая группа, исторические счётчики и признаки происхождения кандидата. Ценовая группа — порядковый номер, а не денежная цена. SKU используется для сопоставления записей и разрешения равных баллов; как числовой признак в модель он не попадает. Полный перечень — в схеме признаков.
Допустим, у B сильная графовая связь с A, но слабое сходство описаний. У C — наоборот. Деревья могут по-разному оценить эти сочетания с учётом категории, поиска и доступных действий с товаром.
Даже если графовый источник не выбрал C в свою квоту, графовый балл для него всё равно рассчитывается, когда это возможно. Отдельный признак показывает, попал ли товар в список этого источника. Квота ограничивает отбор, но не скрывает известную связь от модели.
Для обучения и выдачи используются одни и те же функции расчёта состояния и признаков. Тесты проверяют, что изменение событий после запроса не меняет его кандидатов и признаков. Полная сессия уже лежит на диске, но последующий просмотр C не должен влиять на представление интереса в момент, когда посетитель открыл только A.
Чему учится LightGBM
Из 50 000 подготовленных сессий периода B зарегистрированная цель есть у 625. Запросы этих сессий образуют группы для обучения. Внутри группы кандидат получает метку 1, если его SKU есть в цели, и 0 в остальных случаях.
Нулевая метка означает только отсутствие SKU в зарегистрированной цели. Товар мог не быть показан, а сведения о покупке могли не попасть в записи.
Вернёмся к примеру. Если после запроса зарегистрирована покупка B, парное обучение стремится поставить B выше A, C и D. Для кандидата  с меткой 1 и кандидата
 с меткой 0 основа сравнения — логистическая потеря:
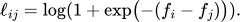
Здесь  и
 — текущие баллы. Чем выше балл целевого товара относительно второго кандидата, тем меньше потеря.
Пары дополнительно взвешиваются по тому, насколько их перестановка изменила бы NDCG@20. Эта метрика учитывает позиции целевых товаров и сильнее ценит верхние места. Если оба кандидата ниже двадцатого места, вес пары равен нулю. Если целевой товар снизу сравнивается с нецелевым из первой двадцатки, перестановка может изменить верх списка, и пара получает ненулевой вес.
Есть и нормировка на число пар с разными метками в группе. Ранги и веса пересчитываются на каждой итерации.
Использую схему LambdaMART: ансамбль деревьев учится упорядочивать товары по парным сравнениям с учётом NDCG@20. LightGBM строит деревья, а производные рассчитывает собственная функция session_lambdas_v1 вместо встроенного objective=lambdarank. Она учитывает все пары с разными метками внутри запроса, веса перестановок и нормировку.
Вместо прямой оптимизации Hit@20 здесь используется парное сравнение с весами NDCG@20. Выходной балл нужен для упорядочивания товаров и не является вероятностью покупки.
Если B не попал в кандидаты и других целевых товаров в группе нет, все метки будут нулевыми. Парного градиента не возникнет. Добавлять B задним числом нельзя: тогда состав обучающих кандидатов зависел бы от будущего. Поэтому 625 сессий с целью не гарантируют 625 групп с обучающими парами. При оценке такие потери отбора остаются промахами.
LightGBM позволяет учитывать числовые и категориальные признаки и их сочетания. В основной модели 200 деревьев; параметры и начальные значения зафиксированы в рецепте обучения. Это базовый вариант для сравнения изменений отдельных компонентов. Сравнения с GNN или трансформером пока не было.
Что получилось на отложенном периоде
В периоде D подготовлено 60 000 сессий. В 748 из них есть зарегистрированная цель. Hit@20 — доля этих сессий, где хотя бы один целевой SKU попал в первые 20 рекомендаций. У всех методов одинаковый знаменатель. Цели вне каталога или списка кандидатов из оценки не удаляются.
|
Метод |
Попадания |
Hit@20 |
|---|---|---|
|
Граф, метаданные и LightGBM |
441 / 748 |
58,96% |
|
Граф и LightGBM без метаданных |
376 / 748 |
50,27% |
|
Последние просмотренные товары с дополнением популярными |
325 / 748 |
43,45% |
|
Популярные товары |
2 / 748 |
0,27% |
Неизвестно, были ли метаданные доступны на момент исторических рекомендаций. В варианте без них отключены отбор и признаки по описаниям, изображениям и поисковому запросу, а также категории, ценовые группы и их производные. Общие счётчики событий сессии, включая события поиска, сохранены.
Для этого варианта заново рассчитаны кандидаты и признаки, а отдельный ранжировщик обучен на том же периоде B. Каталог, сессии и предел в 300 кандидатов сохранены; свободные места заполняются популярными товарами.
Разница между 441 и 376 попаданиями показывает зависимость результата от совместного использования этих данных в данном эксперименте. Она не позволяет разделить пользу описаний, изображений и поиска или исключить временную утечку в неизвестном снимке метаданных. Вклад одного графа таблица тоже не выделяет: по сравнению с простыми методами меняется сразу несколько компонентов.
У доверительного интервала в отчёте статус insufficient. Предварительный период C_smoke охватывает менее недели допустимых стартов; в данных заметен суточный цикл, а выбранные шестичасовые блоки не обоснованы как достаточные для учёта временной зависимости. Это ограничение статистического вывода, а не ошибка подсчёта Hit@20. Таблица описывает полученные результаты, но статистическое превосходство не доказано.
A/B-эксперимента не было, и совпадения с историческими покупками не измеряют рост продаж. Качество на актуальном ассортименте также неизвестно.
Путь от трёх исходных CSV до модели и отчёта проверен на малом прогоне в отдельной установке пакета, без результатов прежних запусков. Команды есть в инструкции воспроизведения. Этот прогон проверил исполнимость инструкции; полный эксперимент на D он не повторял. API проверен локально.
Следующий эксперимент — про отбор кандидатов: что изменится, если дать больше мест товарам, похожим по описанию и изображению? Прогон с 370 кандидатами уже выполнен. В следующей статье разберу, во что превратилось дополнительное покрытие после обучения ранжировщика.
Автор: YaninaK

