


Привет! Меня зовут Руслан Сакаев, я DS-тимлид в Авито. В статье расскажу, как мы внедряли LLM в проверки объявлений и что пришлось достроить вокруг модели, чтобы решение выдержало продакшен.
Статья будет полезна DS/ML-инженерам, MLOps и техническим руководителям, которые уже поняли, что LLM закрывает их задачу, но пока не знают, как обернуть это в готовое продакшн-решение.
В этой статье
Задача и ограничения
Почему LLM хорошо работает в задачах модерации
Мы проверяем больше 20 млн объявлений в сутки, и более 95% проверок уже автоматизировано. Оставшийся поток направляется на дополнительную проверку. На наших объёмах это сотни тысяч объявлений в день, и с ними работают несколько сотен модераторов.
При этом ручная модерация довольно тяжело масштабируется. Регламенты большие и сложные, держать их в голове целиком человек не может. Новому модератору нужно около полугода, чтобы выйти на продуктивное плато по качеству, и всё это время он неизбежно ошибается.
Мы поставили себе цель: перевести проверки на LLM, сохранив качество ручной модерации. Именно LLM, а не очередная классическая модель — по трём причинам.
Понимает контекст и нюансы правил. Регламент — это не список ключевых слов, а десятки страниц формулировок с оговорками, и работа с таким текстом — ровно то, что языковые модели умеют.
Быстрее закрывает новые схемы обхода правил. Когда появляется новый способ, под классическую модель нужно собирать разметку и переобучать её, а то и обучать с нуля. С LLM такого длительного цикла можно избежать.
Масштабируется при росте объёмов контента. При увеличении потока можно наращивать GPU-мощности или переходить на более экономичные модели. К тому же регулярно выходят новые поколения моделей, которые дают то же качество при меньшем размере.
Далее расскажу, из каких компонентов состоит система, которая на момент написания статьи работает в продакшене.
Как передать модели регламент
Главный ориентир в модерации — регламент: модератор обязан проверять объявление в соответствии с ним. Регламент может быть достаточно большим, до 200 страниц. Как подать такой документ на вход модели?
Мы рассматривали три варианта.
👉 RAG. Дешевле на запрос и легче обновлять правила, но появляются промахи retrieval, тяжело обрабатываются пересечения правил, и главное — это отдельный инженерный контур, за метриками качества которого надо следить.
👉 Регламент целиком в контекст. Минимум инфраструктуры и целостное понимание правил, но дорого, медленно, и на больших контекстах у модели проседает внимание и точность.
👉 Промпт, собранный на основе регламента. Низкая стоимость, высокая скорость, стабильное поведение. Минусы — риск потерять смысл при сжатии и более сложная поддержка.
Мы выбрали последний вариант: промпт показал лучшие метрики, а заодно мы избежали второй инженерной системы, которая требовала бы постоянного внимания.
Промпт выглядит стандартно ↓
Задача. Определить, есть ли нарушение правил в объявлении по тексту (заголовок и описание) и фото.
Формат входа. На вход подаётся описание объявления с полями: Заголовок, Описание, Фото.
Требуемый формат ответа. Строго одна строка: True или False. Без пояснений, дополнительных символов и форматирования.
Правила проверки. <…>
Выбор модели
Первое ограничение — мы не можем отправлять некоторые проверки во внешние LLM из-за персональных данных и других юридических рисков. И, в общем-то, этого достаточно, чтобы контур был замкнутым.
Второе — бизнес-требования часто меняются. Регламент не статичен, а под новые правила не всегда получается быстро собрать качественную разметку. Поэтому по возможности хотелось работать без дообучения модели под каждое изменение.
Для сложных нарушений, к сожалению, без дообучения не обойтись, но дообучаем только когда для этого достаточно оснований.
Дальше мы прогнали модели разных размеров по своим задачам.
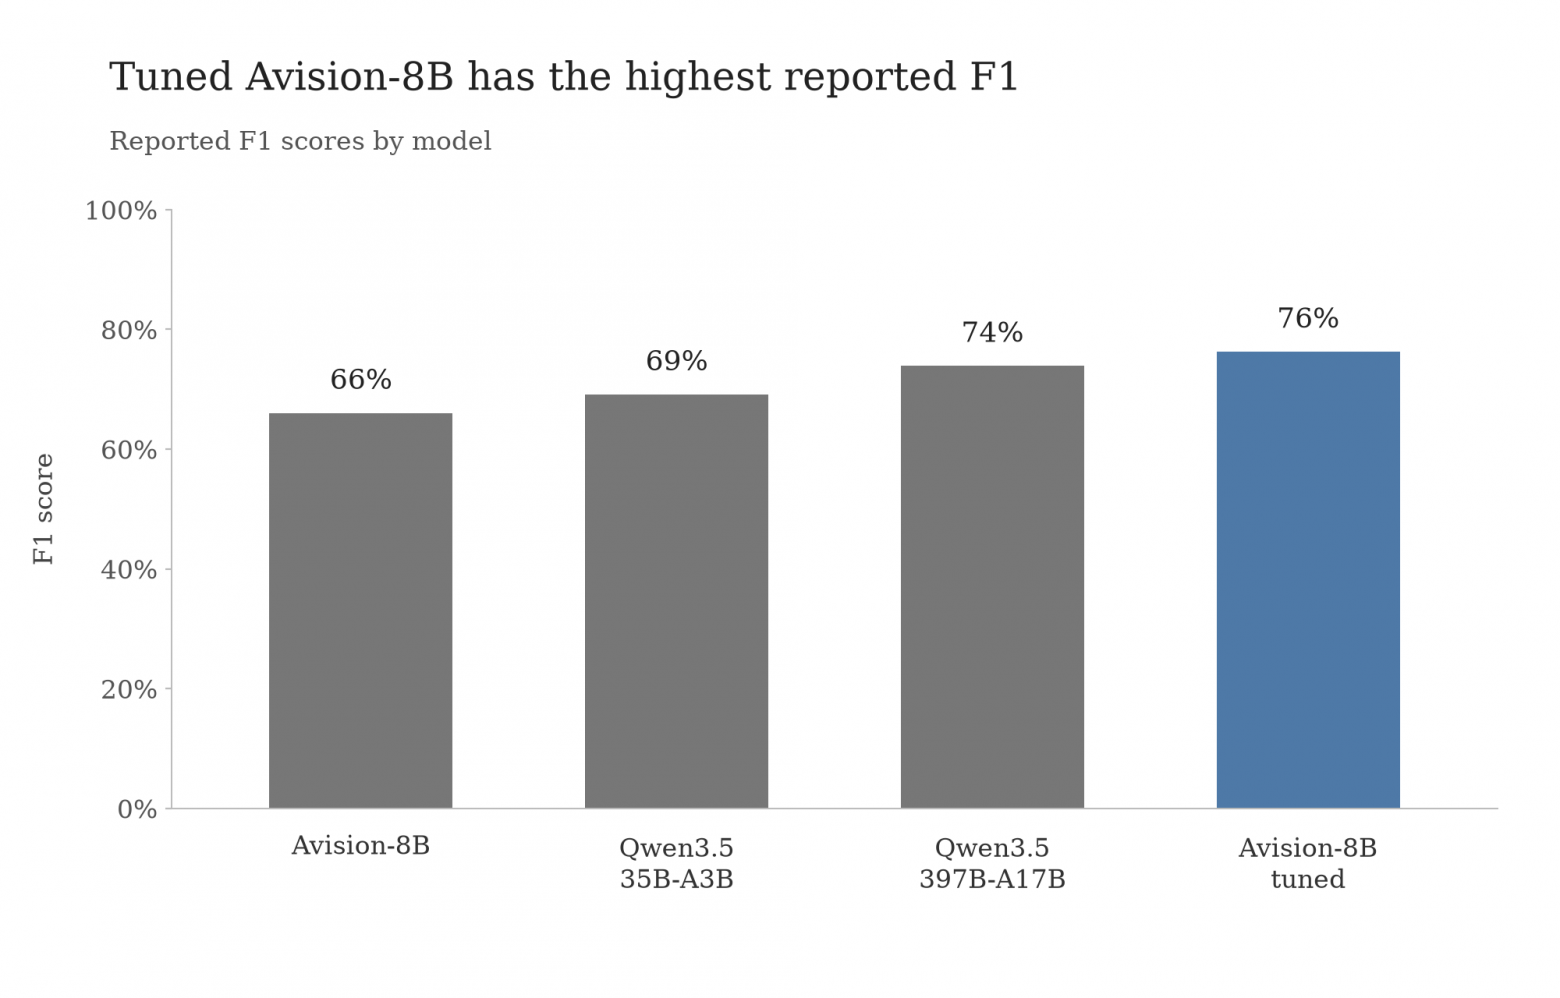
Наша дообученная Avision-8B показывает F1 76%: это лучше, чем у Qwen3.5-35B-A3B, которую мы используем по умолчанию, и даже лучше, чем у 397B-модели. Но для дообучения нужна качественная разметка.
Поэтому при массовом переводе проверок на LLM мы берём 35B-модель из коробки: она даёт высокое качество при наименьшем количестве активных параметров. А на нарушениях, где качество проседает, дообучаем 8B.
Уже после подготовки этого сравнения мы протестировали Jev на наших задачах. По F1 модель превзошла базовую Avision-8B и показала результат на уровне Qwen3.5-35B-A3B. Подход выглядит перспективным для задач модерации, поэтому продолжим за ним следить.
Работа над качеством
Подбор промптов
Регламент написан для человека, а не для модели. В нём есть примеры, разборы пограничных случаев и дополнительные пояснения, которые помогают модератору, но могут мешать LLM.
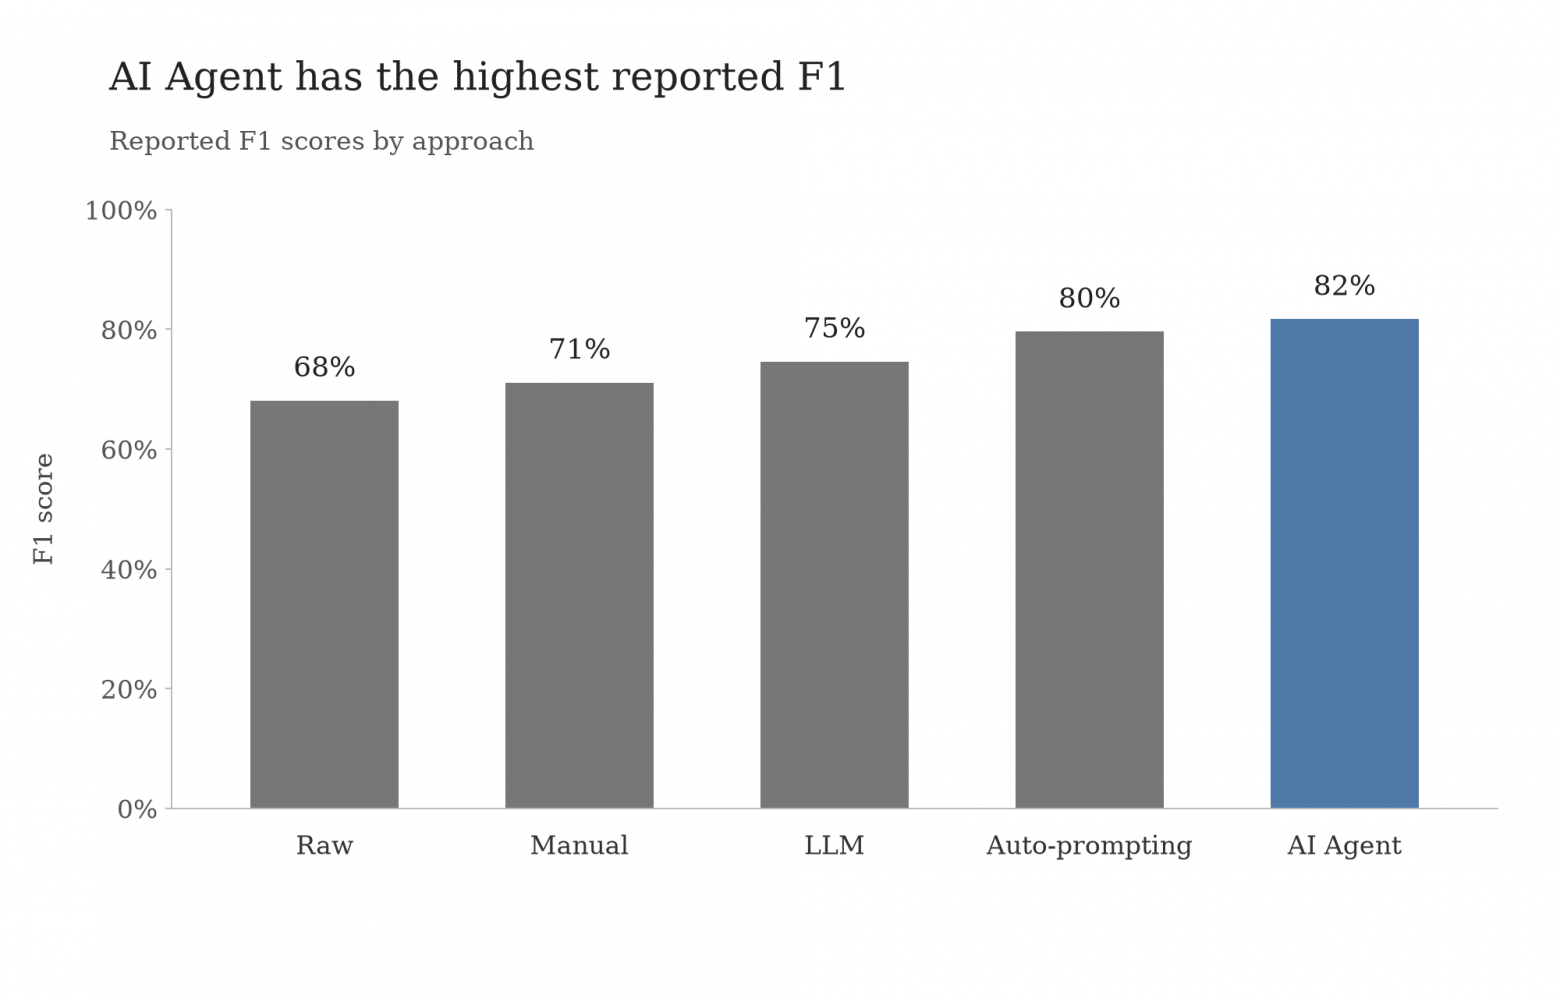
За время работы над проектом мы перепробовали несколько подходов к тому, как превращать регламент в промпт, с каждым шагом улучшая итоговое качество.
0️⃣ Нулевая итерация. Использовали регламент «как есть», без каких-либо изменений.
1️⃣ Первая итерация. Попросили людей, которые каждый день работают с регламентом, переписать его в компактную инструкцию.
2️⃣ Вторая итерация. Модели неплохо пишут промпты друг для друга, поэтому мы использовали LLM для переписывания регламентов в промпты, а результат проверяли вручную.
3️⃣ Третья итерация. Решили считать промпт гиперпараметром модели, а гиперпараметры оптимизируют алгоритмически, а не интуитивно. Поэтому мы начали использовать алгоритмы автоподбора промпта.
4️⃣ Четвёртая итерация. Мы сделали набор MCP-серверов и скиллов для агента: разбор ошибок, оптимизация параметров, запуск автоподбора промпта и обучения адаптеров.
Теперь мы запускаем агентов, которые оптимизируют метрики, а нам остаётся проверить и принять результат.
Автоподбор промпта
У себя мы используем адаптированный вариант GEPA. Пробовали и другие методы, например MiPRO, ProTeGi, SAMMO, SkillOpt, CoolPrompt, но в наших экспериментах они не давали существенного прироста качества и не ускоряли сходимость.
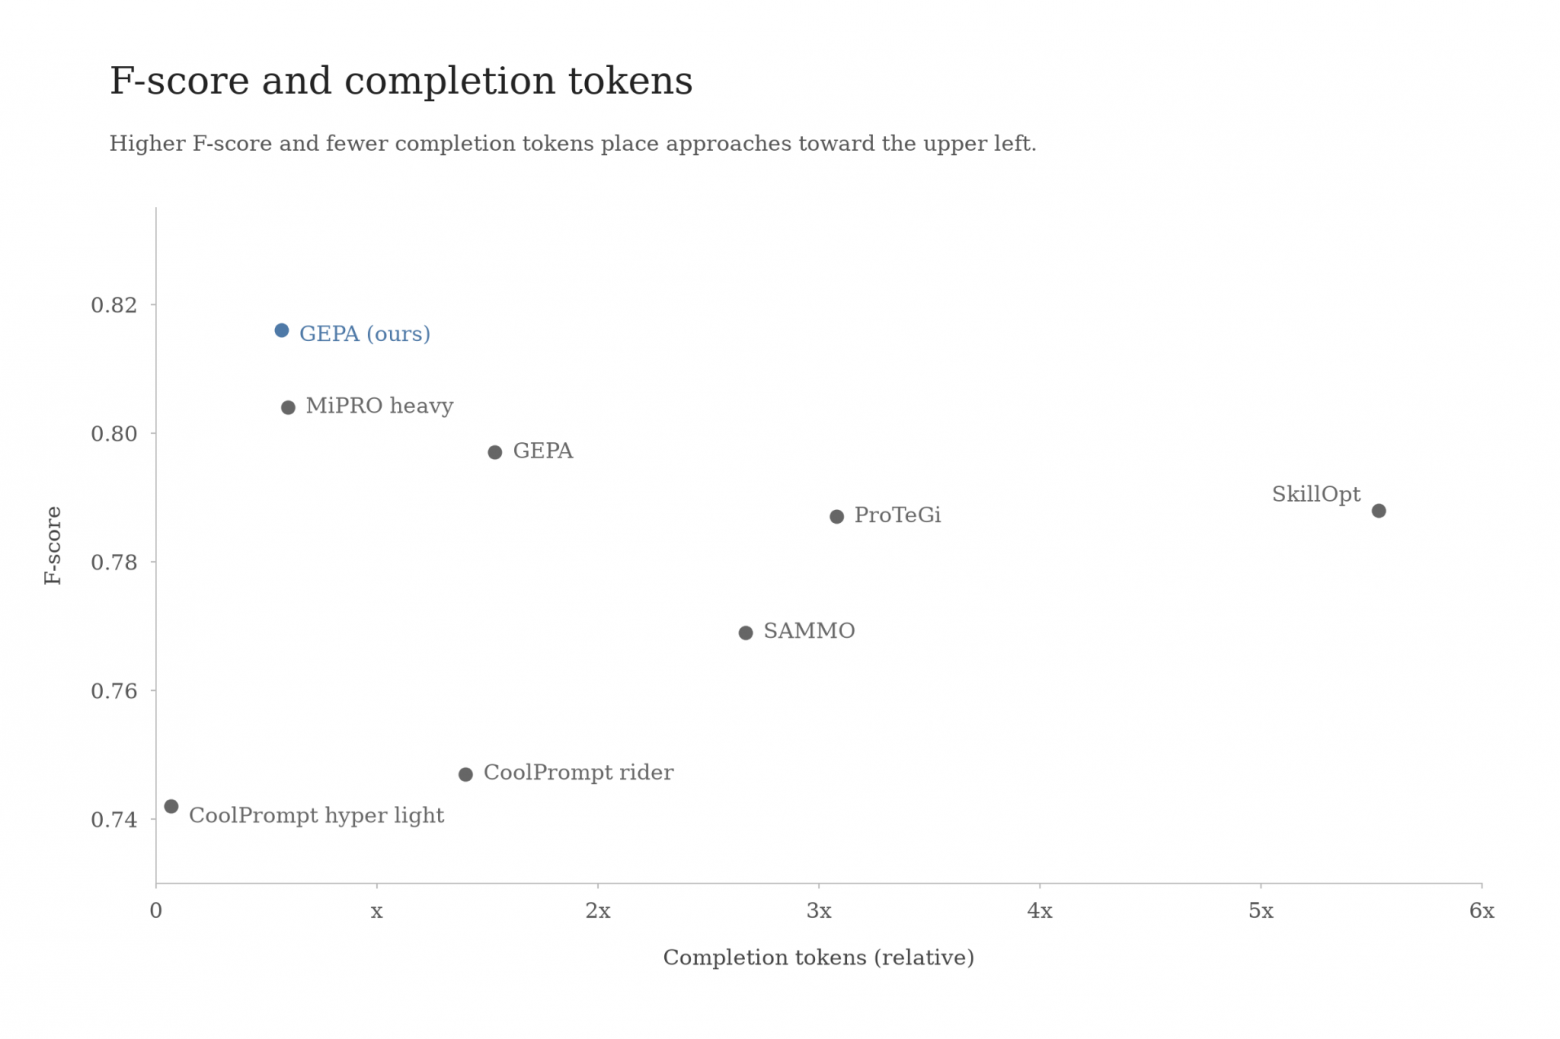
Под наш кейс GEPA пришлось поправить в трёх местах:
👉 Используем вероятности токенов — забираем из модели вероятности True и False, а не только сам ответ.
👉 Ограничили, насколько сильно промпт может меняться за одну итерацию. Иначе промпт полностью переписывается на каждом шаге, что делает метрику сильно волатильной и замедляет сходимость.
👉 Перевели внутренние инструкции на русский — внутри фреймворка они на английском, и на нашей задаче перевод дал прибавку к качеству.
Результаты и ограничения автоподбора. У автоподбора три плюса: его можно применять к разным задачам с LLM, он даёт хорошее качество и не раздувает промпт — итоговый текст остаётся компактным, его можно быстро прочитать глазами.
Но у автоподбора есть и ограничения. Процесс занимает много времени и требует значительных вычислительных ресурсов. Кроме того, оптимизатор может переобучиться под выборку, а LLM — добавить в промпт ошибочные формулировки. Поэтому итоговый вариант нужно проверять на отложенных данных и валидировать вручную.
Подробнее про разные методы работы с промптами в статье: «Как оптимизация промптов превратилась из шаманства в инженерную дисциплину»
Обучение LLM
Для дообучения моделей используем LoRA на NLP-слоях, vision-слои не трогаем — не наблюдали прироста качества при их обновлении.
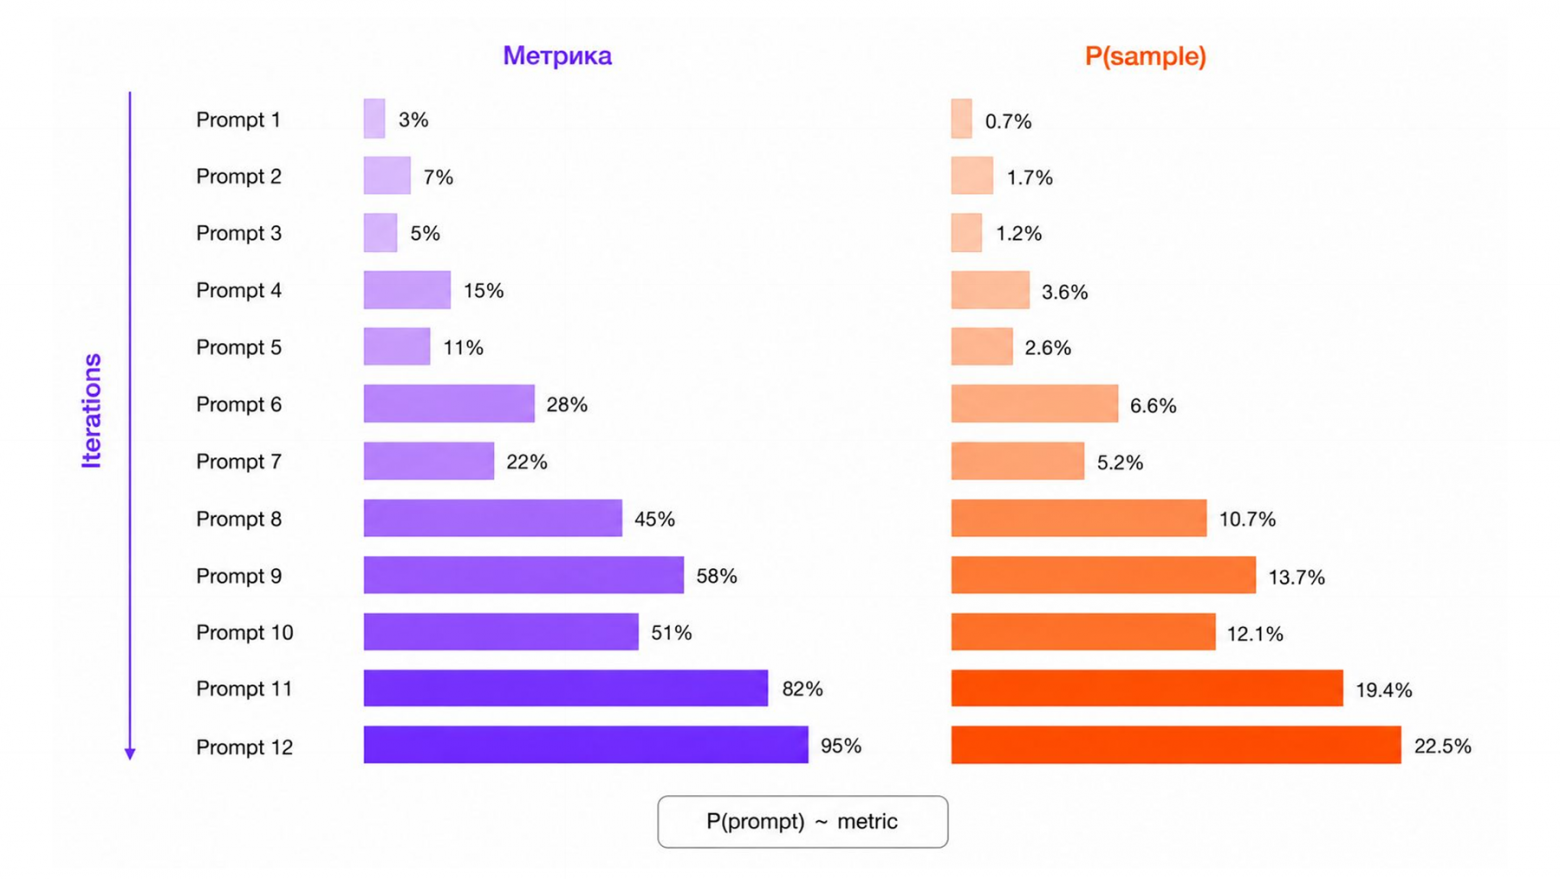
Используем не один фиксированный промпт, а пул кандидатов, полученных на этапе автоподбора: у них разное качество, и мы берём их в обучение пропорционально метрике.
Как система работает в продакшене
Наша архитектура
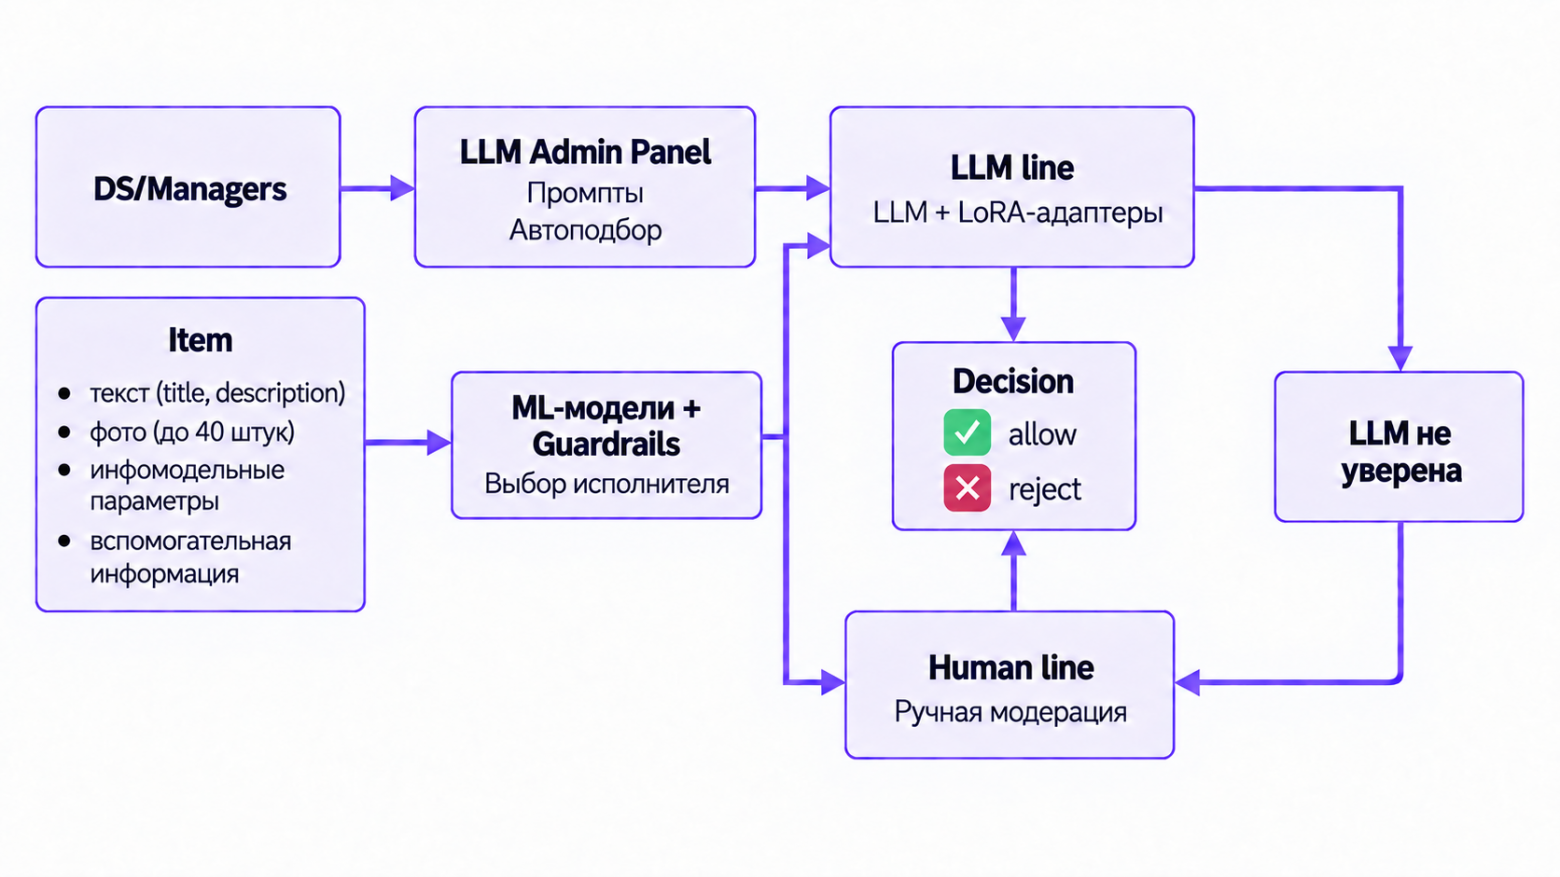
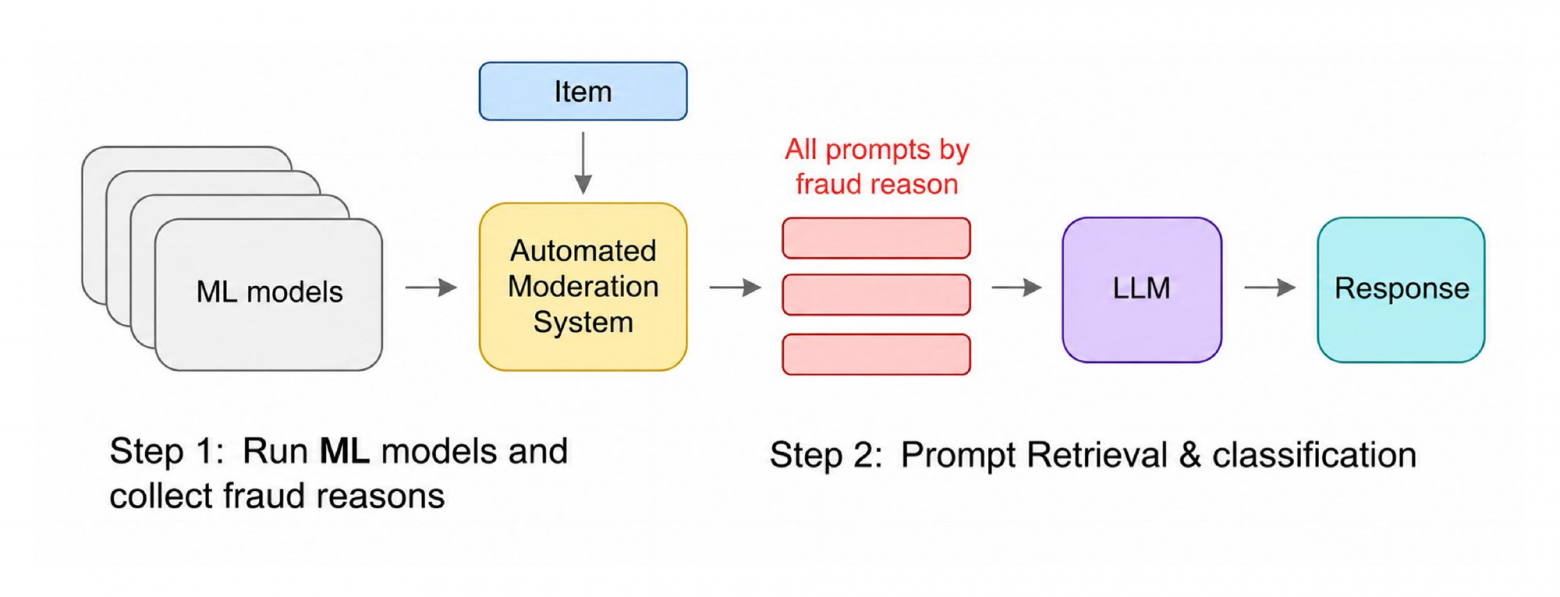
Классические ML-модели находят потенциальное нарушение, по которому система выбирает промпт.
GuardRails проверяет вход: подозрительные объявления направляет модератору, остальные — в LLM.
Если LLM не уверена в результате, решение также перепроверяет модератор. После проверки система принимает итоговое решение — allow или reject.
LLM Admin panel — управление промптами
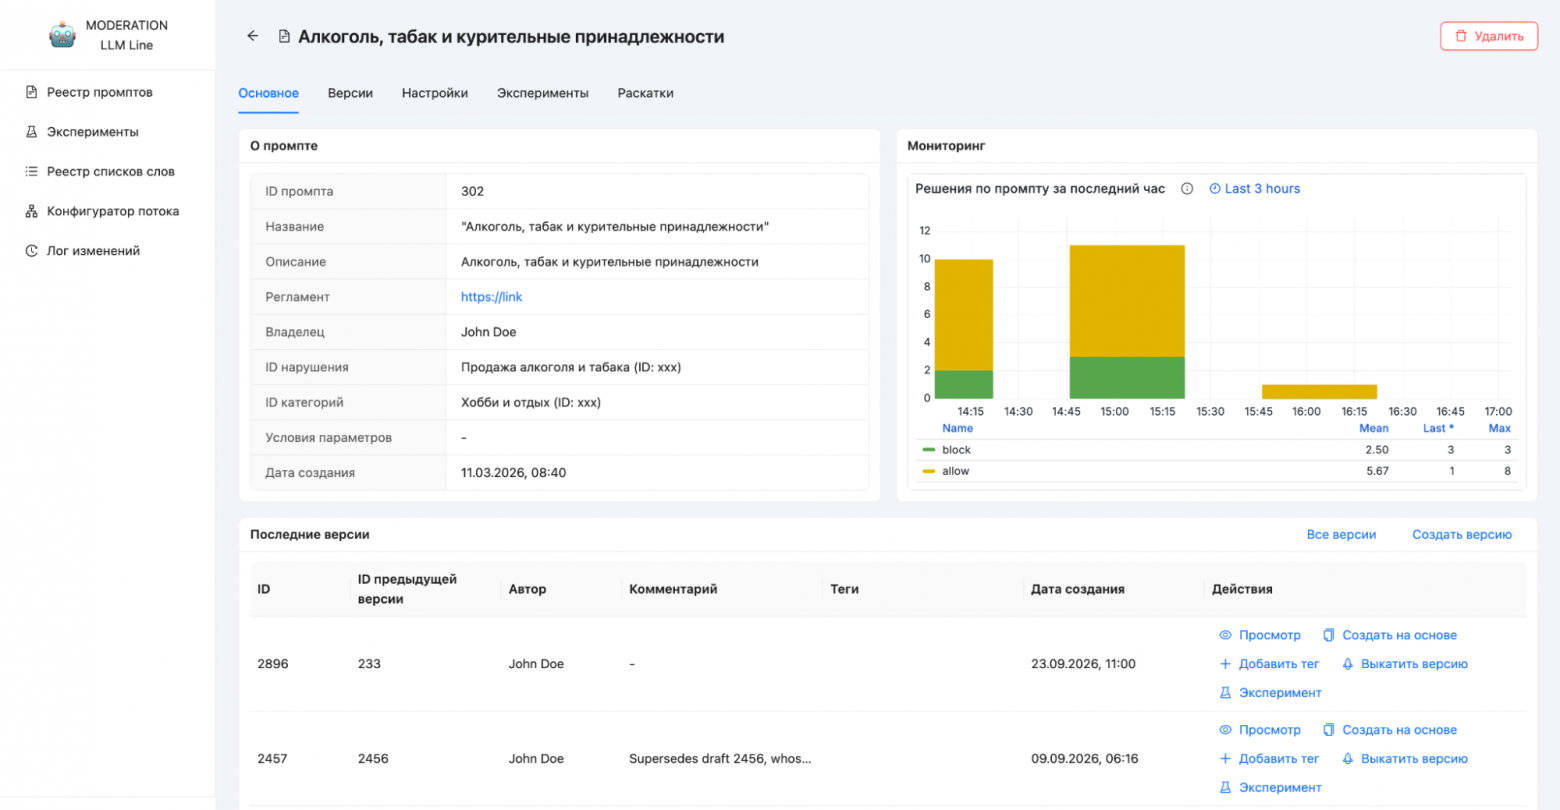
Мы написали свою админку для промптов и экспериментов. С самого начала делали её с оглядкой на то, что управлять процессом должен уметь менеджер или другой сотрудник без технической подготовки.
Через нашу панель сейчас можно мониторить поток, управлять версиями промптов, запускать эксперименты, автоподбор и дообучение — когда изменился регламент или накопились новые данные.
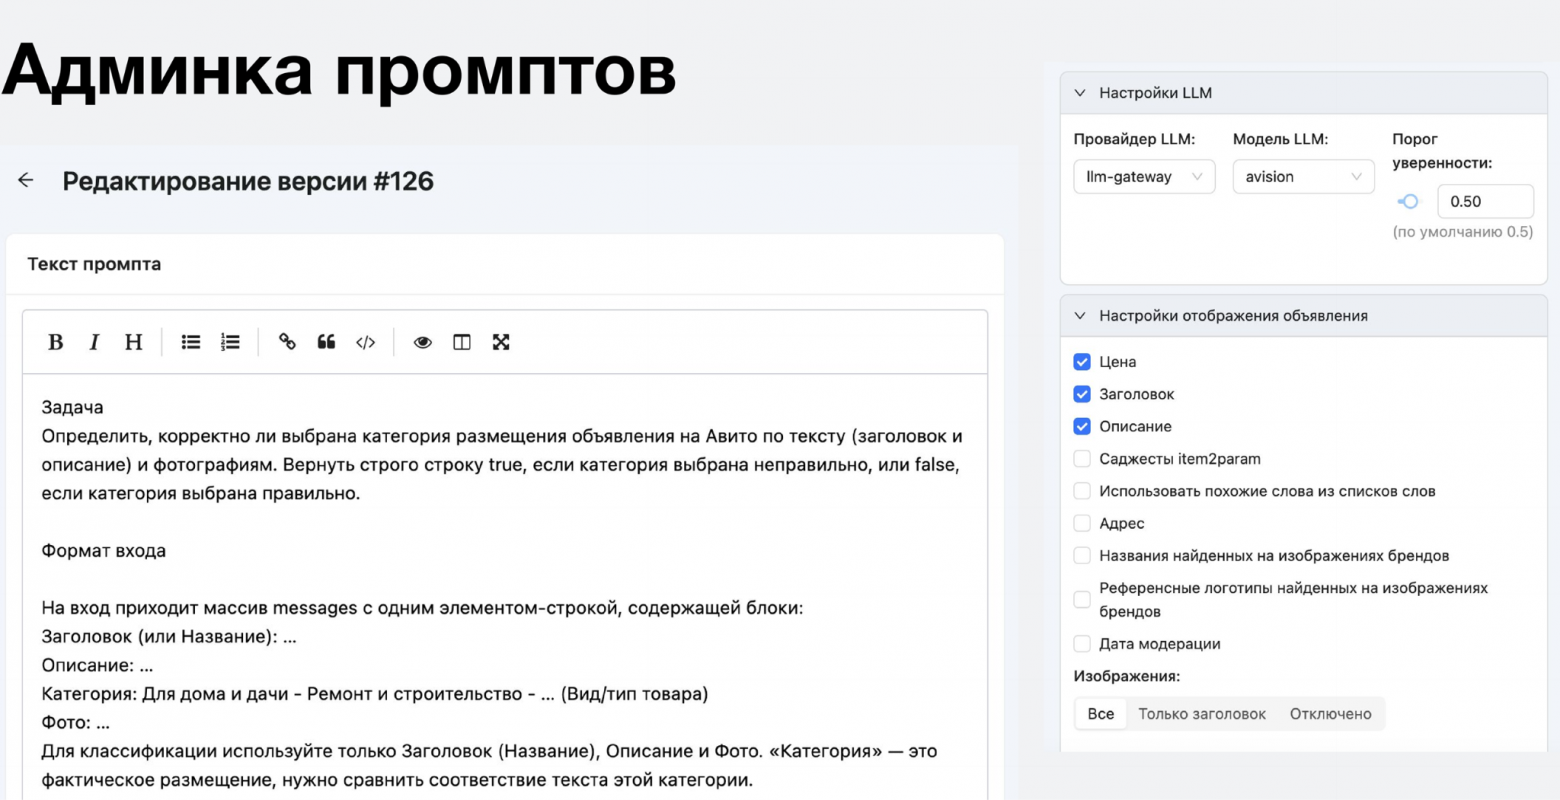
Из интересного: для некоторых проверок качество повышает дополнительная метаинформация из объявления, например цена. Её можно подключить к конкретному промпту чекбоксом: отметили «Цена» — модель видит цену. В некоторых регламентах это важно.
GuardRails
Модерация — adversarial-среда: есть пользователи, которые целенаправленно пытаются её обойти. Наша LLM обрабатывает текст, который пишет пользователь, поэтому защита нужна, даже если пользователь не видит ответ модели.
Более того, у нас в компании разрабатываются AI-ассистенты, которые могут принимать на вход объявления для различных бизнес-сценариев. Поэтому в модерации стоит отдельный контур GuardRails для поиска атак на LLM вроде Prompt injection и Jailbreaks.
Если вход выглядит подозрительно, объявление сразу уходит на ручную модерацию, а не в LLM.
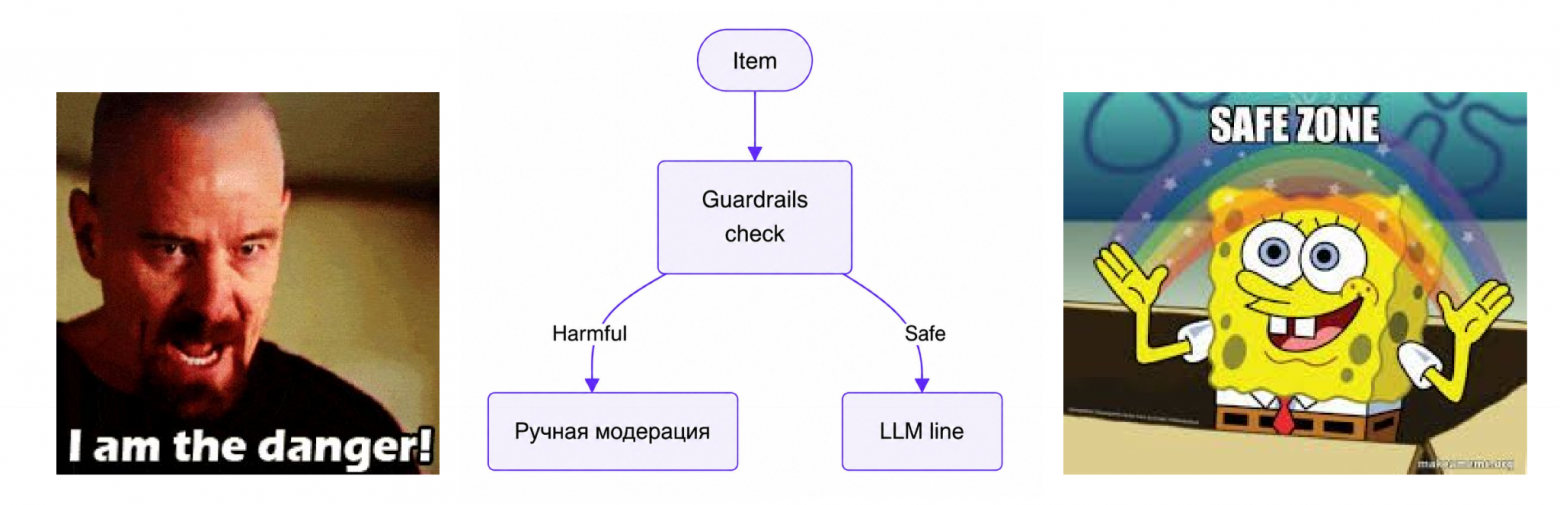
Если сама LLM недостаточно уверена в результате, её решение тоже перепроверяет модератор.
Инференс LLM
Для инференса используем vLLM. У него хороший time to first token (TTFT), а ещё из коробки достаются логиты, которыми можно балансировать precision и recall под конкретную проверку.
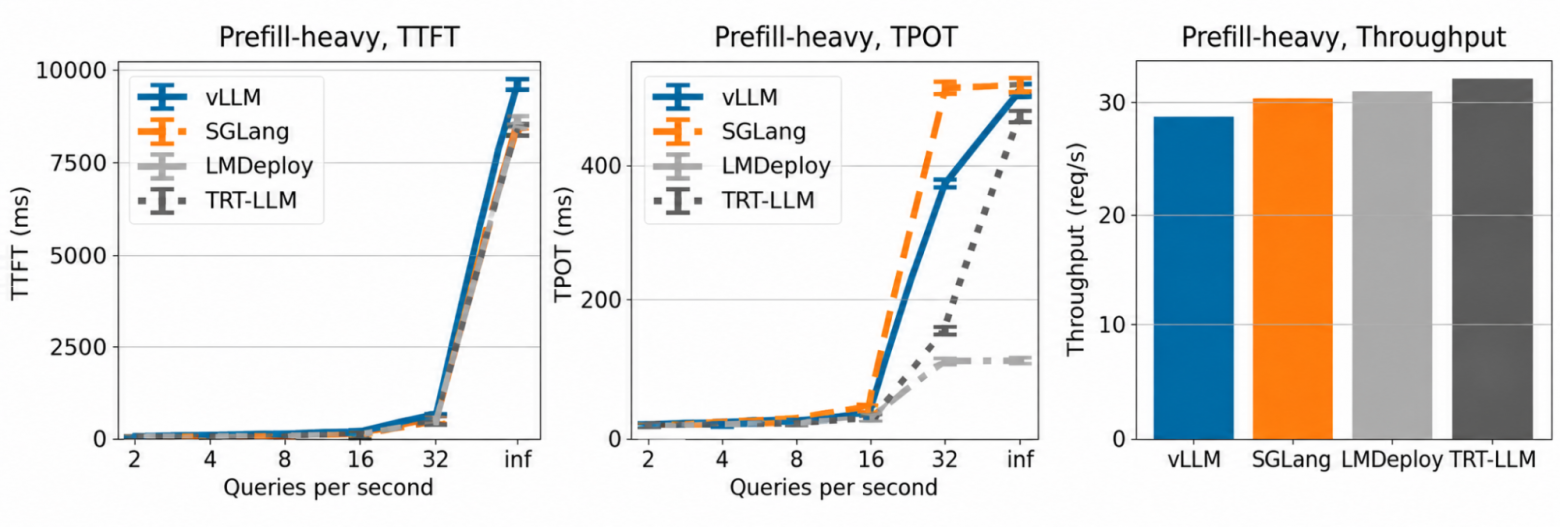
Но главная причина выбора — prefix caching, который идеально ложится на нашу задачу. Регламент внутри одной проверки одинаков для всех объявлений: меняется только объявление, а огромный префикс остаётся тем же. На кэшировании этого префикса мы сильно экономим.
Чтобы не тратить ресурсы на генерацию длинного ответа, мы ограничили вывод одним токеном и сделали его детерминированным:
-
предсказываем ровно один токен: True или False;
-
temperature = 0;
-
reasoning_effort = “none”.
Интеграция с классическим ML
Когда в пайплайн встраивается LLM, возникает вопрос: а что делать с моделями, которые мы разрабатывали до этого?
Ответ: они становятся контуром полноты.
Классические модели рассчитаны на то, чтобы переварить большой поток и найти как можно больше потенциальных нарушений. Они проставляют объявлению идентификаторы предполагаемых нарушений, по этим идентификаторам LLM-модуль подбирает нужный промпт — и уже LLM принимает более точное решение.
Поэтому LLM проверяет только самую подозрительную часть потока.
Результаты
Сейчас LLM автоматически обрабатывает около 70% объявлений, которые основной пайплайн направляет на дополнительную проверку. Precision на этом потоке около 94%.
Остальные 30% — наиболее сложные случаи; автоматизировать их — следующий этап работы.
Что мы поняли после внедрения
Промпт — параметр системы. Его подбор и анализ ошибок можно автоматизировать, но результат всё равно нужно проверять на данных и валидировать вручную.
Одной модели для всех проверок недостаточно. Для большинства задач подходит базовая модель, а для отдельных сложных нарушений — дообученная компактная.
Кстати, ещё про платформу дообучения для LoRA-адаптеров рассказывал Влад Кириенко в «Доске AI-объявлений»
В продакшене LLM работает как часть системы. Её дополняют классический ML, маршрутизация, управление промптами, GuardRails и ручная проверка сложных случаев.
Автор: Ningeen

