


Отдел аналитики FMCG-производителя каждый понедельник начинал одинаково: человек открывал stat.gov.kz, качал пачку Excel-таблиц, потом шёл на сайт Нацбанка за курсами, потом на KASE, потом за мировыми ценами на сахар и какао к FAO. Часа через два всё это оказывалось в общей папке под именами вроде data(1).xlsx
И мне сказали “Автоматизируй”.
Дали список сайтой откуда они берут данные
Список был таков, но он рос по ходу:
-
Казахстан: stat.gov.kz (Бюро национальной статистики), KASE, Нацбанк, goszakup.gov.kz, adilet.zan.kz — там законы, их тоже захотели, причём с разбивкой по статьям;
-
сырьё и еда: FAOSTAT, UN Comtrade, UNdata — лимонная кислота, кофеин, чёрный чай. ряды FRED на основе данных BLS;
-
финансы: ECB SDMX API, ЦБ соседей, MOEX ISS, мировые индексы и фьючерсы;
-
World Bank (потребительские индикаторы, LPI), Open-Meteo по городам Казахстана.
Первая мысль была очевидной: Airbyte, Meltano, что-нибудь на Singer-тапах. Посмотрел. Коннекторов к stat.gov.kz, KASE или адилету там нет и не будет, а их тут большинство. Писать свои пришлось бы в любом случае, только уже внутри чужого фреймворка — и тащить ради этого отдельную инфраструктуру с оркестратором.
CKAN и прочие каталоги данных решают другую задачу. Они хранят и показывают, но не выковыривают таблицу из HTML-страницы госсайта, где «скачать» — это <a> без расширения, отдающий .xls, который на самом деле HTML.
ImportError:
Import lxmlfailed. Use pip or conda to install the lxml package.
Это, кстати, не выдуманная строка: она пять раз лежит в журнале ингестов. Поставить lxml можно, но я к тому моменту всё равно написал свой разбор таблиц на BeautifulSoup — с нормальной обработкой <th> и строк разной длины. Так и осталось.
Короче, писал сам.
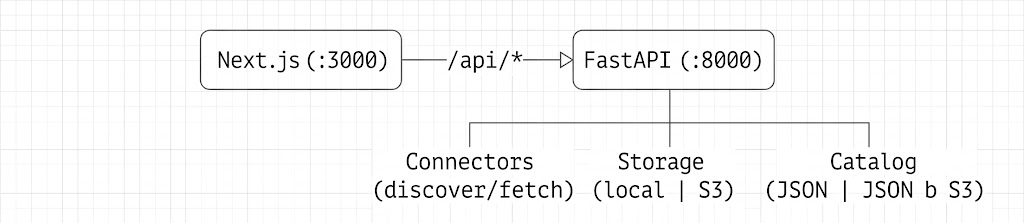
У каждого коннектора три метода:
class BaseConnector(ABC):
    source_name: str = "unknown"
    source_type: str = "web_api"

    @abstractmethod
    def discover(self) -> list[DiscoveredDataset]: ...   # что вообще есть на источнике

    @abstractmethod
    def fetch(self, dataset: DiscoveredDataset) -> bytes: ...   # сырые байты

    @abstractmethod
    def fetch_as_dataframe(self, dataset: DiscoveredDataset): ...   # если повезёт — сразу таблица
Пайплайн двухфазный. Сначала discover: коннектор обходит источник и возвращает список того, что можно забрать. Пользователь во фронте ставит галочки. Потом ingest: забираем выбранное, кладём в хранилище, пишем запись в каталог.Разделение появилось не от любви к красоте. Discover у KASE — это 16 разделов сайта с паузой 0.4 секунды между запросами, чтобы не словить бан. Гонять его на каждый клик никто не будет.
def make_session(verify_ssl: bool = False) -> requests.Session:
    s = requests.Session()
    s.trust_env = False      # корпоративный прокси из env ломал половину запросов
    s.verify = verify_ssl    # да, SSL выключен. см. ниже
    retry = Retry(
        total=3, connect=3, read=3, status=3,
        backoff_factor=0.6,
        status_forcelist=(429, 500, 502, 503, 504),
        allowed_methods=("GET", "HEAD", "OPTIONS"),
        raise_on_status=False,
    )
    adapter = HTTPAdapter(max_retries=retry, pool_connections=20, pool_maxsize=20)
    s.mount("http://", adapter)
    s.mount("https://", adapter)
verify=False — компромисс, за который мне немного стыдно. Часть государственных сайтов отдаёт кривую цепочку сертификатов, и с проверкой коннектор просто не стартует. Читаем мы только публичные данные и ничего секретного не отправляем, поэтому я решил, что это допустимо. Но в проде с чувствительными данными я бы так делать не стал.
Ретраи на 5xx спасают регулярно. FRED, например, иногда отвечает так:
504 Server Error: Gateway Time-out for url: https://fred.stlouisfed.org/graph/fredgraph.csv?id=WPU057
Три таких записи в журнале — это уже после трёх ретраев с бэкоффом. Без них их было бы заметно больше.
Главное открытие проекта: верить расширению файла нельзя. И Content-Type тоже. Госсайты отдают .xlsx, внутри которого старый OLE-формат, или application/octet-stream вообще на всё подряд.Поэтому формат сначала определяется по магическим байтам, и только потом по имени:
def detect_data_format(name: str = "", content_type: str = "", payload: bytes | None = None) -> str:
    ...
    leading = payload[:16]

    if leading.startswith(b"PKx03x04"):                          # zip-контейнер → xlsx
        return "xlsx"
    if leading.startswith(b"xd0xcfx11xe0xa1xb1x1axe1"):    # OLE2 → старый xls
        return "xls"
    if leading.startswith(b"PAR1"):
        return "parquet"
    if lower_name.endswith(".csv") or "csv" in lower_type:
        return "csv"
А при старте бэкенд проходит по каталогу и переименовывает файлы, у которых расширение не совпадает с содержимым (repair_file_extensions_by_content). Костыль? Да. Но openpyxl, получивший OLE-файл под именем .xlsx, падает с такой ошибкой, что по ней не сразу поймёшь, что произошло.С CSV своя песня. Разделитель бывает запятой, точкой с запятой или табом, кодировка — UTF-8 с BOM, без BOM или cp1251. Решение тупое и рабочее — перебор:
def decode_bytes(data: bytes) -> str:
    for encoding in ("utf-8-sig", "utf-8", "cp1251", "latin-1"):
        try:
            return data.decode(encoding)
        except UnicodeDecodeError:
            continue
    return data.decode("utf-8", errors="replace")
attempts.extend([
{"sep": ",", "engine": "python"},
{"sep": ";", "engine": "python"},
{"sep": "t", "engine": "python"},
{"sep": None, "engine": "python"}, # пусть csv.Sniffer гадает
# и те же четыре варианта с on_bad_lines="skip" — последний рубеж
])latin-1 в конце списка декодирует вообще что угодно, поэтому до errors="replace" дело обычно не доходит. Зато если файл был в cp1251, а utf-8 вдруг прошёл (бывает на коротких файлах из одной латиницы), получаем красивые кракозябры. Ловил пару раз.
Типичная таблица с stat.gov.kz: три строки шапки с названием ведомства, пустая строка, объединённые ячейки, и где-то на пятой строке настоящие заголовки. pd.read_excel(header=0) честно делает заголовками «Бюро национальной статистики» и пять Unnamed.Эвристика простая: в первых 15 строках ищем ту, где больше всего заполненных ячеек, и считаем её шапкой.
scan_limit = min(len(cleaned), 15)
header_idx = 0
best_cells = -1
for idx in range(scan_limit):
    filled = int(cleaned.iloc[idx].notna().sum())
    if filled > best_cells:           # строго больше: при равенстве побеждает верхняя
        best_cells = filled
        header_idx = idx
Из всех листов книги выбирается тот, где больше данных: score = непустые_ячейки + колонки * 10. Вес у колонок завышен специально — иначе выигрывал лист «Методология» с одной колонкой длинного текста.Работает не всегда. Но лучше, чем Unnamed: 0.
Тут будет стыдно, но честно.
Для .xls pandas нужен xlrd. Его не было, и pandas отвечал так:
ImportError:
Import xlrdfailed. Install xlrd >= 2.0.1 for xls Excel support
Вместо того чтобы поставить одну библиотеку, я (в тот момент это казалось гениальным) решил конвертировать .xls в .xlsx настоящим Excel через COM. Из Python. Через PowerShell.
command = f"""
$excel = $null
$workbook = $null
try {{
  $excel = New-Object -ComObject Excel.Application
  $excel.Visible = $false
  $excel.DisplayAlerts = $false
  $workbook = $excel.Workbooks.Open('{ps_source}')
  $workbook.SaveAs('{ps_target}', 51)       # 51 = xlOpenXMLWorkbook
}} finally {{
  if ($workbook -ne $null) {{ $workbook.Close($false) }}
  if ($excel -ne $null) {{ $excel.Quit() }}
}}
"""
result = subprocess.run(["powershell", "-NoProfile", "-NonInteractive", "-Command", command],
                        capture_output=True, text=True, timeout=60)
Самое смешное — оно работает. На моей машине с Office.
Проблем ровно три:
После Quit() Excel ещё какое-то время держит файл. shutil.rmtree(temp_dir, ignore_errors=True) молча не удаляет папку, и в .tmp_excel_conversion/ у меня до сих пор лежат четыре осиротевших job_*/source.xls.
Кавычки в пути экранируются через replace("'", "''"). Для одинарных кавычек PowerShell этого хватает, но строить скрипт форматированием строки — так себе идея.
Docker-образ у бэкенда — python:3.12-slim. Там нет ни PowerShell, ни Excel. То есть в контейнере вся эта конструкция просто не работает.
Правильный фикс — pip install xlrd (или LibreOffice headless, если файлы совсем экзотические). Он стоит у меня первым в TODO, и мне за него немного неловко.
Каталог на одном JSON
Самая спорная часть. Все метаданные — источники, датасеты, история загрузок, кэш discover — лежат в одном catalog.json. В S3-режиме это один объект meta/catalog.json.
Почему не Postgres? Он предусмотрен: в проекте есть catalog/db.py с SQLAlchemy-моделями и флаг USE_DATABASE в конфиге. Но к API он не подключён. Первые недели нужен был каталог, который можно открыть глазами, поправить руками и закоммитить как фикстуру. JSON это давал, а потом так и прижился. Временное решение, как обычно, оказалось самым долгоживущим.
Первая версия записи: атомарный replace
Сначала я сделал «по учебнику»: пишем во временный файл, потом os.replace поверх основного, а между процессами синхронизируемся через lock-файл с O_CREAT | O_EXCL:
fd = os.open(lock_path, os.O_CREAT | os.O_EXCL | os.O_WRONLY)
os.write(fd, str(os.getpid()).encode("utf-8"))
На Linux это классика. На Windows os.replace падает, если целевой файл кто-то держит открытым — а держал его то второй процесс uvicorn с --reload, то антивирус, то я сам в редакторе:
PermissionError: [Errno 13] Отказано в доступе
От той итерации остались артефакты: в .tmp_api_smoke/ лежит catalog.json.tmp.20872.14844 (имя собрано из PID и thread id) и catalog.json.lock с содержимым 20872. Процесс умер, а lock остался. Ровно поэтому в acquirefile_lock потом появилось stale_after = 30 секунд: lock старше 30 секунд считается протухшим и удаляется.
Текущая версия
def _save(self):
    payload = json.dumps(self._data, ensure_ascii=False, indent=2, default=str).encode("utf-8")

    with open(target, "a+b") as file_obj:          # a+b: не обнуляет файл при открытии
        file_obj.seek(0)
        if os.name == "nt":
            msvcrt.locking(file_obj.fileno(), msvcrt.LK_LOCK, 1)   # лочим первый байт
        else:
            fcntl.flock(file_obj.fileno(), fcntl.LOCK_EX)
        try:
            existing = file_obj.read()
            if existing:
                with open(backup_path, "wb") as backup_obj:   # сначала — бэкап старого
                    backup_obj.write(existing)
                    backup_obj.flush()
                    os.fsync(backup_obj.fileno())

            file_obj.seek(0)
            file_obj.truncate()
            file_obj.write(payload)
            file_obj.flush()
            os.fsync(file_obj.fileno())
        finally:
Это не атомарная запись. Если процесс умрёт между truncate() и write(), основной файл окажется пустым или обрезанным. Зато восстановимым: _load ловит JSONDecodeError и поднимает catalog.json.bak, который к этому моменту уже лежит на диске с fsync.
def _load(self) -> dict:
    if os.path.exists(self.filepath):
        try:
            return self._read_json_file(self.filepath)
        except json.JSONDecodeError:
            backup_path = self._backup_path()
            if os.path.exists(backup_path):
                return self._read_json_file(backup_path)
            raise
И отдельно про режим a+b. С wb файл обнуляется ещё до того, как мы взяли блокировку, и параллельный читатель видит пустоту.
Ещё одна деталь, которую я заметил, только когда перечитывал код для статьи: функция acquirefile_lock с O_EXCL-логикой и защитой от протухших локов в классе осталась, но _save её больше не вызывает. Мёртвый код, памятник первой итерации.
Дедупликация по хэшу контента
Половина источников обновляется раз в месяц, а аналитики жмут «загрузить» каждый день. Плодить одинаковые CSV не хотелось.
content_hash = compute_df_hash(df)         # sha256 от df.to_csv()
schema_hash = compute_schema_hash(df)      # отдельно: имена колонок + dtypes

if (
    existing_dataset
    and existing_dataset.get("content_hash") == content_hash
    and dataset_file_is_available(existing_dataset.get("file_path", ""))
):
    catalog.add_ingestion(..., message="Dataset unchanged; existing file reused")
    return {..., "reused": True}
Хэш схемы считается отдельно: если ведомство переименовало колонку, это видно сразу, даже когда цифры не изменились.
Третье условие — dataset_file_is_available — появилось после грабли, о которой ниже. Без него система радостно отвечала «данные не изменились, файл переиспользован» и отдавала путь к файлу, которого давно нет.
Проблемы
Кавычки в имени файла
KASE публикует новости с названиями вроде АО "Банк Развития Казахстана" принял решение.... Название датасета идёт в путь. Windows кавычки в именах не принимает:
[WinError 123] Синтаксическая ошибка в имени файла, имени папки или метке тома:
‘D:\…\data_storage\kase.kz\KASE_Global_→_Единственный_акционер_АО_”Банк_Развития_Казахстана”_принял_решение’
29 упавших загрузок, пока не появилась функция санитизации:
def sanitize_path_component(value: str, max_length: int = 120) -> str:
    text = str(value or "").strip()
    text = text.replace("xa0", " ")                        # неразрывный пробел с госсайтов
    text = re.sub(r'[<>:"/\|?*x00-x1f]', "_", text)
    text = re.sub(r"s+", "_", text)
    text = re.sub(r"_+", "_", text)
    text = text.rstrip(" ._")                               # Windows не любит точку в конце

    reserved_names = {"CON", "PRN", "AUX", "NUL", "COM1", ..., "LPT9"}
    if text.upper() in reserved_names:
        text = f"_{text}"
    return text[:max_length] or "file"
Зарезервированные имена — не паранойя. Датасет с названием CON на Windows создаёт не файл, а обращение к консоли.
118 миллисекунд на каждую строчку истории
Каталог сейчас весит 6.33 МБ. Каждый вызов add_ingestion — это полная сериализация, бэкап и два fsync. Замер на копии каталога, 30 вызовов подряд:
load_s 0.063
add_ingestion ms p50 117.7 p95 122.7
save_peak_MB 29.4
file_MB 6.33
Из этих 118 мс около 56 уходит на json.dumps(..., indent=2), остальное — запись бэкапа и fsync. Пиковая память на одно сохранение — 29 МБ, почти в 4.6 раза больше самого файла.
Загрузка одного нового датасета — минимум два сохранения (add_dataset + add_ingestion), а если загрузка повторная, то ещё и update_dataset. Для 1789 датасетов это примерно семь минут чистой перезаписи JSON. И с каждым ингестом файл растёт, так что дальше будет только медленнее — O(n) на запись в чистом виде.
Валидатор ссылок с ложными срабатываниями
После discover битые ссылки отсеиваются: HEAD, если не вышло — GET со stream=True. Ответ считается битым, если в первых 400 символах есть "not found" или "exception".
Работает, пока на странице раздела нет новости со словом «exception» в заголовке. Поэтому у KASE и custom URL валидация отключена флагом validate_discovered_links = False. Плюс проверка идёт последовательно, с таймаутом 12 секунд и тремя ретраями, так что сотня мёртвых ссылок превращает discover в перекур.
Сброс кэша через стартап
В начале api.py при каждом запуске выполняется вот такое:
catalog.delete_discovery("food_inputs_kz")
catalog.delete_discovery("stat.gov.kz")
catalog.delete_discovery("ecb_cis_banks")
# ...ещё девять штук
catalog.purge_datasets_by_external_ids(["kgd_taxpayer"])
catalog.purge_ingestions_by_error_substrings(["kgd.gov.kz"])
Это миграции бедного человека. Когда я менял логику коннектора, старый кэш discover становился невалидным, и проще всего было дропать его при старте. Коннектор к kgd.gov.kz выпилили целиком, а его следы до сих пор вычищаются при каждом запуске. Нормальное решение — версия схемы коннектора в ключе кэша. Сделаю.
|
Метрика |
Значение |
|
Источников в реестре коннекторов |
16 |
|
Источников в каталоге (с custom URL) |
32 |
|
Датасетов в каталоге |
1 789 |
|
Строк данных суммарно |
~2.76 млн |
|
Форматы |
CSV 1180, HTML 435, JSON 105, HTML-таблицы 43, PDF 23, XML 3 |
|
Ингестов всего |
2 918 |
|
Успешных |
2 522 (86.4%) |
|
Упавших |
396 (13.6%) |
|
Переиспользовано по хэшу |
313 |
|
Размер каталога |
6.33 МБ |
|
Загрузка каталога при старте |
63 мс |
|
Запись в каталог, p50 / p95 |
117.7 / 122.7 мс |
|
Пиковая память на одно сохранение |
29.4 МБ |
|
Python-кода |
~9.4 тыс. строк |
Из чего состоят 396 падений:
131 | Structured source could not be parsed as xlsx
 81 | Structured source could not be parsed as json
 52 | Structured source could not be parsed as csv
 36 | Structured source could not be parsed as xls
 32 | This source only links to an informational page and has no structured dataset
 29 | [WinError 123] Синтаксическая ошибка в имени файла...
  7 | No nested xlsx/xls/csv/json resources found on price statistics page
  5 | `Import lxml` failed.
  3 | 504 Server Error: Gateway Time-out (FRED)
  1 | 'DataFrame' object has no attribute 'dtype'
Лидер — xlsx. Подозреваю, что часть этих случаев — вообще не Excel: проверка PKx03x04 срабатывает на любой zip, включая архивы с CSV внутри и .docx. Магические байты говорят, что это контейнер, но не говорят, что в нём лежит.
Следующий шаг — заглядывать в [Content_Types].xml.Главная цифра для бизнеса другая: понедельничный ритуал на два часа исчез. Аналитик открывает фронт, жмёт «загрузить» и получает CSV, у которого заголовки — это заголовки, а не «Бюро национальной статистики».
Что дальшe
-
pip install xlrdи удалить COM-конвертацию. Вообще. -
Относительные пути в каталоге.
-
Перенести каталог в Postgres — модели уже есть, осталось подключить. JSON оставить как формат экспорта.
-
Потоковый хэш и одна запись CSV вместо трёх копий в памяти.
-
Версия коннектора в ключе кэша discover вместо
delete_discoveryпри старте. -
Параллельная проверка ссылок.
Если вы тоже собираете данные с госсайтов СНГ — расскажите в комментариях, какой формат отдают у вас. Ставлю на HTML с расширением .xls
Автор: greet_di

