


Модель размечает, код считает
Я учитель и эксперт ЕГЭ, около двух лет я работаю над Telegram-ботом, который проверяет ответы второй части ЕГЭ по обществознанию, и главное, чему научил меня этот проект: модели нельзя поручать ставить балл.
В том виде, в котором бот работает сейчас, модель делает то, что у неё получается хорошо: читает ответ и размечает его по схеме: какие примеры считать конкретными, какие суждения верными, какие пункты плана ключевыми. А дальше включается обычный код. Он пересчитывает баллы по критериям, проверяет то, что можно проверить без модели, и запускает перепроверки, которые могут балл только понизить.
В этой части расскажу о том, как это устроено: путь одного ответа, распределение обязанностей между моделью и кодом по заданиям, два фрагмента кода, отказоустойчивость и цена. Насколько точно это всё работает и как я это измерял, расскажу во второй части.
Что вообще проверяем
ЕГЭ по обществознанию состоит из двух частей. Первая — задания 1–16 с коротким ответом, их проверяет машина. Вторая — задания 17–25 с развёрнутым ответом: ученик пишет текст, а оценивают его два независимых эксперта по критериям ФИПИ. Если их баллы сильно расходятся, работу смотрит третий.
|
Задание |
Что делает ученик |
Макс. балл |
|---|---|---|
|
17–18 |
отвечает на вопросы к тексту, объясняет понятие и связь |
2 + 2 |
|
19 |
приводит три конкретных примера к теоретическому положению |
3 |
|
20 |
формулирует суждения по теме |
3 |
|
21 |
анализирует график спроса и предложения |
3 |
|
22 |
решает задачу-ситуацию |
4 |
|
23 |
находит в Конституции РФ нормы, которые подтверждают положение |
3 |
|
24 |
составляет сложный план по теме |
4 |
|
25 |
обосновывает тезис, отвечает на вопрос, приводит три примера |
6 |
Сложность для ИИ в том, что критерии очень формальные. Пример в задании 19 должен быть конкретным: «полиция охраняет порядок» — это функция, а не пример, за него ставится 0. Если в задании сказано «про Россию», пример про «государство Z» не засчитывается. План в задании 24 без трёх обязательных пунктов из эталона получает 0 баллов целиком, даже если всё остальное в нём верно. Модель, которая «в целом понимает обществознание», оценивает такие ответы слишком щедро. Отсюда и архитектура, описанная ниже.
Путь одного ответа
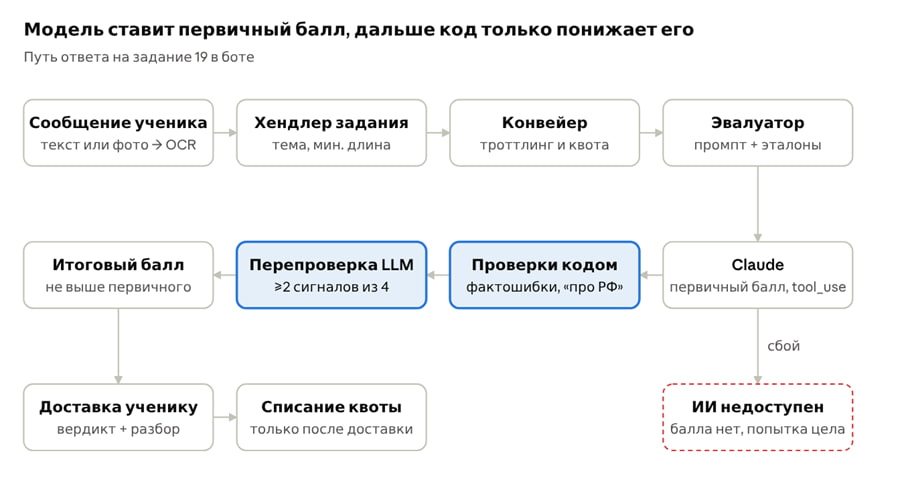
Первичный балл ставит модель, а всё, что идёт после неё, может только уменьшить его. Внутри бота все шаги — обычные await в одном процессе, очереди нет. Тот же эвалуатор вызывается из режима учителя, с сайта и из B2B API; в B2B перед ним стоит очередь на Redis.
Кто что считает в заданиях 17–25
У каждого задания свой плагин: хендлер, эвалуатор и спецификация. Общего «универсального промпта для второй части» нет: критерии у заданий настолько разные, что и доля работы модели получается разной, от «решает почти всё» до «на балл не влияет».
|
Задание (макс.) |
Что делает модель |
Что считает код |
Перепроверка |
|---|---|---|---|
|
17 (2) — вопросы к тексту |
всю оценку |
обрезку балла до диапазона |
— |
|
18 (2) — понятие и связь |
оценку понятия и объяснения |
сверку признаков с каталогом (стемминг) |
— |
|
19 (3) — три примера |
первичный балл через tool_use |
регулярки фактических ошибок, требование «про Россию», штраф за лишние примеры |
«конкретное действие органа» |
|
20 (3) — суждения |
оценку каждого суждения |
арифметику штрафа за лишние суждения |
дубли суждений |
|
21 (3) — график спроса и предложения |
только второй вопрос |
первый и третий вопросы по ключевым словам, итог = число верных |
— |
|
22 (4) — задача |
всю оценку |
обрезку балла |
— |
|
23 (3) — Конституция |
оценку по элементам |
поиск якоря в Конституции, сверку итога с вердиктами по элементам |
подтверждение якоря |
|
24 (4) — план |
замечания и обратную связь, на К1 не влияет |
К1 и К2 целиком: разбор плана, леммы, сверка с эталонными планами |
снятие К2 через три прогона |
|
25 (6) — обоснование и примеры |
оценку К1–К3 |
«одно предложение → К1 = 0», проверку диапазонов |
конкретность примеров в К3 |
Во всех заданиях, кроме одного, код может балл модели только понизить. Исключение составляет задание 20: тут код пересчитывает штраф за лишние суждения и может балл поднять, если модель обнулила ответ там, где по правилу снимается один балл. Модель делала это стабильно.
Закономерность видна по объёму кода: задание 17 укладывается в 942 строки, а 24 и 25 занимают по 6,8–7,2 тысячи. Чем сложнее критерии, тем больше кода вокруг модели, а не длиннее промпт.
Как выглядит «разметка»
Модель не пишет в ответ «ставлю 2 балла, потому что…». Она заполняет JSON-схему через tool_use, и каждое поле в ней потом проверяет код. Вот сокращённая схема для задания 19:
TASK19_PRIMARY_SCHEMA = {
    "type": "object",
    "additionalProperties": False,
    "properties": {
        "score": {"type": "integer", "minimum": 0, "maximum": 3},
        "total_examples": {"type": "integer", "minimum": 0},
        "task_requirements": {
            "type": "object",
            "properties": {
                "requires_russia": {"type": "boolean"},
                "requires_structure": {"type": "boolean"},
            },
        },
        "valid_examples": {
            "type": "array",
            "items": {
                "type": "object",
                "properties": {
                    "number": {"type": "integer"},
                    "text_snippet": {"type": "string"},   # цитата из ответа
                    "is_about_russia": {"type": ["boolean", "null"]},
                    "why_valid": {"type": "string"},
                    "illustrates_thesis": {"type": "boolean"},
                },
            },
        },
        "invalid_examples": {"type": "array"},
    },
}
Самое полезное поле здесь illustrates_thesis. Модель часто засчитывает пример, который конкретен и фактически верен, но иллюстрирует не то, о чём спрашивали: например, рассказывает о выборах, когда просили пример источника информирования о правовой системе. Отдельный флаг заставляет её ответить на этот вопрос явно, а код потом ограничивает балл числом примеров, где флаг стоит в true.
Задание 19: перепроверка, которая только понижает
В задании 19 ученик приводит три конкретных примера. Часть формулировок требует показать действие государственного органа, и тут модель систематически засчитывала лишнее: пересказ функции органа или рассказ о том, что сделал гражданин. Решение — второй вызов модели с отдельной схемой, поверх которого решает код.
Первое решение: когда перепроверку не запускать. Первая версия срабатывала на всех заданиях и снимала баллы там, где действует семья или гражданин и органа нет по условию. Теперь она включается только по явным маркерам в тексте задания:
def _task_requires_organ_actions(self, task_text: str) -> bool:
    """Conservative default — при отсутствии явных positive markers
    возвращаем False: лучше пропустить recheck (маленький overscore-риск),
    чем применить его ложно (−2 балла underscore).
    """
    text = (task_text or "").lower()
    organ_patterns = (
        r"принуждатьs+кs+соблюдению",
        r"правоохранительнw*",
        r"институтw*s+принуждения",
        r"контрольно-надзорнw*",
        r"обеспечиваw*s+соблюдение",
        r"правоприменительнw*",
    )
    if any(re.search(p, text) for p in organ_patterns):
        return True
    return False  # перераспределение доходов, факторы, источники информации — мимо
Второе решение: один сигнал не довод. Модель ставит каждому примеру четыре флага, а отклоняет пример уже код, и только при двух согласных негативных сигналах. Балл при этом может только уменьшиться:
# High-confidence reject: пример отклоняется ТОЛЬКО при ≥2 независимых
# negative signal'ах. Один-единственный флаг слишком шумный.
strong_rejects = []
for e in examples_list:
    if not isinstance(e, dict) or e.get("passes_recheck") is True:
        continue
    negative_signals = sum([
        e.get("organ_is_actor") is False,
        e.get("has_concrete_action_verb") is False,
        e.get("is_abstract_function") is True,
        e.get("is_citizen_narrative") is True,
    ])
    if negative_signals >= 2:
        strong_rejects.append(e.get("number"))

n_strong_passed = len(valid_examples) - len(strong_rejects)
if 0 <= n_strong_passed < len(valid_examples):
    new_score = min(original_score, n_strong_passed)  # только вниз
    if new_score < original_score:
        primary_result["score"] = new_score
        primary_result["penalty_applied"] = True
Оба решения об одном: защита от завышений сама рождает занижения, и область её срабатывания важна так же, как сама проверка. О том, как это сказалось на цифрах, расскажу во второй части.
Задание 24: балл ставит код, модель только спорит
Задание 24 требует составить сложный план по теме. Первый критерий проверяет, есть ли в плане обязательные пункты, и это почти механическая сверка. Поэтому в боте К1 и К2 целиком считает код, а вызовы модели влияют только на текст разбора.
К1: леммы и синонимы заголовков
Пункты плана лемматизируются pymorphy2 и сверяются с эталонными планами банка (185 тем). Порог совпадений зависит от длины ключевого пункта. Самая досадная ошибка такой схемы — синонимы: ученик пишет «Признаки», в эталоне «Особенности», и верный план получает ноль. Поэтому «головы» заголовков приводятся к одной форме:
_HEAD_SYNONYM_GROUPS = (
    frozenset({'признак', 'особенность', 'черта', 'характеристика', 'свойство'}),
    frozenset({'вид', 'тип', 'типология', 'классификация', 'разновидность'}),
    frozenset({'этап', 'стадия'}),
)
_HEAD_CANON = {lemma: min(group) for group in _HEAD_SYNONYM_GROUPS for lemma in group}
Две осторожности не дают синонимам завышать балл. Синонимичный проход идёт только по пунктам, которые не совпали буквально, и один пункт ученика закрывает не больше одного ключевого. А отличительное слово, кроме «головы», всё равно должно стоять в заголовке: голая «Классификация» не закроет «Типы партийных систем». Проверка качества простая: все 185 эталонных планов, поданные как ответ, должны получать максимум по К1. Сейчас получают все 185, а с заменёнными на синонимы заголовками до правки было 147.
К2: четыре фильтра, прежде чем снять балл
К2 ставится автоматически при полном К1. Снять его может только фактическая ошибка в плане, и тут модель была самым опасным источником занижений: одиночный запрос «найди ошибки» снимал балл даже с эталонных планов. Теперь находка проходит четыре фильтра:
-
тип ошибки — из закрытого списка (сейчас в нём один тип: несуществующий вид или функция);
-
дословная цитата длиной не менее 8 символов, которая действительно есть в плане;
-
два независимых прогона указали на один и тот же фрагмент;
-
отдельный прогон-верификатор подтвердил, что названного вида или функции в школьном курсе нет.
Четвёртый фильтр появился последним, и он самый неочевидный. Согласие двух прогонов ловит не только ошибку ученика, но и общий ложный стереотип модели: на эталонных планах оба прогона дружно находили одну и ту же несуществующую ошибку. Два одинаковых ответа одной модели — это не два независимых мнения.
def _deductible_findings(findings, plan_text):
    """Цитата обязательна именно дословная — пересказанную «ошибку» нельзя
    ни показать ученику, ни сверить между прогонами."""
    plan = _normalise_quote(plan_text)
    kept = []
    for finding in findings:
        if finding.get("error_type") not in K2_DEDUCTIBLE_ERROR_TYPES:
            continue
        quote = _normalise_quote(finding.get("quote"))
        if len(quote) < 8 or quote not in plan:
            continue
        kept.append(finding)
    return kept
Замечания, не прошедшие фильтры, не выбрасываются: они попадают в обратную связь, но на балл не влияют. Оценка и замечания разведены.
Когда ИИ недоступен: лучше честный отказ, чем выдуманный балл
Самая неприятная ошибка в такой системе незаметна. Модель не ответила или вернула нечитаемый JSON, код тихо подставил ноль, и ученик видит обычный разбор с нулём баллов. У меня так работало задание 25: 16 таких нулей на 110 кейсах, и половина из них совпадала с эталоном и считалась в метриках «точным попаданием».
Сейчас в большинстве заданий любой сбой сводится к одному флагу ai_unavailable:
-
нет свободного слота за 90 секунд (на процесс — не больше 6 одновременных запросов);
-
сетевая ошибка после трёх попыток с экспоненциальной паузой;
-
отказ модели (
stop_reason: refusal); -
невалидный JSON после ремонта и одного повтора со строгой инструкцией.
С этим флагом балл не показывается вообще. Ученик видит «Проверка временно недоступна… Попытка не списана», администратор получает алерт. Важен и порядок: бесплатная проверка списывается после доставки результата. Раньше было наоборот, и любой сбой отправки сообщения в Telegram сжигал ученику попытку.
В ноябрьском прогоне на 393 кейсах не было ни одного тихого нуля, отказа модели или ошибки разбора. Но честно скажу, что не везде доведено до конца: в заданиях 21 и 23 и на пути задания 24 для сайта при сбое ещё ставится упрощённый балл без флага. И автоматического переключения на резервного провайдера нет: YandexGPT включается руками, переменной окружения и рестартом.
Структурированный ответ без принуждения
Отдельная мелочь, которая пригодится тем, кто работает с новыми версиями Claude. На текущей модели принудительный tool_choice возвращает ошибку 400, так что инструмент передаётся с {"type": "auto"}, а в конец запроса дописывается просьба вызвать инструмент. Если модель всё же ответила текстом, JSON достаётся из текста и при нужде чинится. Температура на новых моделях тоже не передаётся, вместо неё задаётся уровень усилия (effort: medium).
Цена и скорость: около двух центов и девяти секунд на ответ
В ноябре полный прогон на 393 ответах сделал 497 вызовов модели и стоил 8,87 $. В среднем одна проверка — 1,26 вызова, 0,023 $ и 9 секунд работы модели.
|
Задание |
Вызовов на ответ |
$ на ответ |
Время модели на ответ, с |
Доля входа из кэша |
|---|---|---|---|---|
|
17 |
1,03 |
0,018 |
6,2 |
0% |
|
18 |
1,10 |
0,026 |
8,4 |
41% |
|
19 |
1,23 |
0,029 |
8,4 |
63% |
|
20 |
1,38 |
0,021 |
9,5 |
66% |
|
21 и 22 |
1,02 |
0,013 |
5,5 |
0% |
|
23 |
1,85 |
0,026 |
11,3 |
44% |
|
24* |
1,24 |
0,010 |
5,6 |
73% |
|
25 |
1,38 |
0,031 |
12,9 |
61% |
|
Всего |
1,26 |
0,023 |
9,0 |
54% |
* Задание 24 здесь измерено на пути сайта, где модель размечает пункты плана. В боте вызовов больше, его цену отдельно я не мерил.
Два наблюдения. Дороже всего не самая длинная оценка, а перепроверки: у 23-го почти два вызова на ответ. И кэш промпта снижает цену заметно: в задании 19 из кэша берётся две трети входа, а в 17, 21 и 22 он не срабатывает совсем — похоже, их системные промпты слишком короткие для кэширования.
За скобками таблицы остаются OCR фотографий и доставка в Telegram. Время «от сообщения до балла» в проде я пока не измерял.
Стек, масштаб и что бы я сделал иначе
Бот написан на Python 3.10 и python-telegram-bot 22. Сайт и B2B API — FastAPI, очередь для B2B — arq поверх Redis, данные — SQLite в режиме WAL и PostgreSQL для B2B. Лемматизация — pymorphy2, ретраи — tenacity, модель — Claude Sonnet 5.5. Всё живёт на одном сервере в нескольких systemd-юнитах за nginx.
По объёму: ядро — около 33 тысяч строк, задания 17–25 — ещё столько же, тестов — около 1,8 тысячи без учёта других предметов. Реализацию я в большой степени делегирую Claude Code. Моя часть — критерии, разметка эталонов, спецификации правок и решения по спорным случаям.
Почему Claude и что с данными учеников
Это первый вопрос, который мне задают, поэтому отвечу сразу. Бот начинал на YandexGPT, и до конца июля 2026 года проверка работала на нём. Переключился я по трём причинам, и все они видны в цифрах. На одних и тех же 202 ответах Claude совпадал с экспертом в 65,8% случаев, YandexGPT в 54,5%. YandexGPT иногда отказывался отвечать на совершенно обычные экзаменационные задания («Я не могу обсуждать эту тему»), и такой отказ превращался в ноль баллов. И для структурированного ответа у Claude есть серверная JSON-схема, а с YandexGPT мне приходилось разбирать ответ эвристиками. Подробно об этом сравнении во второй части. YandexGPT остался в резерве.
Что уходит в модель: текст задания, ответ ученика и эталоны из банка заданий. Имени, юзернейма и Telegram ID в запросе нет. В режиме ученика текст ответа после проверки не сохраняется: в базе остаются только балл и длина ответа. Из-за этого, кстати, я не могу измерить точность на реальных ответах пользователей, но этот компромисс я считаю правильным.
Почему не дообучение
Второй частый вопрос: зачем столько кода вокруг модели, если можно её дообучить. Я об этом думал и даже написал заготовку пайплайна под YandexGPT: выгрузка проверенных ответов, загрузка в облако, запуск дообучения. Но в прод она так и не попала, и сейчас я не считаю это ошибкой.
Причин три. Данных мало: чтобы дообучение что-то дало, нужны тысячи размеченных ответов по каждому заданию, а у меня их сотни. Критерии ФИПИ уточняются почти каждый год, и дообученную модель пришлось бы переучивать, а правило в коде я поправлю за вечер. И главное, ошибки модели в оценке оказались не «незнанием обществознания», а нарушением формальных правил: засчитала функцию вместо примера, сняла балл за несуществующую ошибку. Такие правила проще и надёжнее записать кодом, чем надеяться, что модель выучит их из примеров. Пример с задачей 20 выше это хорошо показывает: модель стабильно путала «минус один балл» и «ноль», пока арифметику не забрал код.
Что бы я сделал иначе, если бы начинал сначала:
-
Один конвейер для всех заданий с первого дня. Часть заданий идёт через общий движок проверки, часть — своим хендлером. В итоге одну и ту же логику — учёт попыток, обработку сбоев — приходится поддерживать в нескольких местах, и она неизбежно расходится.
-
Регрессионный набор раньше первого промпта. Бот в первой версии запустился летом 2025 года, а систематические замеры появились только весной 2026-го. Первый же прогон показал, что бот завышает балл примерно каждому третьему ответу.
-
Хранить историю проверок. Сейчас бот сохраняет только балл и длину ответа. Это хорошо для приватности, но из-за этого точность на настоящих ответах учеников измерить нельзя. Нужен был анонимный журнал с согласием пользователя.
Во второй части расскажу, как я измерял точность всего этого и сколько раз обманывал себя метриками.
Автор: martinbehaym

