


Изначально я хотел сделать проект для обучения LLM для себя — ради эксперимента. А в итоге он вырос в программу, в которой свою LLM может обучить любой человек. Делаю его с 8 июня 2026 года — и до сих пор.
Старый ПК в заголовке — не для красного словца. Core i5-2400 2011 года, 16 ГБ DDR3 и GeForce GT 710 — это и есть мой основной компьютер, мощнее у меня нет. Видеокарту PyTorch не поддерживает, так что всё в статье посчитано на процессоре. Мне было интересно проверить, что на таком железе реально сделать с языковыми моделями без облака. Получилось две вещи: модель на 7 млн параметров, обученная с нуля на русских народных сказках, и Qwen3.5-0.8B, дообученная за 1 ч 44 мин отвечать на вопросы о программе, в которой всё это сделано.
Сразу оговорюсь: AuraLite — моя программа, я пишу её с июня 2026 года. Статья не про то, что «вот какой продукт», а про то, что на такой машине реально получается из обучения LLM и где проходят границы. Все цифры ниже — с этой машины, все неудачи — тоже.
Коротко: Core i5-2400 2011 года, 16 ГБ DDR3, всё на процессоре. За 5 ч 38 мин выучил с нуля модель на 7 млн параметров на 321 сказке — она перенимает стиль, но не смысл. За 1 ч 44 мин дообучил Qwen3.5-0.8B отвечать по документации программы: дословных совпадений с эталоном 0 % → 33 %, потери в 38 раз ниже — и три честных провала. Данные и команды в конце, повторить можно на любом похожем железе.
Железо и почему без видеокарты
|
Что |
Значение |
|---|---|
|
Процессор |
Intel Core i5-2400, 3,1 ГГц, 4 ядра / 4 потока, AVX (AVX2 нет) |
|
16 ГБ DDR3, из них 12,7 ГБ доступно обучению |
|
|
Видеокарта |
GeForce GT 710 (Kepler, compute capability 3.5) |
|
Система |
Windows 10 (10.0.19045) |
|
Скорость умножения матриц float32 |
74–76 ГФЛОП/с на 4 потоках |
GT 710 выпадает не потому, что медленная: по fp32 она выдаёт около 366 ГФЛОП/с против 76 у процессора, то есть формально быстрее. Причин три: 1–2 ГБ DDR3 видеопамяти, отсутствие быстрых fp16/bf16-путей и, главное, отсутствие sm_35 в официальных сборках PyTorch — Kepler убрали из готовых бинарников ещё в 1.3.x, практический максимум сегодня — PyTorch 1.12.1 с CUDA 10.2 либо сборка из исходников с TORCH_CUDA_ARCH_LIST=3.5. Поэтому весь эксперимент честно на процессоре.
Заодно эти 74–76 ГФЛОП/с стоит поставить в контекст: теоретический пик i5-2400 без FMA — 4 ядра × 3,1 ГГц × 8 операций ≈ 99 ГФЛОП/с, то есть замер даёт около 75 % пика и матричные умножения упираются в железо, а не в код. Такое железо всё ещё работает не только у меня, но говорить за «многих» не буду: у меня это единственный компьютер, на нём я и не могу позволить себе облако — в этом и был смысл проверки.
Чем обучал
Всё ниже посчитано в AuraLite — программе для обучения и запуска моделей на своём компьютере, открытой, под лицензией Apache-2.0. Ниже не список её возможностей, а те решения, без которых на i5-2400 ничего бы не вышло.
-
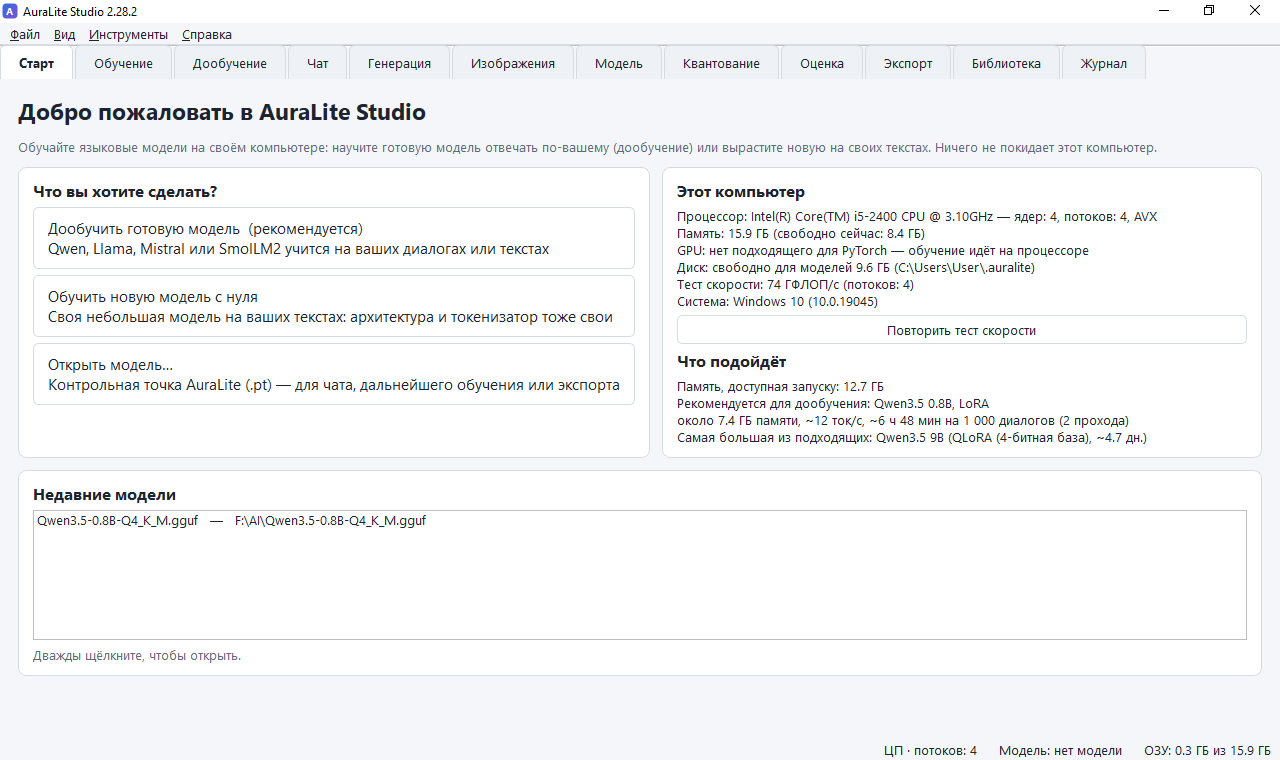
Подбор модели под компьютер. Односекундный тест скорости и объём свободной памяти дают рекомендацию и оценку времени до запуска. Оценка оказалась неровной: скорость мастер предсказал на 16 % выше фактической, зато правильно предупредил, что упрёмся в объём текста, а не в процессор.
-
QLoRA без bitsandbytes. Своя 4-битная квантизация NF4 с двойным квантованием работает на любом процессоре, где есть PyTorch, включая машины без AVX2. В этом эксперименте она даже не понадобилась: 6,9 ГБ влезали в 12,7 ГБ доступной памяти, поэтому дообучал на полной точности — обычной LoRA.
-
Импорт Qwen3.5 в собственный движок вместе с её линейным вниманием (Gated DeltaNet). Логиты сверены с transformers: наибольшая разница 0,0 по всей последовательности и в пределах 1e-6 на шаге генерации из кэшей (тест
tests/test_qwen35_v2230.py). Обратно модель выгружается в GGUF для llama.cpp, Ollama и LM Studio или в папку Hugging Face. -
План памяти. Батч, который не помещается в память, делится на части с накоплением градиента, при нехватке включается пересчёт активаций. Именно он позволил обучить 0,8B на 4 ядрах без видеокарты.
-
Точное продолжение. Контрольная точка сохраняется каждые 10 минут, и остановленный с последующим продолжением запуск заканчивается теми же весами до последнего бита, что и непрерывный (тест
tests/test_bigdata_v218.py::test_continue_run_is_exact). Для ночных запусков на домашнем ПК это важнее, чем кажется.
Движок свой и читается целиком: Transformer с RoPE, GQA и KV-кэшем, BPE-токенизатор, оптимизатор Muon, расписание скорости обучения WSD. Понимаю, что звучит как перечисление галочек, поэтому дальше — только замеры.
Сколько успевает такой процессор: бенчмарк
В программе есть встроенный замер (auralite bench, в Studio — «Инструменты → Бенчмарк…»). На этом компьютере он показал:
|
Модель |
Параметров |
Обучение, ток/с |
За 8 часов |
Память |
Генерация, ток/с |
|---|---|---|---|---|---|
|
tiny (4 слоя × 128) |
0,9M |
4 466 |
128,6 млн токенов |
0,13 ГБ |
159 |
|
small (8 слоёв × 256) |
7M |
923 |
26,6 млн токенов |
0,46 ГБ |
75 |
|
medium (12 слоёв × 384) |
19M |
353 |
10,2 млн токенов |
1,01 ГБ |
43 |
|
Qwen3.5-0.8B, дообучение LoRA |
763M |
16 |
— |
6,9 ГБ |
— |
Три первых строки — прогон AuraLite 2.23.0 (по 60 секунд на размер), строка дообучения — 2.23.1: там план памяти разложил батч на два окна в четыре прохода, и получилось 16 ток/с против 14 в первом прогоне при 9,5 ГБ памяти. Версию я указываю специально, потому что цифры между прогонами гуляют: тот же small в 2.22.0 показывал 774 ток/с, в 2.23.0 — 923.
Чтобы понимать масштаб: модель на 7 млн параметров успевает за ночь прочитать 26 млн токенов — примерно сто мегабайт русского текста при словаре этого эксперимента. Для языковых моделей это очень мало, поэтому с нуля здесь стоит учить только маленькие модели. Дообучение готовой модели на 16 токенах в секунду — это тысяча коротких диалогов за ночь.
Мастер же считает иначе, чем бенчмарк, и полезно видеть оба счёта. Его оценки — на 1 000 диалогов в два прохода:
|
Компьютер |
Что он рекомендует |
Память |
Время |
|---|---|---|---|
|
4 ГБ, 4 потока |
SmolLM2 135M, QLoRA |
1,8 ГБ |
≈ 3 ч |
|
8 ГБ, класс i5-2400 |
Qwen3.5 0.8B, QLoRA |
5,7 ГБ |
≈ 7 ч |
|
16 ГБ, класс i5-2400 |
Qwen3.5 0.8B, LoRA |
7,4 ГБ |
≈ 7 ч |
|
32 ГБ, 8 потоков |
Qwen3.5 2B, QLoRA |
8,0 ГБ |
≈ 4,5 ч |
Эксперимент 1: модель с нуля на сказках
Данные. 321 сказка из Викитеки, все в общественном достоянии и в современной орфографии: 262 из «Народных русских сказок» Афанасьева (украинские и белорусские варианты я убрал), 36 из «Великорусских сказок» Худякова, 23 — «Алёнушкины сказки» Мамина-Сибиряка и сказки Одоевского. Сноски, разметка и ударения сняты, порядок перемешан. Получилось 5,3 МБ текста — 1,38 млн токенов при BPE-словаре из 512 частей; десятая часть ушла на отложенную выборку, то есть в обучении было 1,24 млн токенов.
Что предложил мастер. Пресет 25m — это 8 слоёв × 256 при словаре 512, около 6,6 млн параметров (в таблице бенчмарка Studio округляет их до 7 млн, карточка запуска показывает точное число). Сразу же он предупредил: «текста мало для такого размера, нужно около 9 МБ». Я согласился: больше сказок в открытом доступе и в современной орфографии мне найти не удалось.
|
Что мерил |
Результат |
|---|---|
|
Время |
5 ч 38 мин |
|
Прочитано токенов |
16 520 960 — 13 проходов по обучающей части (2 022 шага оптимизатора) |
|
Скорость |
812 ток/с в среднем |
|
Память |
1,0–1,8 ГБ |
|
Лучшие потери на отложенных сказках |
2,7854 нат на токен (1,0607 бит на байт UTF-8) |
|
Потери на обучающих сказках в конце |
1,9284 |
Про скорость стоит объяснить сразу, потому что чисел три и они легко путаются. 965 ток/с — оценка мастера, он считает её по тесту матричных умножений. 923 ток/с — встроенный бенчмарк, минута обучения на фиксированном тексте. 812 ток/с — этот запуск: другой датасет, другой шаг оптимизатора, запись контрольных точек. Ошибка оценки — 16 %, и это не «мастер врёт», а то, что оценка не знает про шаги оптимизатора.
Ещё две мелочи, которые видно на скриншотах и которые лучше назвать самому. В статусной строке окна стоит «ОЗУ: 0,6 ГБ» — это память интерфейса, а не обучения; обучение занимало 1,0–1,8 ГБ. И запуск в библиотеке помечен завершённым, хотя я остановил его кнопкой «Завершить» после того, как потери перестали улучшаться; в карточке так и написано — «завершено досрочно после плавного снижения скорости обучения».
Чем учил. Рецепт — не «настройки по умолчанию», поэтому перечислю: Muon со скоростью 0,02 и тремя итерациями Ньютона–Шульца, QK-norm, расписание WSD, AdamW 0,001 для эмбеддингов и выходной головы, батч 32, dropout «авто», weight decay 0,01, обрезка градиента 1,0, 10 % текста на валидацию, ранняя остановка после трёх эпох без улучшения с затуханием скорости в конце. Генерация — температура 0,95, top-k 50, top-p 0,90, штраф за повторы 1,00, 400 токенов.
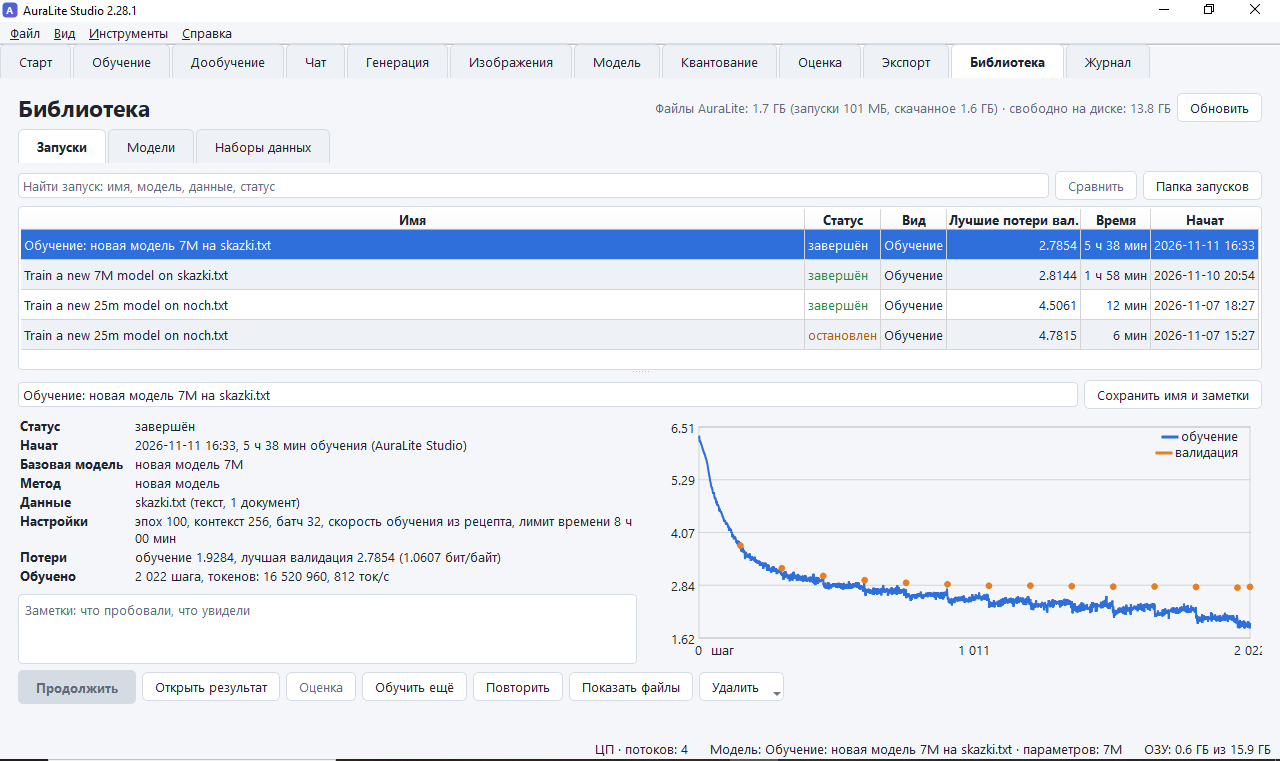
Самое поучительное — кривая. Примерно с шестого прохода потери на отложенных сказках встали на 2,79, а на обучающих продолжали падать: модель начала заучивать текст. Предыдущий запуск, который я остановил через 1 ч 58 мин, дал 2,8144. Лишние 3,5 часа улучшили результат на 1 %. Здесь упёрлись в объём данных, а не во время — ровно как предупреждал мастер.
Что она пишет. Модель продолжает текст с заданного начала, и здесь важно разделить две вещи. Форма усвоена: зачины, обращения, сказочные имена, реплики после тире, ритм перечисления — всё на месте, и на слух такой текст не отличить от источника. Смысла нет: герои меняются местами посреди абзаца, один и тот же богатырь успевает трижды жениться и умереть, а сюжет к концу уходит не туда, куда шёл в начале. Для 7 млн параметров и 5 МБ текста это ровно ожидаемое поведение: модель выучила, как выглядит сказка, но не то, как она устроена. Ради этого я всё и затевал — по стилю видно, что обучение идёт.
Примеров выдачи в статье я не привожу: это сгенерированный текст. Шесть текстов, на которых я потом мерял копирование, лежат файлами в архиве с данными — ссылка в разделе «Как повторить», — их можно открыть и оценить самому.
Не копирует ли она
Раз модель начала заучивать, это стоило проверить. Я сравнил шесть сгенерированных текстов (по 132–148 слов) со всеми сказками. Сравнение — по словам, после приведения к нижнему регистру и снятия пунктуации: считались пятисловные последовательности, которые встречаются в сказках, и самый длинный дословный отрезок подряд.
Числа без базовой линии ничего не значат, поэтому рядом две границы: те же слова в случайном порядке и кусок настоящей сказки.
|
Что сравнивали |
Пятисловий найдено в сказках |
Самый длинный дословный повтор |
|---|---|---|
|
6 текстов модели |
0–4,7 % |
4–8 слов |
|
Контроль: те же слова, перемешаны |
0 % |
2–3 слова |
|
Контроль: кусок настоящей сказки |
100 % |
12 и больше слов |
То есть модель ближе к перемешанному контролю, чем к сказке, и её 4–8 слов — это устойчивые формулы: «в некотором царстве, в некотором государстве жил-был солдат», «и поехал в чистое поле». В каждом тексте есть и свои слова: «кумышка», «покатился-полазился», «белакачет». Модель собирает новый текст из выученных оборотов и падежей, а не пересказывает обучающие сказки — с поправкой на то, что шесть текстов это иллюстрация, а не измерение.
Эксперимент 2: дообучение Qwen3.5-0.8B
С нуля на таком компьютере получится игрушка. Модель, которая отвечает на вопросы, — это дообучение готовой модели. Я взял Qwen3.5-0.8B (март 2026, Apache-2.0): она маленькая и неплохо понимает русский.
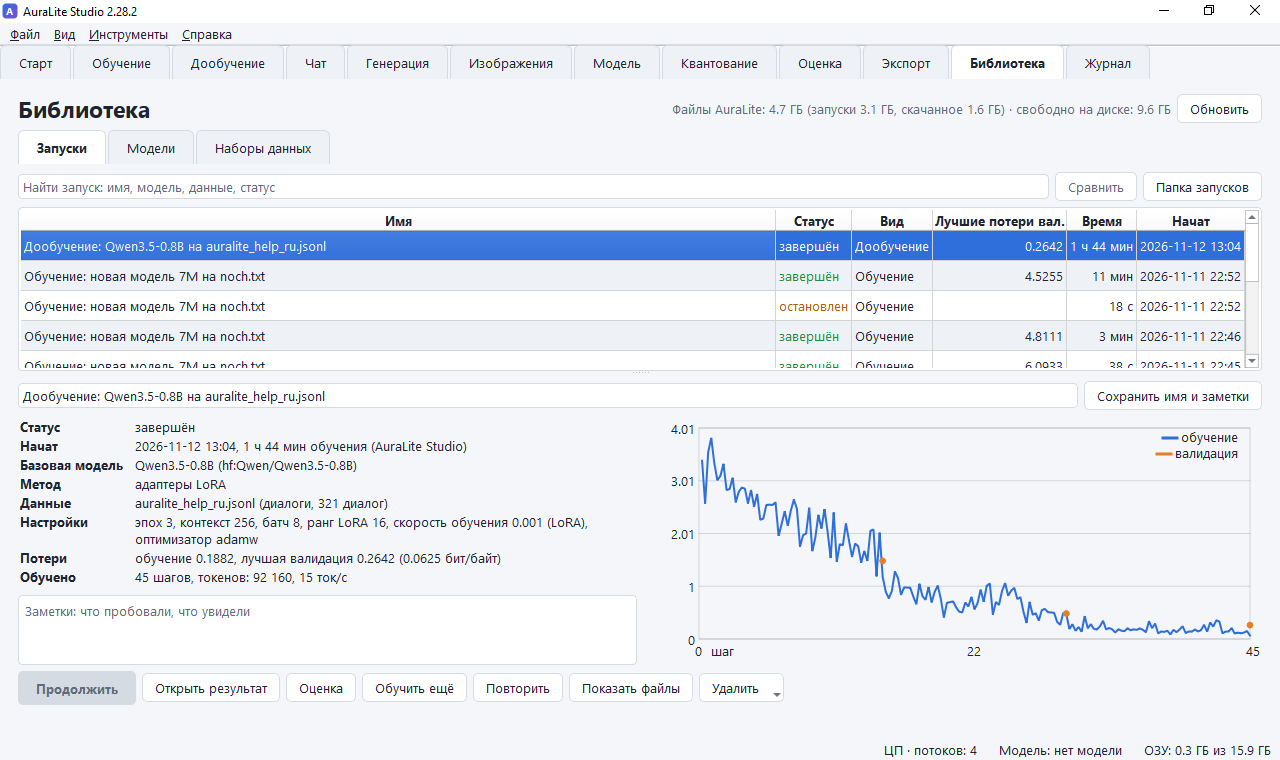
Данные. Мне нужна была задача, которую любой может повторить, без личных данных и вопросов к лицензии, — помощник по самой программе. Набор устроен так: 103 темы из документации (установка, дообучение, библиотека запусков, экспорт, ошибки), каждая в трёх формулировках вопроса с одним эталонным ответом, плюс 12 диалогов в несколько реплик и несколько ответов на вопросы не по теме — итого 321 диалог. Отдельно 30 отложенных вопросов: те же темы, но новыми словами, таких формулировок в обучении нет.
Что предложил мастер. В мастере дообучения он предложил Qwen3.5 2B с QLoRA и около 6 часов: данных немного, и за ночь успевает модель покрупнее. На вкладке «Старт» в 2.28.2 рекомендация другая — 0,8B через LoRA, около 7 часов, — потому что считается от свободной памяти в момент подбора; и то и другое около ночи. Я взял 0.8B по прозаической причине: 2B это ещё 4,6 ГБ загрузки, а интернет у меня медленный, так что скачивание заняло бы больше времени, чем само обучение.
|
Параметр |
Значение |
|---|---|
|
Метод |
LoRA ранга 16 на базе полной точности (QLoRA не понадобилась: 6,9 ГБ влезали) |
|
Оптимизатор и скорость |
AdamW, 0,001 |
|
Проходы |
3 |
|
Окно / батч |
256 токенов / 8 |
|
Шаги |
45 шагов оптимизатора (180 микрошагов) |
|
Время |
1 ч 44 мин, 92 160 токенов, 15 ток/с |
|
Потери на отложенной части запуска |
0,2642 (0,0625 бит на байт) |
Оценка на отложенных вопросах. Вкладка «Оценка»: 15 вопросов из 30, ответ до 160 токенов, жадная генерация. Базовая модель — та же Qwen3.5-0.8B, только без дообучения (в окне она подписана main, 752 млн параметров, а дообученная — 763 млн: это одна и та же модель, во втором случае с адаптерами).
|
Метрика |
Qwen3.5-0.8B до |
После дообучения |
|---|---|---|
|
Ответ заканчивается сам ( |
0 % |
100 % |
|
Нет шаблонных меток чата ( |
100 % |
100 % |
|
Ответ совпал с эталоном дословно ( |
0 % |
33 % (5 из 15) |
|
Потери на эталонных ответах |
3,4565 нат на токен |
0,0907 нат на токен |
|
Токенов в ответе |
160 — упирается в предел |
77,9 |
|
Время на 15 вопросов |
812 с |
488 с |
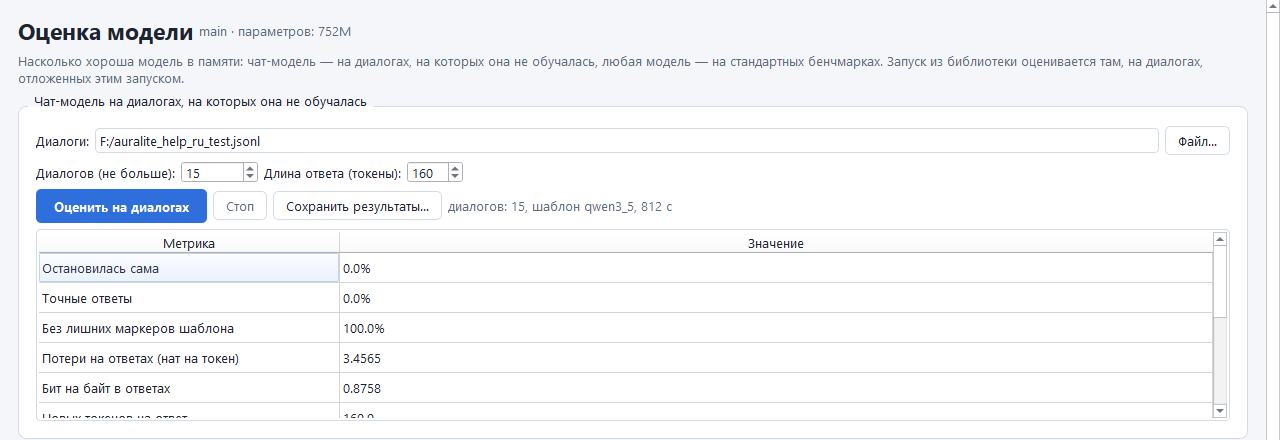
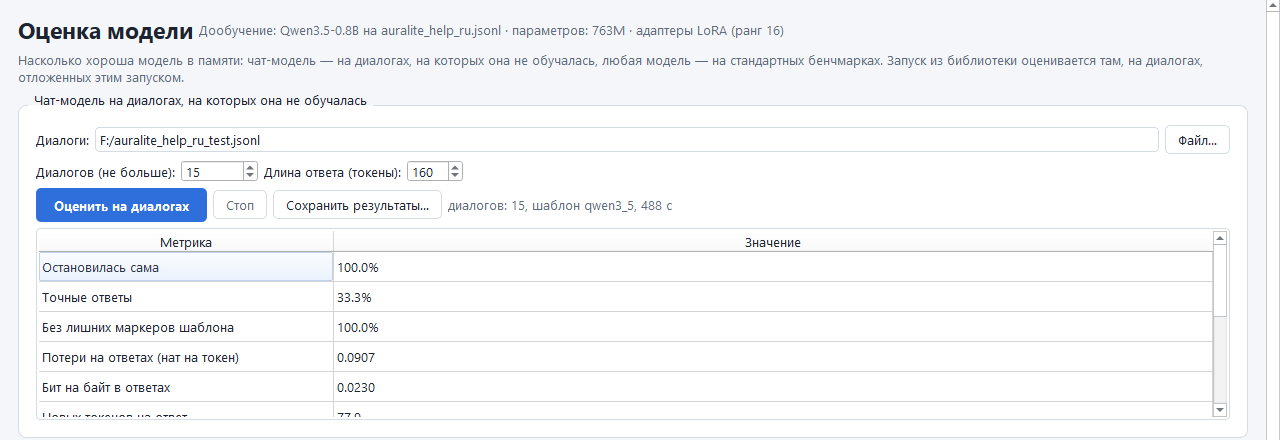
Потери на эталонных ответах упали в 38 раз. Базовая модель ни разу не закончила ответ сама: она пишет общие советы с Markdown-разметкой, пока не упрётся в предел, и по ходу уверенно выдумывает: например, что файл с диалогами бывает с расширением .xml или .log, а LM Studio — это среда для генерации картинок. Дообученная отвечает в несколько предложений словами документации. Пять дословных совпадений с эталоном на вопросах, заданных новыми словами, — это модель, которая выучила ответы на темы; для справочного помощника это нужно.
Что изменилось в ответах. «Умнее» модель не стала: она знает ровно один документ и отвечает по нему. Изменилось то, откуда она берёт слова. Два примера, оба вопроса из отложенного набора.
Первый: что делать, если компьютер перезагрузился посреди дообучения. Базовая Qwen3.5-0.8B перечисляла несуществующие настройки и выдуманную функцию запрета повторов — звучит как инструкция, к программе отношения не имеет. Дообученная вспомнила про контрольные точки каждые 10 минут и про то, что вкладка «Старт» сама предложит продолжить прерванный запуск: потеряется не больше последних десяти минут.
Второй: как открыть дообученную модель в LM Studio. Базовая отправляла искать что-то в «левом верхнем углу окна» и выбирать набор данных из списка вроде MMLU и GSM8K — ни того, ни другого в программе нет. Дообученная назвала вкладку «Экспорт», пункт «Файл GGUF — для llama.cpp, Ollama и LM Studio» и тип Q8_0 или F16.
Разница не в качестве рассуждений. Разница в том, что дообученная перестала сочинять интерфейс, которого не существует.
Что не получилось
Здесь честная половина результата, и она важнее красивой.
-
Факты склеиваются. На вопрос о старом компьютере модель назвала процессор «256-битным»: такого в данных нет, разрядность взялась из воздуха. На вопрос о формате файла она выдала кусок ответа про модель-учителя — то есть подставила близкий по словам абзац, а не тот, который нужен.
-
Температура решает многое. Тот же вопрос при температуре 0,7 получил ответ, который начинался с уверенного «нет», переврал объём памяти и ссылался на несуществующий метод обучения — название модель собрала из обрывков «LoRA» и «QLoRA». При жадной генерации ответ был почти верным. Для справочного помощника я бы ставил температуру 0,2–0,3.
-
Отказ не обобщился. На вопрос «посоветуй хороший фильм на вечер» модель вместо отказа придумала несуществующий открытый файл «Видео 2.0» под лицензией Apache-2.0. Примеров вне темы в данных было три, и все про другое: маленькая модель на маленьком наборе сузилась до своей темы и всё переводит на неё.
Что бы я сделал иначе: больше примеров вне темы, разных, хотя бы 30–50; пять формулировок на тему вместо трёх; Qwen3.5 2B, если позволяет загрузка, — мастер её и предлагал; низкая температура в чате. Всё это — данные и одна настройка, а не железо: компьютер справился.
Дальше модель можно унести из программы. Нажмите «Слить адаптеры» — на вкладке «Дообучение» сразу после обучения или на вкладке «Модель» для открытой модели, — затем на вкладке «Экспорт» сохраните файл GGUF типа Q8_0. Его читают llama.cpp, LM Studio и Ollama. Экспорт Qwen3.5 в GGUF проверен: llama.cpp (llama-cpp-python 0.3.36) считает логиты AuraLite с расхождением 8e-5 в F32 на 100 токенах, 3e-4 в F16 и 8e-3 в Q8_0, токенизатор даёт те же id (тест tests/test_hf_native_real.py).
Как повторить
-
Скачайте AuraLite-Studio-<версия>-windows-x64.zip со страницы релизов, распакуйте и запустите
AuraLite Studio.exe. Скриншоты в статье сняты в Studio 2.28.2, кроме «Библиотеки» на сказках — она снята на 2.28.1, там подпись оси обрезана. Windows предупредит, что приложение не подписано: «Подробнее» → «Выполнить в любом случае». -
Возьмите данные — skazki.txt, auralite_help_ru.jsonl и auralite_help_ru_test.jsonl одним архивом (1,3 МБ): сказки в общественном достоянии, подборка и диалоги — CC0.
-
Откройте «Инструменты → Мастер настройки…». Сказки — «Обучить новую модель с нуля», диалоги — «Дообучить готовую модель». Мастер сам предложит модель и покажет память и время.
Или из консоли, в папке приложения:
# модель с нуля на сказках: пресет 25m = 8 слоёв x 256, лимит 8 часов
.auralite.exe train --data skazki.txt --preset 25m --time-budget 8h --memory-plan auto --model skazki.pt
.auralite.exe generate --model skazki.pt --prompt "Жил-был" --length 400 --temperature 0.95

# дообучение Qwen3.5-0.8B (LoRA; добавьте --quantize nf4 для QLoRA на 8 ГБ)
.auralite.exe train --data auralite_help_ru.jsonl --resume hf:Qwen/Qwen3.5-0.8B --lora 16 --memory-plan auto --model help.pt
.auralite.exe chat-eval --model help.pt --data auralite_help_ru_test.jsonl --limit 15 --max-new-tokens 160
.auralite.exe export --model help.pt --format gguf --quant q8_0 --out help.gguf
На Linux и macOS то же ставится через pip install "auralite-ai[studio]", а запускается командой auralite-studio или auralite. Готовое приложение без Python собрано только для Windows — старые домашние компьютеры чаще всего на ней.
Ограничения
-
Скорость. Дообучение 0.8B — 15–16 токенов в секунду, поэтому тысяча коротких диалогов занимает ночь, а десятки тысяч — уже не вариант. Модели от 4B на этом процессоре учатся днями.
-
Ответы в самой программе медленные: около трёх токенов в секунду, потому что модель с несшитыми адаптерами считается в float32. Для повседневного использования лучше выгрузить её в GGUF и запускать в llama.cpp или LM Studio.
-
Модель с нуля — учебная. 7 млн параметров и 5 МБ текста дают стиль, но не смысл: чтобы получить смысл, нужны на порядки больше и данных, и вычислений.
-
Качество дообученной модели держится на данных. 321 диалог — это демонстрация; для настоящего помощника нужны тысячи разнообразных примеров.
-
Память и загрузка. Модель весит 1,8 ГБ скачивания, в float32 занимает около 3 ГБ памяти и около 7 ГБ в обучении; на 8 ГБ ОЗУ мастер переключится на QLoRA, а на 4 ГБ предложит SmolLM2 135M.
Чего я не проверял
Чтобы не создавать ложного впечатления, перечислю, чего здесь нет. Я не мерил, деградирует ли модель на общих знаниях после дообучения на 321 диалоге, — это первое, что стоит проверить дальше. Не сравнивал дообучение с «документация в промпте»: для справочника по программе это законная и, возможно, более дешёвая альтернатива, и в реальном продукте я, скорее всего, начал бы именно с неё. Оценка «до и после» сделана на 15 вопросах, проверка на копирование — на 6 текстах: это проверка работоспособности, а не измерение качества с погрешностью. Скорость той же модели в llama.cpp на этом процессоре я тоже не мерил — сверены только логиты. И ничего не проверял на других процессорах: все цифры верны ровно для i5-2400 2011 года, 4 потока, AVX без AVX2.
Электричество, раз уж спросят: i5-2400 — 95 Вт по паспорту, весь компьютер под такой нагрузкой — 120–150 Вт, то есть ночь обучения это примерно 1 кВт·ч. Точным замером не занимался.
Вопросы, которые наверняка зададут
Зачем, если в llama.cpp уже есть обучение? Есть, и я это проверял: в llama.cpp работает llama-finetune, а недавно там появилось CPU-дообучение LoRA (examples/llama-finetune-lora) — для dense и hybrid-моделей, с SFT-набором из JSONL, шаблоном чата, чекпоинтами и расписаниями скорости обучения, в том числе для Qwen3.5. Разница в том, чего в нём нет: QLoRA (обучение идёт по уже квантованным весам, без квантизации-осознанного обучения), подбора модели под конкретный компьютер и плана памяти, вкладки «Оценка» с ответом на вопрос «стало лучше или нет», библиотеки запусков с историей и настройками — и всё это собирается из исходников. Мне для эксперимента на i5-2400 нужен был один zip и одно окно.
А Unsloth, nanoGPT? Unsloth рассчитан на видеокарты NVIDIA и на процессоре не работает. nanoGPT — отличный учебный код для GPT-2, но в нём нет современных моделей вроде Qwen3.5, LoRA и QLoRA, мастера и библиотеки запусков.
GT 710 — это не видеокарта для ML. Именно. И дело не в скорости: она не поддерживается современными сборками PyTorch и имеет 1–2 ГБ DDR3. Смысл статьи в том, что видеокарта не обязательна.
Exe без подписи, антивирус ругается. Сертификат для подписи стоит денег. У каждого файла на странице релиза есть контрольная сумма и подписанная запись сборки из GitHub Actions (gh attestation verify), исходники открыты, а проект покрыт автотестами: в версии 2.28.2 их 2 552, отдельно — мутационная проверка, 17 внесённых поломок ловятся все. Кто не хочет качать zip, ставит через pip.
Почему zip весит 240 МБ? Внутри Python, PyTorch и Qt — ставить ничего не нужно. С установленным Python всё то же ставится через pip.
А Linux? Через pip работает так же, включая Studio. Готовое приложение собрано только для Windows.
Почему PyTorch, а не свой C++? Чтобы движок можно было прочитать целиком. Для обучения на процессоре PyTorch достаточно быстр, а выгрузка в GGUF даёт быстрый запуск в llama.cpp.
Это реклама? Код открыт под Apache-2.0, платных функций нет. Статья — про эксперимент и его цифры, включая провалы.
Итог
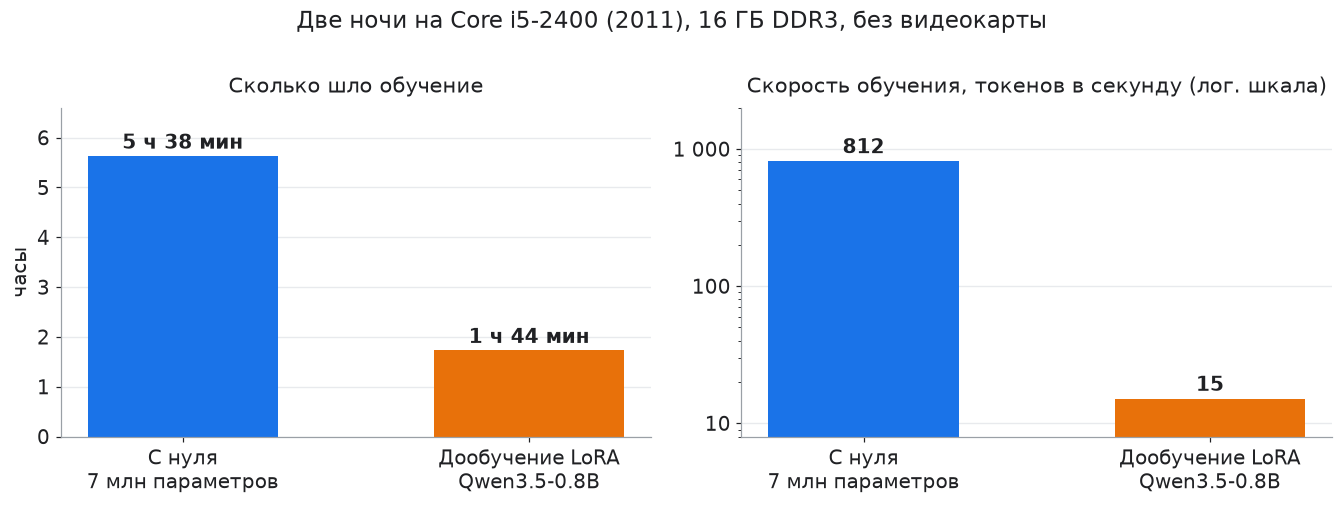
На компьютере 2011 года без видеокарты за одну ночь можно обучить с нуля маленькую модель — она перенимает стиль текста, но не смысл, — и дообучить настоящую модель на 0,8 млрд параметров отвечать на вопросы по своей теме за пару часов. Узкие места — объём данных и их разнообразие, а не железо: программа сама предупредила о нехватке текста и почти точно предсказала масштаб.
Дальше по плану — те же две ночи с Qwen3.5 2B, больше примеров вне темы и сравнение с «документация в промпте». Если интересно, напишу и об этом.
Ссылки. Репозиторий, приложение для Windows, данные из статьи, все цифры обеих ночей одной страницей.
Автор: AlexanderNyr

