


Исследователи из UC Berkeley и Arena сравнили семь моделей внутри Claude Code, Codex CLI и минималистичного Pi. На двух бенчмарках выбор харнесса почти не менял среднюю успешность, но увеличивал стоимость одной и той же модели до пяти раз. Результат хорошо объясняет, почему сравнивать coding-агентов только по названию моделей уже бессмысленно.
А что именно измерили?
На всякий случай напомнлю, что харнессом называют программную оболочку вокруг модели. Она формирует системные инструкции, подключает инструменты, решает, какие файлы и результаты команд положить в контекст, запускает терминал и повторяет цикл до решения задачи. Модель остаётся той же, но маршрут до ответа меняется.
Авторы HarnessTax собрали 21 связку из семи моделей и трёх харнессов. В исследование вошли Claude Fable 5, Opus 4.8, Sonnet 4.6, Haiku 4.5, GPT-5.6 Sol, GPT-5.6 Luna и Kimi K3. Каждую связку проверили на 30 случайных задачах SWE-bench Lite и 30 задачах Terminal-Bench 2.0. Каждая задача запускалась трижды, один прогон ограничивался 100 агентными шагами.
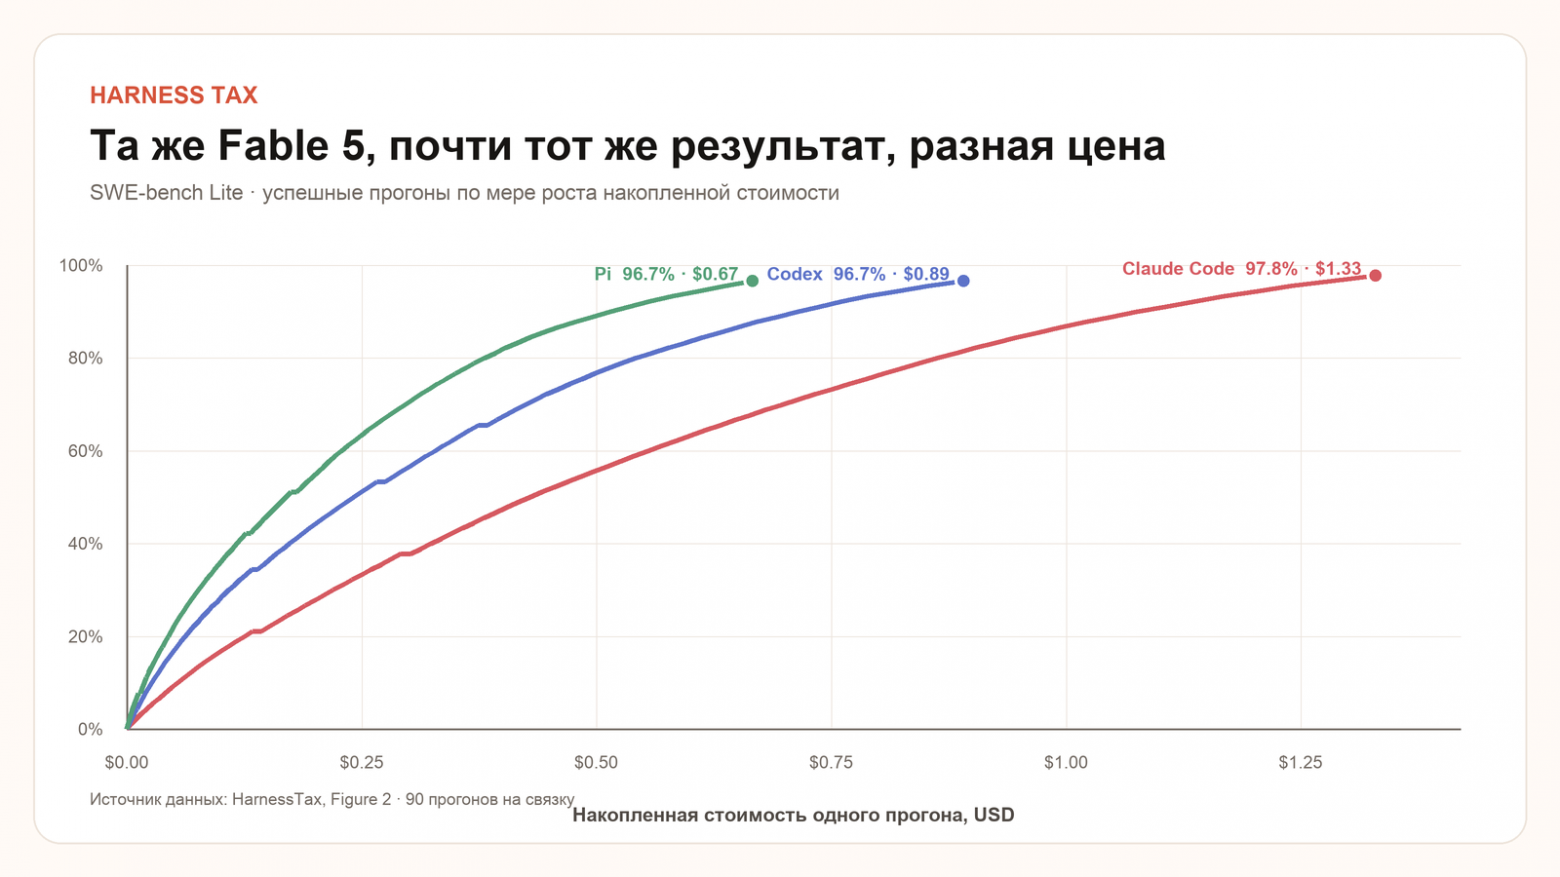
На SWE-bench Lite Claude Fable 5 решила 97,8% попыток в Claude Code и 96,7% в Pi. Разница в успешности составила 1,1 процентного пункта. Средняя стоимость попытки при этом достигла $1,33 в Claude Code и $0,67 в Pi.
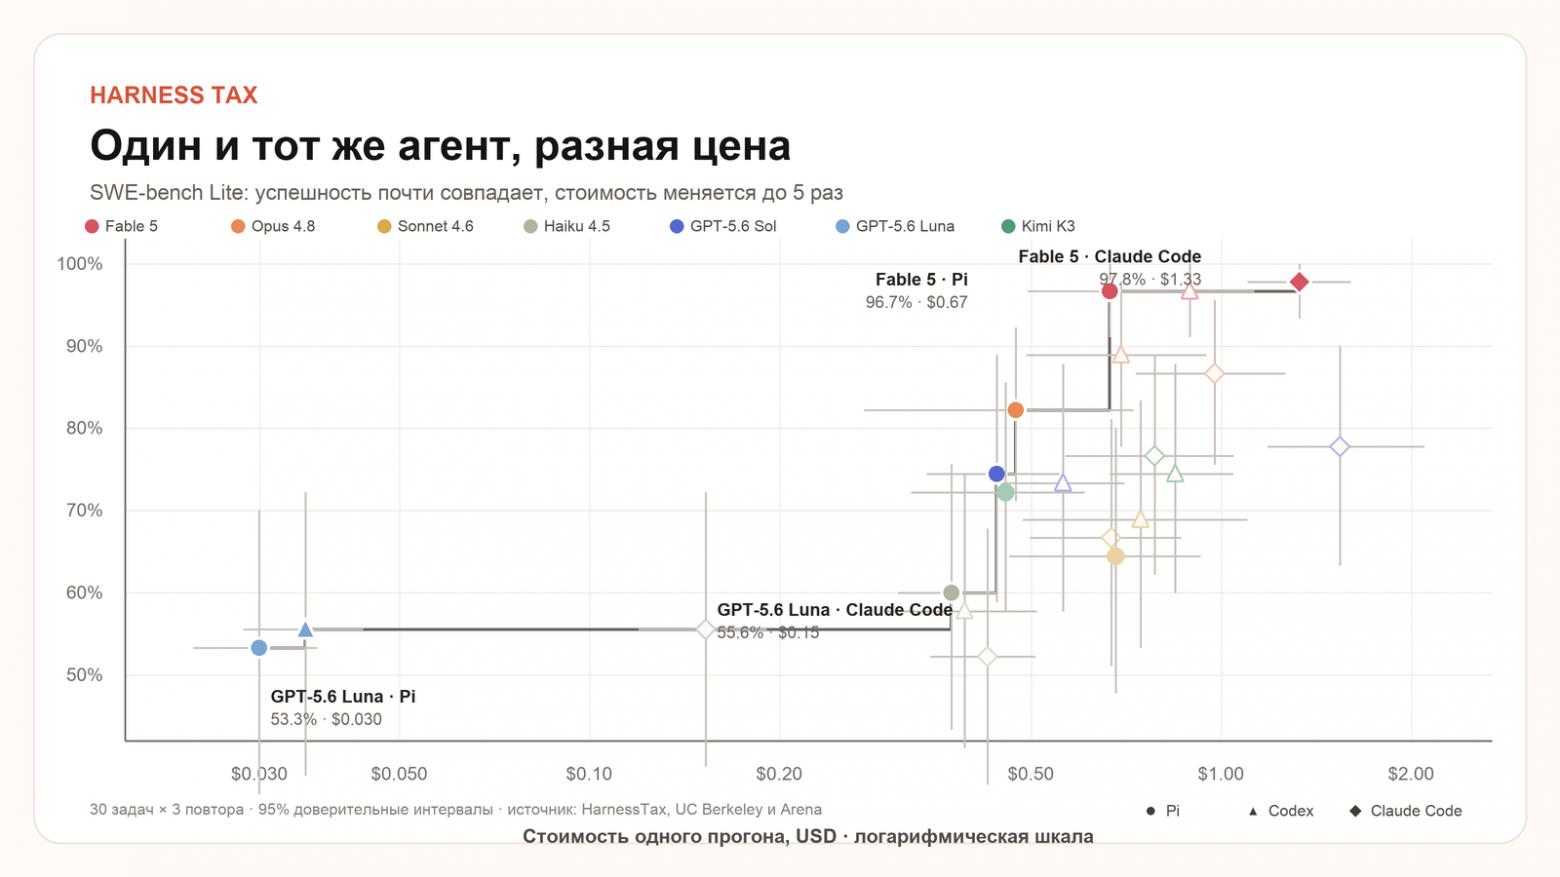
Самый заметный разрыв появился у GPT-5.6 Luna. В Claude Code попытка стоила в среднем $0,152, в Pi около $0,030. Успешность составила 55,6% 53,3% соответственно. Почти тот же результат обошёлся примерно в пять раз дороже.
В среднем по общим моделям Claude Code стоил вдвое дороже Pi и в 1,6 раза дороже Codex CLI на SWE-bench Lite. На Terminal-Bench 2.0 разница с Pi составила 1,5 раза. Авторы назвали эту переплату harness tax или налогом за агентную оболочку.
Откуда берётся лишний счёт
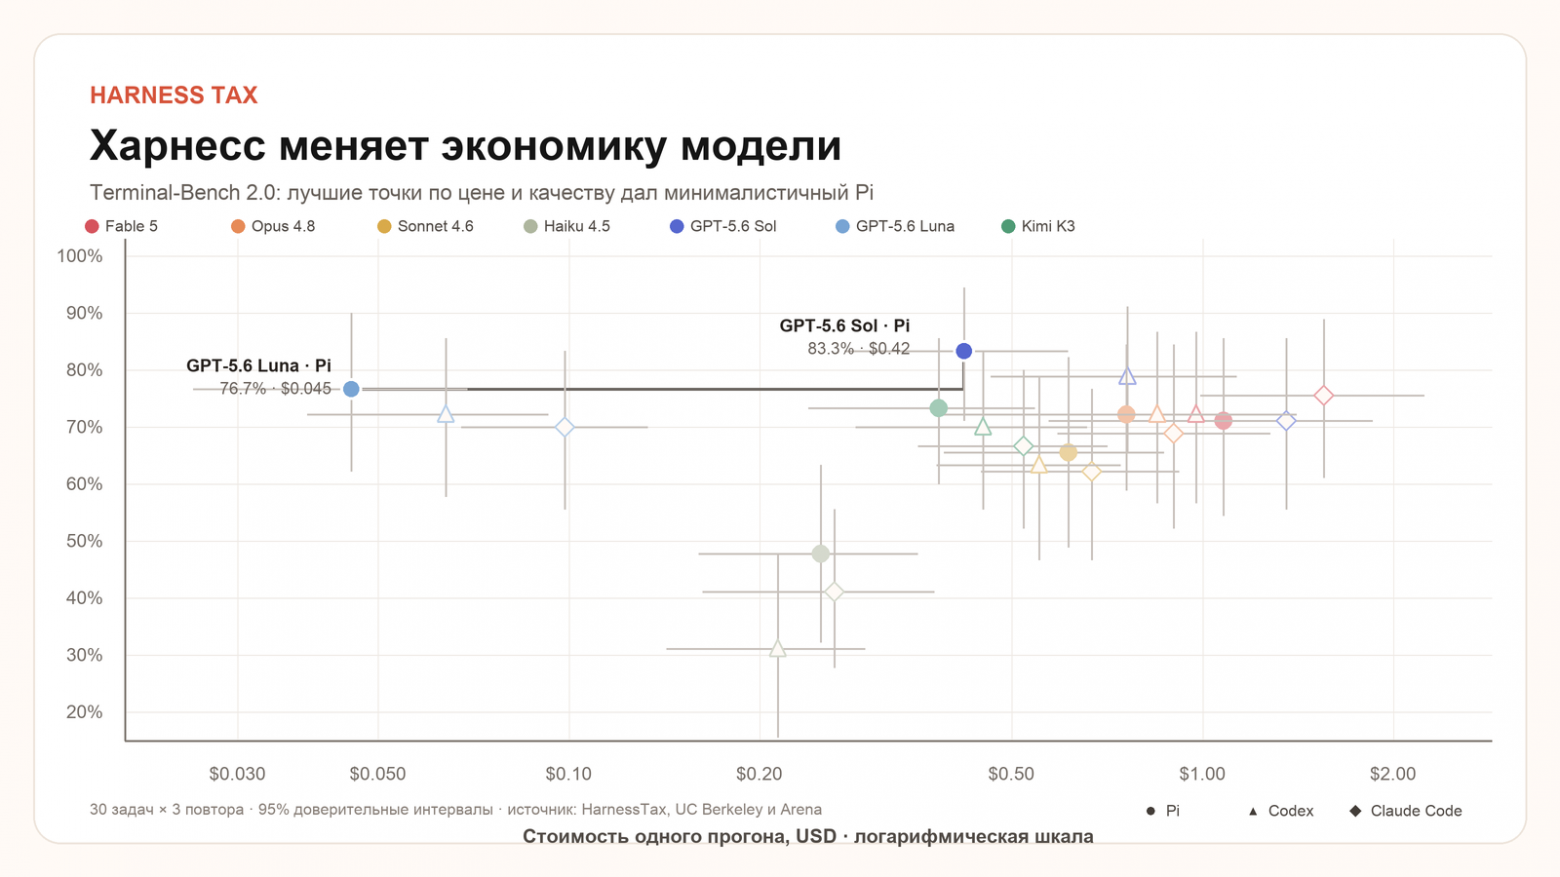
Pi предоставляет модели всего четыре инструмента: чтение, запись, редактирование и bash. Несмотря на минимализм, он попал на границу Парето по цене и успешности на обоих бенчмарках.
-
Это не означает, что четыре инструмента всегда лучше сорока.
-
Это означает, что каждый инструмент, правило и кусок контекста должен окупаться.
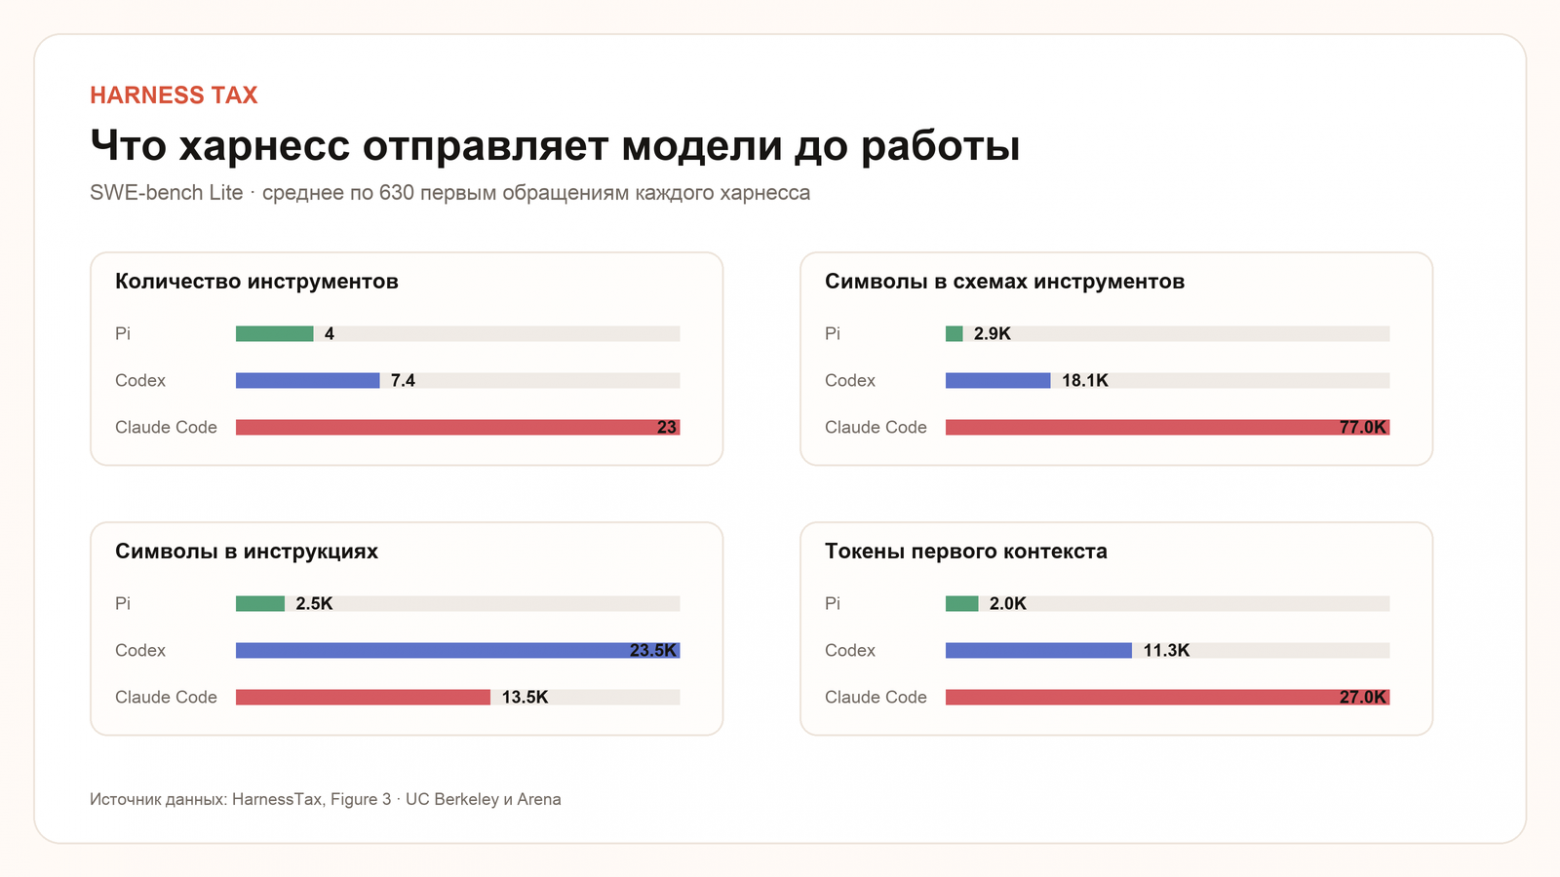
Хороший пример дала та же Fable 5. В Pi она выполняла задачу в среднем за 15,4 шага, в Claude Code за 15,3. Количество шагов почти совпало, но Claude Code оказался примерно вдвое дороже. Один из факторов виден уже в первом обращении к модели. Средний первый контекст содержал 1 972 токена у Pi, 11 308 у Codex и 27 011 у Claude Code. Разница между Pi и Claude Code достигла 13,7 раза. Схемы инструментов отличались ещё сильнее, 2 873 против 76 995 символов. Длинные инструкции и описания инструментов оплачиваются снова при следующих вызовах, если их не перекрывает кеширование.
Есть и ещё один неудобный результат. В девяти из двенадцати сравнений моделей Anthropic и OpenAI максимальную наблюдаемую успешность показал неродной харнесс поставщика. Например, GPT-5.6 Sol на Terminal-Bench 2.0 набрала 83,3% в Pi и 78,9% в Codex CLI. Попытка в Pi стоила $0,42 против $0,76 в Codex.
Сразу оговорюсь. Исследование использует только два публичных бенчмарка, которые могли попасть в обучающие данные. На каждый бенчмарк взяли 30 задач, поэтому доверительные интервалы широкие. Стоимость рассчитана по API-тарифам на 1 сентября 2026 года и не учитывает подписки. Кроме того, короткий и минималистичный харнесс может хорошо выглядеть на ограниченном прогоне, но уступить в длинной работе через несколько сессий. Итог исследования не в том, что Pi победил. А в том, что проверять нужно связку модели, харнесса и собственного типа задач.
Что это говорит о KodaCode
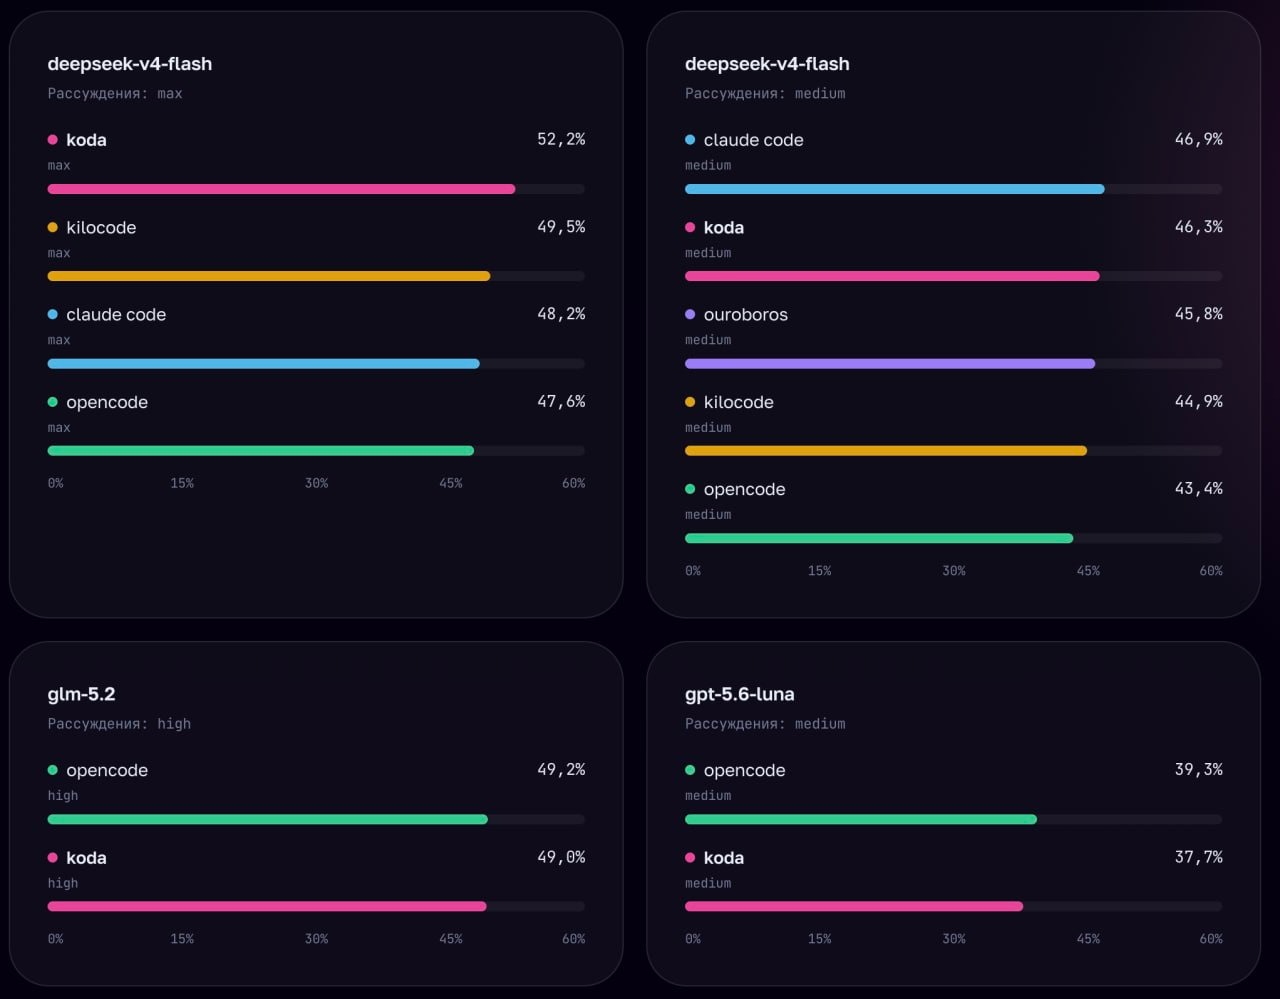
Для нас вывод HarnessTax особенно интересен, потому что мы независимо проверяли тот же принцип на другом наборе задач. В сравнении харнессов одна и та же DeepSeek V4 Flash Max с одинаковым уровнем рассуждений набрала 52,2% в Koda, 49,5% в KiloCode, 48,2% в Claude Code и 47,6% в OpenCode.
В отдельном сравнении моделей внутри Koda новая Koda Pro получила 54,3%, а Koda Base 49,5% при средней расчётной стоимости около 11,9 рубля за задачу. Эти цифры уже не изолируют вклад харнесса, зато показывают правильную единицу измерения. Это в первую очередь качество и цена всей агентной траектории, а не тариф за миллион токенов.
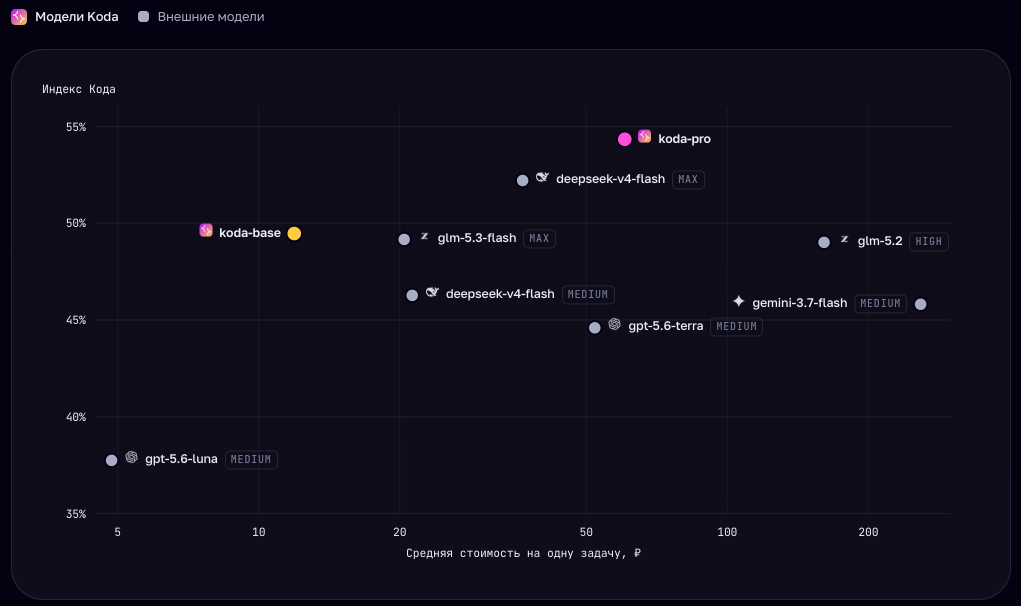
И да, я не провожу сравнение напрямую с HarnessTax. Конечно же, наборы задач, модели и методики разные. Например, наш Индекс Кода включает 261 задачу. Среди них 125 исправлений в существующих репозиториях, 45 задач на проектирование и реализацию ПО и 91 задача по анализу данных. Агент работает в изолированной среде без сети, не видит скрытые тесты и не может подсмотреть исправление в истории Git. Сбой инфраструктуры или выход за лимит считается нерешённой задачей. Поэтому результаты показывают не универсальное лидерство Koda, а конкретный эффект харнесса на фиксированной модели и воспроизводимом прогоне.
Влияние харнесса рождается внутри агентного цикла. Он решает, какие инструкции и схемы инструментов отправить модели, сколько вывода терминала оставить в контексте, как передать ошибку, когда повторить попытку и когда остановиться. Для нас здесь важны две вещи: управляемый контекст и предсказуемый цикл «изменение, запуск, проверка». Именно они могут сократить лишние обращения и не дать длинной сессии утонуть в собственных логах. Но утверждать точную экономию без отдельного замера стоимости было бы нечестно.
Поэтому наш вывод совпадает с HarnessTax:
Оценивать нужно не модель и не харнесс по отдельности, а их связку. Важны принятые изменения, полный расход на траекторию и число попыток до рабочего результата.
Из этого следует и практичная гипотеза. Kodacode может оказаться дешевле другого клиента даже при работе с той же моделью. Не потому, что токены внутри неё стоят иначе, а потому, что харнесс способен отправлять меньше лишнего контекста, реже повторять неудачные действия и быстрее доводить изменение до проверки.
Наш прогон DeepSeek V4 Flash уже показывает разницу в качестве между оболочками. Чтобы доказать преимущество в цене, нужен отдельный одинаковый замер полных траекторий. Но после HarnessTax смотреть только на тариф модели уже точно недостаточно. Иногда дорогим оказывается не сам интеллект, а дорога, по которой его ведут к ответу.
Источники
Попробуйте Kodacode на своём проекте: скачать для IDE, CLI и Desktop. Анонсы обновлений, практические разборы и новости продукта в нашем Telegram‑канале.
Автор: befayer

