


Часть 1 – Начало проекта
С запуском Астры я тянула. Не потому, что не было времени. Просто знала, что стоит запустить и она утянет меня в бездну. Задаешь один вопрос, спрашиваешь, а это можно? И модель выдает такое, что уже не остановиться и часы на экране показывают полночь, а утром на работу. Поэтому я ждала. Еще хотела, чтобы в голове загорелась идея и любопытство, которые уже ничем не сдержать. Так что, когда в пятницу после обеда я почувствовала это, решила, пора. Ровно в пять захлопнула рабочий ноутбук, повернулась к домашнему Маку, справа поставила айпад с чатом GPT, слева – большой стакан воды. Дело предстояло не шуточное. Даже скажем так, сумасшедшее – решили программным путем достучаться до данных Евклида (Euclid) – нового телескопа, висящего в полутора миллионах километров от Земли в районе точки Лагранжа L2, пропустить его данные через новую модель GPT 6 – Astra Extra High и…
Вот это «и» было главным вопросом.
Ладно, если уж на чистоту, стучимся мы, конечно, не к самому телескопу, а к данным в таблицах, прохлаждающимся где-то на серверах. Но это не меняет сути.
Про Евклид я узнала недавно, вернее это была череда поломок в разных обсерваториях. Началось все год назад, когда полетел 3I/ATLAS, мне захотелось увидеть его самой в центре кадра с любительского телескопа, для чего пришлось разобраться и подключиться к онлайн обсерватории с доступом к роботизированным телескопам. Надо ли говорить, что на тот момент я даже не знала, как посчитать координаты для наблюдательной миссии.
Думала, что препятствия остановят меня на пол пути, как это обычно бывало ранее. Но нет, мой ИИ-ассистент, а на тот момент это был GPT 5, постоянно меня подбадривал, мол давай сегодня просто разберем файлы с телескопа и поймем, что в них, а уже завтра возьмемся за код для анализа. Можно сказать, не давал мне сдаться и через 2 месяца я сняла первый спектр кометы и пропустила его через собственный Python pipeline. А еще через несколько месяцев, когда межзвездный объект скрылся из виду, я задумалась – а что дальше? Может снять спектр интересной звезды? И в этот момент единственный в моей обсерватории спектрограф вышел из строя, а техподдержка написала, что починки ждать около месяца.
Я оглянулась по сторонам и пошла разбираться с алертами обсерватории Веры Рубин. Там как раз можно было каждую ночь через брокера забирать публичные данные на домашний компьютер и ловить астероиды, кометы и даже межзвездные. Под эту цель мы тоже построили свой Python pipeline. С той лишь разницей, что если в ноябре 2025 в нашей команде было двое: я и ChatGPT, то весной 2026 к нам присоединился агент Codex и дела пошли веселее. К июню пайплайн не просто был готов, а умел выуживать из миллионов непонятных сигналов быстродвижущиеся объекты Солнечной системы по скорости, магнитуде, морфологии и общему «кометному» скору.
Когда 30 июня 2026 обсерватория объявила об официальном запуске основного окна наблюдений, я забросила свою сеть на крупную рыбу и стала ждать. И…через 2 недели 14 июля в районе обсерватории начался сильнейший за 50 лет снежный шторм. Его последствия разрушили дороги и часть инфраструктуры так, что до сих пор обсерватория не восстановилась. Я ждала несколько недель, читая сводки новостей от директора обсерватории, но фразы были неутешительные: к августу добрались до вершины и запустили генераторы, в сентябре ждали вендоров по оборудованию, но так и не запустили телескоп. То есть работа шла, но конца ее не было видно, и я снова стала смотреть по сторонам.
В одном из роликов услышала от астрофизика Бориса Штерна про Евклид и его публично доступные данные. А это уже был другой размер. Это тоже big data, но другого порядка. У Рубин ты получаешь миллион алертов за ночь, но почти все фильтруешь за ненадобностью. У Евклид – миллионы галактик, но что с ними делать?
Проблема еще в том, что между фразой «данные с телескопа публичны и всем доступны» и реальным использованием лежит пропасть и мостик никто не перекинул. Его надо строить самим.
Поэтому потыкавшись по научным вэб интерфейсам и два раза получив ошибку 500 Internal Server Error, я задала Гроку простой вопрос: как получить доступ к данным Евклид, если я не ученый и не студент астрофизик? Он тут же все разжевал и отправил в сторону API и библиотеки astroquery.esa.euclid. Его ответ я отдала моему ИИ-ассистенту, это уже был ChatGPT 5.6 Sol Medium, а иногда High. Обсудив и обрисовав архитектуру проекта, и понимая, что мы хотим извлечь на первом шаге, начали готовить запуск ИИ-агента Codex с использованием модели Astra Extra High.
Часть 2 – Запуск Астры
Главная проблема была в том, что в отличии от Рубин у нас не было понимания о структуре данных Евклид. То есть на Рубин алерты мы потратили 4 месяца и шаг за шагом разобрались с данными: таблицы, фильтры, поля, расшифровка значений. Но на это ушло время, и оно было болезненным. Я имею в виду, что, когда погружаешься в большие данные почти не реально удерживать их структуру в голове. Нужно либо постоянно смотреть в документацию, либо каждый раз разбираться заново, а это создает лишние ошибки и строит неверные допущения. Я сначала очень рассчитывала на модель, думала «она же все помнит». Но столкнулась с постоянной потерей контекста и изменения практики написания кода.
Я не хотела проходить через это второй раз. Поэтому на совместном с ИИ совете решили, что распределение ролей будет теперь жестким и у каждого своя зона ответственности:
-
Chat GPT — обсуждение проекта и проверка решений. Мы обсуждаем научную задачу, результаты работы агента и документацию, сопоставляем их между собой и ищем, что стоит проверить. Это наш «разговор двух инженеров», из которого рождаются идеи, вопросы и проверки. Диалог идет на русском языке и это критично – родной язык мгновенно упрощает разговор и понимание мною сложной темы, а также вариативность решений.
-
Codex + Astra — разработка и анализ данных. Агент полностью владеет технической частью проекта: структурой, кодом, запросами к Евклид, обработкой данных, визуализациями, исправлением ошибок. Проект практически полностью agent-driven: я не правлю код вручную, если я вижу ошибку, агент должен ее исправить. Промпты агенту пишутся на английском, чтобы снизить шанс потери смысла при переводе научных терминов и самих данных. При этом я надиктовываю основную идею промпта на русском, а GPT возвращает отредактированный промпт на английском и после проверки я его отдаю агенту.
-
С меня постановка задачи и научный смысл. Я определяю, какой вопрос мы пытаемся задать данным и что означает полученный результат. AI может безошибочно написать код и получить красивый график, но моя ответственность – понять отвечает ли выполненный анализ на мой научный вопрос.
Поэтому, когда в Codex CLI я набрала /model и выбрала ChatGPT 6 – Astra Extra High и запустила первый промпт, меня бросило в жар от волнения. Мы, конечно, посмеялись, что сейчас нам Астра в один заход раскроет главную загадку Вселенной, но на деле, пошуршав мозгами, она нам быстренько выдала, что у нас осталось 25% лимита токенов на пятичасовое окно. Но все-таки модель успела достроить первую версию пайплайна и даже успешно запустила его в JupyterLab.
На этом этапе моя цель была «пощупать» Вселенную, и первая задача для Астры была простая:
-
Подсоединиться к данным Евклида (релиз Q1)
-
Сделать анализ структуры данных
-
Взять для примера один объект – галактику
-
Вытащить ее спектр и красное смещение – redshift (z)
-
Резюмировать задачу таблицей с данными по галактике и объяснить, что находится в данных Евклид, и на основании чего считается z.
-
А затем по данному z вытащить сначала все галактики, а затем из них те, у которых самый яркий и надежный маркер активного звездообразования – линия водорода-альфа (H-alpha).
-
И под все это, конечно, написать код на Python, построив пайплайн с вводом данных под задачи пользователя с визуализацией результатов.
То есть объем, на который без агента у меня ушло бы 2 месяца. Астра справилась за 20 минут и когда я открыла вереницу ячеек, я ахнула. Из холодной темноты Вселенной на меня смотрели 21 тысяча галактик, удаляющихся от нас с показателем красного смещения z=1.27.
Но главное было не это.
216 из них прошли наши строжайшие фильтры по силе и надежности сигнала водорода-альфа. Свет этой линии шел к нам около девяти миллиардов лет и теперь светился яркими оранжевыми точками на экране моего компьютера.
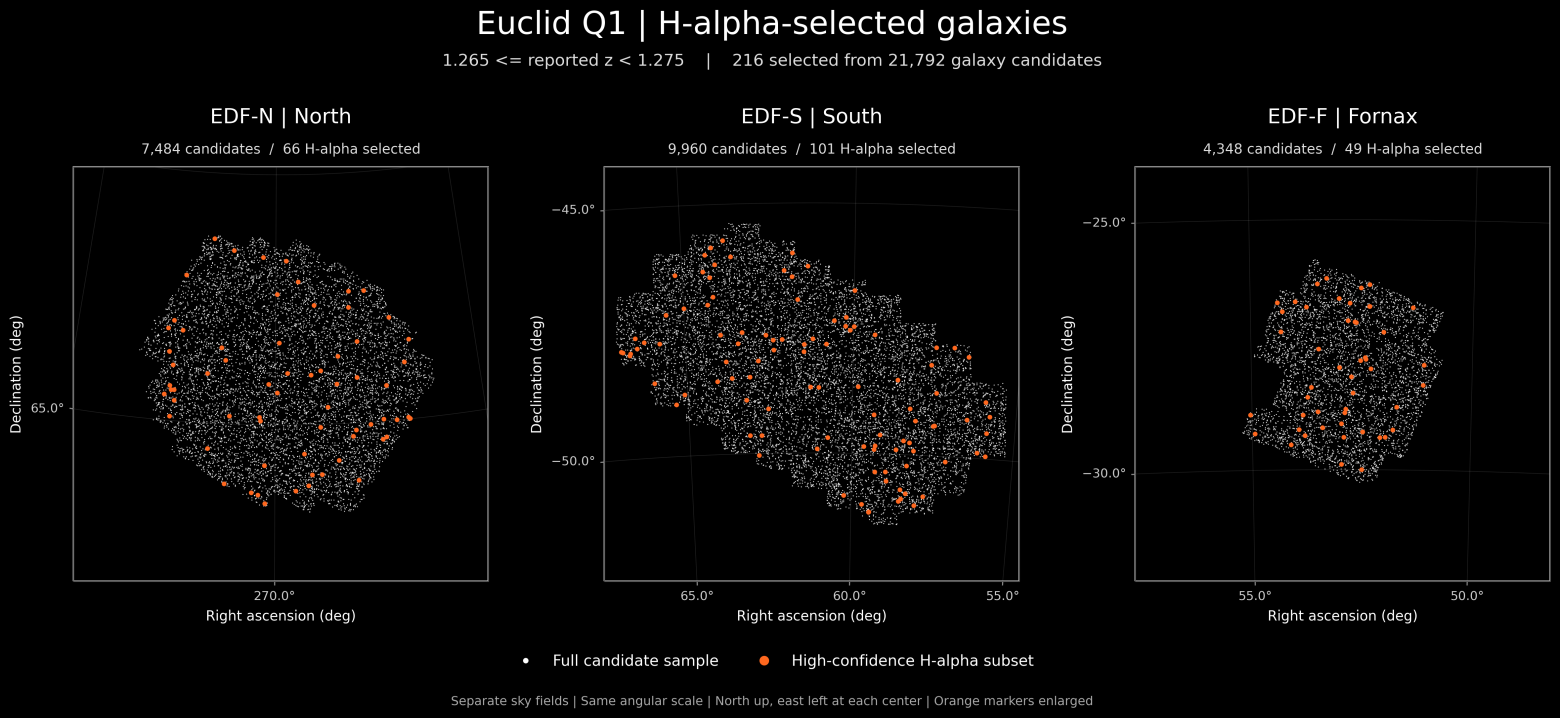
Астра дала пояснения к изображению на экране, сообщив что на карте три огромных скопления точек – это три независимых поля наблюдений Евклид и предупредила: форма этих «островов» определяется прежде всего геометрией обзора, а не устройством Вселенной. А то, что выборка из 216 галактик (оранжевые точки поверх серых) почти повторила форму основной выборки, Astra снова уточнила: прежде чем делать физические выводы, надо учитывать разную площадь полей, полноту данных и качество спектров.
Но если честно, меня поразило другое. Меня поразил масштаб времени. Людям понадобилось 16 лет, чтобы Евклид прошел путь от проекта до космического телескопа и начал присылать научные данные. Модели искусственного интеллекта понадобилось около 20 минут, чтобы разобраться в структуре этих данных, построить работающий пайплайн и выдать мне первый результат. Это уже трудно назвать просто ускорением. Это какой-то варп-двигатель в научной работе.
Часть 3 – Водород-альфа: научное открытие или красивый призрак?
В этот момент я чувствовала себя героем рассказа Кита Лаумера «Свойство материи», который я совершенно случайно слушала за несколько недель до нашего эксперимента. Там два пилота испытывают космический корабль с новейшим сверхсветовым двигателем. Первый невероятный прыжок удается и тогда возникает совершенно человеческая мысль: а что будет, если дернуть рычаг еще раз?
Мы тоже дернули. Только вместо выхода за пределы пространства-времени вылетели за спектральный диапазон, в котором телескоп Евклид мог показать нам линию водорода-альфа смещенную в красную зону спектра. А дело вот в чем.
У галактик есть свой маркер активного звездообразования — водород-альфа. Так же как у людей есть демография и мы строим график, по провалам или пикам которого косвенно можно сделать вывод о глобальных событиях. Так и у галактик: например, столкнулись две галактики, газ сжался и началось интенсивное рождение новых звезд — и яркая линия водорода-альфа буквально кричит об этом в спектре. Конечно, сама по себе Hα не всегда означает именно звездообразование: ее могут усиливать, например, активное ядро галактики или ударные волны. Но как маркер недавнего звездообразования она широко используется в астрономии.
Ученые, конечно, давно знают о таких процессах. Но что, если померить этот маркер на стреле времени у миллионов галактик — какая там «демография» на протяжении большого периода жизни Вселенной? Именно такой научный вопрос мы задали. А фильтр по красному смещению — это и есть наша машина времени. Он позволяет отрезать тонкий временной «блинчик» и выбрать галактики этой эпохи.
Иными словами, я хочу померить долю галактик с интенсивным звездообразованием через маркер линии водорода-альфа в разных временных эпохах, которые определяются по красному смещению и сравнить эти доли – построить график этой динамики.
Так что, воодушевившись первым результатом с красным смещением z=1.27 мы решили прыгнуть еще больше назад по стреле времени, и поставили фильтр отбора галактик на красное смещение z=1.8, а это значит свет шел к нам около 10 миллиардов лет.
Чтобы экономить токены модель прикрутили до Sol, главную задачу Astra выполнила, теперь пошла статистика. Мы вывели данные по двум наборам: галактики с z= 1.27 и галактики с z=1.8.
Данные были похожи, будто Вселенная смеялась над нами: «Ну и что, что вы тут надеетесь увидеть? На больших масштабах я очень однородна». Несмотря на то, что после фильтров выборка уменьшилась в 100 раз, распределение галактик с яркой линией водорода-альфа повторяло геометрию полной выборки. Это все равно что в трех удаленных точках Мирового океана зачерпнуть по чайной ложке воды и удивиться, что процент соли почти одинаков.
Но было и нечто необычное.
Если при красном смещении z=1.27 число галактик с сильным и надежным сигналом водорода-альфа было около 1% от общего числа, то в чуть более раннее время Вселенной, у галактик с z=1.8, этот показатель был почти в два раза выше! Ого, а почему? Нужны были еще точки на стреле времени, и мы прыгнули ближе к нашему времени, поставив z=1.0. Вернее, мы сначала «крутанули ручку» на 0.5, но случился казус – исчезли до нуля галактики, прошедшие наш фильтр водорода-альфа. Стали разбираться и выяснили, у телескопа Евклид инфракрасный спектрограф уверенно видит линии примерно между 1250 нм и 1850 нм. Лабораторное значение водорода-альфа Hα = 656.3 нм, при z = 0.5 → смещается примерно на 984 нм, а это вне диапазона инфракрасного спектрографа Евклида!
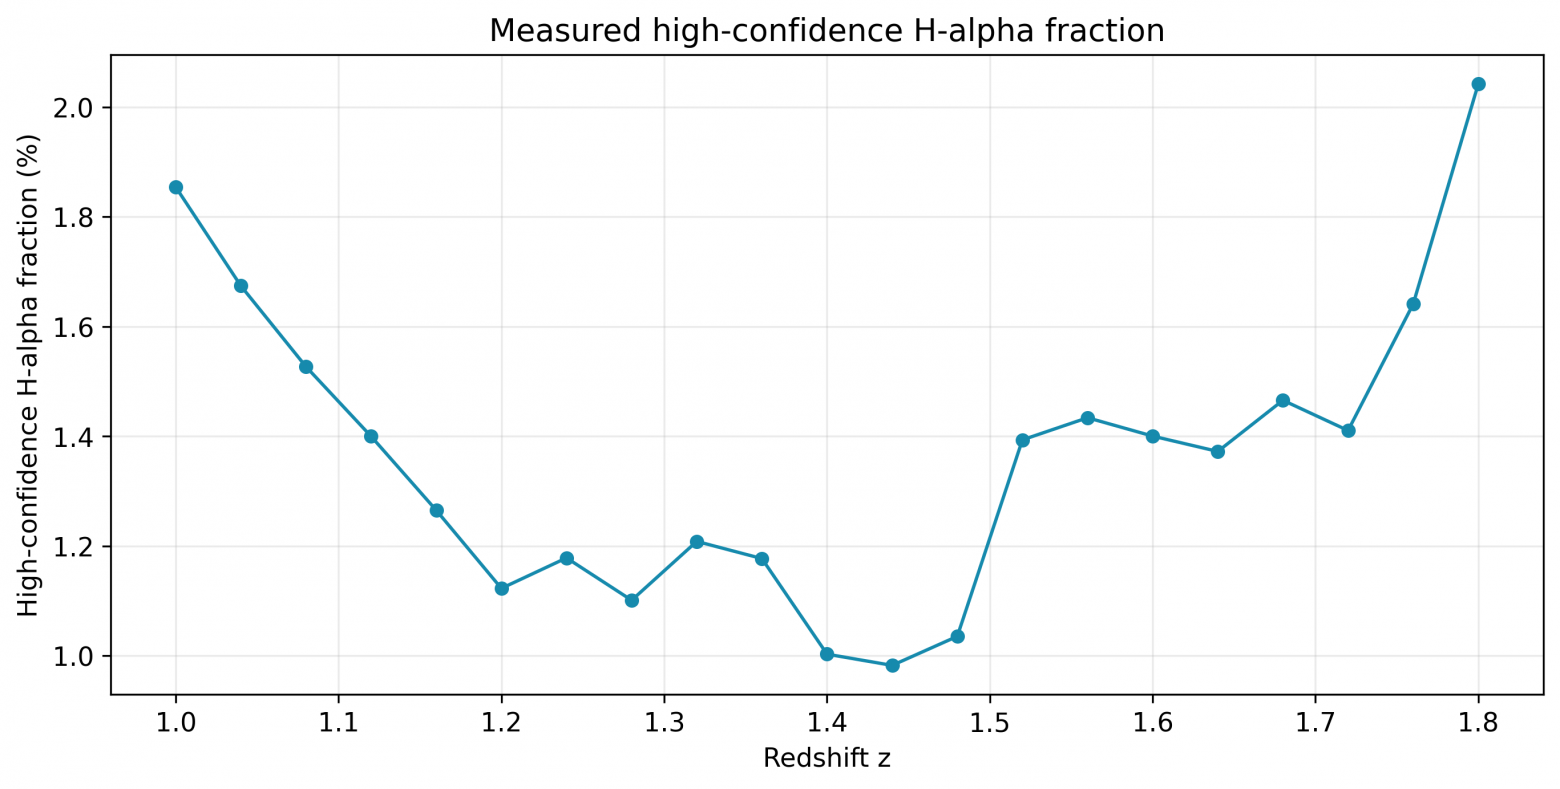
Поэтому пришлось сдать назад, добавить другие валидные точки на стреле времени и построить график, который показал странную картину: доля галактик, прошедших один и тот же строгий Hα-отбор, сначала заметно проваливалась, а затем снова росла по мере движения к более ранней Вселенной.
Я попросила ИИ сверится с научными источниками и получила потрясающую новость. Оказалось, что популяция Hα-излучающих галактик действительно меняется в зависимости от того, на какую эпоху жизни Вселенной мы смотрим и это является предметом научных исследований. Но у нас было одно «но». На нашем графике это не был однородный рост эмиссии по мере уменьшения возраста Вселенной. Это была скорее чаша, а при увеличении шага и построения графика из 21 временной эпохи и вовсе «призрак, летящий на крыльях ночи», при чем с удивительной симметрией на огромном массиве данных: в расчете участвовали 401874 галактик и из них 5402 с яркой линией водорода-альфа:
Мы снова посмеялись и сделали предположение что может этот призрак – материнская гравитационная волна, повлиявшая на плотность материи и тем самым на параметры звездообразования? Но мой ИИ-ассистент сразу одернул меня, ты что, говорит, нельзя перескакивать через целые разделы физики с такими выводами. Так что, мы добавили призраку-графику улыбку, вернулись к данным и посмотрели на них уже серьезно.
Посмотреть на призрака с улыбкой
Часть 4 – Достучаться до небес: как сравнить галактики разных эпох?
Я не сомневалась в данных Евклид: настройки телескопа, сырые данные, астрономический пайплайн, который создает из данных калиброванные научные продукты – все это разработано большой наукой и доступно для анализа. Даже в моем ИИ-агенте я не сомневалась, хотя ручные точечные проверки после него делала. Я сомневалась в собственном подходе: корректно ли выбрать все галактики одной эпохи через красное смещение и считать, что Евклид показал мне «все, что есть в космосе» на этом расстоянии? Нет, конечно, ведь чем дальше от нас, тем слабее свет, а значит и чувствительность телескопа. Тогда как делать выборку? ИИ подсказывал – через ограничение по светимости или массе галактик. Но я колебалась, не могла мысленно согласиться с допущением, что мой подход может изначально брать не совсем корректные данные для расчета.
Поэтому снова, посовещавшись внутри нашей маленькой команды, было принято решение обратиться за консультацией, и мы задали вопрос астрофизику Борису Штерну и заодно запустили исследование по научным работам.
В итоге сначала оказалось, что наш временной «блинчик» нужно подрезать по массе, чтобы на разных расстояниях сравнивать сопоставимые по массе выборки галактик. Но затем выяснилось, что этого мало: его нужно подрезать еще и со стороны спектроскопии — убедиться, что на разных красных смещениях в выборку с измеренным redshift попадает сопоставимая доля таких галактик.
Мы поставили Астре новую задачу, и она начала анализировать данные Евклид под новый подход и через несколько минут вернулась к нам с неутешительными новостями. Массы галактик в данных есть, но не получается найти обоснованное решение, как отобрать сопоставимые по массе выборки галактик для разных эпох и при этом учесть, что Евклид получает надежные спектры не для всех галактик одинаково хорошо.
Мы уперлись в методологию, и я написала письмо на команду Евклид с одним простым вопросом: можно ли вообще корректно сделать наш расчет на текущем релизе или надо ждать новый релиз (Data Release 1 Foundation) в ноябре 2026? Через несколько минут мне пришел автоматический ответ с номером тикета в Jira на дашборде команды Евклид.
Довольная, я захлопнула ноутбук и поехала кататься на велосипеде.
И финальное. Smoke-тест Евклида на кислородном дублете
И вот еду я и думаю: а зачем мы вообще привязались к красному смещению и водороду-альфа? У нас что, других задач нет?
К примеру, Вера Рубин, работая с данными лишь одной галактики Андромеды, обнаружила, что звезды на ее окраинах движутся гораздо быстрее, чем следовало ожидать исходя из распределения видимой массы. Это стало одним из ключевых шагов в истории темной материи — гипотезы о невидимом веществе, образующем массивное гало вокруг галактики и объясняющем такое движение звезд.
А что нам мешает пощупать темную материю? У нас полмиллиона галактик лежит в таблицах Евклид – бери и считай.
Утром следующего дня Астра получила новое задание и снова вернула меня с небес на землю сказав, что и в этот раз данных Евклида не хватит для полноценного эксперимента. При этом, чувствуя мое упадническое настроение, модель предложила компромисс: «есть, говорит, один простой и чистый эксперимент, который позволит проверить выбранные спектры Евклида, а значит и в целом будет больше уверенности в том, что мы верно анализируем данные телескопа».
И мы нашли в отобранных спектрах кислородный дублет – две линии кислорода – и посчитали отношение интенсивностей (яркости) этих линий. Величина этого отношения хорошо известна из атомной физики. Поэтому такой расчет – это как smoke-тест для спектра далекой галактики и заодно локальная проверка данных Евклида.
Идея красивая и интересная, но она сама тянет на отдельную статью, тем более мы «раскладываем пасьянс» для уверенности, вернее пользуемся методом Монте-Карло. Поэтому я постараюсь кратко рассказать суть, а если кто-то захочет повторить – пайплайн по ссылке ниже.
В ионизированном газе далекой галактики, например в областях звездообразования вокруг горячих молодых звезд, атомы кислорода могут потерять два электрона. Такой кислород называется дважды ионизированным и обозначается O III. Столкновение со свободным электроном может перевести один из оставшихся электронов O III на более высокий энергетический уровень — ион становится возбужденным. Возвращаясь из этого возбужденного состояния, он может испустить фотон на длине волны 500.7 нанометров или совершить другой переход с испусканием фотона на длине волны 495.9 нанометров.
Обе эти линии возникают из одного и того же верхнего энергетического уровня, но вероятности двух переходов различаются. Из атомной физики следует, что отношение интенсивностей линий [O III] 5007/4959 должно быть около 2.98.
Соответственно, когда Евклид снимает спектр галактики, эти две линии дают на спектре два пика. Но сравниваем мы не просто их высоту, а измеренный поток в каждой линии — фактически площадь под соответствующим пиком. Если отношение потоков получается близким к 2.98 в пределах погрешности, спектр проходит такой локальный smoke-тест. Если же отношение сильно отличается, надо разбираться, что произошло: причиной могут быть шум, особенности подгонки линий, загрязнение соседними источниками, насыщение или неверная калибровка.
А вот здесь нам и пригодился метод Монте-Карло: не для получения самого значения 2.98, а для оценки неопределенности нашего измерения на реальном шумном спектре.
А дальше по шагам:
-
Берем галактику по object_id, смотрим ее спектр — два пика кислорода есть в ожидаемых положениях с учетом красного смещения — done
-
Считаем интенсивность обеих линий — done
-
Находим их отношение и сверяем с предсказанным физикой — done
Теоретическое значение равно 2.98, а моя отобранная галактика дала 3.07 ± 0.37.
Ниже ее спектр и визуализация решения от Астры.

На спектре выше два пика кислорода (подсвечены зеленым) — они в районе 1300 нм из-за красного смещения z=1.6.

Здесь маленькое изображение галактики — оно настоящее, таким ее видел телескоп. И график с визуализацией от Астры с площадью пиков кислорода для расчета коэффициента.
Все, эксперимент удался, можно было выдыхать, и я подумала: «каждый раз, когда я работаю с научными данными, я начинаю как астроном-любитель, а заканчиваю как QA software engineer – хотели пощупать Вселенную, а осилили лишь ее smoke-тест».
Но это не худший сценарий, теперь данные нам понятны, и мы попробуем новый эксперимент на ноябрьском релизе.
Оставайтесь на связи, будет интересно.
Выводы и наблюдения:
-
Сильная reasoning-модель + документация + ИИ-агент действительно способны очень быстро построить технически работающий исследовательский пайплайн, но это еще не означает, что они автоматически построят правильную научную абстракцию задачи. Самое опасное здесь как раз то, что результат выглядит убедительно: код работает, цифры воспроизводятся, статистика огромная, график красивый. Но главный вопрос остается открыт: а корректен ли сам эксперимент?
-
Доступ к ИИ дал невероятное ускорение и почти бесконечный спектр задач, которые один человек или маленькая команда теперь могут решить. Но и размер контента вырос чудовищно. Это не просто еще один документ, это как зайти в библиотеку и остаться в ней жить. Это требует не просто перестройки «процесса разработки» — это требует перестроить свою жизнь вокруг ИИ.
-
И мое любимое – если модель понимает задачу и имеет необходимые доступы, создание продукта или научное исследование превращается не в «работу в новых условиях», в новое удовольствие от жизни с ощущением, что людям выдали сверхспособности. И это удивительный побочный эффект от внедрения ИИ.
Ссылки:
GitHub. По ссылке лежит Python pipeline с расчетом кислородного дублета. Можно его забрать к себе на компьютер, предварительно установив JupyterLab и необходимые библиотеки, попробовать подсоединиться к данным телескопа и поиграть с ними.
Redshift. Подробно о красном смещении и как оно измеряется на примере спектра квазара 3C 273.
Автор: Dorial

