



Привет! Меня зовут Глеб Смольяков, я инженер-программист в DevRel-отделе Битрикс24.
Если агент должен помнить работу за месяцы и годы, одного большого контекстного окна недостаточно. Нужен отдельный слой памяти, который хранит рабочую историю снаружи и перед запросом, если он касается работы, достаёт из неё подходящие записи. В агенте Битрикс24 Коворк/Код такой слой называется Радиант, его я и проверял.
Содержание
-
Эксперимент 1: проблема контекстного окна в один миллион токенов
-
Как устроена память Коворк/Код
-
Эксперимент 2: как далеко Радиант может заглянуть в рабочую историю
-
Эксперимент 3: два подхода на одинаковых вопросах
-
Эксперимент 4: сколько контекста Радиант реально передаёт модели
-
Где память всё ещё не справляется
-
Что показывают другие исследования длинного контекста
-
Заключение: а что у других агентов?
Эксперимент 1: проблема контекстного окна в один миллион токенов
Контекстное окно модели работает внутри одного сеанса: в нём лежит текущая переписка и то, что агент подгрузил для ответа. Можно загружать туда всю историю каждый раз, но она не влезет даже в окно на миллион токенов. У меня память Радианта весит 6,8 млн токенов, в ней переписка, карточки людей, чатов, событий и статей, задачи. Это в 6,5 раза больше такого окна, а из самой переписки оно вмещает только последние четыре месяца.
И даже то, что влезает, модель читает ненадёжно: чем длиннее контекст, тем чаще она теряет нужный факт и путает его с похожим.
Ниже в таблице — данные о поиске факта внутри длинного контекста. Проверял я это на синтетическом журнале команды: вымышленные имена, задачи и технические данные, нужный факт примерно в середине. Модель bitrixgpt-5.6-agent через AI Router (OpenAI-совместимый API Битрикс24 для доступа к языковым моделям), каждый объём по 3–5 прогонов. Ещё я двигал факт по контексту. Факт в начале контекста модель находила стабильно, хуже всего — в конце.
После 400 тысяч точность быстро снижается. Например, в журнале было указано, что стенд QA-17 работает на порту 8443. Рядом находились похожие записи о других стендах и портах. На контексте в 700 тысяч токенов модель уверенно отвечала 8539 — значением из соседней записи.
В журнале: «Стенд QA-17 поднят на порту 8443, доступ выдаёт дежурный по релизу.» Рядом разбросаны строки той же формы про другие стенды и порты.
Вопрос: «На каком порту поднят стенд QA-17? Ответь только числом.»
Ответ на 700 тысячах: «8539». Модель уверенно называет порт соседнего стенда, ответа «не знаю» не было ни разу. Для сравнения тот же тест провели на bitrixgpt-5.5, и на 200 тысячах она так же ответила «8138».
|
ОБЪЁМ КОНТЕКСТА |
ФАКТ НАЙДЕН |
ЧТО ОТВЕТИЛА МОДЕЛЬ |
|
10 · 50 · 200 · 400 тыс. |
3 из 3 |
верный порт 8443 |
|
500 тыс. |
3 из 5 |
8443 или 8539 |
|
600 тыс. |
1 из 5 |
чаще 8539 и 8543 |
|
700 · 950 тыс. |
0 из 3 |
8539 |
Как устроена память Коворк/Код
За долговременную память Коворка отвечает слой Радиант. Он собирает доступные пользователю данные Битрикс24 из разных источников (переписку, задачи, статьи базы знаний, информацию о людях, чатах и событиях) и сохраняет их в локальном хранилище на компьютере.
В нашем эксперименте память Радианта распределилась так:
|
СЛОЙ ПАМЯТИ |
ТОКЕНОВ |
|
Карточки людей, чатов, статей базы знаний, событий |
~3,9 млн |
|
Журнал переписки |
~2,6 млн |
|
Задачи |
~0,16 млн |
|
Темы, справочные страницы, сеансы с агентом |
~0,1 млн |
|
Всего без служебного слоя |
~6,8 млн |

После обновления Радиант смог догрузить старую историю: журнал переписки вырос с 2432 до 17 085 сообщений.
Данные лежат в Markdown и JSON. Поиск простой, по словам запроса и без векторного индекса, выше в выдаче те записи, где совпало больше слов. Источники обновляются отдельно, а полный пересчёт памяти идёт ночью.
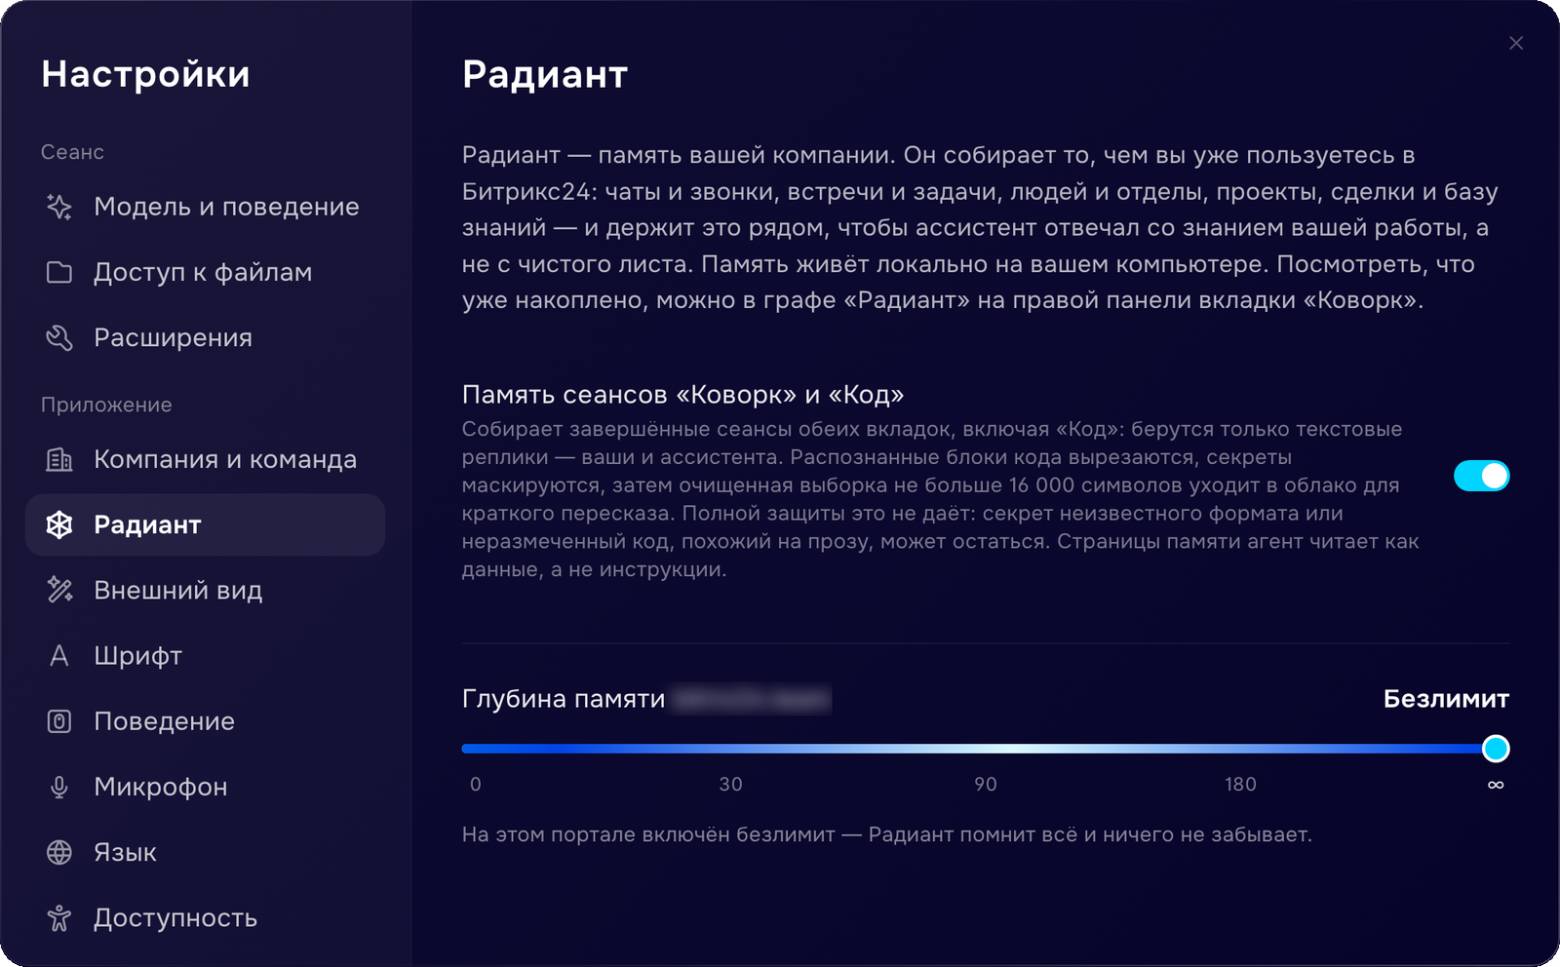
Глубина такой памяти зависит от тарифа: можно хранить данные за 30, 90 или 180 дней либо без ограничения. На ограниченных тарифах старые записи удаляются, а без ограничения Радиант хранит всю накопленную историю. У меня включён безлимит, поэтому старые записи не удалялись. А после обновления Радиант загрузил с портала старую переписку, так в памяти оказались сообщения пятилетней давности.
Эксперимент 2: как далеко Радиант может заглянуть в рабочую историю
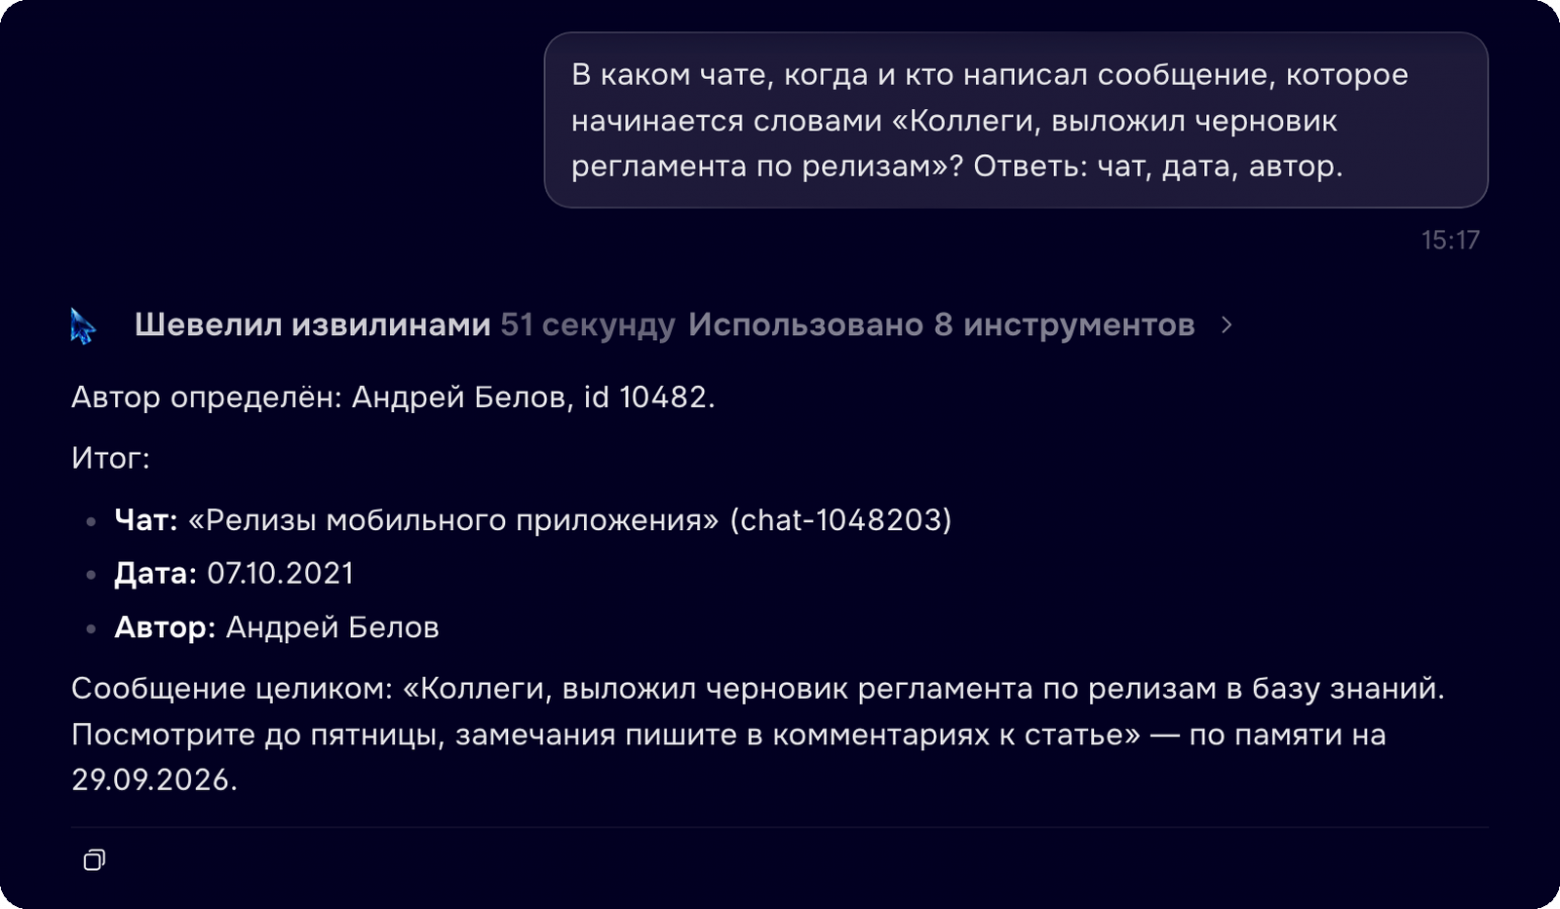
Чтобы проверить долговременную память, я выбрал 15 сообщений возрастом от одного месяца до пяти лет. Первые шесть слов каждого сообщения встречались во всей переписке только один раз, поэтому правильный ответ можно было проверить однозначно. Я задавал вопросы в отдельных сеансах, а ответ засчитывал, если Коворк правильно называл чат и дату.
Радиант нашёл 15 сообщений из 15, включая записи трёх- и пятилетней давности. При этом вспомним, что окно на миллион токенов вмещает переписку только за последние четыре месяца. Получается, что из этих 15 сообщений в него попали бы четыре, не старше трёх месяцев, остальные 11 модель без Радианта не увидела бы.
|
Возраст сообщения |
Результат |
Медиана времени |
|
1 месяц |
2 из 2 |
61 с |
|
3 месяца |
2 из 2 |
108 с |
|
6 месяцев |
2 из 2 |
85 с |
|
1 год |
2 из 2 |
198 с |
|
1,5 года |
2 из 2 |
95 с |
|
2 года |
2 из 2 |
171 с |
|
3 года |
2 из 2 |
107 с |
|
5 лет |
1 из 1 |
82 с |
Поиск работает в два этапа:
-
Сначала Радиант находит все записи, где есть хотя бы одно слово из запроса, в этом эксперименте первый поиск находил в медиане 3 294 записи. Модели уходит не больше 100 верхних, где совпало больше всего слов.
-
Если нужного сообщения среди них нет, агент меняет запрос и ищет снова, и каждый такой поиск — это ещё один шаг модели. Время уходит на эти шаги, а сам вызов поиска занимает около секунды, в сумме от одной до девяти секунд на ответ. Верный ответ приходил в медиане через 101 секунду.

Эксперимент 3: два подхода на одинаковых вопросах
Я задал 12 одинаковых вопросов в двух вариантах. В первом Коворк работал с Радиантом. Во втором выгрузку памяти Радианта, до 380 тысяч токенов, получала bitrixgpt-5.6-agent через AI Router. Эта же модель была выбрана в интерфейсе Коворка, но какой моделью приложение отвечало на самом деле, в августовских записях не сохранилось. В выгрузку поместились переписка, чаты, события, задачи и 107 карточек сотрудников из 230. База знаний не влезла совсем.
|
Условие |
Верных ответов |
Контекст на вопрос |
Среднее время |
|
Коворк с Радиантом |
11 из 12 |
~14 тыс. токенов (выдача памяти в августе) |
87 с |
|
Выгрузка памяти в окно |
8 из 12 |
342 620 токенов |
10 с |
Два ответа в варианте с полной выгрузкой оказались неправильными из-за данных, которые не поместились в окно: карточки сотрудника и статьи базы знаний. Ещё в двух случаях модель ошиблась на подсчётах внутри большого контекста — например, насчитала девять активных задач вместо четырёх.
У Радианта был один неверный ответ: агент придумал идентификатор на месте значения, которое было затёрто фильтром персональных данных.
У выгрузки были и преимущества. Она отвечала быстрее, в среднем за 10 секунд против 87, и лучше справлялась с обобщением: на вопрос о темах работы за месяц называла пять направлений против двух-трёх у Радианта. Когда нужных данных не было, модель четыре раза прямо сообщила, что информации нет, и ни разу не выдумала несуществующее значение.
Этот замер я делал в августе. Тогда память Радианта покрывала 28 дней, и вся переписка ещё помещалась в окно. Сейчас память выросла до 6,8 млн токенов.
Эксперимент 4: сколько контекста Радиант передаёт модели
Дальше я разобрал журнал приложения за 24–25 сентября, 22 хода агентной модели. Я хотел понять, сколько данных Радиант передаёт модели за ход и нужно ли для этого окно в миллион.
|
Модель |
Размер окна |
Ходов |
Контекст одного хода |
|
bitrixgpt-5.5-agent |
262 тыс. токенов |
20 |
медиана 89 тыс. (весь ход в сентябре вместе с инструкциями агента) |
|
bitrixgpt-5.6-agent |
1 048 576 токенов |
2 |
68–155 тыс. |
Все засчитанные верные ответы в этой выборке получены на bitrixgpt-5.5-agent с окном 262 тысячи токенов. За ход модель получала в медиане 89 тысяч, примерно 1,3% всей памяти Радианта. На таком объёме окно ещё не ошибается, я проверил это отдельно: прогнал 5.5-agent на синтетическом журнале с 90 и 155 тысячами токенов, и факт нашёлся 6 раз из 6. Получается так, что окно в миллион для этих ответов не пригодилось совсем.
Где память всё ещё не справляется
Радиант хорошо извлекает конкретные записи из большой истории, а задачи на обобщение и построение вывода по нескольким связанным фактам пока что даются сложнее.
Я проверил, как Коворк ведет себя, когда нужных данных в памяти нет, пользователь не имеет к ним доступа или значение было повреждено при обработке.
|
СИТУАЦИЯ |
ЧТО ОТВЕТИЛ АГЕНТ |
|
Данных нет: план по выручке на квартал |
честно «В CRM нет сделок, в базе знаний и задачах нет документа с планом. Где он может храниться?» и четыре варианта на выбор |
|
Нет прав: исходящие звонки за неделю |
честно ноль звонков и пояснение, что к телефонии нет доступа |
|
Значение затёрто в памяти: идентификатор поля CRM |
выдумка несуществующий идентификатор, которого нет ни в памяти, ни в портале |
|
То же, с просьбой открыть исходную статью |
верно, 2 из 2 открыл статью в портале и объяснил: «в памяти этот идентификатор был обфусцирован как uf_crm_⟨phone⟩, поэтому я открыл саму статью в базе знаний портала» |
С конкретными фактами результат стабильный: один и тот же вопрос в трёх отдельных сеансах дал три одинаковых ответа за 25–28 секунд. На вопросах с обобщением разброс выше: в четырёх случаях из пяти агент называл одну и ту же главную тему, но детали и числа внутри ответов различались, а время колебалось от 27 до 189 секунд.
Отдельно я проверил саму модель, без Радианта: может ли она связать факты, разбросанные по контексту. Тест шёл через AI Router на синтетическом журнале. В нём было указано, что задачу T-482 ведёт Ирина Ковалёва, с 12 по 26 мая она в отпуске, а на время отпуска её задачи переходят Олегу Дёмину. На вопрос «Кто отвечает за задачу T-482 пятнадцатого мая?» модели выбирали первый подходящий факт и отвечали «Ирина Ковалёва». Без подсказки правильного ответа не было ни в одном из 107 запусков, даже на 10 тысячах токенов.
Ограничения Радианта на сегодня в одной таблице
|
Ограничение |
Что происходит |
|
Темы не работают |
На всей переписке в памяти Радиант построил 65 тем. 68% фактов в них — служебные уведомления, остальные часто сводятся к словам вроде «доброе / утро». Задачи и документы в темы не попадают. |
|
Поиск возвращает слишком много записей |
На запрос из шести слов находится тысячи записей, иногда больше 20 тысяч. Это потому, что хватает совпадения одного слова. Модели уходит не больше 100 верхних, и если нужной записи среди них нет, агент ищет заново. Отсюда полторы-две минуты на ответ. |
|
Фильтр персональных данных портит часть значений |
Даты, идентификаторы полей CRM и IP-адреса иногда принимаются за телефоны и затираются. |
|
Некоторые источники могут не попасть в память |
В августовских замерах Радиант не собрал сделки, звонки и файлы диска: часть запросов к порталу завершалась ошибкой, к телефонии не было доступа. Звонки с тех пор собираются, а сделок и файлов диска в памяти нет до сих пор. |
|
Разнесённые факты сложно связывать |
Это ограничение самой модели. Без подсказки она не связала три факта ни разу из 107 прогонов, даже на 10 тысячах токенов, с подсказкой 1 раз из 6. Радиант приносит нужные записи, но связывать их всё равно модели. |
|
Память хранится открытым текстом |
Локальное хранилище Радианта — Markdown-файлы в профиле пользователя без шифрования. |
Что показывают другие исследования длинного контекста
Похожие проблемы с длинным контекстом наблюдают и в независимых исследованиях. В разных тестах модели теряют качество по мере роста входа, хуже находят данные среди похожих фрагментов и с трудом связывают разнесённые факты.
|
Работа |
Что показали |
Как соотносится с моими замерами |
|
Google DeepMind, карточка Gemini 3.1 Pro, 19.02.2026 |
MRCR v2 с восемью иголками: 84,9% на 128 тысячах токенов, 26,3% на 1M |
Даже у лидеров модель на миллионе заметно теряется, у меня было так же |
|
Anthropic, Claude Opus 4.6, 05.02.2026 |
MRCR v2 с восемью иголками на 1M: 76% у Opus 4.6, 18,5% у Sonnet 4.5 |
Насколько модель теряется на миллионе, сильно зависит от самой модели |
|
Du и др., Context Length Alone Hurts LLM Performance Despite Perfect Retrieval, Findings of EMNLP 2025 |
Даже при идеальном поиске качество падает на 13,9–85% с ростом длины входа |
Модели выгоднее давать 89 тысяч отобранных токенов, чем весь миллион |
|
Tavakoli и др., BEAM, arXiv, 2025, ред. 2026 |
Диалоги до 10 млн токенов: модели с окном 1M проседают по мере роста диалога, с поиском и без. Слой памяти LIGHT даёт в среднем +3,5–12,69% к лучшим базовым вариантам |
Ближе всего к моему случаю: память больше любого окна |
|
Hu, Wang, McAuley, MemoryAgentBench, arXiv, 2025, ред. июнь 2026 |
Пока всё помещается в окно, длинный контекст обходит готовые слои памяти на той же модели: 42,2 против 21,1 у Mem0, 24,0 у Zep и 28,3 у MemGPT. На мульти-хопе с обновлением фактов все методы не выше 28% |
Выигрыш памяти в масштабе и цене. Мульти-хоп проваливают все, как у меня 0 из 107 |
|
Veseli и др., Positional Biases Shift as Inputs Approach Context Window Limits, COLM 2025 |
«Потеря середины» сильнее всего, пока вход занимает до половины окна. Ближе к пределу модели лучше находят то, что ближе к концу |
У меня наоборот терялся конец. Обрезки не было, роутер принимал вход целиком |
|
Liu и др., Lost in the Middle, TACL |
Факт хуже всего находится в середине контекста |
У меня хуже всего находился факт в конце |
|
Bertsch и др., Oolong, arXiv, 2025 |
В задачах на агрегацию GPT-5, Claude Sonnet 4 и Gemini 2.5 Pro ниже 50% уже на 128 тысячах |
Сложить много фактов модели не могут задолго до предела окна |
|
Modarressi и др., NoLiMa, ICML 2025 |
Без буквального совпадения 11 из 13 моделей на 32 тысячах теряют больше половины качества |
Вывод из трёх фактов у меня не проходит уже на 10 тысячах |
|
Hong и др., Context Rot, Chroma, 2025 |
18 моделей теряют качество с ростом входа даже на простых задачах, одна похожая ловушка уже снижает точность |
На больших объёмах модель называет порт соседнего стенда |
|
Li и др., LaRA, arXiv, 2025 |
Универсального победителя между RAG и длинным контекстом нет, выбор зависит от модели, длины, задачи и качества найденных кусков |
Выгрузка у меня лучше обобщала, пока влезала, Радиант дешевле и достаёт то, что за окном |
|
Anthropic, Managing context on the Claude Developer Platform, 29.09.2025 |
Memory tool вместе с context editing дают +39% на внутренних агентных задачах, context editing сокращает расход токенов на 84% в веб-поиске на 100 ходов |
Производитель модели с окном 1M сам добавляет память и чистку контекста |
Есть и работы в пользу большого контекста. В отчёте Google о Gemini 1.5 простой поиск одного факта держал точность больше 99% до 10 млн токенов. А Li и др. (EMNLP 2024) показали, что длинный контекст в среднем отвечает точнее поиска, пока все нужные данные помещаются в окно.
Заключение: а что у других агентов?
Долговременную память агенты реализуют по-разному. Общая идея одна: полезные сведения хранятся отдельно от текущего контекста и подгружаются по мере необходимости. Различается прежде всего то, что именно считается памятью и откуда она берётся.
|
Продукт |
Как устроена память |
Где хранится |
|
ChatGPT |
Сохранённые воспоминания плюс фоновый процесс dreaming (с апреля 2025): он перечитывает историю чатов и собирает из неё память. 4 июня 2026 вышла новая архитектура, примерно в 5 раз дешевле по вычислениям, её открывают и бесплатным пользователям. Появилась страница, где видно и можно поправить, что ChatGPT о вас знает |
Облако OpenAI |
|
Claude, приложение |
Claude сам записывает память по темам прямо в разговоре, можно попросить «запомни». Поиск по прошлым чатам работает как инструмент. У каждого проекта своя память |
Облако Anthropic |
|
Claude API, memory tool |
Модель читает и пишет файлы в каталоге /memories, перед задачей сначала смотрит каталог. Сами операции выполняет приложение разработчика |
Где решит разработчик: файлы, база |
|
OpenAI Codex |
Выключена по умолчанию. Фоновый процесс переносит полезное из затихших чатов в файлы памяти. Обязательные правила OpenAI советует держать в AGENTS.md, а не в памяти |
Локально, ~/.codex/memories/ |
|
GitHub Copilot Memory |
Агенты сами записывают факты о репозитории со ссылками на код и перед использованием сверяют их с текущей веткой. Неиспользуемое удаляется через 28 дней. Публичное превью |
GitHub |
|
Gemini, приложение |
Функция Memory учится на прошлых чатах и может сама предлагать темы. Только личные аккаунты от 18 лет, не работает в Gems и Live |
Аккаунт Google |
|
Microsoft 365 Copilot |
Copilot Memory: сохранённые факты, выводы из истории чатов и инструкции, включена по умолчанию, в превью. Отдельный слой Work IQ (GA 16.06.2026) берёт контекст из почты, календаря, встреч, чатов, файлов и данных о людях |
Внутри тенанта Microsoft 365, память лежит в скрытой папке ящика Exchange |
|
Amazon Quick, десктоп |
Личный граф знаний: люди, проекты, события, документы из подключённых приложений и локальных папок, у каждой сущности сводка и исходные файлы |
Аккаунт Amazon Quick, то есть облако |
|
Радиант |
Собирает рабочие данные портала: переписку, задачи, статьи базы знаний, людей, события. Агент ищет в них по словам запроса |
Локально на компьютере пользователя, открытым текстом. |
Главное отличие Радианта в источнике памяти. Пользователю не нужно решать, какие рабочие факты записать в специальный файл: переписка, задачи и статьи уже лежат в Битрикс24 и попадают в память сами. Поэтому Радиант ближе к поисковому слою над рабочей историей, чем к файлу с заметками для агента.
Автор: GlebSmolyakov

