


За три недели два ИИ-агента и я собрали открытый архив моей семьи: 597 человек, 648 документов и снимков, записи с 1705 года. Из этого опыта выросли два открытых проекта: движок для семейных сайтов gene-archive и MCP-сервер genealogy-mcp, который учит любого ассистента искать предков, не выдумывая их.
В статье — как это было по шагам: от первого вопроса к модели до своего движка и MCP. И главное, чему пришлось научить агентов, чтобы им можно было верить.
1. Идея: отдать семейный архив агенту
Началось с папки семейных бумаг: свидетельства о рождении и браке, рукописная родословная, несколько снимков. 25 сентября я отдал сканы ИИ-агенту с одной просьбой: прочитай всё и разберись, кто есть кто.
Агент, а не чат — потому что генеалогия — это цепочки поисков. В свидетельстве названа деревня. Агент ищет её в справочнике населённых пунктов уезда, не находит, просматривает весь список на нужную букву и приходит к выводу, что такой деревни там нет. Потом находит её в другой губернии — с теми же фамилиями среди жителей. И сразу проверяет по военным базам: там находятся люди из этой деревни с нашими фамилиями. Всё это — в первый же день.
К концу первой недели стало понятно, что модель хорошо делает три вещи:
-
читает почерк и дореформенную орфографию в метрических книгах XIX века — неидеально, но быстрее любого человека;
-
проходит тысячи страниц: памятные книжки губерний, адрес-календари, описи архивов, неиндексированные сканы на FamilySearch;
-
связывает разрозненное: метрика, справочник кооперации и опубликованный дневник современницы складываются в биографию человека, о котором в семье знали одну строчку.
И так же быстро стало понятно, где она ошибается. Первое прочтение отчества одного прапрадеда было неверным, исправили его по трём другим метрикам. Однофамильцы соблазнительно ложатся в древо. Об этом — в разделе про уроки: именно там появились правила, которые потом ушли в движок и MCP.
Насколько глубоко: одиннадцать поколений
Самая длинная линия уходит на одиннадцать поколений вверх от моих дочерей — к крестьянину тульского села, который жил в середине XVIII века. Самая ранняя дата в архиве — около 1705 года: возраст женщины в ревизской сказке 1745 года. По другим ветвям архив доходит до 1730-х (тульские деревни), 1770-х (Бессарабия) и середины XIX века (духовенство, кавказские и кубанские роды).
Каждый пласт времени открывается своим видом документов:
|
Время |
Документы |
Где взяли |
Что дают |
|---|---|---|---|
|
1930–1950-е |
военные донесения, карточки военнопленных, списки репрессированных |
«Память народа», Национальный архив Финляндии, Arolsen, базы репрессий |
судьбы в войнах и арестах |
|
1914–1920 |
картотеки Первой мировой, анкеты эмигрантов |
gwar.mil.ru, эмигрантские справочники |
ранения, плен, пути эмиграции |
|
1860–1917 |
метрические книги, памятные книжки, адрес-календари, послужные списки |
FamilySearch, каталоги госархивов, полнотекстовый поиск archive.org, НЭБ |
рождения, браки, крёстные, служба и должности |
|
1811–1858 |
ревизские сказки, исповедные ведомости |
неиндексированные сканы FamilySearch, расшифровки краеведов |
дворы, состав семей, возраст |
|
1745–1795 |
ревизские сказки ранних ревизий |
неиндексированные сканы FamilySearch |
самый ранний пласт: имена и отчества семей села |
Глубже XIX века всё держится на ревизских сказках — переписях населения по дворам. Они не проиндексированы: это тысячи кадров рукописи XVIII века в каталоге FamilySearch, разложенные по уездам и годам. Агент находит нужную плёнку по описи, качает кадры целиком и листает их до нужного села. Потом идёт от ревизии к ревизии: 1858 → 1850 → 1834 → 1816 → 1811 → 1782 → 1745, сверяя имена, отчества и возраст. Человеку такая работа обходится неделями в читальном зале, агенту — вечером, пока сервер не ответит ошибкой 429.
И здесь же главная оговорка. Годы из ревизий — расчётные, по возрасту, и помечены как «около». А самые ранние звенья самой длинной линии до сих пор помечены как «вероятные»: в 1780-х семья переселилась в соседний выселок, и переход из одной ревизии в другую держится на совпадении имён и возрастов, а не на прямой записи. Агент не стал дорисовывать уверенность — и это то, чего мы от него добивались.
2. Личный сайт-архив
Через три дня находок стало столько, что их нужно было куда-то складывать и показывать родным. Так 28 сентября появился наш открытый семейный сайт-архив. Сейчас в его репозитории около 590 коммитов, почти все сделаны агентами.
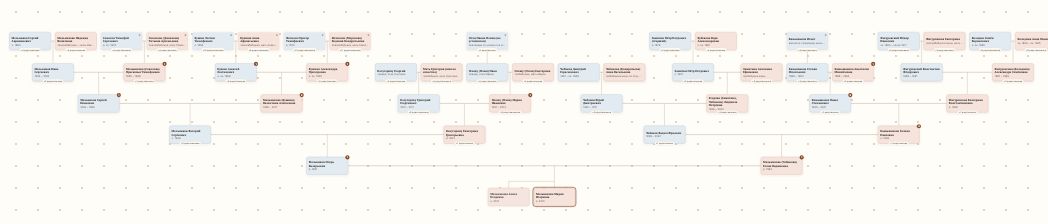
Устройство намеренно простое:
-
Один файл данных. Всё — люди, семьи, документы, места, наводки, журнал поиска и журнал исправлений — лежит в
family_tree.json. Агенту легко его читать и править, а git хранит всю историю. -
Нумерация вместо имён. Люди
I###, семьиF###, документыS###. Номер документа в тексте становится кнопкой, и у каждого факта видно, на чём он держится. -
Проверки до сборки.
validate.pyловит битые ссылки, ссылку на документ без самого документа, даты не в ISO/GEDCOM. При ошибке сайт не собирается. -
Статика и один маленький сервер. Сборщик на Python делает страницы из JSON, сервер нужен только для комментариев. Выкладка отправляет только изменённые файлы и идёт около минуты.
Как устроен архив: от карточки к летописи
Древо — только вход. Сам архив состоит из нескольких слоёв, и все они собираются из одного файла данных. Родные читают сайт как книгу, поэтому каждый слой — это прежде всего текст, а не таблица.
Зачем так много текста? Потому что именно в нём люди оживают. Большинство предков мы помним стариками на поздних снимках или не помним вовсе: фамилия, имя и отчество в чьих-то воспоминаниях. А потом их окружает контекст. Прапрадед, от которого осталась строчка «советский работник в городе на Волге», оказывается кудрявым молодым кооператором, которого летом 1916 года записала в дневник совершенно посторонняя современница: «лихач-кудрявич, очень милый, простой и серьёзный». И кудри видны на его юношеском снимке из фотоателье.
Прадед — уже не дата на надгробии, а, скорее всего, рядовой пехотного полка, раненный осенью 1916-го. Его тесть круглый год жил на заработках в Москве, а родное село жены имело три названия, два из которых — по именам старых владельцев. Человек появляется не из одного документа, а из мест, событий и людей вокруг: крёстных, свидетелей на свадьбе, сослуживцев, соседей по деревне. Поэтому архив и устроен как сеть: из карточки — в место, из места — в главу «Истории», из главы — к документу.
Карточка человека. Блоки с датами, местами и родными, а под ними — связный рассказ о жизни по порядку. Рассказ есть у 510 из 597 человек, вместе около 250 тысяч знаков. Правила для агента жёсткие:
-
это история жизни, а не журнал работы: никакого «отчество уточнено 25.09»;
-
не повторять то, что карточка уже показывает блоками: родителей, даты, место захоронения;
-
у каждого факта с документом — кнопка на скан, семейное предание помечено словами «по рассказу…», «в семье говорили…»;
-
сомнения — отдельным абзацем «Что не подтверждено», и слово «вероятно» не убирается ради гладкости.
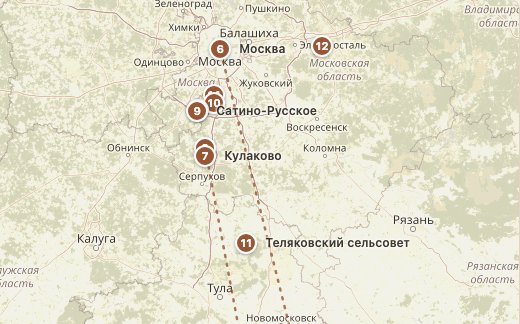
Места. 61 место на карте, в цвете ветвей семьи, с переездами. У каждого села и города своя страница: «тогда» и «сейчас» (волость и уезд → район и область), старые названия, история — владельцы, храм, школа, — хронология событий семьи в этом месте и список архивных фондов, куда писать дальше. Место часто объясняет судьбу лучше дат: село, чьи мужики целыми семьями уходили на заработки в Москву, или молдавское село, где землю крестьяне получили при князе Кузе.
«История». Здесь из сотен карточек складывается история рода. Она есть в трёх видах:
-
«Летопись» в двух частях. «Истоки» — по главе на каждый род, с самых ранних записей. «Век перемен» — что с этими родами сделал XX век: война в Персии и Анатолии, эмиграция, аресты и высылка, мельницы Бессарабии. Текст связан с картой и лентой времени, имена в нём ведут в карточки.
-
«Двенадцать историй» — короткие сюжеты, ради которых родные и открывают сайт: «бабушка-графиня», оказавшаяся княжной, колдунья и знахарка, ветеринар, которого арестовывали дважды, письма с фронта.
-
Версия для детей — та же история словами, понятными школьницам.
Заканчивается «История» главами «Чего мы пока не знаем» и «Куда писать». Неизвестное — тоже часть нарратива, и именно оно заставляет родных вспоминать и писать.
Вопросы к семье и «Что нового». В «Вопросах» — то, что могут знать только родные, ответы пишутся прямо под вопросом. В ленте «Что нового» каждая заметная находка выходит выпуском с датой и временем. Правило тут одно: родным — вся история находки с крёстными, свидетелями и контекстом, а не выжимка «вам может быть интересно».
Книга. Из тех же данных собирается книга «Семь родов» для печати: формат 170×240 мм, часть I — главы «Истории», часть II — статьи о предках по родам, «возможная» родня — в приложении. PDF печатает headless Chrome через Paged.js.
Сайт есть по-русски, по-английски и по-румынски: часть семьи в Молдове. Сборка падает на любой строке без перевода.
Самое ценное оказалось в родных. Они пишут комментарии прямо на сайте — за две недели их набралось больше 80 — и присылают снимки из семейных альбомов. Агент забирает комментарии, вносит правки и отмечает каждый: «✓ Учтено — что сделано». Старые снимки из альбомов реставрирует нейросеть — об этом ниже.
Пайплайн реставрации
Снимков из альбомов пришло много, и реставрация стала отдельным конвейером из двух агентов: один реставрирует, другой проверяет. Сейчас так восстановлен 151 снимок, на это ушло 25 брифов и 12 брифов на переделку.
-
Бриф на партию. Около восьми снимков: пути к оригиналам и готовые пути для результата,
<снимок>-bw.jpgи<снимок>-color.jpg. Codex получает только эту задачу — без отчётов и описаний, иначе он увлекается текстом. Три-четыре партии идут параллельно:codex exec -C . -s workspace-write "Выполни <бриф>" < /dev/null. -
Реставрация. Встроенная генерация изображений Codex в режиме редактирования, один промпт на всех: архивная реставрация этой самой фотографии, убрать царапины, заломы, пятна и выцветание, а людей, лица, возраст, причёски, одежду, награды, надписи и штампы ателье оставить как есть. Не украшать, ничего не добавлять и не убирать. Простая обработка на Pillow и OpenCV была первой попыткой и не подошла.
-
Каждый вариант — от оригинала. Цветная копия делается не из чёрно-белой, а снова из оригинала: иначе искажения накапливаются. Сам Codex сравнивает результат с оригиналом и делает не больше двух попыток на вариант.
-
Независимая проверка. Claude Code сверяет каждую пару с оригиналом: лица, возраст, число людей, надписи и цифры. Типичные ошибки: на совхозном щите цветная версия написала 4937 вместо 4597, а чёрно-белая выдумала другой лозунг; пожилая женщина вышла заметно моложе; на паспарту появилась фамилия фотографа, которую на оригинале не прочитать.
-
Переделка по точечному брифу. Текст на снимке цитируется буква в букву с одним правилом: «если не удаётся передать точно, оставь размытым, но не сочиняй». Сомнительная деталь, которую не исправить, идёт оговоркой под снимок.
-
Публикация. Скрипт собирает манифест: датировка берётся из описания снимка, к каждой паре — оговорка о методе и предположительных цветах. Он не пропустит пару, если оригинал лежит повёрнутым относительно реставрации: сравнивает картинки при поворотах на 0, 90, 180 и 270 градусов. На сайте реставрация всегда лежит рядом с оригиналом с переключателем, и документом остаётся оригинал.
Ещё две вещи понадобились быстрее, чем я думал. Живых родственников сайт прячет от поисковиков (noindex, нет в карте сайта). А документ, который семья попросила убрать, помечается флагом hidden и вычищается из сайта и GEDCOM при сборке.
Что нашлось: три истории
Имена я опускаю: важнее, как складывались цепочки.
Княжна из ногайского рода
О прапрабабушке жены в семье знали имя и старую фотографию. В памятной книжке Киевской губернии на 1901 год она записана служащей сиротского суда — и «княжной». В послужном списке её вероятного брата происхождение написано прямо: «из князей Нагайского племени Кубанской области». По спискам 1872 года род нашёлся в двух ногайских аулах на Кубани.
Дальше цепочка разошлась по всему миру. Кадетский портрет одного из братьев — в выпускном альбоме кадетского корпуса 1906 года с автографом великого князя Константина Константиновича. Анкета беженки в Королевстве сербов, хорватов и словенцев: в январе 1921 года прибыла из Севастополя. Американский реестр, где отец другой дочери назван латиницей. Смерть выпускника Донского кадетского корпуса в Буэнос-Айресе в 1961 году. Могила во Франции. О том, что это одна семья, говорит не фамилия, а одна и та же девичья фамилия матери в анкетах двух братьев.
Карточка из лагеря военнопленных
Сначала в военной базе нашлась одна строка: брат прабабушки погиб в финском плену. Через две недели — его финская карточка военнопленного: в плену с 29 августа 1941 года, до войны шофёр, артиллерист. Через месяц — лагерь № 9 у порта Кеми, крупнейший лагерь советских пленных в Финляндии.
В графе «кого известить» по-русски записаны жена и адрес в подмосковном городе. Так мы впервые узнали, что он был женат. На обороте — дата смерти «1.12.42» и причина: дизентерия. А в базе Национального архива Финляндии — 1 декабря 1941 года.
Агент не стал выбирать наугад, а проверил статистику лагеря: в декабре 1941-го там умерли 428 человек, в декабре 1942-го — четверо. Значит, вероятнее 1941 год. Точный ответ даст личное дело в финском архиве, номер конверта уже известен. Кладбище лагеря сохранилось: обелиск «Здесь похоронено 1648 советских военнопленных».
Крёстная из имения, где жил Чайковский
Метрика 1905 года: в местечке Каменка Киевской губернии крестят сына земского врача. Агент перечитал запись по скану: крёстная — «дворянка Мария Николаева Давыдова, девица». Каменка — имение Давыдовых: там собирались декабристы, а Пётр Чайковский, чья сестра вышла за одного из Давыдовых, подолгу жил и писал там музыку с 1865 по 1893 год.
Интереснее всего то, что агент сделал потом. Он проверил вторичные источники, нашёл строку о каменских Давыдовых в письме самого Чайковского в полном собрании сочинений — и снял с сайта красивое, но ничем не подтверждённое утверждение из вторичного источника. Вот ради такого поведения и писались правила из раздела про уроки.
3. Движок: отделяем код от семьи
Через десять дней стало ясно, что сайт сам по себе полезен не только нам. 7 октября вышла первая версия gene-archive — генератора сайта семейного архива. За неделю было пять выпусков, сегодня вышла 0.5.0. Демо построено на вымышленной семье.
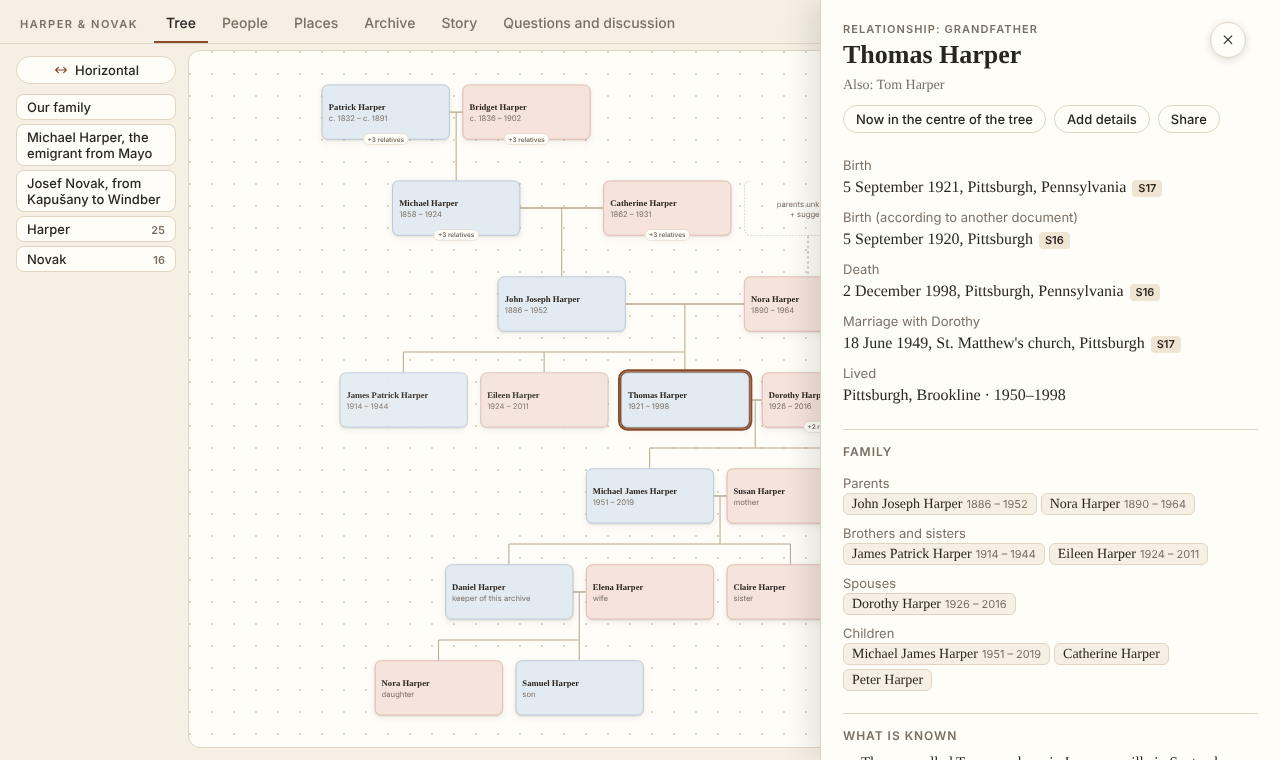
Главная работа была не в новом коде, а в разделении. В личном сайте код и семья срослись: вопросы к родным в сборщике, семейный текст в шаблоне, наши ветви в скриптах. В движке всё это ушло в настройки сайта (site.json) и данные, а формат family_tree.json описан JSON-схемой.
Что добавилось сверх личного сайта:
-
Редактор в браузере. У нас всё правили агенты, а обычной семье нужна форма. Роли, проверка перед сохранением, защита от одновременной правки, каждое изменение — коммит от имени автора. Читатель может предложить исправление из карточки человека.
-
GEDCOM туда и обратно. Импорт из MyHeritage, Ancestry, Gramps и выгрузка в трёх вариантах: полная, для Geni и для открытых форумов, где живые без имён.
-
Приватность на уровне данных. О живых публикуется только имя. Даты, места и документы вырезаются даже из опубликованного файла данных, а не просто прячутся в интерфейсе.
-
«Как мы связаны». Точное родство двух людей — «троюродный дядя», «свояченица» — на трёх языках. Родные пользуются этим чаще, чем древом.
-
Поиск без сервера. Имена, сёла, слова из расшифровок — с учётом падежей, дореформенного письма и латиницы. Работает прямо в браузере, подходит статический хостинг.
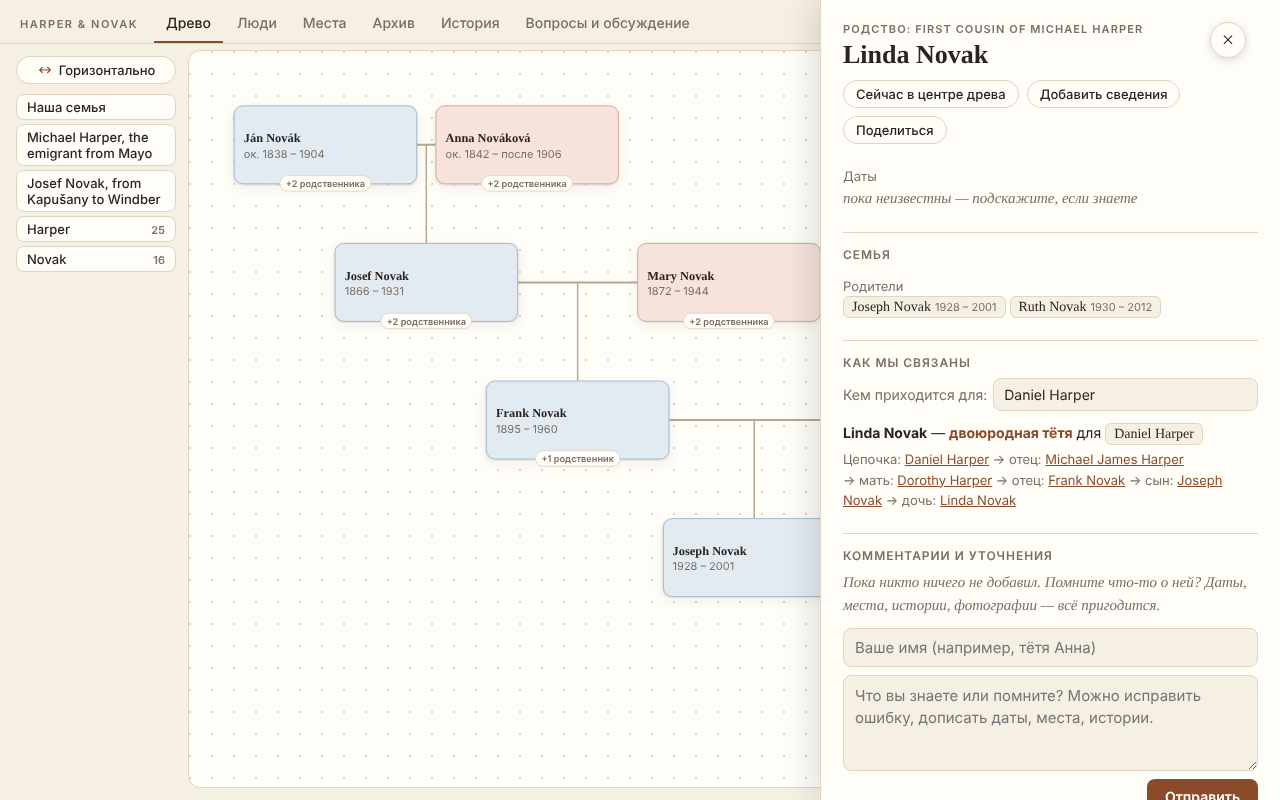
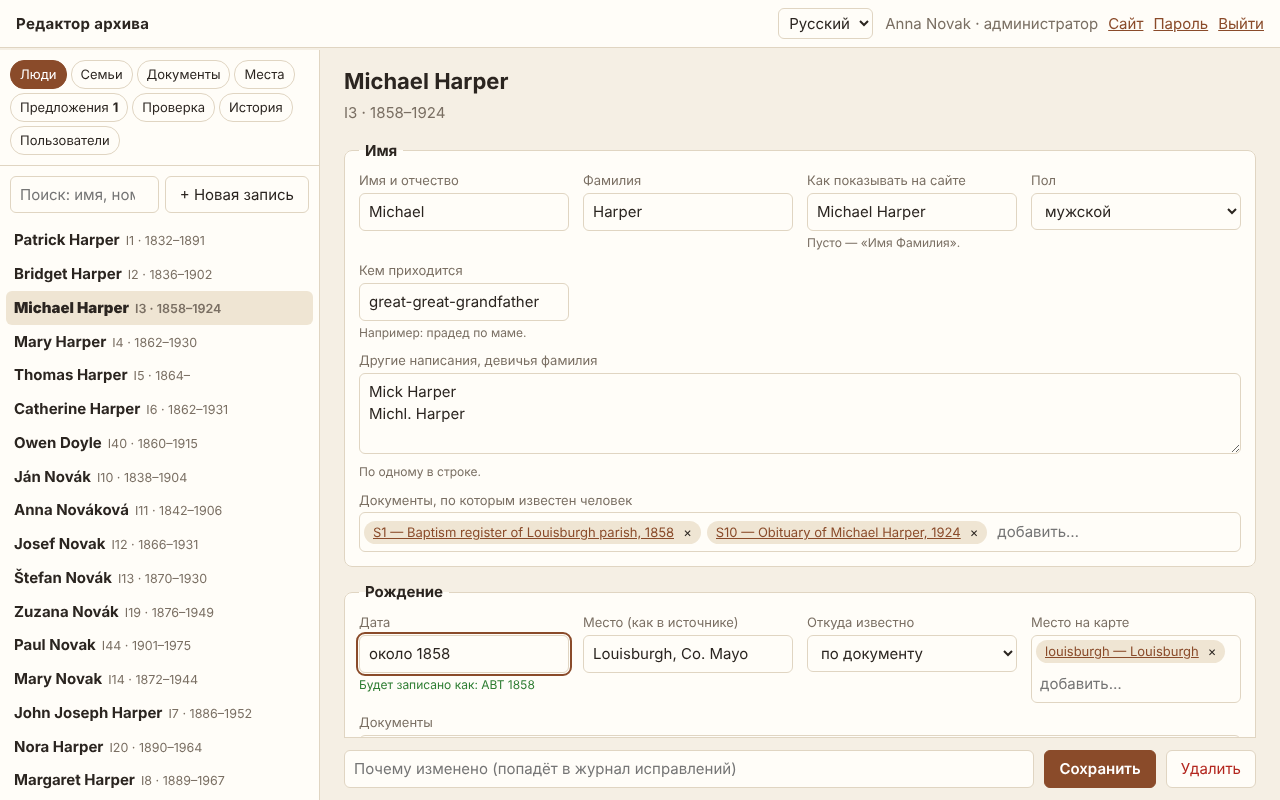
Стек скучный, и это намеренно: Python без зависимостей (Pillow — по желанию, для превью), JavaScript без сборки и фреймворков, Leaflet для карты. Сайт кладётся на GitHub Pages или любой хостинг, комментарии и редактор даёт gene serve или Docker-образ. Семейный архив должен пережить не одно поколение фреймворков.
И ключевая деталь: в каждый новый сайт кладётся AGENTS.md — инструкция для Claude Code и Codex: как устроены данные, как вносить находки, чего не делать. Движок изначально рассчитан на то, что архив наполняет не только человек.
Лицензия — AGPL-3.0: код можно брать и менять, но изменённый движок, запущенный как сервис, нужно открывать. Сами сайты семей — данные, тексты, фото — лицензия не затрагивает.
4. MCP: чтобы метод работал с любым ассистентом
Движок решает, где хранить и как показывать. Но самое дорогое в нашем опыте — не сайт, а метод поиска: где лежат метрики нужной губернии, как искать в каждой базе, как читать старые даты и когда находка действительно о твоём человеке. У нас это жило в AGENTS.md и в головах агентов. 12 октября мы упаковали это в MCP-сервер genealogy-mcp.
MCP (Model Context Protocol) — стандартный способ дать ассистенту инструменты. Один сервер подключается к Claude Desktop и Claude Code, ChatGPT, Cursor, VS Code — и метод перестаёт зависеть от конкретного агента.
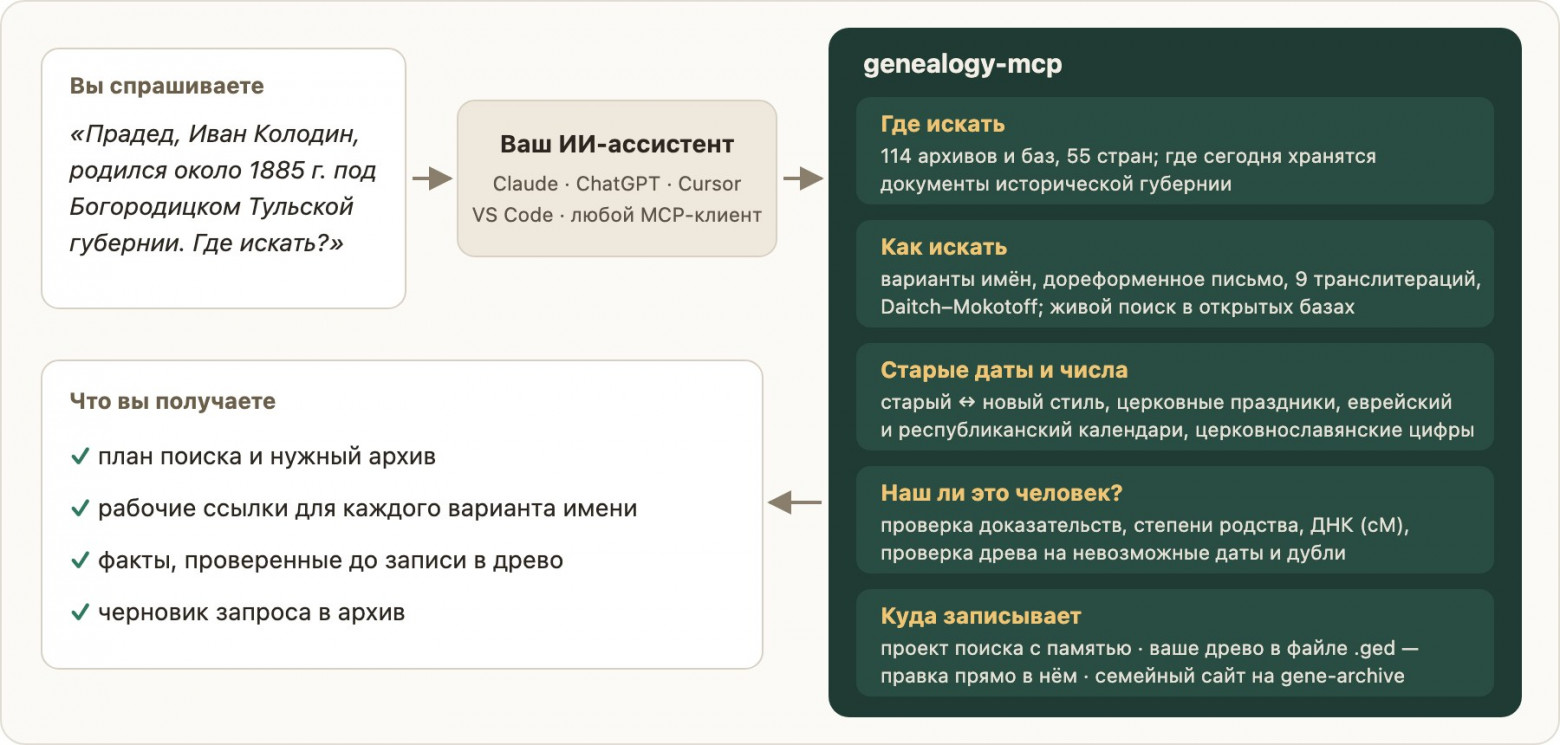
Что внутри:
-
Каталог 114 архивов и баз в 55 странах. У каждого сказано, что там есть и как в нём искать с толком. Отдельно — где сегодня документы исторической губернии: границы менялись, и это часто не архив нынешней области.
-
24 инструмента генеалога. Варианты имён и 9 систем транслитерации, старый стиль, даты по церковным праздникам, церковнославянские цифры, степени родства, ДНК, черновики запросов в архивы.
-
Правило доказательства в коде.
check_matchсравнивает находку с известным факт за фактом. Два независимых совпадения помимо имени — подтверждено, одно — вероятно, противоречие — нужен третий документ. -
Память поиска. Проект на компьютере помнит людей, источники с полными шифрами, наводки и каждый поиск, включая «ничего не нашлось». Иначе ассистент счастливо ищет в одном месте дважды.
Самое интересное — как сервер записывает найденное. Для этого в движке появилась команда gene apply. Правка от ассистента идёт тем же путём, что и правка человека в онлайн-редакторе: проверки, запись в журнал исправлений и журнал поиска, коммит в git от имени автора, пересборка сайта. Перед записью ассистент показывает правку и ждёт «да». То же самое работает с обычным файлом GEDCOM из MyHeritage или Gramps: переписываются только изменённые строки, копия файла сохраняется.
Подключение к Claude Code — одна строка:
claude mcp add genealogy -- uvx genealogy-mcp
Для Claude Desktop есть установка в один клик файлом .mcpb, сервер опубликован в PyPI и официальном каталоге MCP. В сеть он выходит только для поиска, о котором попросили, и только на тот сайт, где ищет.
Есть и осознанные ограничения. Инструменты, которыми мы сами качали сканы из закрытых баз, в сервер не попали: там только открытый поиск — полный текст Internet Archive, WikiTree, Open Archives, Wikidata. Для остального сервер даёт ссылки на поиск и подсказки, а ищет человек.
Уроки: чему пришлось научить агентов
За три недели в журнале исправлений накопилось 286 записей, в журнале поиска — 440. Это не признак плохой работы, а её основа: агент постоянно уточняет сам себя, и каждую смену факта видно. Вот правила, без которых архиву нельзя было бы верить.
-
Однофамилец — не родственник, отчество не даёт отца. Модель очень хочет найти связь, и совпадение фамилии с деревней кажется ей доказательством. Правило стоит первым в инструкции, а в MCP стало кодом: два независимых факта помимо имени. Всё сомнительное идёт в наводки или с пометкой «вероятно», на сайте такие связи рисуются пунктиром.
-
Расшифровка — только по скану. Если модель знает дату из другого документа, она легко «прочитает» её и в этом. Каждое поле читается с картинки, непрочитанное помечается как непрочитанное. То же с реставрацией: дорисованная надпись — переделка.
-
Каждое изменение факта — в журнал. Что было, что стало, почему и по каким документам. Даже поиск без результата записывается, иначе следующий агент пойдёт туда же.
-
Проходить весь список источников. Нашлась зацепка в одной базе — агент радостно копает только её. В инструкции список источников и требование записать, что проверили, а что нет.
-
Два агента — две зоны. Над проектом параллельно работают Claude Code и Codex. Сборка и выкладка идут по одной за раз через блокировку, перед коммитом —
git status, чтобы не захватить чужие правки. А реставрацию фото Codex получает без лишних задач — иначе он начинал писать отчёты вместо снимков. -
Вёрстку проверяет робот, а не агент на слово. Перед каждой выкладкой Playwright открывает сайт в движке Safari на iPhone и ноутбуке и в Chromium. Не прошло дважды — выкладки нет.
Отдельная история — доступ к базам. FamilySearch отвечает ошибкой 429 примерно после трёх тысяч кадров. Капчу в «Памяти народа» вводит человек. Часть российских госсайтов открывается только с сертификатами Минцифры, часть зарубежных баз — только из-за границы. И есть то, что агент делать не должен: письма в архивы и родственникам уходят только после моего «да».
Как попробовать
Сайт для своей семьи:
pip install "gene-archive[images]"
gene init my-family --example
gene serve my-family
Помощник в поиске для Claude Code:
claude mcp add genealogy -- uvx genealogy-mcp
И просто спросите: «Помоги найти прадеда. Вот что я знаю…»
-
Движок: github.com/igormel81/gene_archive, демо на вымышленной семье, AGPL-3.0.
-
MCP-сервер: github.com/igormel81/genealogy-mcp, PyPI и официальный каталог MCP, MIT.
Буду рад issues, историям из ваших поисков и новым источникам для каталога.
Автор: inlem

