


На работе у меня есть PostgreSQL. Точнее, PostgreSQL у меня есть много раз: разные сервисы, окружения, кластеры и сотни шардов.
Немного контекста обо мне: сейчас я бэкенд-разработчик высоконагруженных сервисов, а раньше работал DBA. Поэтому базы для меня — не абстрактное хранилище за ORM, но и вручную носить каждый ALTER TABLE по серверам на флешке мне тоже не приходится.
Штатные миграции наши сервисы раскатывают сами вместе с деплоем. Но остаются редкие операции на больших и постоянно нагруженных таблицах, которым нужен отдельный план: создание индекса, валидация ограничения, тяжёлый DDL или изменение, которое необходимо проводить небольшими этапами. Здесь уже важно выбрать правильный момент, ограничить ожидание блокировки, поставить statement_timeout, не занять надолго весь пул соединений и остановиться после первой проблемы.
Такие операции опасно выполнять по принципу «разработчик посмотрел SQL, вроде всё нормально». Человек может проверить скрипт и забыть lock_timeout, перепутать шард или не заметить частичное применение. Мне хотелось, чтобы эти правила помнил инструмент, а не человек в терминале. Terox появился именно для таких ручных операционных задач и диагностики — не как замена автоматическим миграциям приложения.
Обычный вопрос «а на каком шарде лежит эта запись?» иногда превращался в небольшой квест:
-
найти нужный хост;
-
вспомнить порт и имя базы;
-
открыть
psql; -
выполнить запрос;
-
убедиться, что записи там нет;
-
перейти к следующему шарду и укрепить характер.
Можно использовать pgAdmin, но сначала придётся вручную завести через интерфейс сотню подключений. Для каждого заполнить хост, порт, базу, пользователя и параметры TLS, не перепутать номер шарда и аккуратно разложить всё по группам. На нескольких базах это нормально. Но когда их сотни, это уже долгая, монотонная работа, которую придётся повторять при каждом изменении конфигурации. Можно завести коллекцию shell-алиасов. Можно держать рядом файл с командами подключения, который со временем начинает выглядеть как генеалогическое древо инфраструктуры.
Все эти способы работают. Проблема в том, что мне был нужен не ещё один способ подключиться к PostgreSQL. Мне не хватало инструмента, который понимает сущности уровнем выше: сервис → хранилище → один, несколько или все шарды.
В какой-то момент я перестал копировать очередную строку подключения, сел рядом с ИИ и начал собирать такой инструмент сам. Первую полезную версию мы сделали за пару дней. Так появился Terox — интерактивный CLI-клиент для работы с шардированными PostgreSQL-кластерами.
Название получилось немного космическим. Работа всё равно в основном состоит из SELECT, но теперь хотя бы звучит так, будто мы управляем флотом.
Почему мне не хватало psql и pgAdmin
Сразу оговорюсь: psql прекрасен. pgAdmin тоже решает свои задачи. Terox не пытается заменить ни один из них.
Но у обычного клиента единицей работы является подключение. В шардированной системе единицей работы часто становится целый набор подключений.
Мне регулярно хотелось делать такие вещи:
-
выполнить один диагностический запрос на всех шардах;
-
увидеть результаты в одной таблице и не потерять информацию, с какого шарда пришла строка;
-
быстро перейти на шард, где нашлись данные;
-
сравнить схему таблицы между шардами;
-
посмотреть блокировки, долгие транзакции и размеры таблиц сразу по кластеру;
-
применить одну миграцию с понятными таймаутами и увидеть статус каждого шарда;
-
не перепутать staging и production в пятницу вечером.
Последний пункт особенно важен. Пятница вечером — это распределённая система, в которой роль consensus выполняет внутренний голос: «может, в понедельник?»
Почему не цикл вокруг psql
Самый очевидный вариант выглядит примерно так:
for shard in $(seq -w 1 128); do
  psql "host=pgbouncer-shop-rs${shard}.example.net ..."
    -c "select * from items where item_id = 424242"
done
И это нормальное решение для разовой задачи. Проблемы начинаются, когда такой цикл становится ежедневным инструментом: нужно ограничить параллелизм, отменять уже запущенные запросы, не терять ошибки отдельных шардов, объединять разные наборы колонок, отделять чтение от записи и каждый раз проверять, что цикл не смотрит в production с неожиданными правами.
Terox вырос не из идеи «давайте заменим psql», а из желания один раз собрать эту обвязку и дальше работать с понятием набора шардов, а не со строками подключения.
Один конфиг вместо каталога подключений
В Terox хосты и базы описываются шаблонами. В примерах ниже имена, адреса и данные синтетические — внутреннюю инфраструктуру публиковать не стоит, — но команды и поведение клиента настоящие. Например, условные 128 шардов можно записать так:
max_rows: 100
fanout_concurrency: 8
query_timeout: 7s
statement_timeout: 5s
lock_timeout: 500ms

services:
  shop:
    storages:
      prod:
        host_template: pgbouncer-shop-rs{p1:03}.example.net
        db_template: shard_{p}
        port: 6432
        user: readonly
        password_env: TEROX_SHOP_PASSWORD
        count: 128
        sslmode: verify-full
        prod: true
        migration_role: app_writer
{p1:03} превращается в 001, 002, …, 128, а {p} — в номер позиции от нуля. Хост и имя базы могут нумероваться по-разному.
fanout_concurrency здесь важнее, чем кажется. Он не позволяет клиенту одновременно броситься ко всем 128 шардам и устроить нагрузочный тест, о котором никто не просил. Клиентский query_timeout ограничивает весь вызов к конкретному шарду, а серверные statement_timeout и lock_timeout ограничивают работу уже внутри PostgreSQL.
После этого можно сразу открыть весь кластер:
terox -t shop/prod/all
Или выбрать сервис, хранилище и шард через меню. В приглашении всегда видны текущий контекст, production-бейдж, режим чтения/записи и statement_timeout.
shop/prod(all) [prod ro st=5s] =>
Если запрос ушёл не туда, хотя всё это написано прямо в prompt, инструмент хотя бы честно пытался помочь.
Fan-out без ручного fan-out
Запрос на all выполняется по выбранным шардам, а результаты объединяются. Terox добавляет колонку shard, выравнивает колонки по именам и отдельно показывает ошибки отдельных целей.
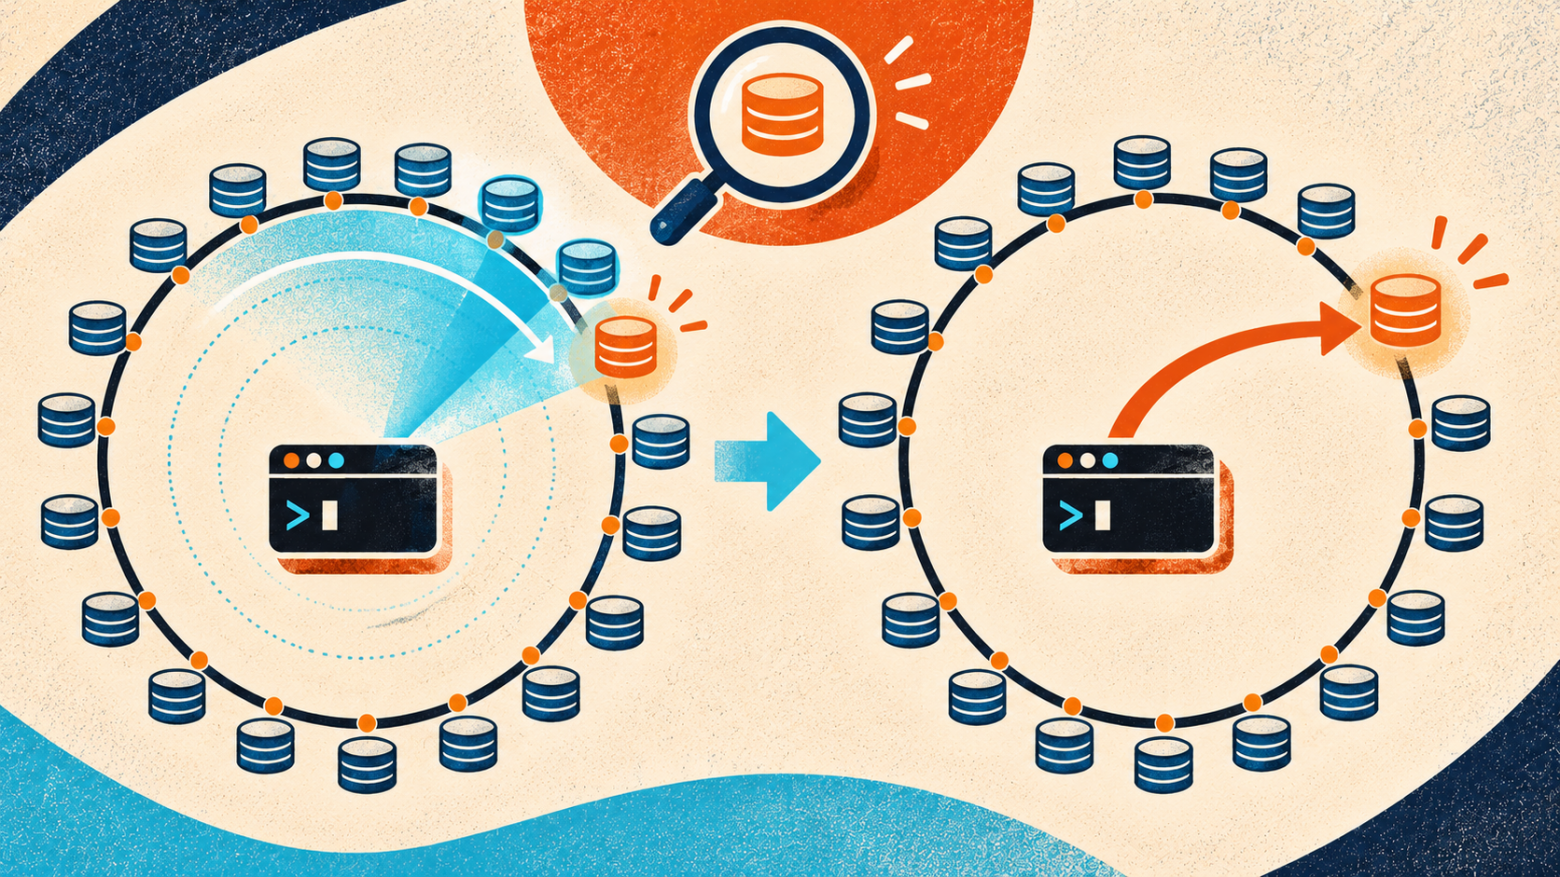
У нас сущности распределяются по шардам с помощью консистентного хеширования. Это удобно для системы, но не всегда удобно для человека: по одному ключу нельзя просто прикинуть на листочке, на каком именно из сотни шардов лежит запись. Для точного ответа нужны актуальное кольцо, виртуальные узлы и та же логика маршрутизации, которой пользуется приложение.
А иногда задача звучит совсем буднично: «найди объект с таким ID и посмотри, что с ним происходит». Перебирать сто подключений вручную — отличный способ превратить минутную проверку в хобби.
Для этого в Terox есть find:
shop/prod(all) => find items item_id = 424242
┌──────────┬───────┐
│ shard    │ count │
├──────────┼───────┤
│ shard_37 │ 1     │
└──────────┴───────┘
found on 1/128 shard(s)
→ shop/prod(shard_37)
Terox пробегает по выбранным шардам, показывает, где нашлись данные, и, если подходящий шард один, автоматически переключается на него. Следующий запрос уже выполняется в правильном месте — без копирования хоста, повторного подключения и игры «угадай шард».
А если совпадений несколько, можно выбрать нужный шард вручную:
s shard_37
Для частых сценариев появились команды count, locate, grep, сохранённые запросы с параметрами и экспорт результата в CSV/JSON. История хранится отдельно для каждого сервиса: запросы из одного контекста не всплывают стрелкой вверх в другом.
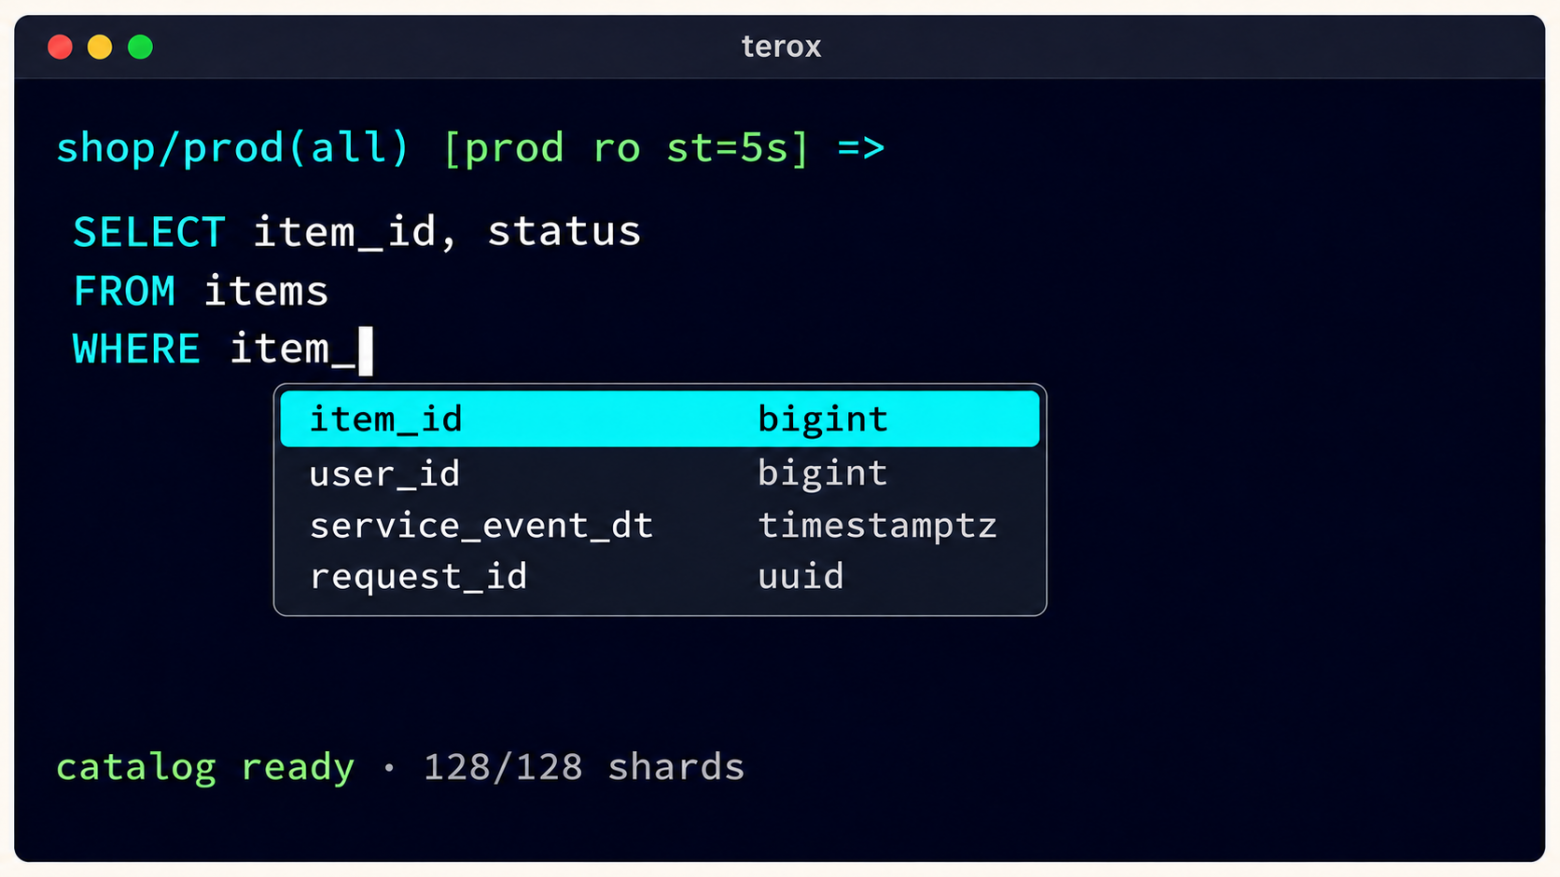
Редактор поддерживает многострочный ввод, перенос длинных строк, живое автодополнение по схемам, таблицам и колонкам. Есть и автоматическое исправление раскладки: если набрать метакоманду в русской раскладке, Terox старается понять, что пальцы помнили лучше головы.
Что происходит внутри fan-out
Упрощённо путь запроса выглядит так:
селектор all / 0,1,5
        │
        ▼
разворачивание списка физических шардов
        │
        ▼
очередь с лимитом fanout_concurrency
        │
        ├── shard_0: READ ONLY + SET LOCAL statement_timeout
        ├── shard_1: READ ONLY + SET LOCAL statement_timeout
        └── shard_N: READ ONLY + SET LOCAL statement_timeout
        │
        ▼
объединение строк + колонка shard + отдельные ошибки
Для каждого шарда пул создаётся лениво: пока к базе не обратились, соединения нет. Внутри одного шардового пула разрешено не более двух соединений — второе нужно, чтобы фоновое автодополнение не блокировало пользовательский запрос. При этом число шардов, обрабатываемых одновременно, ограничивает именно fanout_concurrency.
У каждого шарда свой клиентский дедлайн. Медленный или недоступный шард не стирает успешные результаты остальных: ошибка остаётся привязана к своей цели и выводится отдельно. Ctrl+C отменяет общий контекст, поэтому прерываются уже выполняющиеся запросы, а ещё не начавшиеся не стартуют. При выходе менеджер закрывает все созданные пулы и запрещает фоновой горутине создать новое соединение после закрытия.
Чтение на каждом шарде идёт в настоящей PostgreSQL-транзакции READ ONLY, а не определяется только разбором текста SQL. Результат ограничивается max_rows, чтобы случайный широкий SELECT не съел память терминала; полный экспорт больших выборок использует потоковое чтение.
Диагностика, которую обычно собираешь по кусочкам
Постепенно клиент оброс командами, которые мне постоянно нужны во время разбора проблем. activity, blockers, locks и longtx показывают активность и блокировки; sizes и statements --skew помогают увидеть перекос между шардами; diff <table> сравнивает схему, а doctor --all собирает общий health-check. Для отдельных запросов есть explain, advise и lint.
Это не замена мониторингу и не карманный DBA. Скорее, это короткий путь от «что-то медленно» до нормального вопроса, с которым уже можно идти в метрики, логи и план запроса.
Например, lint предупредит про DELETE без WHERE, LIMIT без ORDER BY, подозрительный декартов продукт или NOT IN с nullable-значениями. Эвристика может ошибиться. Зато она не устаёт и не думает: «да ладно, запрос маленький».
Запись должна включаться осознанно
Чтение в Terox выполняется в READ ONLY-транзакциях. По умолчанию клиент работает в режиме ro, а пишущий запрос отклоняется.
Чтобы разрешить запись, нужно явно выполнить:
write on
При смене сервиса или хранилища write-режим сбрасывается. Это простая защита от ситуации «я думал, что всё ещё на тестовом кластере».
Если у хранилища задана migration_role, запись получает её через SET LOCAL ROLE. Обычная транзакционная миграция оборачивается примерно так:
begin;
set local role app_writer;
set local statement_timeout = '5s';
set local lock_timeout = '500ms';

-- тело миграции

commit;
Здесь важно именно LOCAL: настройки живут внутри транзакции и не протекают следующему клиенту PgBouncer.
DROP DATABASE запрещён безусловно. Да, пользователь взрослый человек. Но клиент, запущенный на сотне шардов, тоже взрослый и имеет право отказаться участвовать.
Миграция — не просто «отправить SQL сто раз»
Ещё раз подчеркну: обычные версионируемые миграции едут с сервисом автоматически. Режим ниже нужен для исключений, где разработчик осознанно управляет раскаткой на нагруженных таблицах и должен видеть каждый этап.
Для миграций есть отдельный режим:
migrate add_column.sql
Без --allowed это dry-run: Terox показывает точный SQL, план раскатки и предупреждения статического анализатора. Реальное применение запускается отдельно:
migrate --allowed add_column.sql
Для больших кластеров есть canary, батчи и продолжение прерванной раскатки:
migrate --allowed --canary add_column.sql
migrate --allowed --batch 10 add_column.sql
migrate --allowed --resume add_column.sql
Контрольная сумма не позволяет незаметно продолжить уже начатую миграцию изменённым файлом.
Общей транзакции на 128 PostgreSQL-серверов здесь, разумеется, нет. Атомарность действует внутри каждого шарда: один уже мог сделать COMMIT, когда следующий вернул ошибку. Поэтому по умолчанию первая ошибка отменяет ещё не начавшиеся и выполняющиеся цели, отчёт явно показывает частичное применение, а --resume продолжает только с непройденных шардов. Именно для этого миграции должны быть идемпотентными, а canary и небольшие батчи полезнее героизма.
Есть отдельный неприятный класс операторов: CREATE INDEX CONCURRENTLY, REINDEX CONCURRENTLY, VACUUM и другие команды, которым запрещено выполняться внутри транзакции. Для них нельзя применить обычную обёртку с SET LOCAL и серверными таймаутами. Terox распознаёт такой SQL, громко показывает, что выполнение будет незащищённым, а на production требует клиентский migration_timeout и отдельное подтверждение.
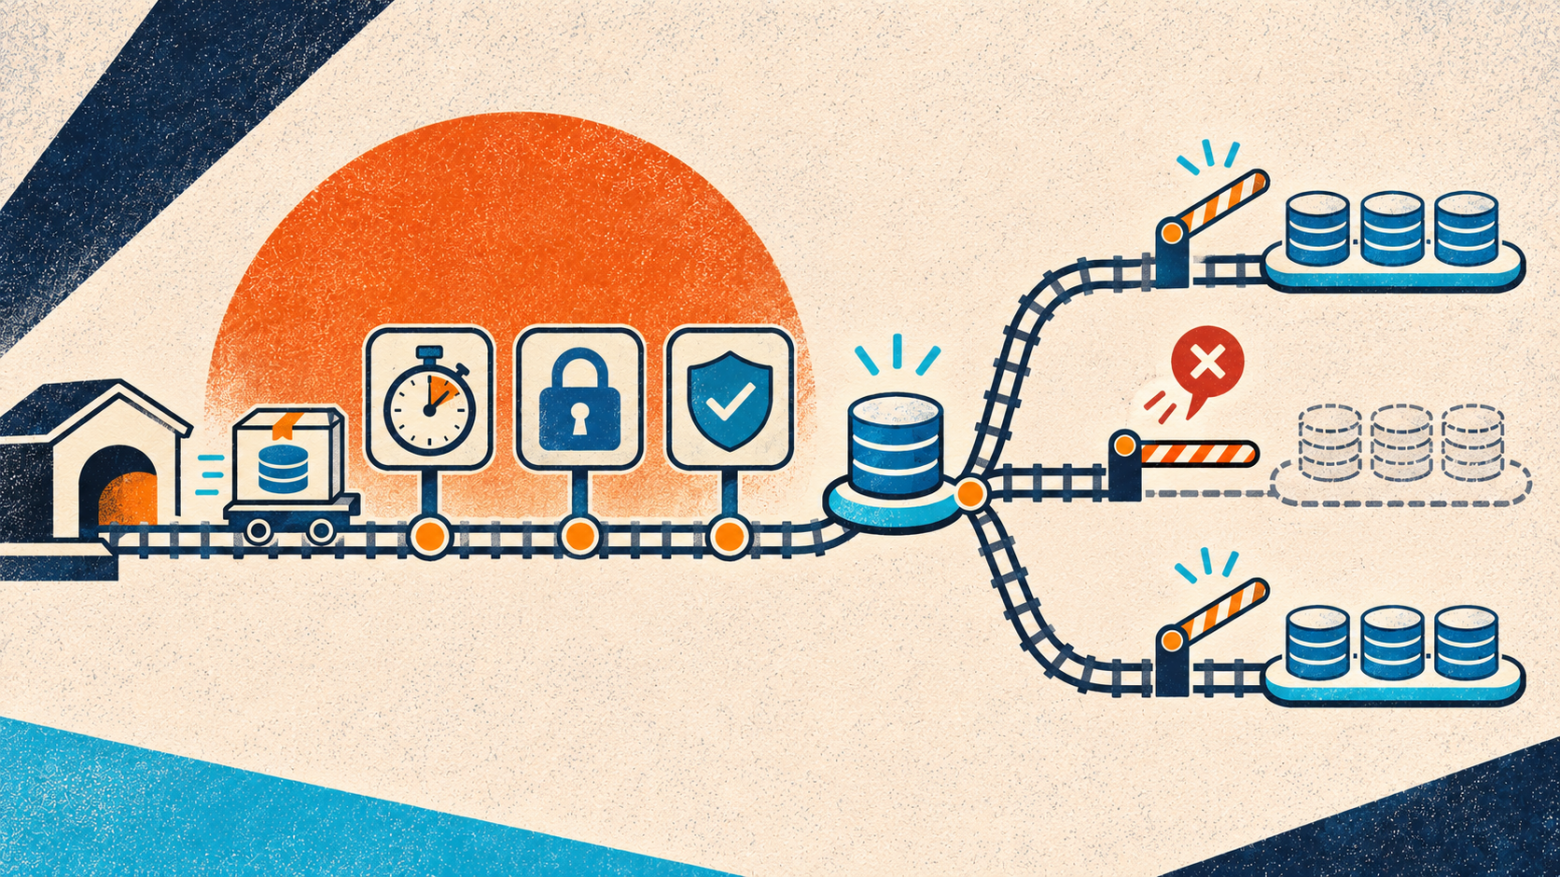
Мне хотелось, чтобы опасный путь был не невозможным, а заметным. Кроме DROP DATABASE. У этого пути и так достаточно самостоятельных инструментов.
Где здесь вайбкодинг
Большую часть Terox я действительно делал совместно с ИИ. Не в смысле «написал один промпт и ушёл пить кофе». Кофе я пил рядом.
Работа выглядела примерно так:
-
я описывал конкретную боль из своего рабочего процесса;
-
мы находили минимальную модель поведения;
-
ИИ предлагал реализацию;
-
я проверял код, запускал тесты и пробовал сценарий руками;
-
очередной крайний случай превращался в новый тест.
Так появились детали, которые редко входят в красивую первую демонстрацию:
-
корректное закрытие всех пулов соединений при выходе;
-
Ctrl+C, который выходит из prompt, но отменяет активный запрос; -
перенос длинного SQL по ширине терминала;
-
многострочная вставка;
-
безопасная история без паролей и с отдельным файлом на сервис;
-
резервная копия конфига перед установкой;
-
строгая проверка неизвестных YAML-полей;
-
защита от утечки session-scoped состояния при transaction pooling;
-
тесты на конкурентное закрытие пулов и race-прогоны.
ИИ очень ускоряет такой цикл. Он быстро находит нужные места, пишет однотипные тесты, предлагает структуру и не жалуется на очередную просьбу «а теперь учти ещё вот это».
Есть и обратная сторона: ошибочную идею он тоже способен реализовать быстро, аккуратно и сразу в двенадцати файлах. Поэтому скорость генерации кода — не то же самое, что скорость принятия правильных решений.
Один из полезных принципов оказался простым: сначала сформулировать инвариант, потом просить код.
Например:
-
после выхода не должно остаться ни одного соединения;
-
read-only должен обеспечиваться PostgreSQL, а не только регулярным выражением;
-
смена контекста обязана выключать запись;
-
секретный SQL не должен попасть в историю;
-
частичная ошибка на шардах не должна выглядеть как полный успех;
-
dry-run не должен внезапно стать apply из-за удобного значения по умолчанию.
С такими правилами разговор с ИИ становится инженерной работой. Без них получается очень производительный генератор сюрпризов.
Что Terox не умеет делать за вас
Terox не превращает любой SQL в безопасный. Статический анализ — эвристика. Настоящие границы безопасности всё ещё создают права роли, READ ONLY-транзакции, TLS, таймауты и дисциплина раскатки.
Он не заменяет систему миграций приложения, мониторинг, бэкапы и понимание плана запроса. Не исправляет архитектуру шардирования. Не знает бизнес-смысл данных.
И, к сожалению, не может определить, действительно ли вам нужно выполнить запрос на всех 128 шардах. Он только очень хорошо умеет сделать это именно там, где вы попросили.
Что получилось
Из локальной боли вырос инструмент, которым мне удобно пользоваться каждый день:
-
один конфиг описывает сервисы, хранилища и шаблоны шардов;
-
один запрос можно выполнить на выбранном наборе целей;
-
результат сохраняет происхождение каждой строки;
-
диагностика знает о многошардовом контексте;
-
чтение защищено
READ ONLY; -
запись включается явно;
-
миграции получают dry-run, lint, транзакционную обёртку, таймауты и поэтапную раскатку;
-
CLI остаётся обычным локальным бинарником без отдельного сервера.
Первая версия появилась за пару дней именно благодаря ИИ. Но полезным Terox стал не потому, что код был написан быстро. Полезным он стал, когда быстрый код начали ограничивать понятными правилами, тестами и реальными рабочими сценариями.
В этом для меня и есть нормальный вайбкодинг: не «не понимать, что происходит», а быстро превращать собственное понимание проблемы в работающий инструмент.
Репозиторий: github.com/nvorobev/terox
Проект открыт, поэтому замечания, идеи и pull request’ы приветствуются. Особенно если у вас тоже есть шард, на котором данные совершенно точно должны были быть.
Автор: nvorobev

